# Spring面试题
大家好,我是小林。
Spring 这块在 Java 后端面试里的地位毋庸置疑,几乎是必考内容。不管是校招还是社招,IOC、AOP、事务、Bean 生命周期这些主题,基本每次都逃不掉。很多人平时天天用 Spring 写代码,@Autowired 一打、@Transactional 一加就完事了,但真被问起"IOC 底层怎么实现的""循环依赖是怎么解决的""事务为什么会失效",就开始语焉不详了。
这篇文章整理了 Spring 全家桶面试中最常被问到的知识点,涵盖 Spring 核心(IOC/AOP/事务/Bean)、SpringMVC、SpringBoot 自动装配、MyBatis,以及 SpringCloud 微服务组件,内容覆盖比较全面。
几个在面试里出现频率特别高的方向,建议重点花时间:
- IOC 和 AOP:IOC 的底层实现原理、三种依赖注入方式的区别,AOP 的动态代理机制(JDK 动态代理 vs CGLIB),以及 AOP 的实际应用场景,这两块是 Spring 面试的绝对核心。
- 循环依赖和三级缓存:为什么需要三级缓存、二级缓存为什么不够,这个问题在面试里被问得越来越频繁,而且很容易被追问到细节。
- Spring 事务:事务什么时候会失效(绕过代理、方法无法被代理、异常不符合回滚规则),这是一道经典坑题,答起来很容易只说表面。
- SpringBoot 自动装配原理:
@SpringBootApplication背后的逻辑、自动配置类是怎么被发现和筛选的,这块是 SpringBoot 的核心,面试里问的很多。 - Bean 的生命周期:从实例化到销毁经历了哪些步骤、各个扩展点在哪里介入,这块答好了能体现对 Spring 底层的理解深度。
如果你是第一次系统准备 Spring,建议先搞清楚 IOC 和 AOP 的原理,再去看 Bean 生命周期和循环依赖,顺序理清楚之后,后面的 SpringBoot 自动装配理解起来会顺很多。
# Spring
# 说一下你对 Spring 的理解
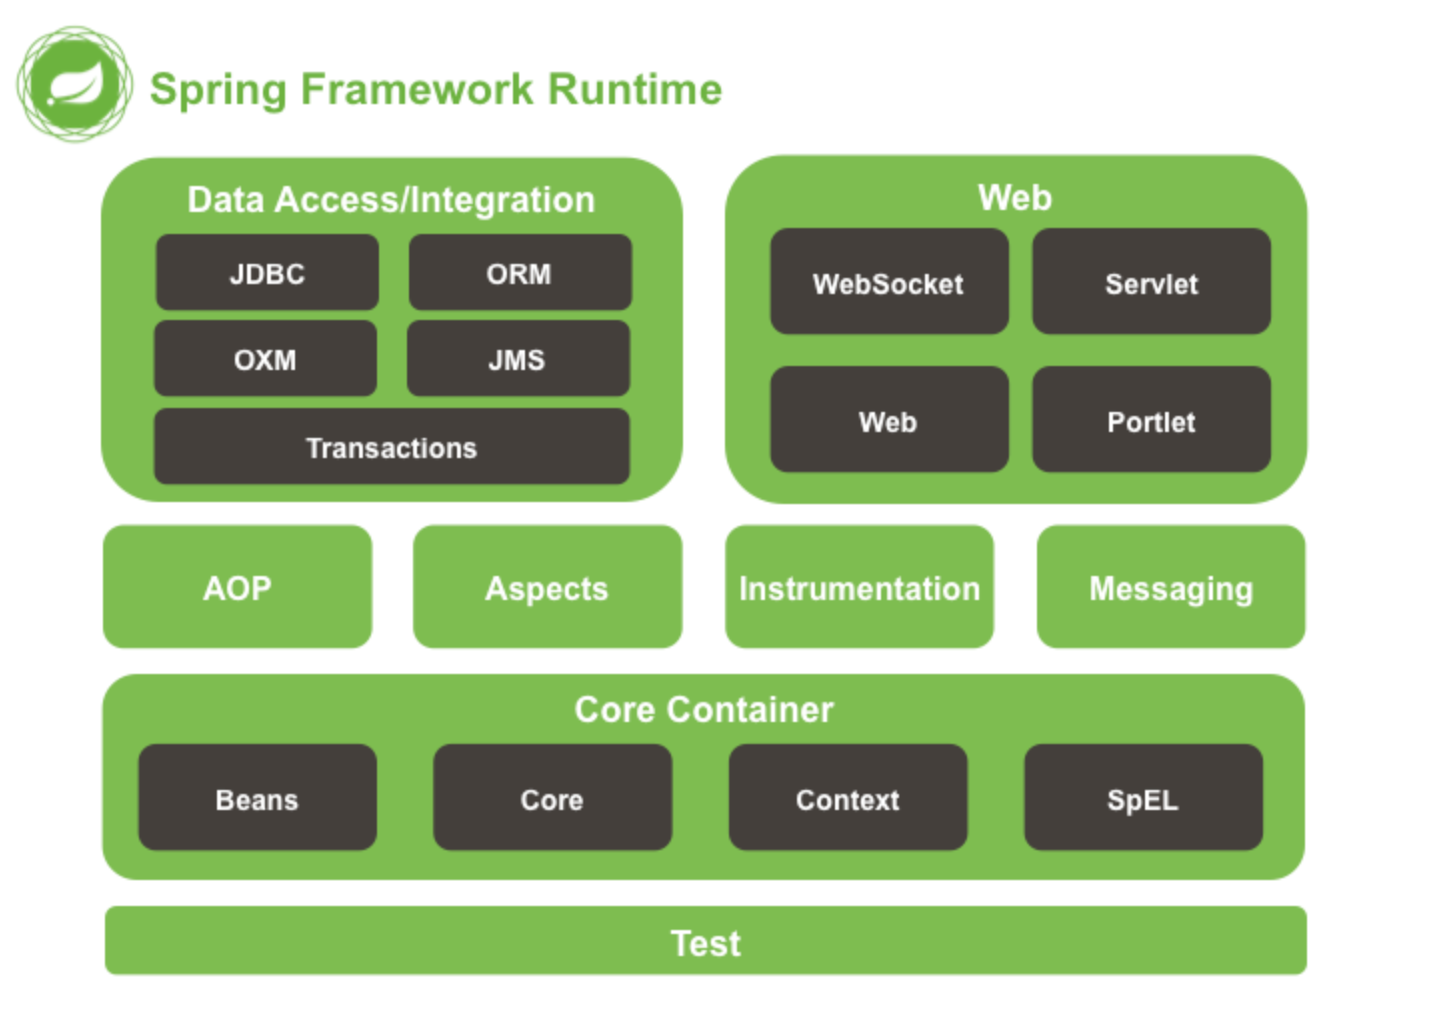
Spring框架核心特性包括:
- IoC容器:Spring通过控制反转实现了对象的创建和对象间的依赖关系管理。开发者只需要定义好Bean及其依赖关系,Spring容器负责创建和组装这些对象。
- AOP:面向切面编程,允许开发者定义横切关注点,例如事务管理、安全控制等,独立于业务逻辑的代码。通过AOP,可以将这些关注点模块化,提高代码的可维护性和可重用性。
- 事务管理:Spring提供了一致的事务管理接口,支持声明式和编程式事务。开发者可以轻松地进行事务管理,而无需关心具体的事务API。
- MVC框架:Spring MVC是一个基于Servlet API构建的Web框架,采用了模型-视图-控制器(MVC)架构。它支持灵活的URL到页面控制器的映射,以及多种视图技术。
# spring的核心思想说说你的理解?
| 核心思想 | 解决的问题 | 实现手段 | 典型应用场景 |
|---|---|---|---|
| IOC | 对象创建与依赖管理的高耦合 | 容器管理Bean生命周期 | 动态替换数据库实现、服务组装 |
| DI | 依赖关系的硬编码问题 | 构造器/Setter/字段注入 | 注入数据源、服务层依赖DAO层 |
| AOP | 横切逻辑分散在业务代码中 | 动态代理与切面配置 | 日志、事务、权限校验统一处理 |
Spring通过这IOC、DI、AOP三大核心思想,实现了轻量级、高内聚低耦合的企业级应用开发框架,成为Java生态中不可或缺的基石。
# Spring IoC和AOP 介绍一下
Spring IoC和AOP 区别:
- IoC:即控制反转的意思,它是一种创建和获取对象的技术思想,依赖注入(DI)是实现这种技术的一种方式。传统开发过程中,我们需要通过new关键字来创建对象。使用IoC思想开发方式的话,我们不通过new关键字创建对象,而是通过IoC容器来帮我们实例化对象。 通过IoC的方式,可以大大降低对象之间的耦合度。
- AOP:是面向切面编程,能够将那些与业务无关,却为业务模块所共同调用的逻辑封装起来,以减少系统的重复代码,降低模块间的耦合度。Spring AOP 基于动态代理:如果被代理对象实现了接口,Spring AOP 默认会使用 JDK Proxy 创建代理对象;如果没有实现接口,则会使用 CGLIB 生成被代理对象的子类作为代理。注意:自 Spring Boot 2.0 起,默认配置
spring.aop.proxy-target-class=true,即无论是否实现接口都优先使用 CGLIB,如需切回 JDK 动态代理需手动设为 false。
在 Spring 框架中,IOC 和 AOP 结合使用,可以更好地实现代码的模块化和分层管理。例如:
- 通过 IOC 容器管理对象的依赖关系,然后通过 AOP 将横切关注点统一切入到需要的业务逻辑中。
- 使用 IOC 容器管理 Service 层和 DAO 层的依赖关系,然后通过 AOP 在 Service 层实现事务管理、日志记录等横切功能,使得业务逻辑更加清晰和可维护。
# Spring的aop介绍一下
Spring AOP是Spring框架中的一个重要模块,用于实现面向切面编程。
我们知道,Java 就是一门面向对象编程的语言,在 OOP 中最小的单元就是“Class 对象”,但是在 AOP 中最小的单元是“切面”。一个“切面”可以包含很多种类型和对象,对它们进行模块化管理,例如事务管理。
在面向切面编程的思想里面,把功能分为两种
- 核心业务:登陆、注册、增、删、改、查、都叫核心业务
- 周边功能:日志、事务管理这些次要的为周边业务
在面向切面编程中,核心业务功能和周边功能是分别独立进行开发,两者不是耦合的,然后把切面功能和核心业务功能 "编织" 在一起,这就叫AOP。
AOP能够将那些与业务无关,却为业务模块所共同调用的逻辑或责任(例如事务处理、日志管理、权限控制等)封装起来,便于减少系统的重复代码,降低模块间的耦合度,并有利于未来的可拓展性和可维护性。
在 AOP 中有以下几个概念:
- Aspect:切面,把切点和通知组织在一起,描述在哪里执行什么横切逻辑。使用注解方式时,通常对应一个带有
@Aspect的类。AspectJ 是独立的 AOP 框架,Spring AOP 可以使用它的注解和切点表达式,但底层仍然是代理机制。 - Join point:连接点,指程序执行过程中的一个点,例如方法调用、异常处理等。在 Spring AOP 中,仅支持方法级别的连接点。
- Advice:通知,即我们定义的一个切面中的横切逻辑,包含
before、after、after-returning、after-throwing、around五种类型。在很多的 AOP 实现框架中,Advice 通常作为一个拦截器,也可以包含许多个拦截器作为一条链路围绕着 Join point 进行处理。 - Pointcut:切点,用于匹配连接点,决定通知要作用在哪些方法上,比如匹配某个包下的方法,或者带有指定注解的方法。
- Introduction:引介,为代理对象增加目标类原本没有实现的接口,并提供相应的实现,比如让代理对象额外具备某种状态查询能力。
- Weaving:织入,在有了连接点、切点、通知以及切面,如何将它们应用到程序中呢?没错,就是织入,在切点的引导下,将通知逻辑插入到目标方法上,使得我们的通知逻辑在方法调用时得以执行。
- AOP proxy:AOP 代理,指在 AOP 实现框架中实现切面协议的对象。在 Spring AOP 中有两种代理,分别是 JDK 动态代理和 CGLIB 动态代理。
- Target object:目标对象,就是被代理的对象。
Spring AOP 是基于 JDK 动态代理和 CGLIB 字节码增强实现的,两种代理方式都属于运行期织入,不需要专用编译器(与 AspectJ 的编译期 / 类加载期织入相对),因此 Spring AOP 完全可以在普通 Java 项目中使用。
# IOC和AOP是通过什么机制来实现的?
Spring IOC 实现机制
- 反射:Spring IOC容器利用Java的反射机制动态地加载类、创建对象实例及调用对象方法,反射允许在运行时检查类、方法、属性等信息,从而实现灵活的对象实例化和管理。
- 依赖注入:依赖注入是实现 IOC 的主要方式,即容器负责管理应用程序组件之间的依赖关系。Spring通过构造函数注入、属性注入或方法注入,将组件之间的依赖关系描述在配置文件中或使用注解。
- 设计模式 - 工厂模式:Spring IOC容器通常采用工厂模式来管理对象的创建和生命周期。容器作为工厂负责实例化Bean并管理它们的生命周期,将Bean的实例化过程交给容器来管理。
- 容器实现:Spring IOC容器是实现IOC的核心,通常使用BeanFactory或ApplicationContext来管理Bean。BeanFactory是IOC容器的基本形式,提供基本的IOC功能;ApplicationContext是BeanFactory的扩展,并提供更多企业级功能。
Spring AOP 实现机制
Spring AOP的实现依赖于动态代理技术。动态代理是在运行时动态生成代理对象,而不是在编译时。它允许开发者在运行时指定要代理的接口和行为,从而实现在不修改源码的情况下增强方法的功能。
Spring AOP支持两种动态代理:
- 基于JDK的动态代理:使用java.lang.reflect.Proxy类和java.lang.reflect.InvocationHandler接口实现。这种方式需要代理的类实现一个或多个接口。
- 基于CGLIB的动态代理:当被代理的类没有实现接口时,Spring会使用CGLIB库生成一个被代理类的子类作为代理。CGLIB(Code Generation Library)是一个第三方代码生成库,通过继承方式实现代理。
# 怎么理解SpringIoc?
IOC:Inversion Of Control,即控制反转,是一种设计思想。在传统的 Java SE 程序设计中,我们直接在对象内部通过 new 的方式来创建对象,是程序主动创建依赖对象;
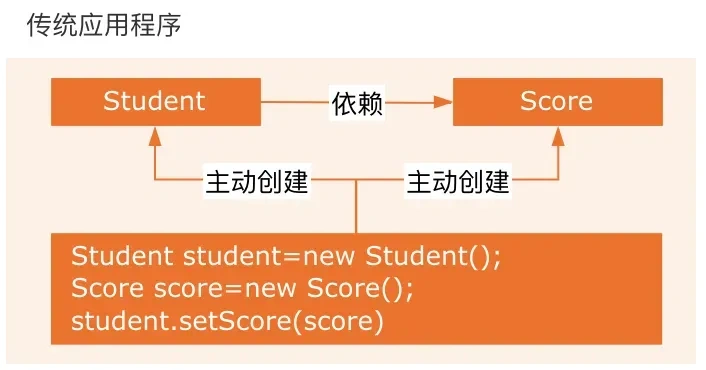
而在Spring程序设计中,IOC 是有专门的容器去控制对象。
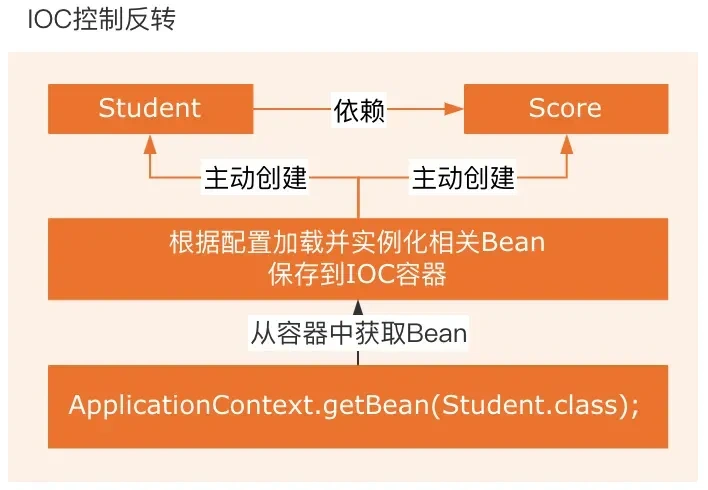
所谓控制就是对象的创建、初始化、销毁。
- 创建对象:原来是 new 一个,现在是由 Spring 容器创建。
- 初始化对象:原来是对象自己通过构造器或者 setter 方法给依赖的对象赋值,现在是由 Spring 容器自动注入。
- 销毁对象:容器关闭时,Spring 会调用它所管理的 Bean 的销毁回调,比如关闭连接、释放资源。这里的“销毁”指资源清理,对象内存最终还是由 JVM 的垃圾回收器回收。
总结:IOC 解决了繁琐的对象生命周期的操作,解耦了我们的代码。所谓反转:其实是反转的控制权,前面提到是由 Spring 来控制对象的生命周期,那么对象的控制就完全脱离了我们的控制,控制权交给了 Spring 。这里反转的是对象创建和依赖组装的控制权:业务代码从“自己创建依赖”,变成“声明依赖并接收容器提供的对象”。
# 依赖倒置,依赖注入,控制反转分别是什么?
这三个概念经常一起出现,但它们说的是不同层面的事情。
- 控制反转(IoC):是一种设计思想。原来由业务对象自己创建和管理依赖,现在把这部分控制权交给外部容器。在 Spring 里,就是由 IoC 容器负责创建 Bean、组装依赖和管理生命周期。
- 依赖注入(DI):是实现控制反转的一种方式。对象只声明自己需要什么,外部通过构造器、Setter 方法或者字段把依赖传进来。DI 和 IoC 不是相反的关系,而是实现方式和设计思想的关系,而且依赖注入并不一定要用 Spring,手动通过构造器传入对象也是 DI。
- 依赖倒置(DIP):是一条设计原则。高层模块和低层模块都应该依赖抽象,抽象不应该依赖具体实现,具体实现应该依赖抽象。
举个例子,订单服务需要发通知。如果它直接 new SmsSender(),就和短信实现绑死了。我们可以让它依赖 MessageSender 接口,再通过构造器注入具体实现:依赖接口体现依赖倒置,构造器传参体现依赖注入,把创建和组装交给 Spring 则体现控制反转。
# 依赖注入了解吗?怎么实现依赖注入的?
在传统编程中,当一个类需要使用另一个类的对象时,通常会在该类内部通过new关键字来创建依赖对象,这使得类与类之间的耦合度较高。
而依赖注入则是将对象的创建和依赖关系的管理交给 Spring 容器来完成,类只需要声明自己所依赖的对象,容器会在运行时将这些依赖对象注入到类中,从而降低了类与类之间的耦合度,提高了代码的可维护性和可测试性。
具体到Spring中,常见的依赖注入的实现方式,比如构造器注入、Setter方法注入,还有字段注入。
- **构造器注入:**通过构造函数传递依赖对象,保证对象初始化时依赖已就绪。
@Service
public class UserService {
    private final UserRepository userRepository;

    // 构造器注入(Spring 4.3+ 自动识别单构造器,无需显式@Autowired)
    public UserService(UserRepository userRepository) {
        this.userRepository = userRepository;
    }
}
- **Setter 方法注入:**通过 Setter 方法设置依赖,灵活性高,但依赖可能未完全初始化。
public class PaymentService {
    private PaymentGateway gateway;

    @Autowired
    public void setGateway(PaymentGateway gateway) {
        this.gateway = gateway;
    }
}
- **字段注入:**直接通过
@Autowired注解字段,代码简洁但隐藏依赖关系,不推荐生产代码。
@Service
public class OrderService {
    @Autowired
    private OrderRepository orderRepository;
}
# 为什么更推荐构造器注入?
我一般会把必需的依赖放在构造器里,可选的依赖再考虑 Setter 注入。
构造器注入主要有这么几个好处:
- 依赖明确:看构造方法就知道这个类要用哪些组件,依赖太多也能直接暴露出来,方便判断是不是该拆分类了。
- 对象创建后就能使用:必需的依赖在构造时就传进来了,不容易出现对象已经创建、依赖却还是
null的情况。 - 方便测试:单元测试里直接
new UserService(mockRepository)就可以,不用启动 Spring 容器,也不用反射给字段赋值。 - 支持
final字段:依赖引用可以固定下来,避免后续被随意替换。不过final只是保证引用不变,不代表依赖对象本身就线程安全。
还有一点,构造器注入遇到循环依赖会在启动时暴露问题,这反而能提醒我们检查设计。如果两个 Service 必须互相依赖,通常可以抽出公共逻辑,或者加一个上层服务来协调。
# @Autowired 和 @Resource 有什么区别?
它们都可以用来注入依赖,主要区别在于来源和依赖匹配方式。
@Autowired:是 Spring 提供的注解,主要按类型匹配。存在多个同类型 Bean 时,可以通过@Qualifier指定候选,或者用@Primary标记默认候选;没有这些明确选择时,在满足条件的情况下还可能根据字段名、参数名匹配 Bean 名。仍然无法确定唯一候选,就会报错。@Resource:是 Java 的标准注解,常用于字段和 Setter 方法。显式写了name时,按指定名称查找;没写name时,先尝试字段名或属性名,找不到对应名称再按类型匹配。显式指定名称却找不到时,不会再随便选一个同类型 Bean。
比如有支付宝和微信两个支付实现,写 @Autowired PaymentService paymentService 就可能存在歧义,可以用 @Qualifier("wechatPaymentService") 明确选择;也可以写 @Resource(name = "wechatPaymentService")。
版本上也要注意:Spring Boot 2.x 常见的是 javax.annotation.Resource,Spring Boot 3.x 起使用 jakarta.annotation.Resource。
# 如果让你设计一个SpringIoc,你觉得会从哪些方面考虑这个设计?
我会先把它拆成 读取定义、创建对象、注入依赖、管理生命周期 四个主要过程,再补作用域和扩展能力。
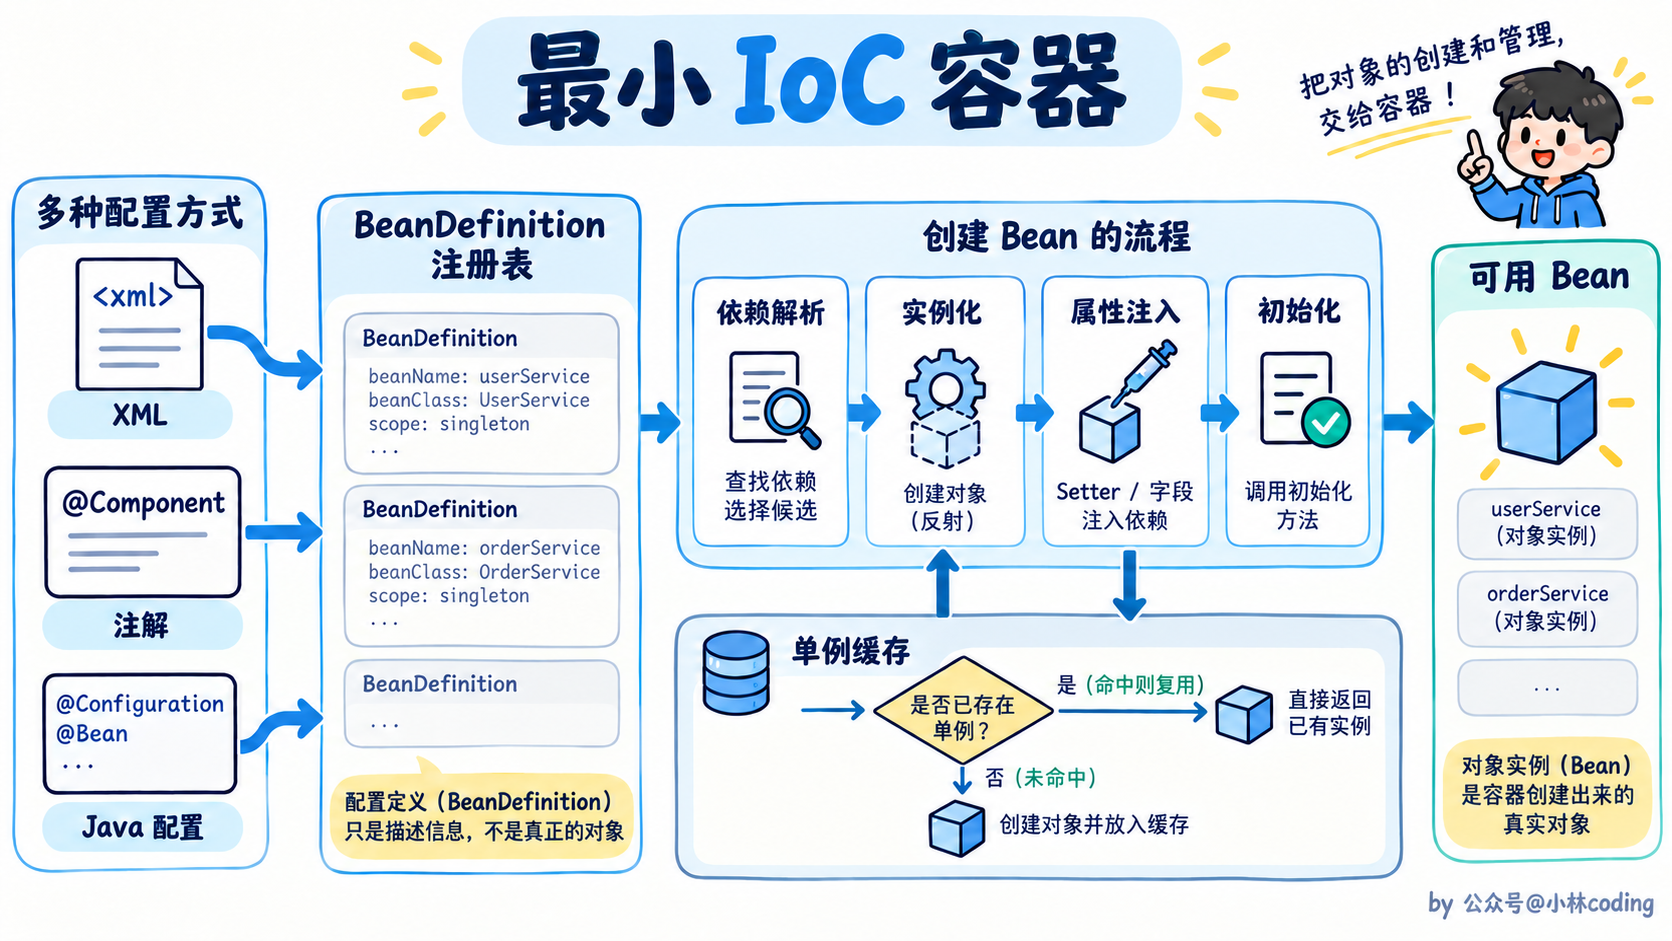
- Bean定义管理:设计类似 BeanDefinition 的结构,记录类型、作用域、构造参数、属性和初始化方法。XML、注解、Java 配置都先转换成统一的定义,后面的创建逻辑就不用关心配置来源了。
- 对象创建与依赖解析:根据定义选择构造器或工厂方法,递归查找依赖,再通过构造器、Setter 等方式完成注入。同类型有多个候选时,需要支持按名称、限定符等选择,并在无法确定时给出清晰的异常。
- 作用域和缓存:单例按 Bean 名缓存并复用,prototype 每次获取时创建,其他作用域由对应的策略管理。还要保证并发创建单例时不会产生多个对外实例。
- 生命周期:把实例化和初始化分开,提供初始化、销毁回调,并根据作用域决定容器管理到哪一步。
- 循环依赖:记录正在创建的 Bean,能提前暴露实例的单例循环可以按规则处理;构造器循环等无法解决的情况要及时报错,不能无限递归。
- 扩展点和代理:定义类似 BeanFactoryPostProcessor、BeanPostProcessor 的扩展接口,让外部能修改定义、处理实例或者替换成代理对象。
如果只是实现一个最小版本,我会先做“定义注册 + 单例创建 + 构造器注入”,把依赖解析和错误处理跑通,再逐步加入生命周期、其他作用域和 AOP。这样设计的关键是把对象怎么描述、怎么创建、怎么扩展分开。
# SpringAOP主要想解决什么问题
Spring AOP 主要解决的是横切逻辑重复、分散在各个业务类中的问题。
举个例子,订单、支付、用户这些 Service 都要记录调用日志。如果每个方法都手动写日志代码,业务代码就会被通用逻辑打断;以后调整日志格式或增加耗时统计,还要到很多地方逐个修改。
这些 Service 的主要业务职责不同,不能为了共享日志就强行放进同一条继承关系里。我们可以通过组合封装日志组件,但每个业务方法仍然需要主动调用它。
AOP 则把这部分逻辑放到切面里,通过切点指定哪些方法需要增强,再由代理在方法执行时统一调用。业务方法主要关注下单、支付等核心流程,日志、事务等逻辑可以独立维护。
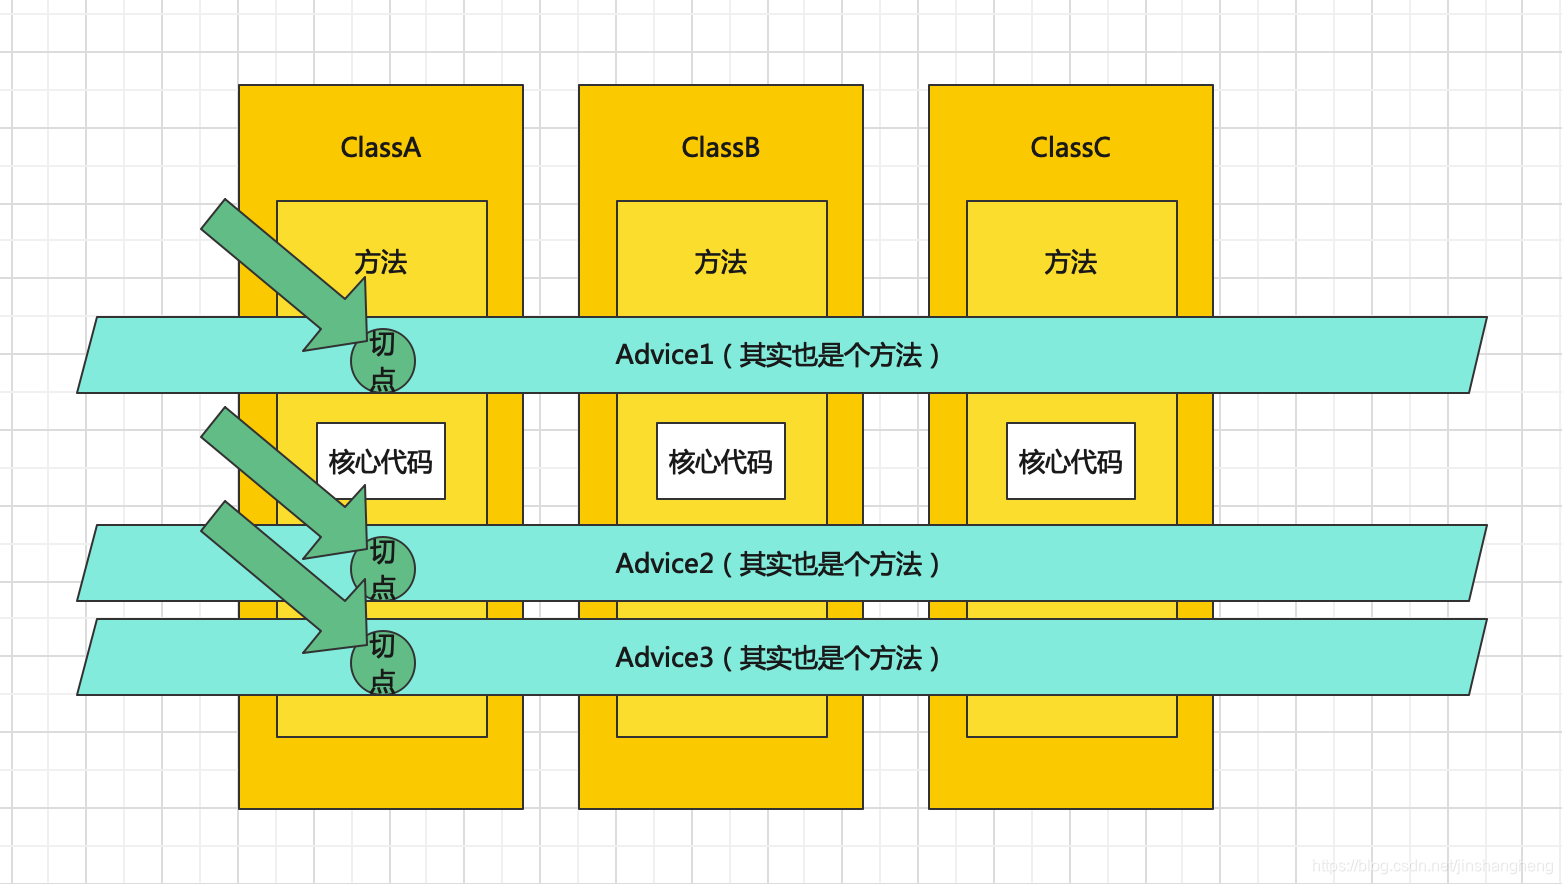
所以它是对面向对象设计的一种补充,重点在于把跨多个模块的共性行为抽出来,而不是专门弥补 Java 不支持多继承。
# AOP在spring中的应用,你知道哪些?
在 Spring 中,AOP(面向切面编程)是核心特性之一,它通过分离横切关注点(如日志、事务、安全等)与业务逻辑,让代码更清晰、可维护。实际应用中,Spring AOP 的典型场景有这么几个:
- 最常见的是事务管理,Spring 的声明式事务就是基于 AOP 实现的。我们只需要在方法上标注
@Transactional,Spring 就会通过 AOP 在方法执行前开启事务,执行后根据是否有异常决定提交或回滚,不用手动写事务控制代码,大大简化了事务管理。 - 然后是日志记录,比如对接口的调用参数、返回结果、执行时间做日志,用 AOP 可以把这些逻辑抽离出来,定义一个切面,通过
@Before获取入参,@AfterReturning获取返回值,@Around统计执行时间,这样业务方法里就不用掺杂日志代码,既干净又方便统一修改。 - 还有权限校验,比如某些接口需要登录后才能访问,或者需要特定角色权限。可以定义一个切面,在方法执行前(
@Before)检查用户的登录状态或权限,如果不满足就直接抛出异常阻止方法执行,避免在每个接口方法里重复写权限判断。
Spring AOP 的这些应用,本质上都是通过 “切面” 封装横切逻辑,通过 “切入点” 指定要作用的方法,然后在方法执行的不同阶段(前、后、异常时等)插入这些逻辑,实现了 “无侵入” 地增强业务功能,这也是 AOP 在 Spring 中如此重要的原因。
# 谈谈你对 Spring AOP 的了解程度?
我对 Spring AOP 的理解,核心就是它是一种不侵入业务代码的横切逻辑解决方案。比如日志、事务、权限校验这些,如果全写在业务方法里会非常乱,AOP 的作用就是把这些和业务无关、但又必须要做的事情抽出来,统一处理。
在 Spring 里,AOP 主要是通过代理机制来实现的。在没有强制使用类代理的情况下,有接口通常用 JDK 动态代理,没有接口用 CGLIB;Spring Boot 2.x、3.x 的 AOP 自动配置默认倾向于 CGLIB,所以还要结合项目的代理配置判断。本质上,调用的并不是原始对象,而是代理对象,方法执行前后会被织入额外逻辑。
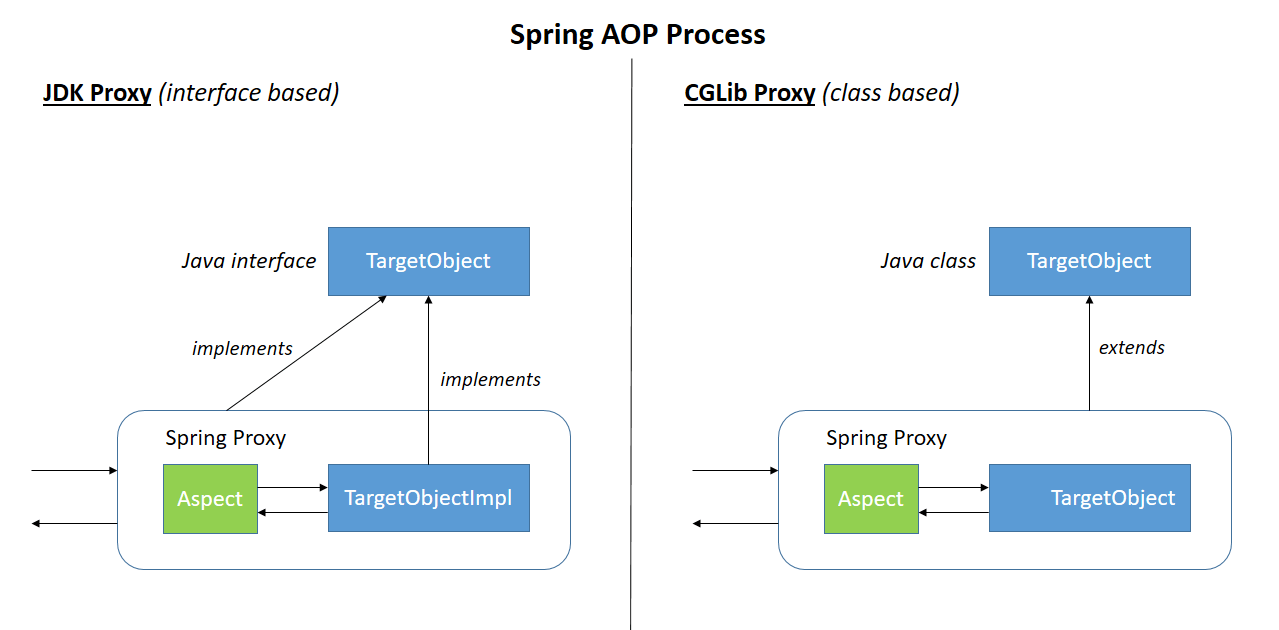
从使用角度来看,Spring AOP 是基于运行时代理的 AOP,不是像 AspectJ 那种编译期或类加载期织入。我们平时写 @Aspect、@Before、@After、@Around 这些注解,其实就是在定义切面、切点和通知,Spring 在容器启动的时候会解析这些配置,最后帮我们把代理对象准备好。
真正执行的时候,方法调用会走一条拦截器链。以 @Around 为例,本质上就是在方法执行前后包一层逻辑,是否放行、是否执行原方法,都是通过 proceed() 来控制的。事务、日志这些底层实现,其实就是一组 MethodInterceptor 在按顺序执行。
在实际项目里,我主要用 AOP 来做几类事情,比如声明式事务、接口日志、统一异常处理、参数校验或者一些轻量级的权限控制。这些场景的共同点是,它们都不属于核心业务逻辑,但又需要在很多地方重复出现,用 AOP 抽出来会非常干净。
当然 Spring AOP 也有它的边界。第一是它只能作用在 Spring 容器管理的 Bean 上,自己 new 出来的对象是不会生效的。第二是同类内部方法调用不会触发 AOP,因为走的是 this,绕过了代理。第三是它只能拦截方法级别的调用,做不到字段级别或者构造方法级别的增强。
整体来说,我会把 Spring AOP 当成一种工程层面的工具,用来解决通用、可复用的横切问题,而不是拿它去写复杂业务逻辑,超过这个边界我一般会考虑别的设计方式。
# SpringAOP的原理了解吗
Spring AOP 的核心是在目标对象外面包一层代理,把匹配到的通知组织成拦截器链。
可以从创建代理和执行代理这两个过程来看:
- 解析切面:Spring 解析
@Aspect类中的切点和通知,把它们转换成 Advisor。Advisor 可以理解为“在哪些方法上执行什么增强逻辑”。 - 创建代理:自动代理创建器作为 Bean 后置处理器,检查当前 Bean 是否匹配这些 Advisor。匹配就创建代理,一般在初始化后完成;遇到循环依赖时,可能提前暴露代理引用。
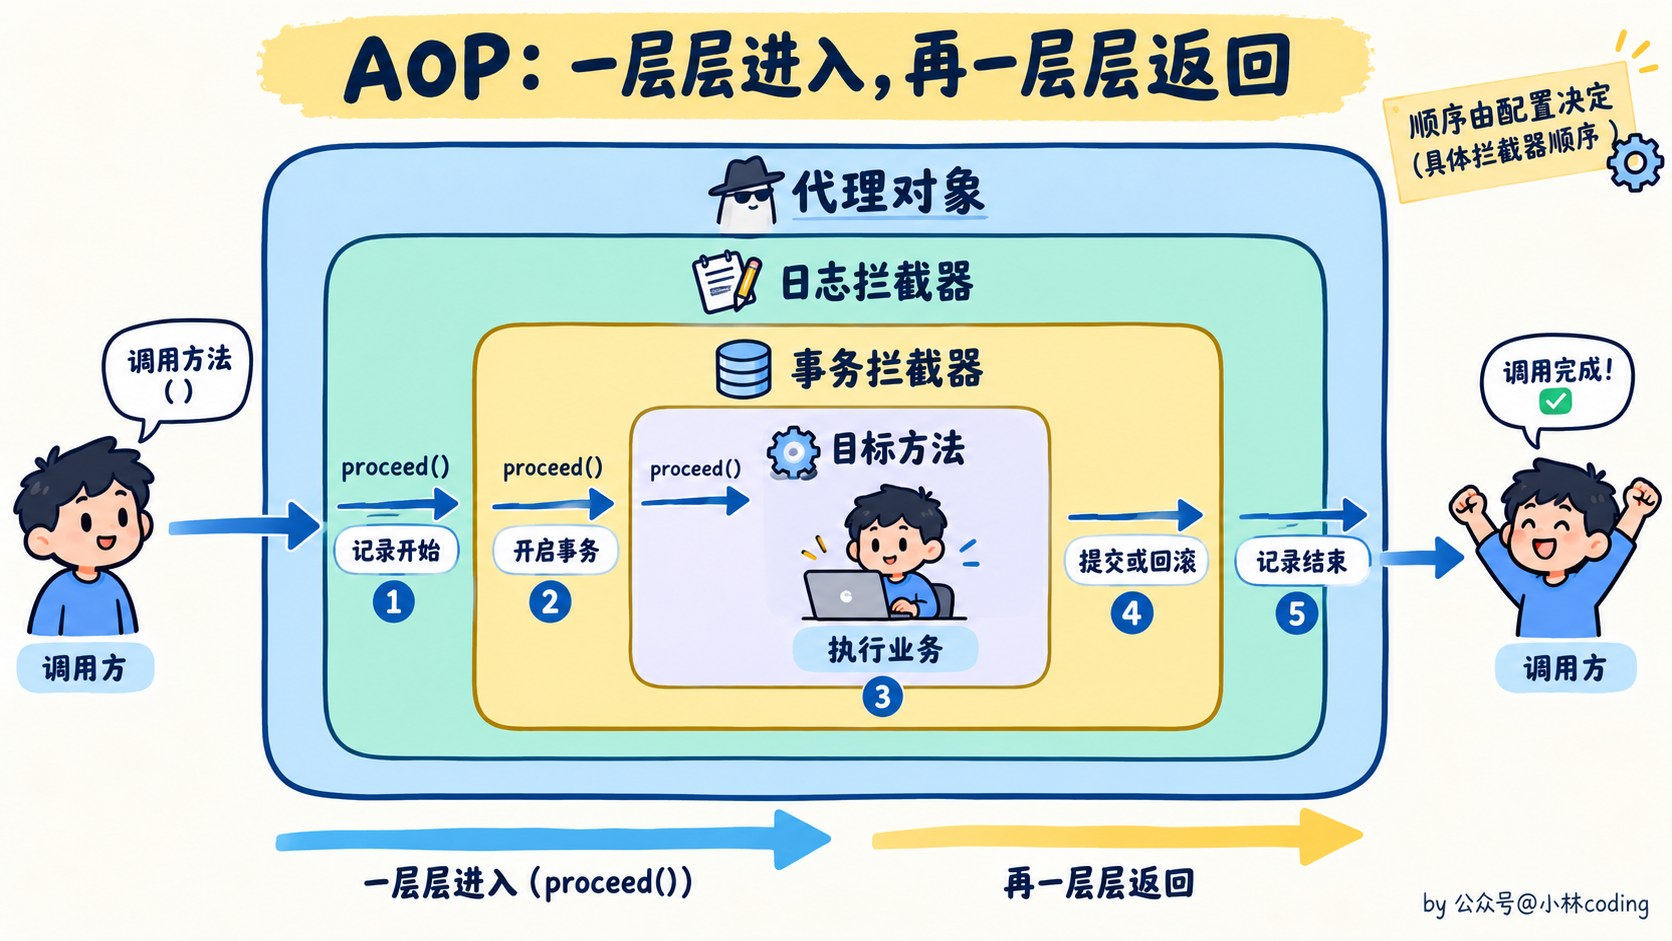
- 执行增强:外部通过代理调用方法时,代理找到适用的拦截器,按顺序执行。拦截器可以在目标方法前后加逻辑,也可以决定是否继续调用。
比如事务增强,调用链大致是:调用方 → 代理对象 → 事务拦截器 → 目标方法 → 提交或回滚。
代理有两种主要实现:
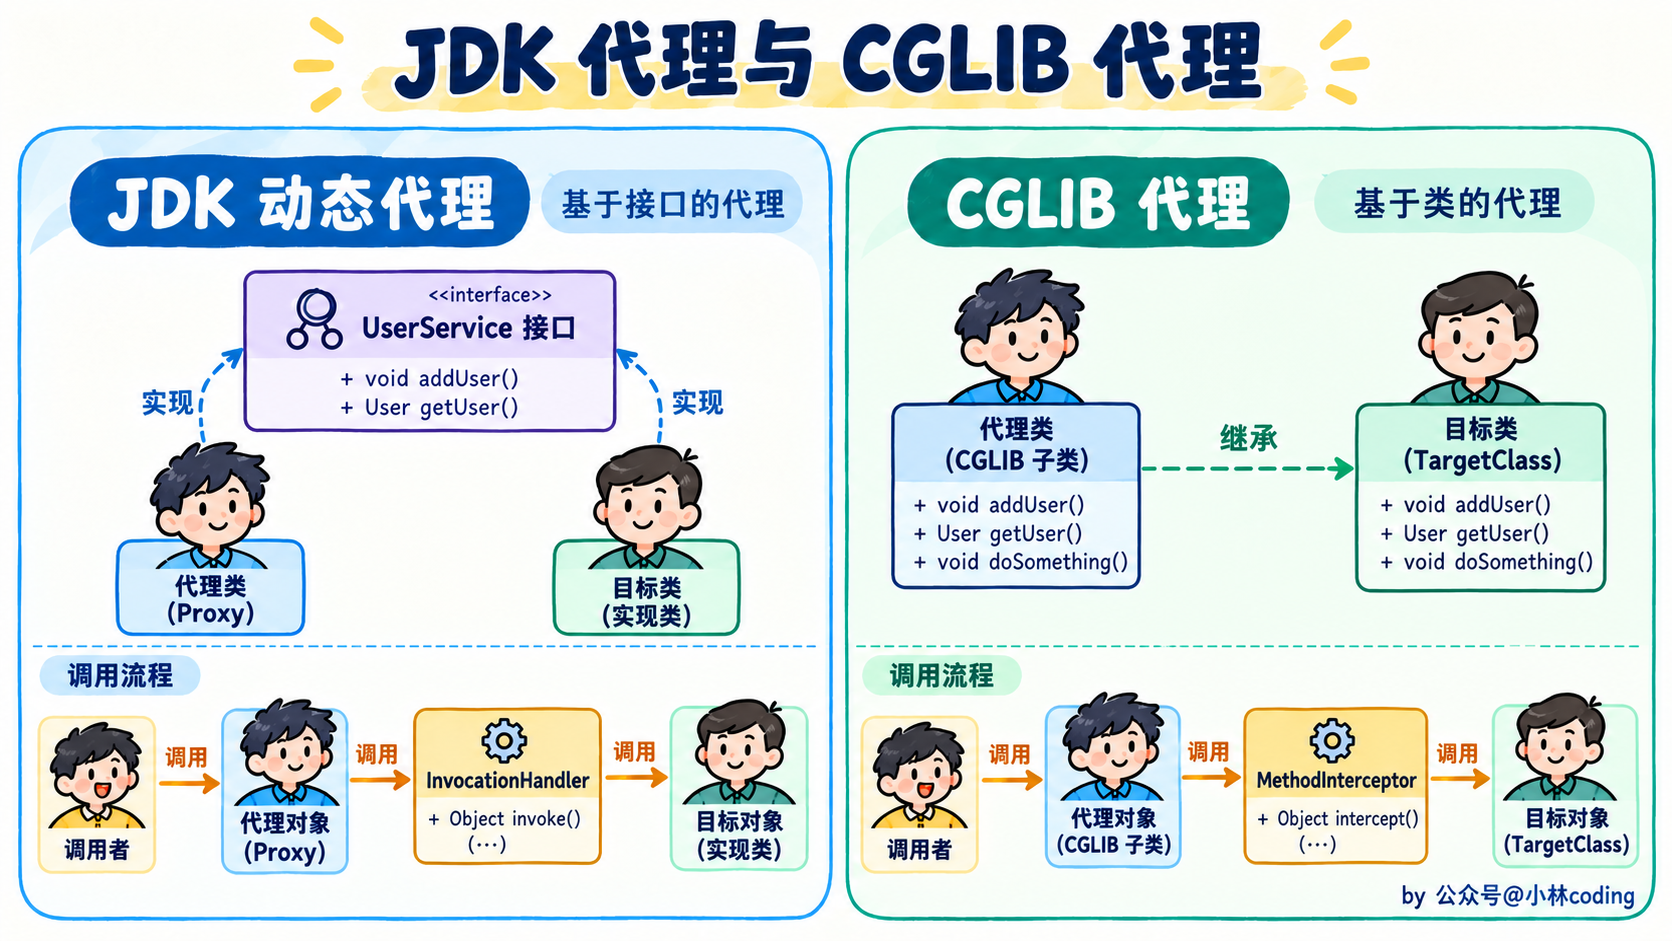
- JDK 动态代理:生成实现目标接口的代理类,通过
InvocationHandler处理调用,主要代理接口中暴露的方法。 - CGLIB 代理:生成目标类的子类,通过方法拦截完成增强,不要求目标类实现接口。因为依赖继承,
final类不能用它创建子类代理,final方法和private方法也不能被它增强。
如果没有强制使用类代理,Spring 通常有接口就用 JDK 动态代理,没有接口就用 CGLIB;Spring Boot 2.x、3.x 的 AOP 自动配置默认使用 CGLIB,可以通过 spring.aop.proxy-target-class=false 调整。
最后要注意,代理生效的前提是调用经过代理对象。同类内部的 this 调用直接进入目标对象,不会重新经过拦截器链,这也是事务、缓存等注解经常失效的原因。
# 动态代理是什么?
Java的动态代理是一种在运行时动态创建代理对象的机制,主要用于在不修改原始类的情况下对方法调用进行拦截和增强。
Java动态代理主要分为两种类型:
基于接口的代理(JDK动态代理): 这种类型的代理要求目标对象必须实现至少一个接口。Java动态代理会创建一个实现了相同接口的代理类,然后在运行时动态生成该类的实例。这种代理的实现核心是
java.lang.reflect.Proxy类和java.lang.reflect.InvocationHandler接口。代理类本身实现的是业务接口,增强逻辑由实现了InvocationHandler的处理器负责,每个代理对象都关联到一个handler。当通过代理对象调用一个方法时,这个方法的调用会被转发为由InvocationHandler接口的invoke()方法来进行调用。基于类的代理(CGLIB动态代理): CGLIB(Code Generation Library)是一个强大的高性能的代码生成库,它可以在运行时动态生成一个目标类的子类。CGLIB代理不需要目标类实现接口,而是通过继承的方式创建代理类。因此,如果目标对象没有实现任何接口,可以使用CGLIB来创建动态代理。
# 动态代理和静态代理的区别
代理是一种常用的设计模式,目的是:为其他对象提供一个代理以控制对某个对象的访问,将两个类的关系解耦。代理类和委托类都要实现相同的接口,因为代理真正调用的是委托类的方法。
区别:
- 静态代理:由程序员创建或者是由特定工具创建,在代码编译时就确定了被代理的类是一个静态代理。静态代理通常只代理一个类;
- 动态代理:在代码运行期间,由 JVM 根据目标对象自动生成代理类,不需要为每个被代理类手写代理类。JDK 动态代理基于接口(要求目标对象实现接口),CGLIB 动态代理基于继承(通过生成目标类的子类作为代理,不要求目标对象实现接口)。
# 能使用静态代理的方式实现AOP吗?
可以,静态代理也能实现方法增强,只是通用性和维护成本不同。
比如手写一个 OrderServiceProxy,在调用真正的 OrderService 前后记录日志、统计耗时,就实现了最基本的横切逻辑。
但业务接口和方法一多,静态代理就比较麻烦:
- 代理代码多:每个接口的方法都要写转发逻辑,很多方法前后做的事情其实一样。
- 维护成本高:接口新增方法或调整签名时,对应的代理类也要同步修改。动态代理可以减少手写转发代码,但业务调用方仍然要适配接口变化。
- 统一配置不方便:如果想通过切点表达式批量匹配方法,还得自己实现匹配和分发机制。
所以 Spring AOP 采用运行时动态代理,把代理对象的生成、方法匹配和通知执行统一交给框架处理。面试里可以回答:静态代理能做 AOP 的基本增强,动态代理更适合框架层面的大规模复用。
# AOP实现有哪些注解?
常用的注解包括:
- @Aspect:用于定义切面,标注在切面类上。
- @Pointcut:定义切点,标注在方法上,用于指定连接点。
- @Before:在方法执行之前执行通知。
- @After:在方法执行之后执行通知(无论方法正常返回还是抛出异常)。
- @Around:在方法执行前后都执行通知,是功能最强的一种。
- @AfterReturning:在方法正常返回结果后执行通知。
- @AfterThrowing:在方法抛出异常后执行通知。
# 什么是反射?有哪些使用场景?
反射机制是指程序在运行状态下,对于任意一个类,都能够获取这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意属性和方法。也就是说,Java 反射允许在运行时获取类的信息并动态操作对象,即使在编译时不知道具体的类也能实现。
反射具有以下特性:
- 运行时类信息访问:反射机制允许程序在运行时获取类的完整结构信息,包括类名、包名、父类、实现的接口、构造函数、方法和字段等。
- 动态对象创建:可以使用反射API动态地创建对象实例,即使在编译时不知道具体的类名。这通常通过
Constructor.newInstance()方法实现(Class.newInstance()自 Java 9 起已被标记为@Deprecated,推荐使用clazz.getDeclaredConstructor().newInstance())。 - 动态方法调用:可以在运行时动态地调用对象的方法,包括私有方法。这通过Method类的invoke()方法实现,允许你传入对象实例和参数值来执行方法。
- 访问和修改字段值:反射还允许程序在运行时访问和修改对象的字段值,即使是私有的。这是通过Field类的get()和set()方法完成的。
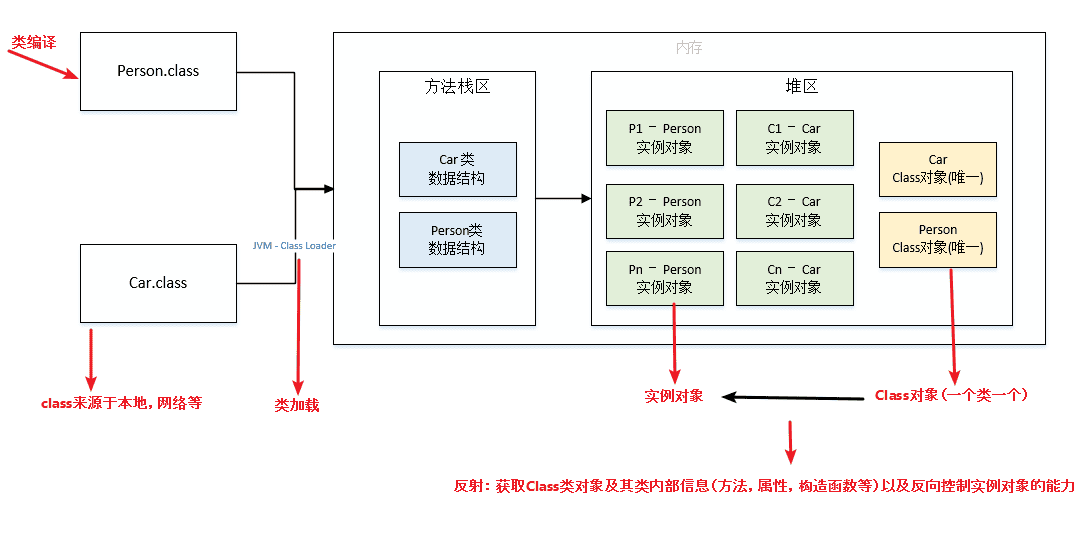
Java反射机制在spring框架中,很多地方都用到了反射,让我们来看看Spring的IoC和AOP是如何使用反射技术的。
1、Spring框架的依赖注入(DI)和控制反转(IoC)
Spring 使用反射来实现其核心特性:依赖注入。
在Spring中,开发者可以通过XML配置文件或者基于注解的方式声明组件之间的依赖关系。当应用程序启动时,Spring容器会扫描这些配置或注解,然后利用反射来实例化Bean(即Java对象),并根据配置自动装配它们的依赖。
例如,当一个Service类需要依赖另一个DAO类时,开发者可以在Service类中使用@Autowired注解,而无需自己编写创建DAO实例的代码。Spring容器会在运行时解析这个注解,通过反射找到对应的DAO类,实例化它,并将其注入到Service类中。这样不仅降低了组件之间的耦合度,也极大地增强了代码的可维护性和可测试性。
2、动态代理的实现
在需要对现有类的方法调用进行拦截、记录日志、权限控制或是事务管理等场景中,反射结合动态代理技术被广泛应用。
一个典型的例子是Spring AOP(面向切面编程)的实现。Spring AOP允许开发者定义切面(Aspect),这些切面可以横切关注点(如日志记录、事务管理),并将其插入到业务逻辑中,而不需要修改业务逻辑代码。
例如,为了给所有的服务层方法添加日志记录功能,可以定义一个切面,在这个切面中,Spring会使用JDK动态代理或CGLIB(如果目标类没有实现接口)来创建目标类的代理对象。这个代理对象在调用任何方法前或后,都会执行切面中定义的代码逻辑(如记录日志),而这一切都是在运行时通过反射来动态构建和执行的,无需硬编码到每个方法调用中。
这两个例子展示了反射机制如何在实际工程中促进松耦合、高内聚的设计,以及如何提供动态、灵活的编程能力,特别是在框架层面和解决跨切面问题时。
# spring是如何解决循环依赖的?
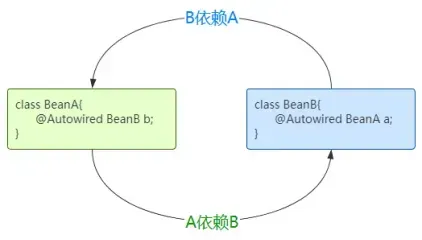
循环依赖指的是两个类中的属性相互依赖对方:例如 A 类中有 B 属性,B 类中有 A属性,从而形成了一个依赖闭环,如下图。
循环依赖问题在Spring中主要有三种情况:
- 第一种:通过构造方法进行依赖注入时产生的循环依赖问题。
- 第二种:通过setter方法进行依赖注入且是在多例(原型)模式下产生的循环依赖问题。
- 第三种:通过 setter 方法或字段(Field)进行依赖注入且是在单例模式下产生的循环依赖问题。
这三种典型情况里,Spring 的早期引用机制主要解决【第三种方式】,前提是容器允许循环依赖,并且相关 Bean 能正确暴露早期引用。双方都通过构造器直接依赖对方、或者双方都是 prototype 的循环依赖,不能靠这套机制解决。
Spring 在 DefaultSingletonBeanRegistry 类中维护了三个重要的缓存 (Map),称为“三级缓存”:
singletonObjects(一级缓存):存放的是完全初始化好的、可用的 Bean 实例,getBean()方法最终返回的就是这里面的 Bean。此时 Bean 已实例化、属性已填充、初始化方法已执行、AOP 代理(如果需要)也已生成。earlySingletonObjects(二级缓存):存放的是提前暴露的 Bean 的原始对象引用 或 早期代理对象引用,专门用来处理循环依赖。当一个 Bean 还在创建过程中(尚未完成属性填充和初始化),但它的引用需要被注入到另一个 Bean 时,就暂时放在这里。此时 Bean 已实例化,但属性可能还没填充完,初始化方法也可能尚未执行,它可能是一个原始对象,也可能是一个为了解决 AOP 代理问题而提前生成的代理对象。singletonFactories(三级缓存):存放的是 Bean 的ObjectFactory工厂对象,这是解决循环依赖和 AOP 代理协同工作的关键。当 Bean 被实例化后(刚调完构造函数),Spring 会创建一个ObjectFactory并将其放入三级缓存。这个工厂的getObject()方法负责返回该 Bean 的早期引用(可能是原始对象,也可能是提前生成的代理对象),当检测到循环依赖需要注入一个尚未完全初始化的 Bean 时,就会调用这个工厂来获取早期引用。
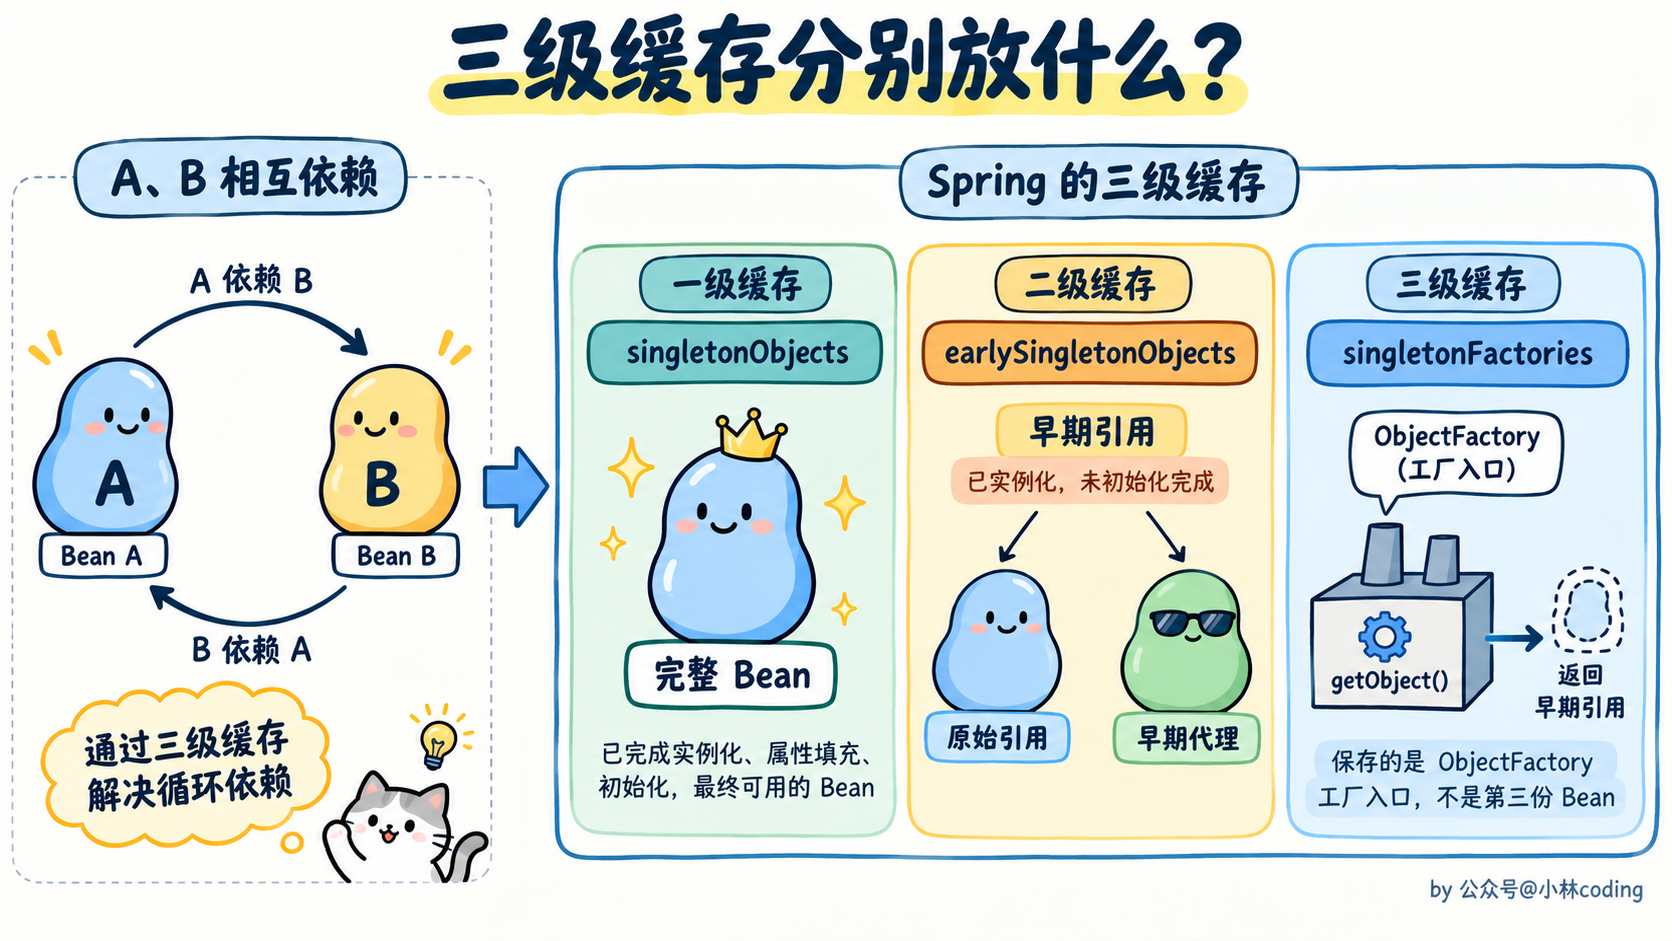
Spring 通过 三级缓存 和 提前暴露未完全初始化的对象引用 的机制来解决单例作用域 Bean 的 setter 注入方式的循环依赖问题。
假设存在两个相互依赖的单例Bean:BeanA 依赖 BeanB,同时 BeanB 也依赖 BeanA。当Spring容器启动时,它会按照以下流程处理:
- 第一步:创建
BeanA的实例并提前暴露工厂。
Spring首先调用BeanA的构造函数进行实例化,此时得到一个原始对象(尚未填充属性)。紧接着,Spring会将一个特殊的ObjectFactory工厂对象存入第三级缓存(singletonFactories)。这个工厂的使命是:当其他Bean需要引用BeanA时,它能动态返回当前这个半成品的BeanA(可能是原始对象,也可能是为应对AOP而提前生成的代理对象)。此时BeanA的状态是"已实例化但未初始化",像一座刚搭好钢筋骨架的大楼。
- 第二步:填充
BeanA的属性时触发BeanB的创建。
Spring开始为BeanA注入属性,发现它依赖BeanB。于是容器转向创建BeanB,同样先调用其构造函数实例化,并将BeanB对应的ObjectFactory工厂存入三级缓存。至此,三级缓存中同时存在BeanA和BeanB的工厂,它们都代表未完成初始化的半成品。
- 第三步:
BeanB属性注入时发现循环依赖。
当Spring试图填充BeanB的属性时,检测到它需要注入BeanA。此时容器启动依赖查找:
- 在一级缓存(存放完整Bean)中未找到
BeanA; - 在二级缓存(存放已暴露的早期引用)中同样未命中;
- 最终在三级缓存中定位到
BeanA的工厂。
Spring立即调用该工厂的getObject()方法。这个方法会执行关键决策:若BeanA需要AOP代理,则动态生成代理对象(即使BeanA还未初始化);若无需代理,则直接返回原始对象。得到的这个早期引用(可能是代理)被放入二级缓存(earlySingletonObjects),同时从三级缓存清理工厂条目。最后,Spring将这个早期引用注入到BeanB的属性中。至此,BeanB成功持有BeanA的引用——尽管BeanA此时仍是个半成品。
- 第四步:完成
BeanB的生命周期。
BeanB获得所有依赖后,Spring执行其初始化方法(如@PostConstruct),将其转化为完整可用的Bean。随后,BeanB被提升至一级缓存(singletonObjects),二级和三级缓存中关于BeanB的临时条目均被清除。此时BeanB已准备就绪,可被其他对象使用。
- 第五步:回溯完成
BeanA的构建。
随着BeanB创建完毕,流程回溯到最初中断的BeanA属性注入环节。Spring将已完备的BeanB实例注入BeanA,接着执行BeanA的初始化方法。这里有个精妙细节:若之前为BeanA生成过早期代理,Spring会直接复用二级缓存中的代理对象作为最终Bean,而非重复创建。最终,完全初始化的BeanA(可能是原始对象或代理)入驻一级缓存,其早期引用从二级缓存移除。至此循环闭环完成,两个Bean皆可用。
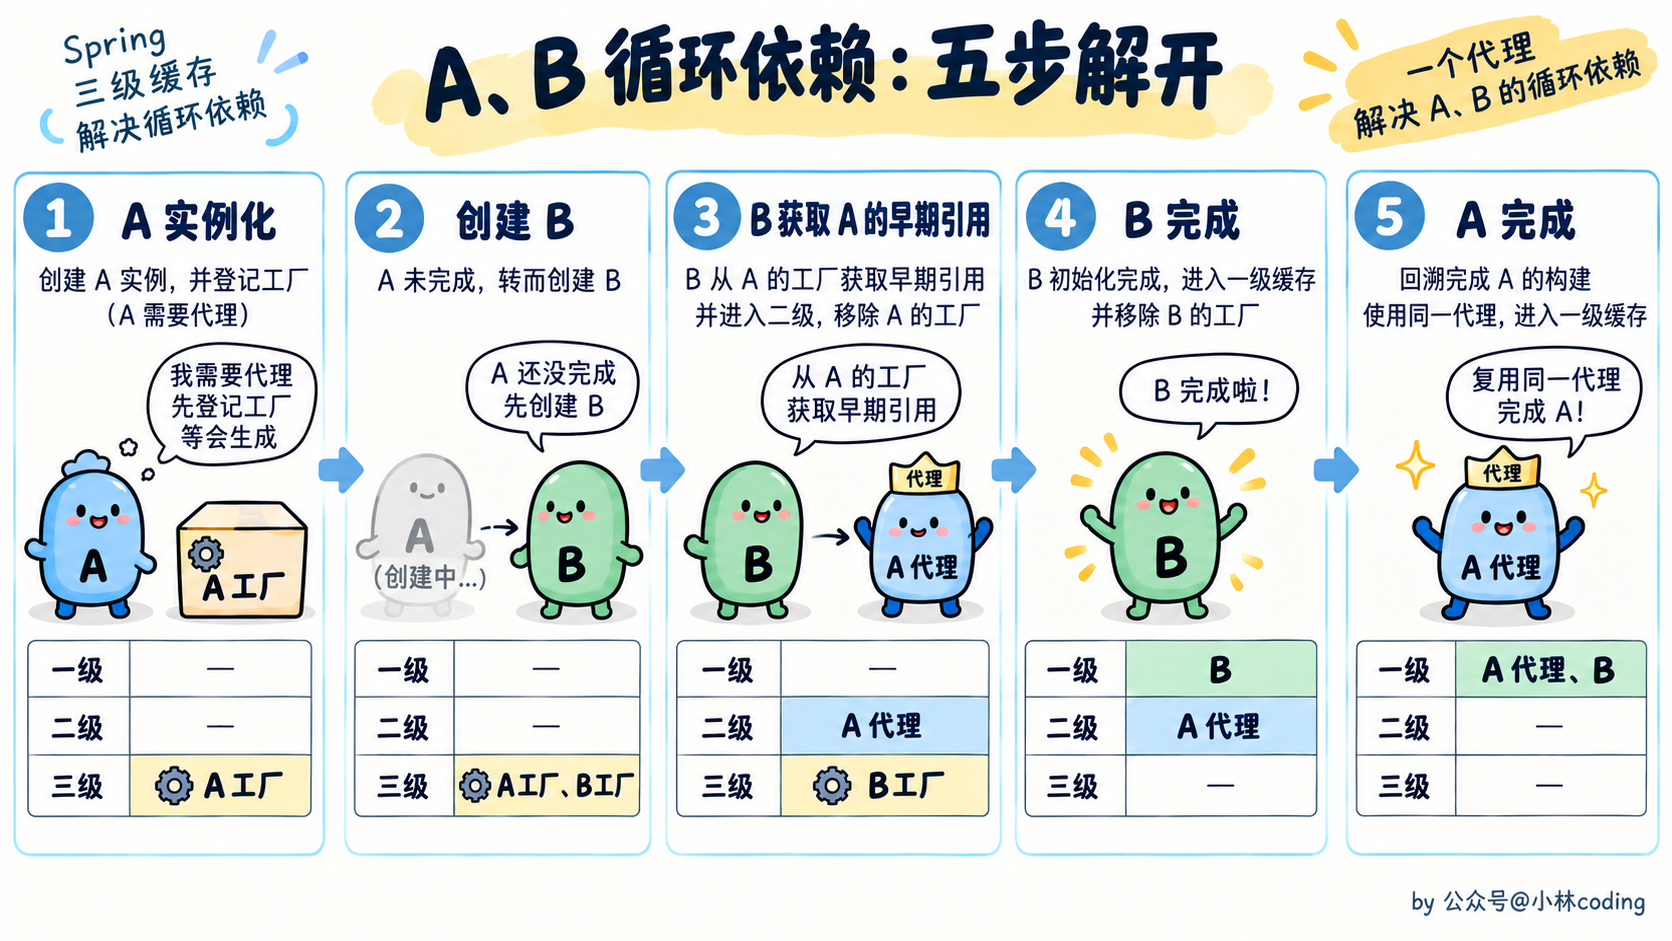
三级缓存的设计的精髓:
- 三级缓存工厂(
singletonFactories)负责在实例化后立刻暴露对象生成能力,兼顾AOP代理的提前生成; - 二级缓存(
earlySingletonObjects)临时存储已确定的早期引用,避免重复生成代理; - 一级缓存(
singletonObjects)最终交付完整Bean。
整个机制通过中断初始化流程、逆向注入半成品、延迟代理生成三大策略,将循环依赖的死结转化为有序的接力协作。
值得注意的是,这里讲的是基于早期引用解决单例 Bean 的 Setter/字段循环依赖。双方都通过构造器直接依赖对方时,连第一个实例都创建不出来,容器通常会抛出 BeanCurrentlyInCreationException,并不是线程意义上的死锁。
另外,Spring Boot 从 2.6 起默认禁止循环依赖。设置 spring.main.allow-circular-references=true 只是允许容器尝试解决支持的循环依赖,不代表任何循环都能解决。实际项目里优先拆分职责、抽出公共组件,必要时再通过 @Lazy 或 ObjectProvider 延迟获取依赖;也不要在初始化方法里急着调用尚未初始化完成的依赖。
# Spring为什么用3级缓存解决循环依赖问题?用2级缓存不行吗?
先说结论:如果只是解决普通对象的循环依赖,两个缓存也能做到;Spring 使用三级缓存,主要是为了按需提供早期引用,并和 AOP 代理的创建流程配合。
假设 A 依赖 B,B 又依赖 A,而且 A 需要事务代理。如果实例化 A 后直接把原始对象放进二级缓存,B 注入的就是原始 A。等 A 初始化后再创建代理,容器对外提供的是代理 A,B 却还拿着原始 A,通过 B 调用 A 时就会绕过事务增强。
这里的问题是对外引用不一致,不是目标对象和代理对象不能同时存在。正常的代理机制本来就会同时有目标对象和代理对象。
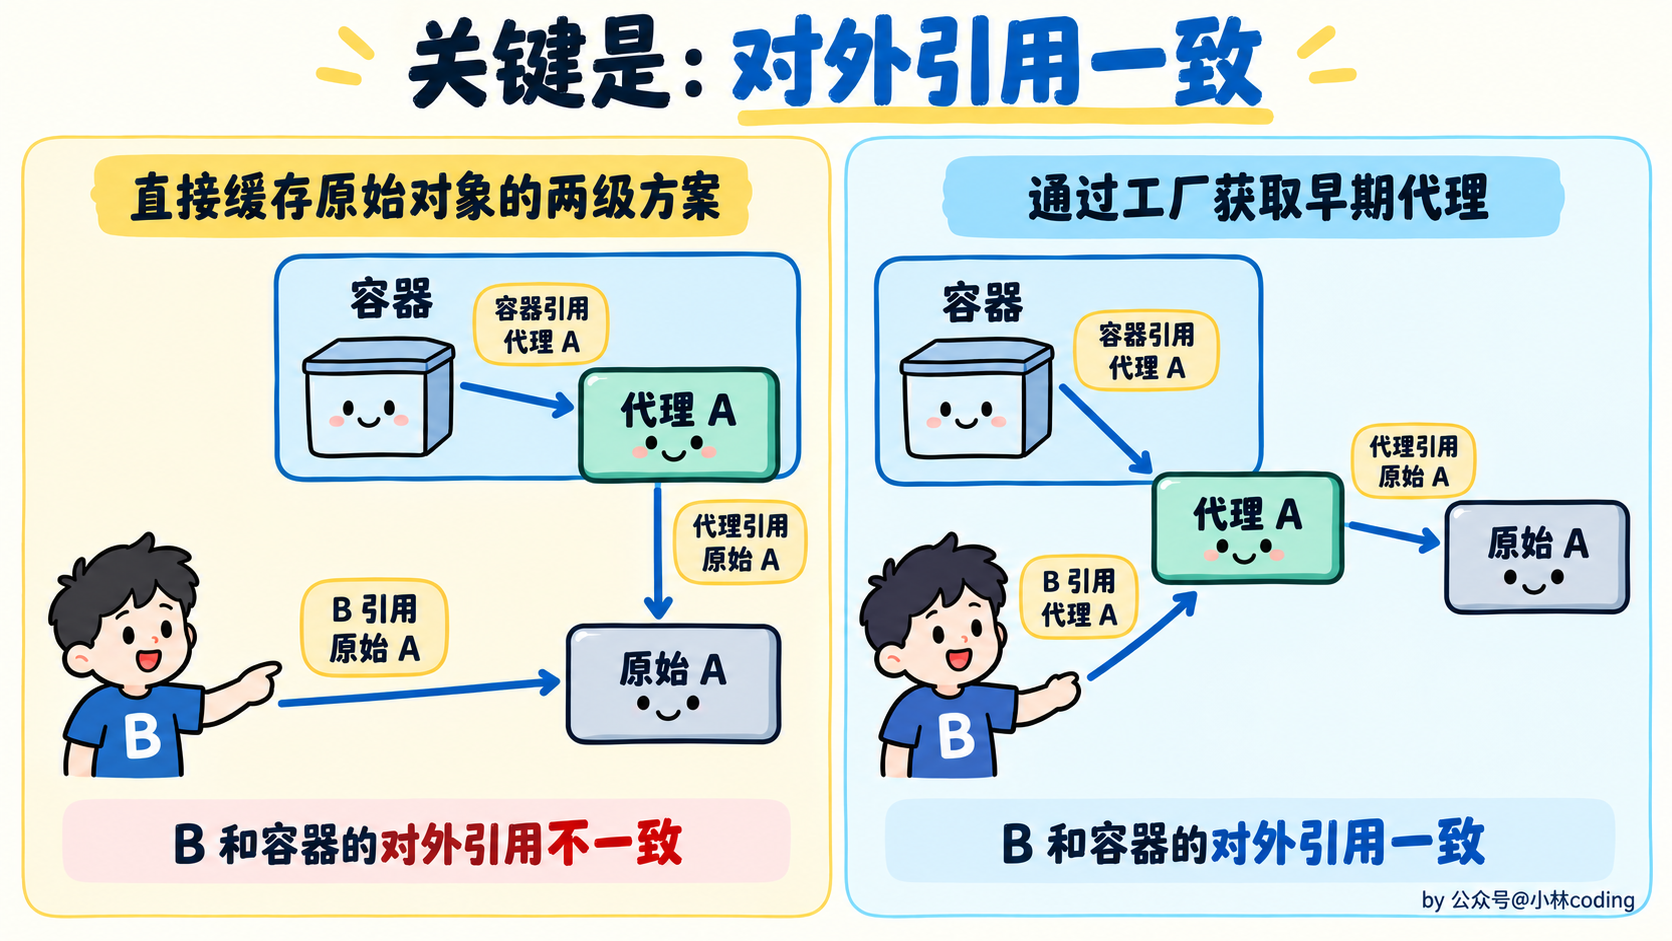
三级缓存里的 ObjectFactory 不直接保存最终引用,而是保留一个获取早期引用的入口:
- A 实例化后,先把工厂放进三级缓存,不急着创建早期代理。
- 如果 B 在创建时确实需要 A,就调用工厂,通过
getEarlyBeanReference()获取原始引用或早期代理。 - 把得到的引用放进二级缓存,后续直接复用,不重复生成。
- A 初始化完成后,再把一致的对外引用放进一级缓存,并清理二、三级缓存。
那能不能实例化后就提前生成代理,直接放进二级缓存?理论上可以重新设计这样的两级方案,只是这会让没发生循环依赖的 Bean 也提前执行代理相关处理,改变 Spring 通常在初始化后包装 Bean 的流程。
所以面试里不要简单说“没有三级缓存就一定无法解决循环依赖”。更准确的回答是:三级缓存让早期引用按需生成,二级缓存让生成后的引用可以复用,一级缓存保存最终可用的 Bean。这套配合能处理常见的自动代理场景,但自定义后置处理器如果只在初始化后包装对象、又不支持早期引用,仍然可能出问题。
# spring三级缓存的数据结构是什么?
三者都是 Map 类型的缓存,但 value 的类型不同:
- 一级缓存(Singleton Objects):
Map<String, Object>,存储的是已经完全初始化好的 bean,即完全准备好可以使用的 bean 实例。键是 bean 的名称,值是 bean 的实例。对应DefaultSingletonBeanRegistry类中的singletonObjects属性。 - 二级缓存(Early Singleton Objects):
Map<String, Object>,存储的是早期的 bean 引用,即已经实例化但还未完全初始化的 bean(可能是原始对象,也可能是为解决 AOP 循环依赖而提前生成的代理对象)。这些 bean 已经被实例化,但可能还没有完成属性注入等操作。对应DefaultSingletonBeanRegistry类中的earlySingletonObjects属性。 - 三级缓存(Singleton Factories):
Map<String, ObjectFactory<?>>,注意 value 不是 bean 实例本身,而是一个ObjectFactory工厂函数。当一个 bean 正在创建过程中被其他 bean 依赖时,就会调用这个工厂的getObject()方法生成早期引用(必要时会提前生成代理),从而解决循环依赖与 AOP 协同的问题。对应DefaultSingletonBeanRegistry类中的singletonFactories属性。
# spring框架中都用到了哪些设计模式
Spring 里设计模式很多,我会结合具体组件来举例,而不是只背模式名字。
- 工厂模式:BeanFactory 把对象的创建和获取统一起来,调用方只需要描述依赖,不必自己处理复杂的组装过程。
- 代理模式:Spring AOP 用代理对象在目标方法前后加入事务、日志等增强。
- 单例管理:默认 singleton 作用域通过容器缓存复用实例,范围是每个容器中的每个 Bean 定义。
- 模板方法模式:AbstractApplicationContext 的
refresh()定义容器刷新的主要步骤,把部分具体工作交给子类和扩展点。JdbcTemplate 则体现了模板与回调结合的思路,统一处理连接、异常和资源清理,把具体 SQL 操作交给回调。 - 策略模式:比如不同的 Resource 实现负责读取不同来源的资源;动态数据源也可以通过路由策略选择目标数据源。
- 装饰器模式:TransactionAwareCacheDecorator 在普通缓存外面增加事务相关的处理能力,而不要求重写底层缓存实现。
- 观察者模式:通过 ApplicationEventPublisher 发布事件,由监听器接收并处理。
- 适配器模式:Spring MVC 用 HandlerAdapter 适配不同类型的 Handler,让 DispatcherServlet 能统一调度。
重点是能说明这个模式解决了什么问题,比如 MVC 的适配器解决调用方式不统一,AOP 的代理解决通用逻辑增强。
# spring 常用注解有什么?
@Autowired 注解
@Autowired:主要用于自动装配bean。当Spring容器中存在与要注入的属性类型匹配的bean时,它会自动将bean注入到属性中。就跟我们new 对象一样。
用法很简单,如下示例代码:
@Component
public class MyService {
}

@Component
public class MyController {

    @Autowired
    private MyService myService;

}
在上面的示例代码中,MyController类中的myService属性被@Autowired注解标记,Spring会自动将MyService类型的bean注入到myService属性中。
@Component
这个注解用于标记一个类作为Spring的bean。当一个类被@Component注解标记时,Spring会将其实例化为一个bean,并将其添加到Spring容器中。在上面讲解@Autowired的时候也看到了,示例代码:
@Component
public class MyComponent {
}
在上面的示例代码中,MyComponent类被@Component注解标记,Spring会将其实例化为一个bean,并将其添加到Spring容器中。
@Configuration
@Configuration,注解用于标记一个类作为Spring的配置类。配置类可以包含@Bean注解的方法,用于定义和配置bean,作为全局配置。示例代码:
@Configuration
public class MyConfiguration {

    @Bean
    public MyBean myBean() {
        return new MyBean();
    }

}
@Bean
@Bean注解用于标记一个方法作为Spring的bean工厂方法。当一个方法被@Bean注解标记时,Spring会将该方法的返回值作为一个bean,并将其添加到Spring容器中,如果自定义配置,经常用到这个注解。
@Configuration
public class MyConfiguration {

    @Bean
    public MyBean myBean() {
        return new MyBean();

    }

}
@Service
@Service,这个注解用于标记一个类作为服务层的组件。它是@Component注解的特例,用于标记服务层的bean,一般标记在业务service的实现类。
@Service
public class MyServiceImpl {

}
@Repository
@Repository注解用于标记一个类作为数据访问层的组件。它也是@Component注解的特例,用于标记数据访问层的bean。加上这个注解后,Spring 会通过 PersistenceExceptionTranslationPostProcessor 对持久层抛出的异常进行统一翻译(转换为 Spring 的 DataAccessException 体系),忽略它会丢失这层异常转换能力。
@Repository
public class MyRepository {

}
在上面的示例代码中,MyRepository类被@Repository注解标记,Spring会将其实例化为一个bean,并将其添加到Spring容器中。
@Controller
@Controller注解用于标记一个类作为控制层的组件。它也是@Component注解的特例,用于标记控制层的bean。这是MVC结构的另一个部分,加在控制层
@Controller
public class MyController {

}
在上面的示例代码中,MyController类被@Controller注解标记,Spring会将其实例化为一个bean,并将其添加到Spring容器中。
# Spring的事务什么情况下会失效?
我会先从三个方向看:调用有没有经过代理、方法能不能被代理、事务和回滚规则有没有配置正确。下面这些情况都比较常见,这里讨论的是默认的代理模式。
- 对象没有交给 Spring 管理:自己
new出来的 Service 没有事务代理,即使方法上写了@Transactional也不会自动开启事务。 - 同类内部调用:
this.xxx()绕过代理,被调用方法上的事务配置不会被应用。尤其是想通过内部方法的REQUIRES_NEW开启新事务时,很容易踩坑。 - 方法无法被代理:
private方法不能通过代理增强;CGLIB 不能增强final方法,也不能代理final类。JDK 代理主要拦截接口暴露的 public 方法。不能一概说非 public 方法都失效,Spring 6.0 起,类代理默认还支持可代理的 protected 和包可见方法。为了减少差异,业务事务方法通常仍然写成 public。 - 异常不符合回滚规则:默认只对
RuntimeException和Error回滚,受检异常默认不回滚。需要时配置rollbackFor = Exception.class;如果项目调整了全局默认回滚规则,还要结合实际配置判断。 - 异常被当前方法吞掉:如果异常没有传到事务拦截器,也没有其他地方把事务标记成 rollback-only,代理会按正常返回提交。可以重新抛出异常,或者在确实需要时显式标记回滚。
- 跨线程执行:常见的 JDBC 本地事务资源绑定在当前线程,方法里新建线程或提交异步任务,不会自动继承外层事务。异步方法可以通过自己的事务代理开启事务,但这是另一个事务。
- 事务管理器或底层资源不匹配:例如多数据源场景选错了事务管理器,SQL 用的连接不归当前事务管理器管理,或者数据库存储引擎不支持事务。
- 传播行为不符合预期:比如
NOT_SUPPORTED会以非事务方式执行,REQUIRES_NEW会独立提交,外层回滚也不会把它已提交的数据撤销。这些通常是配置语义和预期不同,不是 Spring 没有工作。
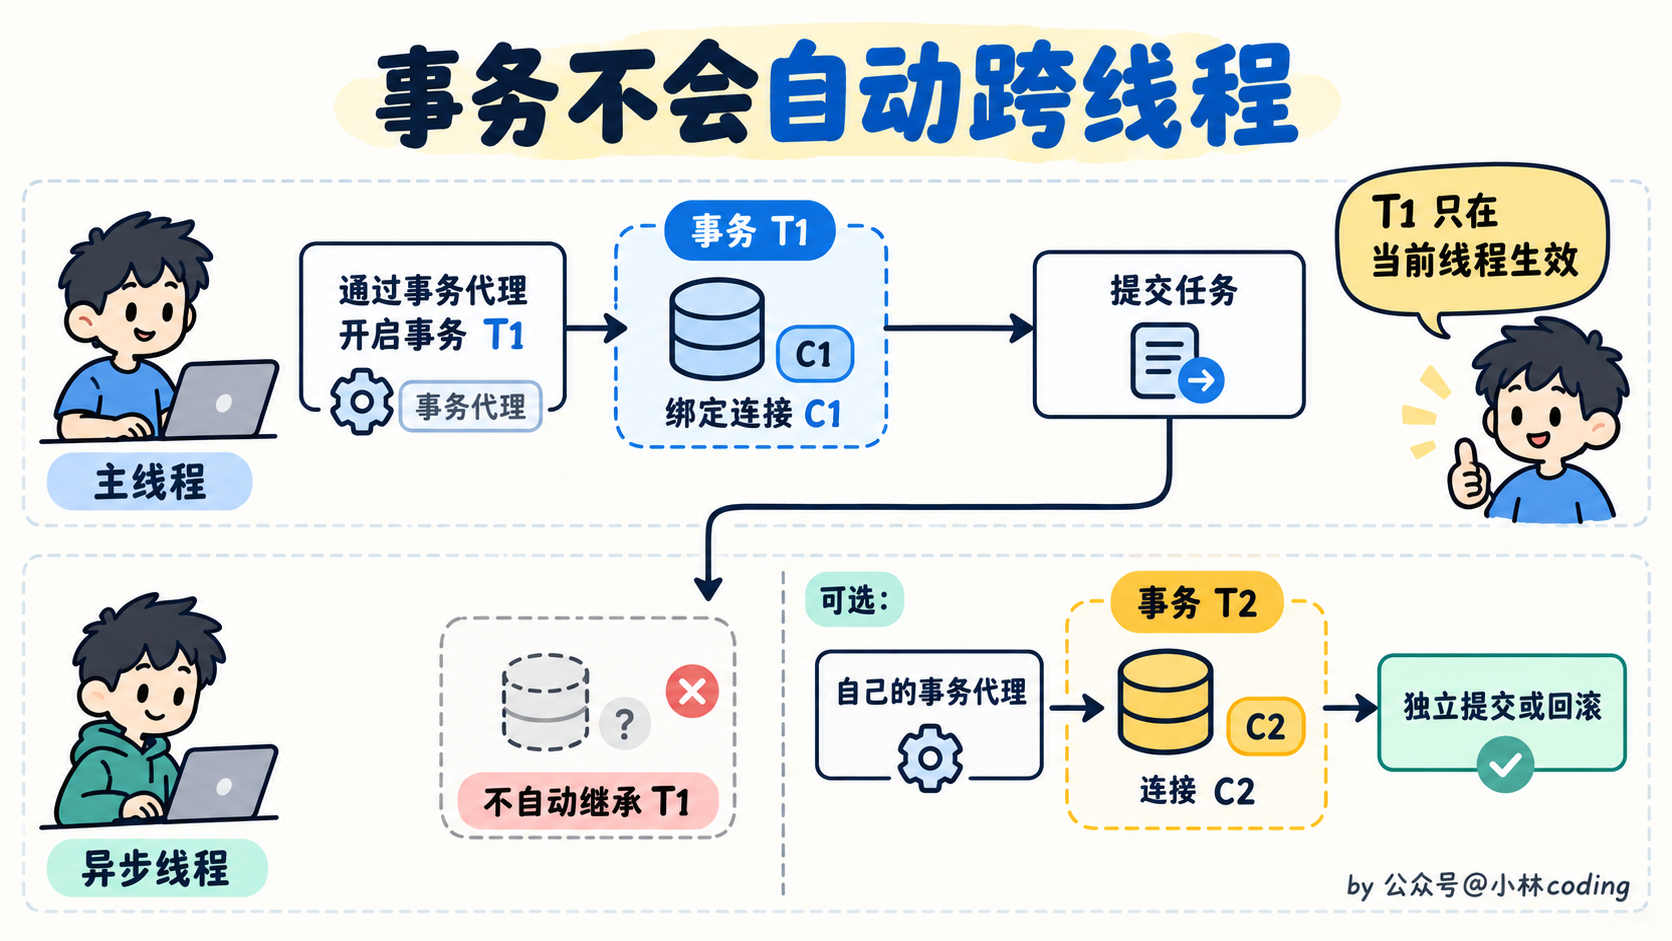
还有一个容易漏掉的点:在 @PostConstruct 中依赖当前 Bean 的事务代理通常不可靠,因为此时代理可能还没有准备好。需要启动时执行业务事务,可以在容器准备好后,通过另一个 Bean 的代理调用。
# Spring的事务,使用this调用是否生效?
准确地说,被调用方法上的 @Transactional 不会因为 this 调用而生效,但它里面的数据库操作可能仍然处在外层已有的事务中。
比如下面这个例子:
@Service
public class OrderService {
    @Transactional
    public void createOrder() {
        this.saveLog();
    }

    @Transactional(propagation = Propagation.REQUIRES_NEW)
    public void saveLog() {
        // 保存日志
    }
}
如果外部通过代理调用 createOrder(),外层事务已经开启。接着 this.saveLog() 直接调用目标对象,不会应用 saveLog() 上的 REQUIRES_NEW。如果日志操作使用同一事务管理器管理的数据源,它仍然参与外层事务,不会独立提交。
如果 createOrder() 本身也没有事务,那么这次内部调用就不会因为 saveLog() 上的注解自动开启事务。
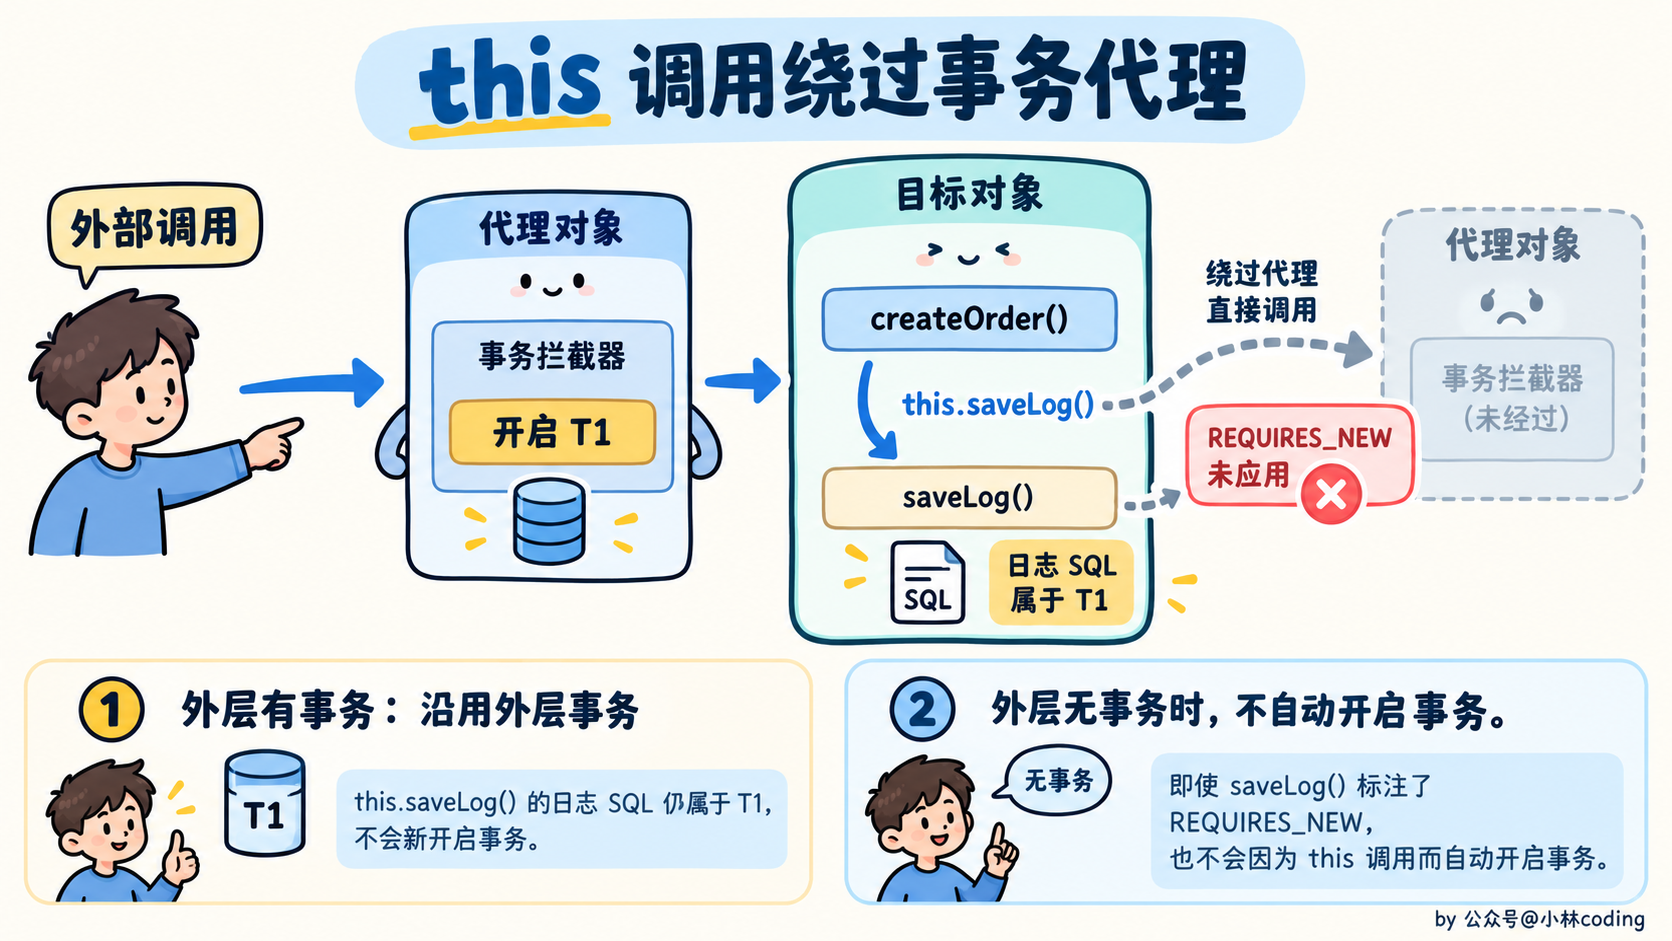
原因是 Spring 声明式事务默认通过 AOP 代理实现,只有经过代理的调用才会进入事务拦截器。常见的处理方式是把需要独立事务的方法拆到另一个 Service,通过注入的 Bean 调用;如果需要在一个方法里明确控制事务边界,也可以使用 TransactionTemplate。
# Spring声明式事务的实现原理是什么?
Spring 声明式事务的核心是 AOP 代理 + 事务拦截器 + 事务管理器。@Transactional 负责描述事务规则,真正控制提交和回滚的是事务管理器。
以常见的 JDBC 本地事务为例,执行过程大致是:
- 调用方通过代理对象调用事务方法,进入
TransactionInterceptor。 - 拦截器读取传播行为、隔离级别、超时时间、回滚规则等配置,交给
PlatformTransactionManager获取事务。 - 事务管理器根据传播行为,决定新建事务、加入已有事务,还是挂起事务。新建 JDBC 事务时,会获取连接、关闭自动提交,并把相关资源绑定到当前线程。
- 执行业务方法。
JdbcTemplate、MyBatis-Spring 等组件可以获取当前事务绑定的连接,让相关 SQL 处在同一个事务里。 - 方法正常返回时尝试提交;抛出异常时根据回滚规则决定回滚还是提交。最后清理线程绑定的资源,并按需要恢复被挂起的事务。
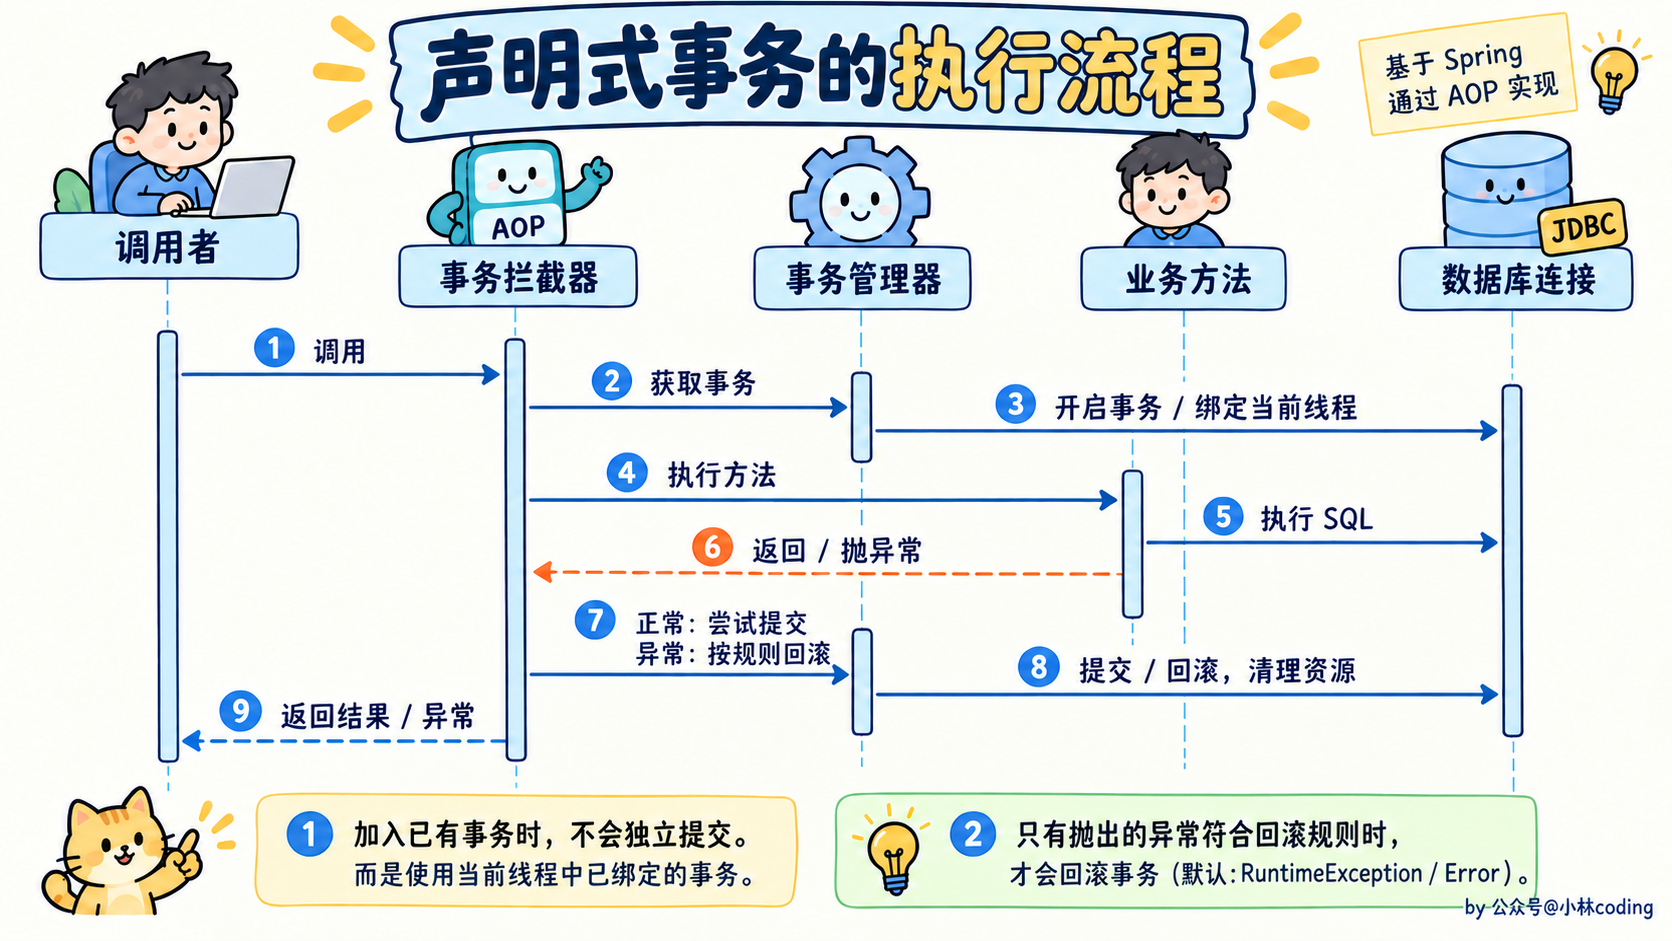
所以,Spring 负责协调事务,数据库负责执行底层的提交和回滚。一个普通的本地事务也不会自动把 HTTP 调用、Redis 写入和另一个数据库的操作都变成原子操作。
# Spring事务的传播行为有哪些?
传播行为解决的是:一个事务方法调用另一个事务方法时,后者怎么处理当前已经存在的事务。它和数据库的隔离级别不是一回事。
Spring 一共有七种传播行为:
| 传播行为 | 当前有事务 | 当前没有事务 |
|---|---|---|
| REQUIRED | 加入当前事务 | 新建事务,默认选项 |
| REQUIRES_NEW | 挂起当前事务,新建独立事务 | 新建事务 |
| NESTED | 在当前事务中建立保存点,形成嵌套事务 | 像 REQUIRED 一样新建事务 |
| SUPPORTS | 加入当前事务 | 以非事务方式执行 |
| NOT_SUPPORTED | 挂起当前事务,以非事务方式执行 | 以非事务方式执行 |
| MANDATORY | 加入当前事务 | 抛出异常 |
| NEVER | 抛出异常 | 以非事务方式执行 |
重点一般是前三种。比如下单和扣库存要一起成功或失败,通常用 REQUIRED;希望业务回滚后失败日志还能保存,可以通过另一个 Bean 的 REQUIRES_NEW 方法写日志。
不过传播行为生效仍然要经过事务代理,直接 this 调用不会切换事务。另外,是否支持事务挂起、保存点,也要看具体事务管理器。
# REQUIRES_NEW 和 NESTED 有什么区别?
它们都可以让内部操作在一定条件下单独回滚,但一个是独立的物理事务,一个是同一物理事务里的保存点。
REQUIRES_NEW:挂起外层事务,开启一个新事务。内层一旦提交,外层之后回滚,也不会撤销内层已经提交的数据。JDBC 场景通常还需要额外获取一条连接,要考虑连接池容量。NESTED:在外层事务里创建保存点。内层失败时可以回滚到保存点,外层如果捕获并处理异常,还可以继续执行;但外层最终回滚时,内层的修改也会一起回滚,内层成功不等于已经独立提交。
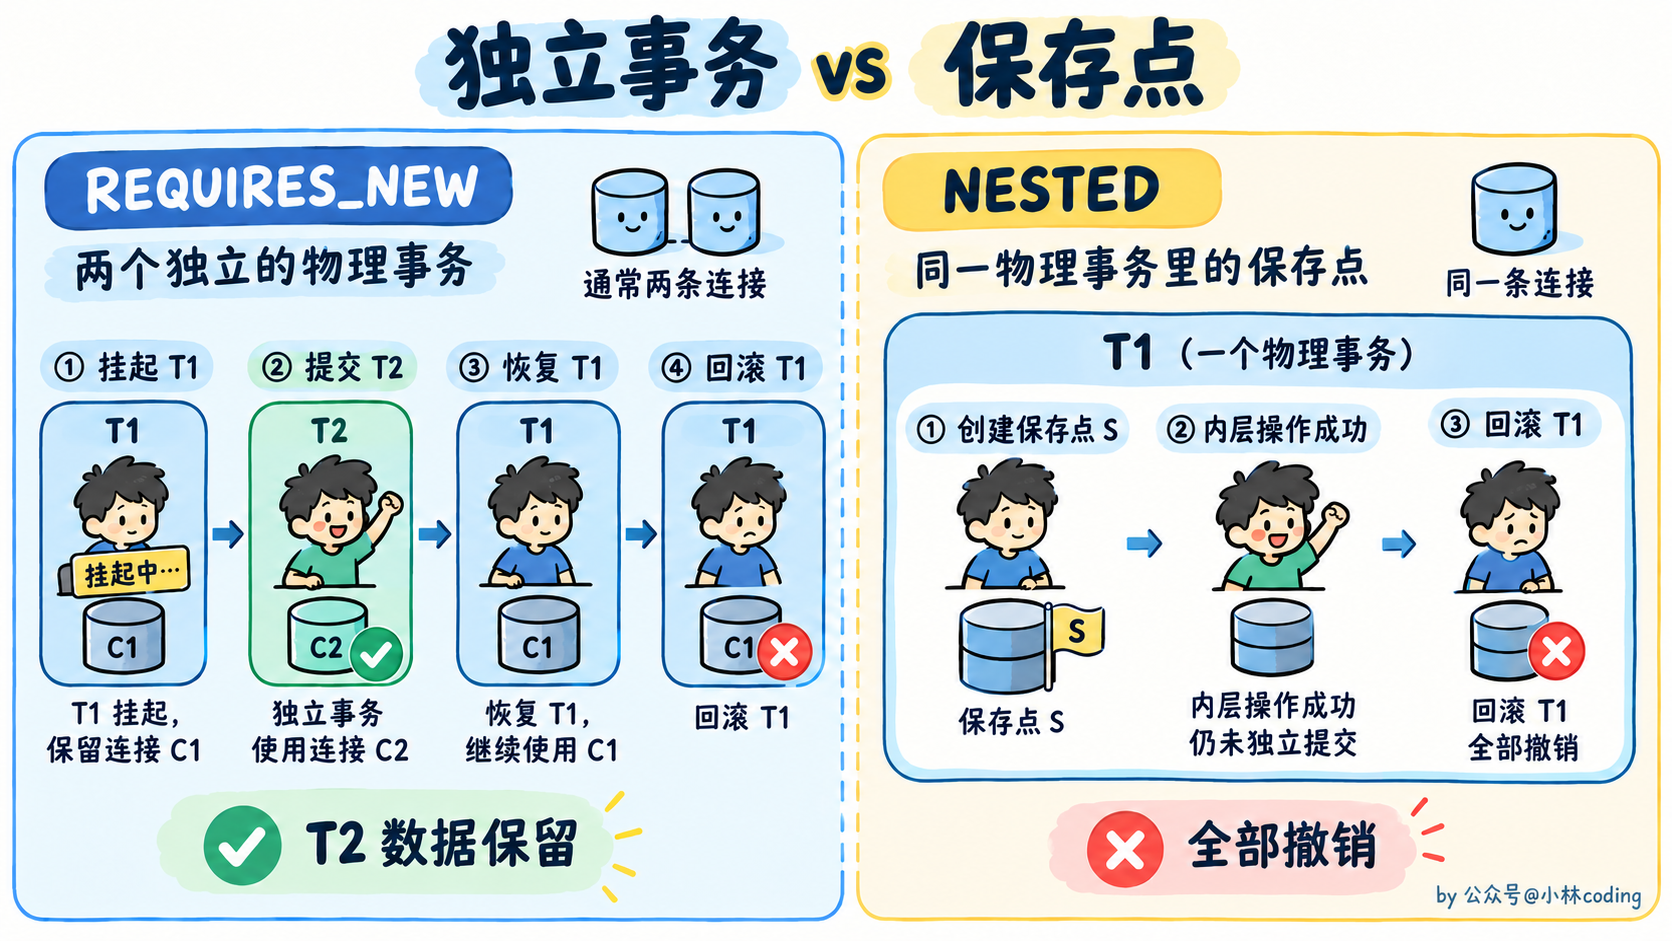
比如一个批量导入任务,某条记录失败后希望跳过它、继续处理其他记录,可以在支持保存点的事务管理器下考虑 NESTED。如果外层任务最终失败,整个批次仍然可以一起回滚。
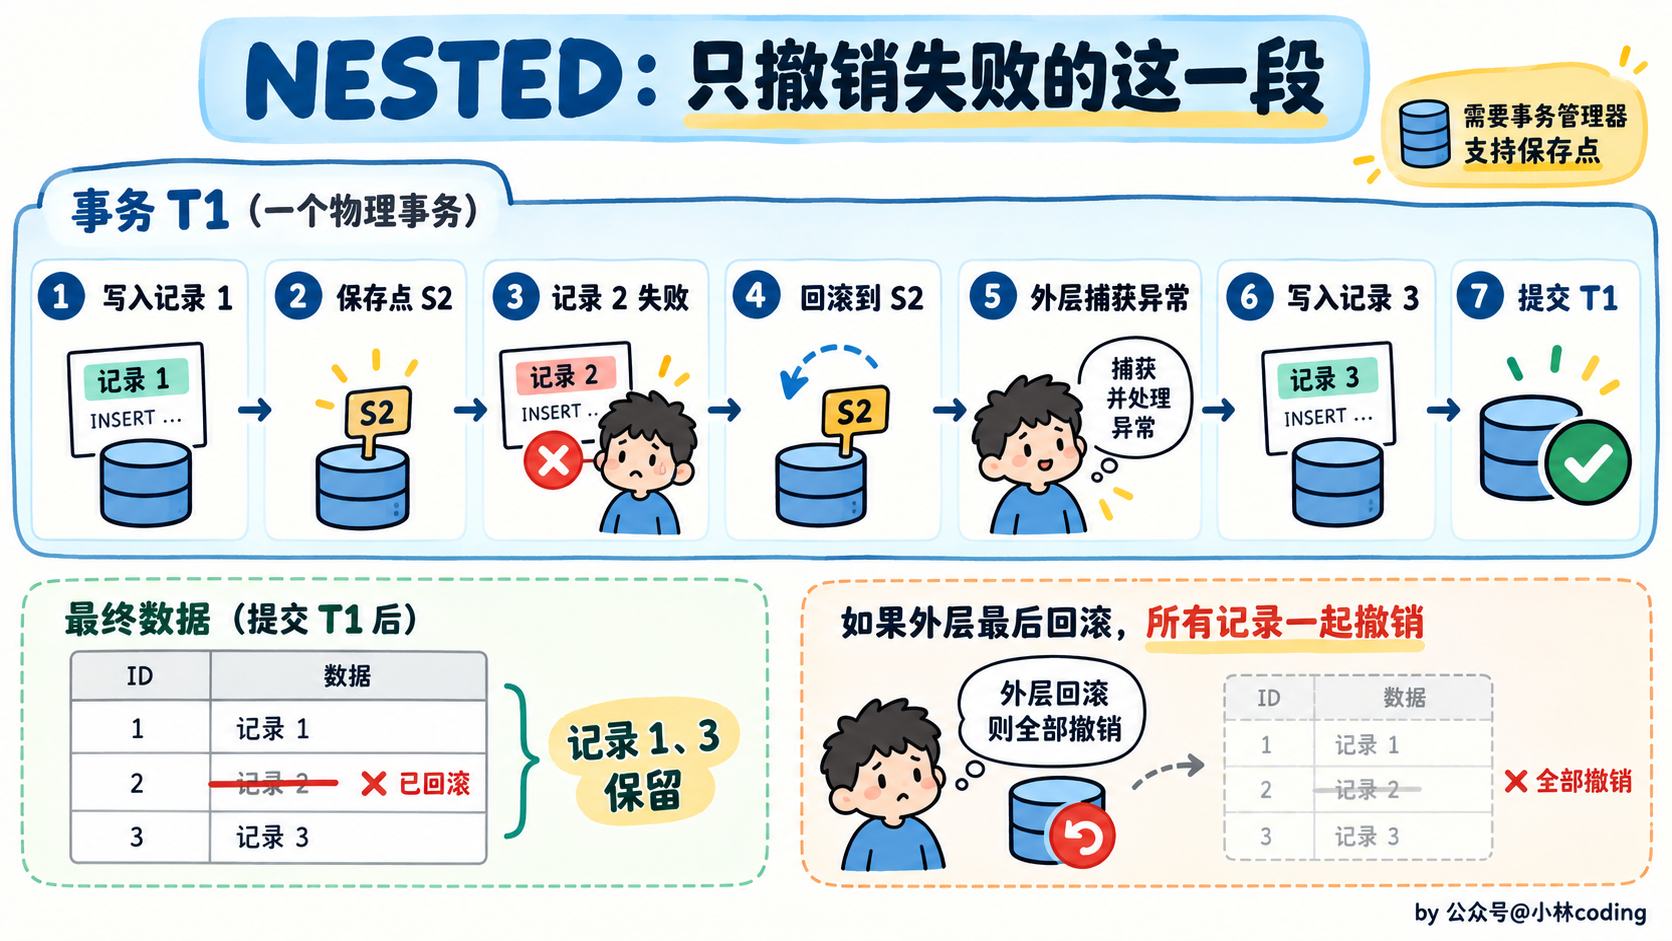
需要注意,不是所有事务管理器都支持 NESTED。它常见于支持 JDBC 保存点的场景,不能直接认为 JPA 或 JTA 也有完全相同的行为。
# 为什么捕获了异常,事务还是回滚了?
这通常和 rollback-only 标记有关。捕获异常不一定能把事务恢复成可提交状态。
比如 A 的事务方法通过 B 的代理调用 B 的事务方法,两者都用默认的 REQUIRED,实际上共享同一个物理事务:
- B 抛出运行时异常,异常经过 B 的事务拦截器,当前事务被标记为 rollback-only。
- A 捕获了这个异常,继续执行后面的代码。
- A 正常返回后尝试提交,但事务已经被标记为只能回滚,于是最终回滚,并可能抛出
UnexpectedRollbackException。
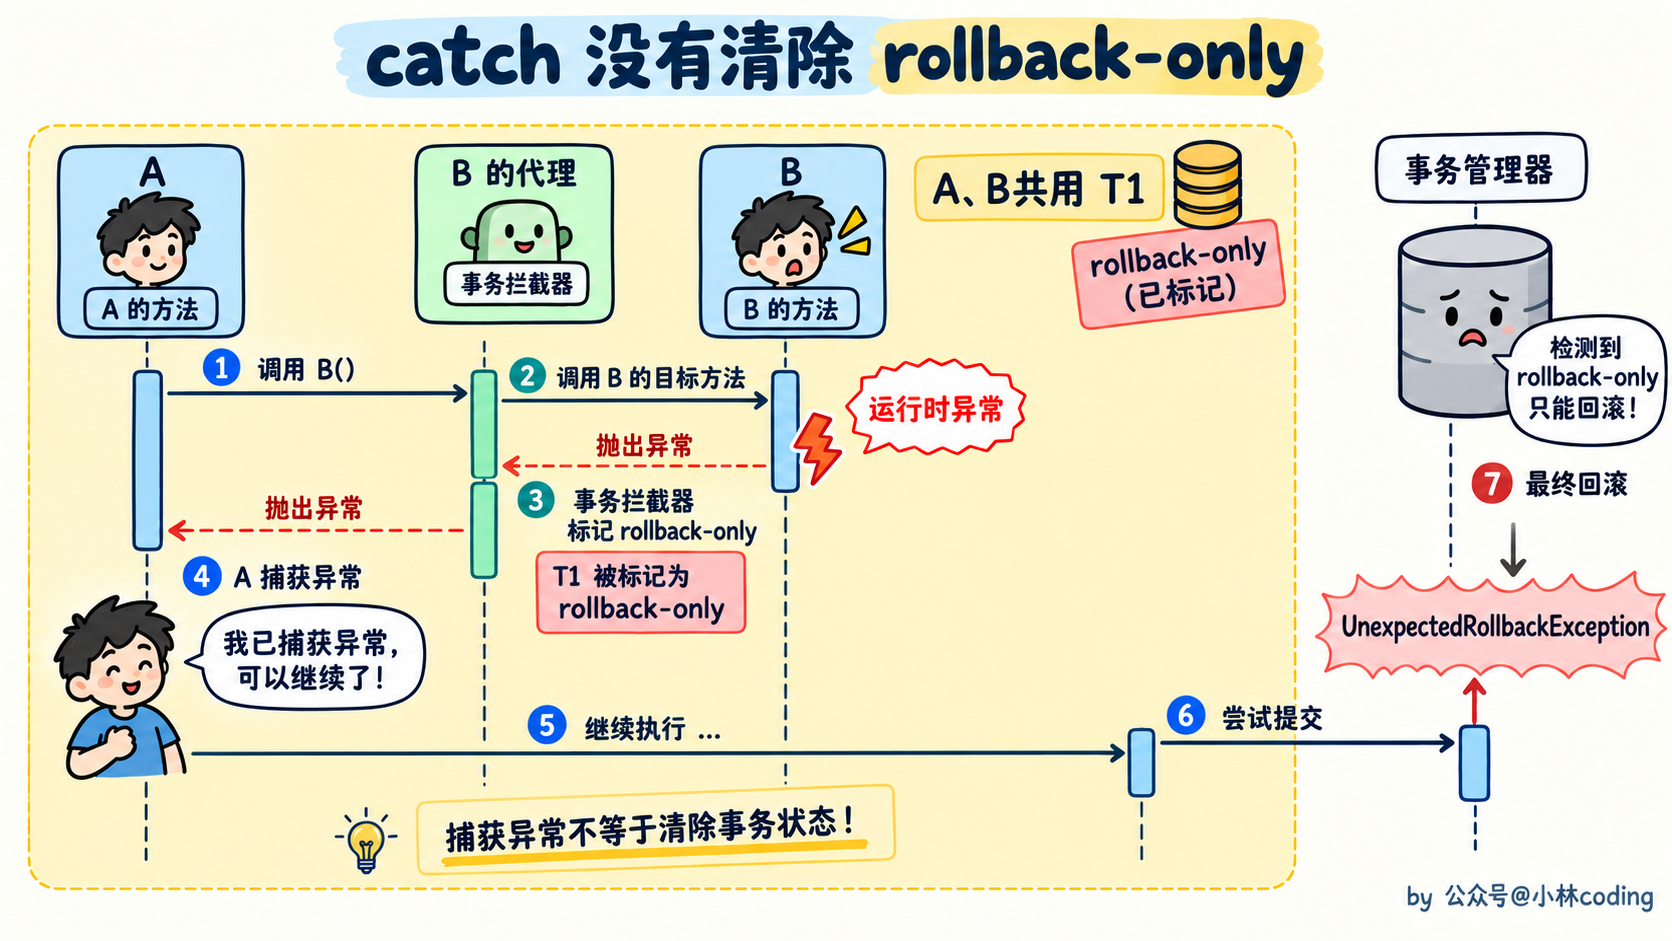
这和“在同一个事务方法内部捕获异常,异常从来没有经过事务拦截器”的情况不同。
实际处理要看业务语义:如果内外操作必须一起成功,就应该让错误向外传播;如果内层操作允许独立失败,可以考虑通过另一个 Bean 使用独立事务,或者在支持的场景下使用保存点,不能只靠加一个 try-catch。
# @Transactional里的隔离级别和readOnly有什么作用?
隔离级别控制并发事务之间能看到什么数据,readOnly 表达这个事务主要用于读取。
Spring 支持 DEFAULT、READ_UNCOMMITTED、READ_COMMITTED、REPEATABLE_READ 和 SERIALIZABLE。默认是 DEFAULT,也就是使用底层数据库的默认隔离级别,Spring 不会统一把所有数据库改成某一种级别。具体能避免哪些并发问题,还要结合数据库的实现来看。
readOnly = true 通常是给事务管理器、JDBC 驱动或 ORM 的提示,用于可能的优化。它不等于所有情况下都会禁止写入,是否强制只读取决于事务管理器和数据库的配置,因此不能拿它当权限控制。
还有一点,隔离级别等配置主要在新建事务时生效。如果一个 REQUIRED 方法加入已有事务,通常沿用外层事务的配置,不会因为内层写了另一个隔离级别就重新创建事务。
# Bean的生命周期说一下?
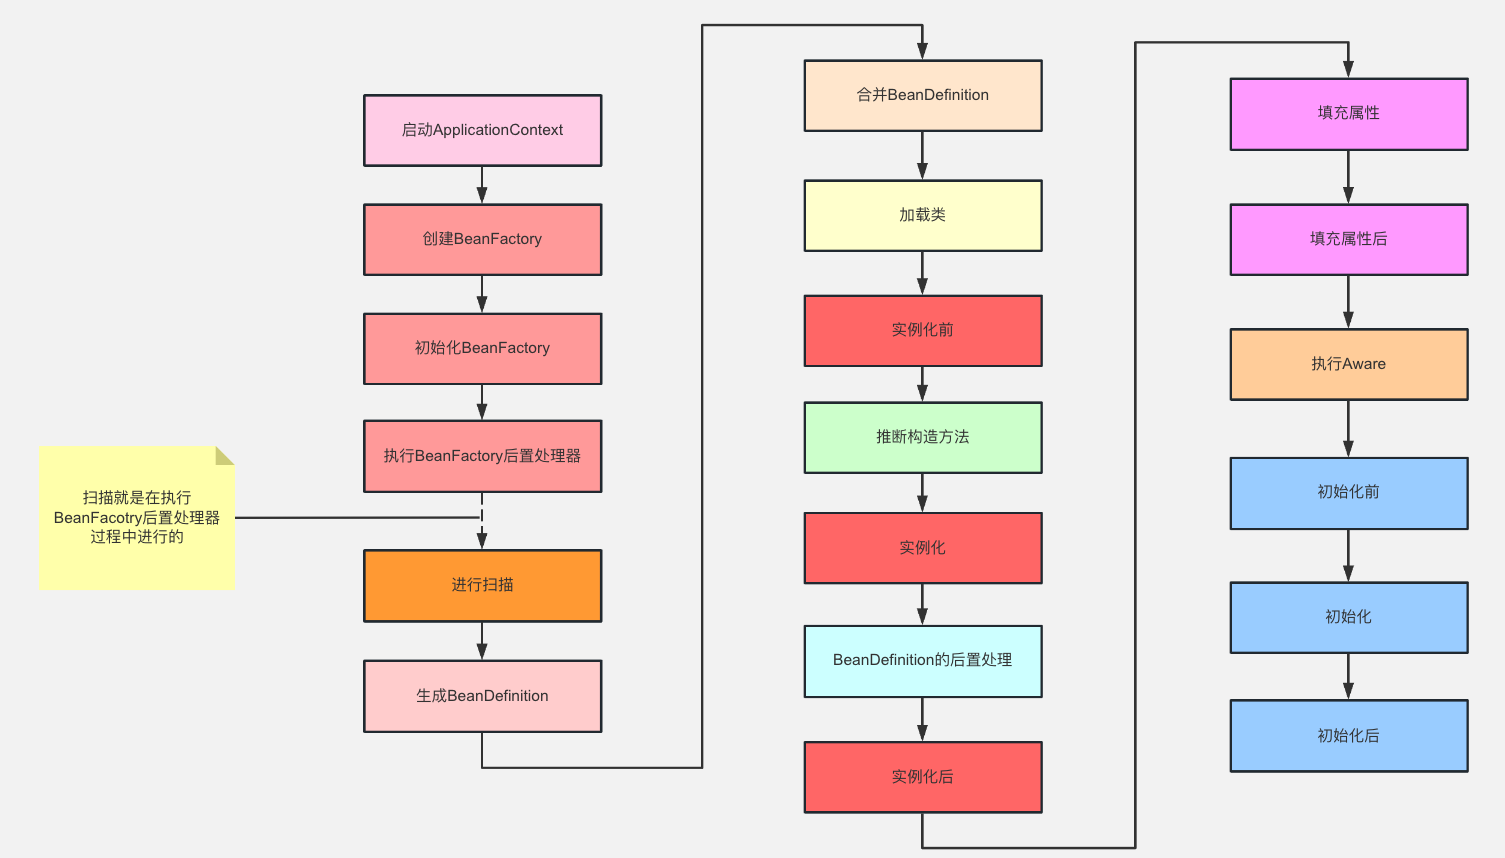
我一般按 实例化 → 属性填充 → 初始化 → 使用 → 销毁 这条主线来回答,再把扩展点放进去。
以容器正常创建一个普通 Bean 为例:
- 实例化:根据 BeanDefinition,通过构造器或工厂方法创建对象。这里只是对象有了,不代表依赖已经注入。
- 属性填充:解析依赖、设置属性,
@Autowired等注入也在相关后置处理器的参与下完成。 - Aware 回调:如果实现了
BeanNameAware、BeanFactoryAware等接口,容器把 Bean 名、BeanFactory 等信息传进来。ApplicationContextAware则由相应的后置处理器处理。 - 初始化前处理:容器调用已注册的 BeanPostProcessor 的
postProcessBeforeInitialization()。@PostConstruct方法通常也由这一阶段的相关处理器调用。 - 初始化方法:先执行
InitializingBean.afterPropertiesSet(),再执行配置的init-method或@Bean(initMethod = "...")方法。 - 初始化后处理:调用 BeanPostProcessor 的
postProcessAfterInitialization()。常见的 AOP 代理就是在这里创建,最终交给调用方的对象可能已经是代理对象。 - 使用 Bean:单例 Bean 通常会进入单例缓存,后续获取时复用。
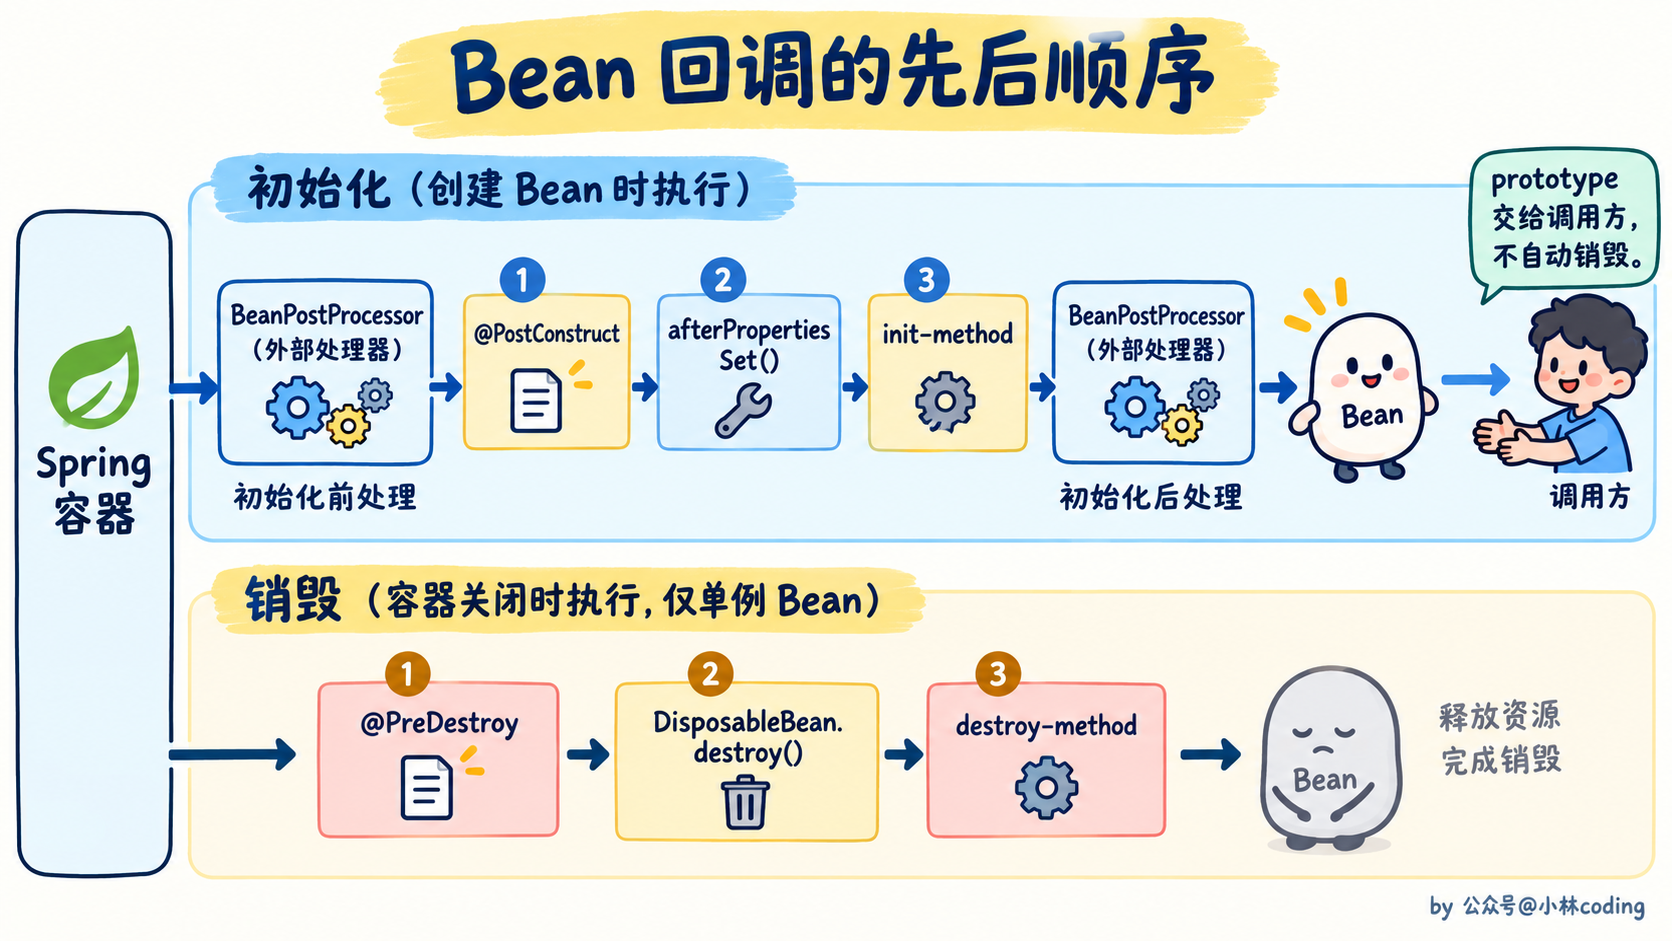
- 销毁:容器正常关闭时,执行单例 Bean 的销毁回调,一般依次是
@PreDestroy、DisposableBean.destroy()、自定义destroy-method。
这里有个容易说错的地方:不是当前 Bean 必须实现 BeanPostProcessor,才会执行前后处理。BeanPostProcessor 是容器里单独注册的一组处理器,它们负责处理其他符合条件的 Bean。
如果同一个 Bean 配置了不同的初始化回调方法,顺序通常是:@PostConstruct → afterPropertiesSet() → 自定义初始化方法。另外,prototype Bean 创建时也会执行初始化流程,但容器不会自动管理它后续的销毁。
上面说的是常规流程。循环依赖可能提前暴露引用,实例化前的某些后置处理器也可能直接返回代理对象,所以看源码时还会遇到提前返回的分支。
# Bean是否单例?
Spring Bean 默认是单例,但这个单例的范围是“同一个容器中的同一个 Bean 定义”,不是整个 JVM 只有一个实例。
比如同一个类注册成两个不同的 Bean 定义,容器可以创建两个实例;不同 ApplicationContext 里也可以各有自己的实例。这和把构造方法私有化、用静态字段保存唯一对象的单例写法不同。
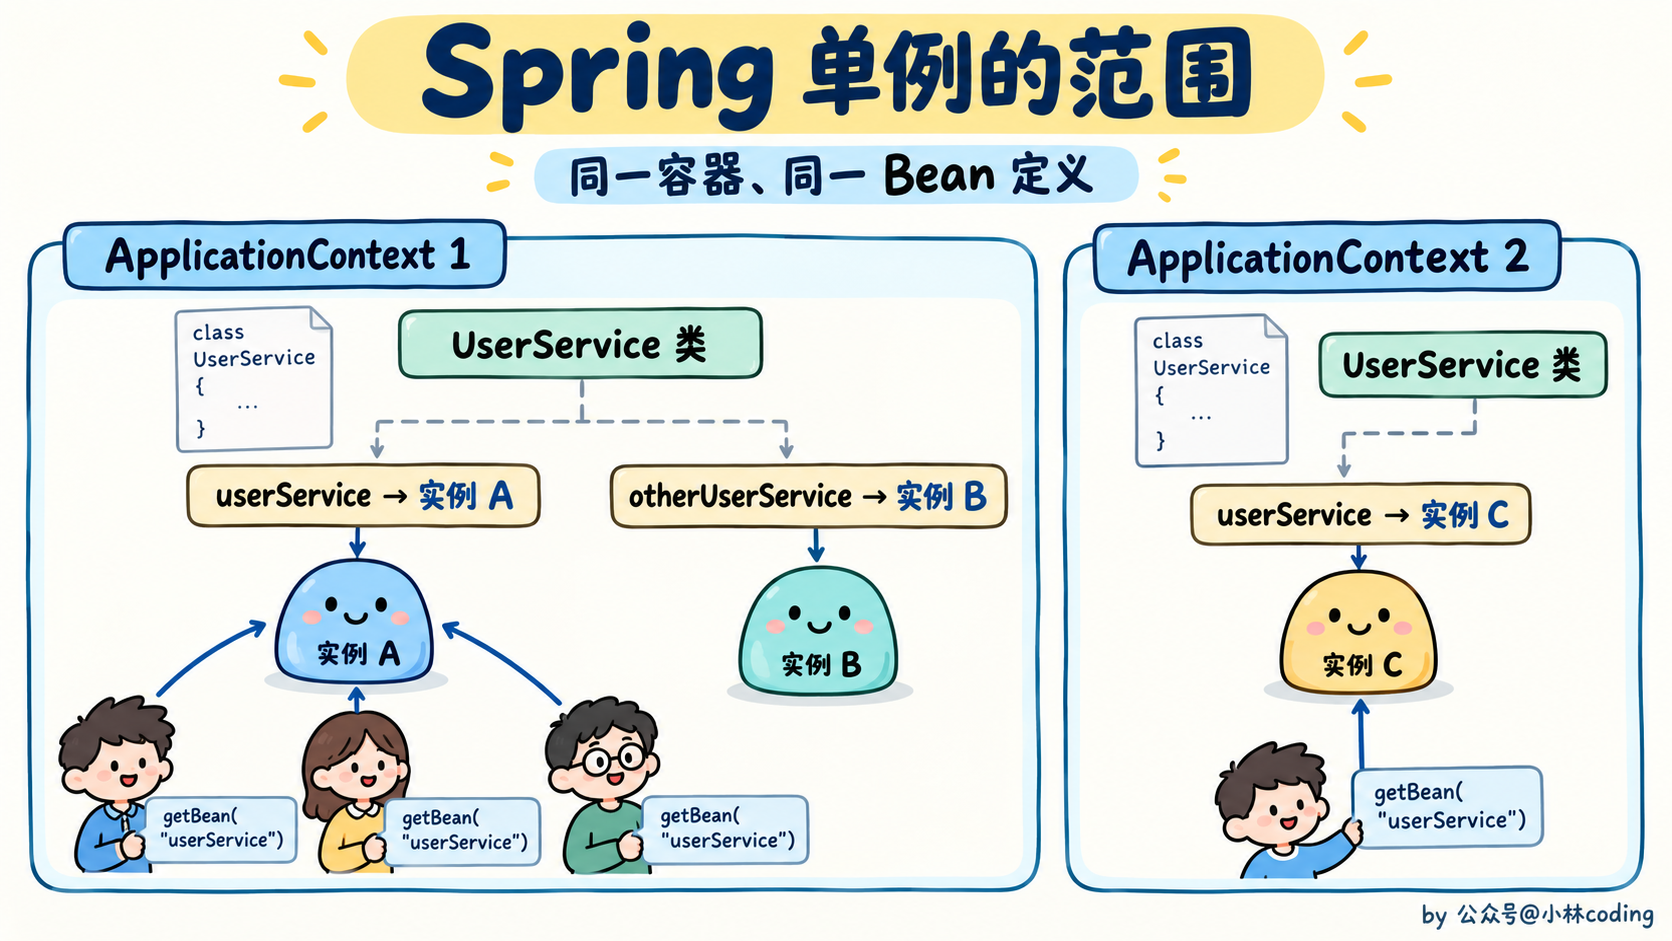
如果把作用域设置为 prototype,每次向容器请求这个 Bean 时,通常都会创建一个新对象。这里的“请求”是获取 Bean,不是指每个 HTTP 请求都会自动创建一个。
还要区分单例和线程安全:单例只保证实例复用,不保证并发访问安全。Service、DAO 通常可以用单例,是因为它们一般不把每个请求的可变数据保存在成员变量中;不可变对象也通常适合共享,而需要独立状态的对象才要考虑其他作用域。
# Bean的单例和非单例,生命周期是否一样
创建和初始化的主流程相同,主要区别是创建时机和销毁管理。对于单例 Bean,Spring 通常管理完整生命周期;对于 prototype Bean,Spring 创建并初始化后交给调用方,就不再自动跟踪它的销毁。这里的“非单例”特指 prototype,request、session 等作用域有各自的清理机制。
具体区别如下:
| 阶段 | 单例(Singleton) | 非单例(如Prototype) |
|---|---|---|
| 创建时机 | 容器启动时创建(或首次请求时,取决于配置)。 | 每次请求时创建新实例。 |
| 初始化流程 | 完整执行生命周期流程(属性注入、Aware接口、初始化方法等)。 | 每次创建新实例时都会完整执行生命周期流程(仅到初始化完成)。 |
| 销毁时机 | 容器关闭时销毁,触发DisposableBean或destroy-method。 | 容器不管理销毁,需由调用者自行释放资源(Spring不跟踪实例)。 |
| 内存占用 | 单实例常驻内存,高效但需注意线程安全。 | 每次请求生成新实例,内存开销较大,需手动管理资源释放。 |
| 适用场景 | 无状态服务(如Service、DAO层)。 | 每次获取时需要独立状态的临时对象。 |
# Spring bean的作用域有哪些?
Spring框架中的Bean作用域(Scope)定义了Bean的生命周期和可见性。不同的作用域影响着Spring容器如何管理这些Bean的实例,包括它们如何被创建、如何被销毁以及它们是否可以被多个用户共享。
Spring支持几种不同的作用域,以满足不同的应用场景需求。以下是一些主要的Bean作用域:
- Singleton(单例):默认作用域,同一个容器中的同一个 Bean 定义只创建一个共享实例。
- Prototype(原型):每次向容器请求该 Bean 时创建新实例,适用于需要独立状态的临时对象。它不等同于每个 HTTP 请求一个实例。
- Request(请求):每个 HTTP 请求都会创建一个新的 Bean 实例。仅在 Spring Web 应用程序中有效,每个 HTTP 请求都会创建一个新的 Bean 实例,适用于 Web 应用中需求局部性的 Bean。
- Session(会话):Session 范围内只会创建一个 Bean 实例。该 Bean 实例在用户会话范围内共享,仅在 Spring Web 应用程序中有效,适用于与用户会话相关的 Bean。
- Application:当前 ServletContext 中只存在一个 Bean 实例。仅在 Spring Web 应用程序中有效,该 Bean 实例在整个 ServletContext 范围内共享,适用于应用程序范围内共享的 Bean。
- WebSocket(Web套接字):在 WebSocket 范围内只存在一个 Bean 实例。仅在支持 WebSocket 的应用程序中有效,该 Bean 实例在 WebSocket 会话范围内共享,适用于 WebSocket 会话范围内共享的 Bean。
- Custom scopes(自定义作用域):Spring 允许开发者定义自定义的作用域,通过实现 Scope 接口来创建新的 Bean 作用域。
在Spring配置文件中,可以通过<bean>标签的scope属性来指定Bean的作用域。例如:
<bean id="myBean" class="com.example.MyBeanClass" scope="singleton"/>
在Spring Boot或基于Java的配置中,可以通过@Scope注解来指定Bean的作用域。例如:
@Bean
@Scope("prototype")
public MyBeanClass myBean() {
    return new MyBeanClass();
}
# Spring单例Bean是线程安全的吗?
不一定,Spring 不会因为 Bean 是单例,就自动给它的方法加锁。
比如下面这种写法就有问题:
@Service
public class UserService {
    private Long currentUserId;

    public void handle(Long userId) {
        this.currentUserId = userId;
        // 后续业务使用 currentUserId
    }
}
多个请求共享同一个 UserService,线程 A 刚写入用户 1,线程 B 就可能改成用户 2,后面的业务就会读到错误的用户信息。
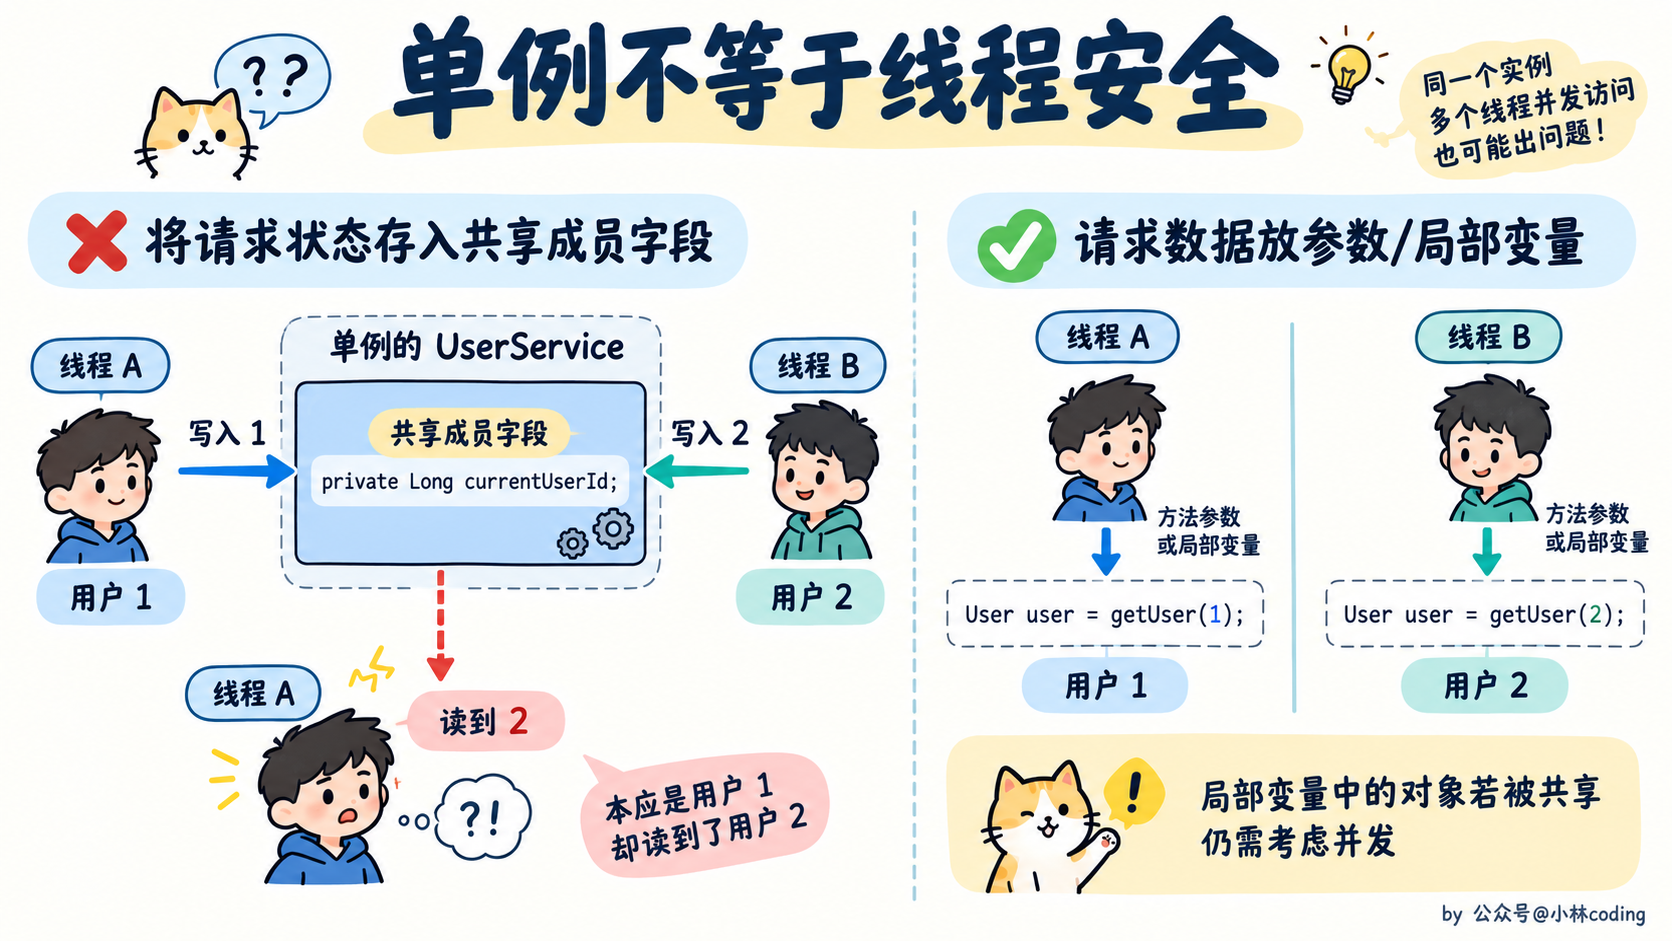
一般的处理思路是:
- 请求数据放在方法参数或局部变量里,避免存在单例 Bean 的可变成员变量中。
- 确实需要共享状态时,使用合适的锁、原子类或并发容器,而且要考虑整个操作是否需要原子性,不能只看某一个字段。
- 状态属于一次请求或一个会话时,可以考虑 request、session 作用域。但同一个 session 也可能被多个请求并发访问,不等于天然线程安全。
ThreadLocal 可以隔离线程数据,但线程池会复用线程,使用后要清理,也不能把它当成所有并发问题的通用解法。
# 单例Bean里注入prototype Bean,每次使用都会创建新对象吗?
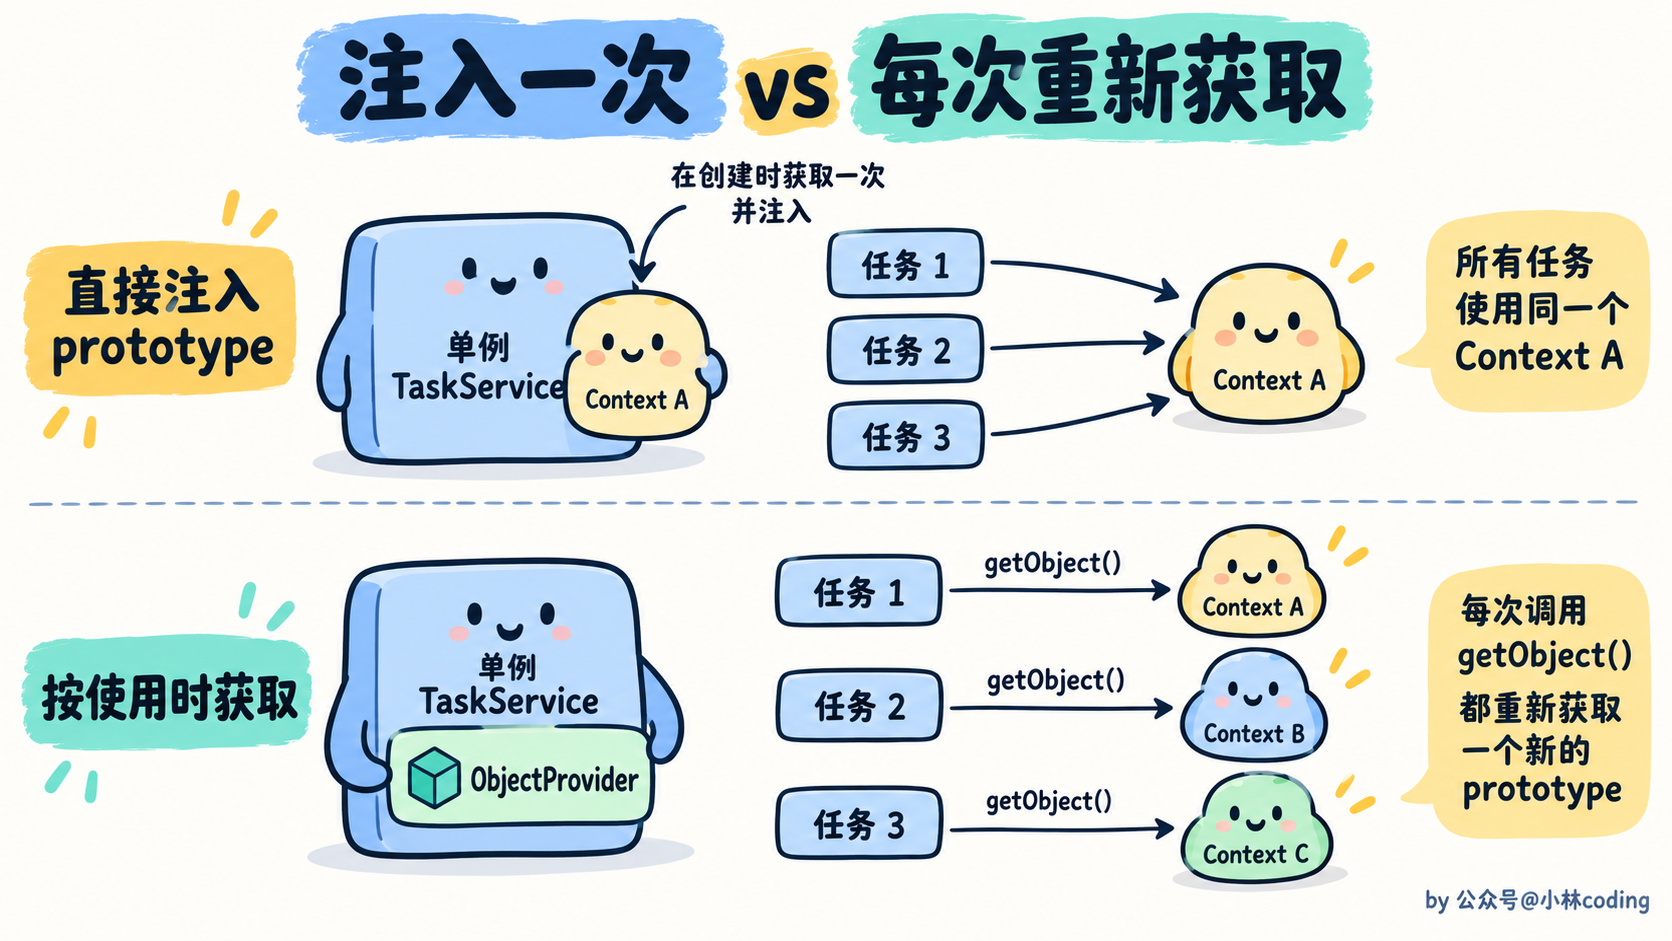
直接注入不会。单例 Bean 通常只创建一次,依赖也在创建时解析一次,所以它会一直持有当时注入的那个 prototype 对象。
如果希望每次使用都获取新实例,可以注入 ObjectProvider,需要时再向容器获取:
@Component
@Scope("prototype")
public class TaskContext {
    // 每个任务独立使用的状态
}

@Service
public class TaskService {
    private final ObjectProvider<TaskContext> contexts;

    public TaskService(ObjectProvider<TaskContext> contexts) {
        this.contexts = contexts;
    }

    public void execute() {
        TaskContext context = contexts.getObject();
        // 本次任务使用新获取的 context
    }
}
每次 getObject() 都重新解析这个 prototype Bean。也可以考虑 @Lookup 或作用域代理,但要理解它们具体的获取时机;如果对象占用了外部资源,使用完仍然需要自己做好清理。
# Spring容器里存的是什么?
不只是 Bean 对象,还包括Bean 的定义信息,以及创建和管理 Bean 所需的基础设施。
- BeanDefinition:描述 Bean 怎么创建,比如类型、作用域、构造参数、属性值、初始化方法等,可以理解为对象的“生产说明书”。
- Bean 实例:已经创建的单例对象保存在单例缓存中,对外提供的可能是原始对象,也可能是 AOP 代理。prototype Bean 则不会像单例一样长期缓存在这里。
- 相关元数据和扩展组件:比如 Bean 名与别名、后置处理器、依赖关系,以及 ApplicationContext 提供的事件、环境配置等能力。
所以容器启动时不是先把所有对象都放进一个 Map 就完了,而是先整理 BeanDefinition,再根据作用域、依赖关系和加载时机创建对象。
# BeanFactory 和 ApplicationContext 有什么区别?
BeanFactory 是 IoC 容器的基础接口,ApplicationContext 在它的基础上提供了更完整的应用上下文能力。
BeanFactory 主要解决 Bean 的创建、获取和依赖管理。ApplicationContext 除了这些,还提供事件发布、国际化、资源访问、环境配置等功能,并在刷新上下文时自动发现、注册和执行相关后置处理器。
创建时机上也经常被问到:普通 BeanFactory 的 Bean 通常按需创建;ApplicationContext 刷新时,通常会提前实例化非懒加载的单例 Bean,让依赖或配置错误尽早暴露。这不代表 ApplicationContext 会启动时创建所有 Bean,懒加载单例和 prototype 仍然有不同的创建时机。
实际业务开发里我们通常使用 ApplicationContext,Spring Boot 启动时也会创建对应类型的 ApplicationContext。
# BeanFactory 和 FactoryBean 有什么区别?
名字很像,但职责完全不同:BeanFactory 是管理 Bean 的容器接口,FactoryBean 是让某个 Bean 负责生产另一个对象的扩展接口。
FactoryBean<T> 主要有三个方法:
getObject():返回它生产的对象。getObjectType():告诉容器生产对象的类型。isSingleton():描述生产对象是否按单例方式处理。
比如 MyBatis 和 Spring 整合时,MapperFactoryBean 就可以负责生产 Mapper 接口的代理对象,调用方拿到的是 Mapper 代理。
如果容器中有一个名为 userMapper 的 FactoryBean,调用 getBean("userMapper") 默认拿到它生产的对象;调用 getBean("&userMapper"),才是拿到 FactoryBean 本身。
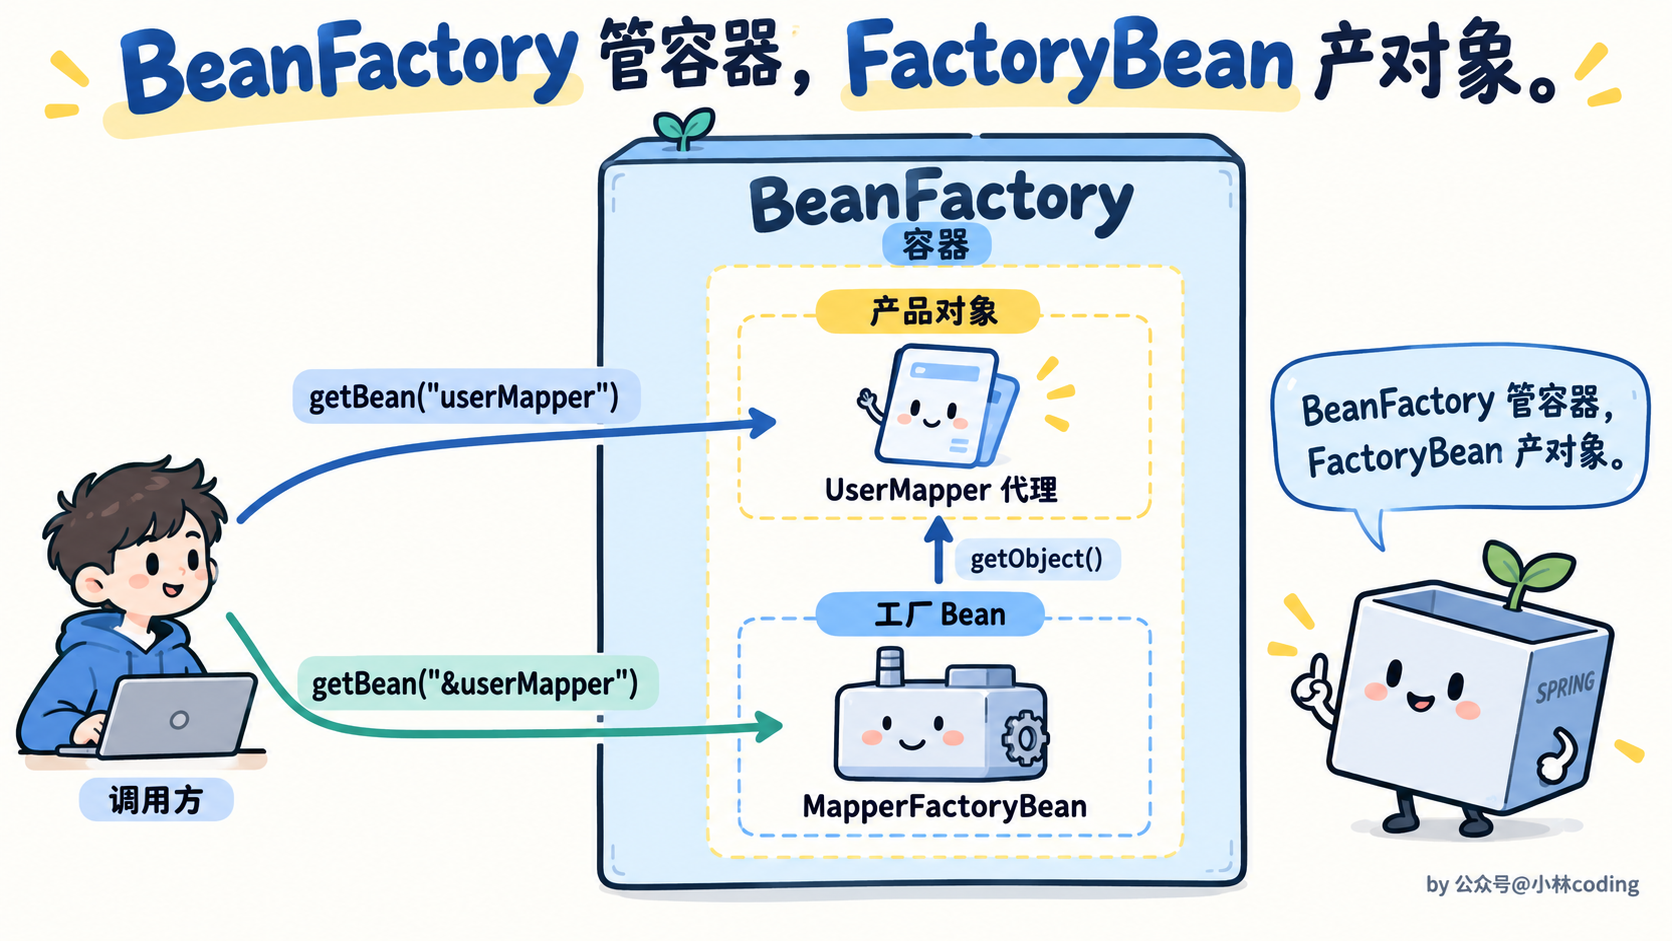
这里还要注意,FactoryBean 自身的作用域和它生产对象的单例语义是两个层面的事情,不能看到 FactoryBean 是单例,就直接认为它每次生产的对象也一定是单例。
# 在Spring中,在bean加载/销毁前后,如果想实现某些逻辑,可以怎么做
在Spring框架中,如果你希望在Bean加载(即实例化、属性赋值、初始化等过程完成后)或销毁前后执行某些逻辑,你可以使用Spring的生命周期回调接口或注解。这些接口和注解允许你定义在Bean生命周期的关键点执行的代码。
使用init-method和destroy-method
在XML配置中,你可以通过init-method和destroy-method属性来指定Bean初始化后和销毁前需要调用的方法。
<bean id="myBean" class="com.example.MyBeanClass"
      init-method="init" destroy-method="destroy"/>
然后,在你的Bean类中实现这些方法:
public class MyBeanClass {

    public void init() {
        // 初始化逻辑
    }

    public void destroy() {
        // 销毁逻辑
    }
}
实现InitializingBean和DisposableBean接口
你的Bean类可以实现org.springframework.beans.factory.InitializingBean和org.springframework.beans.factory.DisposableBean接口,并分别实现afterPropertiesSet和destroy方法。
import org.springframework.beans.factory.DisposableBean;
import org.springframework.beans.factory.InitializingBean;

public class MyBeanClass implements InitializingBean, DisposableBean {

    @Override
    public void afterPropertiesSet() throws Exception {
        // 初始化逻辑
    }

    @Override
    public void destroy() throws Exception {
        // 销毁逻辑
    }
}
使用@PostConstruct和@PreDestroy注解
下面以 Spring Boot 3.x 起使用的 jakarta.annotation 为例;Spring Boot 2.x 常用的是 javax.annotation。
import jakarta.annotation.PostConstruct;
import jakarta.annotation.PreDestroy;

public class MyBeanClass {

    @PostConstruct
    public void init() {
        // 初始化逻辑
    }

    @PreDestroy
    public void destroy() {
        // 销毁逻辑
    }
}
使用@Bean注解的initMethod和destroyMethod属性
在基于Java的配置中,你还可以在@Bean注解中指定initMethod和destroyMethod属性。
@Configuration
public class AppConfig {

    @Bean(initMethod = "init", destroyMethod = "destroy")
    public MyBeanClass myBean() {
        return new MyBeanClass();
    }
}
# BeanFactoryPostProcessor 和 BeanPostProcessor 有什么区别?
区别主要是处理对象不同、介入时机不同。
- BeanFactoryPostProcessor:处理的是 Bean 的定义信息,在普通业务 Bean 实例化前介入,可以修改 BeanDefinition 中的属性、作用域等配置。如果还需要新增 Bean 定义,可以使用它的子接口
BeanDefinitionRegistryPostProcessor。 - BeanPostProcessor:处理的是已经创建出来的 Bean 实例,在初始化前后执行,可以检查、调整甚至替换对象。AOP 自动代理创建器就是这类扩展的典型应用。
比如想把某个 Bean 的作用域改成 prototype,应该修改 BeanDefinition;想在创建后的对象外面加代理,则适合用 BeanPostProcessor。
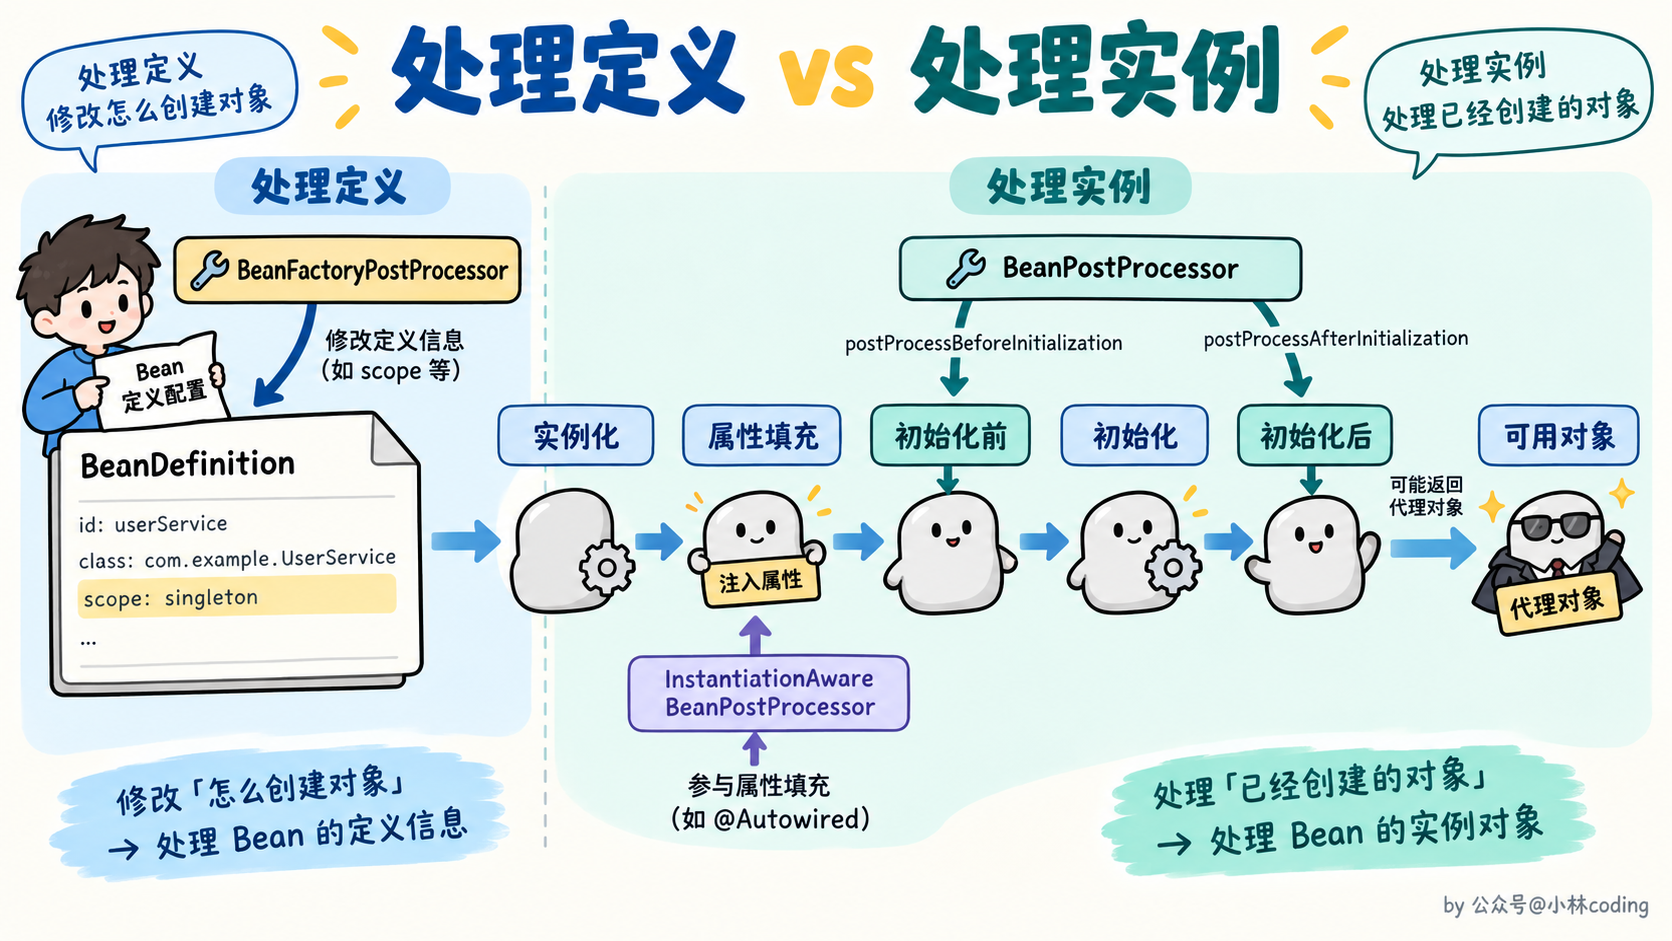
另外,@Autowired 的字段注入需要更早在属性填充阶段介入,使用的是 InstantiationAwareBeanPostProcessor 等扩展能力,不能把所有后置处理都理解成只发生在初始化之后。
面试里可以记住:前者修改“怎么创建对象”,后者处理“已经创建的对象”。
# Spring给我们提供了很多扩展点,这些有了解吗?
Spring框架提供了许多扩展点,使得开发者可以根据需求定制和扩展Spring的功能。以下是一些常用的扩展点:
- BeanFactoryPostProcessor:允许在Spring容器实例化bean之前修改bean的定义。常用于修改bean属性或改变bean的作用域。
- BeanPostProcessor:可以在bean实例化、配置以及初始化之后对其进行额外处理。常用于代理bean、修改bean属性等。
- PropertySource:用于定义不同的属性源,如文件、数据库等,以便在Spring应用中使用。
- ImportSelector和ImportBeanDefinitionRegistrar:用于根据条件动态注册bean定义,实现配置类的模块化。
- Spring MVC中的HandlerInterceptor:用于拦截处理请求,可以在请求处理前、处理中和处理后执行特定逻辑。
- Spring MVC中的ControllerAdvice:用于全局处理控制器的异常、数据绑定和数据校验。
- Spring Boot的自动配置:通过创建自定义的自动配置类,可以实现对框架和第三方库的自动配置。
- 自定义注解:创建自定义注解,用于实现特定功能或约定,如权限控制、日志记录等。
# SpringMVC
# MVC分层介绍一下
MVC全名是Model View Controller,是模型(model)-视图(view)-控制器(controller)的缩写,一种软件设计典范,用一种业务逻辑、数据、界面显示分离的方法组织代码,将业务逻辑聚集到一个部件里面,在改进和个性化定制界面及用户交互的同时,不需要重新编写业务逻辑。
- 视图(view): 为用户提供使用界面,与用户直接进行交互。
- 模型(model): 代表一个存取数据的对象或 JAVA POJO(Plain Old Java Object,简单java对象)。它也可以带有逻辑,主要用于承载数据,并对用户提交请求进行计算的模块。模型分为两类,一类称为数据承载 Bean,一类称为业务处理Bean。所谓数据承载 Bean 是指实体类(如:User类),专门为用户承载业务数据的;而业务处理 Bean 则是指Service 或 Dao 对象, 专门用于处理用户提交请求的。
- 控制器(controller): 用于将用户请求转发给相应的 Model 进行处理,并根据 Model 的计算结果向用户提供相应响应。它使视图与模型分离。
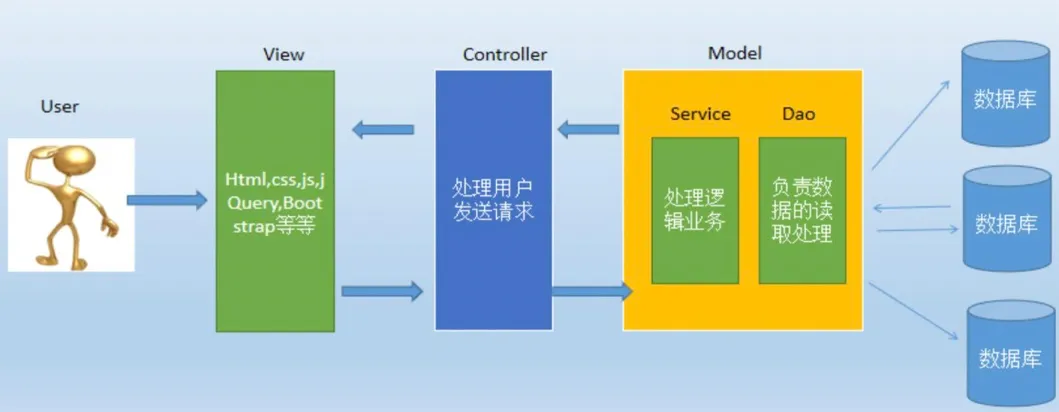
流程步骤:
- 用户通过View 页面向服务端提出请求,可以是表单请求、超链接请求、AJAX 请求等;
- 服务端 Controller 控制器接收到请求后对请求进行解析,找到相应的Model,对用户请求进行处理Model 处理;
- 将处理结果再交给 Controller(控制器其实只是起到了承上启下的作用);
- 根据处理结果找到要作为向客户端发回的响应View 页面,页面经渲染后发送给客户端。
# 了解SpringMVC的处理流程吗?
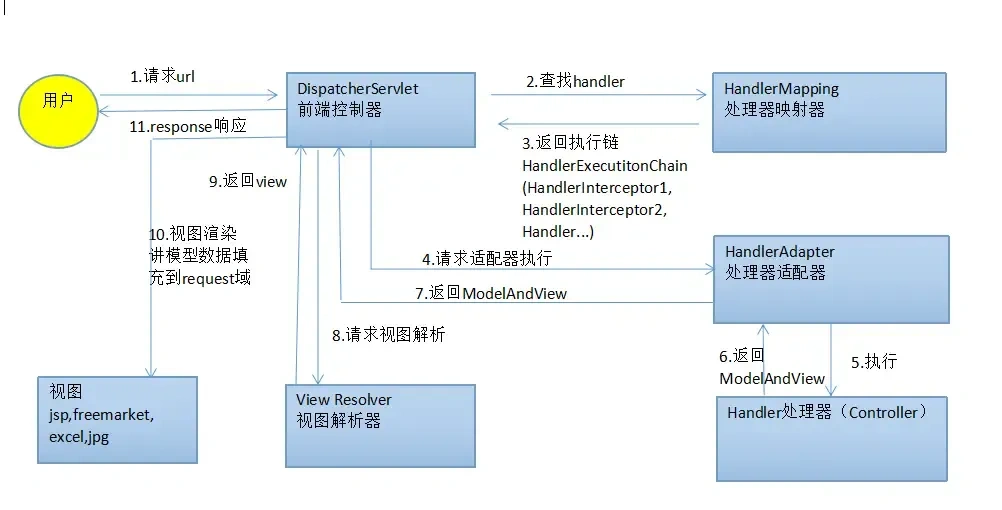
Spring MVC 的核心是 DispatcherServlet 统一接收请求,再把请求交给合适的处理器执行。
以一个普通的同步请求为例,流程大致如下:
- 请求进入 DispatcherServlet:如果配置了 Filter,请求会先经过相应的过滤器链。
- 查找处理器:DispatcherServlet 调用 HandlerMapping,根据 URL、请求方法等找到 Handler,并得到包含拦截器的 HandlerExecutionChain。注解式 Controller 中,Handler 通常是一个 HandlerMethod。
- 选择适配器:找到能执行这个 Handler 的 HandlerAdapter,比如执行注解式 Controller 的 RequestMappingHandlerAdapter。
- 执行前置拦截:按顺序调用拦截器的
preHandle(),如果返回 false,后续处理会中止。 - 处理参数并调用方法:HandlerAdapter 借助参数解析器、类型转换器、消息转换器等准备参数,按配置完成校验,再调用 Controller 方法。
- 处理返回值:如果返回逻辑视图名或 ModelAndView,就准备模型和视图;如果使用
@ResponseBody、@RestController或返回 ResponseEntity,则通过消息转换器把结果写入响应体。 - 完成响应:正常完成 HandlerAdapter 调用后执行
postHandle(),有视图时再解析和渲染视图,最后执行相应拦截器的afterCompletion()。
如果执行中抛出了异常,DispatcherServlet 会交给 HandlerExceptionResolver 体系处理,@ExceptionHandler 和 @ControllerAdvice 就在这套机制中发挥作用。
现在项目里经常是前后端分离,所以还要补一句:返回 JSON 的请求通常不会再走视图解析和页面渲染。而且响应体可能在 HandlerAdapter 执行期间就已经写出,不能指望在 postHandle() 里统一修改 JSON,适合的扩展点是 ResponseBodyAdvice。
# @Controller 和 @RestController 有什么区别?
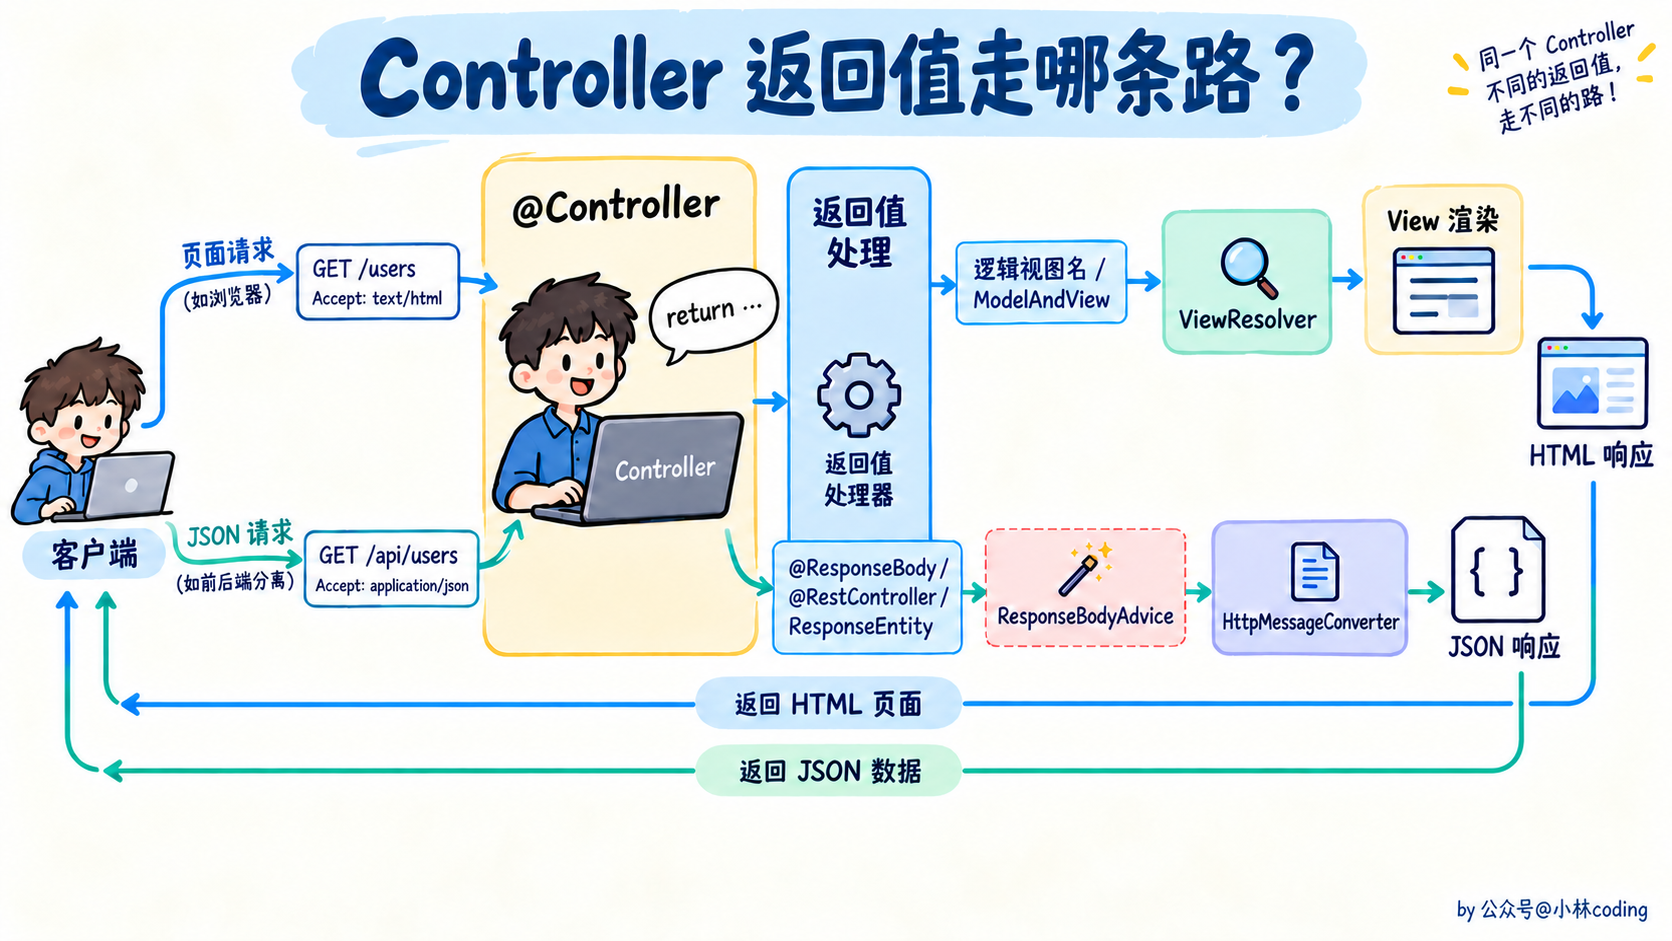
@RestController 相当于 @Controller 加上类级别的 @ResponseBody,主要区别是返回值怎么处理。
普通 @Controller 方法如果返回 String,通常会把它当成逻辑视图名,例如返回 "index",再由视图解析器找到页面。如果给这个方法加上 @ResponseBody,就会把返回值交给消息转换器写入响应体。
@RestController 则默认对类里的请求处理方法应用响应体语义,返回对象时常见的是由 Jackson 序列化成 JSON。但它不意味着所有返回值一定都是 JSON,返回字符串、字节数组等会由适用的消息转换器处理,还要结合媒体类型配置。
所以返回页面一般用 @Controller,前后端分离的接口一般用 @RestController。需要同时控制响应状态码、响应头和响应体时,可以返回 ResponseEntity。
# @RequestParam、@PathVariable 和 @RequestBody 有什么区别?
它们主要区别是参数从哪里来。
@RequestParam:读取查询参数或表单参数,比如/users?page=1中的 page,可以指定默认值和是否必填。@PathVariable:读取 URL 路径中的变量,比如/users/{id}中的 id。@RequestBody:读取 HTTP 请求体,由 HttpMessageConverter 根据 Content-Type 转换成 Java 对象,常用来接收 JSON。
比如修改用户信息:
@PutMapping("/users/{id}")
public void updateUser(@PathVariable("id") Long id,
                       @Valid @RequestBody UpdateUserRequest request) {
    // id 来自路径,request 来自 JSON 请求体
}
需要注意,@RequestBody 不是专门对应 POST,关键是请求体和消息转换规则。另外,绑定成功不等于校验通过,还需要结合 @Valid 或 @Validated 和字段上的约束注解;Spring Boot 项目使用 Bean Validation 时通常还需要引入 validation starter。
# SpringMVC怎么统一处理异常?
一般通过 @RestControllerAdvice 配合 @ExceptionHandler,把 Controller 请求处理链路中的异常转换成统一响应。
@RestControllerAdvice
public class GlobalExceptionHandler {
    @ExceptionHandler(IllegalArgumentException.class)
    public ResponseEntity<String> handleInvalidArgument(
            IllegalArgumentException exception) {
        return ResponseEntity.badRequest().body("请求参数不合法");
    }
}
单个 Controller 也可以定义自己的 @ExceptionHandler,只处理它自己的请求;需要统一处理多个 Controller 时,再使用 Advice。
底层是 HandlerExceptionResolver 体系在处理异常,不是一定要给每个 Controller 加一个 AOP 切面。实际项目通常还会区分参数校验异常、业务异常和未知异常,返回统一的错误码,并记录必要的排查信息。
还要注意边界:普通 Filter 中在进入 DispatcherServlet 前抛出的异常,不会直接被 ControllerAdvice 捕获;独立线程里的异常也不会自动进入当前请求的异常处理链,需要在对应位置处理。
# Handlermapping 和 handleradapter有了解吗?
可以把它们理解成两个分工:HandlerMapping 负责找谁来处理,HandlerAdapter 负责怎么调用它。
- HandlerMapping:根据请求信息匹配 Handler,并返回带有拦截器的执行链。比如 RequestMappingHandlerMapping 会解析
@RequestMapping、@GetMapping等映射,把请求匹配到具体的 Controller 方法。 - HandlerAdapter:判断自己是否支持当前 Handler,支持就按相应方式执行。比如 RequestMappingHandlerAdapter 负责调用注解式 Controller 方法,并处理参数解析、数据绑定和返回值。
为什么要分成两个组件?因为 Spring MVC 的 Handler 不一定都是同一种类型。除了注解方法,还可以是实现了 Controller、HttpRequestHandler 等接口的对象,适配器把不同的调用方式统一起来,DispatcherServlet 就不用写一大堆类型判断。
大致链路是:DispatcherServlet → HandlerMapping 找到 Handler → 选择支持它的 HandlerAdapter → 执行 Handler → 处理返回值。
注意,HandlerAdapter 不负责根据 URL 找 Controller,也不是所有 Handler 执行后都会返回 ModelAndView,响应体也可以在执行过程中直接写出。
# SpringBoot
# 为什么使用springboot
- 简化开发:Spring Boot通过提供一系列的开箱即用的组件和自动配置,简化了项目的配置和开发过程,开发人员可以更专注于业务逻辑的实现,而不需要花费过多时间在繁琐的配置上。
- 快速启动:Spring Boot提供了快速的应用程序启动方式,可通过内嵌的Tomcat、Jetty或Undertow等容器快速启动应用程序,无需额外的部署步骤,方便快捷。
- 自动化配置:Spring Boot通过自动配置功能,根据项目中的依赖关系和约定俗成的规则来配置应用程序,减少了配置的复杂性,使开发者更容易实现应用的最佳实践。
# SpringBoot比Spring好在哪里
- Spring Boot 提供了自动化配置,大大简化了项目的配置过程。通过约定优于配置的原则,很多常用的配置可以自动完成,开发者可以专注于业务逻辑的实现。
- Spring Boot 提供了快速的项目启动器,通过引入不同的 Starter,可以快速集成常用的框架和库(如数据库、消息队列、Web 开发等),极大地提高了开发效率。
- Spring Boot 支持内嵌 Web 服务器,常见的 Servlet Web starter 默认使用 Tomcat,也可以按版本和依赖选择其他实现。应用可以打包成可执行 JAR,直接运行。
# SpringBoot用到哪些设计模式?
Spring Boot 本身建立在 Spring 之上,所以 IoC 的工厂、AOP 的代理、容器事件的观察者等模式也会出现。如果问 Boot 的特点,我会重点举启动和扩展相关的例子:
- 工厂模式:ServletWebServerFactory 根据实现创建对应的内嵌 Web 服务器,应用不需要直接负责服务器的完整创建过程。
- 策略模式:Tomcat、Jetty 等服务器工厂提供不同实现,上层通过统一接口使用,具体支持哪些实现取决于 Boot 版本和依赖。
- 观察者模式:启动过程中会发布准备环境、上下文刷新完成、应用就绪等事件,监听器可以在不同阶段执行逻辑。
- 模板方法模式:底层 ApplicationContext 的
refresh()固定了容器刷新的主流程,Web 上下文通过扩展相应步骤接入服务器创建等功能。
另外,starter 和条件化自动配置是 Boot 的重要机制,但不能因为它们很常用,就直接把它们当成某一种经典设计模式。面试里把具体类、调用关系和解决的问题连起来,回答会更清楚。
# 怎么理解SpringBoot中的约定大于配置
约定大于配置是Spring Boot的核心设计理念,它通过预设合理的默认行为和项目规范,大幅减少开发者需要手动配置的步骤,从而提升开发效率和项目标准化程度。
理解 Spring Boot 中的“约定大于配置”原则,可以从以下几个方面来解释:
- 自动化配置:Spring Boot 提供了大量的自动化配置,通过分析项目的依赖和环境,自动配置应用程序的行为。开发者无需显式地配置每个细节,大部分常用的配置都已经预设好了。例如,引入
spring-boot-starter-web后,Spring Boot会自动配置内嵌Tomcat和Spring MVC,无需手动编写XML。 - 默认配置:Spring Boot 为诸多方面提供大量默认配置,如连接数据库、设置 Web 服务器、处理日志等。开发人员无需手动配置这些常见内容,框架已做好决策。例如,默认的日志配置可让应用程序快速输出日志信息,无需开发者额外繁琐配置日志级别、输出格式与位置等。
- 约定的项目结构:Spring Boot 提倡特定项目结构,通常主应用程序类(含 main 方法)置于根包,控制器类、服务类、数据访问类等分别放在相应子包,如
com.example.demo.controller放控制器类,com.example.demo.service放服务类等。此约定使团队成员更易理解项目结构与组织,新成员加入项目时能快速定位各功能代码位置,提升协作效率。
# SpringBoot的项目结构是怎么样的?
一个正常的企业项目里一种通用的项目结构和代码层级划分的指导意见。按这《阿里巴巴Java开发手册》时本书上说的,一般分为如下几层:
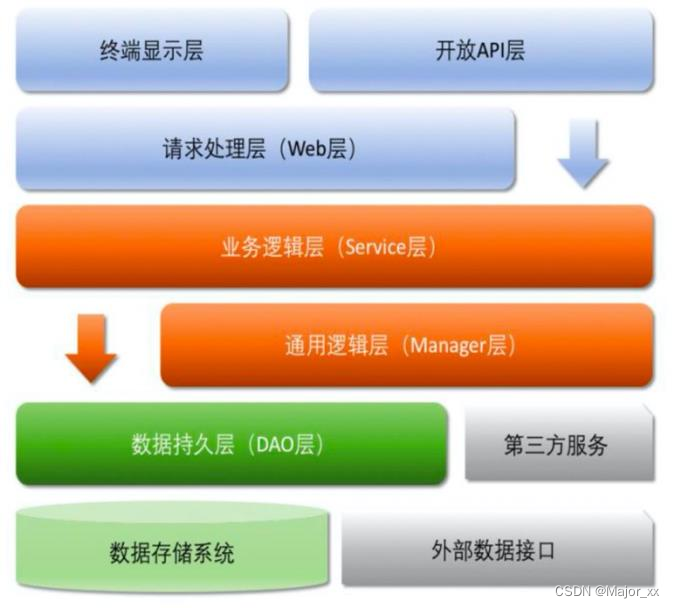
开放接口层:可直接封装 Service 接口暴露成 RPC 接口;通过 Web 封装成 http 接口;网关控制层等。
终端显示层:各个端的模板渲染并执行显示的层。当前主要是 velocity 渲染,JS 渲染,JSP 渲染,移动端展示等。
Web 层:主要是对访问控制进行转发,各类基本参数校验,或者不复用的业务简单处理等。
Service 层:相对具体的业务逻辑服务层。
Manager 层:通用业务处理层,它有如下特征:
- 1)对第三方平台封装的层,预处理返回结果及转化异常信息,适配上层接口。
- 2)对 Service 层通用能力的下沉,如缓存方案、中间件通用处理。
- 3)与 DAO 层交互,对多个 DAO 的组合复用。
DAO 层:数据访问层,与底层 MySQL、Oracle、Hbase、OceanBase 等进行数据交互。
第三方服务:包括其它部门 RPC 服务接口,基础平台,其它公司的 HTTP 接口,如淘宝开放平台、支付宝付款服务、高德地图服务等。
外部接口:外部(应用)数据存储服务提供的接口,多见于数据迁移场景中。
如果从一个用户访问一个网站的情况来看,对应着上面的项目代码结构来分析,可以贯穿整个代码分层:
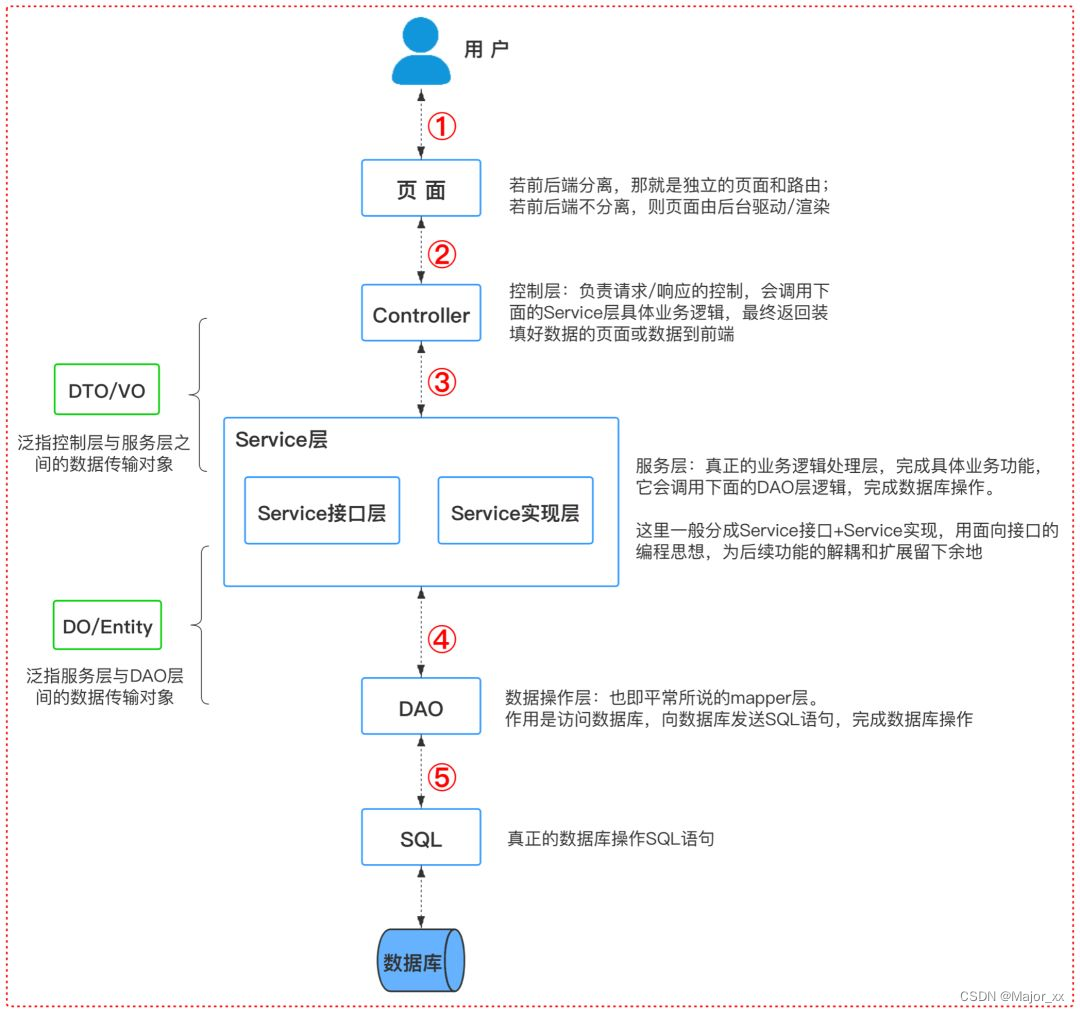
对应代码目录的流转逻辑就是:
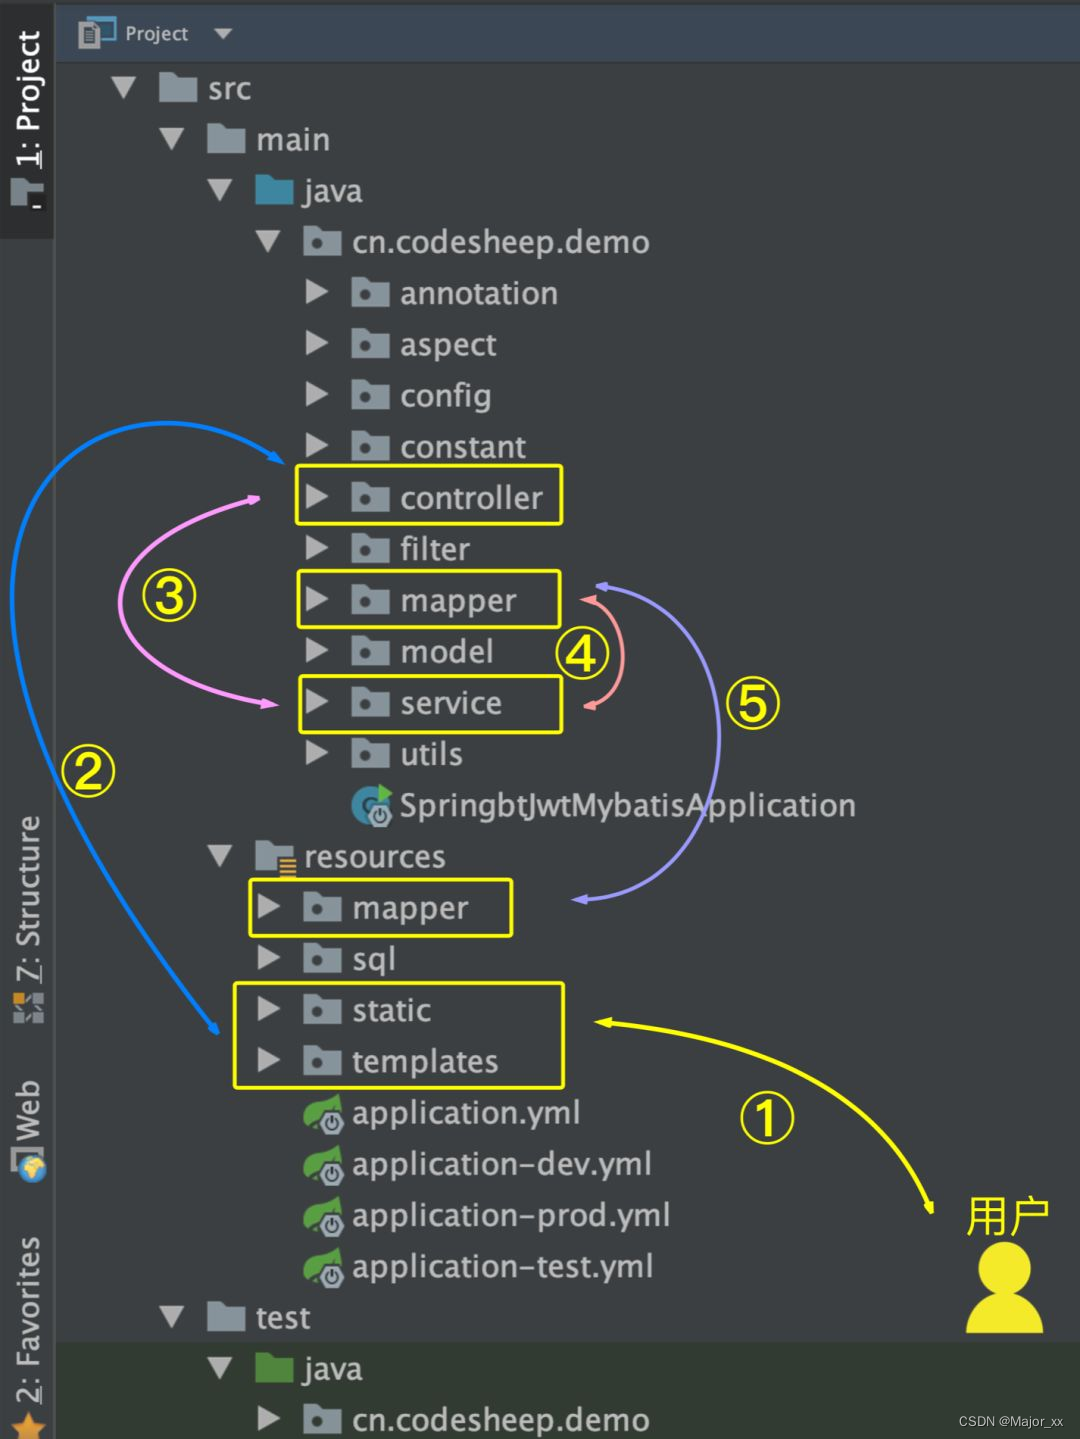
所以,以后每当我们拿到一个新的项目到手时,只要按照这个思路去看别人项目的代码,应该基本都是能理得顺的。
# SpringBoot自动装配原理是什么?
什么是自动装配?
Spring Boot 的自动装配,可以理解为:根据项目引入的依赖、配置属性和已经存在的 Bean,自动补齐一套常用的配置。
比如项目引入 JDBC 相关依赖,配置了数据源连接信息,又没有自己定义 DataSource,Spring Boot 就可以通过数据源自动配置创建对应的 Bean。它不是把依赖包里的所有类都扫进容器,而是按约定发现自动配置类,再通过条件判断决定是否生效。
SpringBoot自动装配原理
首先看 @SpringBootApplication,其中最关键的是三个注解:
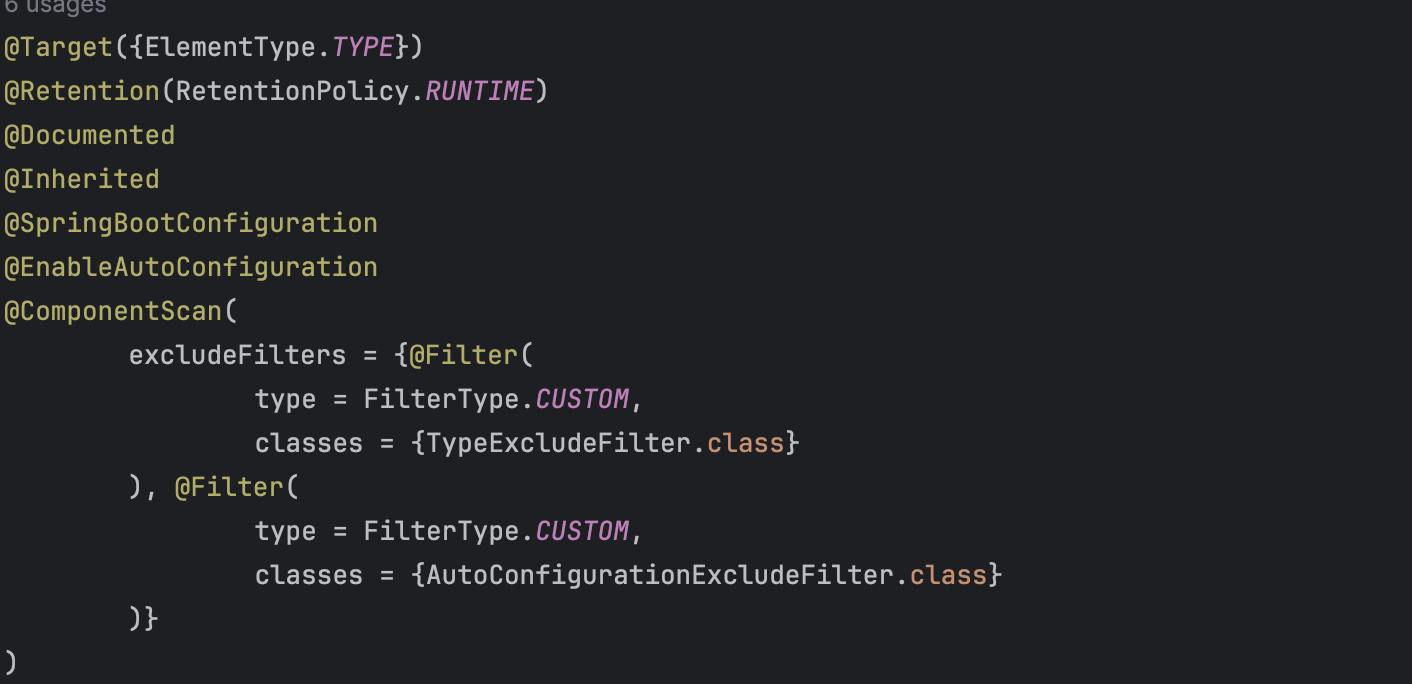
@SpringBootConfiguration:标识 Spring Boot 配置类,底层建立在@Configuration之上。@ComponentScan:扫描应用组件,默认从启动类所在包及其子包开始找@Component、@Service等。@EnableAutoConfiguration:开启自动配置,是这个问题的重点。
继续看 @EnableAutoConfiguration:
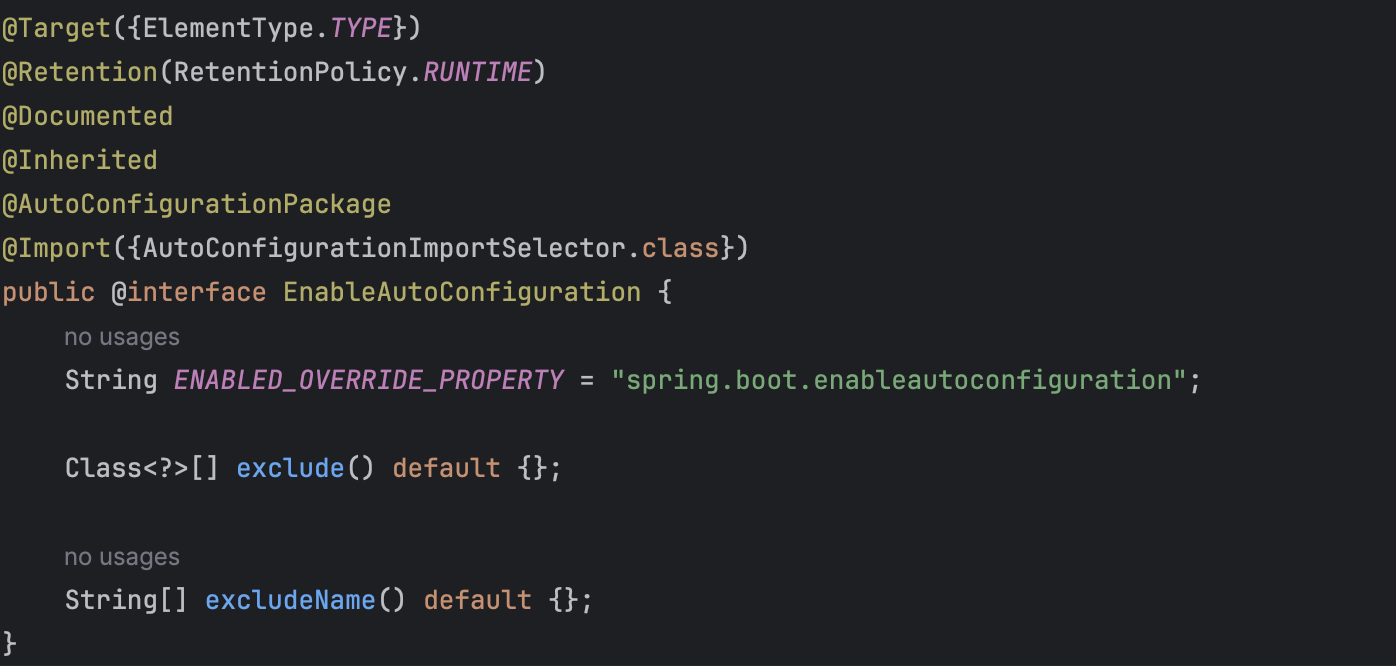
这里有两个关键部分:
@AutoConfigurationPackage:记录自动配置默认使用的基础包,供 JPA 实体扫描等功能参考。它本身不负责扫描所有@Component,也不是直接开启@MapperScan。@Import(AutoConfigurationImportSelector.class):通过自动配置导入选择器获取候选配置类,并参与筛选和导入。
AutoConfigurationImportSelector 实现了 DeferredImportSelector,让自动配置的导入延后处理,便于结合用户配置进行判断。整个过程可以按下面几步记:
- 读取候选配置:从类路径中的自动配置元数据文件获取配置类的全限定类名。
- 去重和排除:去掉重复项,处理
exclude、excludeName、spring.autoconfigure.exclude等排除配置。 - 筛选和排序:通过导入过滤器做部分条件筛选,再根据自动配置之间的 before、after 等关系确定处理顺序。
- 解析配置并注册 Bean:Spring 继续解析这些配置类,评估类和
@Bean方法上的条件,满足条件才注册相应的 Bean 定义,之后由容器按生命周期创建对象。
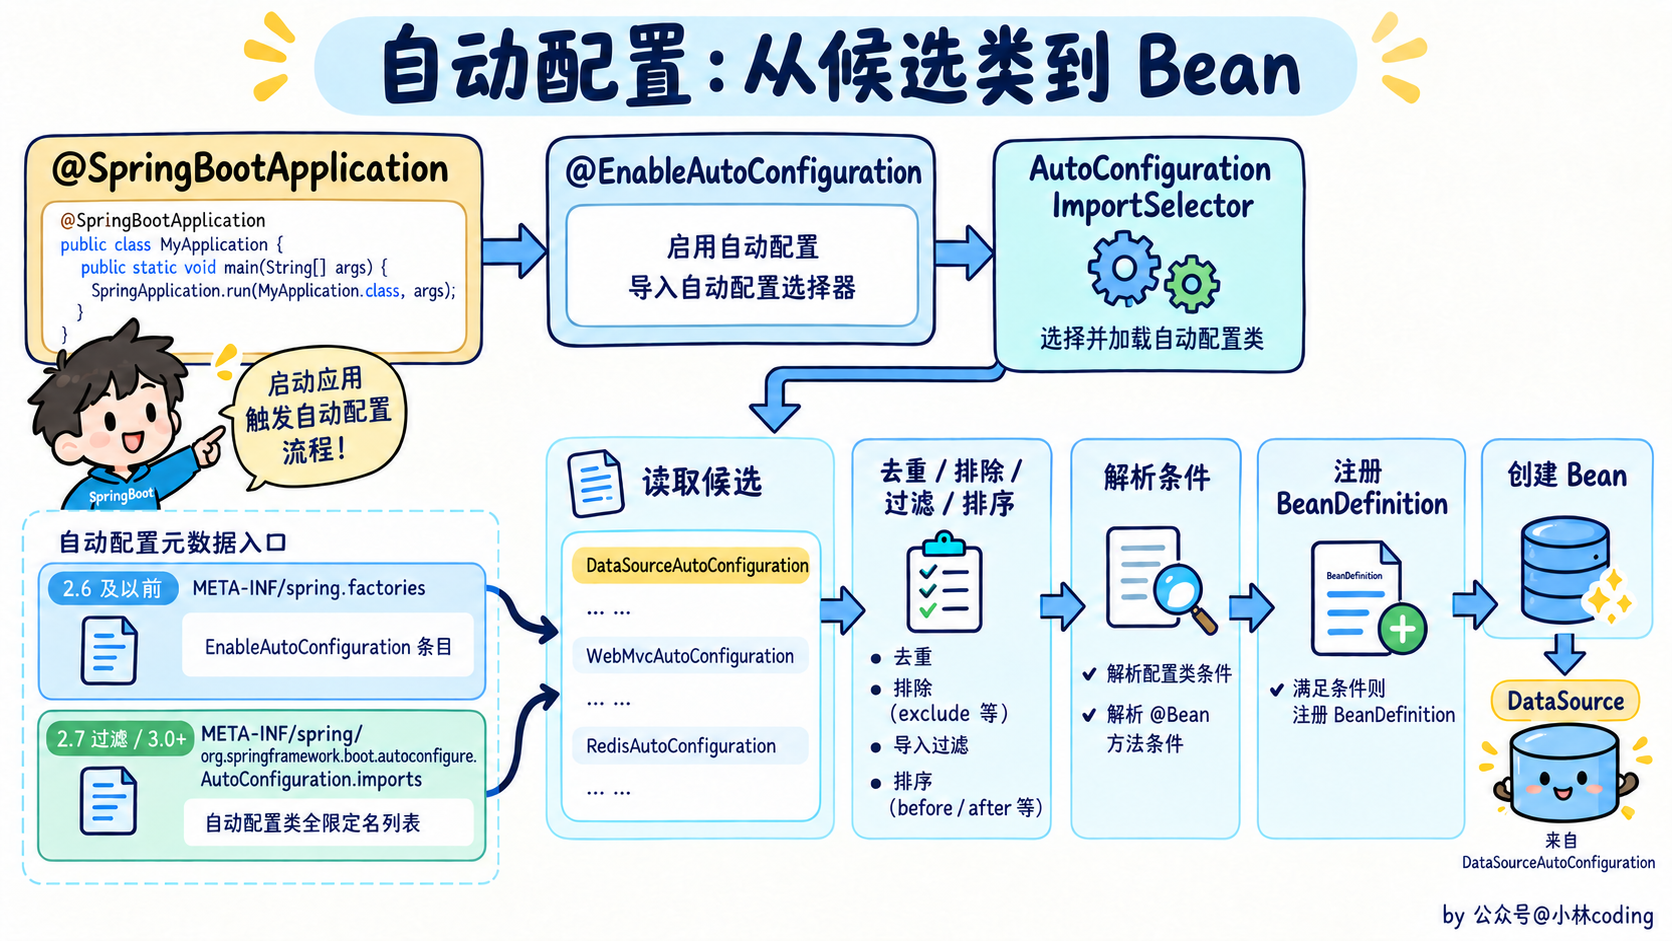
这里要区分版本:
| 版本 | 自动配置类的注册方式 |
|---|---|
| Spring Boot 2.6及以前 | META-INF/spring.factories 中的 org.springframework.boot.autoconfigure.EnableAutoConfiguration 条目 |
| Spring Boot 2.7 | 新增并推荐 META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports,同时兼容旧方式 |
| Spring Boot 3.x起 | 使用 AutoConfiguration.imports,不再通过上述 spring.factories 条目注册自动配置类 |
AutoConfiguration.imports 每行写一个自动配置类名,不需要再写 EnableAutoConfiguration 这个键。它里面列的是自动配置类,比如 DataSourceAutoConfiguration,不是 RedisTemplate 这样的普通业务或基础设施 Bean 类。spring.factories 仍然可以用于其他扩展点,不能说这个文件被整个废弃了。
为什么自定义Bean之后,自动配置通常会退让?
因为自动配置中大量使用了条件注解:
@ConditionalOnClass:类路径中存在指定类时才生效。@ConditionalOnMissingBean:容器里没有符合条件的 Bean 时才生效。@ConditionalOnProperty:配置属性满足要求时才生效。@ConditionalOnWebApplication:当前应用是指定类型的 Web 应用时才生效。
比如数据源自动配置发现用户已经提供了 DataSource,就可以跳过默认创建逻辑。这里通常是按类型等条件决定是否退让,不是简单地“同名 Bean 后注册的覆盖前面的”。
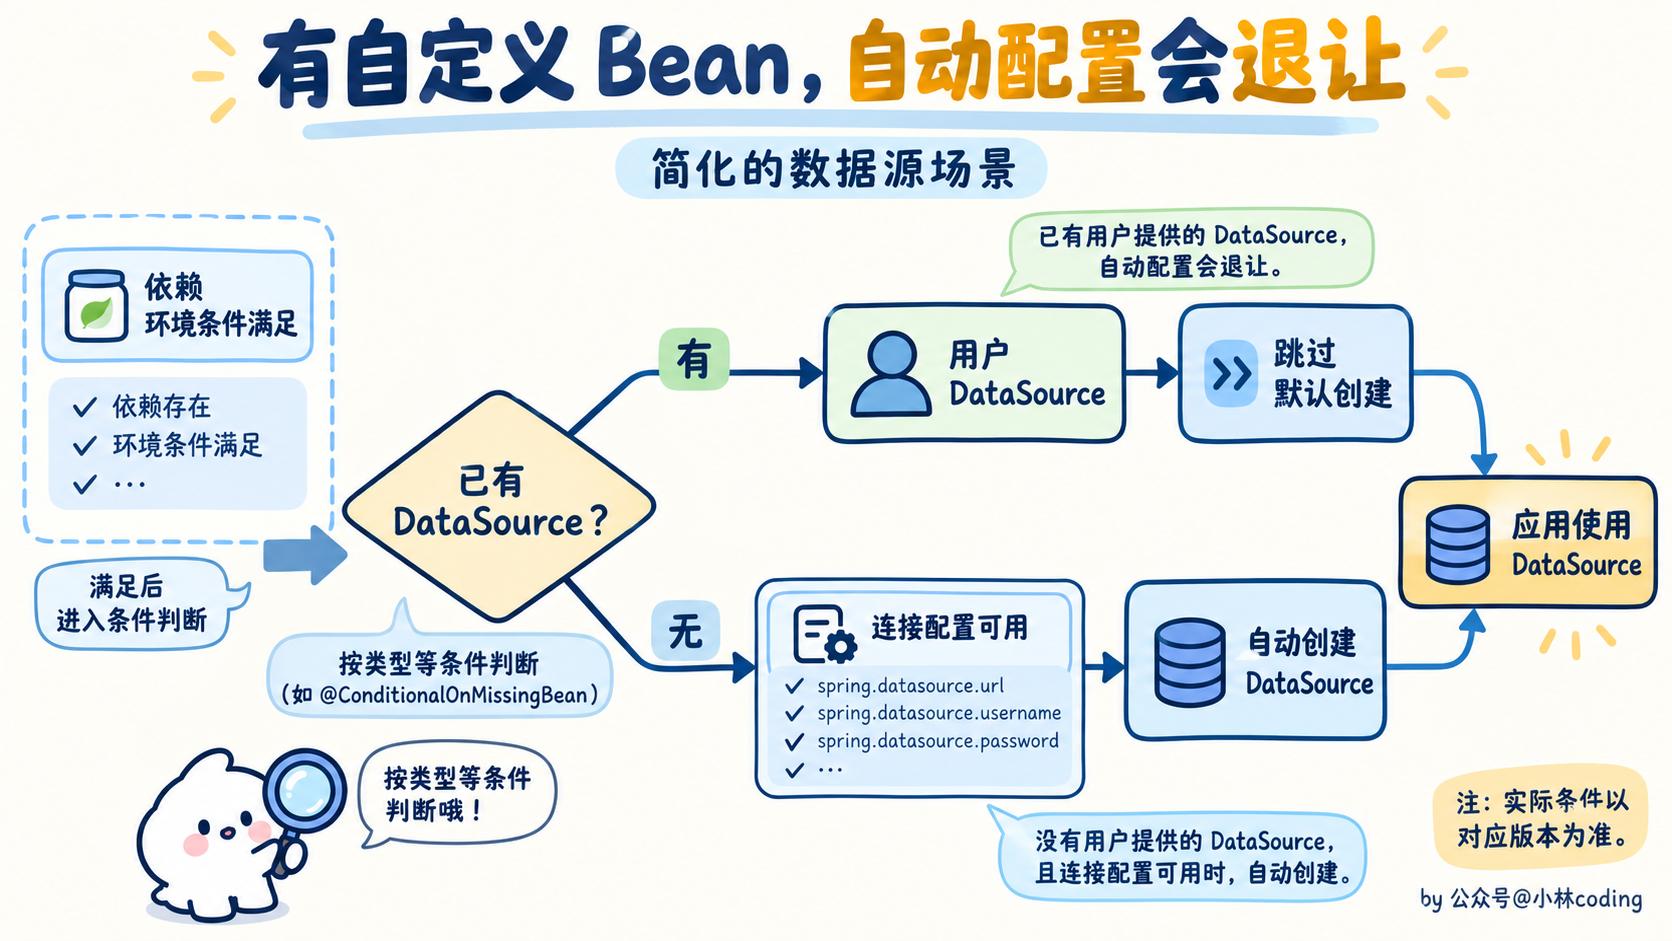
面试时可以顺着这条链路回答:启动注解开启自动配置 → 导入选择器读取候选类 → 排除、筛选和排序 → 条件注解控制配置及 Bean 注册 → 容器创建 Bean。
# 说几个启动器(starter)?
- spring-boot-starter-web:这是最常用的起步依赖之一,它包含了Spring MVC和Tomcat嵌入式服务器,用于快速构建Web应用程序。
- spring-boot-starter-security:提供了Spring Security的基本配置,帮助开发者快速实现应用的安全性,包括认证和授权功能。
- mybatis-spring-boot-starter:这个Starter是由MyBatis团队提供的,用于简化在Spring Boot应用中集成MyBatis的过程。它自动配置了MyBatis的相关组件,包括SqlSessionFactory、MapperScannerConfigurer等,使得开发者能够快速地开始使用MyBatis进行数据库操作。
- spring-boot-starter-data-jpa 或 spring-boot-starter-jdbc:如果使用的是 Java Persistence API (JPA) 进行数据库操作,那么应该使用
spring-boot-starter-data-jpa。这个 Starter 包含了 Hibernate(JPA 实现)、Spring Data JPA、HikariCP 连接池等必要的库。注意:该 Starter 不包含具体数据库的 JDBC 驱动,如要连接 MySQL 还需另外引入mysql-connector-j依赖,并在 application.properties 或 application.yml 中配置 MySQL 的连接信息。如果倾向于直接使用 JDBC 而不通过 JPA,那么可以使用spring-boot-starter-jdbc,它提供了基本的 JDBC 支持。 - spring-boot-starter-data-redis:用于集成 Redis 缓存和数据存储服务。这个 Starter 包含了与 Redis 交互所需的客户端(自 Spring Boot 2.0 起默认是 Lettuce 客户端,它基于 Netty 实现,线程安全且支持响应式;如需使用 Jedis,需要在依赖中排除 lettuce-core 并手动引入 jedis),以及 Spring Data Redis 的支持,使得在 Spring Boot 应用中使用 Redis 变得非常便捷。同样地,需要在配置文件中设置 Redis 服务器的连接详情。
- spring-boot-starter-test:包含了单元测试和集成测试所需的库,如JUnit, Spring Test, AssertJ等,便于进行测试驱动开发(TDD)。
# 写过SpringBoot starter吗?
自定义 starter 的核心是把依赖、配置属性和自动配置封装好,让使用方引入依赖后就能按约定使用。
我一般会把它拆成两部分:autoconfigure 模块放自动配置和配置属性,starter 模块负责聚合依赖。功能比较小的时候,也可以合并成一个模块。下面以 Spring Boot 2.7 及之后支持的写法为例。
步骤1:定义功能类
假设我们要封装一个简单的消息服务,下面这些类都放在 com.example.starter 包下:
public class MyService {
    private final String name;

    public MyService(String name) {
        this.name = name;
    }

    public String getName() {
        return name;
    }
}
这个类不需要加 @Service,后面通过自动配置的 @Bean 方法创建,避免依赖使用方的包扫描。
步骤2:定义配置属性
@ConfigurationProperties(prefix = "my")
public class MyProperties {
    private String name = "default";
    private boolean enabled = true;

    public String getName() { return name; }
    public void setName(String name) { this.name = name; }
    public boolean isEnabled() { return enabled; }
    public void setEnabled(boolean enabled) { this.enabled = enabled; }
}
步骤3:编写自动配置类
@AutoConfiguration
@EnableConfigurationProperties(MyProperties.class)
@ConditionalOnProperty(prefix = "my", name = "enabled",
        havingValue = "true", matchIfMissing = true)
public class MyAutoConfiguration {
    @Bean
    @ConditionalOnMissingBean(MyService.class)
    public MyService myService(MyProperties properties) {
        return new MyService(properties.getName());
    }
}
@EnableConfigurationProperties 负责注册配置属性 Bean 并启用绑定,@ConditionalOnProperty 让使用方可以关闭这个功能,@ConditionalOnMissingBean 则让使用方能够提供自己的实现。封装可选的第三方库时,还可以通过 @ConditionalOnClass 检查依赖是否存在。
步骤4:注册自动配置
在 src/main/resources/META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports 中写入:
com.example.starter.MyAutoConfiguration
如果还需要兼容 Spring Boot 2.6 及以前,则要结合对应版本使用 @Configuration 和 spring.factories 注册方式,不能直接照搬 @AutoConfiguration。
步骤5:聚合依赖并使用
starter 引入 autoconfigure 模块和功能所需的依赖,发布到 Maven 仓库后,使用方只需要引入 starter,并配置属性:
my:
  name: Hello World
  enabled: true
之后就可以在业务组件里注入 MyService。starter 本身不需要提供主启动类,也不一定要引入 spring-boot-starter-web,除非它的功能确实依赖 Web。
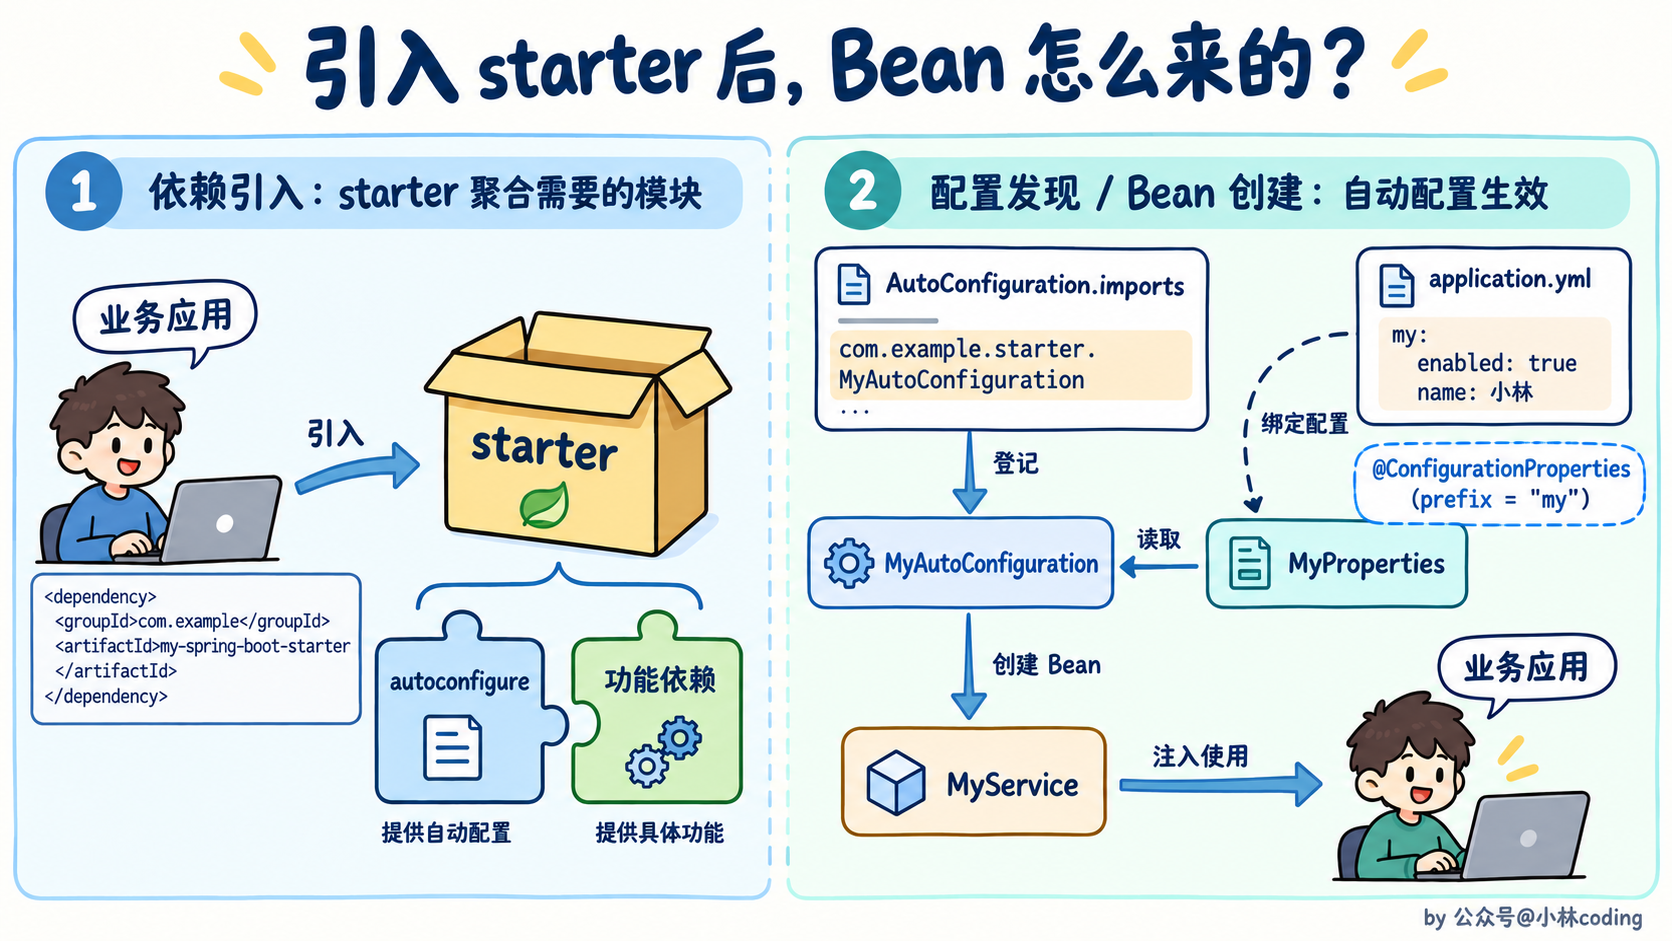
实际开发还要验证三个关键场景:默认配置能创建 Bean、关闭功能时不创建 Bean、使用方提供自定义 Bean 时自动配置能够退让,这几个场景可以用 ApplicationContextRunner 来验证。
# SpringBoot启动流程大致是什么?
Spring Boot 启动入口通常是 SpringApplication.run(),但核心还是准备环境、创建并刷新 Spring 容器,最后执行启动后的任务。
大致可以分成下面几步:
- 准备 SpringApplication:确定应用类型,准备初始化器和监听器等基础组件。
- 准备 Environment:处理命令行参数,读取配置数据,确定激活的 Profile,形成应用的配置环境。
- 创建 ApplicationContext:根据应用类型创建对应的上下文,例如 Servlet Web 应用使用支持 Web 服务器的上下文。
- 准备并刷新容器:注册启动类等 Bean 定义,执行后置处理器,解析组件扫描和自动配置,实例化非懒加载单例 Bean。
- 启动 Web 服务器:Web 应用在上下文刷新过程中创建和启动内嵌服务器,这不是等所有启动后回调结束才开始的。
- 执行启动任务:上下文刷新完成后发布相关事件,调用 ApplicationRunner、CommandLineRunner,最后发布应用就绪事件。
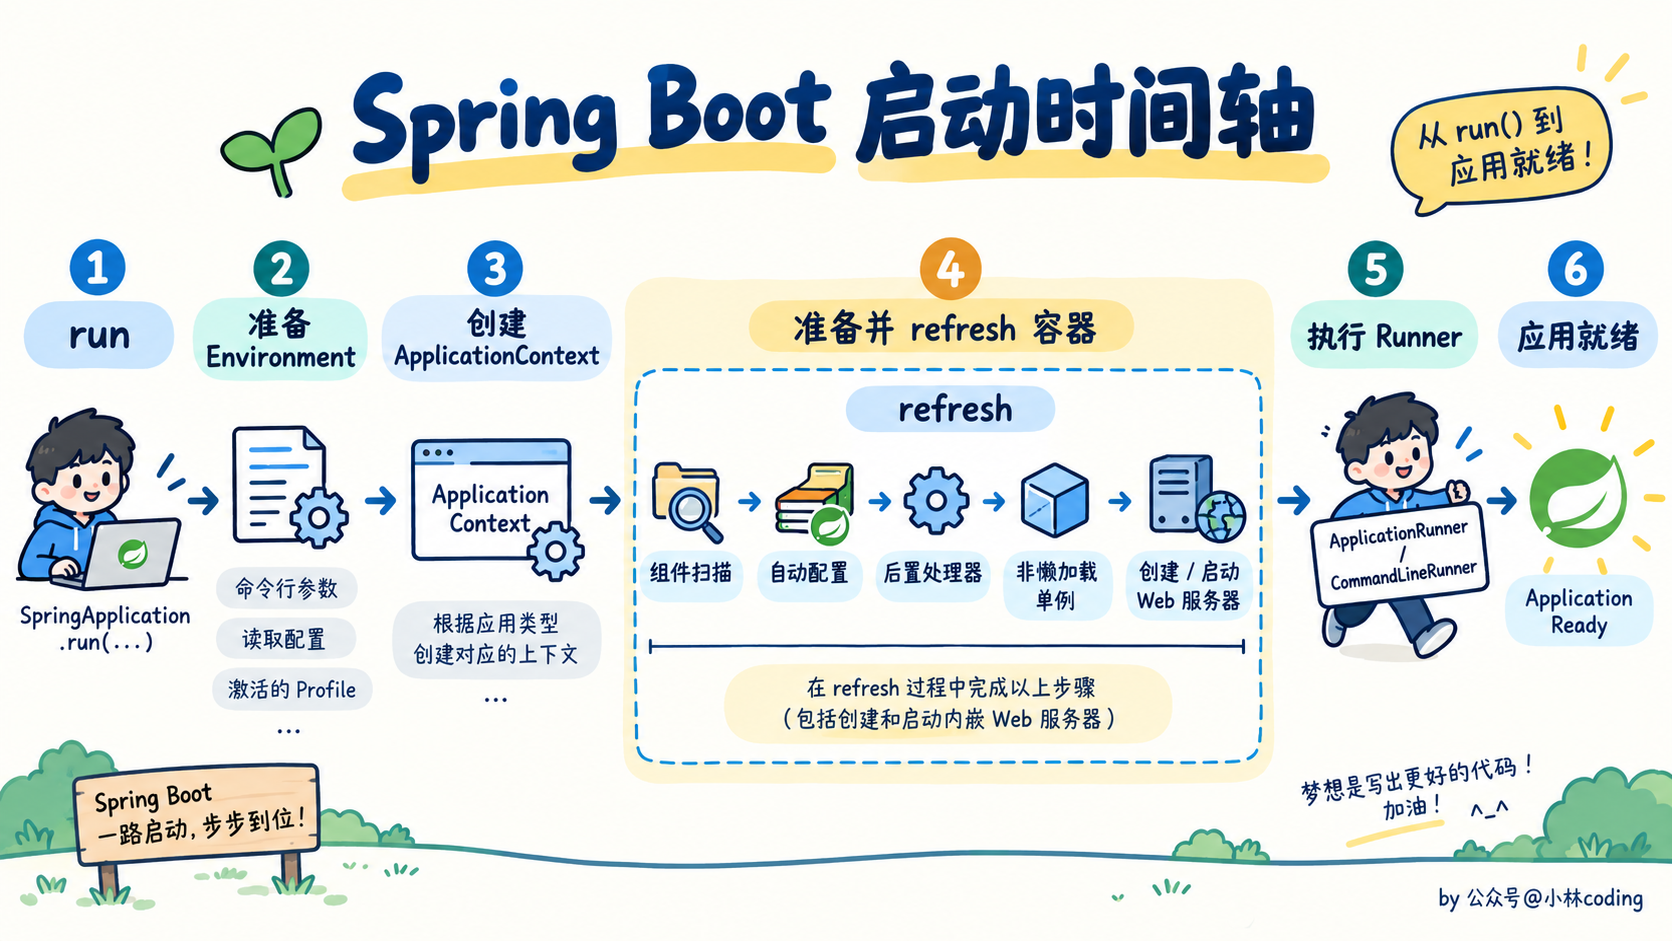
ApplicationRunner 接收解析后的 ApplicationArguments,CommandLineRunner 接收原始字符串参数,多个 Runner 可以通过 @Order 等方式安排执行顺序。
如果启动失败,我会结合异常所在阶段排查:配置没读到、Bean 创建失败、自动配置条件没满足、端口占用,还是 Runner 执行失败。
# 自动配置没有生效,怎么排查?
我会先确认自动配置类有没有被发现,再确认哪个条件没满足。
- 看依赖和版本:starter 是否真的在类路径里,相关第三方类是否存在,Spring Boot 与 starter 的版本是否兼容。
- 看注册方式:自定义自动配置是否写进对应版本支持的元数据文件,文件路径、包名是否正确。
- 看条件:配置属性是否满足要求,是否已经有同类型 Bean 导致
@ConditionalOnMissingBean退让,当前应用类型是否符合要求。 - 看排除配置:是否在启动注解或
spring.autoconfigure.exclude中排除了这个自动配置。 - 看条件评估报告:启动时添加
--debug,查看哪些配置匹配、哪些没有匹配,以及原因。项目启用了相关 Actuator 端点时,也可以通过 conditions 端点查看。
比如引入了数据源 starter 但 Bean 没有按预期创建,可能是缺少驱动或连接信息,也可能是用户定义的 DataSource 让默认配置退让。要根据报告定位原因,不要只看到“自动”两个字就认为任何依赖都会立即生效。
# @Value 和 @ConfigurationProperties 有什么区别?
@Value 更适合注入零散的配置值,@ConfigurationProperties 更适合把一组配置绑定到对象里。
比如只取一个开关,可以用 @Value("${feature.enabled:false}");如果一个组件有地址、超时、重试次数等多项配置,我通常会定义一个配置属性类,按同一个前缀统一绑定。
@Value:使用简单,支持占位符和 SpEL 表达式,但大量字段散落在不同类里时不方便管理。@ConfigurationProperties:支持结构化绑定、嵌套对象、集合和宽松绑定,可以结合@Validated进行配置校验,也方便生成 IDE 配置提示。它不会像@Value那样对属性值求值 SpEL。
配置属性类也需要被注册到容器中,可以用 @EnableConfigurationProperties 或 @ConfigurationPropertiesScan,不是只写一个注解就一定会被加载。
# SpringBoot配置文件的优先级是怎样的?
Spring Boot 可以从多个来源读取配置,同一个属性同时出现在多个来源时,由优先级更高的来源覆盖。
以 Spring Boot 2.4 之后常见的默认配置为例,下面这些来源从高到低可以这样记:
命令行参数 → Java 系统属性 → 操作系统环境变量 → 应用配置文件中的值。
配置文件这一层,在默认加载规则下,通常是:包外的 Profile 配置 → 包外的普通配置 → 包内的 Profile 配置 → 包内的普通配置。Profile 配置指 application-prod.yml 这类文件,只有对应 Profile 激活时才参与加载。
比如包内 application.yml 把端口设置为 8080,环境变量设置了 SERVER_PORT=8081,启动参数又写了 --server.port=8082,最终通常用 8082。
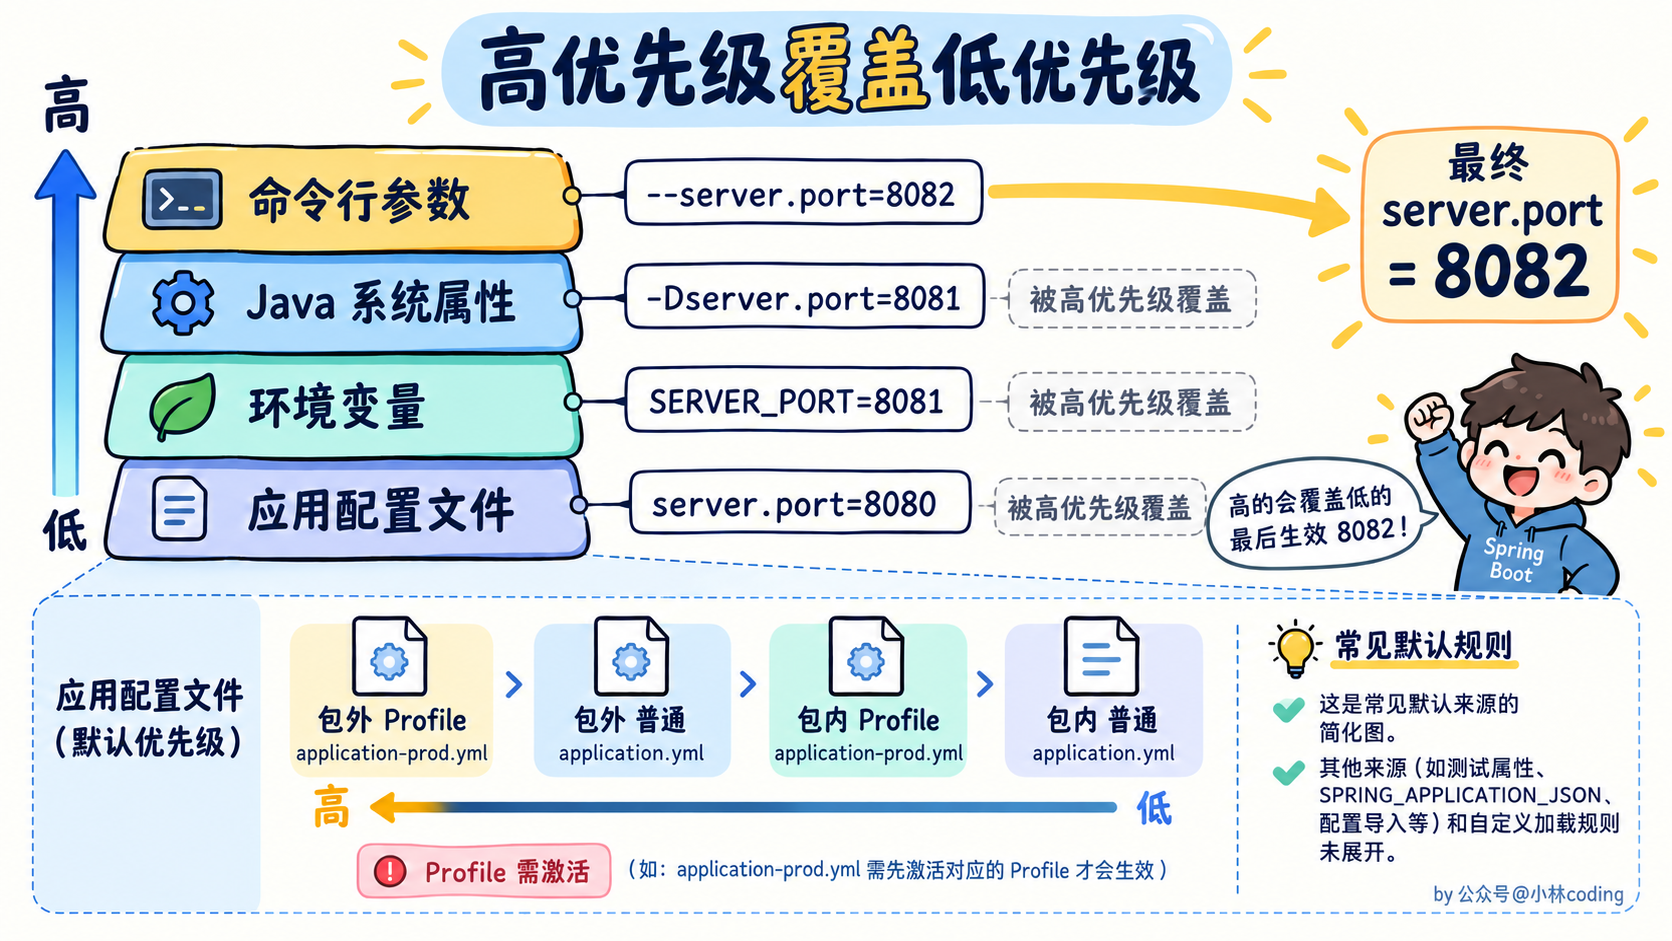
上面只列了常见来源,测试属性、SPRING_APPLICATION_JSON、配置导入等还有各自的优先级。配置了自定义 location 或 import 时,也要按实际加载顺序判断,不能把这条简化顺序当成所有场景的完整规则。
# SpringBoot里面有哪些重要的注解?还有一个配置相关的注解是哪个?
Spring Boot 中一些常用的注解包括:
- @SpringBootApplication:用于标注主应用程序类,标识一个Spring Boot应用程序的入口点,同时启用自动配置和组件扫描。
- @Controller:标识控制器类,处理HTTP请求。
- @RestController:结合@Controller和@ResponseBody,返回RESTful风格的数据。
- @Service:标识服务类,通常用于标记业务逻辑层。
- @Repository:标识数据访问组件,通常用于标记数据访问层。
- @Component:通用的Spring组件注解,表示一个受Spring管理的组件。
- @Autowired:用于自动装配Spring Bean。
- @Value:用于注入配置属性值。
- @RequestMapping:用于映射HTTP请求路径到Controller的处理方法。
- @GetMapping、@PostMapping、@PutMapping、@DeleteMapping:简化@RequestMapping的GET、POST、PUT和DELETE请求。
另外,几个与配置相关的重要注解是:
- @Configuration:用于指定配置类,通常与
@Bean配合定义由容器管理的 Bean。 - @ConfigurationProperties:将指定前缀的一组配置绑定到 Java 对象中。
- @EnableConfigurationProperties:注册指定的配置属性类并启用绑定。
- @ConfigurationPropertiesScan:扫描并注册配置属性类。
# springboot怎么开启事务?
在 Spring Boot 中,如果已经配置好受支持的数据源和对应事务管理器,通常在由 Spring 管理的服务方法上添加 @Transactional 就可以使用声明式事务。调用时还需要经过代理对象。
例如,假设我们有一个 UserService 接口,其中有一个保存用户的方法 saveUser():
public interface UserService {
    void saveUser(User user);
}
我们希望在这个方法中开启事务,只需在该方法上添加 @Transactional 注解,如下所示:
@Service
public class UserServiceImpl implements UserService {

    @Autowired
    private UserRepository userRepository;

    @Override
    @Transactional
    public void saveUser(User user) {
        userRepository.save(user);
    }
}
这样,当调用 saveUser() 方法时,Spring 就会自动为该方法开启一个事务。如果方法执行成功,事务会自动提交;如果方法抛出 RuntimeException 或 Error,事务会自动回滚。注意:@Transactional 默认只对 RuntimeException 和 Error 触发回滚,受检异常(checked Exception,如 IOException)默认不会回滚,如果希望受检异常也回滚,需要配置 @Transactional(rollbackFor = Exception.class)。在有合适的事务管理器,且相关自动配置条件满足时,Spring Boot 通常会自动启用事务管理,无需再手动添加 @EnableTransactionManagement。仅引入 JDBC 依赖而没有可用的数据源配置,并不能保证事务可以使用。
事务相关的依赖通常通过 spring-boot-starter-jdbc 或 spring-boot-starter-data-jpa 引入(它们会带入 PlatformTransactionManager):
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-jdbc</artifactId>
</dependency>
# Springboot怎么做到导入就可以直接使用的?
这个主要依赖于自动配置、起步依赖和条件注解等特性。
起步依赖
起步依赖是一种特殊的 Maven 或 Gradle 依赖,它将项目所需的一系列依赖打包在一起。例如,spring-boot-starter-web 这个起步依赖就包含了 Spring Web MVC、Tomcat 等构建 Web 应用所需的核心依赖。
开发者只需在项目中添加一个起步依赖,Maven 或 Gradle 就会自动下载并管理与之关联的所有依赖,避免了手动添加大量依赖的繁琐过程。
比如,在 pom.xml 中添加 spring-boot-starter-web 依赖:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
</dependency>
自动配置
Spring Boot 的自动配置机制会根据类路径下的依赖和开发者的配置,自动创建和配置应用所需的 Bean。它通过 @EnableAutoConfiguration 注解启用,该注解会触发 Spring Boot 去查找对应的自动配置元数据文件(2.7 以前是 META-INF/spring.factories,2.7 及以后是 META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports,Spring Boot 3.0 已彻底移除对 spring.factories 自动配置条目的支持)。
元数据文件中定义了一系列自动配置类,Spring Boot 会根据当前项目的依赖情况,选择合适的自动配置类进行加载。例如,如果项目中包含 spring-boot-starter-web 依赖,Spring Boot 会加载 WebMvcAutoConfiguration 类,该类会自动配置 Spring MVC 的相关组件,如 DispatcherServlet、视图解析器等。
开发者可以通过自定义配置来覆盖自动配置的默认行为。如果开发者在 application.properties 或 application.yml 中定义了特定的配置,或者提供了自动配置所检查类型的 Bean,相关自动配置通常会通过条件判断退让。它并不是靠同名 Bean 自动覆盖来保证这一点。
条件注解
条件注解用于控制 Bean 的创建和加载,只有在满足特定条件时,才会创建相应的 Bean。Spring Boot 的自动配置类中广泛使用了条件注解,如 @ConditionalOnClass、@ConditionalOnMissingBean 等。
比如,@ConditionalOnClass 表示只有当类路径中存在指定的类时,才会创建该 Bean。例如,在 WebMvcAutoConfiguration 类中,可能会有如下代码:
@Configuration
@ConditionalOnClass({ Servlet.class, DispatcherServlet.class, WebMvcConfigurer.class })
public class WebMvcAutoConfiguration {
    // 配置相关的 Bean
}
这段代码表示只有当类路径中存在 Servlet、DispatcherServlet 和 WebMvcConfigurer 类时,才满足示例中的类路径条件;实际是否生效还要继续检查 Web 应用类型、是否存在 WebMvcConfigurationSupport 等其他条件。
# SpringBoot 过滤器和拦截器说一下?
过滤器和拦截器都可以在请求前后执行逻辑,区别主要是所在层次和能拿到的信息不同。
| 特性 | 过滤器(Filter) | 拦截器(HandlerInterceptor) |
|---|---|---|
| 所属体系 | Servlet 规范,由 Servlet 容器调度 | Spring MVC,由 MVC 执行链调度 |
| 作用位置 | 在目标 Servlet 前后 | 在匹配 Handler 后,围绕处理器执行 |
| 作用范围 | 取决于 URL、Servlet 和 dispatcher type 等映射配置 | 取决于 HandlerMapping 和拦截器路径配置 |
| 核心方法 | doFilter() | preHandle()、postHandle()、afterCompletion() |
| 常见能力 | 处理编码、包装请求响应、通用日志、安全过滤链 | 获取 HandlerMethod 信息,处理方法相关的检查和统计 |
| 依赖注入 | 在 Boot 中作为 Spring Bean 注册时可以注入依赖 | 注册为 Spring 管理的 Bean 时可以注入依赖 |
Filter 在 doFilter() 中通过 chain.doFilter() 把请求交给后面的过滤器或 Servlet,可以在它前后执行逻辑。如果不继续调用,请求也可以直接在 Filter 中结束。
拦截器的几个方法分别是:
preHandle():Handler 执行前调用,返回 false 可以中止后续处理。postHandle():HandlerAdapter 正常完成后调用,传统视图场景下处于视图渲染之前;如果处理器抛出异常,通常不会执行它。afterCompletion():在请求处理完成后做清理,通常会对preHandle()已返回 true 的拦截器执行。
普通同步请求可以记成:Filter 前置 → DispatcherServlet → Interceptor 前置 → Controller → 返回值处理 → Interceptor 后置 → 视图渲染(如果有)→ Interceptor 完成回调 → Filter 后置。多个 Filter 或拦截器的后置逻辑通常按进入顺序的反方向执行,异步请求还有额外的分派流程。
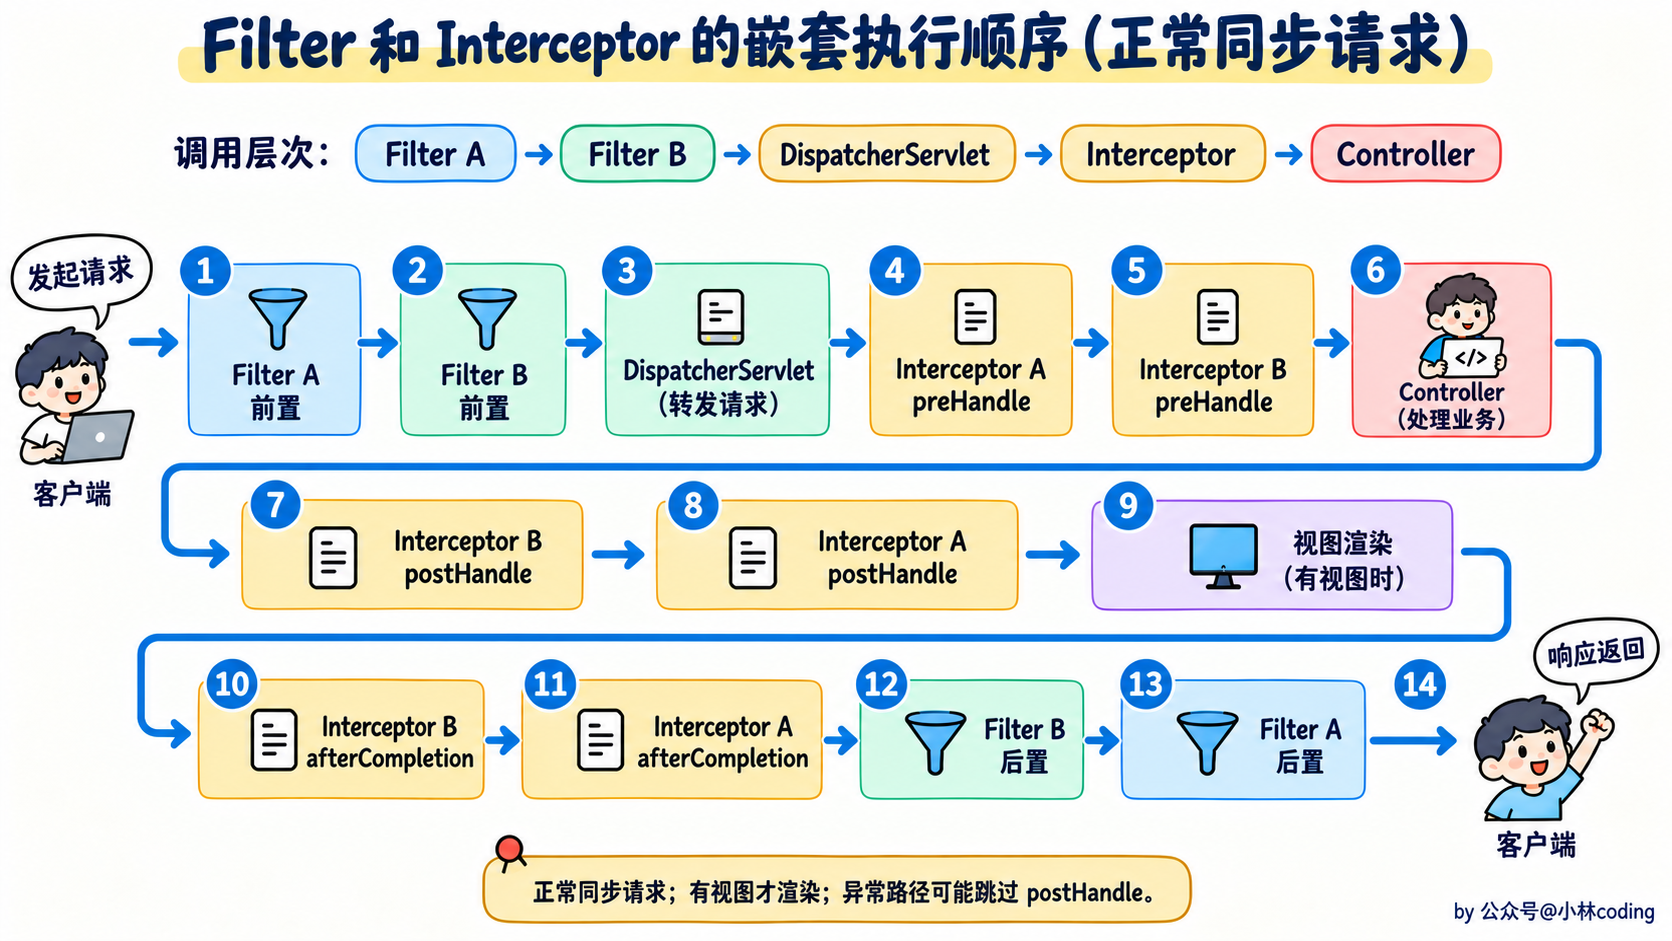
有两个误区要注意:第一,Filter 不是一定无法注入 Spring Bean,关键看它是怎么创建和注册的;第二,拦截器也不只作用于 Controller,Spring MVC 管理的静态资源 Handler 如果匹配规则,也可能被拦截。
安全认证和授权通常优先使用 Spring Security 的过滤器链,因为它能覆盖更完整的请求处理边界;拦截器更适合依赖 MVC Handler 信息的逻辑。
# Mybatis
# 与传统的JDBC相比,MyBatis的优点?
- 基于 SQL 语句编程,相当灵活,不会对应用程序或者数据库的现有设计造成任 何影响,SQL 写在 XML 里,解除 sql 与程序代码的耦合,便于统一管理;提供 XML 标签,支持编写动态 SQL 语句,并可重用。
- 与直接使用 JDBC 相比,封装了参数设置、结果集映射和资源管理等重复代码;独立使用时仍要正确关闭 SqlSession,与 Spring 整合后通常由相关组件管理会话和连接;
- 很好的与各种数据库兼容,因为 MyBatis 使用 JDBC 来连接数据库,所以只要 JDBC 支持的数据库 MyBatis 都支持。
- 能够与 Spring 很好的集成,开发效率高
- 提供映射标签,支持对象与数据库的 ORM 字段关系映射;提供对象关系映射 标签,支持对象关系组件维护。
# MyBatis觉得在哪方面做的比较好?
MyBatis 在 SQL 灵活性、动态 SQL 支持、结果集映射和与 Spring 整合这几个方面比较实用,尤其适合重视 SQL 可控性的项目。
- SQL 与代码解耦,灵活可控:MyBatis 允许开发者直接编写和优化 SQL,相比全自动 ORM(如 Hibernate),MyBatis 让开发者明确知道每条 SQL 的执行逻辑,便于性能调优。
<!-- 示例:XML 中定义 SQL -->
<select id="findUserWithRole" resultMap="userRoleMap">
    SELECT u.id AS user_id, u.name AS user_name,
           r.id AS role_id, r.role_name
    FROM user u
    LEFT JOIN user_role ur ON u.id = ur.user_id
    LEFT JOIN role r ON ur.role_id = r.id
    WHERE u.id = #{userId}
</select>
- 动态 SQL 的强大支持:比如可以动态拼接SQL,通过
<if>,<choose>,<foreach>等标签动态生成 SQL,避免 Java 代码中繁琐的字符串拼接。
<select id="searchUsers" resultType="User">
    SELECT * FROM user
    <where>
        <if test="name != null">AND name LIKE #{name}</if>
        <if test="status != null">AND status = #{status}</if>
    </where>
</select>
- 自动映射与自定义映射结合:自动将查询结果字段名与对象属性名匹配(如驼峰转换)。
<resultMap id="userRoleMap" type="User">
    <id property="id" column="user_id"/>
    <result property="name" column="user_name"/>
    <collection property="roles" ofType="Role" notNullColumn="role_id">
        <id property="id" column="role_id"/>
        <result property="roleName" column="role_name"/>
    </collection>
</resultMap>
- 插件扩展机制:可编写插件拦截 SQL 执行过程,实现分页、性能监控、SQL 改写等通用逻辑。
@Intercepts({
    @Signature(type = Executor.class, method = "query",
        args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class})
})
public class SqlMonitorPlugin implements Interceptor {
    @Override
    public Object intercept(Invocation invocation) throws Throwable {
        // 在这里添加 SQL 监控等逻辑
        return invocation.proceed();
    }
}
- 与 Spring 生态无缝集成:通过
@MapperScan快速扫描 Mapper 接口,结合 Spring 事务管理,配置简洁高效。
@Configuration
@MapperScan("com.example.mapper")
public class MyBatisConfig {
    // 数据源和 SqlSessionFactory 配置
}
# 还记得JDBC连接数据库的步骤吗?
主要是 获取连接 → 创建语句 → 设置参数 → 执行 SQL → 处理结果 → 释放资源。
- 准备驱动:引入数据库 JDBC 驱动。JDBC 4.0 起,驱动通常可以通过 SPI 自动加载,一般不需要再手动
Class.forName()。 - 获取连接:示例可以用 DriverManager,实际项目一般通过 DataSource 和连接池获取。
- 创建语句并设置参数:带有外部参数时优先使用 PreparedStatement,通过占位符传递数据,不要把用户输入直接拼接进 SQL。
- 执行 SQL:查询使用
executeQuery(),更新通常使用executeUpdate()。 - 处理结果:通过 ResultSet 遍历结果并读取字段。
- 释放资源:使用 try-with-resources,异常时也能关闭 ResultSet、Statement 和 Connection。
例如:
import java.sql.*;

public class Main {
    public static void main(String[] args) {
        String sql = "SELECT id, username FROM users WHERE id = ?";
        try (Connection connection = DriverManager.getConnection(
                    "jdbc:mysql://localhost:3306/mydatabase", "username", "password");
             PreparedStatement statement = connection.prepareStatement(sql)) {
            statement.setLong(1, 1L);
            try (ResultSet resultSet = statement.executeQuery()) {
                while (resultSet.next()) {
                    System.out.println(resultSet.getString("username"));
                }
            }
        } catch (SQLException exception) {
            exception.printStackTrace();
        }
    }
}
如果需要手动管理事务,还要关闭自动提交,成功时 commit,失败时 rollback。通过连接池获取的连接调用 close(),通常是归还连接池;在 Spring 管理的事务中,则应通过相应的数据访问组件配合管理连接。
# 如果项目中要用到原生的mybatis去查询,该怎样写?
这里要先区分:在 Spring Boot 里使用 MyBatis,和脱离 Spring 独立使用 MyBatis,获取 Mapper 和管理 SqlSession 的方式不同。
以 Spring Boot 项目为例,主要有下面几步:
- 引入与项目版本兼容的
mybatis-spring-boot-starter、数据库驱动,并配置数据源。 - 创建实体类和 Mapper 接口,用
@Mapper或启动配置中的@MapperScan注册 Mapper。 - 编写 XML 映射,namespace 对应 Mapper 接口全限定名,SQL 的 id 对应接口方法名。
- 配置 Mapper XML 的位置,在 Service 中注入 Mapper 并调用。
比如 Mapper 接口放在 com.example.dao 包下:
@Mapper
public interface UserMapper {
    User selectUserById(@Param("id") Long id);
}
在 resources/mapper/UserMapper.xml 中定义 SQL,假设实体类是 com.example.model.User,具有对应属性及访问方法:
<mapper namespace="com.example.dao.UserMapper">
    <select id="selectUserById" resultType="com.example.model.User">
        SELECT id, username, email FROM users WHERE id = #{id}
    </select>
</mapper>
配置 XML 扫描路径:
mybatis:
  mapper-locations: classpath*:mapper/*.xml
然后在服务层调用:
@Service
public class UserService {
    private final UserMapper userMapper;

    public UserService(UserMapper userMapper) {
        this.userMapper = userMapper;
    }

    public User getUser(Long id) {
        return userMapper.selectUserById(id);
    }
}
如果完全不用 Spring,就要根据 mybatis-config.xml 创建 SqlSessionFactory,在配置中注册数据源和 Mapper,再自己打开和关闭 SqlSession:
try (InputStream input = Resources.getResourceAsStream("mybatis-config.xml")) {
    SqlSessionFactory factory = new SqlSessionFactoryBuilder().build(input);
    try (SqlSession session = factory.openSession()) {
        UserMapper mapper = session.getMapper(UserMapper.class);
        User user = mapper.selectUserById(1L);
    }
}
SqlSessionFactory 通常创建一次并复用,SqlSession 本身不能被多个线程共享。独立使用时执行写操作还需要按配置提交或回滚;Spring 整合场景通常通过 Mapper 代理和 SqlSessionTemplate 管理会话,并配合 Spring 事务。
# Mybatis里的 # 和 $ 的区别?
核心区别是:#{} 是参数绑定,${} 是文本替换。
#{}:在默认的 PreparedStatement 执行方式下,会转换成?占位符,再通过 JDBC 设置参数。用户输入作为数据传递,不会因为其中包含 SQL 关键字就变成 SQL 结构,适合用户名、id、日期等参数值。${}:直接把内容拼进 SQL 文本中,输入内容可能改变 SQL 结构,存在 SQL 注入风险。即使最终仍然使用 PreparedStatement 执行,也不能消除这部分文本拼接的风险。
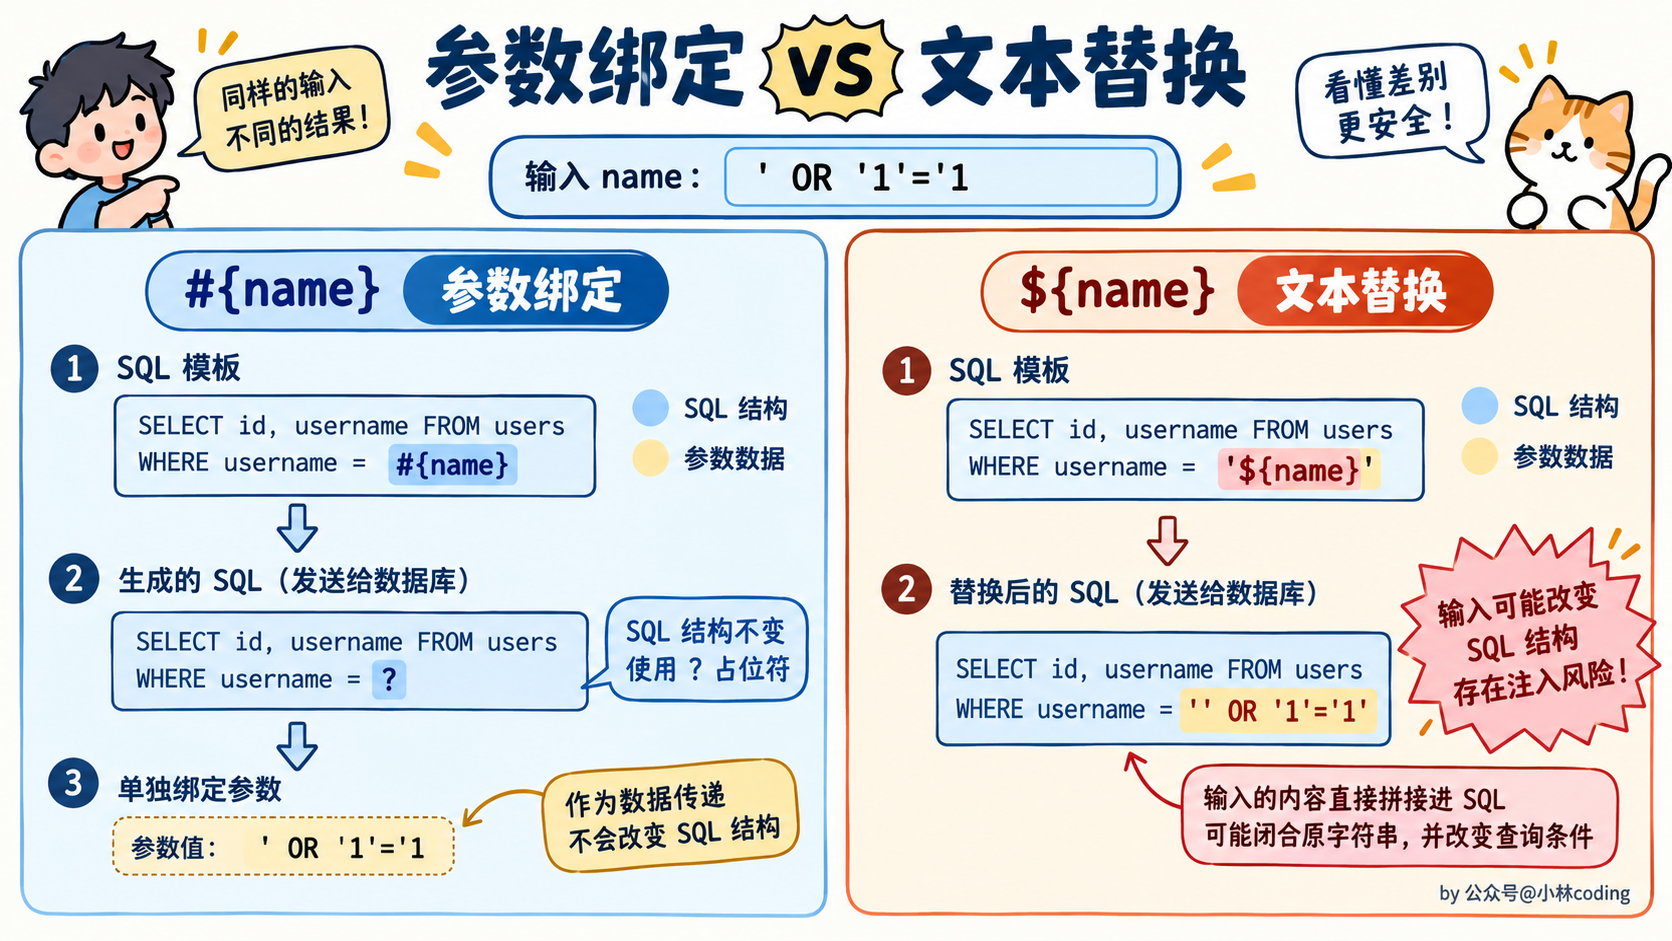
比如:
<select id="selectByName" resultType="com.example.model.User">
    SELECT id, username FROM users WHERE username = #{name}
</select>
这里生成的 SQL 类似 WHERE username = ?,不需要手动给 #{name} 再加引号。
那为什么还需要 ${}?因为表名、列名、排序方向这些属于 SQL 结构,不能直接用 ? 当成标识符。确实需要动态选择时,应该使用服务端白名单或 <choose> 等方式限定允许的选项,不能直接把用户传入的字符串拼进去。
面试时还可以补一句:#{} 不代表所有 SQL 都一定更快,性能还和数据库、驱动和执行计划有关;它最关键的价值是正确进行参数绑定,降低参数值导致 SQL 注入的风险。
# MyBatis的执行流程是什么?
MyBatis 的核心是把 Mapper 方法调用转换成 SQL 执行,再把结果映射成 Java 对象。
大致流程可以分成两部分:
- 启动时:读取配置和 Mapper 映射,把每条 SQL 的信息封装成 MappedStatement,统一放在 Configuration 中,再创建 SqlSessionFactory。
- 执行时:获取 SqlSession 和 Mapper 代理,调用接口方法时,由 MapperProxy 找到对应的 SQL 定义,交给执行器执行。
一次普通查询的主要链路是:
Mapper 代理 → SqlSession → Executor → StatementHandler → JDBC → ResultSetHandler。
其中:
- Executor:负责执行调度,并处理一级缓存;开启二级缓存时还会有 CachingExecutor 包装。
- StatementHandler:准备和执行 JDBC Statement。
- ParameterHandler:设置 SQL 参数,结合 TypeHandler 完成 Java 类型和 JDBC 类型的转换。
- ResultSetHandler:按 resultType 或 resultMap 把结果映射成对象。
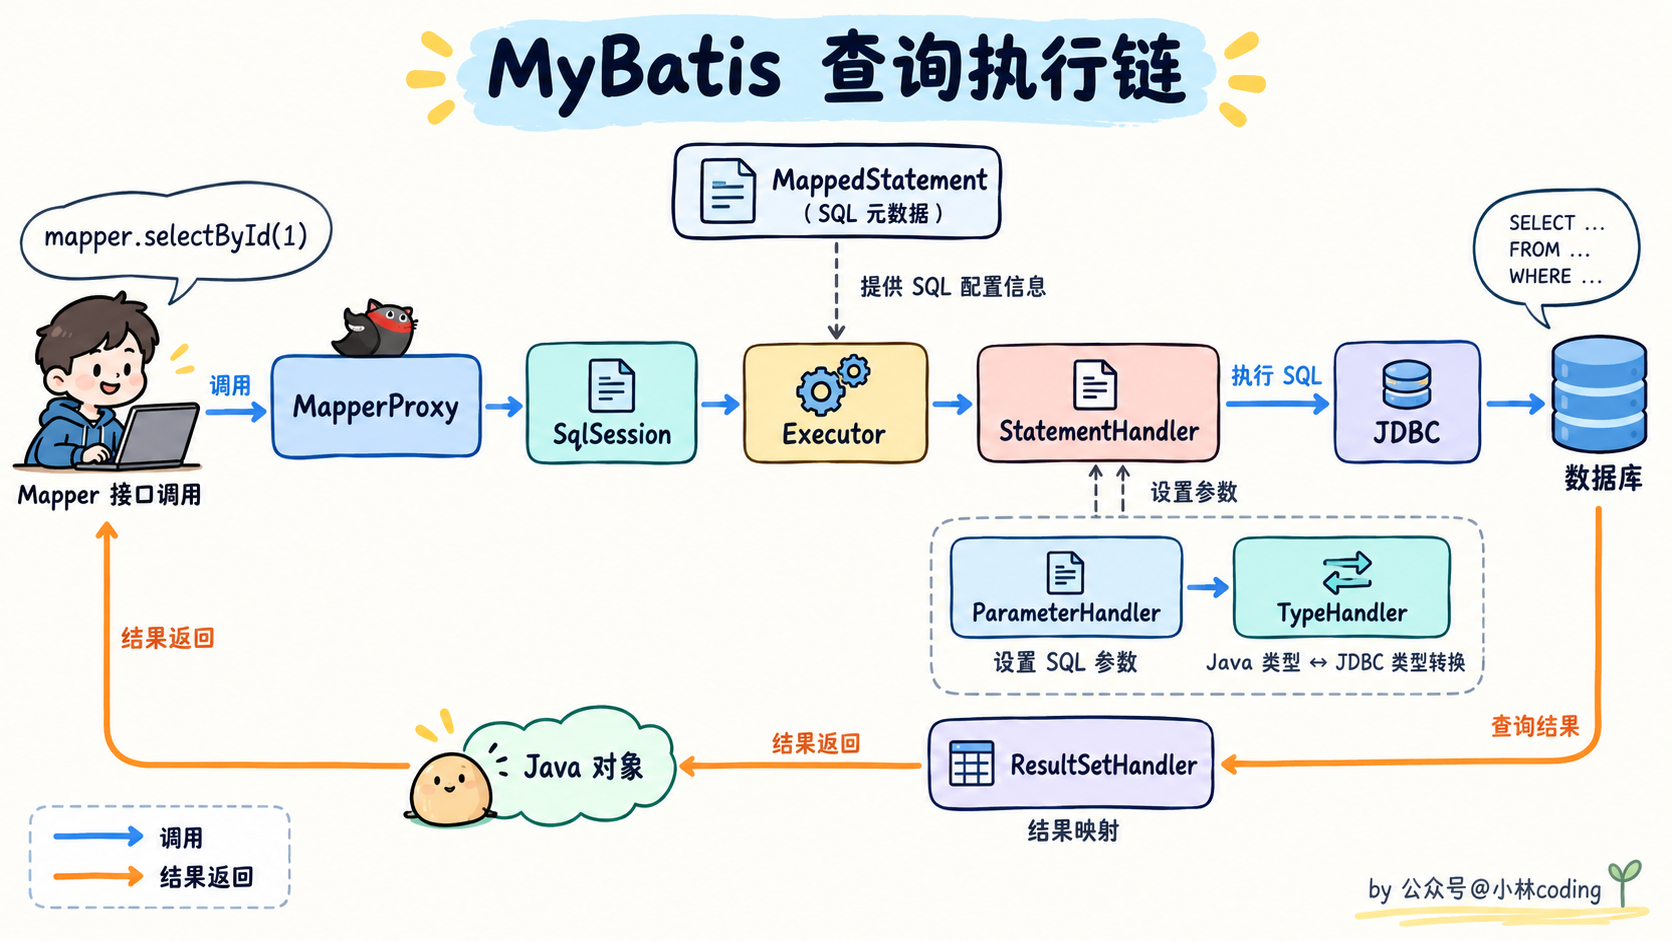
所以 Mapper 接口没有实现类也能调用,是因为运行时拿到的是代理对象,而不是 MyBatis 替我们生成了一份手写风格的 DAO 源码。
# MyBatis的一级缓存和二级缓存有什么区别?
一级缓存属于 SqlSession,二级缓存通常属于 Mapper 的 namespace。
- 一级缓存:默认启用,默认作用范围是 SESSION。同一个 SqlSession 内重复执行相同查询,如果缓存键一致,期间没有触发清理,通常可以复用结果。缓存键不只是 SQL,还包括语句标识、参数、分页信息等。更新、提交、回滚、关闭会话或显式清理等操作会清理本地缓存,也可以配置
localCacheScope=STATEMENT缩小复用范围。 - 二级缓存:需要满足全局缓存开关以及 Mapper 的
<cache/>、@CacheNamespace等配置,才会参与查询。它可以跨 SqlSession 共享结果,常见情况下会在会话提交后发布缓存结果;具体关闭行为还取决于会话是否需要提交或回滚。回滚事务的修改不能当成已提交结果发布。
开启二级缓存后,典型查询路径是:二级缓存 → 一级缓存 → 数据库,但前提是这条语句允许使用对应缓存。
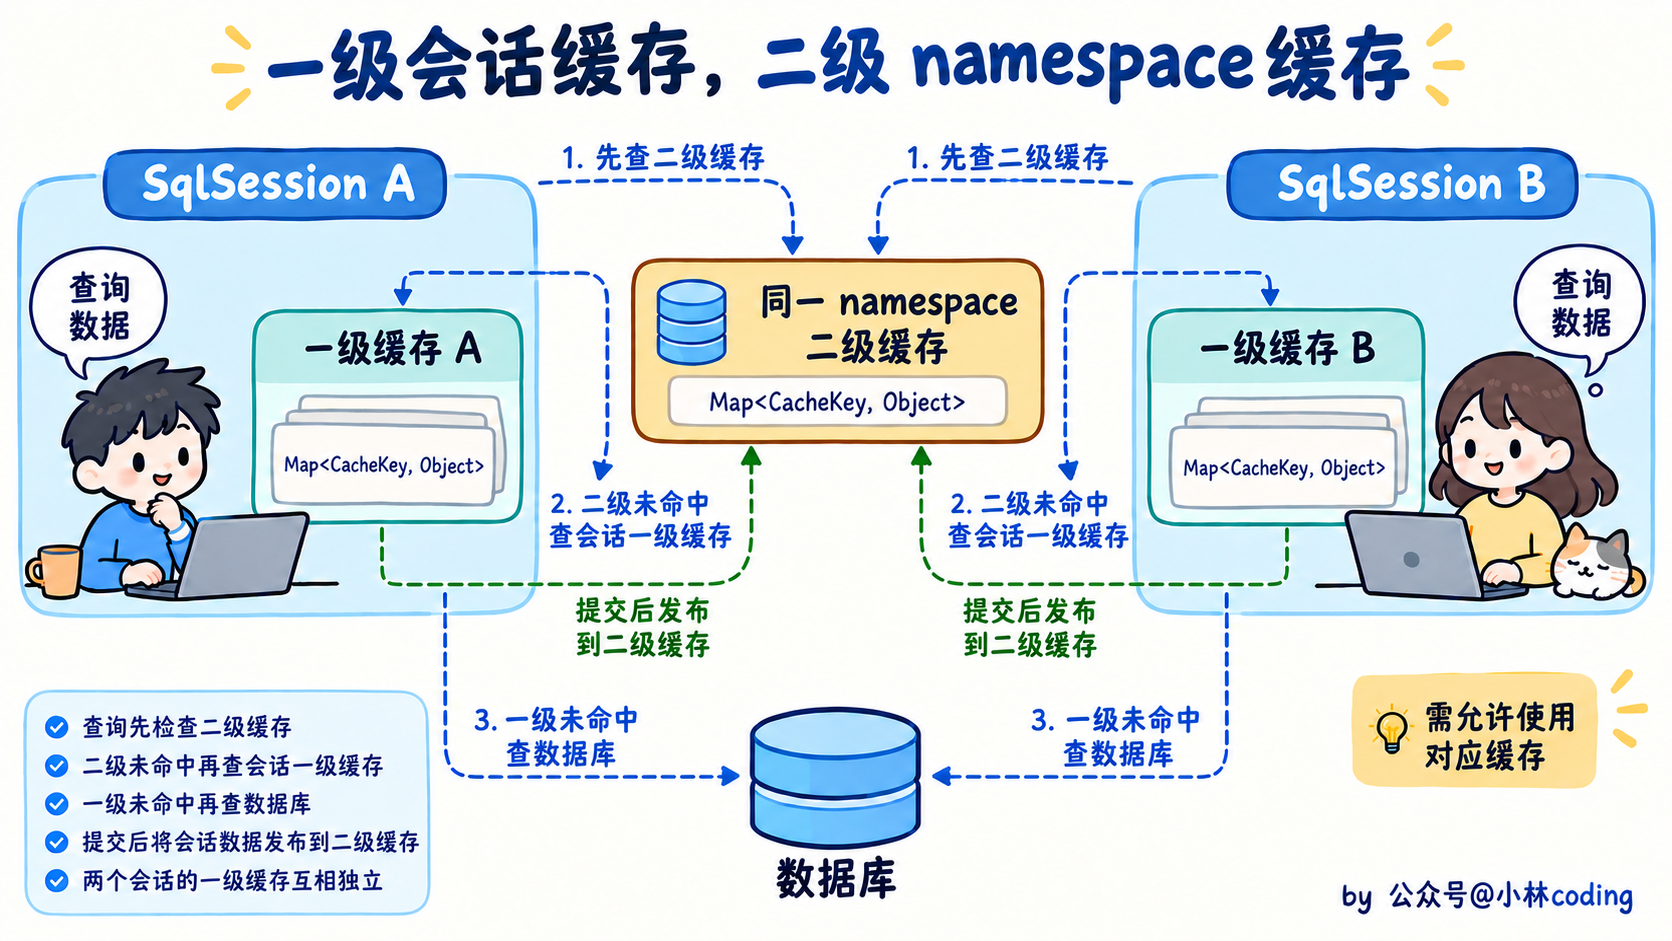
和 Spring 整合时还要注意:Mapper 多次调用不一定使用同一个底层 SqlSession。在同一个 Spring 事务内,通常会复用事务绑定的会话;没有事务时,会话可能在每次调用后关闭,所以不能只看 Mapper 对象相同就认定一级缓存会命中。
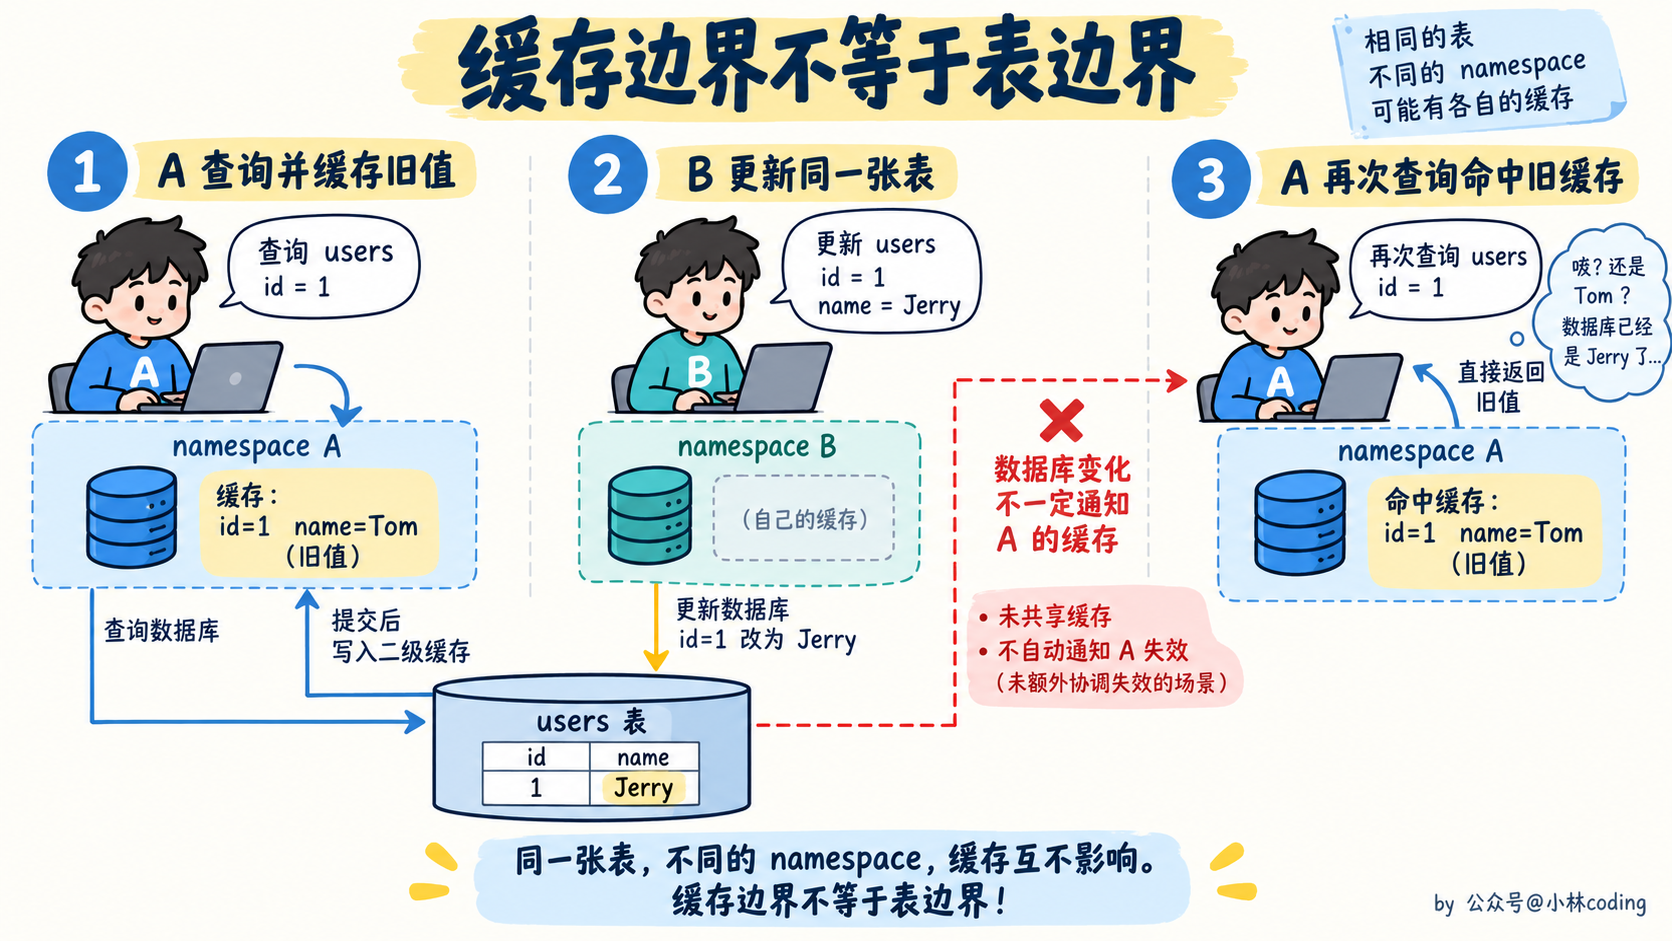
二级缓存也有一致性边界:一个 namespace 下的更新通常只清理关联的缓存,其他 Mapper 或外部程序修改同一张表,不一定会让这里的缓存失效。所以对更新频繁、跨表关联复杂的数据,不能随意开启二级缓存,更不能把它直接当成 Redis 那样的跨进程共享缓存。
# resultType 和 resultMap 有什么区别?
resultType 用于指定结果对象类型,resultMap 用于显式定义字段与对象属性之间的映射关系。
如果字段名和属性名一致,或者通过 SQL 别名、开启下划线转驼峰就能对应,使用 resultType 比较方便。MyBatis 会根据自动映射规则填充属性,并不是不需要任何映射过程。
如果字段与属性差异较大,或者涉及一对一、一对多等复杂结果,就适合用 resultMap:
id、result:定义普通字段映射,id 还可以帮助识别结果对象。association:映射一个关联对象。collection:映射关联集合,比如用户的多个角色。
同一个查询通常选择 resultType 或 resultMap 其中一个,不同时配置。
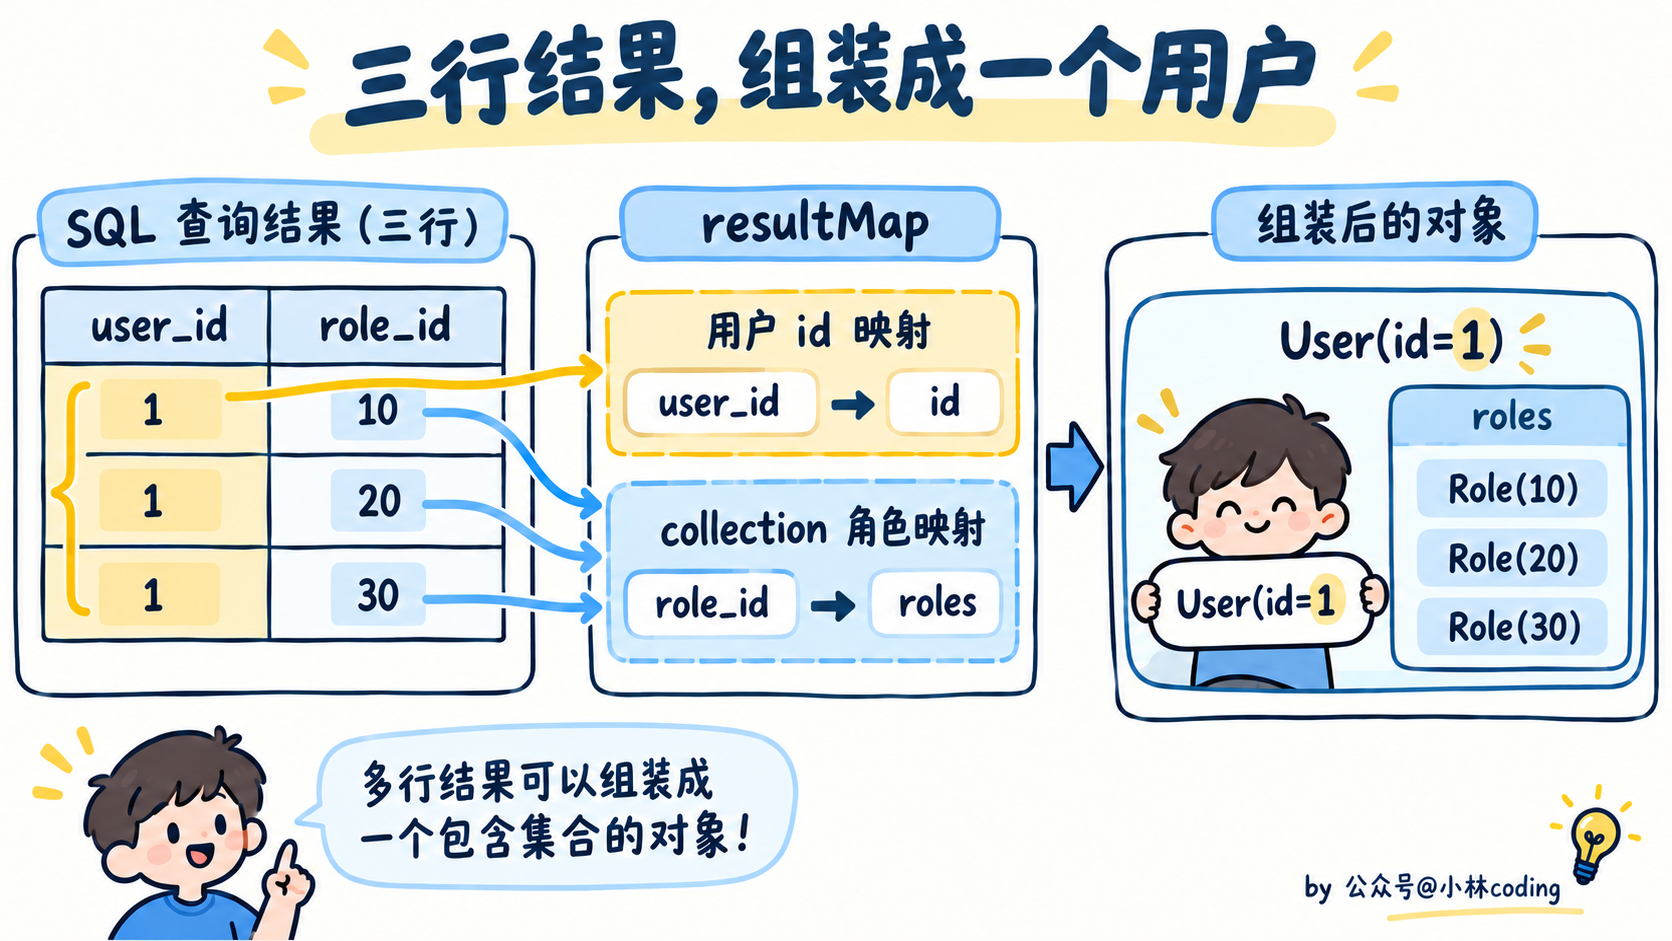
还要留意一对多查询的 N+1 问题:先查询 N 个用户,再给每个用户单独查一次角色,就可能执行 N+1 次查询。可以根据场景用关联查询映射结果,或者批量查询后组装;开启延迟加载只会推迟查询时间,不一定减少最终的查询次数。
# MybatisPlus和Mybatis的区别?
MybatisPlus是一个基于MyBatis的增强工具库,旨在简化开发并提高效率。以下是MybatisPlus和MyBatis之间的一些主要区别:
- CRUD操作:MybatisPlus通过继承BaseMapper接口,提供了一系列内置的快捷方法,使得CRUD操作更加简单,无需编写重复的SQL语句。
- 代码生成器:MybatisPlus提供了代码生成器功能,可以根据数据库表结构自动生成实体类、Mapper接口以及XML映射文件,减少了手动编写的工作量。
- 通用方法封装:MybatisPlus封装了许多常用的方法,如条件构造器、排序、分页查询等,简化了开发过程,提高了开发效率。
- 分页插件:MybatisPlus内置了分页插件,支持各种数据库的分页查询,开发者可以轻松实现分页功能,而在传统的MyBatis中,需要开发者自己手动实现分页逻辑。
- 多租户支持:MybatisPlus提供了多租户的支持,可以轻松实现多租户数据隔离的功能。
- 注解支持:MybatisPlus引入了更多的注解支持,使得开发者可以通过注解来配置实体与数据库表之间的映射关系,减少了XML配置文件的编写。
# MyBatis运用了哪些常见的设计模式?
比较典型的有下面这些:
- 建造者模式:SqlSessionFactoryBuilder、XMLConfigBuilder 等,负责解析配置并逐步构建所需对象。
- 工厂模式:SqlSessionFactory 负责创建 SqlSession,MapperProxyFactory 负责创建 Mapper 代理。
- 代理模式:MapperProxy 用 JDK 动态代理把 Mapper 接口方法转换成 SQL 执行;延迟加载也会使用代理,具体实现要结合配置和版本。
- 组合模式:动态 SQL 里的 SqlNode 可以组合成树状结构,统一处理
<if>、<choose>等节点。 - 模板方法模式:BaseExecutor 定义部分执行流程,由 SimpleExecutor、ReuseExecutor、BatchExecutor 提供具体行为。
- 适配器模式:Log 接口把不同日志框架适配成统一的调用方式。
- 装饰器模式:缓存中的 LruCache 等装饰器,在基础缓存外面增加淘汰等能力;CachingExecutor 则在执行器外面增加二级缓存处理。
还可以提一下 ErrorContext:它通过 ThreadLocal 管理当前线程的错误上下文,不是整个 JVM 共享同一个可变上下文对象。面试时举两三个自己理解的例子,比罗列一长串模式更容易回答追问。
# SpringCloud
# 了解SpringCloud吗,说一下他和SpringBoot的区别
Spring Boot是用于构建单个Spring应用的框架,而Spring Cloud则是用于构建分布式系统中的微服务架构的工具,Spring Cloud提供了服务注册与发现、负载均衡、断路器、网关等功能。
两者可以结合使用,通过Spring Boot构建微服务应用,然后用Spring Cloud来实现微服务架构中的各种功能。
# 用过哪些微服务组件?
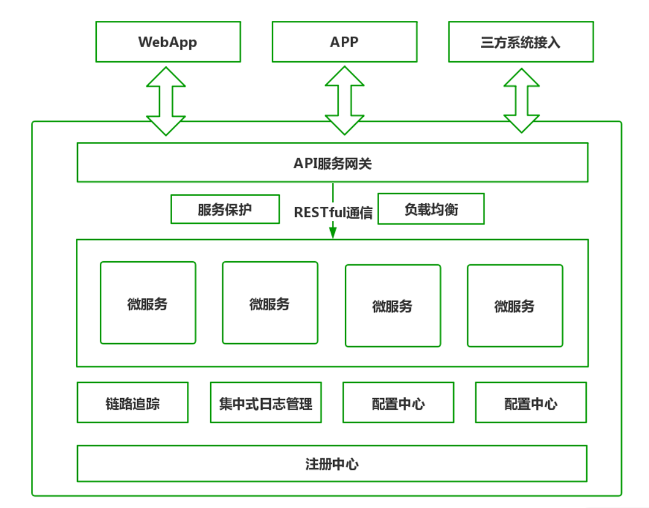
微服务常用的组件:
- 注册中心:注册中心是微服务架构最核心的组件。它起到的作用是对新节点的注册与状态维护,解决了「如何发现新节点以及检查各节点的运行状态的问题」。微服务节点在启动时会将自己的服务名称、IP、端口等信息在注册中心登记,注册中心会定时检查该节点的运行状态。注册中心通常会采用心跳机制最大程度保证已登记过的服务节点都是可用的。
- 负载均衡:负载均衡解决了「如何发现服务及负载均衡如何实现的问题」,通常微服务在互相调用时,并不是直接通过IP、端口进行访问调用。而是先通过服务名在注册中心查询该服务拥有哪些节点,注册中心将该服务可用节点列表返回给服务调用者,这个过程叫服务发现,因服务高可用的要求,服务调用者会接收到多个节点,必须要从中进行选择。因此服务调用者一端必须内置负载均衡器,通过负载均衡策略选择合适的节点发起实质性的通信请求。
- 服务通信:服务通信组件解决了「服务间如何进行消息通信的问题」,服务间通信采用轻量级协议,通常是HTTP RESTful风格。但因为RESTful风格过于灵活,必须加以约束,通常应用时对其封装。例如在SpringCloud中就提供了Feign和RestTemplate两种技术屏蔽底层的实现细节,所有开发者都是基于封装后统一的SDK进行开发,有利于团队间的相互合作。
- 配置中心:配置中心主要解决了「如何集中管理各节点配置文件的问题」,在微服务架构下,所有的微服务节点都包含自己的各种配置文件,如jdbc配置、自定义配置、环境配置、运行参数配置等。要知道有的微服务可能可能有几十个节点,如果将这些配置文件分散存储在节点上,发生配置更改就需要逐个节点调整,将给运维人员带来巨大的压力。配置中心便由此而生,通过部署配置中心服务器,将各节点配置文件从服务中剥离,集中转存到配置中心。一般配置中心都有UI界面,方便实现大规模集群配置调整。
- 集中式日志管理:集中式日志主要是解决了「如何收集各节点日志并统一管理的问题」。微服务架构默认将应用日志分别保存在部署节点上,当需要对日志数据和操作数据进行数据分析和数据统计时,必须收集所有节点的日志数据。那么怎么高效收集所有节点的日志数据呢?业内常见的方案有ELK、EFK。通过搭建独立的日志收集系统,定时抓取各节点增量日志形成有效的统计报表,为统计和分析提供数据支撑。
- 分布式链路追踪:分布式链路追踪解决了「如何直观的了解各节点间的调用链路的问题」。系统中一个复杂的业务流程,可能会出现连续调用多个微服务,我们需要了解完整的业务逻辑涉及的每个微服务的运行状态,通过可视化链路图展现,可以帮助开发人员快速分析系统瓶颈及出错的服务。
- 服务保护:服务保护主要是解决了「如何对系统进行链路保护,避免服务雪崩的问题」。在业务运行时,微服务间互相调用支撑,如果某个微服务出现高延迟导致线程池满载,或是业务处理失败。这里就需要引入服务保护组件来实现高延迟服务的快速降级,避免系统崩溃。
SpringCloud Alibaba实现的微服务架构:
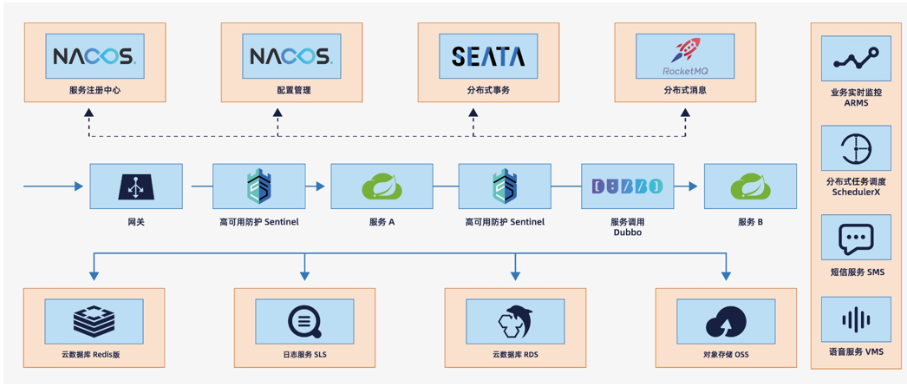
- SpringCloud Alibaba中使用Alibaba Nacos组件实现注册中心,Nacos提供了一组简单易用的特性集,可快速实现动态服务发现、服务配置、服务元数据及流量管理。
- SpringCloud Alibaba 早期复用 Ribbon 做客户端负载均衡,新版本(2020.x+)已切换为 Spring Cloud LoadBalancer,并可结合 Nacos 提供的权重、健康状态等元数据实现加权负载均衡(Nacos 主要承担注册中心 / 配置中心角色,真正的负载均衡仍由客户端组件完成)。
- SpringCloud Alibaba 可以使用 Spring Cloud OpenFeign 和 Apache Dubbo 相关集成组件来实现服务通信,前者与 SpringCloud 采用了相同的方案,后者则是对自家的 RPC 框架 Dubbo 也给予支持,为服务间通信提供另一种选择。
- SpringCloud Alibaba 在API服务网关组件中,使用与SpringCloud相同的组件,即:SpringCloud Gateway。
- SpringCloud Alibaba在配置中心组件中使用Nacos内置配置中心,Nacos内置的配置中心,可将配置信息存储保存在指定数据库中
- SpringCloud Alibaba在原有的ELK方案外,还可以使用阿里云日志服务(LOG)实现日志集中式管理。
- 较早的项目常使用 Sleuth + Zipkin 做链路追踪;Spring Boot 3.x 及对应的新一代生态主要转向 Micrometer Tracing,可以结合 Zipkin 或 OpenTelemetry 等方案。要根据项目版本说明,不能把 Sleuth 当成所有版本通用的组件。
- SpringCloud Alibaba 可以使用 Sentinel 做流量控制、熔断降级等服务保护。具体组件组合还要匹配 Spring Boot、Spring Cloud 和 Spring Cloud Alibaba 的版本。
# 负载均衡有哪些算法?
- 简单轮询:将请求按顺序分发给后端服务器上,不关心服务器当前的状态,比如后端服务器的性能、当前的负载。
- 加权轮询:根据服务器自身的性能给服务器设置不同的权重,将请求按顺序和权重分发给后端服务器,可以让性能高的机器处理更多的请求
- 简单随机:将请求随机分发给后端服务器上,请求越多,各个服务器接收到的请求越平均
- 加权随机:根据服务器自身的性能给服务器设置不同的权重,将请求按各个服务器的权重随机分发给后端服务器
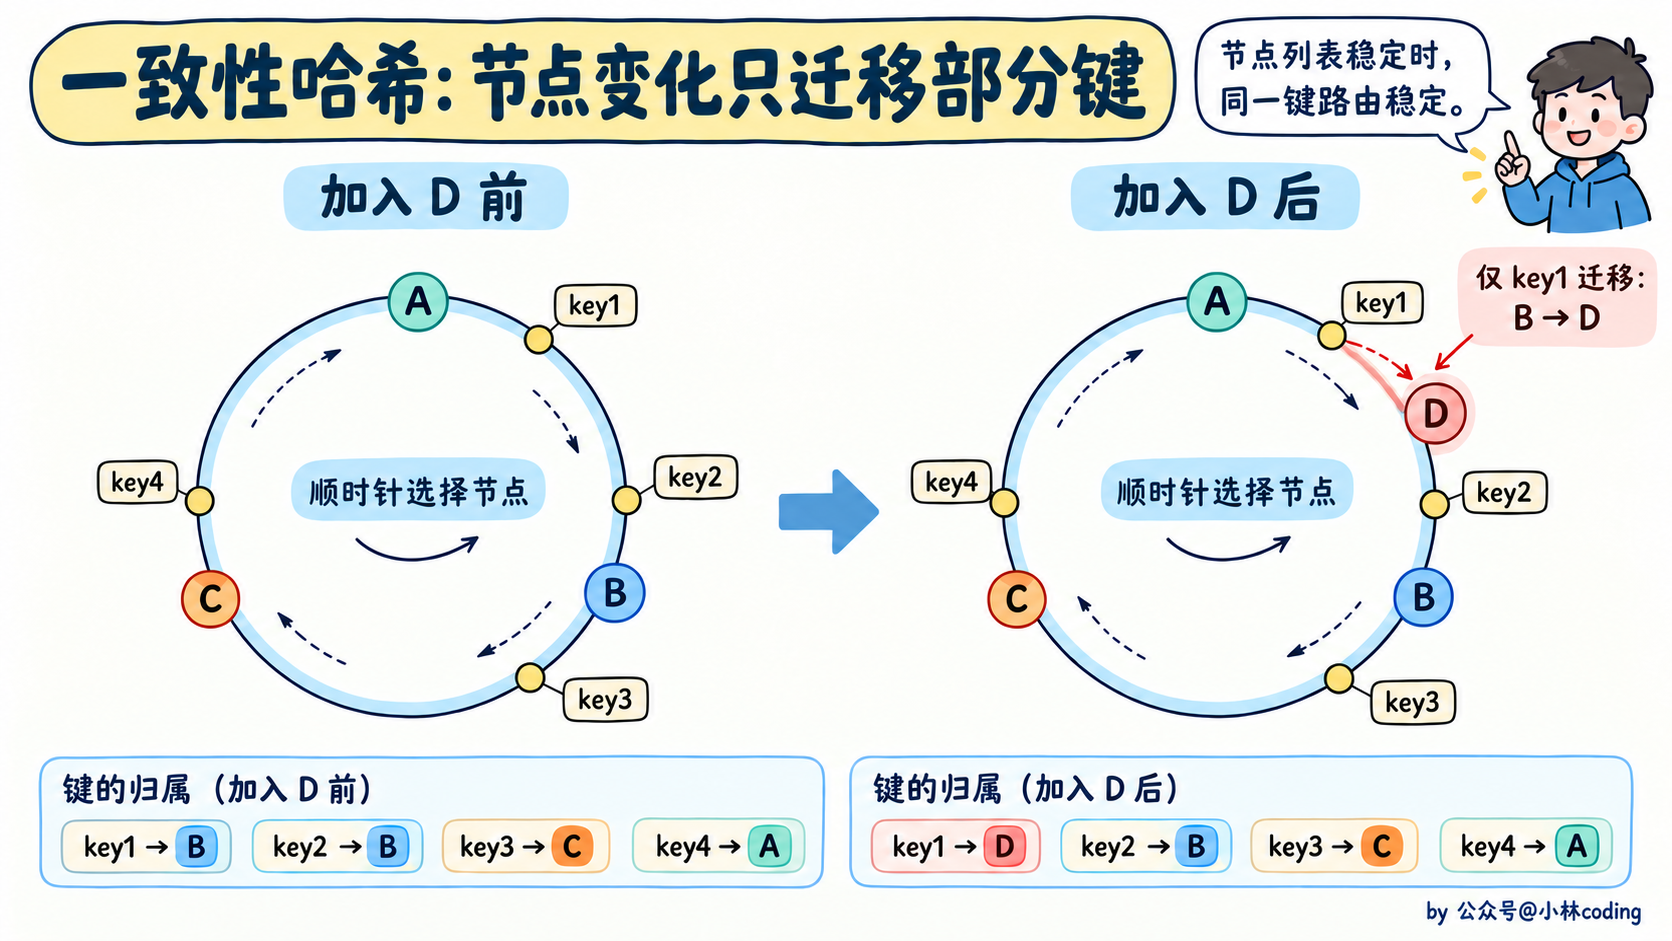
- 一致性哈希:把节点和请求键映射到同一个哈希环上,按环上的位置选择节点,通常配合虚拟节点改善分布。节点列表不变时,同一个键会落到同一个节点;节点增减时,通常只需要迁移部分键,区别于直接按节点数量取模
- 最小活跃数:统计每台服务器上当前正在处理的请求数,也就是请求活跃数,将请求分发给活跃数最少的后台服务器
# 如何实现一直均衡给一个用户?
如果意思是让同一个用户的请求尽量落到同一台服务器,一般叫会话保持或粘性会话。
可以使用用户 id、会话标识等稳定的键做一致性哈希,把请求映射到哈希环上的节点。相比直接按服务器数量取模,一致性哈希在节点增减时通常只改变部分键的映射。
但不能保证永远不变:节点下线、故障切换或路由规则变化时,用户也可能被分配到其他节点。客户端 IP 也不一定适合作为用户标识,因为多个用户可能共享出口 IP,用户自己的网络还可能变化。
如果这样做只是为了把登录状态保存在某一台机器上,我会优先考虑把服务做成无状态,使用共享的会话存储或令牌方案,减少对固定节点的依赖。
# 介绍一下服务熔断
服务熔断是一种防止下游故障持续拖垮上游的保护机制,可以把它理解成调用链上的保险丝。
比如 A 调用 B,B 调用 C。C 如果一直响应很慢,B 的线程、连接等资源可能被占满,进而影响 A,这就是服务雪崩的一种形成过程。
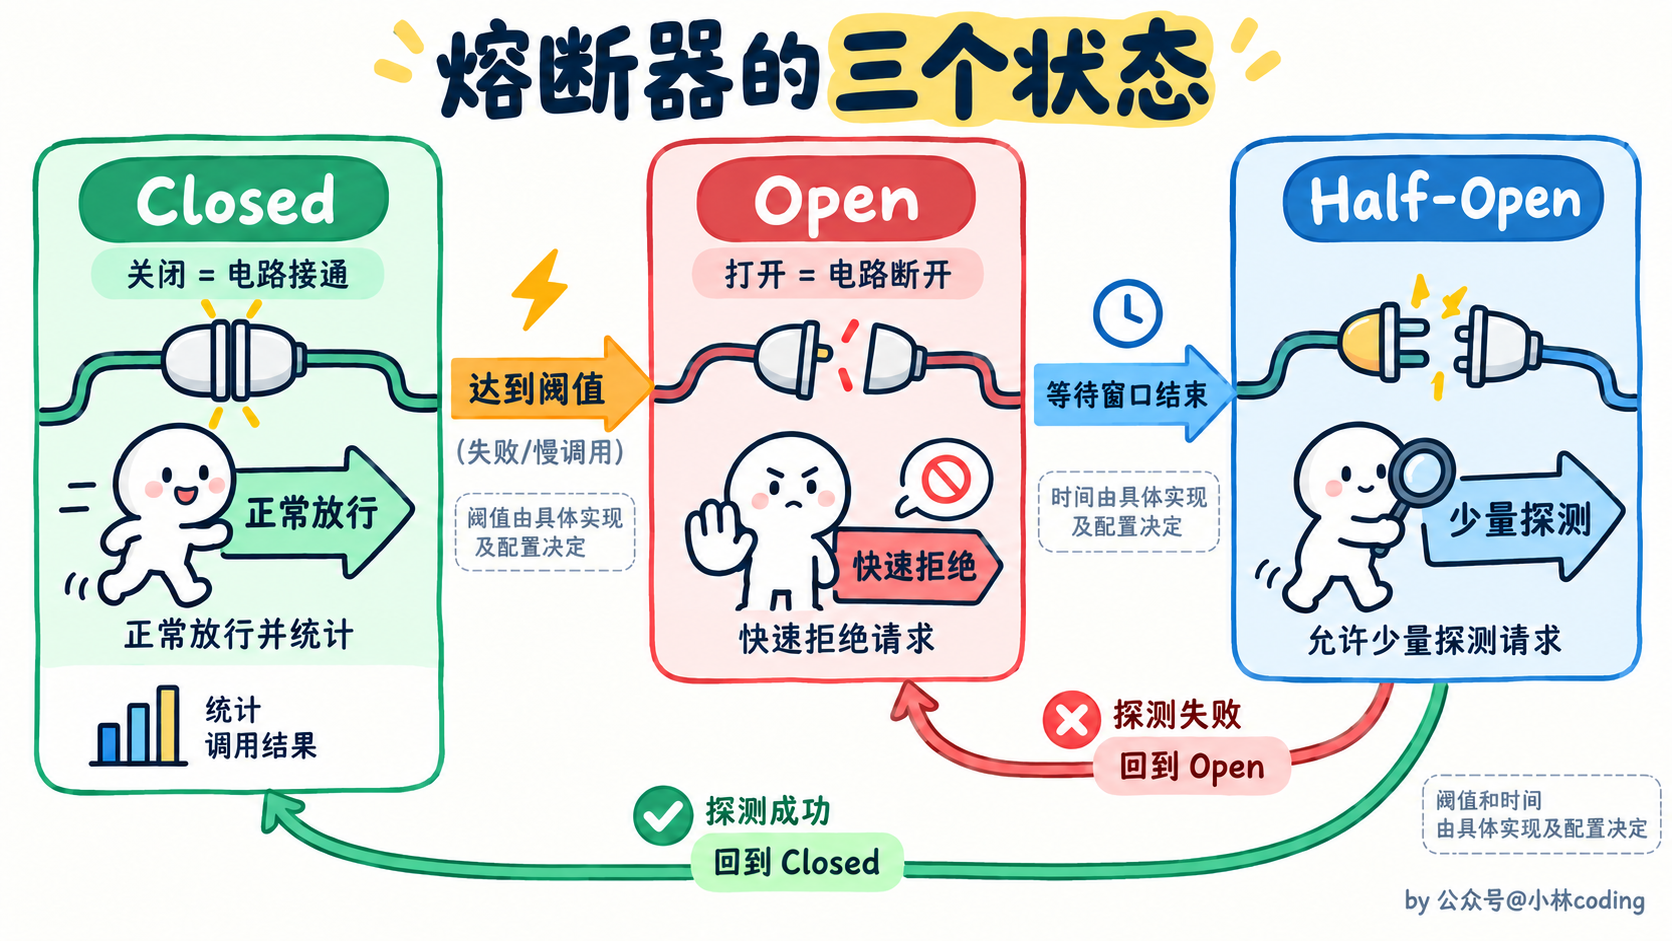
熔断器会统计一段时间内的失败率、慢调用等指标,达到配置条件后,暂时拒绝继续调用下游,让请求快速失败或进入降级逻辑。
一般有三个状态:
- 关闭(Closed):正常放行请求,同时统计调用结果。
- 打开(Open):达到阈值后拒绝请求,避免持续消耗资源。
- 半开(Half-Open):等待一段时间后允许少量探测请求,成功达到条件就恢复关闭,失败则重新打开。
这里的“关闭”是电路接通、“打开”是电路断开,别和中文里“开服务、关服务”的习惯混淆。
Spring Cloud 项目可以通过 Spring Cloud CircuitBreaker 结合 Resilience4j 等实现,Spring Cloud Alibaba 项目也常用 Sentinel。Hystrix 是较早的常见方案,已经进入维护状态,不能把 Spring Cloud 的熔断机制等同于 Hystrix。
最后,熔断通常不能替代超时控制和资源隔离。先设置合理的调用超时,再结合隔离、熔断和降级,才能避免故障请求长时间占住上游资源。
# 介绍一下服务降级
服务降级一般是指在服务器压力剧增的时候,根据实际业务使用情况以及流量,对一些服务和页面有策略的不处理或者用一种简单的方式进行处理,从而释放服务器资源,以保证核心业务的正常运行。
服务器的资源是有限的,而请求是无限的。在用户访问的并发高峰期,会影响整体服务的性能,严重的话会导致宕机,以至于某些重要服务不可用。故高峰期为了保证核心功能服务的可用性,就需要对某些服务降级处理。可以理解为舍小保大
服务降级是从整个系统的负荷情况出发和考虑的,对某些负荷会比较高的情况,为了预防某些功能(业务场景)出现负荷过载或者响应慢的情况,在其内部暂时舍弃对一些非核心的接口和数据的请求,而直接返回一个提前准备好的fallback(退路)错误处理信息。这样,虽然提供的是一个有损的服务,但却保证了整个系统的稳定性和可用性。
# 限流、熔断和降级有什么区别?
这三个概念经常一起使用,但它们解决的问题不同:
- 限流:控制进入系统的请求量,避免超过处理能力。比如接口每秒只允许一定数量的请求,超出的请求直接拒绝或按策略等待。
- 熔断:发现下游服务异常时,暂时切断调用,让请求快速失败,避免故障继续扩散。
- 降级:在资源紧张或依赖失败时,提供简化结果,优先保住核心业务。比如推荐服务不可用时返回默认推荐列表。
举个例子,商品详情页流量突然增大,可以先限流;推荐服务持续超时,可以对它熔断;页面仍然展示商品信息,同时返回默认推荐,这就是降级。
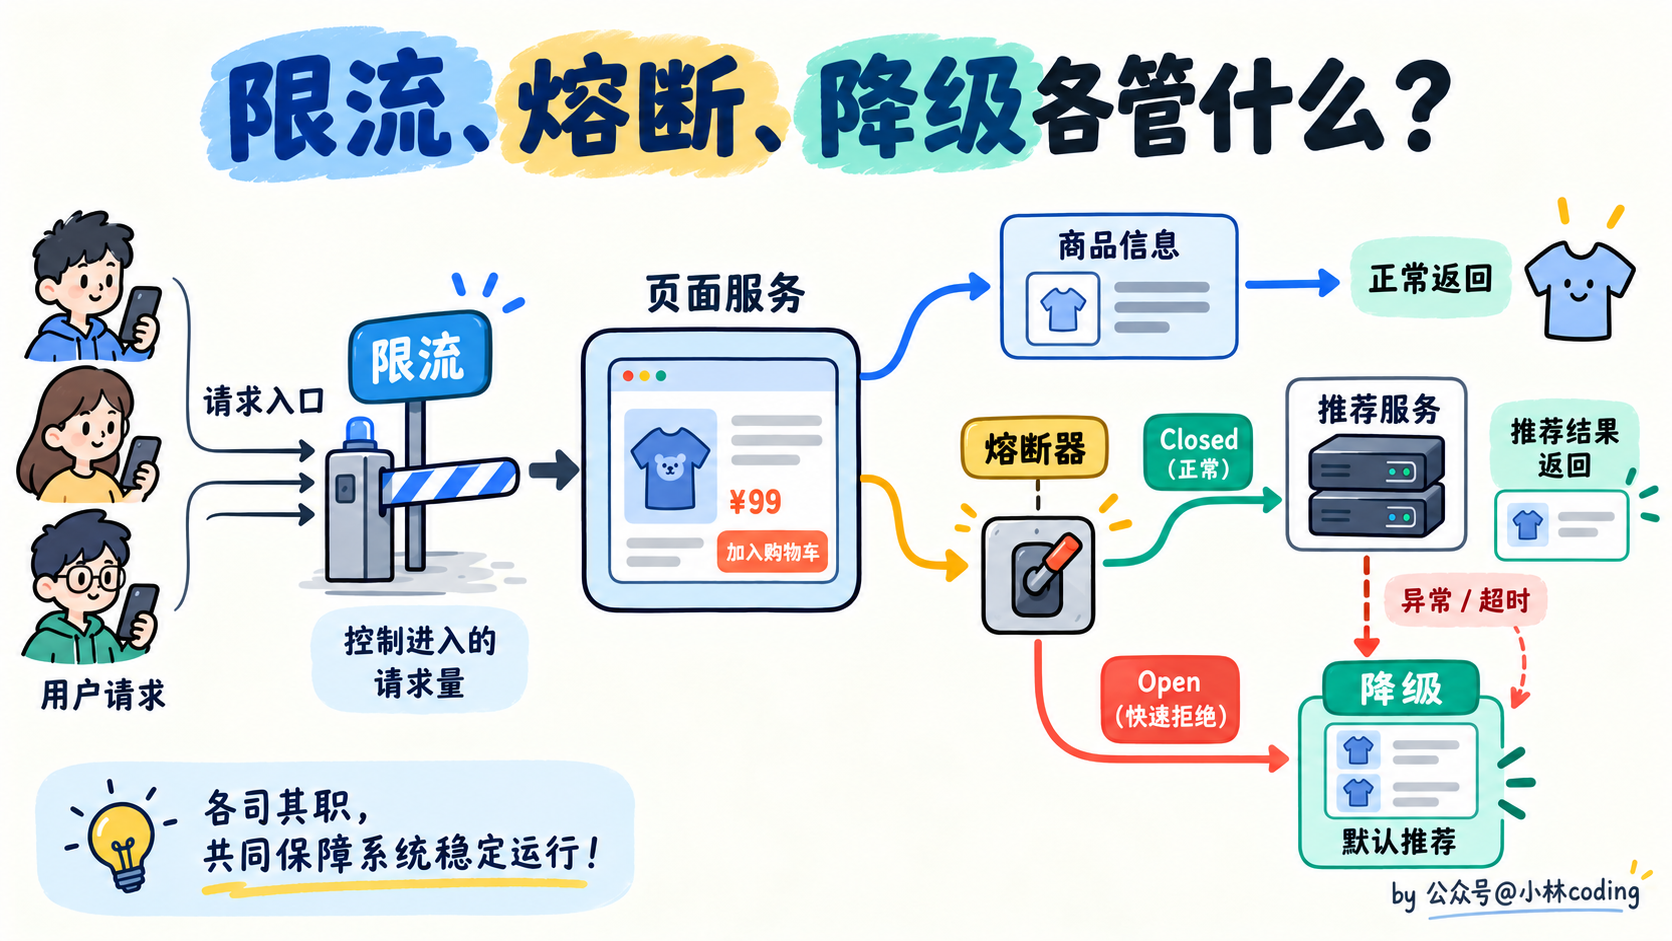
熔断可以触发降级,但降级不一定由熔断触发,也可以因为超时、异常、限流或主动关闭非核心功能而触发。对于扣款、下单这类关键操作,不能随便用降级结果伪装成操作成功。
# 微服务调用失败后,能不能直接重试?
不能无条件重试,要先判断失败原因、操作是否幂等,以及重试会不会放大故障。
比如查询商品信息,遇到短暂网络波动时可以做有限重试;但创建订单、扣款等写操作,如果只是响应超时,请求可能已经在下游执行成功,再发一次就可能重复处理。
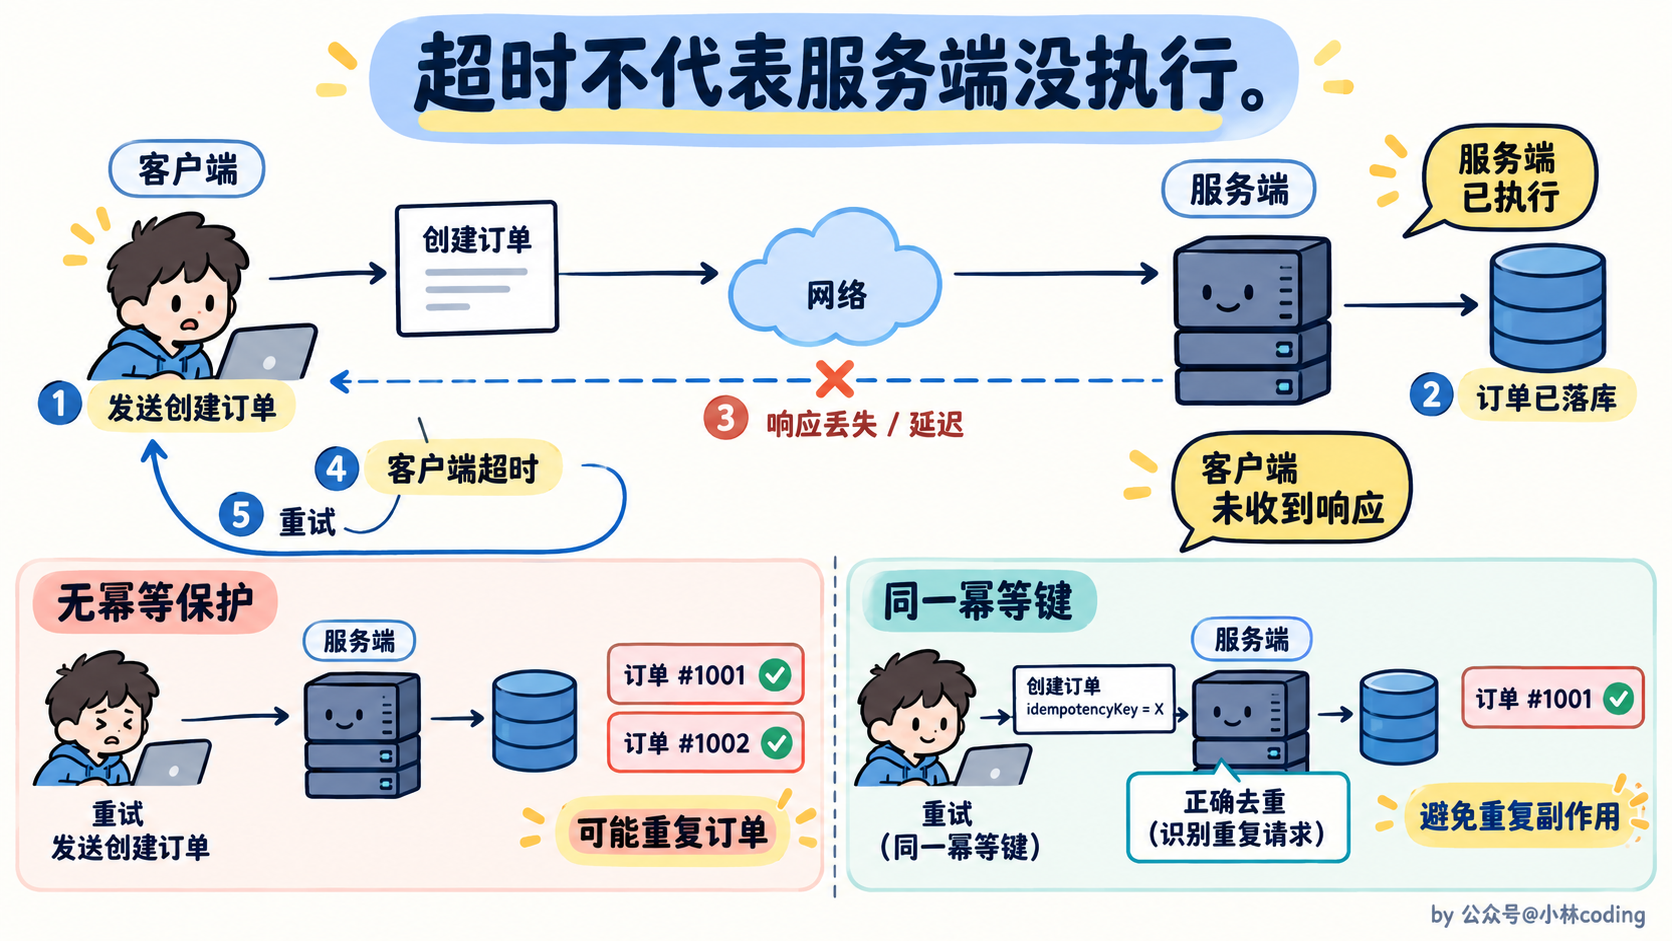
一般需要注意这么几个点:
- 设置超时和次数上限:重试要放在整体超时预算里,不能每次都无限等待。
- 区分可重试的失败:短暂连接故障和参数错误的处理方式不同,明确的业务校验失败通常不应该重试。
- 保证幂等:写操作可以使用业务唯一键、幂等令牌等,让重复请求不会产生重复副作用。
- 退避并增加随机间隔:避免大量请求在同一时间立即重试,进一步压垮下游。
- 避免多层叠加重试:网关、调用客户端、业务代码如果都重试,最终请求次数可能成倍放大。
所以重试是恢复短暂故障的一种手段,必须和超时、幂等、熔断一起设计。不能只因为“调用报错了”,就认定下游没有执行。
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。
← Java虚拟机面试题 C++面试题 →