# Java并发编程面试题
大家好,我是小林。
Java 并发编程是面试里的重头戏,尤其是中高级岗位,这块几乎是必考的。很多人平时工作里用的多线程场景不多,或者用了但没深究原理,到了面试就容易被问住。这块知识点比较分散,从底层的内存模型到上层的线程池配置,跨度很大,但只要理清楚主线,其实是很有逻辑的。
这篇文章整理了 Java 并发面试中最常被问到的知识点,涵盖多线程基础、并发安全机制、锁原理、线程池,以及一些常见的并发场景题。内容偏向原理理解,不是让你背 API,而是帮你搞清楚"这东西为什么这么设计"。
有几块是面试里的高频区域,建议重点投入:
- synchronized 和 ReentrantLock:两者的区别、传统 HotSpot 中的锁升级过程及不同 JDK 版本的变化、以及 AQS 是什么、怎么实现的,这条线是并发面试的核心主线。
- volatile 和 CAS:volatile 解决了什么问题、为什么不能保证原子性、CAS 的原理和 ABA 问题,这些问题入门好答,但深挖起来很多人答不全。
- ThreadLocal:用途、底层 ThreadLocalMap 的实现、为什么会内存泄漏、怎么避免,这个在面试里出现频率越来越高。
- 线程池:核心参数的含义、任务提交后的执行流程、几种拒绝策略的区别、以及常见的线程池类型,这块是工程实践和面试的双重重点。
- 死锁:死锁的四个必要条件、怎么排查、怎么避免,这是个老题,但每次还是会考。
如果你是第一次系统准备这块,建议先搞清楚 JMM 和 synchronized 的原理,再去看 AQS 和线程池,这样整体脉络会更清晰,后面的内容理解起来也会快很多。
# 多线程
# Java 的内存模型(JMM)介绍一下
JMM,也就是 Java 内存模型,是 Java 定义的一套多线程访问共享变量的规则。简单说,就是规定了一个线程修改共享变量后,其他线程什么时候能看到,以及哪些操作的先后顺序是有保证的。
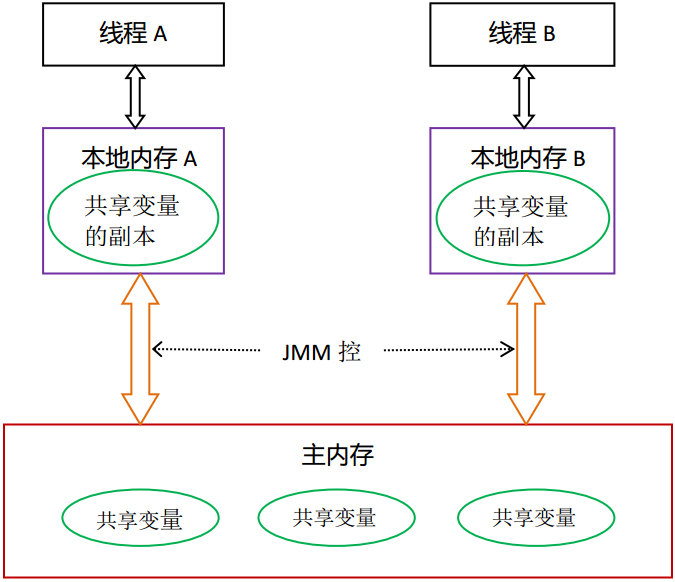
理解 JMM,主要看三个问题:可见性、原子性和有序性。
先说可见性。比如两个线程共享一个停止标志,线程 A 把标志改成了 true,希望线程 B 看到后结束循环。但如果没有同步措施,线程 B 就可能一直看不到这个变化。
为啥会这样?因为处理器有缓存,编译器也会做优化,线程读取共享变量时,不一定每次都能观察到其他线程的最新修改。
JMM 用主内存和工作内存来描述这种交互:共享变量存放在主内存中,线程通过自己的工作内存来操作变量。不过,这是一种抽象模型,不能把工作内存直接等同于 CPU 缓存,也不能把主内存直接等同于 JVM 堆。
对于停止标志这种场景,可以使用 volatile:
private volatile boolean stopped = false;

public void run() {
    while (!stopped) {
        // 执行任务
    }
}

public void stop() {
    stopped = true;
}
一个线程修改了 stopped,另一个线程后续读取这个变量时,就能观察到这次修改。
再说原子性。比如 i++,看着是一行代码,其实包含“读取 i、加 1、写回 i”三个步骤。如果两个线程都读到了 10,然后都把 11 写回去,就丢失了一次更新。
这时候只加 volatile 没用,因为它不能把这三个步骤变成一个不可分割的操作。可以使用 AtomicInteger,或者用 synchronized、ReentrantLock 把整个操作保护起来。使用锁时,相关线程必须遵守同一套加锁规则。
最后是有序性。编译器和处理器为了提高效率,可能调整指令的执行顺序,只要不改变单线程程序的执行结果就行。但在多线程环境下,这种调整可能让另一个线程看到不符合预期的状态,比如拿到了对象引用,对象却还没初始化完成。
JMM 通过 happens-before 规则来规定哪些操作之间具有可见性和顺序保证。面试里可以重点说几个:
- volatile 规则:对一个 volatile 变量的写,happens-before 后续对这个变量的读。
- 锁规则:对一把锁的解锁,happens-before 后续对同一把锁的加锁。
- 线程启动规则:调用线程的
start(),happens-before 被启动线程中的操作。 - 线程结束规则:线程中的操作,happens-before 另一个线程通过
join()成功等待它结束之后的操作。 - 传递性:如果 A happens-before B,B happens-before C,那么 A happens-before C。
这里要注意,happens-before 不代表底层指令一定按这个顺序执行,而是要求最终观察到的结果符合这些规则。所以也不能把 volatile 理解成禁止所有重排序,它限制的是会破坏这些保证的重排序。
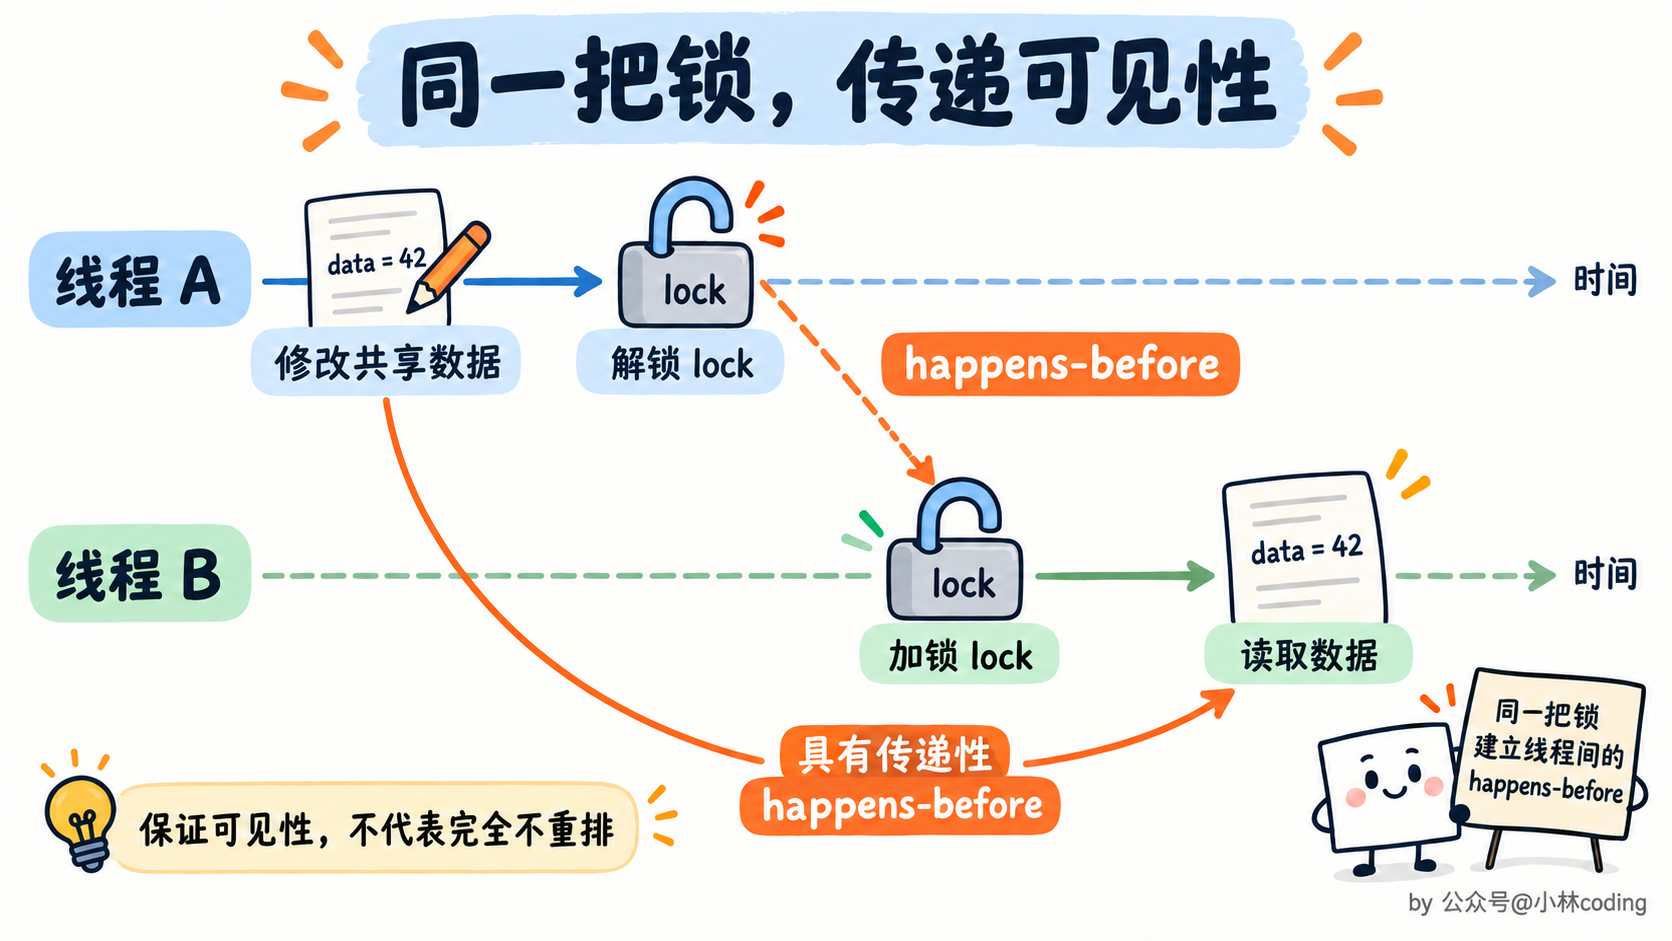
理解了这几个规则,就能明白为什么线程 A 在释放锁之前修改的数据,线程 B 拿到同一把锁之后能看到,也能明白为什么等待子线程 join() 返回后,可以读取它计算出来的结果。
# java多线程是什么?需要注意什么?
Java 多线程是指在一个 Java 程序中同时运行多个线程,这些线程共享程序的内存空间(如全局变量、方法区等),但有各自的栈和程序计数器,能同时执行不同的任务,比如一个线程处理用户输入,另一个线程后台下载文件,提升程序效率。
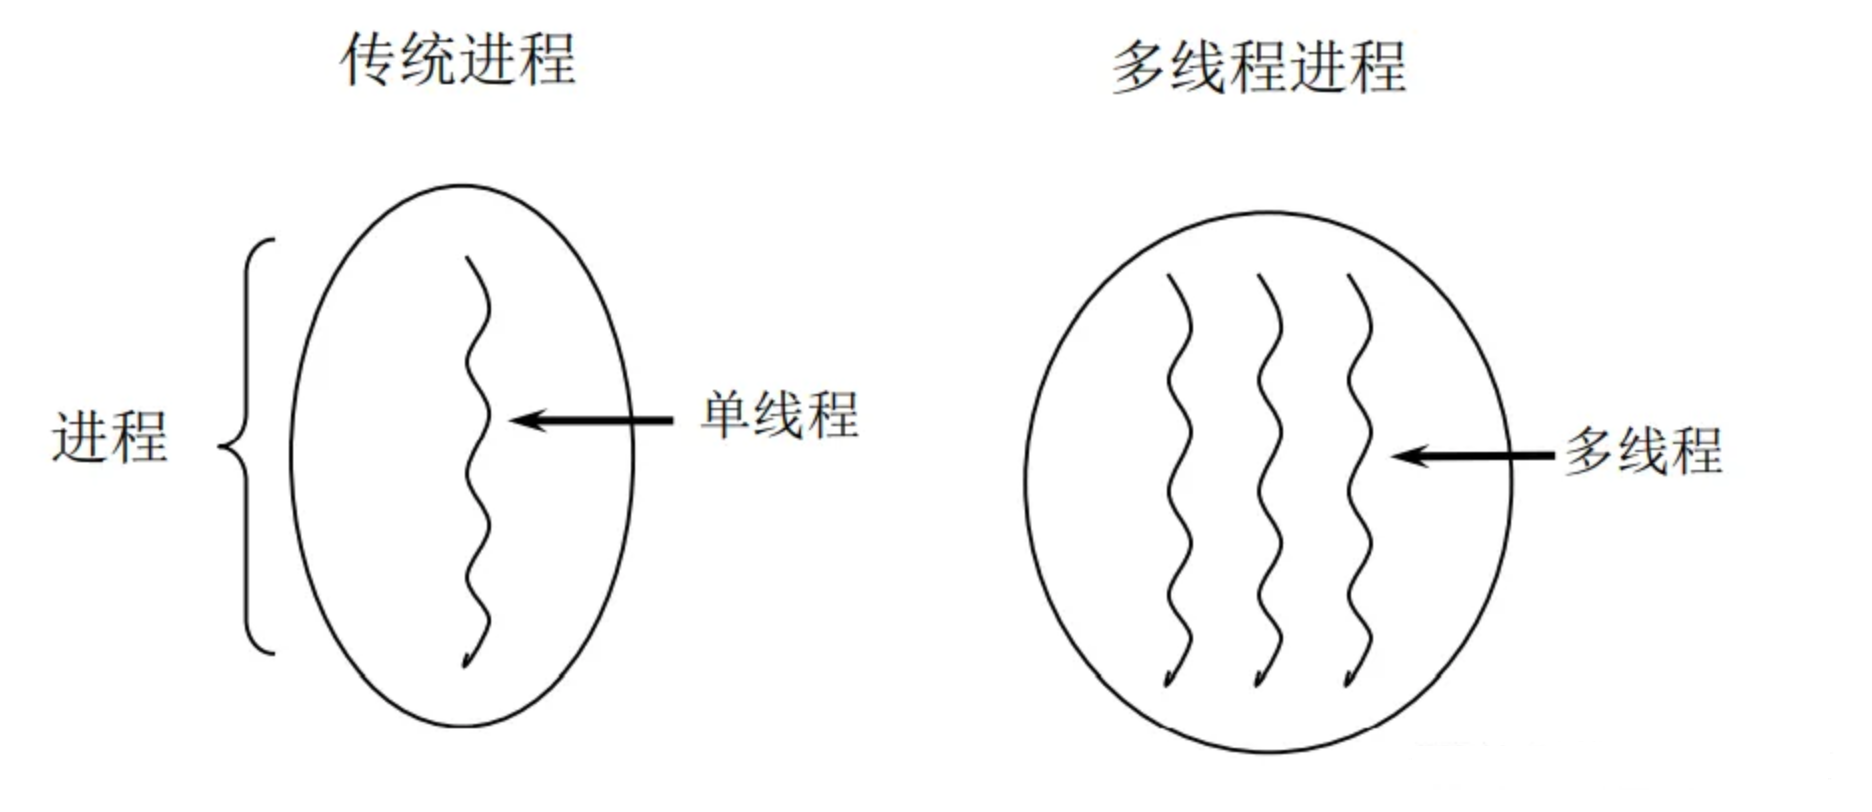
使用 Java 多线程需要注意以下几点:
- 首先是线程安全问题。多个线程同时操作共享数据时,可能出现错误。比如两个线程同时给一个变量加 1,原本该加 2,结果可能只加了 1,这是因为线程切换时没做好数据保护。需要用
synchronized关键字、Lock锁等方式,保证同一时间只有一个线程操作共享数据。 - 其次是线程间通信。线程需要协作时,比如一个线程生产数据,另一个线程消费数据,要通过
wait()、notify()等方法控制,避免出现一方没准备好,另一方就操作的情况,否则可能导致数据错误或线程无限等待。 - 然后是线程的创建和销毁成本。频繁创建和销毁线程会消耗系统资源,影响性能。可以用线程池管理线程,提前创建好一定数量的线程,重复使用,减少资源消耗。
# java里面的线程和操作系统的线程一样吗?
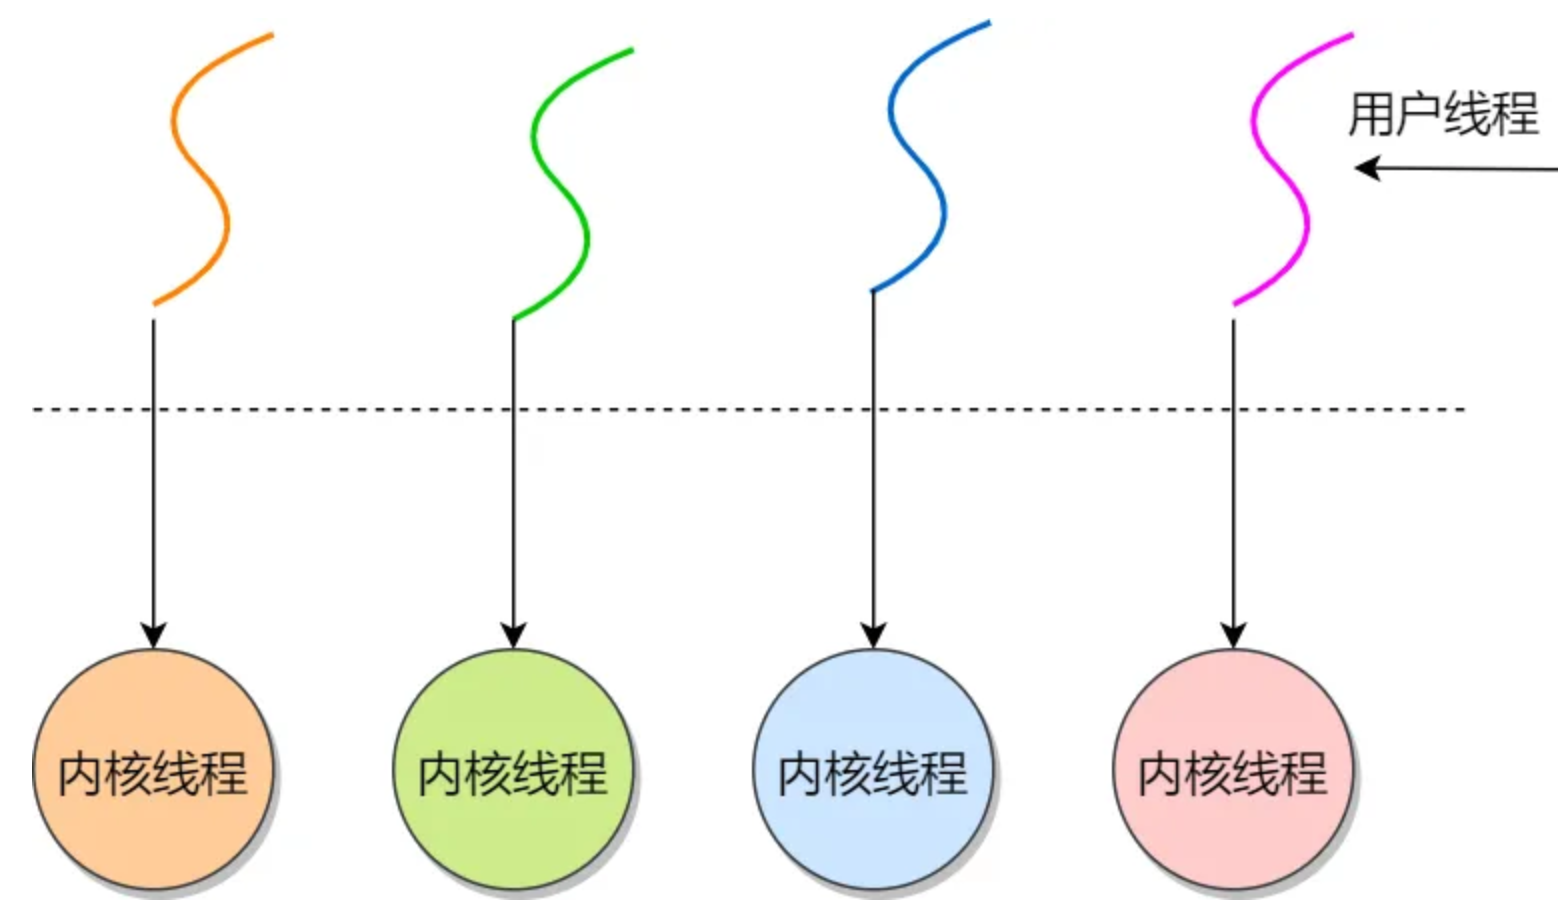
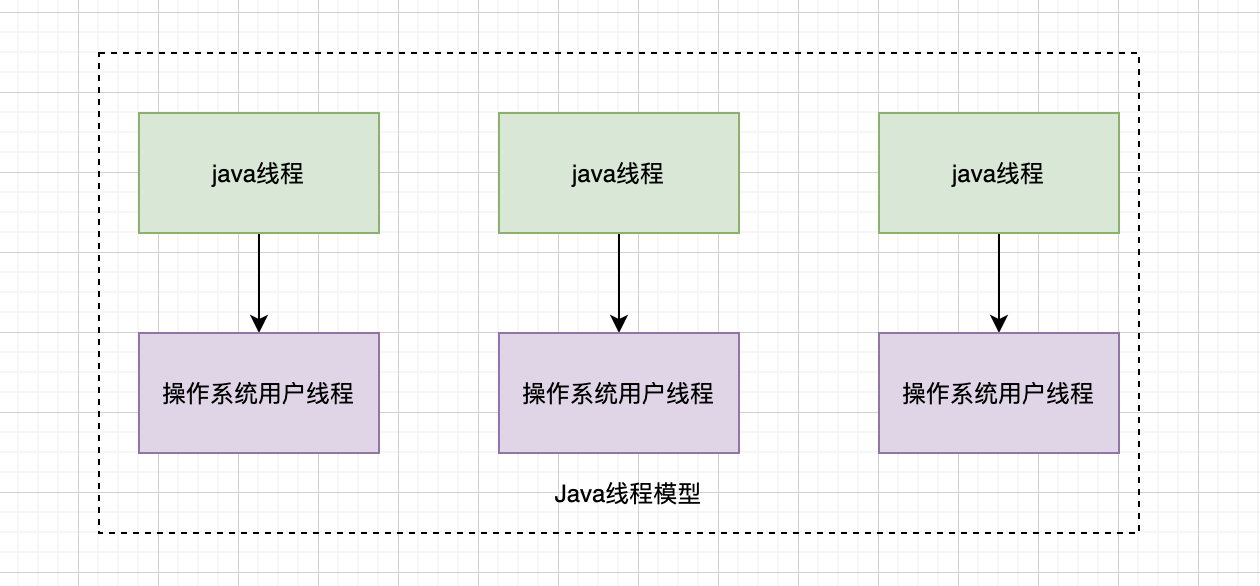
要分两种情况回答:平台线程(Platform Thread) 和 虚拟线程(Virtual Thread)。
- 平台线程:这是 Java 长期以来默认的线程实现。JVM 在 Linux 上通过
pthread_create创建线程,一个 Java 平台线程对应一个操作系统线程,是严格的 1:1 线程模型,线程的调度、上下文切换都由操作系统内核负责,开销较大,每个线程需要栈和系统资源,栈大小受平台及 JVM 配置影响,不能无限创建。 - 虚拟线程:Java 21 正式发布(JEP 444),是 JVM 在用户态自行调度的轻量级线程,采用 M:N 模型——大量虚拟线程会被映射到少量载体平台线程(Carrier Thread)上执行。虚拟线程由 JVM 的
ForkJoinPool调度,创建和管理的开销较小,栈空间按需增长,适合有大量阻塞等待的 IO 密集型任务。实际能承载多少线程仍然取决于任务和内存消耗。
所以"Java 线程等于操作系统线程"这种说法只适用于 JDK 21 之前或只使用平台线程的场景;用了虚拟线程后,Java 的并发模型已经很接近 Go 协程的 M:N 调度了。
# 使用多线程要注意哪些问题?
要保证多线程的程序是安全,不要出现数据竞争造成的数据混乱的问题。
Java的线程安全在三个方面体现:
- 原子性:一个操作或一组需要整体保护的操作,不能被其他线程观察到中间状态,可以通过原子操作或互斥保护实现,在Java中使用了atomic包(这个包提供了一些支持原子操作的类,这些类可以在多线程环境下保证操作的原子性)和synchronized关键字来确保原子性;
- 可见性:一个线程对主内存的修改可以及时地被其他线程看到,在Java中使用了synchronized和volatile这两个关键字确保可见性;
- 有序性:一个线程观察其他线程中的指令执行顺序,由于指令重排序,该观察结果一般杂乱无序,在Java中使用了happens-before原则来确保有序性。
# 保证数据的一致性有哪些方案呢?
- 事务管理:使用数据库事务来确保一组数据库操作要么全部成功提交,要么全部失败回滚。通过ACID(原子性、一致性、隔离性、持久性)属性,数据库事务可以保证数据的一致性。
- 锁机制:使用锁来实现对共享资源的互斥访问。在 Java 中,可以使用 synchronized 关键字、ReentrantLock 或其他锁机制来控制并发访问,从而避免并发操作导致数据不一致。
- 版本控制:通过乐观锁的方式,在更新数据时记录数据的版本信息,从而避免同时对同一数据进行修改,进而保证数据的一致性。
# 线程的创建方式有哪些?
1.继承Thread类
这是最直接的一种方式,用户自定义类继承java.lang.Thread类,重写其run()方法,run()方法中定义了线程执行的具体任务。创建该类的实例后,通过调用start()方法启动线程。
class MyThread extends Thread {
    @Override
    public void run() {
        // 线程执行的代码
    }
}

public static void main(String[] args) {
    MyThread t = new MyThread();
    t.start();
}
采用继承Thread类方式
- 优点: 编写简单,如果需要访问当前线程,无需使用Thread.currentThread ()方法,直接使用this,即可获得当前线程
- 缺点:因为线程类已经继承了Thread类,所以不能再继承其他的父类
2.实现Runnable接口
如果一个类已经继承了其他类,就不能再继承Thread类,此时可以实现java.lang.Runnable接口。实现Runnable接口需要重写run()方法,然后将此Runnable对象作为参数传递给Thread类的构造器,创建Thread对象后调用其start()方法启动线程。
class MyRunnable implements Runnable {
    @Override
    public void run() {
        // 线程执行的代码
    }
}

public static void main(String[] args) {
    Thread t = new Thread(new MyRunnable());
    t.start();
}
采用实现Runnable接口方式:
- 优点:线程类只是实现了Runable接口,还可以继承其他的类。在这种方式下,可以多个线程共享同一个目标对象,所以非常适合多个相同线程来处理同一份资源的情况,从而可以将CPU代码和数据分开,形成清晰的模型,较好地体现了面向对象的思想。
- 缺点:编程稍微复杂,如果需要访问当前线程,必须使用Thread.currentThread()方法。
- 实现Callable接口与FutureTask
java.util.concurrent.Callable接口类似于Runnable,但Callable的call()方法可以有返回值并且可以抛出异常。要执行Callable任务,需将它包装进一个FutureTask,因为Thread类的构造器只接受Runnable参数,而FutureTask实现了Runnable接口。
class MyCallable implements Callable<Integer> {
    @Override
    public Integer call() throws Exception {
        // 线程执行的代码, 这里返回一个整型结果
        return 1;
    }
}

public static void main(String[] args) {
    MyCallable task = new MyCallable();
    FutureTask<Integer> futureTask = new FutureTask<>(task);
    Thread t = new Thread(futureTask);
    t.start();

    try {
        Integer result = futureTask.get();  // 获取线程执行结果
        System.out.println("Result: " + result);
    } catch (InterruptedException | ExecutionException e) {
        e.printStackTrace();
    }
}
采用实现Callable接口方式:
- 缺点:编程稍微复杂,如果需要访问当前线程,必须调用Thread.currentThread()方法。
- 优点:线程类只实现 Callable 接口,仍然可以继承其他类;且
call()方法可以有返回值,也可以抛出异常,配合FutureTask能方便地获取异步执行结果。
- 使用线程池(Executor框架)
从Java 5开始引入的java.util.concurrent.ExecutorService和相关类提供了线程池的支持,这是一种更高效的线程管理方式,避免了频繁创建和销毁线程的开销。可以通过Executors类的静态方法创建不同类型的线程池。
class Task implements Runnable {
    @Override
    public void run() {
        // 线程执行的代码
    }
}

public static void main(String[] args) {
    ExecutorService executor = Executors.newFixedThreadPool(10);  // 创建固定大小的线程池
    for (int i = 0; i < 100; i++) {
        executor.submit(new Task());  // 提交任务到线程池执行
    }
    executor.shutdown();  // 关闭线程池
}
采用线程池方式:
- 缺点:程池增加了程序的复杂度,特别是当涉及线程池参数调整和故障排查时。错误的配置可能导致死锁、资源耗尽等问题,这些问题的诊断和修复可能较为复杂。
- 优点:线程池可以重用预先创建的线程,避免了线程创建和销毁的开销,显著提高了程序的性能。对于需要快速响应的并发请求,线程池可以迅速提供线程来处理任务,减少等待时间。并且,线程池能够有效控制运行的线程数量,防止因创建过多线程导致的系统资源耗尽(如内存溢出)。通过合理配置线程池大小,可以最大化CPU利用率和系统吞吐量。
# 怎么启动线程 ?
启动线程要调用 Thread 对象的 start() 方法,它会启动一个新线程,由新线程执行 run() 中的任务。
Thread thread = new Thread(() -> {
    System.out.println(Thread.currentThread().getName());
}, "worker");
thread.start();
这里面试经常会追问:直接调用 run() 可以吗?
可以调用,但那只是当前线程里的一次普通方法调用,不会启动新线程。比如主线程调用 thread.run(),任务还是在主线程里执行。
另外,同一个 Thread 对象只能调用一次 start()。即使线程已经执行结束,也不能再次启动,否则会抛出 IllegalThreadStateException。如果想再次执行任务,需要创建新的线程,或者把任务交给线程池。
# 如何停止一个线程的运行?
停止线程要靠协作式取消,也就是外部发出停止请求,线程在合适的位置检查请求、清理资源,然后自己退出。
常用的方式有三种:
- 共享标志位:用
volatile boolean表示是否继续运行,线程在循环中检查。适合没有长时间阻塞的任务,但只修改标志位,不能把正在sleep()或等待队列的线程立即唤醒。 - 中断机制:调用线程的
interrupt(),任务通过isInterrupted()检查中断状态,或者通过sleep()、wait()等可中断操作响应请求。 - 取消线程池任务:通过
submit()返回的Future调用cancel(true),尝试中断执行任务的线程。任务仍然需要配合处理中断。
比如,一个既有循环又会休眠的任务,可以这样写:
Thread worker = new Thread(() -> {
    try {
        while (!Thread.currentThread().isInterrupted()) {
            // 执行一轮任务
            Thread.sleep(1000);
        }
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
    } finally {
        // 清理资源
    }
});
worker.start();
// 需要停止时,由其他线程调用
worker.interrupt();
要注意,interrupt() 不会强行终止线程,也不会自动释放线程持有的锁。如果任务忽略中断,就可能继续运行。
不要使用已废弃的 Thread.stop() 来强制停止,它可能让线程在共享数据更新到一半时退出,导致其他线程看到不一致的数据。
# 调用 interrupt 是如何让线程抛出异常的?
interrupt() 本身是发出一个中断请求,是否抛异常,要看目标线程正在做什么。
- 正在正常运行:通常只是设置中断标志,线程需要主动调用
isInterrupted()检查,不会在任意一行代码上突然抛异常。 - 正在执行
sleep()、wait()、join()等可中断等待:这些方法会响应中断,结束等待,并在目标线程中抛出InterruptedException,同时清除中断标志。调用这些方法前已经有中断标志,也可能直接抛异常。 - 正在执行
LockSupport.park():中断可以使它返回,但不会抛出InterruptedException,也不会清除中断标志。 - 正在等待进入
synchronized,或者调用ReentrantLock.lock()等待锁:不能靠中断直接取消这次锁等待。需要可中断的锁等待时,应使用lockInterruptibly()。
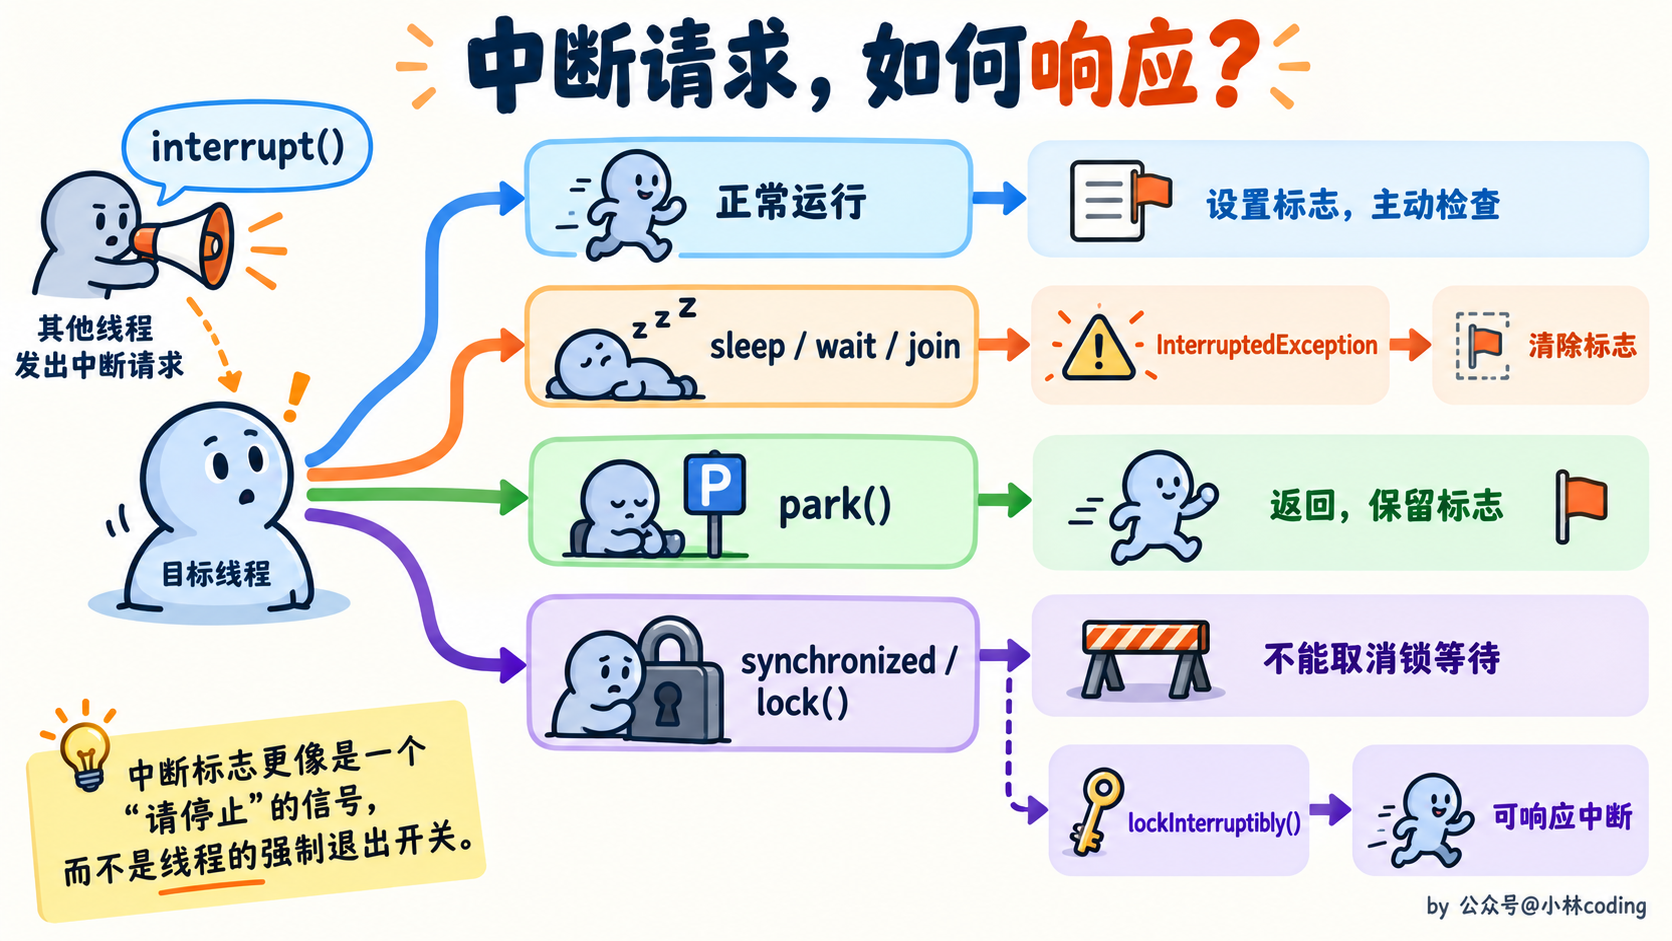
所以,中断标志更像是一个“请停止”的信号,而不是线程的强制退出开关。
处理 InterruptedException 时,如果当前方法不能继续完成任务,可以向上抛出;如果不能向上抛出,通常需要恢复中断标志,并结束当前任务。不要只打印异常,然后继续原来的循环。
另外,isInterrupted() 只检查状态,Thread.interrupted() 检查的是当前线程,并且会清除中断标志,两者不要混用。
# Java线程的状态有哪些?
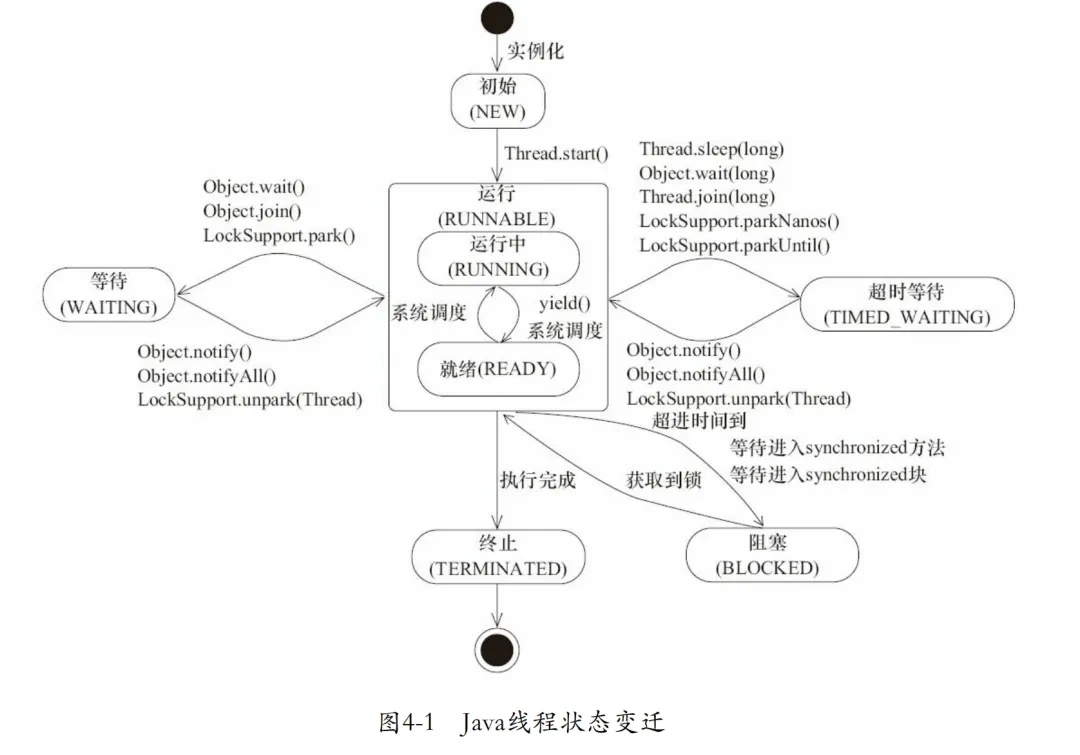
源自《Java并发编程艺术》 java.lang.Thread.State枚举类中定义了六种线程的状态,可以调用线程Thread中的getState()方法获取当前线程的状态。
| 线程状态 | 解释 |
|---|---|
| NEW | 尚未启动的线程状态,即线程创建,还未调用start方法 |
| RUNNABLE | 就绪状态(调用start,等待调度)+正在运行 |
| BLOCKED | 等待监视器锁时,陷入阻塞状态 |
| WAITING | 等待状态的线程正在等待另一线程执行特定的操作(如notify) |
| TIMED_WAITING | 具有指定等待时间的等待状态 |
| TERMINATED | 线程完成执行,终止状态 |
# sleep 和 wait的区别是什么?
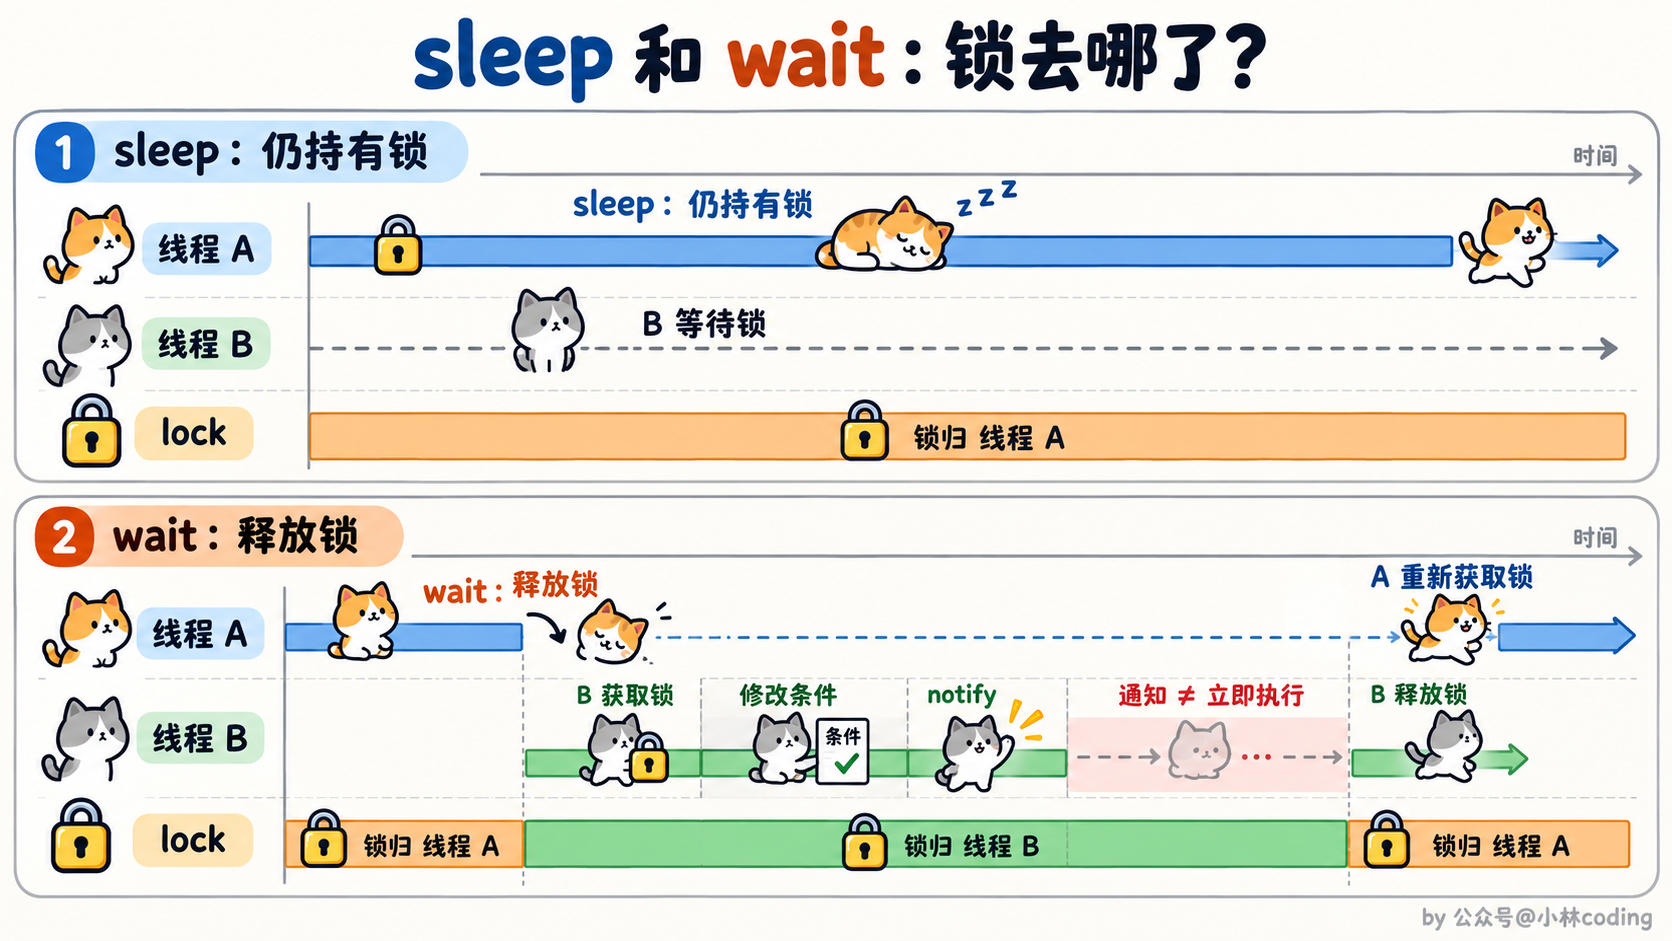
sleep() 和 wait() 都可以让线程暂停执行,但用途不一样:sleep 主要是让当前线程休眠,wait 主要是配合锁进行线程间协作。
| 对比项 | Thread.sleep() | Object.wait() |
|---|---|---|
| 所属类 | Thread,静态方法 | Object,实例方法 |
| 调用前提 | 不需要持有锁 | 必须持有调用对象的监视器锁 |
| 是否释放锁 | 不释放已经持有的锁 | 释放调用对象的监视器锁 |
| 线程状态 | 通常是 TIMED_WAITING | 无超时是 WAITING,有超时是 TIMED_WAITING |
| 结束等待的原因 | 时间到,或者被中断 | 通知、超时、中断,也可能虚假唤醒 |
比如线程在 synchronized (lock) 里面调用 Thread.sleep(),虽然暂停了执行,但仍然占着 lock,其他线程进不来。
如果调用的是 lock.wait(),就会释放 lock,让其他线程有机会进入同步块,修改条件并发出通知。不过,wait 只释放调用对象的监视器锁,不会释放当前线程持有的其他锁。
还有一个关键点:被 notify 唤醒,不代表 wait 立刻返回。等待的线程必须重新拿到同一把锁,才能继续执行。通知线程调用 notify() 后,也不会马上释放锁。
使用 wait() 时,要在 while 循环里检查条件:
synchronized (lock) {
    while (!ready) {
        lock.wait();
    }
    // 条件满足后再继续处理
}
这是因为可能发生虚假唤醒,也可能线程被唤醒后,条件又被其他线程改变了。sleep() 则不能用来保证多个线程的执行顺序,休眠时间到了也只是有资格继续运行,具体什么时候执行还要看调度。
# sleep会释放cpu吗?
是的,调用 Thread.sleep() 时,线程会释放 CPU,但不会释放持有的锁。
当线程调用 sleep() 后,会主动让出 CPU 时间片,进入 TIMED_WAITING 状态。此时操作系统会触发调度,将 CPU 分配给其他处于就绪状态的线程。这样其他线程(无论是需要同一锁的线程还是不相关线程)便有机会执行。
sleep() 不会释放线程已持有的任何锁(如 synchronized 同步代码块或方法中获取的锁)。因此,如果有其他线程试图获取同一把锁,它们仍会被阻塞,直到原线程退出同步代码块。
# blocked和waiting有啥区别
这两个状态都表示线程暂时不能继续执行,但等待的原因不一样。
- BLOCKED:专门表示线程在等待进入或重新进入
synchronized所使用的监视器。比如线程 A 占着lock,线程 B 也想进入synchronized (lock),B 就会进入 BLOCKED。 - WAITING:表示线程在进行没有超时时间的等待,比如
Object.wait()、Thread.join()、LockSupport.park()。它需要等待通知、目标线程结束、许可或中断等事件,具体取决于调用的方法。
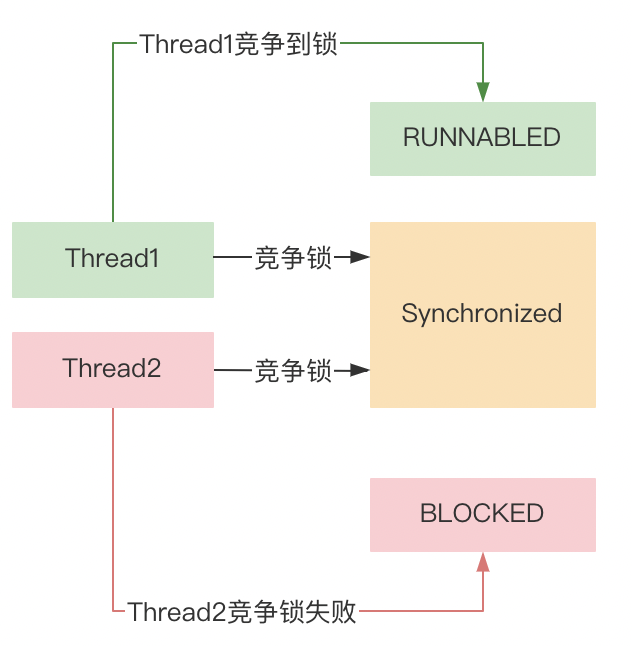
这里容易混淆的是:不是所有“等待锁”的线程都处于 BLOCKED。ReentrantLock 获取失败后,通常通过 AQS 和 LockSupport.park() 等待,所以在线程转储里常见的是 WAITING;如果带超时,可能是 TIMED_WAITING。
再看 wait():线程调用 lock.wait() 后,会释放 lock,进入 WAITING。收到通知后,还要重新竞争 lock,如果锁被其他线程持有,就可能先进入 BLOCKED,拿到锁后才继续运行。
所以排查线程状态时,要结合线程栈里的方法一起看。BLOCKED 重点看谁持有监视器,WAITING 则要看线程是在等条件、等任务结果,还是通过 AQS 等待锁。
# wait 状态下的线程如何恢复到 RUNNABLE 状态?
如果这里说的是调用 Object.wait() 后进入等待状态的线程,常见的结束等待方式有:
- 其他线程对同一个对象调用
notify()或notifyAll()。 - 等待线程被中断,随后抛出
InterruptedException。 - 调用了带超时时间的
wait(),等待时间到达。 - 发生虚假唤醒,所以程序不能只依赖“有没有收到通知”来判断条件是否满足。
不过,结束等待不等于马上恢复执行。线程还需要重新获取调用 wait() 时释放的监视器锁,如果锁还被占用,就可能先处于 BLOCKED。
比如等待一个准备完成的标志,可以这样写,以下代码位于可以抛出 InterruptedException 的方法中:
synchronized (lock) {
    while (!ready) {
        lock.wait();
    }
    // 已重新获得 lock,且条件满足
}

// 其他线程修改条件,并通知等待线程
synchronized (lock) {
    ready = true;
    lock.notifyAll();
}
ready 的检查和修改都放在同一把锁的保护下。这样即使通知先于等待发生,等待线程也会看到 ready 已经是 true,不再调用 wait()。
如果说的是更广泛的 WAITING 状态,还要区分具体方法:join() 等待的是目标线程结束,park() 可以由 unpark() 或中断等方式使其返回,不能都用 notify() 来唤醒。
# notify 和 notifyAll 的区别?
两者都是对某个对象的等待线程发出通知,调用时必须持有这个对象的监视器锁,而且调用后不会立即释放锁。
- notify():从这个对象的等待集合里选择一个线程通知,选择顺序没有 Java API 层面的保证。
- notifyAll():通知这个对象等待集合里的所有线程,让它们有机会重新竞争锁。
这里要区分“被通知”和“获得锁”:即使调用 notifyAll(),同一时刻也只有一个线程能拿到这把监视器锁。线程拿到锁之后,还要重新检查自己的等待条件,条件不满足就继续 wait()。
比如,同一个对象上既有等待“队列非空”的消费者,也有等待“队列未满”的生产者。如果只调用 notify(),可能通知了一个条件仍不满足的线程,而真正能继续工作的线程还在等待,程序就可能无法继续推进。
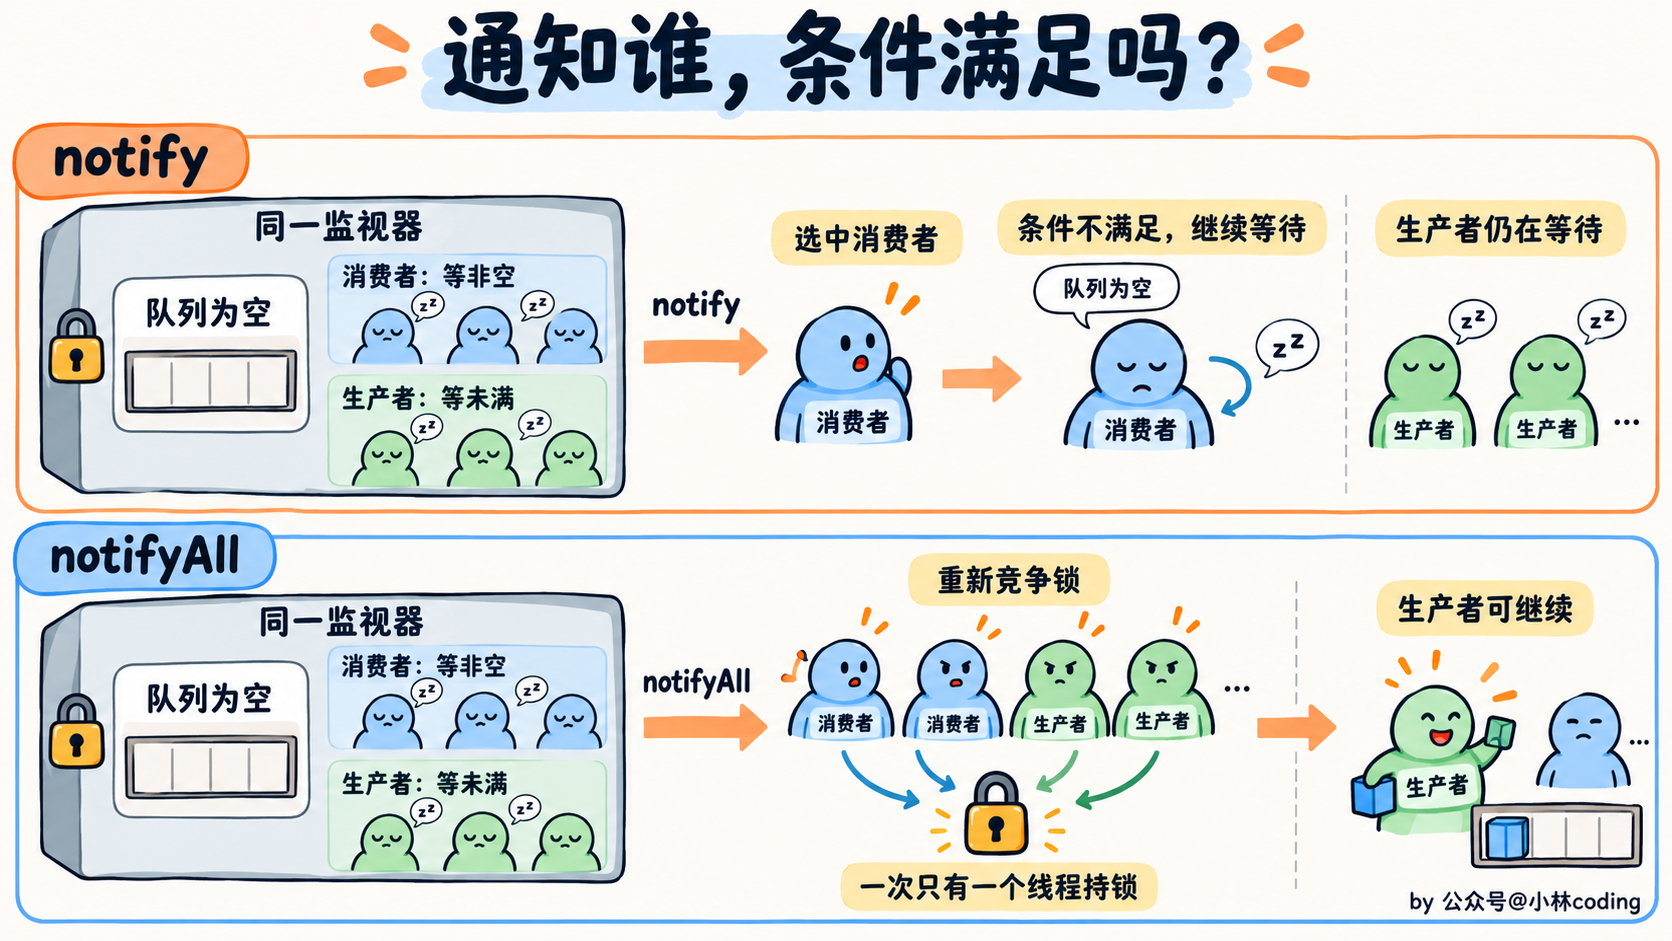
所以,同一把锁对应多个等待条件,或者不好判断应该通知谁时,通常用 notifyAll 更稳妥。它的代价是可能唤醒一些暂时不能继续工作的线程,增加锁竞争。
如果希望分别通知不同条件的线程,可以使用 ReentrantLock 配合多个 Condition,比如 notEmpty 和 notFull。无论使用哪种方式,等待条件都应该放在 while 中检查。
# notify 选择哪个线程?
从 Java API 的约定来看,notify() 选择哪个等待线程没有顺序保证,不能认为一定是最先等待的线程,也不能把它当作公平调度。
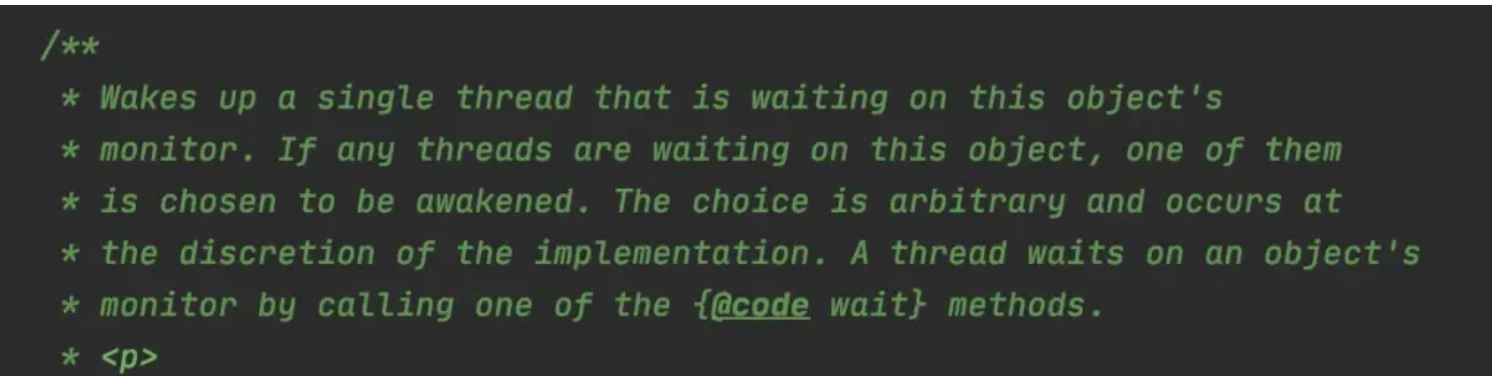
具体 JVM 的某个版本可能采用某种等待队列处理顺序,但这是实现细节,写程序时不能依赖它。
而且,被选择的线程只是有机会重新竞争监视器锁,并不是直接获得锁。它还要和其他竞争这把锁的线程一起等待,拿到锁后才能从 wait() 继续执行。
如果业务要求线程按指定顺序执行,比如先 A、再 B、再 C,就应该使用明确的状态变量、独立的 Condition 或 Semaphore 来控制,不能靠 notify() 恰好选中某个线程。
# 不同的线程之间如何通信?
共享变量是最基本的线程间通信方式。多个线程可以访问和修改同一个共享变量,从而实现信息的传递。为了保证线程安全,通常需要使用 synchronized 关键字或 volatile 关键字。
class SharedVariableExample {
    // 使用 volatile 关键字保证变量的可见性
    private static volatile boolean flag = false;

    public static void main(String[] args) {
        // 生产者线程
        Thread producer = new Thread(() -> {
            try {
                Thread.sleep(2000);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            // 修改共享变量
            flag = true;
            System.out.println("Producer: Flag is set to true.");
        });

        // 消费者线程
        Thread consumer = new Thread(() -> {
            while (!flag) {
                // 等待共享变量被修改
            }
            System.out.println("Consumer: Flag is now true.");
        });

        producer.start();
        consumer.start();
    }
}
代码解释
volatile关键字确保了flag变量在多个线程之间的可见性,即一个线程修改了flag的值,其他线程能立即看到。- 生产者线程在睡眠 2 秒后将
flag设置为true,消费者线程在flag为false时一直等待,直到flag变为true才继续执行。
Object 类中的 wait()、notify() 和 notifyAll() 方法可以用于线程间的协作。wait() 方法使当前线程进入等待状态,notify() 方法唤醒在此对象监视器上等待的单个线程,notifyAll() 方法唤醒在此对象监视器上等待的所有线程。
class WaitNotifyExample {
    private static final Object lock = new Object();
    private static boolean ready = false;

    public static void main(String[] args) {
        // 生产者线程
        Thread producer = new Thread(() -> {
            synchronized (lock) {
                System.out.println("Producer: Producing...");
                ready = true;
                System.out.println("Producer: Production finished. Notifying consumer.");
                lock.notifyAll();
            }
        });

        // 消费者线程
        Thread consumer = new Thread(() -> {
            synchronized (lock) {
                try {
                    System.out.println("Consumer: Waiting for production to finish.");
                    // 进入等待状态
                    while (!ready) {
                        lock.wait();
                    }
                    System.out.println("Consumer: Production finished. Consuming...");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });

        consumer.start();
        producer.start();
    }
}
代码解释:
lock是一个用于同步的对象,生产者和消费者线程都需要获取该对象的锁才能执行相应的操作。- 消费者线程调用
lock.wait()方法进入等待状态,释放锁;生产者线程修改ready后调用lock.notifyAll(),等待方重新获得锁、检查条件后继续执行。
java.util.concurrent.locks 包中的 Lock 和 Condition 接口提供了比 synchronized 更灵活的线程间通信方式。Condition 接口的 await() 方法类似于 wait() 方法,signal() 方法类似于 notify() 方法,signalAll() 方法类似于 notifyAll() 方法。
import java.util.concurrent.locks.Condition;
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReentrantLock;

class LockConditionExample {
    private static final Lock lock = new ReentrantLock();
    private static final Condition condition = lock.newCondition();
    private static boolean ready = false;

    public static void main(String[] args) {
        // 生产者线程
        Thread producer = new Thread(() -> {
            lock.lock();
            try {
                System.out.println("Producer: Producing...");
                ready = true;
                System.out.println("Producer: Production finished. Notifying consumer.");
                condition.signalAll();
            } finally {
                lock.unlock();
            }
        });

        // 消费者线程
        Thread consumer = new Thread(() -> {
            lock.lock();
            try {
                System.out.println("Consumer: Waiting for production to finish.");
                // 进入等待状态
                while (!ready) {
                    condition.await();
                }
                System.out.println("Consumer: Production finished. Consuming...");
            } catch (InterruptedException e) {
                e.printStackTrace();
            } finally {
                lock.unlock();
            }
        });

        consumer.start();
        producer.start();
    }
}
代码解释:
ReentrantLock是Lock接口的一个实现类,condition是通过lock.newCondition()方法创建的。- 消费者线程调用
condition.await()方法进入等待状态,生产者线程修改ready后调用condition.signalAll(),消费者重新获得锁、检查条件后继续执行。
java.util.concurrent 包中的 BlockingQueue 接口提供了线程安全的队列操作,当队列满时,插入元素的线程会被阻塞;当队列为空时,获取元素的线程会被阻塞。
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.LinkedBlockingQueue;

class BlockingQueueExample {
    private static final BlockingQueue<Integer> queue = new LinkedBlockingQueue<>(1);

    public static void main(String[] args) {
        // 生产者线程
        Thread producer = new Thread(() -> {
            try {
                System.out.println("Producer: Producing...");
                queue.put(1);
                System.out.println("Producer: Production finished.");
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        });

        // 消费者线程
        Thread consumer = new Thread(() -> {
            try {
                System.out.println("Consumer: Waiting for production to finish.");
                int item = queue.take();
                System.out.println("Consumer: Consumed item: " + item);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        });

        consumer.start();
        producer.start();
    }
}
代码解释:
LinkedBlockingQueue是BlockingQueue接口的一个实现类,容量为 1。- 生产者线程调用
queue.put(1)方法将元素插入队列,如果队列已满,线程会被阻塞;消费者线程调用queue.take()方法从队列中取出元素,如果队列为空,线程会被阻塞。
这里的 ready 检查、修改和等待,必须使用同一把锁保护。线程启动的先后顺序不能保证它们实际执行的先后顺序,所以不能只依赖先启动消费者。wait() 和 await() 都要在 while 中检查条件,通知本身不能代替条件状态。
# 线程间通信方式有哪些?
1、Object 类的 wait()、notify() 和 notifyAll() 方法。这是 Java 中最基础的线程间通信方式,基于对象的监视器(锁)机制。
wait():使当前线程进入等待状态,直到其他线程调用该对象的notify()或notifyAll()方法。notify():唤醒在此对象监视器上等待的单个线程。notifyAll():唤醒在此对象监视器上等待的所有线程。
class SharedObject {
    private boolean ready = false;

    public synchronized void consumerMethod() throws InterruptedException {
        while (!ready) {
            wait();
        }
        // 执行相应操作
    }

    public synchronized void producerMethod() {
        ready = true;
        notifyAll();
    }
}
2、Lock 和 Condition 接口。Lock 接口提供了比 synchronized 更灵活的锁机制,Condition 接口则配合 Lock 实现线程间的等待 / 通知机制。
await():使当前线程进入等待状态,直到被其他线程唤醒。signal():唤醒一个等待在该Condition上的线程。signalAll():唤醒所有等待在该Condition上的线程。
import java.util.concurrent.locks.Condition;
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReentrantLock;

class SharedResource {
    private final Lock lock = new ReentrantLock();
    private final Condition condition = lock.newCondition();
    private boolean ready = false;

    public void consumer() throws InterruptedException {
        lock.lock();
        try {
            while (!ready) {
                condition.await();
            }
            // 执行相应操作
        } finally {
            lock.unlock();
        }
    }

    public void producer() {
        lock.lock();
        try {
            ready = true;
            condition.signalAll();
        } finally {
            lock.unlock();
        }
    }
}
3、volatile 关键字。可以用于发布简单的状态变化,通过 volatile 写和后续读建立可见性及顺序保证。不过它不能保证复合操作原子,也不应该理解成完全绕过 CPU 缓存。下面的空循环仅演示状态传递,会消耗 CPU,长时间等待应考虑阻塞式协作。
class VolatileExample {
    private volatile boolean flag = false;

    public void writer() {
        flag = true;
    }

    public void reader() {
        while (!flag) {
            // 等待
        }
        // 执行相应操作
    }
}
4、CountDownLatch。CountDownLatch 是一个同步辅助类,它允许一个或多个线程等待其他线程完成操作。
CountDownLatch(int count):构造函数,指定需要等待的线程数量。countDown():减少计数器的值。await():使当前线程等待,直到计数器的值为 0。
import java.util.concurrent.CountDownLatch;

public class CountDownLatchExample {
    public static void main(String[] args) throws InterruptedException {
        int threadCount = 3;
        CountDownLatch latch = new CountDownLatch(threadCount);

        for (int i = 0; i < threadCount; i++) {
            new Thread(() -> {
                try {
                    // 执行任务
                    System.out.println(Thread.currentThread().getName() + " 完成任务");
                } finally {
                    latch.countDown();
                }
            }).start();
        }

        latch.await();
        System.out.println("所有线程任务完成");
    }
}
5、CyclicBarrier。CyclicBarrier 是一个同步辅助类,它允许一组线程相互等待,直到所有线程都到达某个公共屏障点。
CyclicBarrier(int parties, Runnable barrierAction):构造函数,指定参与的线程数量和所有线程到达屏障点后要执行的操作。await():使当前线程等待,直到所有线程都到达屏障点。
import java.util.concurrent.CyclicBarrier;

public class CyclicBarrierExample {
    public static void main(String[] args) {
        int threadCount = 3;
        CyclicBarrier barrier = new CyclicBarrier(threadCount, () -> {
            System.out.println("所有线程都到达屏障点");
        });

        for (int i = 0; i < threadCount; i++) {
            new Thread(() -> {
                try {
                    // 执行任务
                    System.out.println(Thread.currentThread().getName() + " 到达屏障点");
                    barrier.await();
                    // 继续执行后续任务
                } catch (Exception e) {
                    e.printStackTrace();
                }
            }).start();
        }
    }
}
6、Semaphore。Semaphore 是一个计数信号量,它可以控制同时访问特定资源的线程数量。
Semaphore(int permits):构造函数,指定信号量的初始许可数量。acquire():获取一个许可,如果没有可用许可则阻塞。release():释放一个许可。
import java.util.concurrent.Semaphore;

public class SemaphoreExample {
    public static void main(String[] args) {
        int permitCount = 2;
        Semaphore semaphore = new Semaphore(permitCount);

        for (int i = 0; i < 5; i++) {
            new Thread(() -> {
                boolean acquired = false;
                try {
                    semaphore.acquire();
                    acquired = true;
                    System.out.println(Thread.currentThread().getName() + " 获得许可");
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    if (acquired) {
                        semaphore.release();
                        System.out.println(Thread.currentThread().getName() + " 释放许可");
                    }
                }
            }).start();
        }
    }
}
Semaphore 不记录许可的线程归属,release() 会增加许可数量。因此只有成功 acquire() 后才应该在 finally 中归还,不能在获取许可被中断时仍然 release(),否则可能让并发数超过设定值。
# 如何停止一个线程?
在 Java 中,停止线程的正确方式是 通过协作式的逻辑控制线程终止,而非强制暴力终止(如已废弃的 Thread.stop())。以下是实现安全停止线程的多种方法:
第一种方式:通过共享标志位主动终止。定义一个 可见的 状态变量,由主线程控制其值,工作线程循环检测该变量以决定是否退出。
public class SafeStopWithFlag implements Runnable {
    // 使用 volatile 保证可见性
    private volatile boolean running = true;

    @Override
    public void run() {
        while (running) {
            try {
                // 处理任务逻辑
                System.out.println("Thread is running...");
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                // 捕获中断异常后设置 running=false
                running = false;
                Thread.currentThread().interrupt(); // 重新设置中断标志
            }
        }
        System.out.println("Thread terminated safely.");
    }

    // 停止线程的方法(由外部调用)
    public void stop() {
        running = false;
    }
}
调用方式:
SafeStopWithFlag task = new SafeStopWithFlag();
Thread thread = new Thread(task);
thread.start();
// 某个时刻调用停止
Thread.sleep(3000);
task.stop();
第二种方式使用线程中断机制。通过 Thread.interrupt() 触发线程中断状态,结合中断检测逻辑实现安全停止。
public class InterruptExample implements Runnable {
    @Override
    public void run() {
        while (!Thread.currentThread().isInterrupted()) {
            try {
                System.out.println("Working...");
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                // 当阻塞时被中断, 抛出异常并清除中断状态
                System.out.println("Interrupted during sleep!");
                Thread.currentThread().interrupt(); // 重新设置中断标志
            }
        }
        System.out.println("Thread terminated by interrupt.");
    }
}
调用方式:
Thread thread = new Thread(new InterruptExample());
thread.start();
// 中断线程
Thread.sleep(3000);
thread.interrupt();
interrupt()发出中断请求,不会强制终止线程,实际响应取决于线程当前执行的操作。- 线程需手动检查中断状态(
isInterrupted())或触发可中断操作(如sleep(),wait(),join())响应中断。 sleep()、wait()、join()等可中断等待会抛出InterruptedException并清除中断状态,不能把这个结论套用到所有阻塞操作上。
第三种方式通过 Future 取消任务。使用线程池提交任务,并通过 Future.cancel(true) 尝试取消任务,任务执行中的退出依赖它是否响应中断。
public class FutureCancelDemo {
    public static void main(String[] args) {
        ExecutorService executor = Executors.newSingleThreadExecutor();
        Future<?> future = executor.submit(() -> {
            while (!Thread.currentThread().isInterrupted()) {
                System.out.println("Task running...");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    System.out.println("Task interrupted.");
                    Thread.currentThread().interrupt();
                }
            }
        });

        try {
            Thread.sleep(3000);
            future.cancel(true); // true表示尝试中断任务线程
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        } finally {
            executor.shutdown();
        }
    }
}
第四种方式处理不可中断的阻塞操作。并不是所有等待都响应中断。比如普通 ReentrantLock.lock() 不会因中断取消等待,需要改用 lockInterruptibly();部分传统 IO 等待,则需要关闭资源来解除阻塞,具体行为取决于 API、线程类型和实现。下面用平台线程中的传统 ServerSocket 等待说明资源关闭的思路。
import java.io.IOException;
import java.net.ServerSocket;
import java.net.Socket;

public class SocketHandler implements Runnable {
    private final ServerSocket serverSocket;
    private volatile boolean stopped = false;

    public SocketHandler(ServerSocket serverSocket) {
        this.serverSocket = serverSocket;
    }

    @Override
    public void run() {
        try {
            while (!stopped) {
                try (Socket socket = serverSocket.accept()) {
                    // 处理连接...
                }
            }
        } catch (IOException e) {
            if (!stopped) {
                throw new java.io.UncheckedIOException(e);
            }
        }
    }

    // 特殊关闭方法(销毁资源)
    public void stop() {
        stopped = true;
        try {
            serverSocket.close(); // 关闭资源使accept()抛出异常
        } catch (IOException e) {
            System.out.println("Error closing socket: " + e);
        }
    }
}
调用方式:调用 stop() 方法关闭资源以解除阻塞。
线程停止的正确实践,如下表格:
| 方法 | 适用场景 | 注意事项 |
|---|---|---|
| 循环检测标志位 | 简单无阻塞的逻辑 | 确保标志位使用 volatile 或通过锁保证可见性 |
| 中断机制 | 可中断的阻塞操作 | 正确处理 InterruptedException 并恢复中断标志 |
| Future.cancel() | 线程池管理任务 | 需要线程池任务支持中断处理机制 |
| 资源关闭 | 不可中断的阻塞操作(如Sockets) | 显式关闭资源触发异常,结合中断状态判断回滚 |
避免使用以下已废弃方法:
Thread.stop():暴力终止,可能导致状态不一致。Thread.suspend()/resume():易导致死锁。
上面的标志位方案里,stop() 只修改 running,不能主动唤醒 sleep(),因此停止响应可能延迟。资源关闭示例只演示解除 accept() 等待,已经建立的连接如果还有阻塞读写,也需要单独设置超时或管理关闭。
# Go 的协程和 Java 的线程有啥区别?
Go的协程和Java的线程确实有很大区别,我从几个方面来说一下。
首先最核心的区别是它们的调度模型不一样。Java 的**平台线程(Platform Thread)**是操作系统级别的线程,一个 Java 平台线程对应一个操作系统线程,创建、销毁、调度都由操作系统内核管理。不过从 Java 21 开始,JEP 444 正式引入了虚拟线程(Virtual Thread),这是 JVM 层面的 M:N 轻量级线程,和 Go 协程的思路已经比较接近了。下面的对比主要针对传统平台线程,虚拟线程的部分会在最后补充说明。
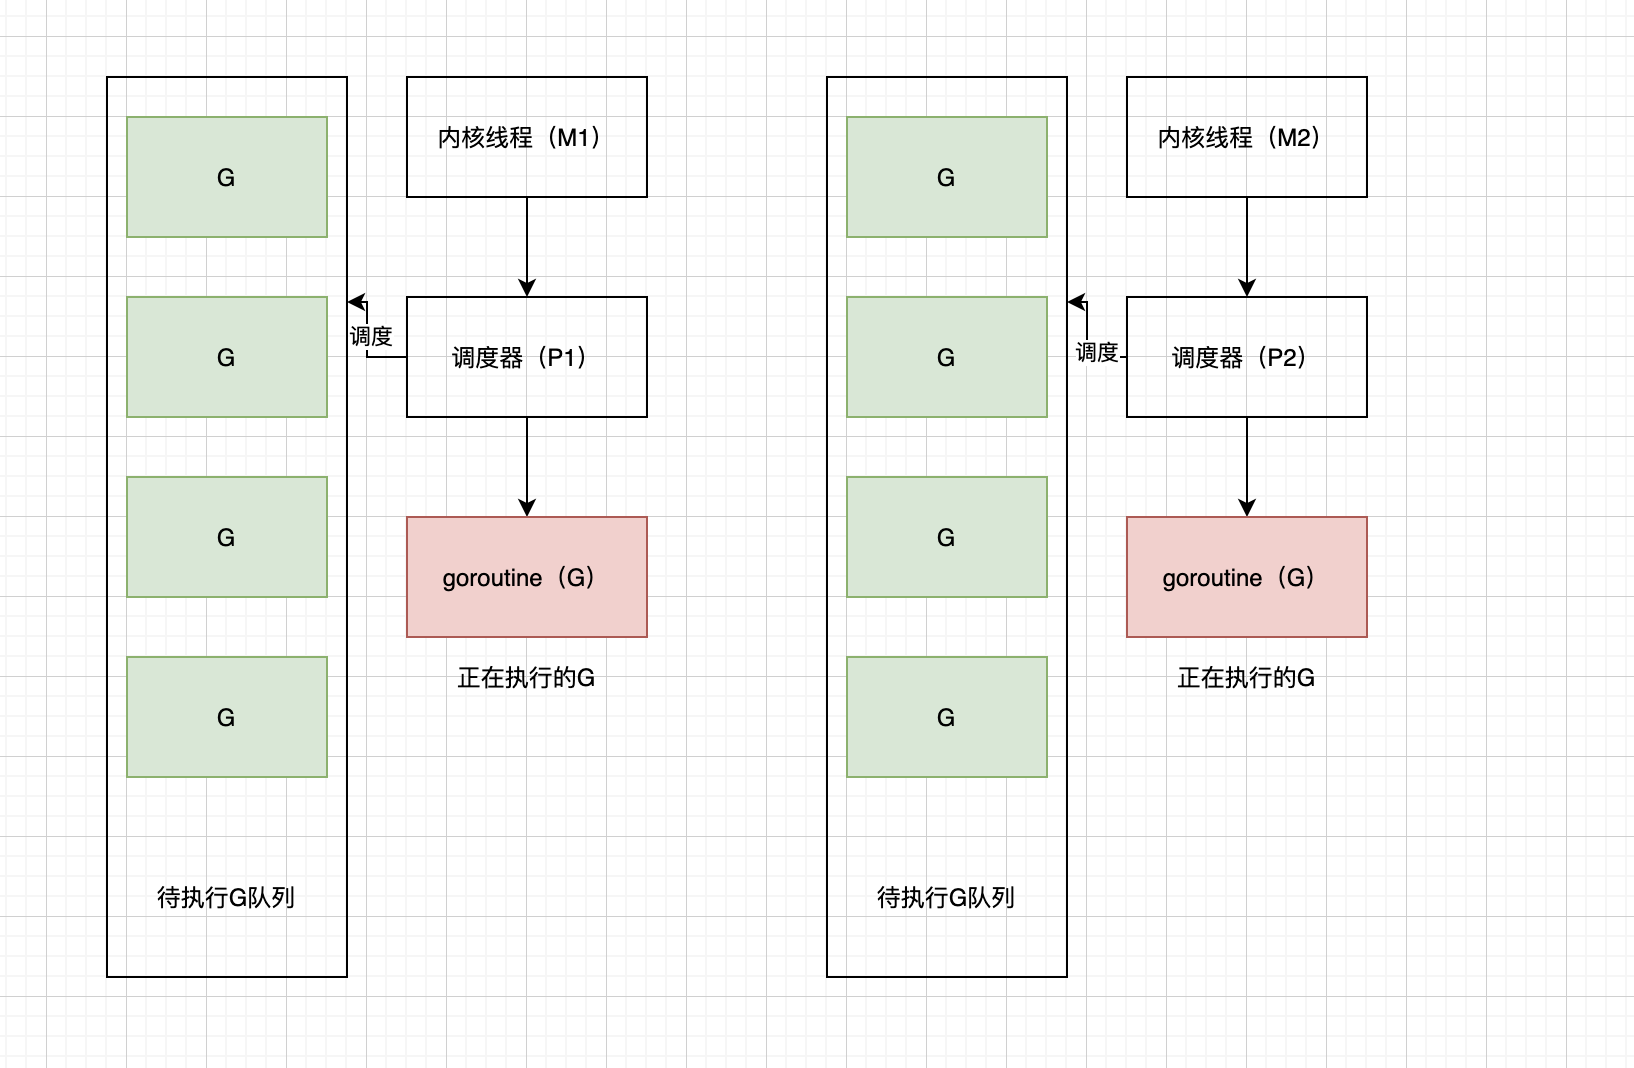
而Go的协程,也就是goroutine,它是用户态的轻量级线程,是由Go运行时自己调度的,不需要经过操作系统内核。这就导致了很多后续的差异。
从资源消耗上来说,差别非常明显。Java创建一个线程的开销是比较大的,默认情况下一个线程的栈空间大概是1MB左右,而且线程的创建和销毁都需要系统调用,开销不小。所以在Java里你不能无限制地创建线程,创建几千个线程系统可能就扛不住了,这也是为什么Java里要用线程池来复用线程。
但Go的协程就轻量多了,一个goroutine初始栈空间只有2KB,而且栈空间是可以动态伸缩的。Go里创建几万甚至几十万个协程都是很正常的事情,我之前做过一个项目,同时跑了十几万个goroutine,系统压力也不大。
调度方式上也不太一样。Java线程的调度是抢占式的,由操作系统的调度器决定什么时候切换线程,线程切换需要保存和恢复上下文,涉及到用户态和内核态的切换,这个开销相对比较大。
Go的协程调度是在用户态完成的,Go运行时有个GMP模型,G就是goroutine,M是操作系统线程,P是逻辑处理器。Go会把多个协程映射到少量的操作系统线程上执行,协程的切换完全在用户态,不需要陷入内核,所以切换成本非常低。而且Go的调度器会在协程发生阻塞的时候,比如IO操作或者channel操作时,自动把这个协程挂起,让其他协程继续执行,现代 Go 运行时也支持抢占机制,不能把 goroutine 完全理解为必须主动让出的协作式调度。
从使用方式上来讲,Go的协程用起来要简单太多了。在Go里创建一个协程只需要在函数调用前加个go关键字就行了,比如go doSomething(),就这么简单,如下代码:
package main

import (
    "fmt"
    "time"
)

func doSomething(name string) {
    for i := 0; i < 3; i++ {
        fmt.Printf("%s: %d\n", name, i)
        time.Sleep(100 * time.Millisecond)
    }
}

func main() {
    // 创建协程就这么简单, 加个go关键字
    go doSomething("协程1")
    go doSomething("协程2")
    go doSomething("协程3")

    // 等待协程执行完
    time.Sleep(time.Second)
    fmt.Println("主程序结束")
}
而在Java里创建线程,你要么new一个Thread对象,要么实现Runnable接口,或者用线程池,总之代码量要多一些。Go这种简洁的语法让并发编程的心智负担降低了很多。
public class RunnableExample {
    public static void main(String[] args) {
        // 实现Runnable接口
        Runnable task = new Runnable() {
            @Override
            public void run() {
                for (int i = 0; i < 3; i++) {
                    System.out.println(Thread.currentThread().getName() + ": " + i);
                    try {
                        Thread.sleep(100);
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                }
            }
        };

        // 创建Thread对象并传入Runnable
        Thread thread1 = new Thread(task, "线程1");
        Thread thread2 = new Thread(task, "线程2");
        Thread thread3 = new Thread(task, "线程3");

        thread1.start();
        thread2.start();
        thread3.start();
    }
}
通信机制也有很大差异。Java线程之间通信主要靠共享内存,需要用synchronized、Lock这些同步机制来保证线程安全,还要小心处理死锁、竞态条件这些问题,写起来比较容易出错。Go虽然也支持共享内存和锁,但它更提倡用channel来通信,有句话叫"不要通过共享内存来通信,而要通过通信来共享内存"。用channel的话,代码会更清晰,也更不容易出现并发问题。
性能上不能只根据协程和线程模型就断定哪个语言更快,需要结合任务、框架和运行时版本测试。比如说要处理几万个并发请求,Java可能需要用复杂的异步框架或者线程池来优化,而Go直接为每个请求开一个协程就行了,代码简单性能还好。当然这不是说Java不行,Java在企业级应用、生态完善性这些方面还是有很大优势的,在并发模型上也要区分 Java 平台线程和虚拟线程。
从我实际使用的感受来说,如果是写IO密集型的高并发服务,比如API网关、聊天服务器这种,Go的协程模型开发效率高,性能也好。但如果是传统的企业级应用,需要用到大量的中间件和框架,Java的生态会更成熟一些。两者各有优势,选择哪个还是要看具体场景。
最后再补充一下 Java 21 的虚拟线程。JEP 444 正式发布的虚拟线程,让 Java 终于也有了类似协程的 M:N 调度模型——虚拟线程由 JVM 的 ForkJoinPool 在用户态调度,大量虚拟线程会被映射到少量载体平台线程上执行,创建和管理开销较小,栈空间按需增长,能够用较少的平台线程承载大量处于等待中的任务。创建方式也很简洁:
// 方式一:直接启动虚拟线程
Thread.startVirtualThread(() -> System.out.println("Hello from virtual thread"));

// 方式二:通过 Executors 创建每任务一个虚拟线程的线程池
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    executor.submit(() -> { /* 任务 */ });
}
虚拟线程执行支持卸载的阻塞操作时,JVM 可以把它从载体线程上卸载,让载体执行其他虚拟线程。但不能认为所有 IO、所有本地方法都不会占住载体线程。比如 JDK 21 中,部分 synchronized 范围内的阻塞会产生 pinning;JDK 24 通过 JEP 491 改进了这类情况,本地代码等仍然需要具体分析。
虚拟线程主要提高大量 IO 等待任务的并发承载能力,不会让 CPU 密集型计算凭空增加算力。Java 和 Go 的最终吞吐量,要结合具体程序、运行时版本和资源配置来比较。
# 并发安全
# juc包下你常用的类?
线程池相关:
ThreadPoolExecutor:最核心的线程池类,用于创建和管理线程池。通过它可以灵活地配置线程池的参数,如核心线程数、最大线程数、任务队列等,以满足不同的并发处理需求。Executors:线程池工厂类,提供了一系列静态方法来创建不同类型的线程池,如newFixedThreadPool(创建固定线程数的线程池)、newCachedThreadPool(创建可缓存线程池)、newSingleThreadExecutor(创建单线程线程池)等,方便开发者快速创建线程池。
并发集合类:
ConcurrentHashMap:线程安全的哈希映射表,用于在多线程环境下高效地存储和访问键值对。JDK 1.7 采用分段锁(Segment)实现;JDK 1.8 起已废弃分段锁,改为基于CAS + synchronized锁桶头节点的方式,锁粒度更细,并发度更高,在高并发场景下比传统的Hashtable性能更好。CopyOnWriteArrayList:线程安全的列表,在对列表进行修改操作时,会创建一个新的底层数组,将修改操作应用到新数组上,而读操作仍然可以在旧数组上进行,从而实现了读写分离,提高了并发读的性能,适用于读多写少的场景。
同步工具类:
CountDownLatch:允许一个或多个线程等待其他一组线程完成操作后再继续执行。它通过一个计数器来实现,计数器初始化为线程的数量,每个线程完成任务后调用countDown方法将计数器减一,当计数器为零时,等待的线程可以继续执行。常用于多个线程完成各自任务后,再进行汇总或下一步操作的场景。CyclicBarrier:让一组线程互相等待,直到所有线程都到达某个屏障点后,再一起继续执行。与CountDownLatch不同的是,CyclicBarrier可以重复使用,当所有线程都通过屏障后,计数器会重置,可以再次用于下一轮的等待。适用于多个线程需要协同工作,在某个阶段完成后再一起进入下一个阶段的场景。Semaphore:信号量,用于控制同时访问某个资源的线程数量。它维护了一个许可计数器,线程在访问资源前需要获取许可,如果有可用许可,则获取成功并将许可计数器减一,否则线程需要等待,直到有其他线程释放许可。常用于控制对有限资源的访问,如数据库连接池、线程池中的线程数量等。
原子类:
AtomicInteger:原子整数类,提供了对整数类型的原子操作,如自增、自减、比较并交换等。通过硬件级别的原子指令来保证操作的原子性和线程安全性,避免了使用锁带来的性能开销,在多线程环境下对整数进行计数、状态标记等操作非常方便。AtomicReference:原子引用类,用于对对象引用进行原子操作。保证的是引用更新的原子性,不会自动保护对象内部字段的修改。多个字段需要一起更新时,可以把它们放进不可变对象,再原子替换整个引用。常用于实现无锁数据结构或需要对对象进行原子更新的场景。
# ConcurrentHashMap 是怎么保证线程安全的?
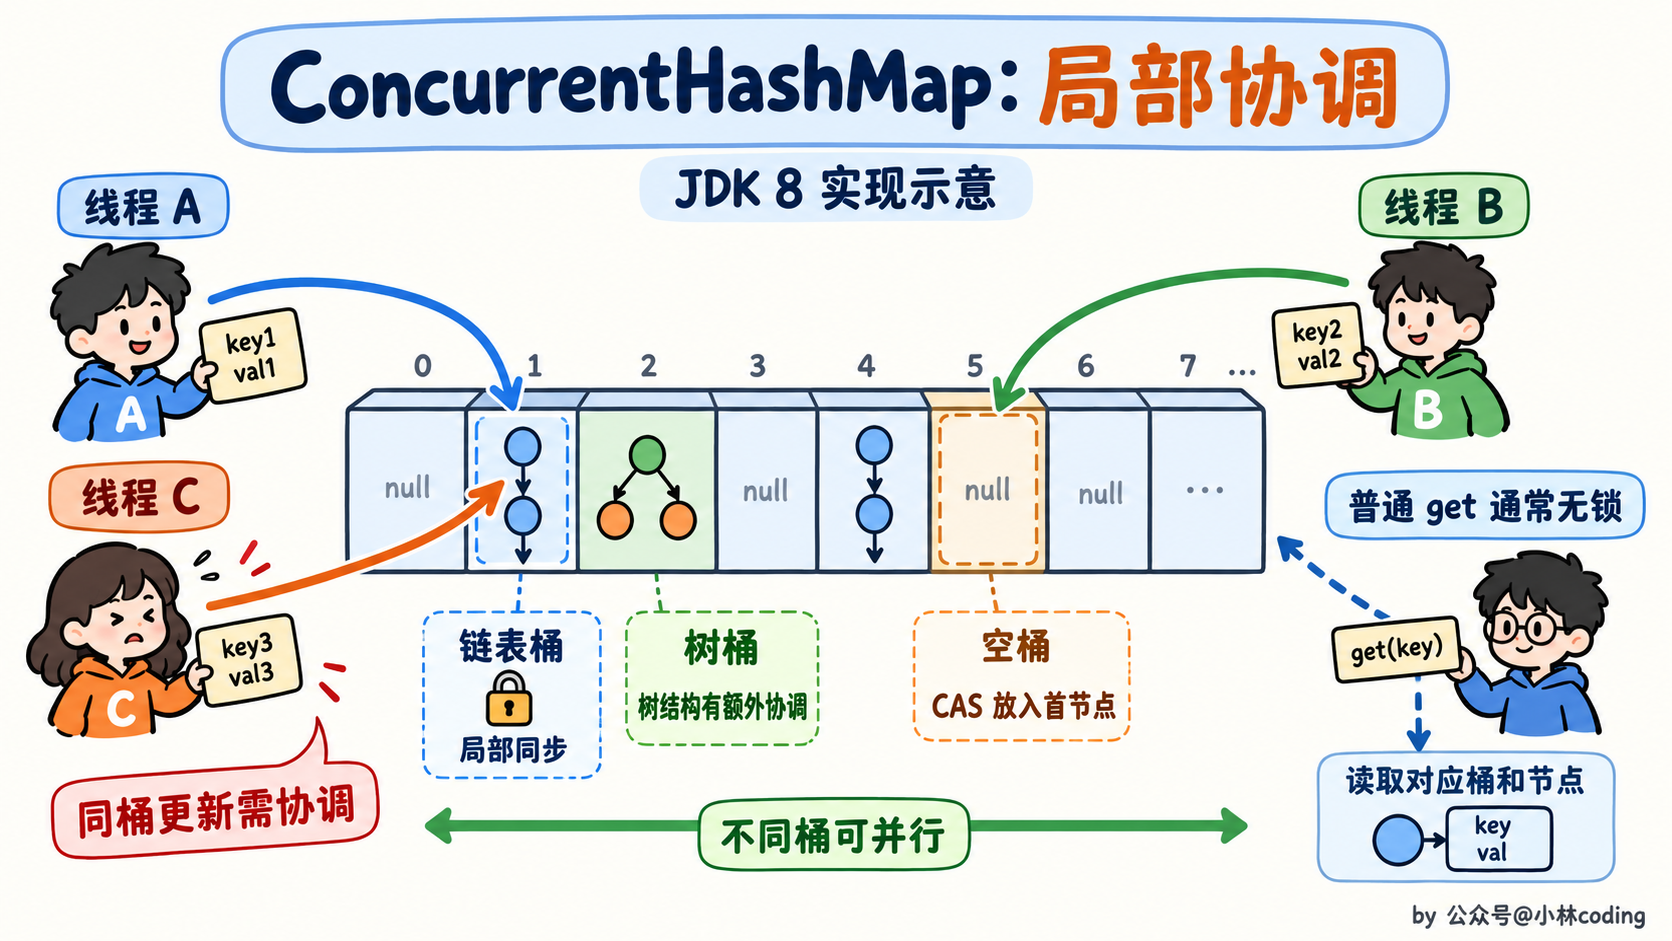
这道题一般以 JDK 8 的实现为例回答:底层使用数组、链表和红黑树,通过 CAS 和局部加锁来协调更新,普通 get() 通常不需要加锁。
先说写入。一个桶还没有节点时,可以通过 CAS 放入第一个节点;桶已经有节点时,对这个桶的更新通常需要对桶头等进行同步,再处理链表或树中的节点。
这样不同桶上的写入,在没有其他冲突时可以并行进行,不用每次修改都锁住整个 Map。树结构的内部协调还有自己的机制,不能把所有更新都简化为同一个 CAS。
再说读取。相关节点字段通过 volatile 等机制保证可见性,get() 可以读取对应桶和节点。扩容时还会利用转发节点,使访问转向新表,并允许多个线程协作迁移数据。
面试里可以补充:JDK 7 使用的是 Segment 分段锁,JDK 8 的主要更新机制已经不再依赖 Segment。
但单个方法线程安全,不代表多个方法组合起来也原子。比如下面的写法仍然存在竞争:
if (!map.containsKey(key)) {
    map.put(key, value);
}
如果要实现“没有才放入”,应该使用 putIfAbsent();需要针对同一个键更新值,可以考虑 compute()、merge() 等原子方法。
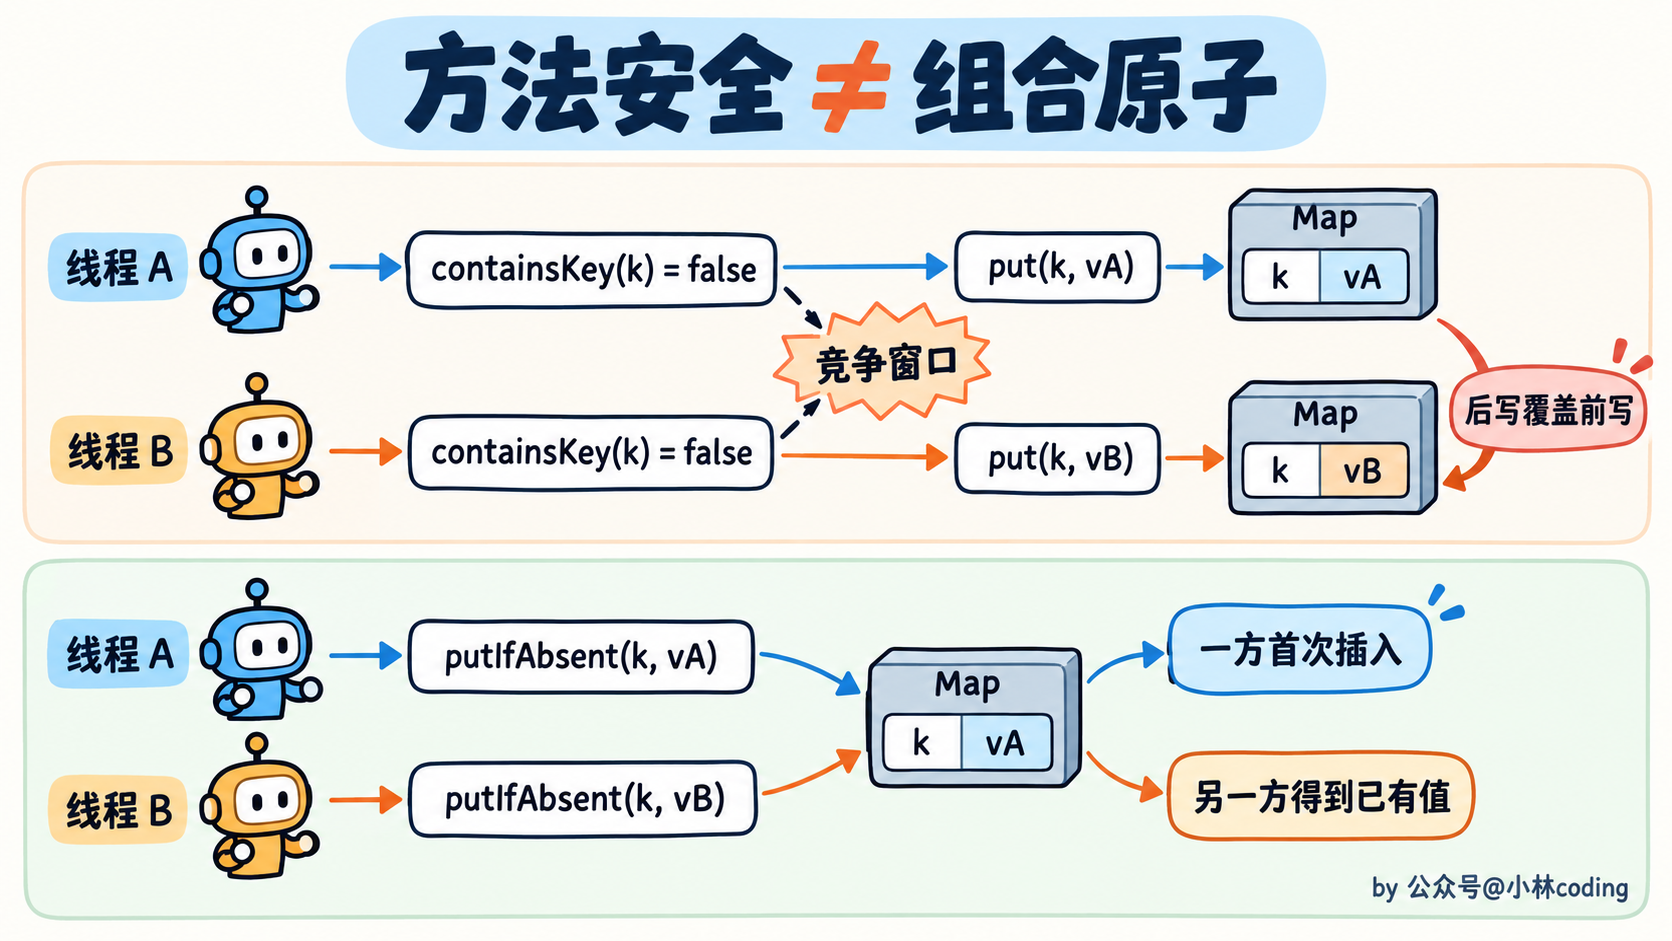
回调里的计算尽量短,不要在里面做长时间的远程调用。它们也不代表可以对多个不同键执行一个整体事务。
还有两点:它不允许 null 键和 null 值;遍历是弱一致的,不提供整个 Map 某一时刻的固定快照。Map 里存的是可变对象时,对对象内部字段的并发修改,也不会自动被 Map 保护。
# 怎么保证多线程安全?
- synchronized关键字:可以使用
synchronized关键字来同步代码块或方法,确保同一时刻只有一个线程可以访问这些代码。对象锁是通过synchronized关键字锁定对象的监视器(monitor)来实现的。
public synchronized void someMethod() { /* ... */ }

public void anotherMethod() {
    synchronized (someObject) {
        /* ... */
    }
}
- volatile关键字:
volatile关键字用于变量,确保所有线程看到的是该变量的最新值,而不是可能存储在本地寄存器中的副本。
public volatile int sharedVariable;
- Lock接口和ReentrantLock类:
java.util.concurrent.locks.Lock接口提供了比synchronized更强大的锁定机制,ReentrantLock是一个实现该接口的例子,提供了更灵活的锁管理能力,性能则需要结合竞争情况评估。
private final ReentrantLock lock = new ReentrantLock();

public void someMethod() {
    lock.lock();
    try {
        /* ... */
    } finally {
        lock.unlock();
    }
}
- 原子类:Java并发库(
java.util.concurrent.atomic)提供了原子类,如AtomicInteger、AtomicLong等,这些类提供了原子操作,可以用于更新基本类型的变量而无需额外的同步。
示例:
AtomicInteger counter = new AtomicInteger(0);

int newValue = counter.incrementAndGet();
- 线程局部变量:
ThreadLocal可以让每个线程分别存储自己的值,减少共享。它不会自动复制对象,如果各线程存入同一个可变对象,仍然存在竞争;使用完要及时remove()。
ThreadLocal<Integer> threadLocalVar = new ThreadLocal<>();

threadLocalVar.set(10);
int value = threadLocalVar.get();
- 并发集合:使用
java.util.concurrent包中的线程安全集合,如ConcurrentHashMap、ConcurrentLinkedQueue等,这些集合内部已经实现了线程安全的逻辑。 - JUC工具类: 使用
java.util.concurrent包中的一些工具类可以用于控制线程间的同步和协作。例如:Semaphore和CyclicBarrier等。
还要注意,线程安全是针对完整业务操作来说的。比如 ConcurrentHashMap 的 containsKey() 和 put() 各自线程安全,但组合起来不一定原子,需要使用 putIfAbsent() 等原子方法。多字段有约束关系时,也要放在同一套同步规则下保护,不能只给每个字段单独加一个原子类。
# Java中有哪些常用的锁,在什么场景下使用?
选锁主要看两个问题:哪些操作需要互斥,以及是否需要超时、中断、多个等待条件等能力。
- synchronized:Java 的内置锁,适合简单的互斥场景,比如保护一个计数器或一组共享字段。进入同步块时加锁,退出时自动释放,抛异常也会释放,使用起来比较直接。
- ReentrantLock:也是可重入的互斥锁,适合需要可中断等待、超时获取锁、公平性配置、多个
Condition的场景。要用try-finally确保释放锁。 - ReentrantReadWriteLock:把读锁和写锁分开,多个线程可以同时持有读锁,写锁则是独占的。适合读多写少、读操作确实有一定耗时的场景。读操作很短时,读写锁的管理开销也可能抵消收益。
- StampedLock:支持读锁、写锁和乐观读。乐观读先读取数据,再通过
validate()检查期间是否发生写入,失败后退回读锁重新读取。适合能正确处理乐观读的场景,但它不支持可重入,使用时要更小心。
另外,面试里经常说的悲观锁、乐观锁、自旋锁,是对并发处理方式的分类,不全是某一个具体的 Java 类。
比如 synchronized、ReentrantLock 属于悲观锁;使用 CAS 更新共享状态,属于乐观并发控制;自旋则是在获取失败后继续尝试,用 CPU 时间换取减少阻塞的机会。
实际使用时,我会先用简单的同步方案把正确性保证好,再结合锁竞争和耗时决定是否调整。不能只看“读多写少”就认定读写锁一定更快,也不能认为 CAS 一定比锁性能好。
# 怎么在实践中用锁的?
Java提供了多种锁的实现,包括synchronized关键字、java.util.concurrent.locks包下的Lock接口及其具体实现如ReentrantLock、ReadWriteLock等。下面我们来看看这些锁的使用方式。
synchronized
synchronized关键字可以用于方法或代码块,它是Java中最早的锁实现,使用起来非常简单。
示例:synchronized方法
public class Counter {
    private int count = 0;

    public synchronized void increment() {
        count++;
    }

    public synchronized int getCount() {
        return count;
    }
}
示例:synchronized代码块
public class Counter {
    private Object lock = new Object();
    private int count = 0;

    public void increment() {
        synchronized (lock) {
            count++;
        }
    }
}
- 使用
Lock接口
Lock接口提供了比synchronized更灵活的锁操作,包括尝试锁、可中断锁、定时锁等。ReentrantLock是Lock接口的一个实现。
示例:使用ReentrantLock
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReentrantLock;

public class Counter {
    private Lock lock = new ReentrantLock();
    private int count = 0;

    public void increment() {
        lock.lock();
        try {
            count++;
        } finally {
            lock.unlock();
        }
    }
}
- 使用
ReadWriteLock
ReadWriteLock接口提供了一种读写锁的实现,允许多个读操作同时进行,但写操作是独占的。
示例:使用ReadWriteLock
import java.util.concurrent.locks.Lock;
import java.util.concurrent.locks.ReadWriteLock;
import java.util.concurrent.locks.ReentrantReadWriteLock;

public class Cache {
    private ReadWriteLock lock = new ReentrantReadWriteLock();
    private Lock readLock = lock.readLock();
    private Lock writeLock = lock.writeLock();
    private Object data;

    public Object readData() {
        readLock.lock();
        try {
            return data;
        } finally {
            readLock.unlock();
        }
    }

    public void writeData(Object newData) {
        writeLock.lock();
        try {
            data = newData;
        } finally {
            writeLock.unlock();
        }
    }
}
# Java 并发工具你知道哪些?
Java 中一些常用的并发工具,它们位于 java.util.concurrent 包中,常见的有:
- CountDownLatch:CountDownLatch 是一个同步辅助类,它允许一个或多个线程等待其他线程完成操作。它使用一个计数器进行初始化,调用
countDown()方法会使计数器减一,当计数器的值减为 0 时,等待的线程会被唤醒。可以把它想象成一个倒计时器,当倒计时结束(计数器为 0)时,等待的事件就会发生。示例代码:
import java.util.concurrent.CountDownLatch;

public class CountDownLatchExample {
    public static void main(String[] args) throws InterruptedException {
        int numberOfThreads = 3;
        CountDownLatch latch = new CountDownLatch(numberOfThreads);

        // 创建并启动三个工作线程
        for (int i = 0; i < numberOfThreads; i++) {
            new Thread(() -> {
                System.out.println(Thread.currentThread().getName() + " 正在工作");
                try {
                    Thread.sleep(1000);  // 模拟工作时间
                    System.out.println(Thread.currentThread().getName() + " 完成工作");
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    latch.countDown(); // 成功或失败都通知等待方,结果需另行检查
                }
            }).start();
        }

        System.out.println("主线程等待工作线程完成");
        latch.await();  // 主线程等待, 直到计数器为 0
        System.out.println("所有工作线程已完成, 主线程继续执行");
    }
}
- CyclicBarrier:CyclicBarrier 允许一组线程互相等待,直到到达一个公共的屏障点。当所有线程都到达这个屏障点后,它们可以继续执行后续操作,并且这个屏障可以被重置循环使用。与
CountDownLatch不同,CyclicBarrier侧重于线程间的相互等待,而不是等待某些操作完成。示例代码:
import java.util.concurrent.CyclicBarrier;

public class CyclicBarrierExample {
    public static void main(String[] args) {
        int numberOfThreads = 3;
        CyclicBarrier barrier = new CyclicBarrier(numberOfThreads, () -> {
            System.out.println("所有线程都到达了屏障, 继续执行后续操作");
        });

        for (int i = 0; i < numberOfThreads; i++) {
            new Thread(() -> {
                try {
                    System.out.println(Thread.currentThread().getName() + " 正在运行");
                    Thread.sleep(1000);  // 模拟运行时间
                    barrier.await();  // 等待其他线程
                    System.out.println(Thread.currentThread().getName() + " 已经通过屏障");
                } catch (Exception e) {
                    e.printStackTrace();
                }
            }).start();
        }
    }
}
- Semaphore:Semaphore 是一个计数信号量,用于控制同时访问某个共享资源的线程数量。通过
acquire()方法获取许可,使用release()方法释放许可。如果没有许可可用,线程将被阻塞,直到有许可被释放。可以用来限制对某些资源(如数据库连接池、文件操作等)的并发访问量。代码如下:
import java.util.concurrent.Semaphore;

public class SemaphoreExample {
    public static void main(String[] args) {
        Semaphore semaphore = new Semaphore(2);  // 允许 2 个线程同时访问

        for (int i = 0; i < 5; i++) {
            new Thread(() -> {
                boolean acquired = false;
                try {
                    semaphore.acquire();
                    acquired = true;
                    System.out.println(Thread.currentThread().getName() + " 获得了许可");
                    Thread.sleep(2000);
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    if (acquired) {
                        semaphore.release();
                    }
                }
            }).start();
        }
    }
}
- Future 和 Callable:Callable 是一个类似于
Runnable的接口,但它可以返回结果,并且可以抛出异常。Future 用于表示一个异步计算的结果,可以通过它来获取Callable任务的执行结果或取消任务。代码如下:
import java.util.concurrent.Callable;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;

public class FutureCallableExample {
    public static void main(String[] args) throws Exception {
        ExecutorService executorService = Executors.newSingleThreadExecutor();

        Callable<Integer> callable = () -> {
            System.out.println(Thread.currentThread().getName() + " 开始执行 Callable 任务");
            Thread.sleep(2000);  // 模拟耗时操作
            return 42;  // 返回结果
        };

        Future<Integer> future = executorService.submit(callable);
        System.out.println("主线程继续执行其他任务");

        try {
            Integer result = future.get();  // 等待 Callable 任务完成并获取结果
            System.out.println("Callable 任务的结果: " + result);
        } catch (Exception e) {
            e.printStackTrace();
        }

        executorService.shutdown();
    }
}
- ConcurrentHashMap:ConcurrentHashMap 是一个线程安全的哈希表,它允许多个线程同时进行读操作,在一定程度上支持并发的修改操作,避免了
HashMap在多线程环境下需要使用synchronized或Collections.synchronizedMap()进行同步的性能问题。代码如下:
import java.util.concurrent.ConcurrentHashMap;

public class ConcurrentHashMapExample {
    public static void main(String[] args) {
        ConcurrentHashMap<String, Integer> map = new ConcurrentHashMap<>();
        map.put("key1", 1);
        map.put("key2", 2);

        // 并发读操作
        map.forEach((key, value) -> System.out.println(key + ": " + value));

        // 并发写操作
        map.computeIfAbsent("key3", k -> 3);
    }
}
# CountDownLatch 是做什么的讲一讲?
CountDownLatch 是一个倒计时式的同步工具,让一个或多个线程等待指定数量的操作完成,然后再继续执行。
比如查询商品详情时,分别查询商品信息、库存和促销,汇总线程可以等这三个任务都结束,再组装结果。
它的使用过程很直接:
- 创建时指定计数,比如 3。
- 工作任务结束时调用
countDown(),计数减 1。 - 汇总线程调用
await(),计数不为 0 就等待,为 0 就继续执行。
import java.util.concurrent.CountDownLatch;

class MainThreadWaitExample {
    public static void main(String[] args) throws InterruptedException {
        CountDownLatch latch = new CountDownLatch(3);
        for (int i = 0; i < 3; i++) {
            new Thread(() -> {
                try {
                    Thread.sleep(100);
                    System.out.println("任务处理完成");
                } catch (InterruptedException e) {
                    Thread.currentThread().interrupt();
                } finally {
                    latch.countDown();
                }
            }, "worker-" + i).start();
        }
        latch.await();
        System.out.println("三个任务都已结束,可以检查结果");
    }
}
这里把 countDown() 放在 finally 中,是因为即使某个任务抛异常,等待方也应该知道这个任务已经结束,否则计数可能一直无法归零。
但要注意,计数归零只表示约定的操作已经结束,不代表所有任务都成功。异常和结果需要另外记录,或者通过 Future、CompletableFuture 传递。
底层上,它基于 AQS 的共享模式,state 表示剩余计数。countDown() 通过 CAS 减少计数,减到 0 时使等待线程可以通过。
它还提供可见性保证:任务在 countDown() 前完成的写入,对成功通过对应 await() 的线程可见。不过这不会替代多个任务之间对共享集合进行写入时所需的同步。
最后,CountDownLatch 是一次性的,计数不能重置;计数表示需要倒数的次数,也不一定等于线程数。如果不希望无限等待,可以使用带超时的 await(),根据返回值判断是否按时完成。
# CountDownLatch 和 CyclicBarrier 有什么区别?
两者都能协调多个线程,但CountDownLatch 更像“等几件事结束”,CyclicBarrier 更像“大家在同一个集合点会合”。
| 对比项 | CountDownLatch | CyclicBarrier |
|---|---|---|
| 主要用途 | 一个或多个线程等待若干操作完成 | 一组线程相互等待,一起通过屏障 |
| 计数变化 | 调用 countDown() 减少计数 | 参与线程调用 await() 到达屏障 |
| 是否重复使用 | 一次性,不能重置计数 | 正常通过后可以继续下一轮 |
| 调用方是否等待 | countDown() 本身不等待 | await() 通常等待其他参与者到齐 |
| 完成动作 | 等待方通过 await() 后执行后续逻辑 | 可以配置屏障动作,由最后到达的线程执行 |
比如同时查三份数据,汇总线程等结果,用 CountDownLatch;三个线程分阶段计算,每一轮都需要等大家完成后再进入下一轮,可以用 CyclicBarrier。
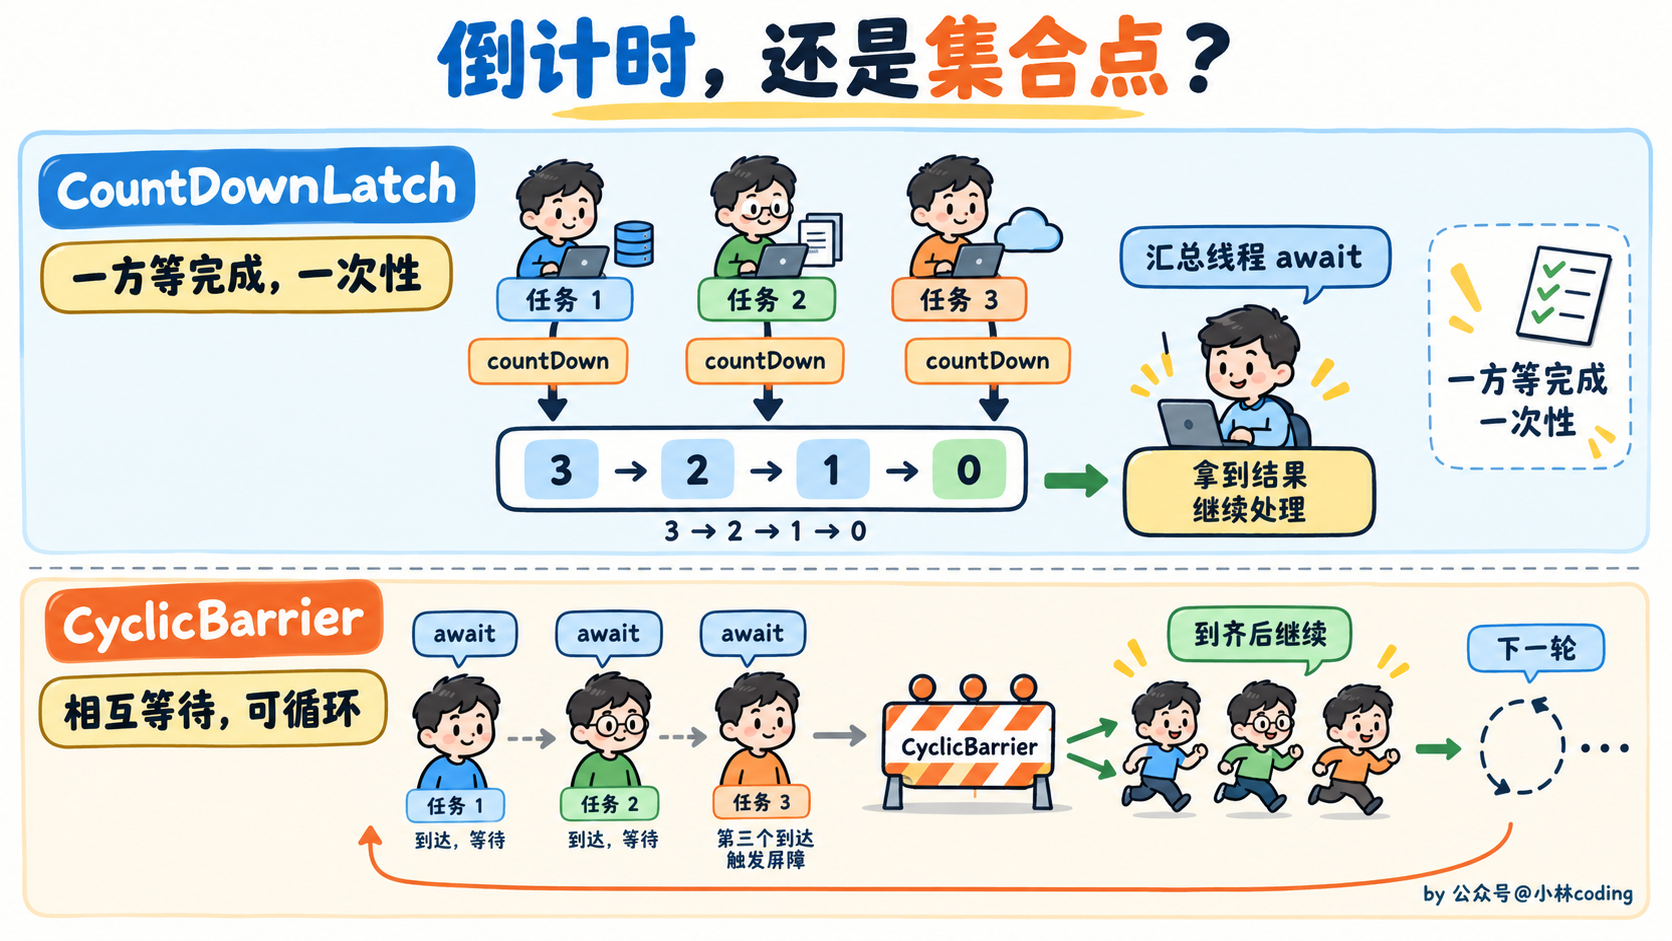
还有一个区别:某个线程在屏障等待期间被中断或等待超时,CyclicBarrier 的这一轮可能被打破,其他等待者会收到 BrokenBarrierException,需要整体处理这一轮的失败。
而 CountDownLatch 的某个等待线程被中断,不会自动把计数归零,也不会替其他任务调用 countDown()。
使用屏障还要保证参与者能全部运行起来。如果屏障需要 3 个任务到达,线程池却只有 2 个线程,前两个任务都阻塞在屏障上,第三个任务还在队列里,就可能永远到不了集合点。
# synchronized和reentrantlock及其应用场景?
两者都可以实现可重入的互斥访问,并提供相应的内存可见性保证。主要区别在于实现方式和提供的功能。
synchronized 工作原理
synchronized 使用对象关联的监视器锁。同步代码块通常对应 monitorenter、monitorexit 字节码指令;同步方法则通过方法上的 ACC_SYNCHRONIZED 标志,由 JVM 在调用和退出时处理加锁、解锁。
同一时刻只有一个线程能持有同一把锁,持有者可以再次进入使用这把锁的同步代码。退出一次同步范围,就释放一次重入,完全释放后其他线程才有机会获取锁。
如果调用 wait(),线程会释放调用对象的监视器锁,进入等待集合;收到通知后,还要重新获取锁。即使之前重入了多次,wait() 也会释放这个监视器的全部持有,并在返回前恢复原来的持有状态。
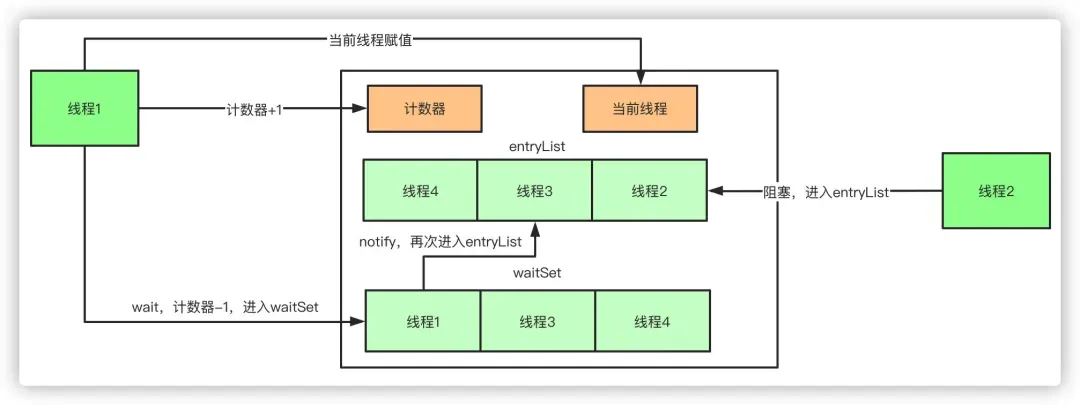
从内存语义来说,对一把锁的解锁,happens-before 后续对同一把锁的加锁。也就是说,线程 A 释放锁之前的修改,线程 B 后续拿到同一把锁之后能看到。
JVM 会针对不同的竞争情况优化 synchronized,不能认为每次加锁都要调用操作系统互斥量,或者每次都要发生线程阻塞。
ReentrantLock 工作原理
ReentrantLock 基于 AQS 实现,主要依靠同步状态 state、持有锁的线程信息,以及等待队列。
- 首次获取:锁空闲时,通过 CAS 等方式尝试修改
state,成功后记录持有线程。 - 再次获取:如果当前线程已经持有锁,就增加
state,记录重入次数。 - 获取失败:根据调用的 API,选择排队等待、响应中断、等待超时,或者直接返回失败。
- 释放锁:减少重入次数,完全释放后唤醒等待线程,使其重新尝试获取。
它默认是非公平锁,可以通过 new ReentrantLock(true) 创建公平锁。lockInterruptibly() 支持可中断等待,tryLock(timeout, unit) 支持超时等待,多个 Condition 可以区分不同的等待条件。
应用场景的区别
简单的共享数据保护,可以优先使用 synchronized。比如对一组字段进行更新,代码块比较短,也没有特殊的等待要求,自动释放锁能减少使用错误。
需要控制获取锁的过程,可以使用 ReentrantLock。比如等待锁超过 100 毫秒就放弃、任务取消后结束锁等待,或者生产者和消费者分别等待 notFull、notEmpty 两个条件。
性能要结合实际的 JDK 版本、竞争程度和临界区耗时来判断,不能直接说 ReentrantLock 一定比 synchronized 快。
# 除了用synchronized,还有什么方法可以实现线程同步?
- 使用
ReentrantLock类:ReentrantLock是一个可重入的互斥锁,相比synchronized提供了更灵活的锁定和解锁操作。它还支持公平锁和非公平锁,以及可以响应中断的锁获取操作。 - 使用
volatile关键字:虽然volatile不是锁,但它能用于标志位或状态的安全发布,提供可见性和顺序保证。它不能代替对i++等复合操作的互斥保护。 - 使用
Atomic类:Java提供了一系列的原子类,例如AtomicInteger、AtomicLong、AtomicReference等,用于实现对单个变量的原子操作,这些类在实现细节上利用了CAS(Compare-And-Swap)算法,可以用来实现无锁的线程安全。
# synchronized锁静态方法和普通方法区别?
主要区别是锁的对象不同:
- 普通同步方法:锁的是当前对象实例,也就是
this。多个线程调用同一个实例的同步方法,会相互排斥;调用不同实例的同步方法,则不会因为这两把实例锁相互阻塞。 - 静态同步方法:锁的是声明这个方法的类所对应的
Class对象,比如Service.class。访问同一个类的静态同步方法,使用的是同一把锁。
这里最常见的追问是:同一个类的静态同步方法和普通同步方法,能不能同时执行?
可以,因为一个锁的是 Service.class,另一个锁的是某个 Service 实例,是两把不同的锁。除非代码里另外获取了同一把锁,否则不会相互排斥。
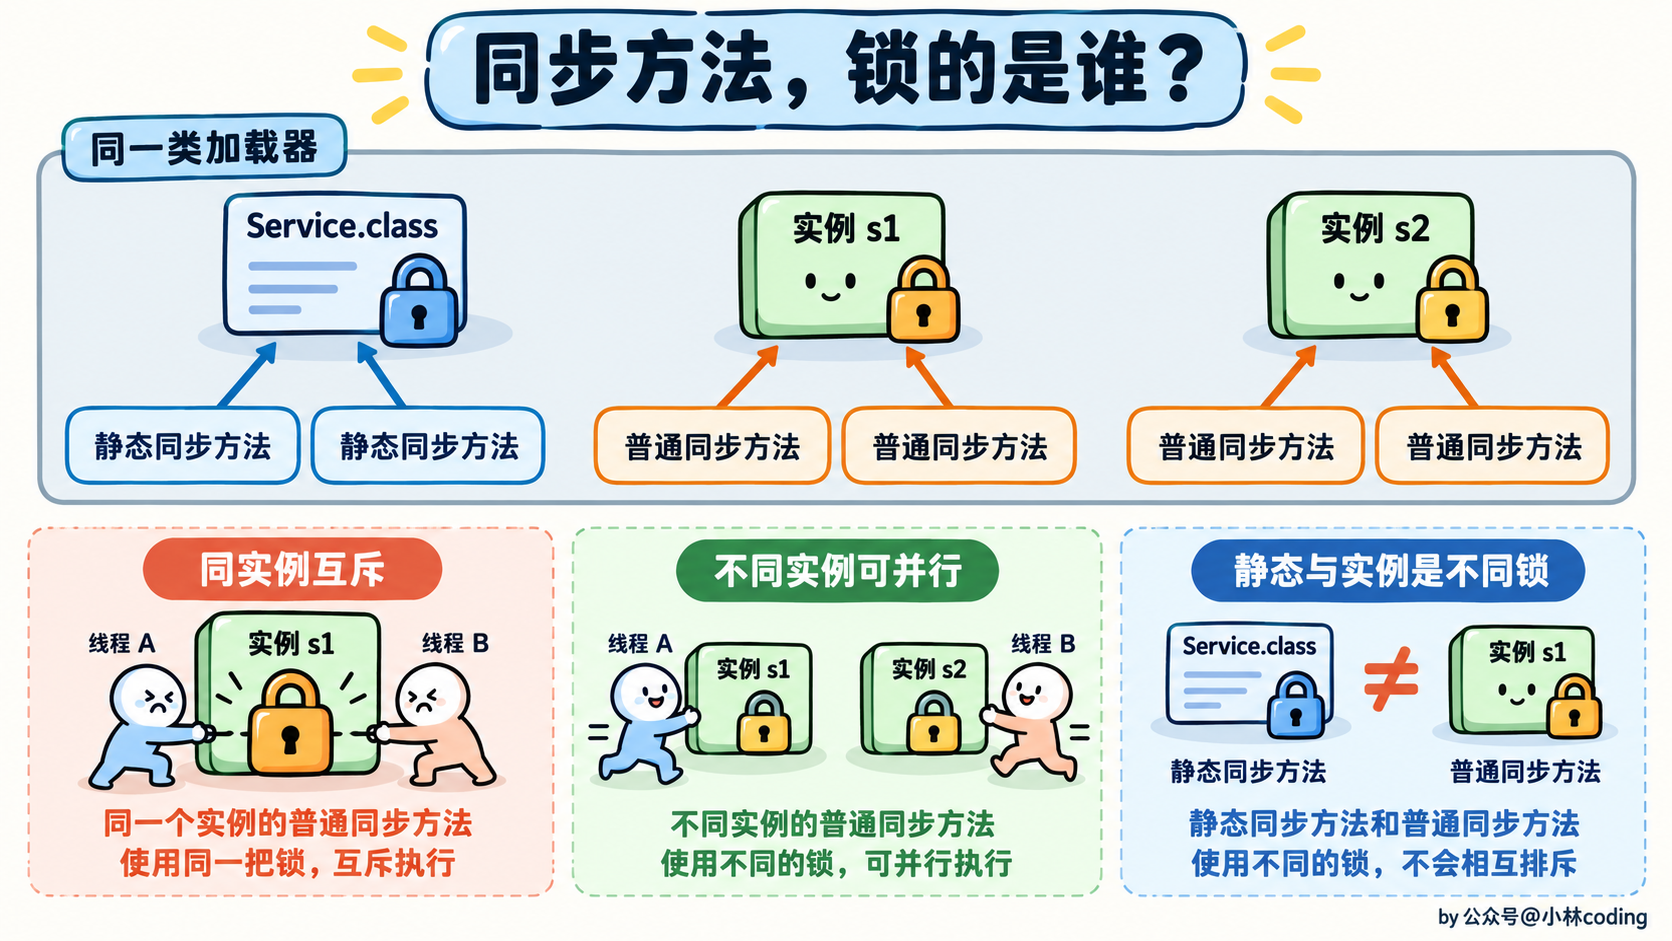
class Service {
    public synchronized void instanceMethod() {
        // 等价于对 this 加锁
    }

    public static synchronized void staticMethod() {
        // 等价于对 Service.class 加锁
    }
}
所以,如果静态方法和普通方法都会修改同一份共享数据,不能以为两个方法都加了 synchronized 就安全了。相关操作必须使用同一把锁,才能建立互斥和可见性保证。
另外,Class 对象的唯一性要放在类加载器的上下文里理解,同名类由不同类加载器加载,可以对应不同的 Class 对象。
# synchronized和reentrantlock区别?
synchronized 和 ReentrantLock 都是可重入的互斥锁,都能用于保护共享数据,区别主要有以下几个:
- 使用方式:
synchronized是关键字,进入同步范围时自动加锁,退出时自动释放;ReentrantLock是类,需要显式加锁,并在finally中解锁。 - 公平性:
synchronized不保证公平;ReentrantLock默认非公平,也可以配置为公平锁。 - 中断和超时:等待进入
synchronized不能通过中断直接取消;ReentrantLock的lockInterruptibly()支持中断,tryLock(timeout, unit)支持超时。注意,普通的lock()不会因为中断就放弃等待。 - 等待通知:
synchronized配合对象的wait()、notify()、notifyAll();ReentrantLock可以创建多个Condition,分别管理不同的等待条件。 - 底层实现:
synchronized由 JVM 实现,涉及对象的锁状态和监视器;ReentrantLock基于 AQS,利用同步状态、CAS 和等待队列协调线程。
还有一个细节:公平 ReentrantLock 的无参 tryLock() 仍然可以插队;带超时的 tryLock() 则遵守公平性设置。
选择上,简单互斥可以用 synchronized,需要超时、中断或多个条件队列时用 ReentrantLock。可中断的锁等待有助于取消任务,但不会自动解决所有死锁,仍然要正确处理中断和锁的释放。
# 怎么理解可重入锁?
可重入锁是指同一个线程在获取了锁之后,可以再次重复获取该锁而不会造成死锁或其他问题。当一个线程持有锁时,如果再次尝试获取该锁,就会成功获取而不会被阻塞。
ReentrantLock实现可重入锁的机制是基于线程持有锁的计数器。
- 当一个线程第一次获取锁时,计数器会加1,表示该线程持有了锁。在此之后,如果同一个线程再次获取锁,计数器会再次加1。每次线程成功获取锁时,都会将计数器加1。
- 当线程释放锁时,计数器会相应地减1。只有当计数器减到0时,锁才会完全释放,其他线程才有机会获取锁。
这种计数器的设计使得同一个线程可以多次获取同一个锁,而不会造成死锁或其他问题。每次获取锁时,计数器加1;每次释放锁时,计数器减1。只有当计数器减到0时,锁才会完全释放。
ReentrantLock通过这种计数器的方式,实现了可重入锁的机制。它允许同一个线程多次获取同一个锁,并且能够正确地处理锁的获取和释放,避免了死锁和其他并发问题。
# synchronized 支持重入吗?如何实现的?
支持。同一个线程已经持有某个对象的监视器锁,再次进入使用同一把锁的同步代码时,可以直接重入。
比如下面两个同步方法,锁的都是当前对象 this:
class Service {
    public synchronized void outer() {
        inner();
    }

    public synchronized void inner() {
        // 处理业务
    }
}
线程执行 outer() 时已经拿到 this 的锁,调用 inner() 时可以继续进入,不会因为自己占着锁就把自己阻塞住。
从语义上,可以理解为 JVM 要记录锁的持有者和重入层数:同一个线程再次进入,就增加重入层数;退出一次,就减少一层;全部退出后,才真正释放锁。
不过,不同锁实现阶段的底层表示不完全一样。在 HotSpot 的重量级监视器实现里,可以通过持有者和重入计数来管理;轻量级锁则有自己的重入记录方式,不能说所有阶段都靠 ObjectMonitor 的同一个计数器实现。
另外,可重入只解决同一个线程重复获取同一把锁的问题。如果线程 A 持有锁 1 等锁 2,线程 B 持有锁 2 等锁 1,仍然会死锁。
# synchronized锁升级的过程讲一下
这道题要先说明 JDK 版本。面试里常说的“无锁 → 偏向锁 → 轻量级锁 → 重量级锁”,主要是针对开启偏向锁的早期 HotSpot 实现,比如常见的 JDK 8 场景。
JDK 15 起,偏向锁默认禁用。较新的 JDK 对轻量级锁也有实现调整,所以不能把这条路径当成所有版本都完全一样的固定流程。
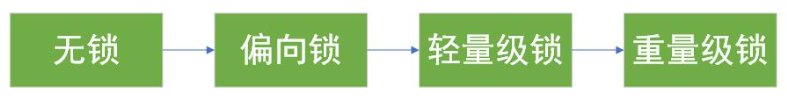
这些优化的主要思路是:竞争不激烈时,尽量在用户态完成加锁;竞争激烈或者等待时间较长时,再通过监视器管理等待线程。
以传统 HotSpot 实现为例
对象头里的 Mark Word 会保存对象的部分状态信息。在不同锁状态下,它的内容可能不同,比如偏向线程信息、锁记录指针或者监视器指针。
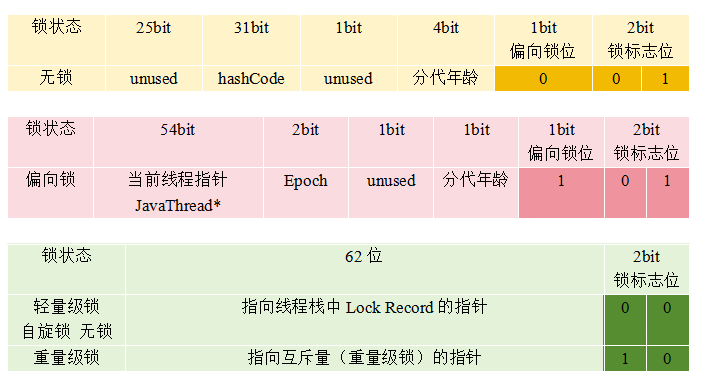
- 无锁状态:对象还没有被线程锁定。锁是否需要获取、采用哪种方式,要看对象状态、JVM 配置和竞争情况。
- 偏向锁:针对同一线程反复进入同步块的场景,把偏向线程的信息记录下来,后续这个线程进入时可以减少同步开销。其他线程访问时,可能需要撤销偏向或重新偏向,再根据是否存在竞争采用其他方式。
- 轻量级锁:传统实现会在线程栈中建立锁记录,通过 CAS 等操作尝试更新对象头。没有竞争时,可以避免线程阻塞;获取失败时,根据具体实现和竞争情况,可能重试或使锁膨胀。
- 重量级锁:对象关联一个
ObjectMonitor,由监视器管理锁的持有者和等待线程。竞争线程可能先自旋尝试,仍无法获得锁时再阻塞,等待后续唤醒。
自旋的目的,是希望持锁线程很快释放锁,从而避免一次阻塞和唤醒。它会占用 CPU,所以并不是自旋越久越好,具体策略由 JVM 实现决定。
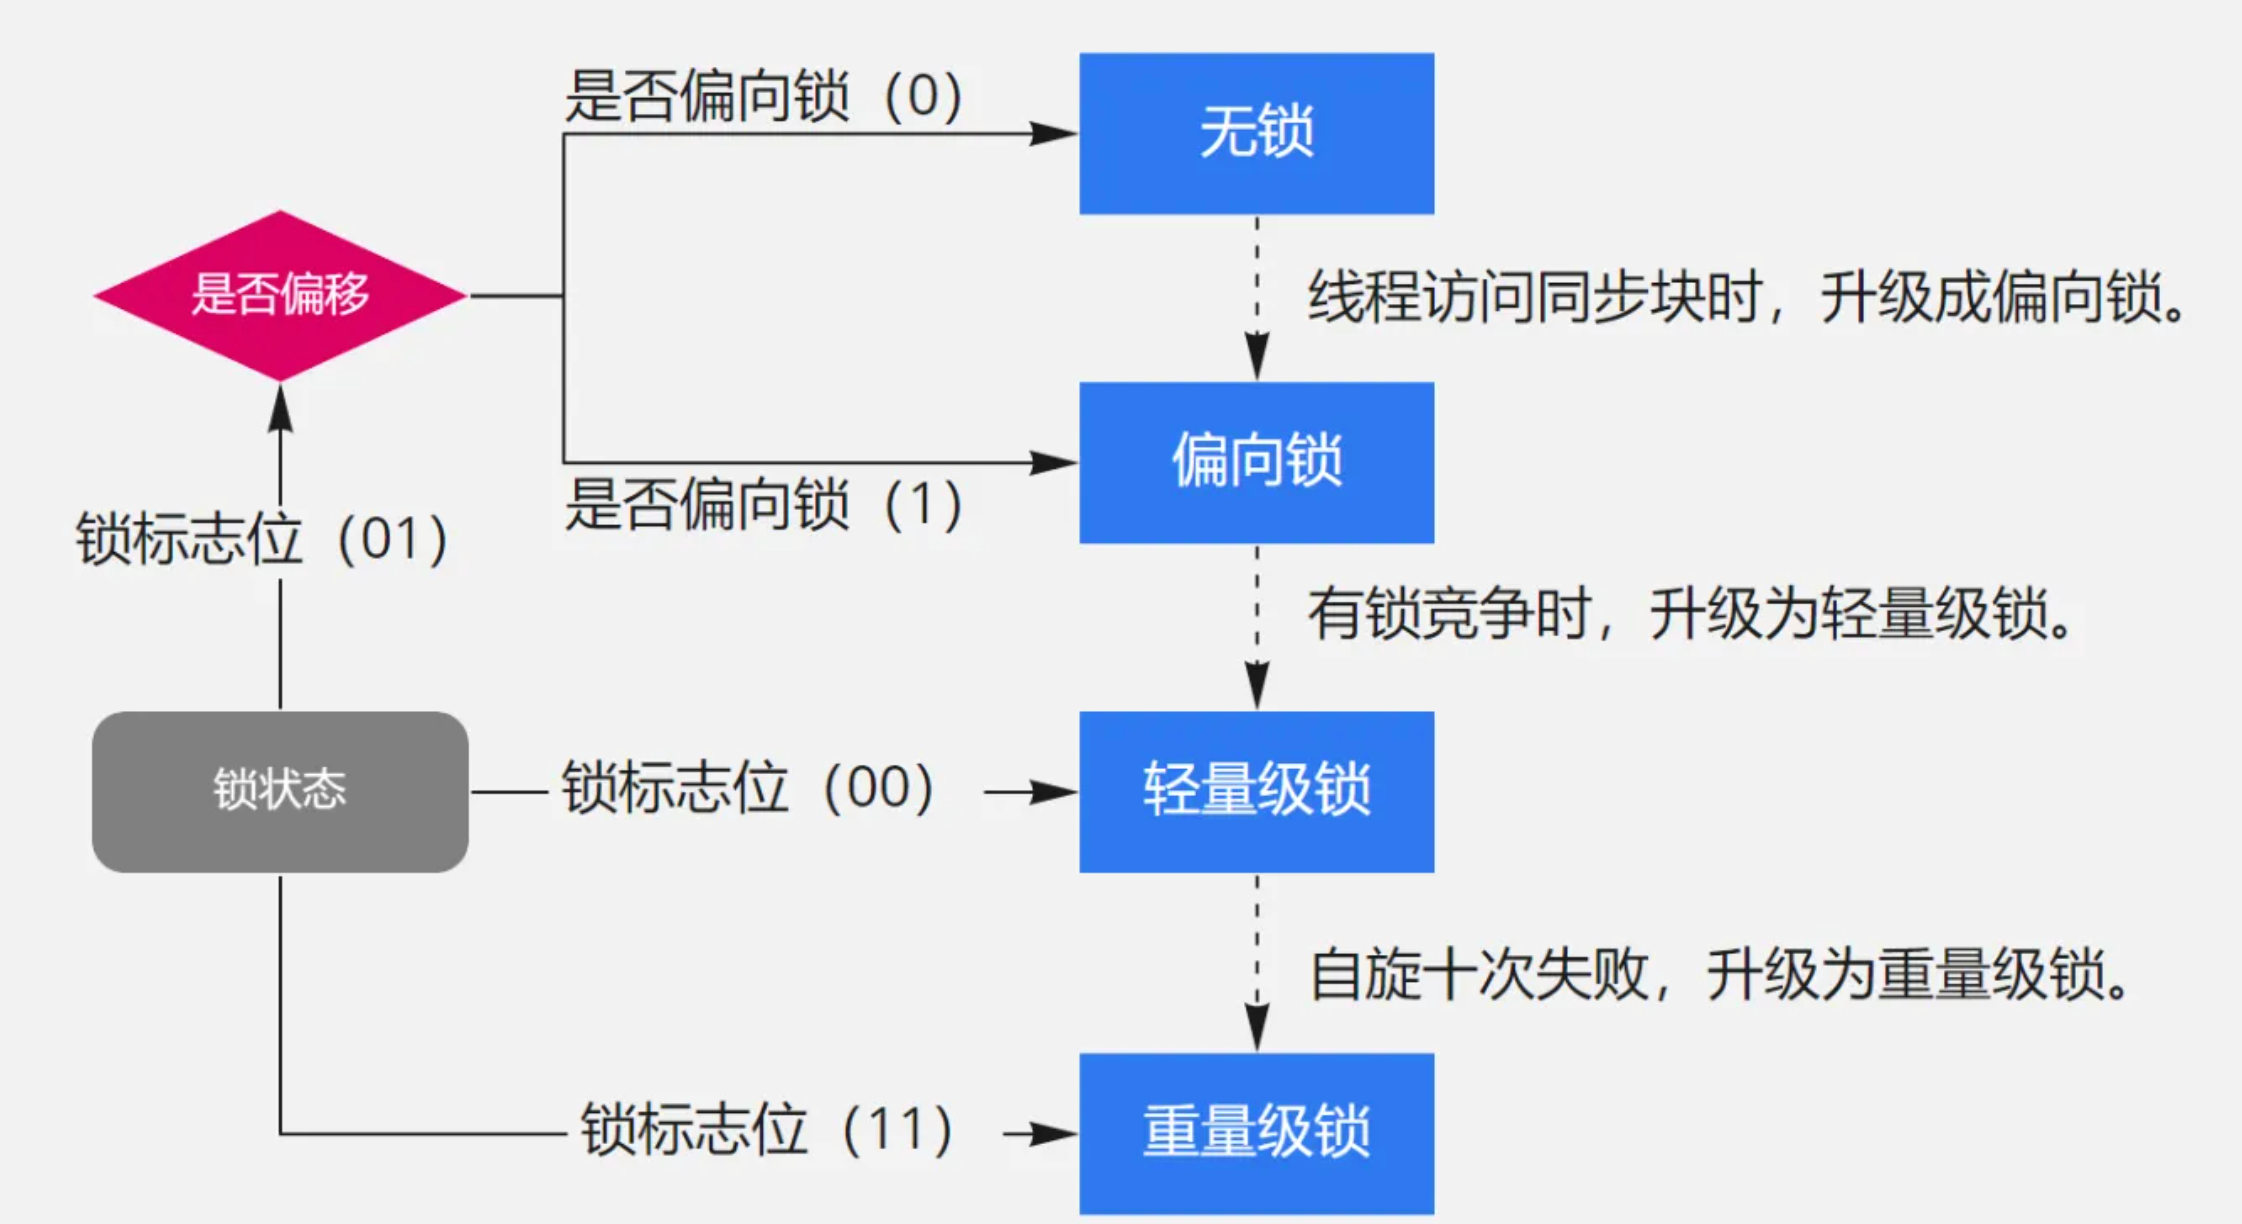
这里有两个容易答错的地方:
第一,锁不是每次都要按所有阶段走一遍。比如偏向锁关闭了,就不会经过偏向锁;调用 wait() 等操作,也可能触发监视器膨胀。
第二,“锁只能升级,永远不能降级”说得太绝对。竞争期间不会为了降低开销随意切换锁状态,但 HotSpot 可以在合适的条件下,对已经空闲的监视器进行 deflation,也就是解除对象与监视器的关联。这个过程不能理解为持锁期间随意降级。
面试时可以先讲传统实现的优化思路,再补充自己使用的 JDK 版本,重点解释为什么要减少无竞争时的开销,以及为什么竞争激烈时需要阻塞等待。
# JVM对Synchornized的优化?
JVM 对 synchronized 的优化,主要是减少不必要的加锁,以及降低锁竞争的开销。常见的有下面几种:
- 针对不同竞争情况采用不同加锁方式:在无竞争或竞争较少时,尽量通过轻量级的操作完成加锁;必要时再膨胀为监视器锁。传统 HotSpot 还使用过偏向锁,但它从 JDK 15 起默认禁用,不能把偏向锁当作所有版本都有的默认优化。
- 锁消除:JIT 编译器通过逃逸分析等手段,判断某个对象不会被其他线程访问时,可以消除不必要的同步。比如方法内部创建、没有逃逸出去的
StringBuffer,相关同步就可能被消除。不过不是所有局部变量都能消除锁,还要看它引用的对象是否逃逸。 - 锁粗化:对同一把锁连续进行多次加锁、解锁时,JIT 可能把同步范围扩大,减少反复获取和释放的成本。是否进行粗化取决于编译器分析,不能认为代码里出现循环就一定会把锁移到循环外。
- 自适应自旋:获取锁失败后,先尝试一段时间,避免持锁线程马上释放锁时,等待线程却已经阻塞。JVM 会结合竞争情况调整策略,长时间自旋反而会浪费 CPU。
比如锁消除和锁粗化,看起来一个是“去掉锁”,一个是“扩大锁”,但它们都要在保证程序同步语义的前提下进行。
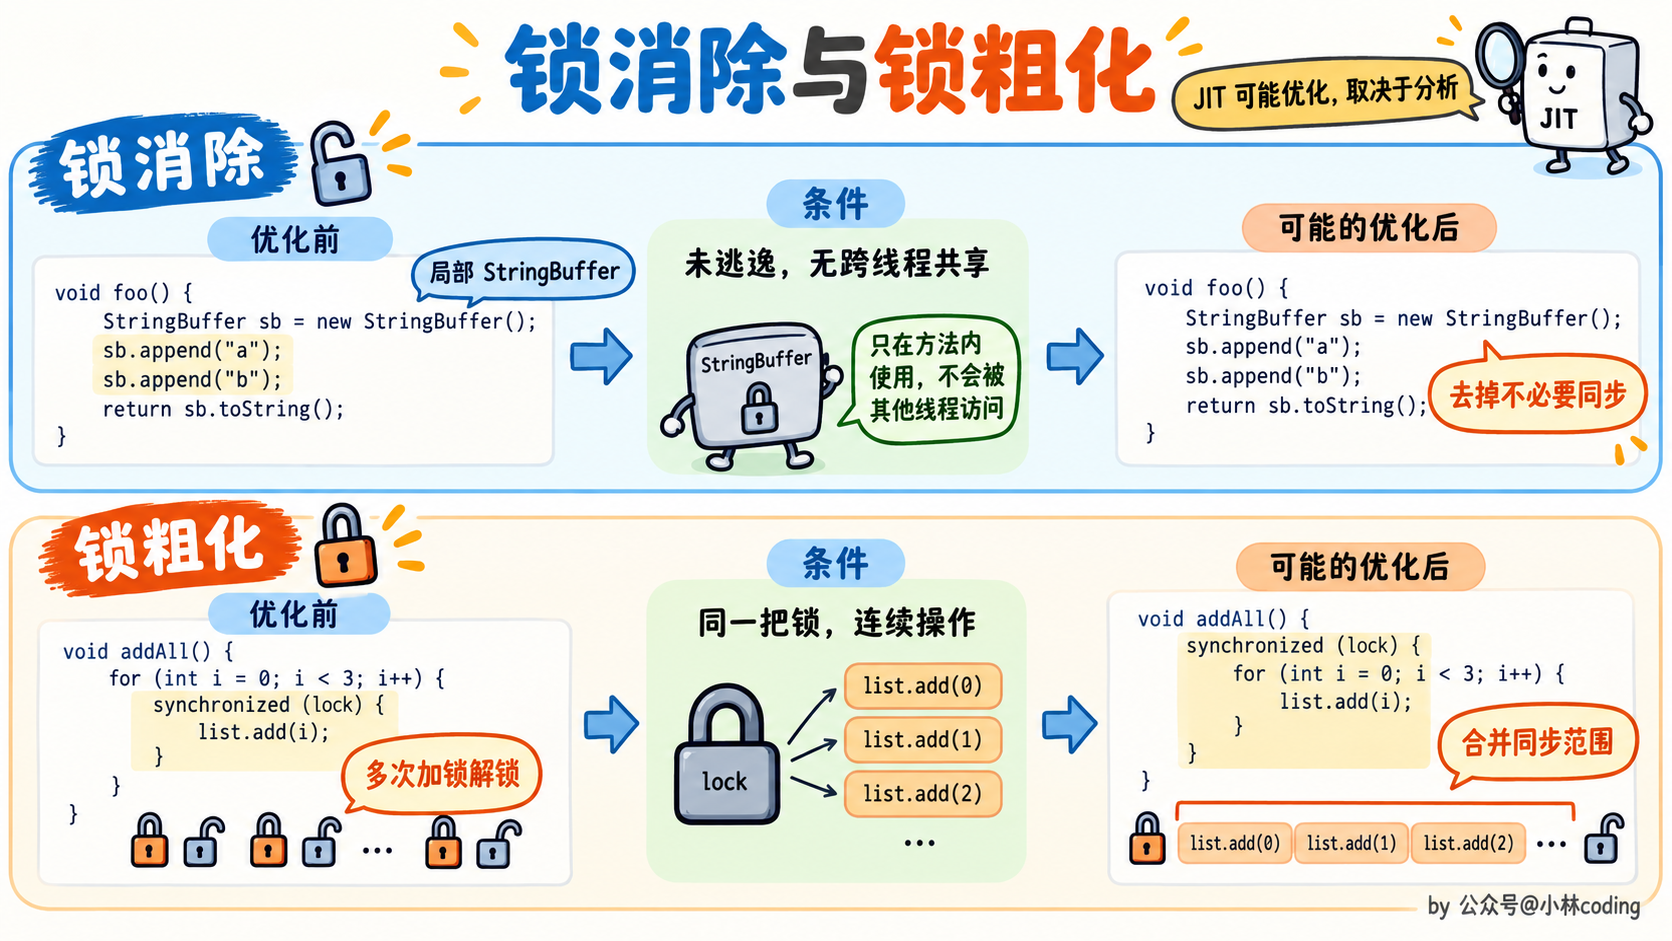
实际开发时,还是应该先减少锁内的耗时操作、避免不必要的共享,再通过性能分析看是否存在锁竞争。不能把性能问题全部寄希望于 JVM 自动优化。
# 介绍一下AQS
AQS 全称是 AbstractQueuedSynchronizer,是 Java 用来构建锁和同步器的基础框架。像 ReentrantLock、Semaphore、CountDownLatch,都使用了 AQS。
简单说,AQS 负责同步状态的管理,以及获取失败后的排队、阻塞和唤醒;具体“怎样才算获取成功”,由它的子类决定。
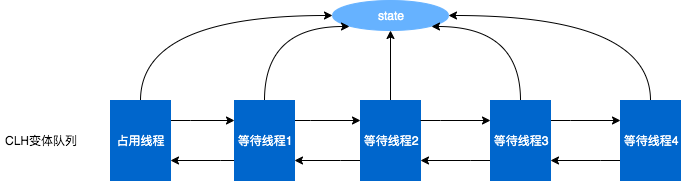
它的核心可以分成三部分:
同步状态 state
AQS 使用一个 volatile int 类型的 state 表示同步状态,不同工具里,它的含义不同:
ReentrantLock:表示锁的持有次数,0 表示未被持有,正数表示已经持有及其重入次数。Semaphore:表示可用许可数量。CountDownLatch:表示还需要完成多少次倒数。
子类可以通过 getState()、setState()、compareAndSetState() 访问状态。这里要注意,volatile 保证可见性,但涉及并发竞争的“读取后修改”,仍然需要 CAS 等措施;setState() 本身不是比较并交换。
等待队列
获取资源失败后,AQS 会把等待线程组织到一个双向队列里。这个队列借鉴了 CLH 队列的思路,但不是让所有线程一直自旋,而是配合 LockSupport.park()、unpark() 进行等待和唤醒。
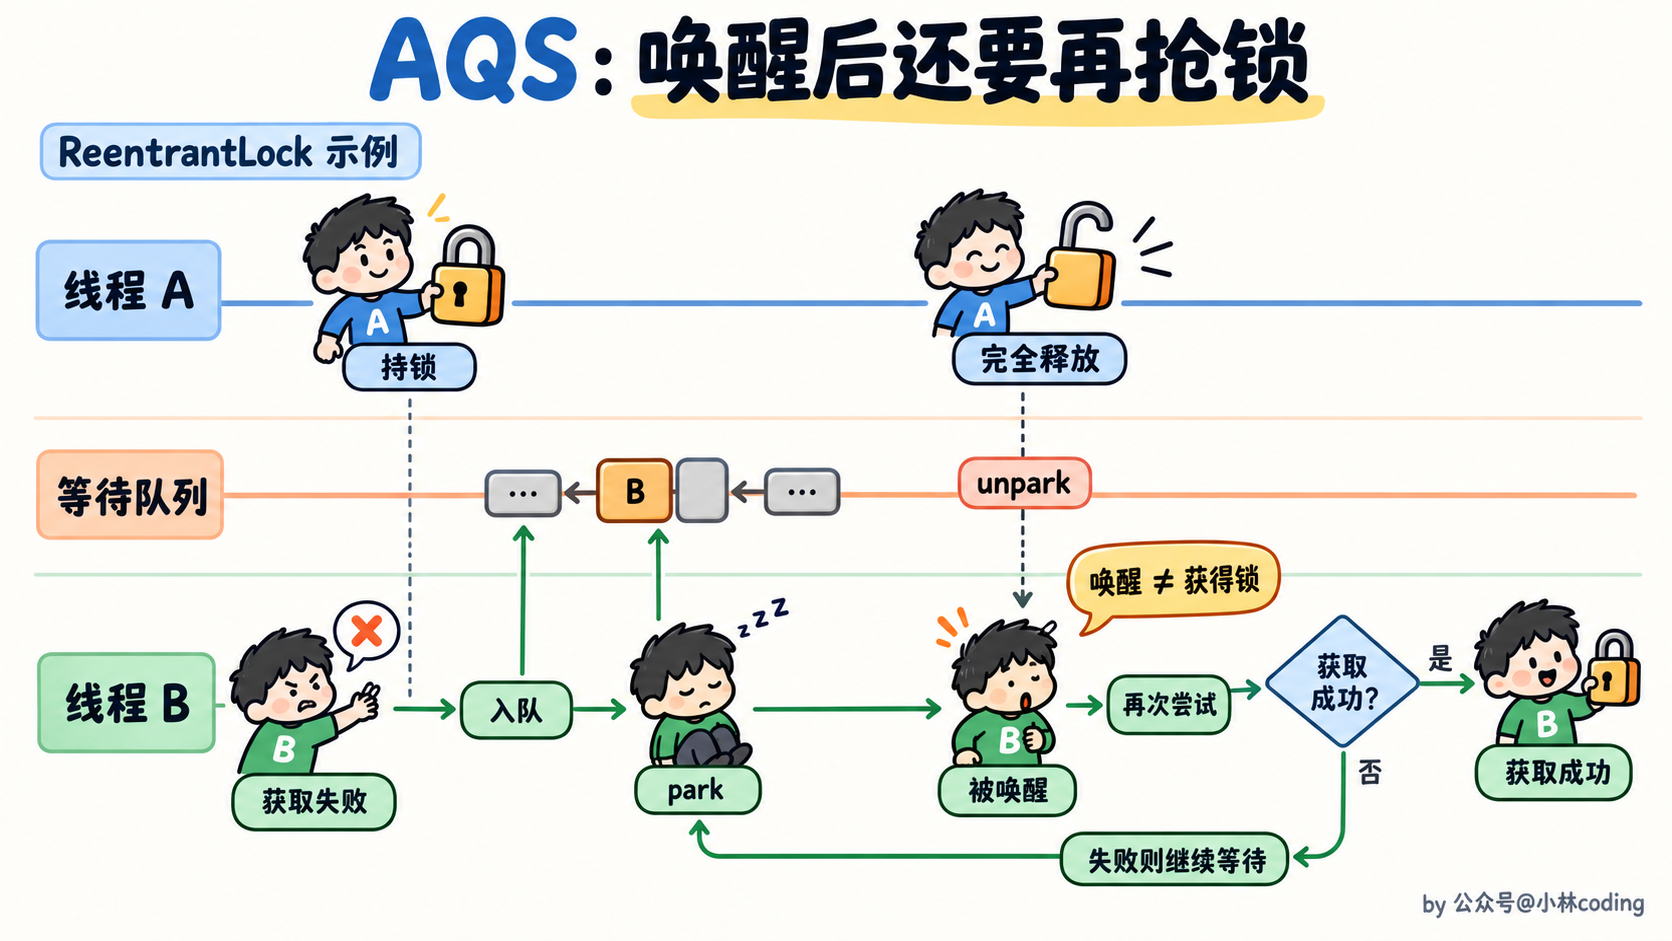
比如线程 A 持有锁,线程 B 获取失败,B 就可能进入队列并等待。A 完全释放锁后,会唤醒后继等待线程,让它重新尝试获取。
被唤醒不代表直接拿到了锁,等待线程仍然要再次判断同步状态,并尝试获取资源。
子类实现获取和释放规则
AQS 把通用的排队流程封装起来,子类按需实现以下方法:
- 独占模式:
tryAcquire()、tryRelease(),比如ReentrantLock。 - 共享模式:
tryAcquireShared()、tryReleaseShared(),比如Semaphore、CountDownLatch。 - 独占持有判断:
isHeldExclusively(),用于判断当前线程是否独占同步器,配合条件等待等功能。
独占模式下,通常同一时刻只有一个线程能获取资源;共享模式下,可以根据状态允许多个线程通过。比如信号量有多个许可时,多个线程都能获取成功。
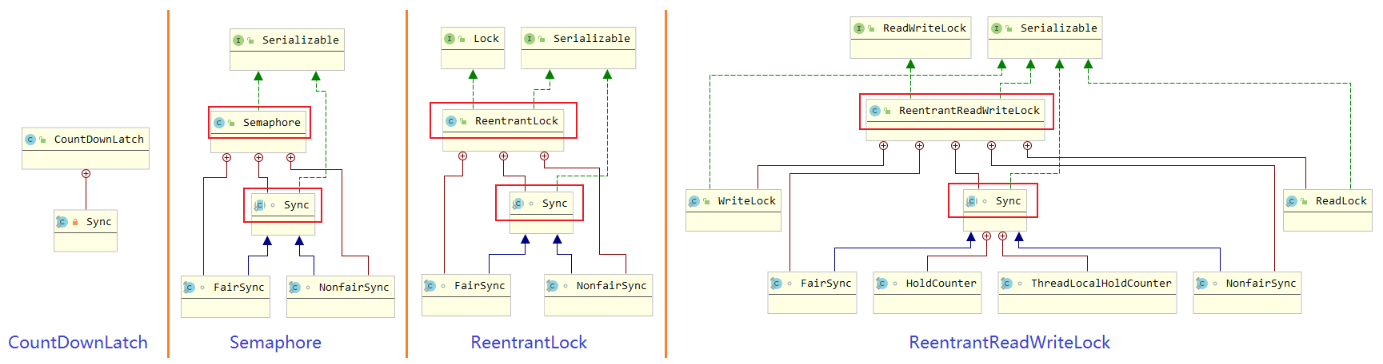
具体类通常在内部定义一个继承 AQS 的 Sync,把自己的同步规则写进去,外部再提供 lock()、acquire()、await() 等 API。
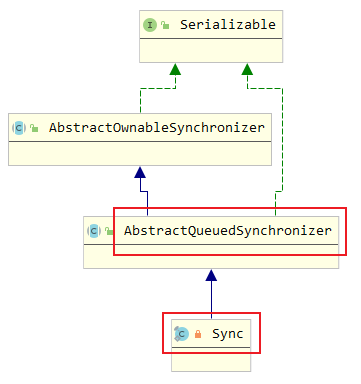
最后补充一个常见追问:AQS 有 FIFO 队列,不代表基于 AQS 的锁一定公平。新来的线程是否需要先检查队列、能不能直接尝试获取资源,取决于子类的实现。ReentrantLock 的公平锁和非公平锁,就使用了不同的获取规则。
# CAS 和 AQS 有什么关系?
CAS 和 AQS 不是同一个层次的东西:CAS 是一种原子更新操作,AQS 是构建锁和同步器的框架。
CAS 可以理解成“先比较,再更新”:给出预期值和新值,如果当前值等于预期值,就把它更新成新值,否则更新失败。比较和更新作为一个原子操作完成,底层通常由硬件原子指令支持。
AQS 则解决更多问题:同步状态如何管理、获取失败的线程如何排队、什么时候阻塞、释放资源后如何唤醒。CAS 是它实现这些机制时会用到的基础操作。
以 ReentrantLock 为例:
- 锁空闲时,线程尝试通过 CAS 把
state从 0 改为 1,竞争成功后成为锁的持有者。 - 获取失败时,由 AQS 管理后续的排队和等待,不会让线程无限制地循环 CAS。
- 持有者释放锁时,减少重入次数,完全释放后再唤醒等待线程。
这里要注意,AQS 并不是每次修改 state 都必须使用 CAS。比如独占锁的持有者在重入或释放时,只有自己能修改持有次数,可以使用 setState();而信号量等共享同步器的并发状态更新,则通常需要 CAS。
所以,CAS 负责某一步更新的原子性,AQS 在此基础上组织完整的同步流程。
# 如何用 AQS 实现一个可重入的公平锁?
AQS 实现一个可重入的公平锁的详细步骤:
- 继承 AbstractQueuedSynchronizer:创建一个内部类继承自
AbstractQueuedSynchronizer,重写tryAcquire、tryRelease、isHeldExclusively等方法,这些方法将用于实现锁的获取、释放和判断锁是否被当前线程持有。 - 实现可重入逻辑:在
tryAcquire方法中,检查当前线程是否已经持有锁,如果是,则增加锁的持有次数(通过state变量);如果不是,尝试使用 CAS操作来获取锁。 - 实现公平性:在
tryAcquire方法中,在首次获取锁时,通过hasQueuedPredecessors()判断当前线程前面是否有排队的等待者,有前驱就不能直接获取;当前持有者重入时则不受这个检查限制。 - 创建锁的外部类:创建一个外部类,内部持有
AbstractQueuedSynchronizer的子类对象,并提供lock和unlock方法,这些方法将调用AbstractQueuedSynchronizer子类中的方法。
import java.util.concurrent.locks.AbstractQueuedSynchronizer;
import java.util.concurrent.locks.Condition;

public class FairReentrantLock {

    private static class Sync extends AbstractQueuedSynchronizer {

        // 判断锁是否被当前线程持有
        protected boolean isHeldExclusively() {
            return getExclusiveOwnerThread() == Thread.currentThread();
        }

        // 尝试获取锁
        protected boolean tryAcquire(int acquires) {
            final Thread current = Thread.currentThread();
            int c = getState();
            if (c == 0) {
                // 公平性检查:检查队列中是否有前驱节点, 如果有, 则当前线程不能获取锁
                if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) {
                    setExclusiveOwnerThread(current);
                    return true;
                }
            } else if (current == getExclusiveOwnerThread()) {
                // 可重入逻辑:如果是当前线程持有锁, 则增加持有次数
                int nextc = c + acquires;
                if (nextc < 0) {
                    throw new Error("Maximum lock count exceeded");
                }
                setState(nextc);
                return true;
            }
            return false;
        }

        // 尝试释放锁
        protected boolean tryRelease(int releases) {
            int c = getState() - releases;
            if (Thread.currentThread()!= getExclusiveOwnerThread()) {
                throw new IllegalMonitorStateException();
            }
            boolean free = false;
            if (c == 0) {
                free = true;
                setExclusiveOwnerThread(null);
            }
            setState(c);
            return free;
        }

        // 提供一个条件变量, 用于实现更复杂的同步需求, 这里只是简单实现
        ConditionObject newCondition() {
            return new ConditionObject();
        }
    }

    private final Sync sync = new Sync();

    // 加锁方法
    public void lock() {
        sync.acquire(1);
    }

    // 解锁方法
    public void unlock() {
        sync.release(1);
    }

    // 判断当前线程是否持有锁
    public boolean isHeldByCurrentThread() {
        return sync.isHeldExclusively();
    }

    // 提供一个条件变量, 用于实现更复杂的同步需求, 这里只是简单实现
    public Condition newCondition() {
        return sync.newCondition();
    }
}
代码解释:
内部类 Sync:
isHeldExclusively:使用getExclusiveOwnerThread方法检查当前锁是否被当前线程持有。tryAcquire:首先获取当前锁的状态
c。如果
c为 0,表示锁未被持有,此时进行公平性检查,通过hasQueuedPredecessors检查是否有前驱节点在等待队列中。如果没有,使用compareAndSetState尝试将状态设置为acquires(通常为 1),并设置当前线程为锁的持有线程。如果
c不为 0,说明锁已被持有,检查是否为当前线程持有。如果是,增加锁的持有次数(可重入),但要防止溢出。
tryRelease:先将状态减
releases(通常为 1)。检查当前线程是否为锁的持有线程,如果不是,抛出异常。
如果状态减为 0,说明锁被完全释放,将持有线程设为
null。
newCondition:创建一个ConditionObject用于更复杂的同步操作,如等待 / 通知机制。
外部类 FairReentrantLock:
lock方法:调用sync.acquire(1)尝试获取锁。unlock方法:调用sync.release(1)释放锁。isHeldByCurrentThread方法:调用sync.isHeldExclusively判断锁是否被当前线程持有。newCondition方法:调用sync.newCondition提供条件变量。
# Threadlocal作用,原理,具体里面存的key value是啥,会有什么问题,如何解决?
ThreadLocal 是 Java 提供的线程局部变量工具。简单说,就是同一个 ThreadLocal,在不同线程里可以存不同的值,各个线程访问的是自己的那一份。
比如处理用户请求时,可以把当前用户信息放进 ThreadLocal,这样同一个线程里的业务方法就能直接获取,不用每层方法都传一遍参数。
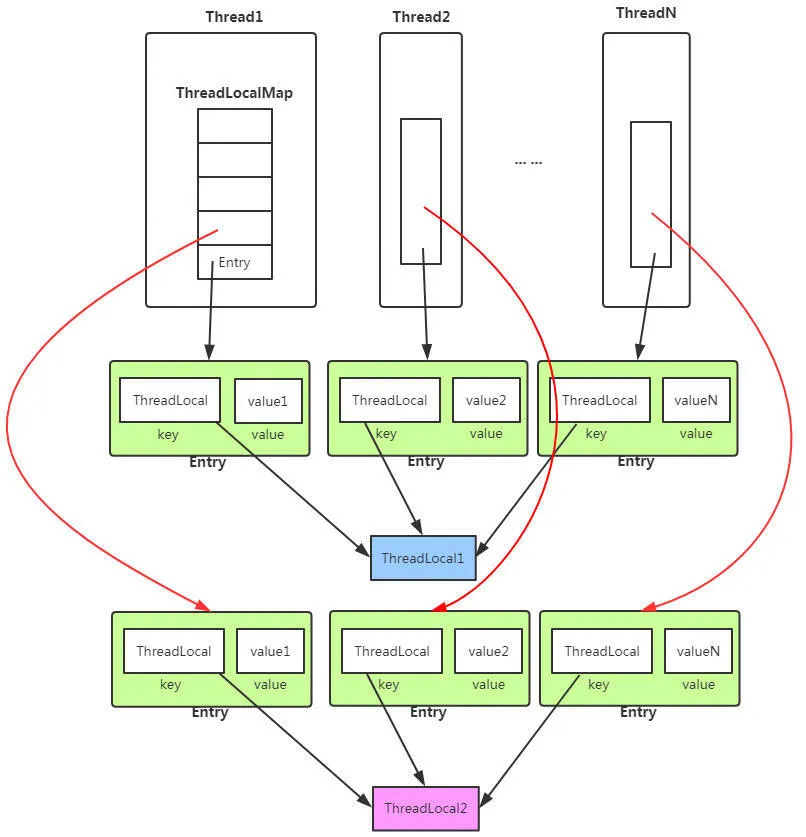
ThreadLocal 的原理
它的底层依赖 ThreadLocalMap,但这里有个容易搞反的地方:不是 ThreadLocal 对象里存着所有线程的数据,而是每个 Thread 对象里有自己的 ThreadLocalMap。
这个 Map 内部维护了一个 Entry 数组,每个 Entry 存一组 key、value:
- key:对
ThreadLocal对象的弱引用。 - value:当前线程存进去的值,是强引用。
所以,两个线程即使使用同一个 ThreadLocal 对象,访问的也是各自线程里的 Map,数据就隔离开了。
调用 set() 时,会找到当前线程的 ThreadLocalMap,把这个 ThreadLocal 和对应的值存进去。
调用 get() 时,也是在当前线程的 Map 里查找。如果还没有对应的条目,就调用 initialValue() 获取初始值并保存;默认初始值是 null,也可以通过 withInitial() 指定。
调用 remove() 时,则会移除当前线程里对应的条目。
不过要注意,ThreadLocal 隔离的是变量的存储,不会自动复制对象。如果两个线程都把同一个可变对象放进去,它们操作的还是同一个对象,仍然可能出现线程安全问题。
可能存在的问题
首先是内存泄漏。
前面说了,key 是弱引用,value 是强引用。如果外部不再持有这个 ThreadLocal 的强引用,它就可能被 GC 回收,Entry 的 key 变成 null。
但 key 被回收,不代表 value 也会一起被回收。只要线程还活着,就可能存在下面这条引用链:
Thread → ThreadLocalMap → Entry → value
这样,已经不再使用的 value 仍然占着内存。在线程池里尤其要注意,因为工作线程通常会存活很长时间。
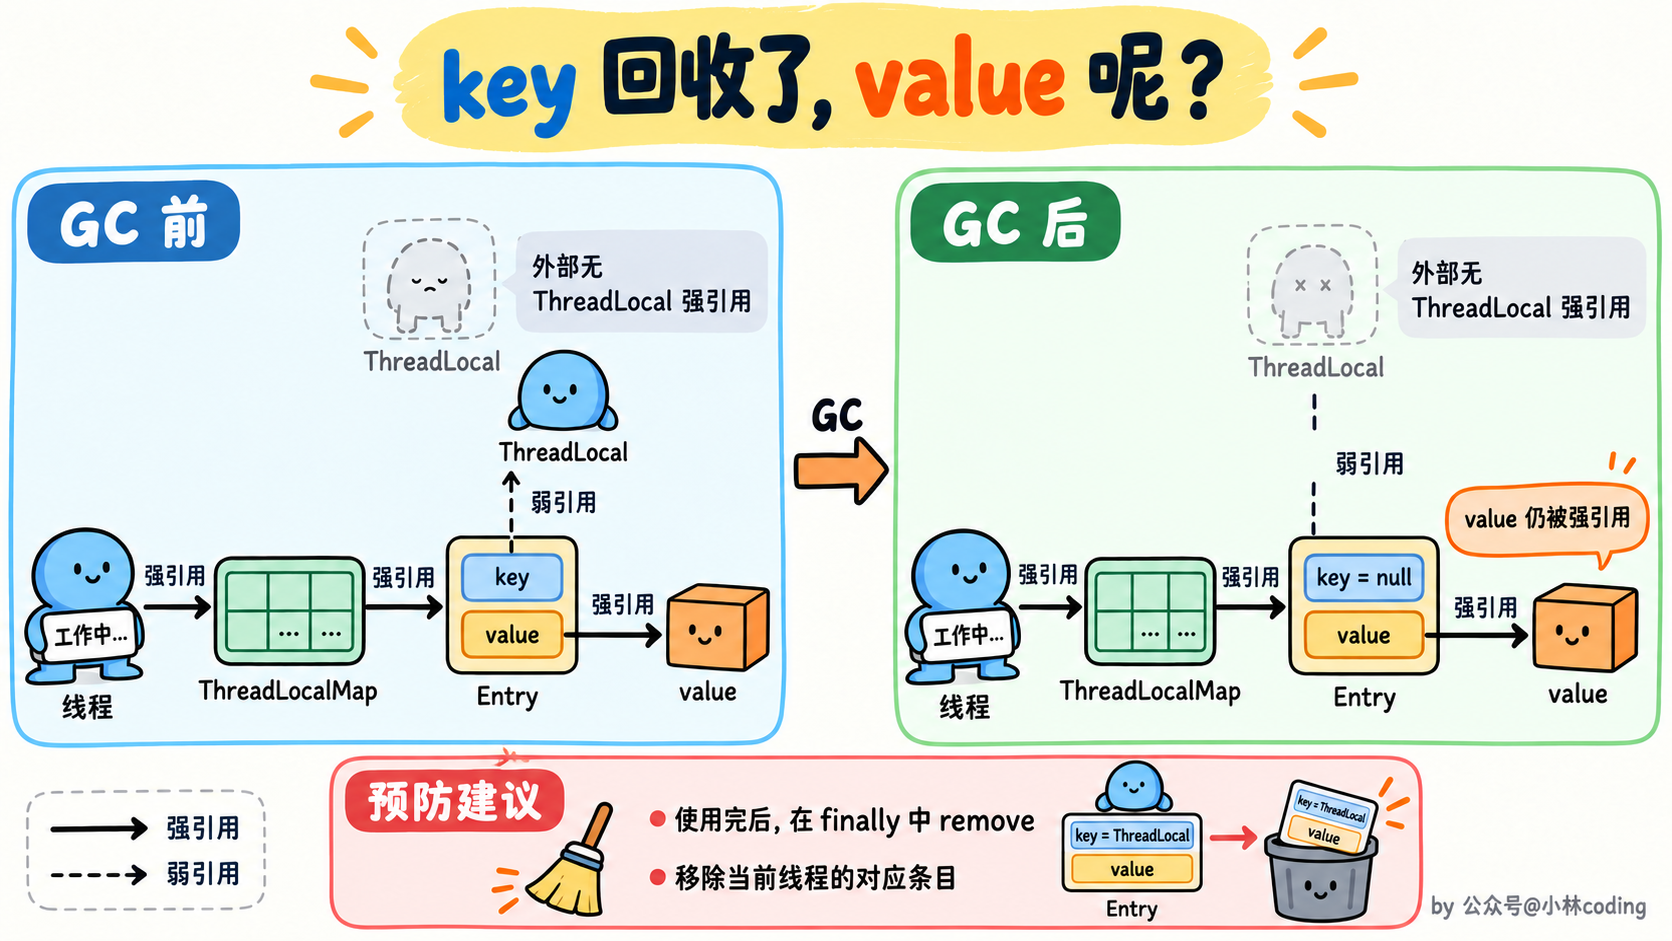
ThreadLocalMap 会在部分 get()、set()、remove() 操作中清理失效条目,但不能保证下一次操作就把所有 key 为 null 的条目清理干净,所以不能依赖它自动兜底。
而且,即使 key 没有被回收,比如 ThreadLocal 定义成了静态变量,忘记清理也可能让已经用完的数据长期留在线程里。
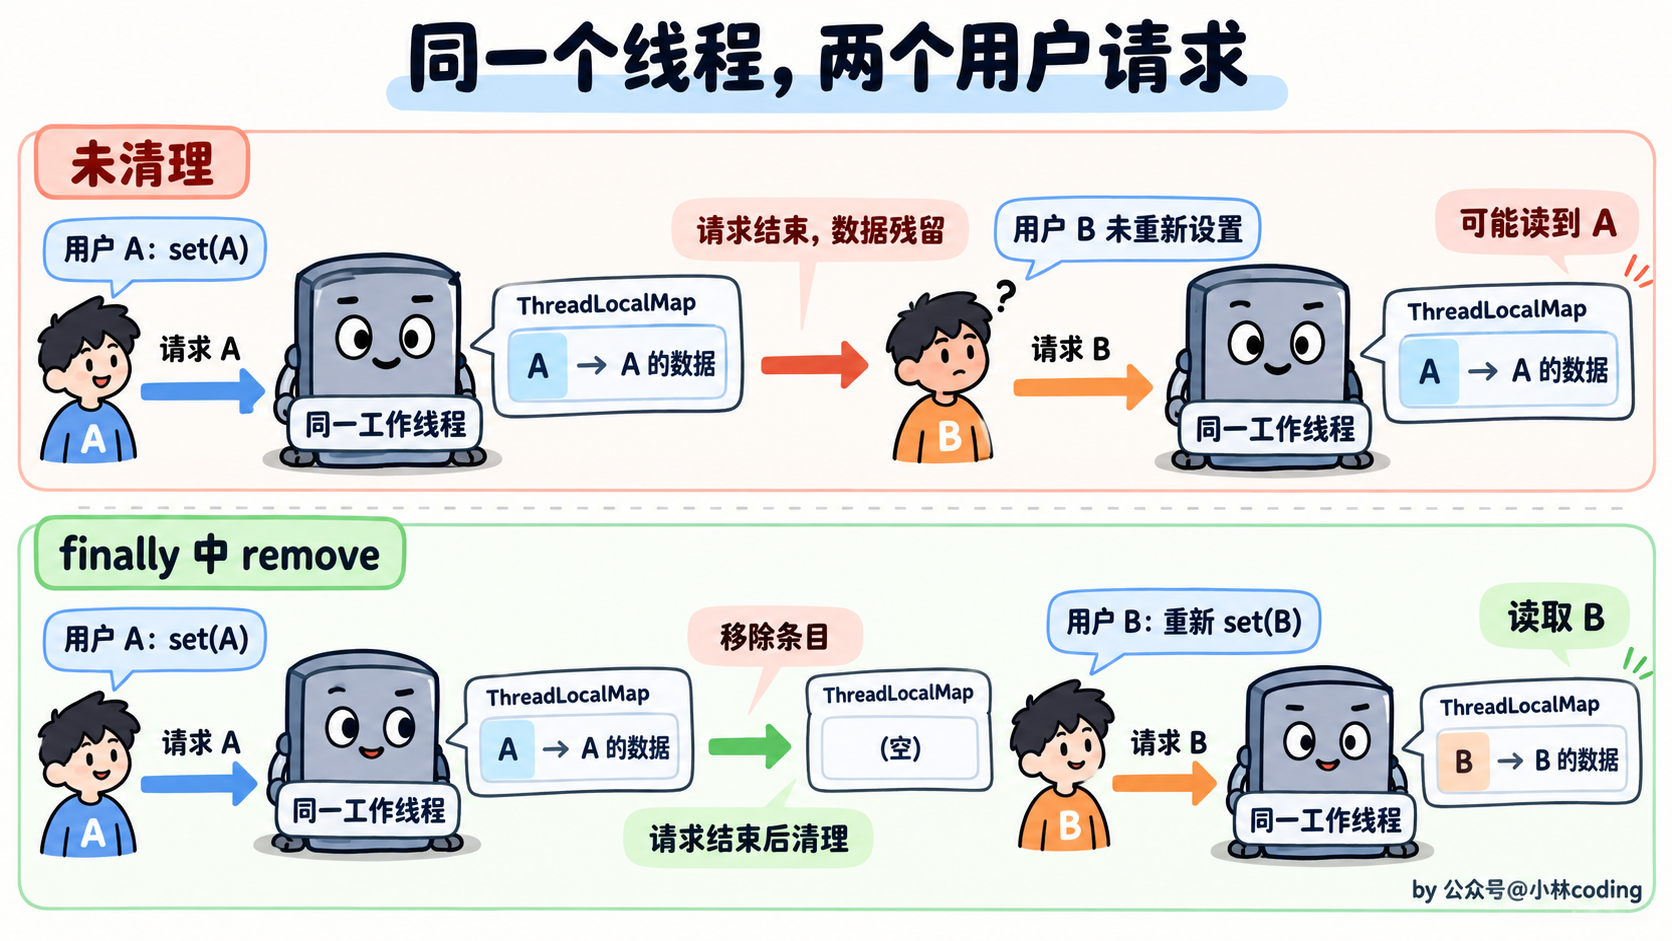
其次是线程复用导致的数据串用。
比如线程池里的线程处理完用户 A 的请求,没有清理用户信息。随后这个线程处理用户 B 的请求,如果新请求没有正确设置上下文,就可能读到用户 A 的数据。
所以使用时,应该把清理放在 finally 里:
private static final ThreadLocal<String> USER_CONTEXT =
        new ThreadLocal<>();

public void handleRequest(String userId) {
    try {
        USER_CONTEXT.set(userId);
        // 处理业务,同一个线程内可以获取用户信息
    } finally {
        USER_CONTEXT.remove();
    }
}
这样无论业务成功还是抛出异常,都会执行清理。
另外,普通 ThreadLocal 不会自动把数据传给异步任务。如果把任务提交到线程池,任务执行在线程池的工作线程里,不能直接拿到提交任务的线程中的值。需要在提交前取出数据,再通过参数等方式显式传过去。
# 悲观锁和乐观锁的区别?
- 乐观锁: 就像它的名字一样,对于并发间操作产生的线程安全问题持乐观状态,乐观锁认为竞争不总 是会发生,因此它不需要持有锁,将比较-替换这两个动作作为一个原子操作尝试去修改内存中的变量,如果失败则表示发生冲突,那么就应该有相应的重试逻辑。
- 悲观锁: 还是像它的名字一样,对于并发间操作产生的线程安全问题持悲观状态,悲观锁认为竞争总 是会发生,因此每次对某资源进行操作时,都会持有一个独占的锁,就像 synchronized,不管三七二十一,直接上了锁就操作资源了。
# Java中想实现一个乐观锁,都有哪些方式?
- CAS(Compare and Swap)操作: CAS 是乐观锁的基础。Java 提供了 java.util.concurrent.atomic 包,包含各种原子变量类(如 AtomicInteger、AtomicLong),这些类使用 CAS 操作实现了线程安全的原子操作,可以用来实现乐观锁。
- 版本号控制:增加一个版本号字段记录数据更新时候的版本,每次更新时递增版本号。在更新数据时,同时比较版本号,若当前版本号和更新前获取的版本号一致,则更新成功,否则失败。
- 时间戳:把读取数据时的更新时间作为预期值,更新时原子地检查当前时间戳是否仍与预期值相同,相同才执行更新并修改时间戳。时间戳精度不足或发生重复时,可能漏掉变化,因此需要可靠的更新标识,很多场景直接使用递增版本号更合适。
# CAS 有什么缺点?
CAS 常见的问题主要有三个:
- ABA 问题:线程读到 A,准备更新时发现还是 A,但中间可能已经被改成 B,再改回 A。CAS 只比较当前值,发现不了这段变化。如果业务关心状态是否经历过修改,可以把版本号一起比较,比如使用
AtomicStampedReference。并不是所有场景都会受到 ABA 影响,要看中间的变化是否会破坏业务判断。 - 竞争激烈时重试成本高:CAS 本身只是一次尝试,是很多基于 CAS 的算法在失败后循环重试。大量线程同时更新一个变量时,可能反复失败,消耗 CPU,并产生缓存一致性开销。可以根据场景使用锁,或者像
LongAdder一样分散计数竞争。 - 不能直接保护多个独立变量的整体操作:比如同时扣减余额、增加积分,分别对两个变量做 CAS,不能保证这两个步骤整体原子。如果要一起更新,可以使用同一把锁,或者把多个字段放进不可变对象,通过
AtomicReference原子替换整个对象引用。
这里要注意,AtomicReference 保证的是引用更新的原子性,不是对象内部所有字段修改的原子性。如果还在原地修改它引用的可变对象,仍然需要考虑并发安全。
# 为什么不能所有的锁都用CAS?
因为 CAS 只能完成一次原子比较和更新,它不会自动提供阻塞等待、超时、中断响应,也不会自动保证多个操作组成的业务逻辑是原子的。
比如一个临界区要调用远程接口,可能执行几百毫秒。如果其他线程一直循环 CAS 等它完成,就会白白占用 CPU。这时候把等待线程阻塞起来,通常更合适。
再比如,要同时修改多个共享字段,还要保证它们之间的约束,只对某一个字段做 CAS 并不能完成这个保护。
所以 CAS 和锁往往是配合使用的。像 ReentrantLock,获取锁时会用 CAS,竞争失败后再由 AQS 排队等待;不是必须在“只用 CAS”和“只用阻塞”之间二选一。
实际选择时,短小的单变量更新可以用原子类,复杂的互斥逻辑可以用锁。竞争程度和临界区耗时,也会影响最终性能。
# CAS 有什么问题,Java是怎么解决的?
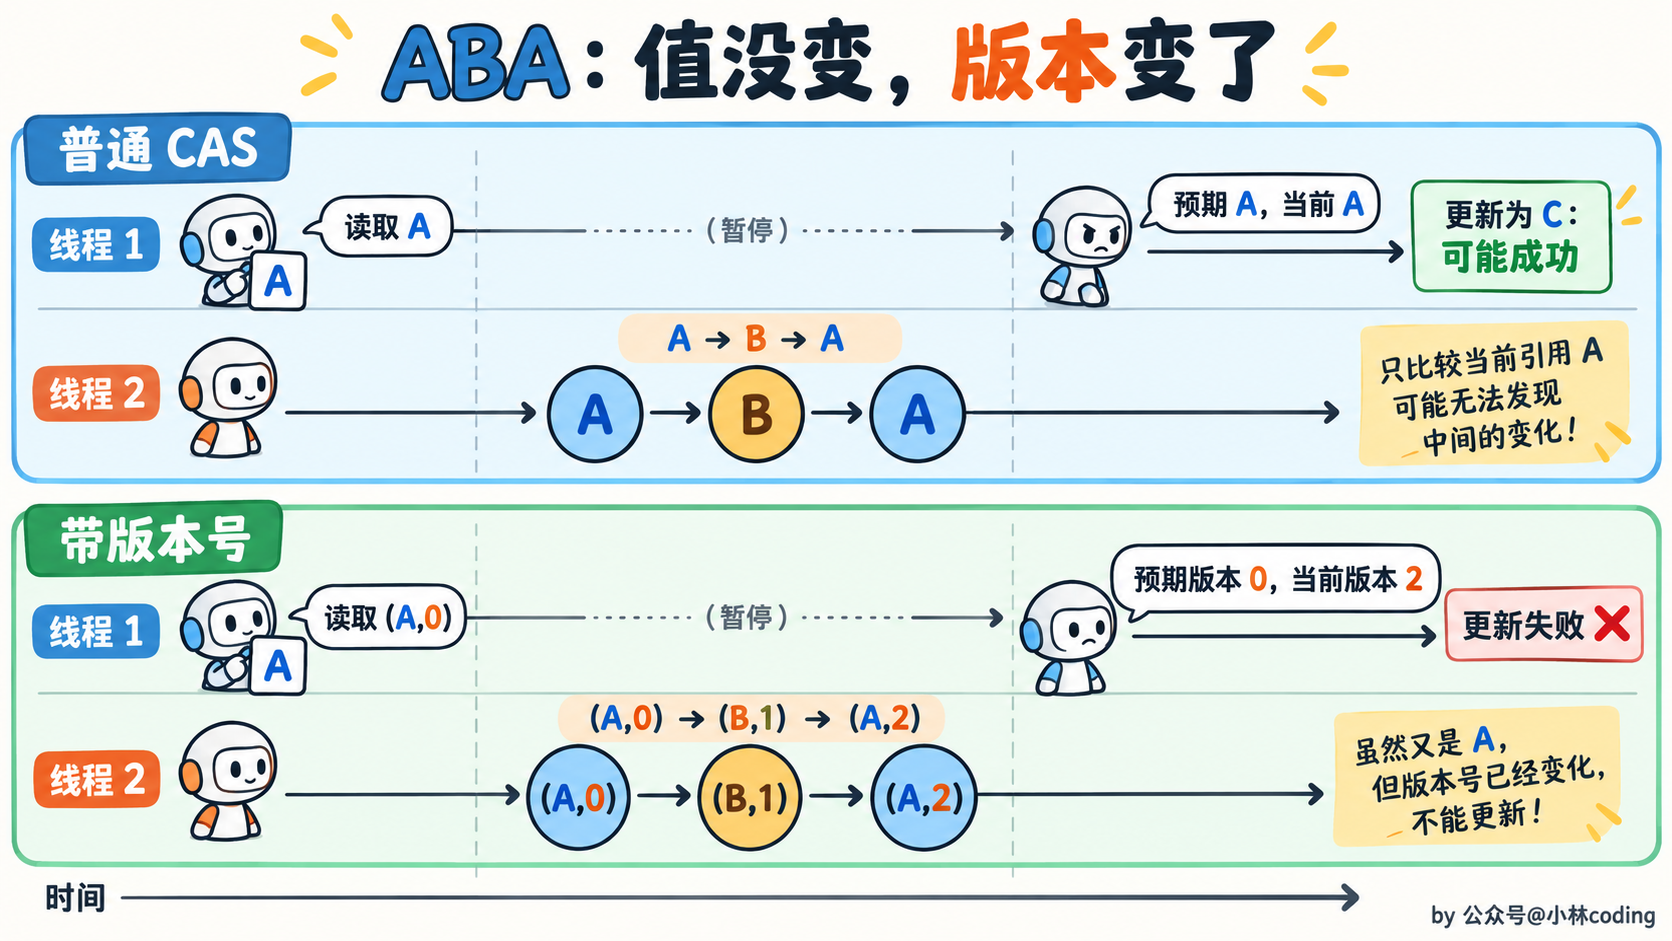
面试里最常追问的是 ABA 问题:线程读取到的值是 A,准备更新时发现仍然是 A,但中间已经发生过 A → B → A 的变化。
比如无锁链表的节点引用回到了原来的节点,但节点之间的关系已经改变,仅比较引用就可能做出错误判断。
Java 可以使用 AtomicStampedReference,把对象引用和版本号作为一组状态一起比较、一起更新。只要每次相关修改都同步更新版本号,即使引用回到了 A,也能发现版本已经变化。
import java.util.concurrent.atomic.AtomicStampedReference;

class AbaExample {
    public static void main(String[] args) {
        Object a = new Object();
        Object b = new Object();
        Object c = new Object();
        AtomicStampedReference<Object> ref =
                new AtomicStampedReference<>(a, 0);

        int[] stamp = new int[1];
        Object expected = ref.get(stamp);
        int expectedStamp = stamp[0];

        // 模拟其他线程把 A 改成 B,再改回 A
        ref.compareAndSet(a, b, 0, 1);
        ref.compareAndSet(b, a, 1, 2);

        // 引用相同,但版本号不匹配,更新失败
        boolean success = ref.compareAndSet(
                expected, c, expectedStamp, expectedStamp + 1);
        System.out.println(success); // false
    }
}
这里有两个细节:首先,最好通过 get(int[]) 一起取得引用和版本号,避免分两次读取到不对应的状态;其次,它比较的是对象引用是否相同,而不是调用 equals() 比较内容。
AtomicMarkableReference 则配合一个布尔标记,适合表示“是否删除”等状态,但布尔标记不能像版本号一样记录多次变化,不能直接等同于通用的 ABA 解决方案。
# AtomicLong 和 LongAdder 有什么区别?
两者都能用于并发计数,但AtomicLong 维护一个原子值,LongAdder 则通过分散更新来减少高竞争下的冲突。
AtomicLong 的自增等操作集中更新同一个值,多个线程同时修改时,需要竞争同一个更新位置。它提供 incrementAndGet()、compareAndSet() 等方法,可以获得一次原子操作对应的结果。
LongAdder 则在竞争发生时,把更新分散到多个 Cell 上,最后读取时再把基础值和各个 Cell 加起来。这样可以减少大家反复争抢同一个位置的情况,适合访问次数、调用次数等统计场景。
LongAdder requestCount = new LongAdder();
requestCount.increment();
long count = requestCount.sum();
不过,sum() 不是并发更新期间的原子快照。它汇总不同位置时,其他线程还可能继续增加计数,所以不能拿这个结果来完成严格的“检查额度后再扣减”。
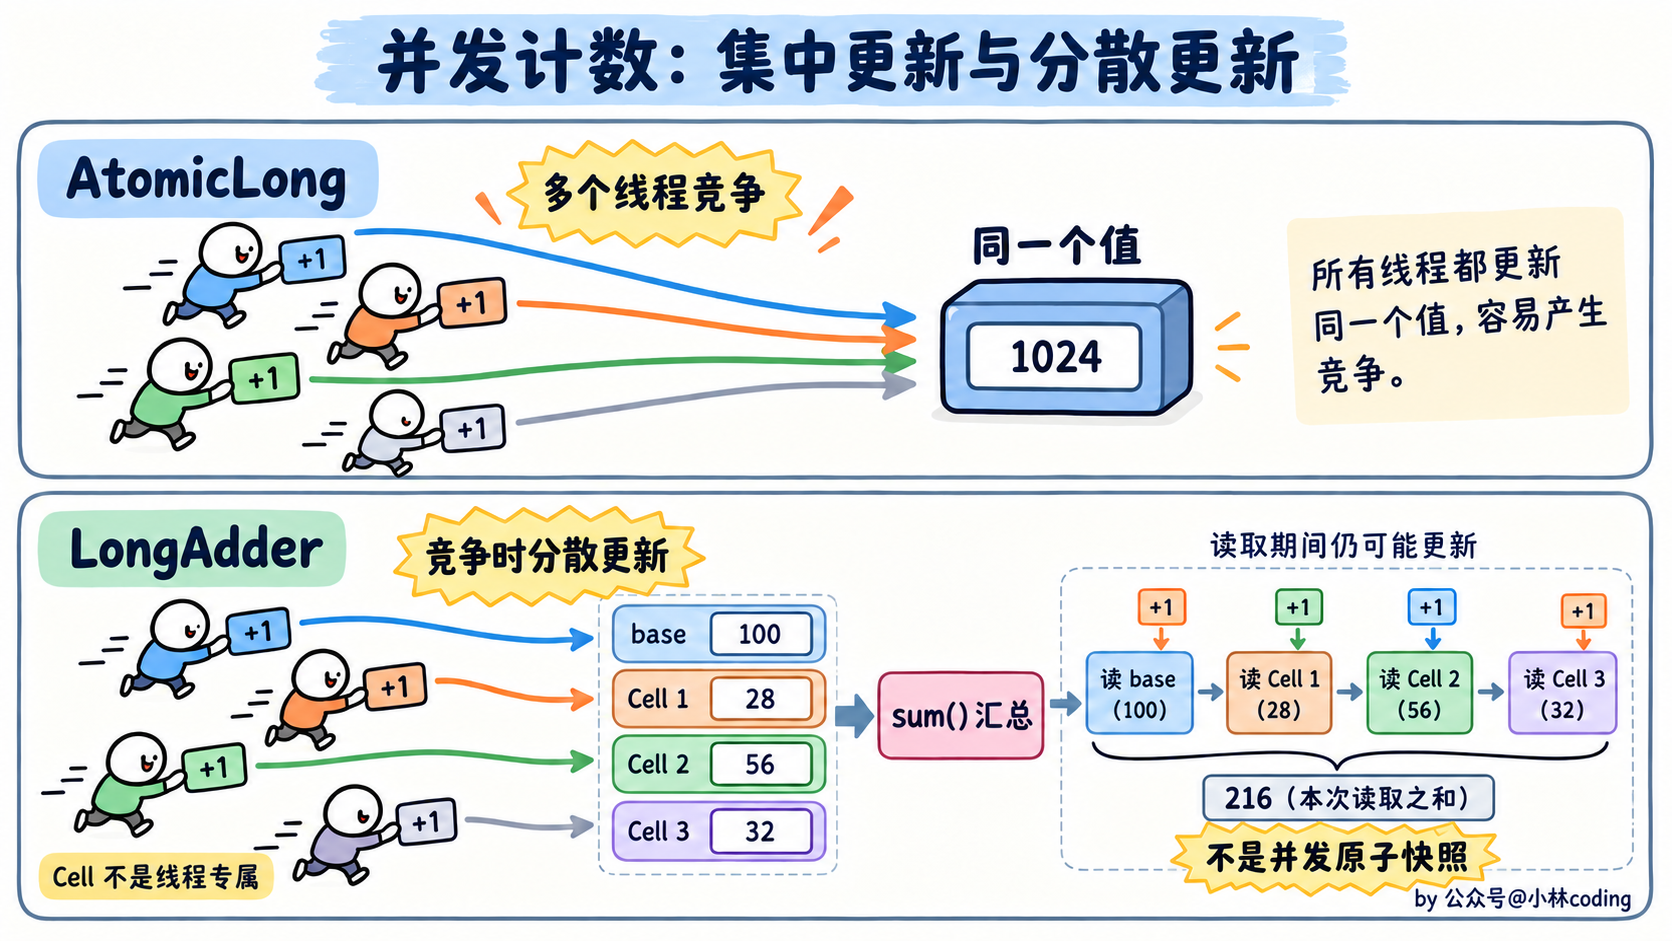
选择上,统计高并发事件次数,可以考虑 LongAdder;如果要生成递增序号、执行 CAS 状态转换,或者要求一次操作返回精确的原子更新结果,就使用 AtomicLong。
LongAdder 也会占用更多空间,低竞争时不一定有明显收益。
# voliatle关键字有什么作用?
volatile 主要有两个作用:保证可见性,以及提供特定的顺序保证,但它不提供互斥,不能把复合操作变成原子操作。
保证可见性
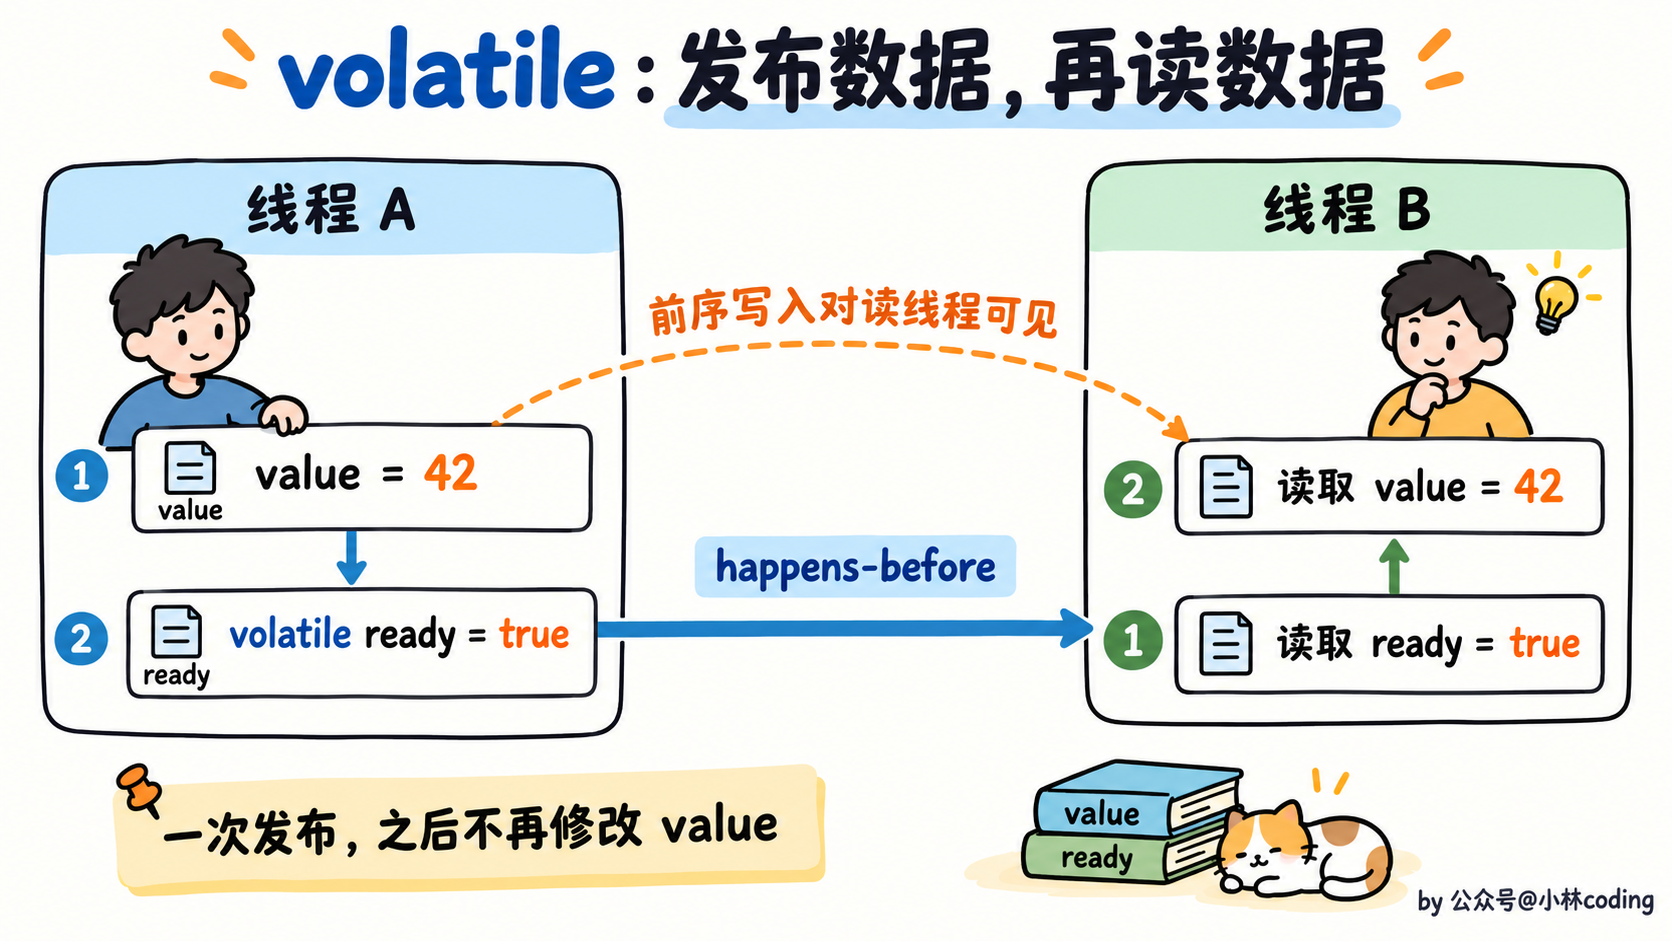
一个线程对 volatile 变量的写,happens-before 后续对这个变量的读。读线程不只是能看到这个标志本身的变化,还能看到写线程在这次 volatile 写之前完成的相关修改。
比如下面的代码,假设 publish() 由一个线程执行,read() 由另一个线程执行,发布后不再修改 value:
private int value = 0;
private volatile boolean ready = false;

public void publish() {
    value = 42;
    ready = true;
}

public void read() {
    if (ready) {
        System.out.println(value); // 读到 ready 为 true 时,value 是 42
    }
}
虽然 value 没有加 volatile,但它的写入发生在 ready = true 之前。读线程观察到这次 ready 的写入后,也能看到前面的 value 修改。
限制重排序
编译器和处理器不能进行破坏 volatile 内存语义的重排序。比如上面的数据写入,不能以让读线程看到 ready 已经是 true、value 却仍然是 0 的方式被观察到。
底层通常通过编译器约束、内存屏障和处理器的缓存一致性机制来实现。面试里提到 StoreStore、StoreLoad、LoadLoad、LoadStore 时,可以把它们理解为限制不同读写操作排序的屏障类型,但具体指令和屏障组合取决于处理器架构、JVM 实现及优化。
不能简单理解成 volatile 读写完全绕过 CPU 缓存,也不能说它禁止所有指令重排序。
它适合停止标志、状态发布,以及双重检查单例中的安全发布。对于 count++ 这种“读取、计算、写回”的操作,仍然需要原子类或锁。
# 指令重排序的原理是什么?
在执行程序时,为了提高性能,处理器和编译器常常会对指令进行重排序,但是重排序要满足下面 2 个条件才能进行:
- 在单线程环境下不能改变程序运行的结果
- 存在数据依赖关系的不允许重排序。
所以重排序不会对单线程有影响,只会破坏多线程的执行语义。
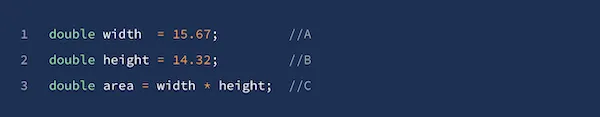
我们看这个例子,A和C之间存在数据依赖关系,同时B和C之间也存在数据依赖关系。因此在最终执行的指令序列中,C不能被重排序到A和B的前面,如果C排到A和B的前面,那么程序的结果将会被改变。但A和B之间没有数据依赖关系,编译器和处理器可以重排序A和B之间的执行顺序。
# volatile可以保证线程安全吗?
要看具体的操作。volatile 能保证可见性和特定的顺序关系,但不提供互斥,所以不能保证任意使用方式都线程安全。
比如一个线程设置 volatile boolean stopped,其他线程只读取这个标志来判断是否退出,这种场景可以使用 volatile。
但如果多个线程同时对 volatile int count 执行 count++,就不安全。因为它仍然要经历读取、加 1、写回,两个线程可能读到同一个值,最后丢失一次更新。
private volatile int count = 0;

public void increment() {
    count++; // volatile 不能保证这整个操作的原子性
}
这个场景可以改用 AtomicInteger.incrementAndGet(),或者把整个操作放在同一把锁的保护下。
还有一种容易忽略的情况:volatile 修饰对象引用,不代表对象内部所有字段都自动变成线程安全的。比如 volatile List<String> 可以用于发布一个新的列表引用,但多个线程同时对同一个 ArrayList 调用 add(),仍然不安全。
所以要判断的不是“有没有加 volatile”,而是业务是否需要原子更新、是否存在多个字段之间的约束,以及发布后的对象是否还会被并发修改。
# volatile和sychronized比较?
两者都能用于线程之间的可见性和顺序控制,但synchronized 还提供互斥,volatile 不提供。
| 对比项 | volatile | synchronized |
|---|---|---|
| 使用范围 | 修饰字段 | 修饰方法或代码块 |
| 可见性 | volatile 写与后续读建立 happens-before | 同一把锁的解锁与后续加锁建立 happens-before |
| 复合操作 | 不能保证 i++ 等操作整体原子 | 可以保护整个临界区,相关访问要使用同一把锁 |
| 是否阻塞 | 不会像互斥锁一样排队等待锁 | 存在竞争时,可能自旋或阻塞 |
| 常见用途 | 标志位、状态发布 | 多个步骤或多个字段的互斥更新 |
比如只是通知线程“任务该停止了”,可以使用 volatile 标志;如果要判断余额够不够,再扣减余额,就需要把判断和修改作为一个整体保护,不能只给余额加 volatile。
开销上,volatile 通常比获取互斥锁更轻,但它提供的能力也更少。选择时先看正确性要求,不能为了减少开销,把需要互斥的操作直接换成 volatile。
# 什么是公平锁和非公平锁?
公平锁和非公平锁,主要区别在于新来的线程是否需要尊重已经排队等待的线程。
- 公平锁:获取锁时,通常会检查前面是否还有等待者,优先让等待时间更长的线程获取,减少插队和长期等待。比如
new ReentrantLock(true)。 - 非公平锁:允许新来的线程先尝试获取锁,获取失败后再排队。这样可能出现后来的线程先拿到锁,但通常能减少交接期间的空闲,提高吞吐量。
ReentrantLock默认就是非公平锁。
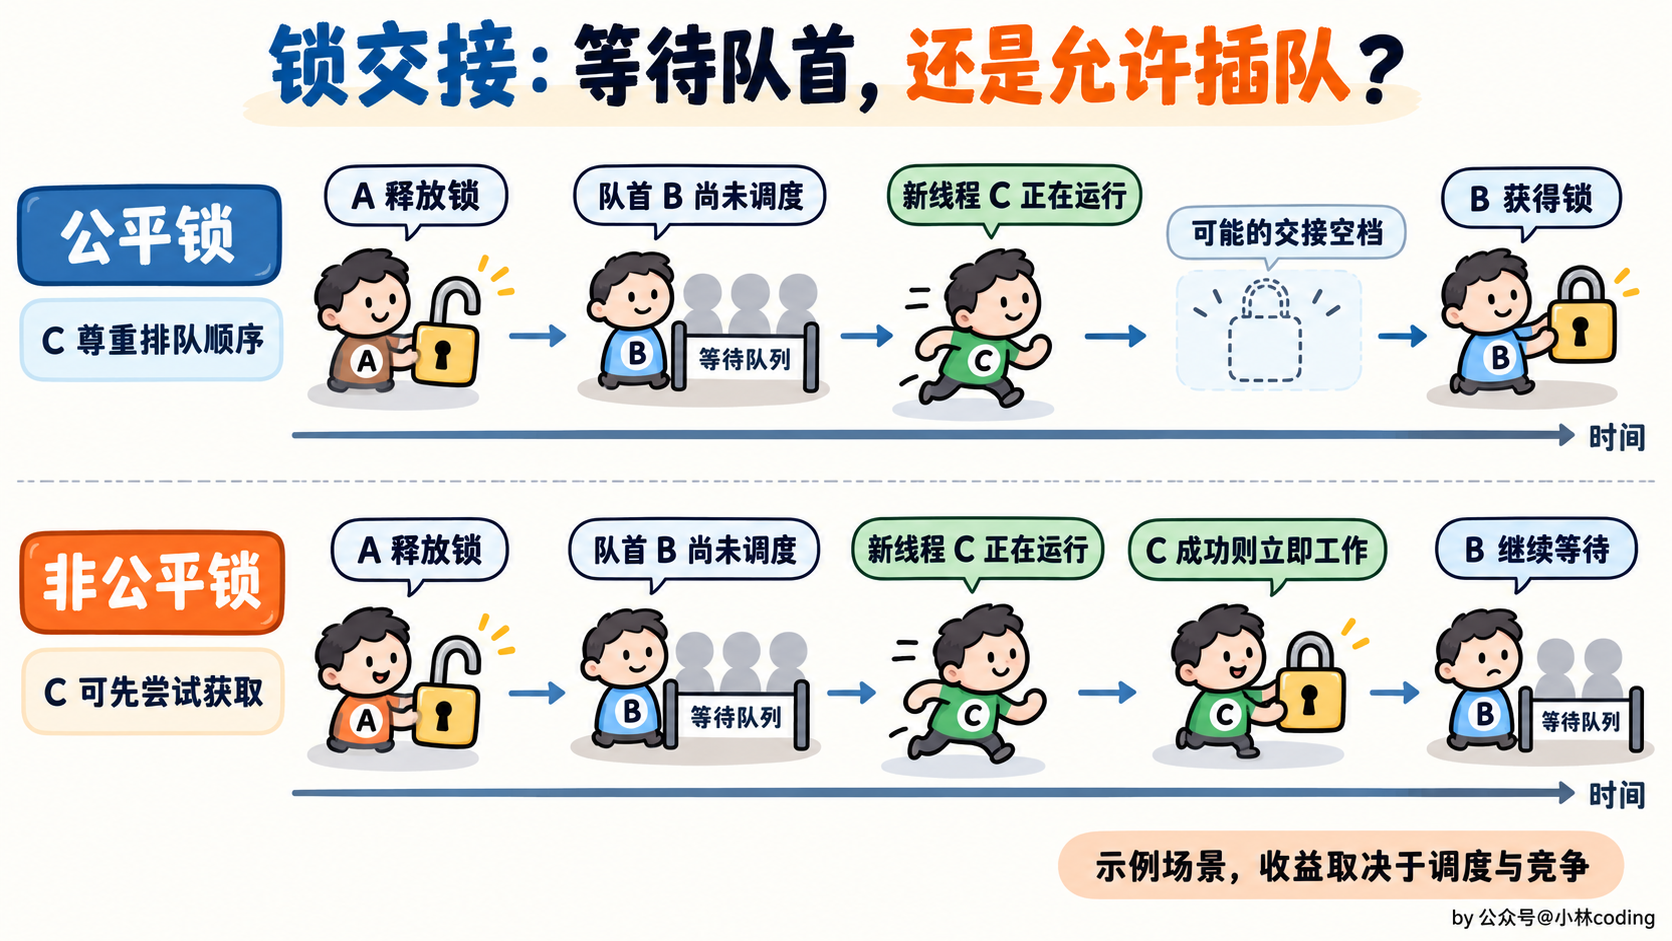
举个例子,线程 A 刚释放锁,队列里的线程 B 正准备被唤醒,这时新来的线程 C 也想获取锁。公平锁通常会让 C 尊重 B 的排队位置;非公平锁则允许 C 先尝试获取。
不过,公平不代表所有线程严格按调用方法的时间执行,也不代表操作系统的线程调度公平。持有锁的线程可以重入,无参 tryLock() 也可以绕过公平性设置。
实际选择上,优先考虑吞吐量时通常使用非公平锁;如果更关心等待时间的稳定性,可以考虑公平锁,并结合业务压测评估代价。
# 非公平锁吞吐量为什么比公平锁大?
非公平锁通常吞吐量更高,主要是因为允许正在运行的线程直接尝试获取锁,减少等待线程交接期间的空档。
比如线程 A 刚释放锁,公平锁需要让排队靠前的线程 B 获得机会。但 B 可能还没有被操作系统调度起来,这段时间锁虽然空闲,其他线程也不能随意插队。
非公平锁则允许这时正在运行的线程 C 直接尝试获取。如果 C 成功,就能立刻开始工作,减少一次等待和调度带来的延迟;某些场景下,还能更好地利用当前线程相关的缓存。
不过,这不是说公平锁每次都要阻塞,也不是非公平锁没有阻塞。两者获取失败时都可能排队等待,主要区别在于是否允许插队。
而且“非公平一定更快”也不成立,最终要看临界区长度、竞争程度和线程调度。它的代价是等待时间可能更不稳定,个别线程可能长时间拿不到锁。
# Synchronized是公平锁吗?
synchronized 不保证公平性。已经等待很久的线程,不一定比新来的线程先获得锁,程序不能依赖它按照申请顺序执行。
ReentrantLock 也不是默认公平,它有两种模式:
ReentrantLock nonfairLock = new ReentrantLock(); // 默认非公平
ReentrantLock fairLock = new ReentrantLock(true); // 公平
如果面试里被追问到公平性,还可以补充:即使配置了公平 ReentrantLock,无参 tryLock() 仍然可以直接尝试获取锁,不遵守排队顺序。
# ReentrantLock是怎么实现公平锁的?
核心是在首次获取锁时,检查当前线程前面是否存在排队的等待者。下面以 JDK 8 的相关获取逻辑为例,较新版本的具体源码组织可能不同:
protected final boolean tryAcquire(int acquires) {

    final Thread current = Thread.currentThread();
    int c = getState();

    if (c == 0) {

        if (!hasQueuedPredecessors() && //这里判断了 hasQueuedPredecessors()
                compareAndSetState(0, acquires)) {

            setExclusiveOwnerThread(current);

            return true;
        }

    } else if (current == getExclusiveOwnerThread()) {

        int nextc = c + acquires;

        if (nextc < 0) {
            throw new Error("Maximum lock count exceeded");
        }
        setState(nextc);
        return true;

    }
    return false;
}
非公平锁的锁获取源码如下:
final boolean nonfairTryAcquire(int acquires) {

    final Thread current = Thread.currentThread();
    int c = getState();

    if (c == 0) {

        if (compareAndSetState(0, acquires)) { //这里没有判断      hasQueuedPredecessors()

            setExclusiveOwnerThread(current);

            return true;

        }

    }

    else if (current == getExclusiveOwnerThread()) {

        int nextc = c + acquires;

        if (nextc < 0) // overflow

        throw new Error("Maximum lock count exceeded");

        setState(nextc);

        return true;

    }

    return false;

}
从这两段获取逻辑可以看出,公平锁在锁空闲时多了 hasQueuedPredecessors() 检查:当前线程前面没有排队的等待者,才尝试 CAS 获取。这里不是判断整个队列是否为空,当前线程自己可能已经位于队列的最前面。
这也就是公平锁和非公平锁的核心区别:公平锁尊重当前线程之前的等待者;对于非公平锁而言,无论是否已经有线程在排队,都会尝试获取一下锁,获取不到的话,再去排队。这里有一个特例需要我们注意,针对 tryLock() 方法,它不遵守设定的公平原则。
例如,当有线程执行 tryLock() 方法的时候,一旦有线程释放了锁,那么这个正在 tryLock 的线程就能获取到锁,即使设置的是公平锁模式,即使在它之前已经有其他正在等待队列中等待的线程,简单地说就是 tryLock 可以插队。
看它的源码就会发现:
public boolean tryLock() {

    return sync.nonfairTryAcquire(1);

}
这里调用的就是 nonfairTryAcquire(),表明了是不公平的,和锁本身是否是公平锁无关。带超时的 tryLock(timeout, unit) 则遵守公平性设置。公平锁减少插队,但不保证所有线程严格按照调用方法的时间执行。
非公平锁加锁时不考虑排队等待情况,直接尝试获取锁,所以存在后申请却先获得锁的情况,但由此也提高了整体的效率。
# 什么情况会产生死锁问题?如何解决?
死锁只有同时满足以下四个条件才会发生:
- 互斥条件:互斥条件是指多个线程不能同时使用同一个资源。
- 持有并等待条件:持有并等待条件是指,当线程 A 已经持有了资源 1,又想申请资源 2,而资源 2 已经被线程 C 持有了,所以线程 A 就会处于等待状态,但是线程 A 在等待资源 2 的同时并不会释放自己已经持有的资源 1。
- 不可剥夺条件:不可剥夺条件是指,当线程已经持有了资源 ,在自己使用完之前不能被其他线程获取,线程 B 如果也想使用此资源,则只能在线程 A 使用完并释放后才能获取。
- 环路等待条件:环路等待条件指的是,在死锁发生的时候,多个线程之间的资源等待关系构成了环形链。
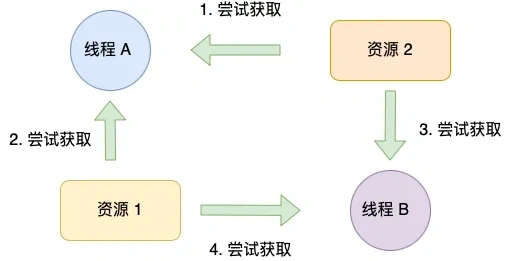
例如,线程 A 持有资源 R1 并试图获取资源 R2,而线程 B 持有资源 R2 并试图获取资源 R1,此时两个线程相互等待对方释放资源,从而导致死锁。
public class DeadlockExample {
    private static final Object resource1 = new Object();
    private static final Object resource2 = new Object();

    public static void main(String[] args) {
        Thread threadA = new Thread(() -> {
            synchronized (resource1) {
                System.out.println("Thread A acquired resource1");
                try {
                    Thread.sleep(100);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (resource2) {
                    System.out.println("Thread A acquired resource2");
                }
            }
        });

        Thread threadB = new Thread(() -> {
            synchronized (resource2) {
                System.out.println("Thread B acquired resource2");
                try {
                    Thread.sleep(100);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (resource1) {
                    System.out.println("Thread B acquired resource1");
                }
            }
        });

        threadA.start();
        threadB.start();
    }
}
避免死锁问题就只需要破环其中一个条件就可以,最常见的并且可行的就是使用资源有序分配法,来破环环路等待条件。
那什么是资源有序分配法呢?线程 A 和 线程 B 获取资源的顺序要一样,当线程 A 是先尝试获取资源 A,然后尝试获取资源 B 的时候,线程 B 同样也是先尝试获取资源 A,然后尝试获取资源 B。也就是说,线程 A 和 线程 B 总是以相同的顺序申请自己想要的资源。
如果线上已经出现线程一直等待,可以先用 jcmd
除了统一加锁顺序,也可以用带超时的 tryLock(),在获取失败时释放已经持有的锁并结束或有限重试。不要在持锁期间做长时间的远程调用,也不要认为给线程发送 interrupt 就一定能解除 synchronized 的锁等待。
# 线程池
# 线程池怎么使用?
线程池的核心作用是复用线程、控制并发数,避免频繁创建销毁线程带来的性能开销。
首先最常用的是通过 Executors 工具类快速创建线程池,适合简单场景,不用手动配置复杂参数。比如需要一个固定线程数的线程池,处理一批异步任务:
// 创建固定3个线程的线程池
ExecutorService fixedThreadPool = Executors.newFixedThreadPool(3);

// 提交Runnable任务 无返回值
for (int i = 0; i < 5; i++) {
    int taskNum = i;
    fixedThreadPool.submit(() -> {
        System.out.println("当前线程 " + Thread.currentThread().getName() + " 处理任务 " + taskNum);
        try {
            Thread.sleep(1000); // 模拟任务执行耗时
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    });
}

// 提交Callable任务 有返回值
Future<Integer> future = fixedThreadPool.submit(() -> {
    Thread.sleep(500);
    return 100 + 200; // 任务返回结果
});

// 获取Callable任务的返回值 会阻塞直到任务完成
try {
    Integer result = future.get();
    System.out.println("任务返回结果: " + result);
} catch (Exception e) {
    e.printStackTrace();
}

// 任务执行完后关闭线程池 避免资源泄露
fixedThreadPool.shutdown();
不过 Executors 创建的线程池有潜在问题,比如 newCachedThreadPool 可能创建大量线程导致 OOM,newScheduledThreadPool 的 maximumPoolSize 为 Integer.MAX_VALUE 且内部使用无界的 DelayedWorkQueue,任务堆积时可能导致 OOM,所以复杂业务场景更推荐用 ThreadPoolExecutor 手动配置,能精准控制线程池行为。
手动创建 ThreadPoolExecutor 需要指定 7 个核心参数,理解这些参数才能用好。比如创建一个适合处理 IO 密集型任务的线程池(这里以 CPU 核心数的 2 倍作为示例起点,实际要结合等待时间、下游容量和压测调整):
// 获取CPU核心数 用于合理设置线程数
int corePoolSize = Runtime.getRuntime().availableProcessors() * 2;

// 手动配置线程池
ThreadPoolExecutor threadPool = new ThreadPoolExecutor(
    corePoolSize, // 核心线程数 默认按需创建,空闲时通常保留
    corePoolSize * 2, // 最大线程数 线程池能容纳的最多线程数
    60L, // 空闲线程存活时间 超过核心线程数的空闲线程 多久后销毁
    TimeUnit.SECONDS, // 存活时间单位
    new ArrayBlockingQueue<>(100), // 任务阻塞队列 核心线程忙时 新任务存这里
    Executors.defaultThreadFactory(), // 线程创建工厂 用于设置线程名 优先级等
    new ThreadPoolExecutor.AbortPolicy() // 拒绝策略 队列满且线程数达最大时 如何处理新任务
);

// 提交任务的两种方式和之前一致 这里用 execute 提交 Runnable(无 Future 返回值,执行异常需要在任务中或异常处理器中记录)
threadPool.execute(() -> {
    System.out.println("IO任务执行中 " + Thread.currentThread().getName());
    // 模拟IO操作 比如数据库查询 网络请求
});

// 发起有序关闭 shutdown 本身不等待任务完成
threadPool.shutdown();
// 若需尝试尽快停止,可调用 shutdownNow 请求中断,并返回队列中的未执行任务
// List<Runnable> unExecutedTasks = threadPool.shutdownNow();
这里要注意几个关键细节:比如拒绝策略有四种,除了默认的 AbortPolicy(直接抛异常),还有 CallerRunsPolicy(让提交任务的线程自己执行,减慢提交速度)、DiscardPolicy(直接丢弃新任务)、DiscardOldestPolicy(丢弃队列里最旧的任务,再提交新任务),要根据业务选择,比如核心业务不能丢任务,就别用 Discard 相关策略。
另外,提交任务时,submit 和 execute 的区别在于 submit 能提交 Callable 有返回值,还能通过 Future 捕获任务执行中的异常,而 execute 只能提交 Runnable,未捕获的执行异常通常在工作线程中传播,并非直接抛给提交任务的线程,比如:
// 以下是独立示例,使用一个尚未关闭的线程池
ExecutorService examplePool = Executors.newSingleThreadExecutor();
Future<?> future = examplePool.submit(() -> {
    int i = 1 / 0; // 模拟异常
});
try {
    future.get();
} catch (ExecutionException e) {
    System.out.println("任务执行异常: " + e.getCause()); // 捕获到算术异常
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
} finally {
    examplePool.shutdown();
}
还有线程池的使用原则:不能创建后不关闭,否则会导致线程泄露,JVM 无法退出;任务队列的容量要合理设置,太大可能导致内存溢出,太小容易触发拒绝策略;线程数要根据任务类型调整,CPU 密集型任务(比如复杂计算)线程数不宜过多,一般和 CPU 核心数相当,避免线程切换开销,IO 密集型任务可以多设些线程,因为线程大部分时间在等待 IO 完成。
# 介绍一下线程池的工作原理
线程池的核心作用是复用线程、控制并发数量。任务来了以后,交给工作线程执行;执行完之后,线程继续处理下一个任务,减少反复创建和销毁线程的开销。
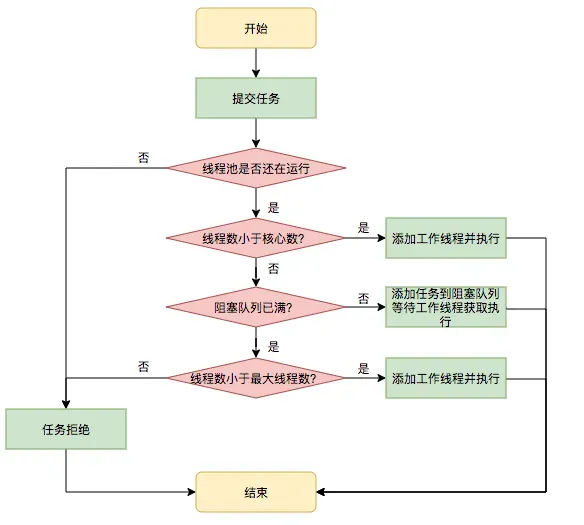
以 ThreadPoolExecutor 为例,理解它的工作原理,主要看三个参数:核心线程数、最大线程数、任务队列。
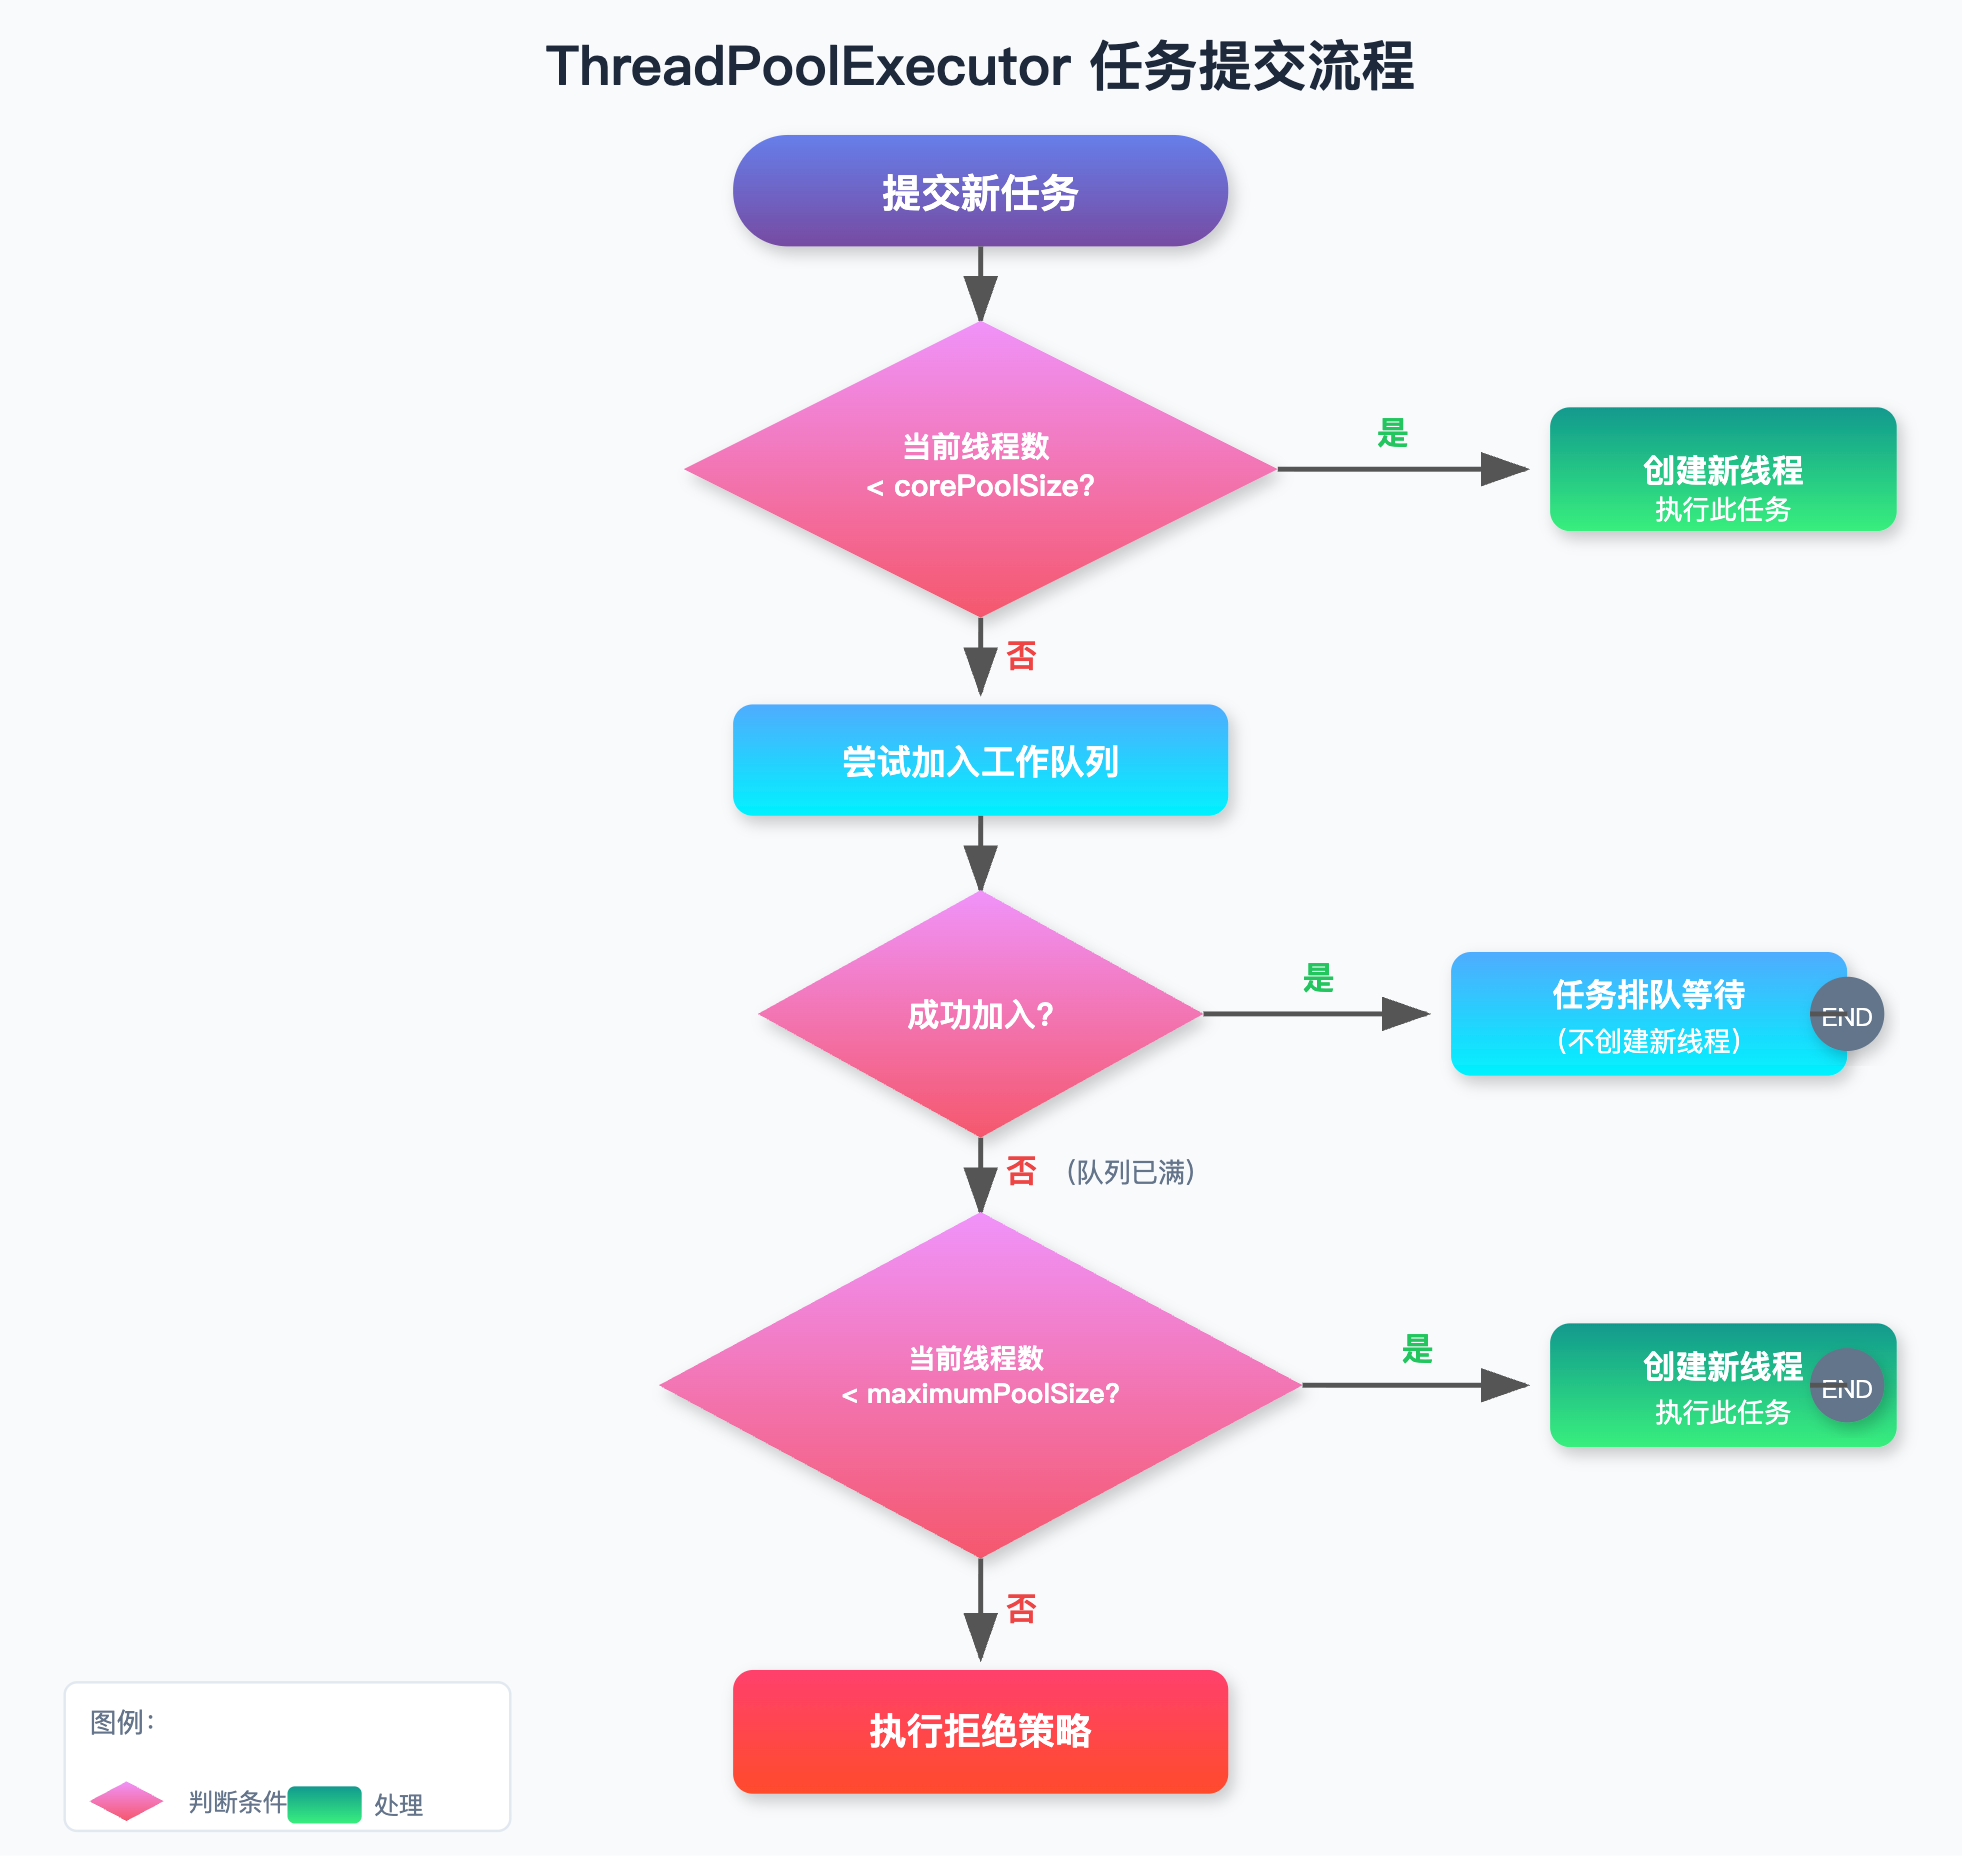
提交一个任务时,处理流程如下:
- 当前线程数小于核心线程数,创建一个工作线程来执行新任务。
- 当前线程数达到核心线程数,尝试把新任务放进任务队列,等待工作线程领取。
- 任务无法入队,尝试继续创建工作线程,但线程总数不能超过最大线程数。
- 任务无法入队,也无法继续创建线程,执行拒绝策略。
这里最容易答错的地方是:达到核心线程数之后,会先尝试入队,而不是直接把线程数增加到最大线程数。
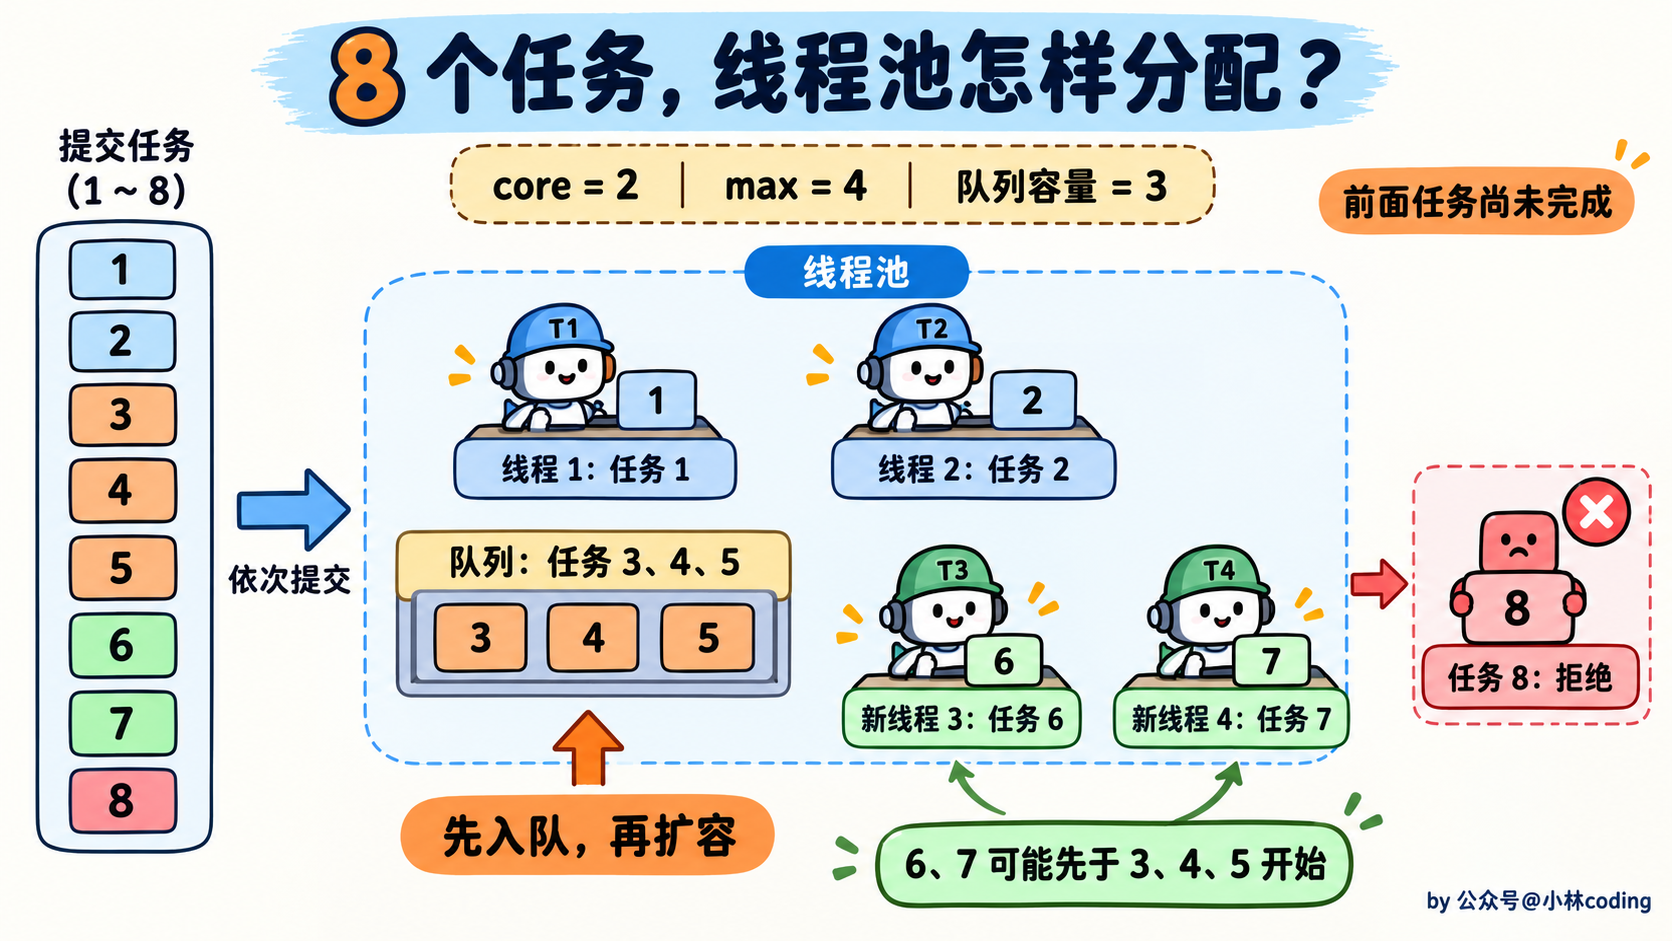
举个例子,假设核心线程数是 2,最大线程数是 4,队列容量是 3。现在连续提交 8 个任务,并且提交过程中,前面的任务都还没有执行完:
- 第 1、2 个任务:分别创建线程执行。
- 第 3、4、5 个任务:进入任务队列。
- 第 6、7 个任务:队列已经满了,分别创建新的工作线程执行,线程总数达到 4。
- 第 8 个任务:队列满了,线程数也达到上限,执行拒绝策略。
这也说明,线程池不一定按照提交顺序执行任务。上面第 6、7 个任务可能比队列里的第 3、4、5 个任务更早开始执行,因为新创建的线程会直接执行触发它创建的任务。
工作线程执行完任务后,会做什么?
工作线程执行完一个任务后,会继续从任务队列中获取任务。
如果队列为空,线程就等待新任务。默认情况下,超过核心线程数的空闲线程,等待时间超过 keepAliveTime 后会被回收;核心线程通常会保留。
如果开启了 allowCoreThreadTimeOut(true),核心线程也可以因为空闲超时被回收。
另外,核心线程默认也是按需创建的,不是创建线程池时就把所有核心线程都启动起来。如果需要提前创建,可以调用 prestartAllCoreThreads()。
任务队列会怎样影响线程池的行为?
这个问题经常和线程池原理一起追问:
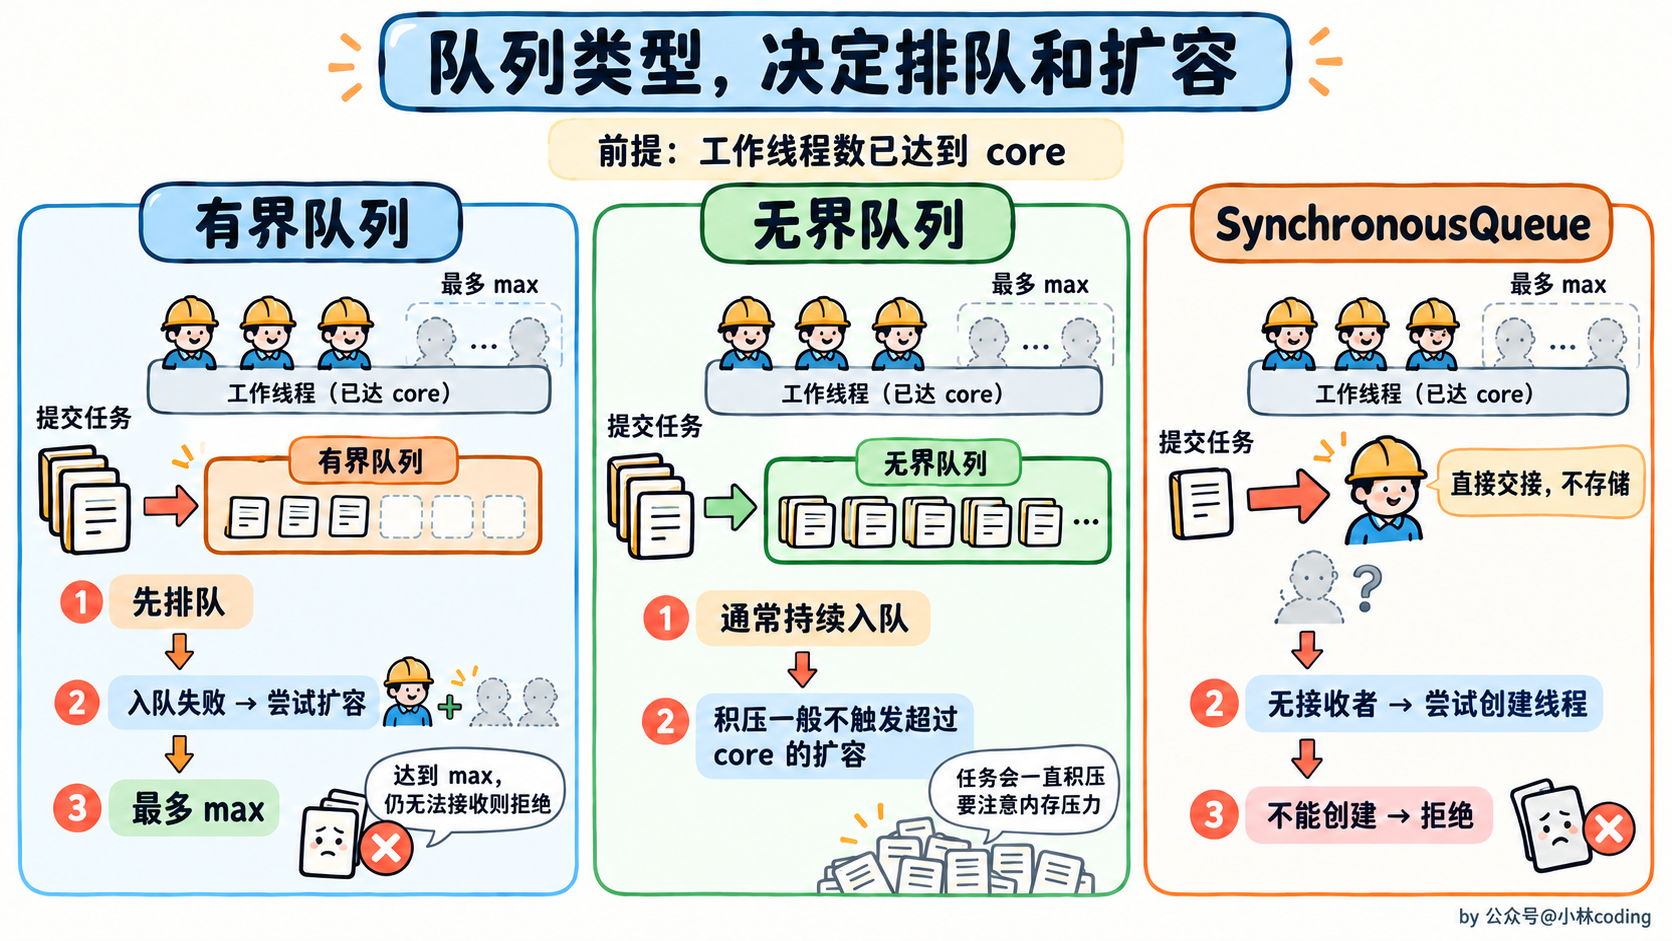
- 有界队列:能限制积压任务的数量。队列满了以后,才会尝试增加线程,达到最大线程数后再拒绝任务。
- 无界队列:任务通常能一直入队,因此线程数一般不会因为任务积压而增长到核心线程数以上。即使最大线程数设得很大,也通常发挥不了作用,反而要注意任务堆积带来的内存压力。
- SynchronousQueue:不存储任务,需要直接把任务交给接收它的工作线程。如果无法交接,就尝试创建新线程;无法创建时执行拒绝策略。
还有一点,触发拒绝策略不只是因为线程数和队列都满了。线程池关闭后再提交新任务,也会触发拒绝策略。
# 线程池的参数有哪些?
ThreadPoolExecutor 常用的完整构造方法有 7 个参数:
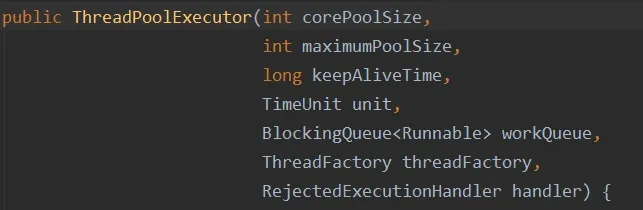
- corePoolSize:核心线程数。默认按需创建,当前工作线程数小于它时,提交任务通常会创建新线程,即使已有线程处于空闲状态。默认情况下,空闲回收不会让线程数降到它以下;开启核心线程超时后则可以继续回收。
- maximumPoolSize:最大工作线程总数,包括核心线程和非核心线程。达到核心线程数后,会先尝试入队,入队失败才尝试创建更多线程。
- keepAliveTime:空闲线程等待新任务的最长时间。默认用于超过核心线程数的部分,开启
allowCoreThreadTimeOut(true)后也适用于核心线程,此时必须设置大于 0 的存活时间。 - unit:
keepAliveTime的时间单位,比如秒、毫秒。 - workQueue:保存等待执行任务的阻塞队列。它的类型和容量会影响排队、扩容和拒绝行为,不能只根据“有没有空闲线程”来理解任务是否入队。
- threadFactory:线程创建工厂。可以设置有意义的线程名、异常处理器等,方便排查问题。
- handler:拒绝策略。当线程池关闭,或者无法接收新任务时,决定是抛异常、让调用者执行,还是丢弃任务等。
参数之间不是互相独立的。比如使用无界队列时,任务通常会持续入队,maximumPoolSize 设得再大,也通常不会因为任务积压而扩容。
另外,构造时需要满足 corePoolSize >= 0、maximumPoolSize > 0、最大线程数不小于核心线程数,空闲存活时间不能为负。配置时要把线程数、队列容量和拒绝策略放在一起考虑。
# 线程池工作队列满了有哪些拒接策略?
先说明一点:队列满了,不一定马上拒绝任务。如果线程数还没达到 maximumPoolSize,线程池会先尝试创建新的工作线程;无法继续接收任务时才执行拒绝策略。线程池关闭后提交任务,也会触发拒绝策略。
ThreadPoolExecutor 内置了四种策略:
- AbortPolicy:默认策略,直接抛出
RejectedExecutionException。适合需要让调用方明确知道提交失败的场景,调用方可以返回错误、降级或者安排后续重试。 - CallerRunsPolicy:线程池没有关闭时,由提交任务的线程自己执行任务,让提交方慢下来。注意是“提交任务的线程”,不一定是主线程;线程池已经关闭时,则丢弃任务。
- DiscardPolicy:直接丢弃新任务,不抛异常。只适合业务明确允许丢失的任务,否则容易造成结果缺失又不好排查。
- DiscardOldestPolicy:线程池没有关闭时,丢弃队列头部的任务,再尝试提交新任务。它丢掉的是队列头,不一定是提交时间最早的任务,具体取决于队列的排序规则。
还可以实现 RejectedExecutionHandler 自定义策略,比如记录告警、写入可靠的任务存储,再由其他流程处理。重试需要有次数和时间限制,不能在系统过载时无限重试。
这里有两个常见的坑:
第一,CallerRunsPolicy 会占用调用线程的时间。如果提交方是处理请求或事件循环的线程,执行耗时任务可能影响整个入口的响应。
第二,静默丢弃和 Future 一起使用,可能让 get() 一直等待。比如 submit() 包装出来的任务被丢弃了,但对应 Future 没有完成,也没有被取消。需要明确失败结果的任务,通常应该让拒绝变得可见,或者在自定义策略里完成取消和通知。
# 有线程池参数设置的经验吗?
线程池参数不能只套“CPU 核数加 1”或者“CPU 核数乘 2”。我会先看任务类型、处理时间、流量,以及下游能承受多少并发,再通过压测调整。
先估算线程数
- CPU 密集型:比如加密、计算,线程数可以从可用 CPU 核数附近开始。线程太多不会让 CPU 多出算力,反而增加上下文切换。
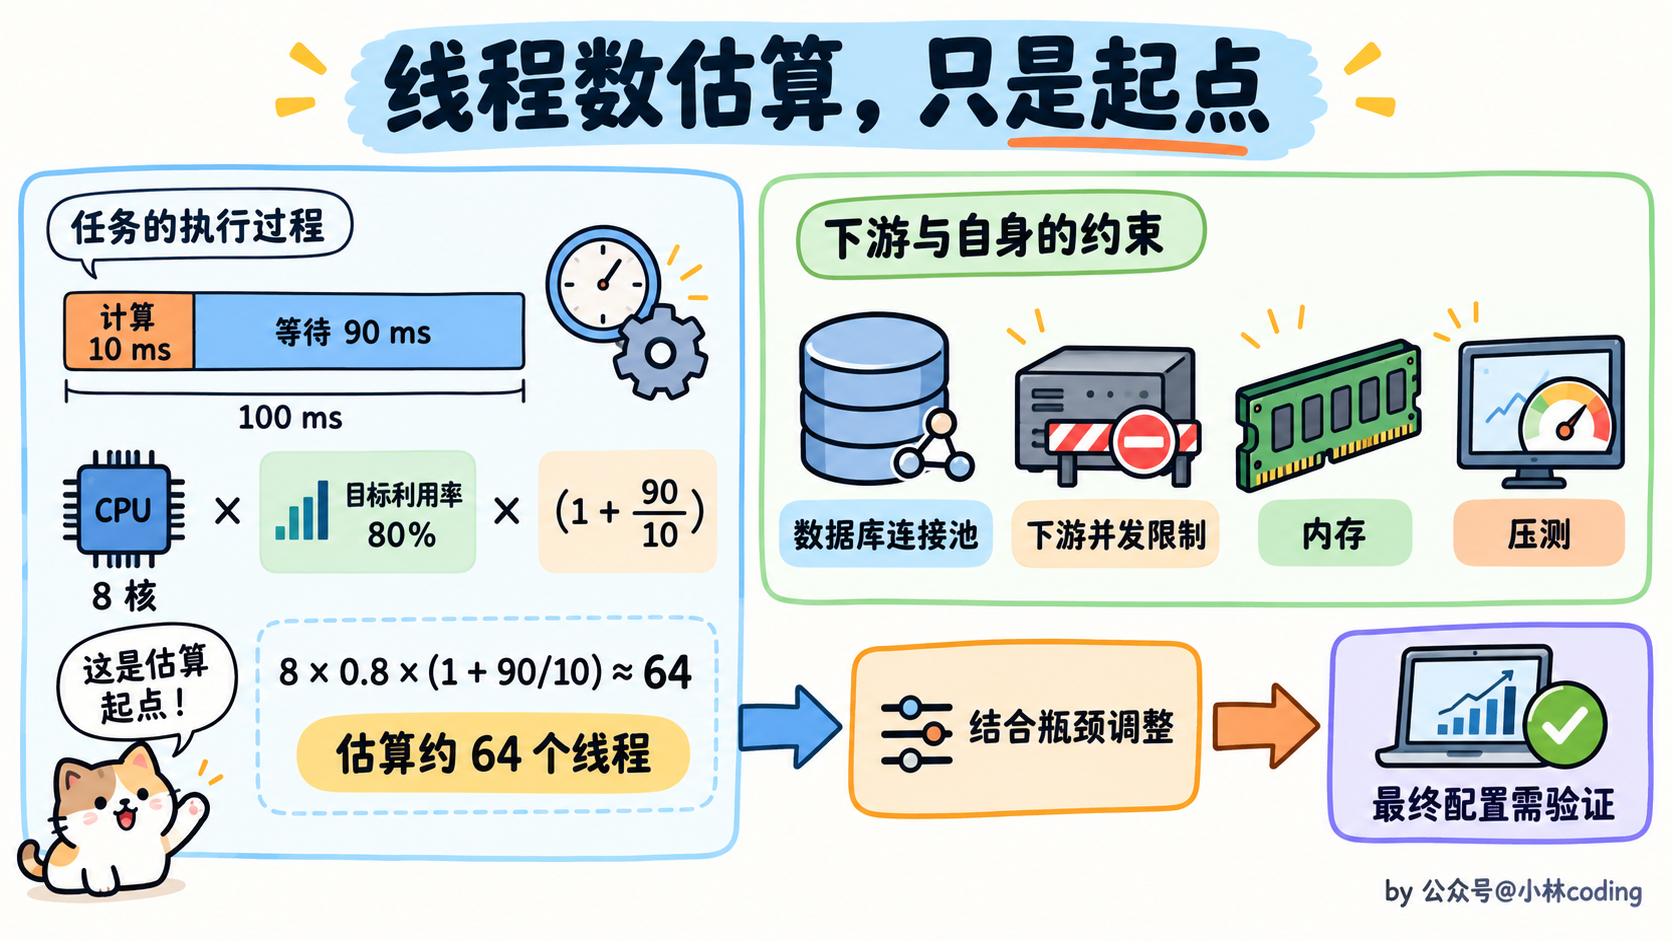
- IO 密集型:比如调用数据库、远程接口,线程经常等待,可以适当增加。一个粗略的估算是:
线程数 ≈ CPU 核数 × 目标 CPU 利用率 × (1 + 等待时间 / 计算时间)。
比如有 8 个可用 CPU 核,目标利用率是 80%,任务平均计算 10 毫秒、等待 90 毫秒,估算得到约 64 个线程。但这只是起点,不能只看这个数字,还要看数据库连接池、下游限流和服务自身的资源上限。
从流量角度,也可以用“每秒任务数 × 平均处理时间”估算平均在途任务数。比如每秒 200 个任务,平均耗时 100 毫秒,平均约有 20 个任务在处理或等待,不是只要有几条线程就一定能扛住。
再设置队列和拒绝策略
队列需要有界,容量要结合允许的排队时间和任务占用内存来估算。队列太大,虽然暂时不拒绝,但用户可能早已超时;队列太小,则可能在短暂峰值时频繁拒绝。
比如一个调用下游服务的线程池,压测确认下游能承受 32 个并发请求,而每个任务同一时刻最多发出一个请求,可以先尝试下面的配置:
ThreadPoolExecutor executor = new ThreadPoolExecutor(
        16,
        32,
        60, TimeUnit.SECONDS,
        new ArrayBlockingQueue<>(100),
        Executors.defaultThreadFactory(),
        new ThreadPoolExecutor.AbortPolicy()
);
这里的 16、32、100 是待验证的初始配置,不是所有 8 核机器都适用。还要注意,队列满了才会从 16 继续扩到 32,如果队列很大,扩容可能迟迟不发生。
最后看压测和监控结果
我会重点观察活跃线程数、队列长度、任务排队时间、执行时间、拒绝次数,以及 CPU、内存、下游响应时间。
- CPU 已经很高,再加线程通常没有帮助。
- 队列在增长、CPU 不高,要检查是不是等待下游或连接池,而不是直接无限加线程。
- 下游已经变慢,要配合超时、限流和降级,增加并发可能进一步拖垮它。
不同类型的任务也尽量使用独立线程池,比如耗时的报表任务和在线接口调用分开,避免一个业务的积压把另一个业务也堵住。
# 核心线程数设置为0可不可以?
可以,corePoolSize 可以设置为 0,但 maximumPoolSize 必须大于 0。这不代表线程池永远没有工作线程。
提交任务时,会先尝试入队。如果入队成功,而当前工作线程数为 0,线程池会尝试创建一个工作线程,从队列里取任务,避免任务一直没人执行。
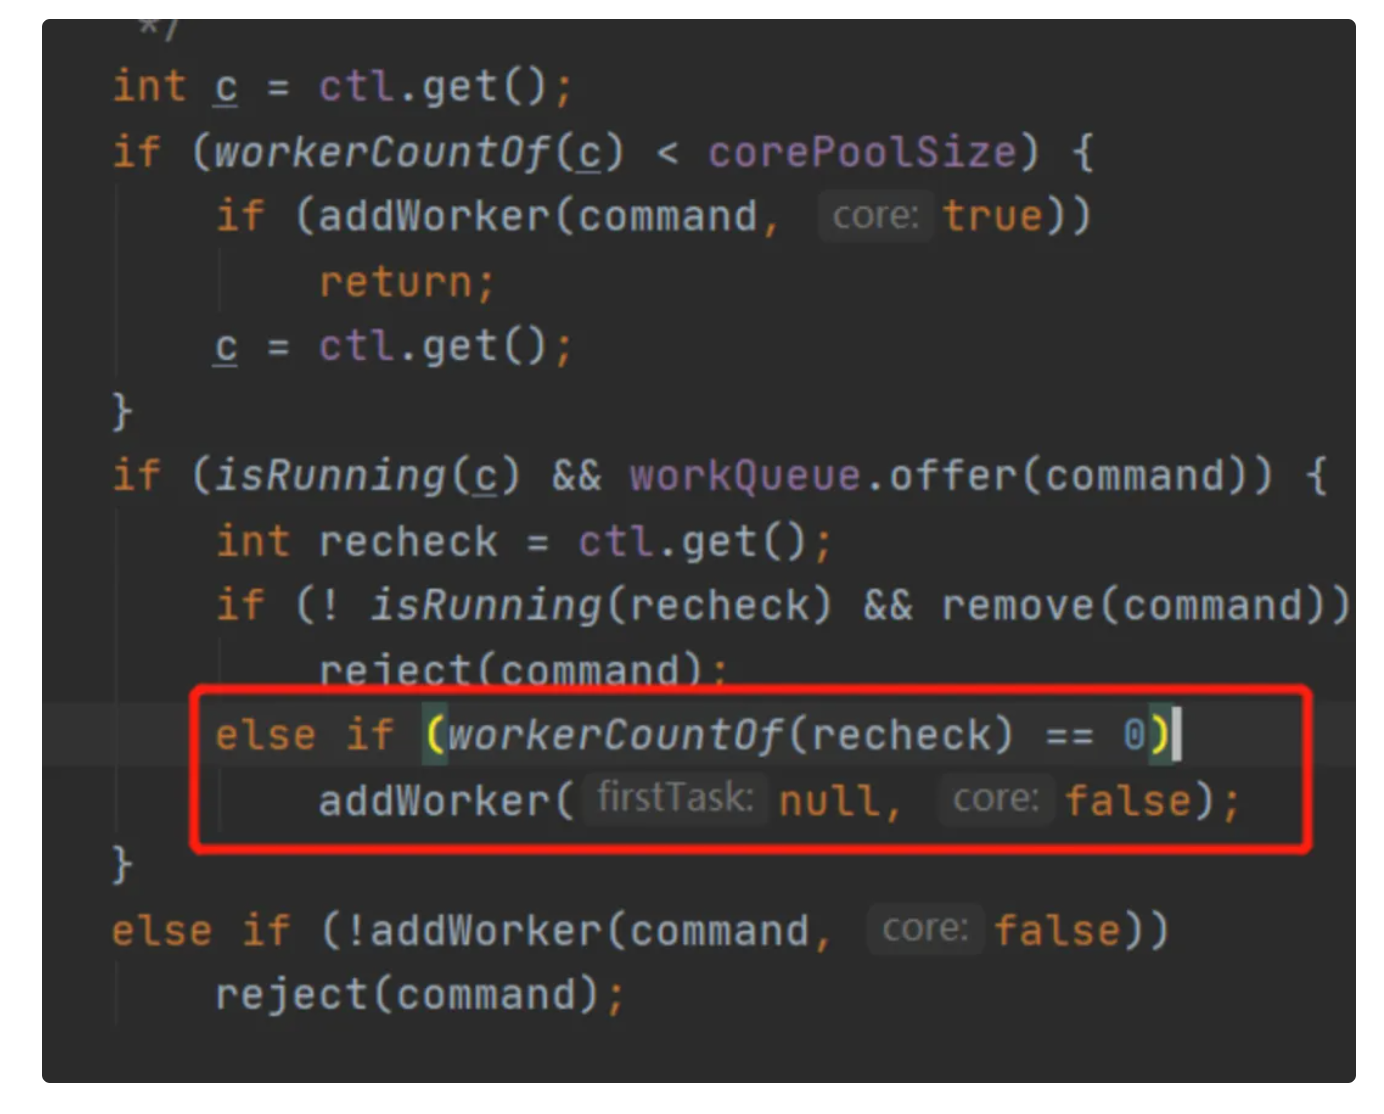
但这个流程取决于队列类型。比如使用 SynchronousQueue,没有接收者时任务无法入队,就会走创建工作线程的分支,而不是先把任务存进队列。
再比如,corePoolSize = 0、最大线程数是 10、使用无界队列。通常第一个任务入队后会创建一个线程,后续任务继续排队,不能认为它会自动扩到 10 个线程。
因为核心线程数为 0,空闲线程可以根据 keepAliveTime 被回收,最终回到没有工作线程的状态。适合需要空闲时释放线程的场景,但要结合队列和最大线程数一起设计。
# 线程池种类有哪些?
- ScheduledThreadPool:可以设置定期的执行任务,它支持定时或周期性执行任务,比如每隔 10 秒钟执行一次任务,我通过这个实现类设置定期执行任务的策略。
- FixedThreadPool:它的核心线程数和最大线程数是一样的,所以可以把它看作是固定线程数的线程池,它的特点是线程池中的线程数除了初始阶段需要从 0 开始增加外,之后的线程数量就是固定的,就算任务数超过线程数,线程池也不会再创建更多的线程来处理任务,而是会把超出线程处理能力的任务放到任务队列中进行等待。需要特别注意的是:它使用的是无界的
LinkedBlockingQueue(容量 Integer.MAX_VALUE),在任务消费速度跟不上生产速度时,队列会无限堆积,最终可能导致 OOM——这也是阿里手册禁止直接使用Executors.newFixedThreadPool()的主要原因。 - CachedThreadPool:可以称作可缓存线程池,它的特点在于线程数理论上没有上限(
maximumPoolSize被设置为Integer.MAX_VALUE),当线程闲置 60 秒后会被回收。它使用SynchronousQueue作为工作队列,容量为 0,只负责对任务进行中转和传递,每来一个任务若无空闲线程就会立即创建新线程。在高并发瞬时大量任务提交的场景下,CachedThreadPool 会快速创建成百上千的线程,很可能直接把系统资源耗尽导致 OOM,这也是阿里手册禁止使用它的核心原因,生产环境请手动 newThreadPoolExecutor并显式约束最大线程数。 - SingleThreadExecutor:它会使用唯一的线程去执行任务,原理和 FixedThreadPool 是一样的,只不过这里线程只有一个,如果线程在执行任务的过程中发生异常,线程池也会重新创建一个线程来执行后续的任务。这种线程池由于只有一个线程,所以非常适合用于所有任务都需要按被提交的顺序依次执行的场景,而前几种线程池不一定能够保障任务的执行顺序等于被提交的顺序,因为它们是多线程并行执行的。
- SingleThreadScheduledExecutor:它实际和 ScheduledThreadPool 线程池非常相似,它只是 ScheduledThreadPool 的一个特例,内部只有一个线程。
# 线程池一般是怎么用的?
Java 中的 Executors 类定义了一些快捷的工具方法,来帮助我们快速创建线程池。《阿里巴巴 Java 开发手册》中提到,禁止使用这些方法来创建线程池,而应该手动 new ThreadPoolExecutor 来创建线程池。这一条规则的背后,是大量血淋淋的生产事故,最典型的就是 newFixedThreadPool 和 newCachedThreadPool,可能因为资源耗尽导致 OOM 问题。
所以,不建议使用 Executors 提供的两种快捷的线程池,原因如下:
- 我们需要根据自己的场景、并发情况来评估线程池的几个核心参数,包括核心线程数、最大线程数、线程回收策略、工作队列的类型,以及拒绝策略,确保线程池的工作行为符合需求,一般都需要设置有界的工作队列和可控的线程数。
- 任何时候,都应该为自定义线程池指定有意义的名称,以方便排查问题。当出现线程数量暴增、线程死锁、线程占用大量 CPU、线程执行出现异常等问题时,我们往往会抓取线程栈。此时,有意义的线程名称,就可以方便我们定位问题。
除了建议手动声明线程池以外,我还建议用一些监控手段来观察线程池的状态。线程池这个组件往往会表现得任劳任怨、默默无闻,除非是出现了拒绝策略,否则压力再大都不会抛出一个异常。如果我们能提前观察到线程池队列的积压,或者线程数量的快速膨胀,往往可以提早发现并解决问题。
# 线程池和三个线程同时并发比有什么优势?
假设业务中需要处理大量并发任务,直接创建三个线程(或每次任务来了新建线程)存在明显局限,而线程池的优势主要体现在:
- 资源复用,降低开销:线程创建 / 销毁需要内核态操作(如系统调用),开销较大。线程池会复用核心线程,避免频繁创建线程,尤其在任务量大时,能显著减少资源消耗。而三个固定线程若任务超过负载,要么排队等待(效率低),要么需要临时新建线程(开销高)。
- 控制并发强度,避免资源耗尽:线程池通过最大线程数和队列限制并发数,防止线程无限制创建(比如瞬间 1000 个任务直接创建 1000 个线程,可能导致 CPU / 内存耗尽)。而三个线程若面对突发大量任务,要么处理不过来(任务堆积),要么手动扩容线程(难以控制)。
- 任务管理更灵活:线程池支持任务排队、优先级调度、拒绝策略等,能应对任务峰值(如秒杀场景的突发请求)。而三个线程的并发方式,缺乏这些机制,任务处理逻辑会和业务代码耦合(如手动写队列、处理超时)。
比如在接口网关场景中,每秒可能有上百个请求,若用三个线程处理,会导致大量请求排队超时;而线程池通过合理的核心线程数(如 10)、队列(如 200)和最大线程数(如 20),既能高效处理请求,又不会因线程过多拖垮系统。
# 线程池用了哪些设计模式?
线程池的实现中运用了多种设计模式,这些模式共同支撑了其高效的线程管理和任务调度能力,主要包括:
首先是工厂模式,体现在线程池的创建过程中。Java 中Executors类提供的newFixedThreadPool、newCachedThreadPool等静态方法,本质上是工厂方法,它们封装了ThreadPoolExecutor复杂的参数配置,根据不同场景返回预配置的线程池实例,简化了用户创建线程池的操作。用户无需关心线程池内部参数的细节,只需根据需求选择对应的工厂方法即可。
其次是享元模式,这是线程池的核心设计思想之一。线程池通过复用已创建的线程(尤其是核心线程)来执行多个任务,避免了频繁创建和销毁线程带来的资源消耗。线程作为 “共享资源”,在完成一个任务后不会被销毁,而是回到线程池等待新的任务,这种对线程资源的共享复用,正是享元模式的典型应用,有效提高了系统的资源利用率。
还有生产者 - 消费者模式,体现在任务的提交与执行流程中。用户通过execute或submit方法提交任务(生产者),任务被放入阻塞队列中;线程池中的工作线程(消费者)不断从队列中取出任务并执行。阻塞队列作为缓冲区,平衡了生产者和消费者的处理速度,避免了任务提交过快导致的线程资源不足,或线程空闲时的资源浪费,实现了任务的异步处理和解耦。
另外,线程池还隐式用到了模板方法模式。ThreadPoolExecutor的execute方法定义了任务执行的整体流程框架:先尝试添加任务到核心线程,失败则加入队列,再失败则创建非核心线程,最后执行拒绝策略。这个流程是固定的模板,而具体的任务执行、线程创建等细节则通过重写beforeExecute、afterExecute等钩子方法进行扩展,用户可以在不改变核心流程的前提下自定义任务执行前后的操作。
# 线程池中shutdown (),shutdownNow()这两个方法有什么作用?
两者都会让线程池停止接收新任务,区别在于怎样处理已经提交的任务。
- shutdown():有序关闭。已经运行的任务继续执行,队列里的任务也会继续处理;后续提交的新任务交给拒绝策略。它会唤醒空闲工作线程,让线程池逐步退出,但不会为了关闭而中断正在执行的任务。
- shutdownNow():尝试更快地停止。通过中断请求让正在执行的任务停止,不再领取队列里的等待任务,并返回从队列中取出的未执行任务。
不过,shutdownNow() 不是强制终止线程。如果任务不检查中断,或者阻塞在不能通过中断取消的操作上,就可能继续运行。计算任务即使没有调用 sleep(),也可以通过检查中断标志来配合退出。
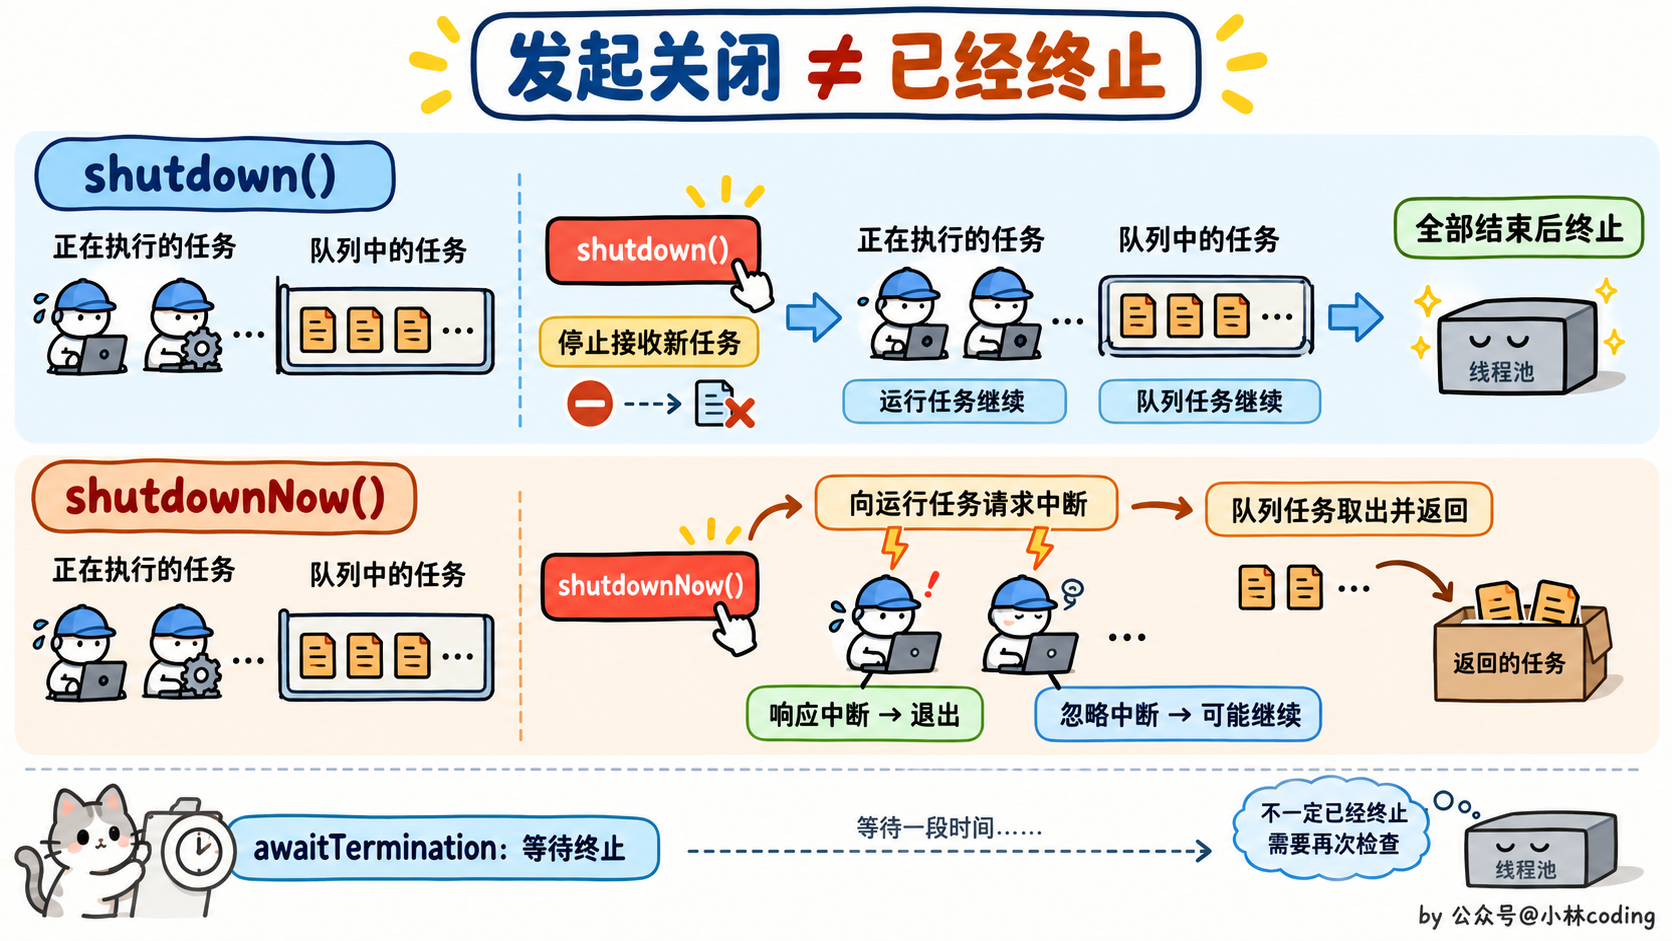
这两个方法本身都不会等待线程池彻底结束。如果需要确认已经退出,应使用 awaitTermination(),例如:
executor.shutdown();
try {
    if (!executor.awaitTermination(30, TimeUnit.SECONDS)) {
        executor.shutdownNow();
        if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {
            System.out.println("仍有任务没有结束,需要进一步处理");
        }
    }
} catch (InterruptedException e) {
    executor.shutdownNow();
    Thread.currentThread().interrupt();
}
isShutdown() 表示已经发起关闭,isTerminated() 才表示关闭后所有任务和工作线程都已结束。
另外,shutdownNow() 返回的任务,需要由业务决定是否记录、补偿或重新提交。从队列移除不代表对应的 Future 一定自动进入取消状态,不能继续无条件等待这些任务的结果。
# execute 和 submit 有什么区别?
两者都能提交任务,主要区别是可提交的任务类型、返回值,以及异常如何被观察到。
- execute():接受
Runnable,没有 Future 返回值。 - submit():可以接受
Runnable或Callable,返回 Future。Callable可以返回结果,Runnable也可以通过 Future 判断完成或取消。
对于常见的 ThreadPoolExecutor,任务通过 execute() 执行时,如果有未捕获的运行时异常,会离开任务执行流程,通常导致这个工作线程退出,异常可以交给线程的未捕获异常处理器。线程池会根据状态和配置补充工作线程。
通过 submit() 提交时,任务通常会被包装成 FutureTask。任务异常会保存在 Future 里,调用 get() 时以 ExecutionException 的形式抛出,原始原因可以通过 getCause() 获取。
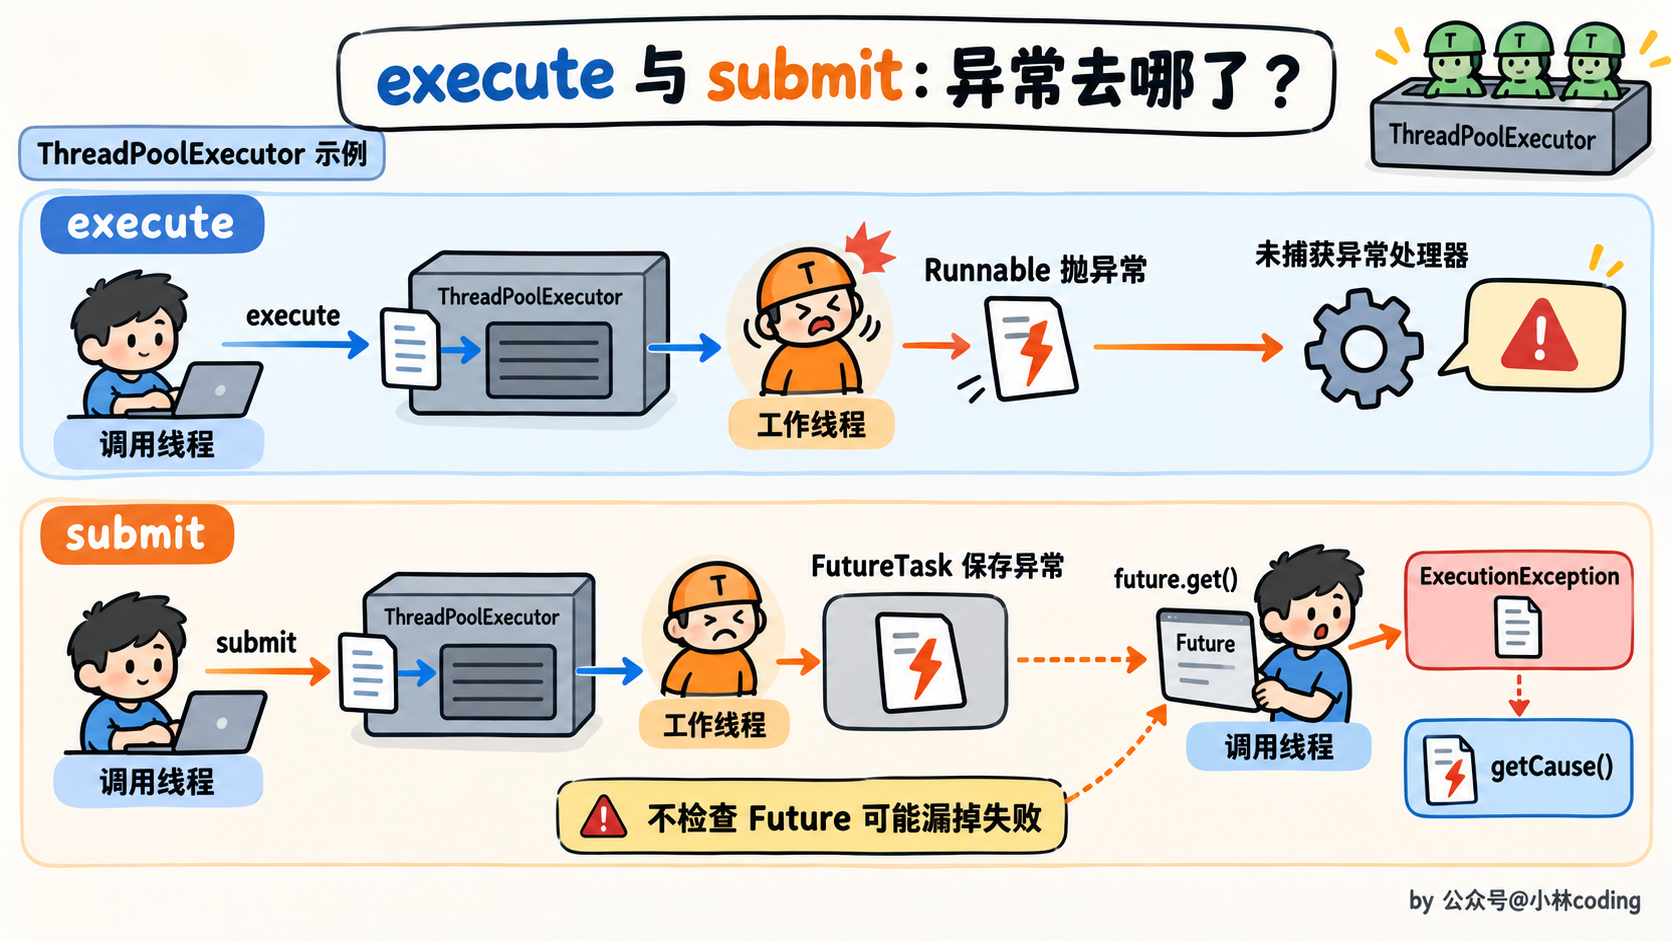
Future<?> future = executor.submit(() -> {
    throw new IllegalStateException("任务执行失败");
});
try {
    future.get();
} catch (ExecutionException e) {
    System.out.println(e.getCause());
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
}
所以,submit() 不是让异常消失了,而是改变了异常的传递方式。如果不检查 Future,也没有其他异常记录机制,就可能忽略任务失败。
另外,任务执行异常和任务提交失败是两回事。线程池使用 AbortPolicy 拒绝任务时,execute()、submit() 都可能在提交阶段直接抛出 RejectedExecutionException。
# 提交给线程池中的任务可以被撤回吗?
可以尝试取消,但要区分取消任务的结果状态和让实际执行停止。通过 submit() 提交任务后,可以用返回的 Future 调用 cancel()。
- 任务还没开始:成功取消后,不应再执行它。
- 任务已经开始,调用
cancel(true):对于常见的ThreadPoolExecutor和FutureTask,会尝试中断执行线程,任务需要配合响应。 - 任务已经开始,调用
cancel(false):不向执行线程发送中断。FutureTask仍可能成功标记取消,但实际任务会继续运行,结果不会再通过这个 Future 正常返回。 - 任务已经完成:通常无法再取消,取消也不会撤销已经发生的数据库写入或其他业务操作。
比如等待任务超过 2 秒,就尝试取消:
import java.util.concurrent.*;

class FutureCancelExample {
    public static void main(String[] args) {
        ExecutorService executor = Executors.newSingleThreadExecutor();
        Future<Integer> future = executor.submit(() -> {
            Thread.sleep(5000); // 可以响应中断
            return 42;
        });

        try {
            System.out.println(future.get(2, TimeUnit.SECONDS));
        } catch (TimeoutException e) {
            future.cancel(true);
        } catch (InterruptedException e) {
            future.cancel(true);
            Thread.currentThread().interrupt();
        } catch (ExecutionException e) {
            System.out.println("任务失败:" + e.getCause());
        } finally {
            executor.shutdown();
        }
    }
}
这里要注意:get() 超时只表示调用方等不下去了,不会自动取消任务,所以需要显式调用 cancel()。
取消之后,get() 会抛出 CancellationException。即使 isCancelled()、isDone() 都是 true,也不能据此认为执行线程已经停止。
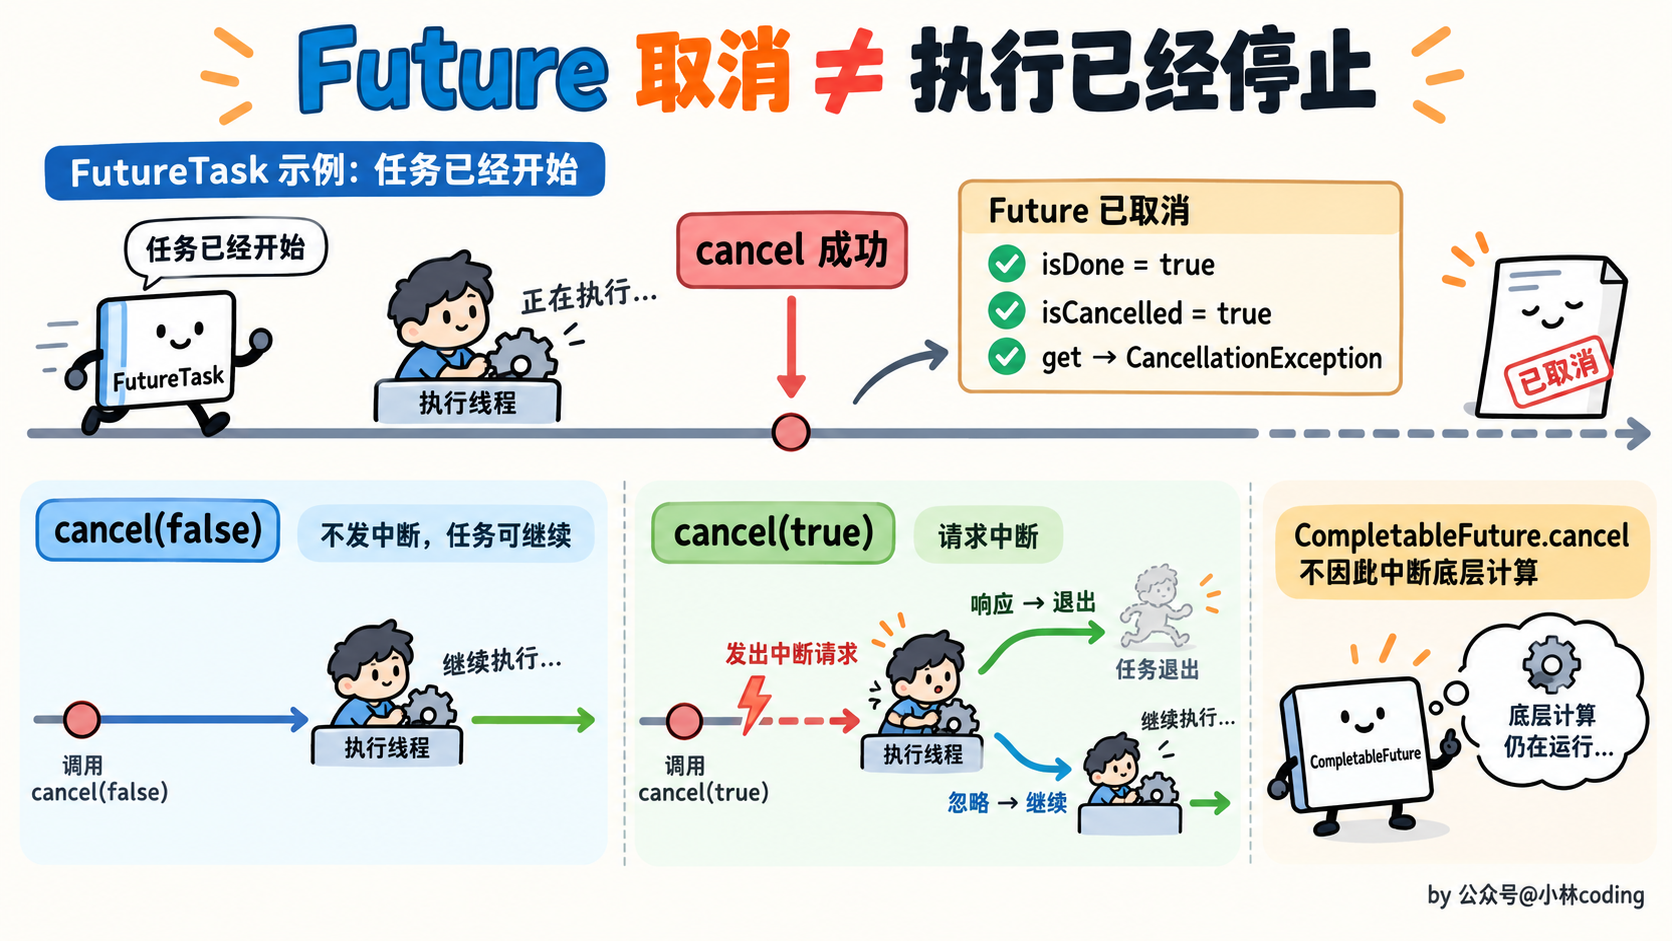
另外,取消的任务包装对象可能暂时还在普通线程池的队列里,需要时可结合 ThreadPoolExecutor.purge() 清理。不同 Future 实现的取消机制也不完全一样,比如 CompletableFuture.cancel(true) 不会因此中断底层计算线程。
# CompletableFuture 和 Future 有什么区别?
Future 主要用于获取异步结果、等待完成和取消任务,CompletableFuture 在这些能力上,进一步支持异步任务之间的组合和完成后的回调。
比如先查询用户,再用用户信息查询订单;或者同时查询价格和库存,等两个结果都回来后组合。这些场景用普通 Future 往往要手动调用 get(),用 CompletableFuture 可以表达任务之间的关系。
常见方法可以这样区分:
- supplyAsync() / runAsync():启动有返回值或无返回值的异步任务。
- thenApply():把上一个阶段的结果转换成另一个值。
- thenCompose():下一步也返回
CompletableFuture时,把两层异步结果串起来。 - thenCombine():等两个阶段正常完成后,组合它们的结果。
- allOf():等待多个阶段全部完成,返回
CompletableFuture<Void>,各个结果仍需从原来的 Future 获取。 - exceptionally() / handle():处理失败,或者把成功和失败都转换成后续结果。
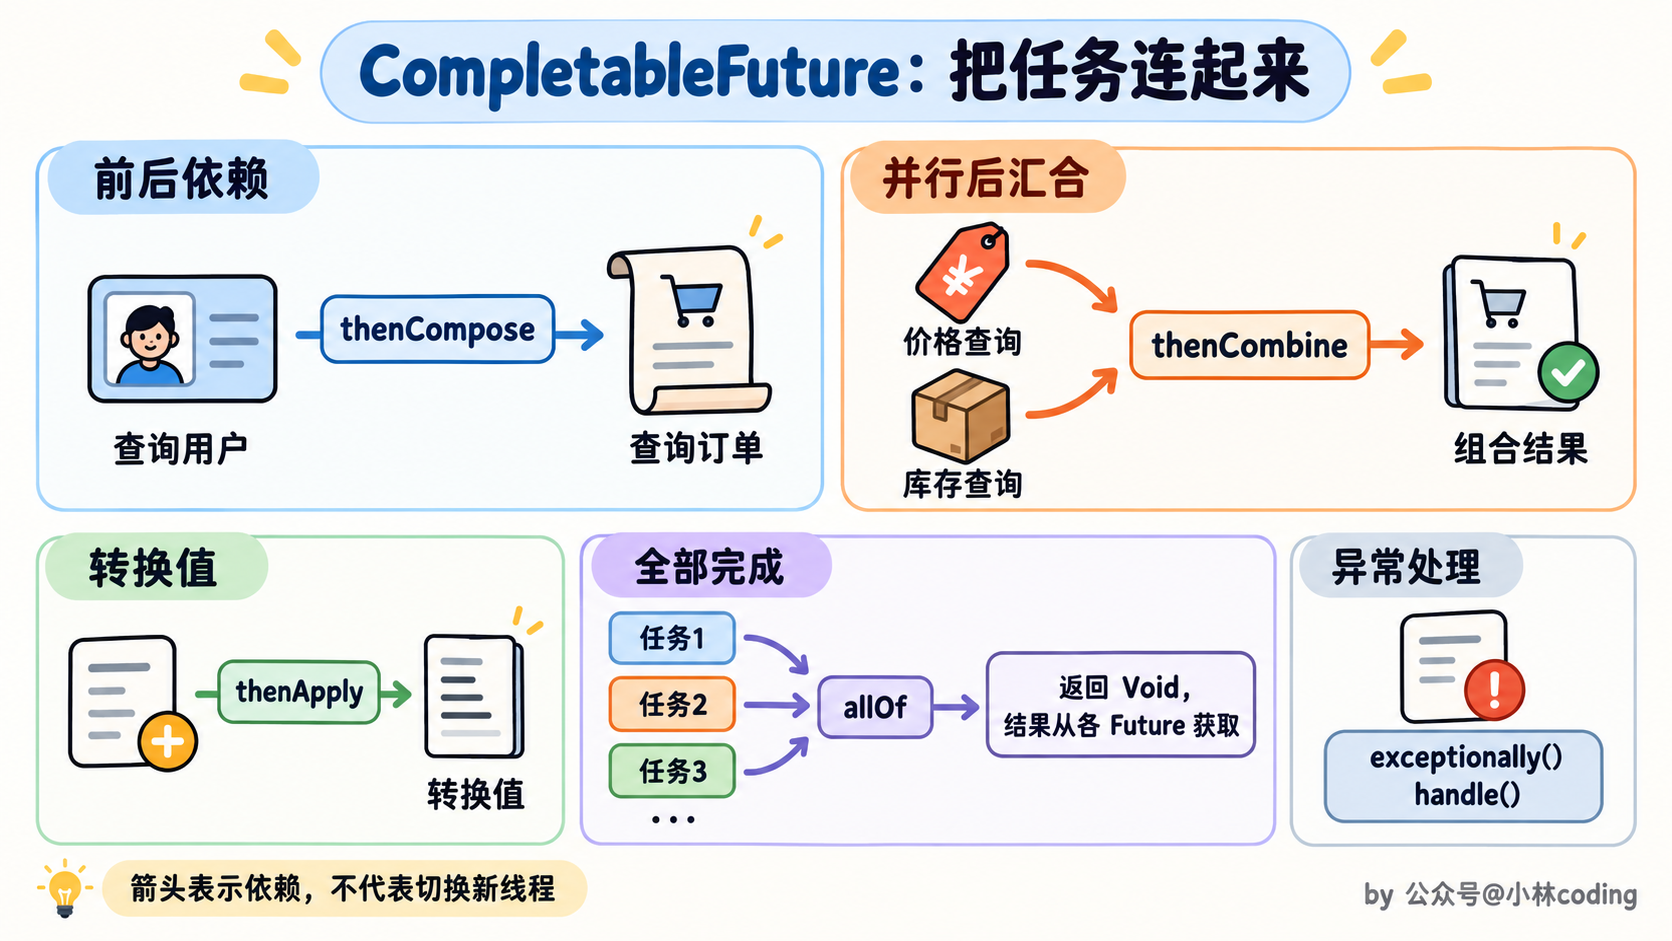
import java.util.concurrent.*;

class CompletableFutureExample {
    public static void main(String[] args) {
        ExecutorService executor = Executors.newFixedThreadPool(2);
        try {
            CompletableFuture<Integer> price =
                    CompletableFuture.supplyAsync(() -> 100, executor);
            CompletableFuture<Integer> stock =
                    CompletableFuture.supplyAsync(() -> 20, executor);
            CompletableFuture<String> result = price.thenCombine(stock,
                    (p, s) -> "价格:" + p + ",库存:" + s);
            System.out.println(result.join());
        } finally {
            executor.shutdown();
        }
    }
}
这里还要注意几个容易被追问的点:
第一,不指定执行器的异步方法,通常使用公共 ForkJoinPool。如果大量阻塞 IO 共用这个池,可能影响其他任务,业务里可以传入专用执行器。
第二,不带 Async 的回调,不保证运行在一个新的线程里。它可能由完成前一个阶段的线程执行,也可能在注册回调的线程中直接执行,不能依靠它自动切换线程。
第三,get() 会抛出受检异常,能处理中断;join() 主要用 CompletionException 传递计算异常,没有受检的 InterruptedException,但两者都可能阻塞。
第四,CompletableFuture.cancel(true) 不会因此中断底层计算线程。取消和超时首先影响结果状态,要停止实际计算,还需要任务本身的取消机制。
最后,不要在资源有限的线程池里,让所有工作线程都阻塞等待同一个池中尚未执行的子任务。可以用异步组合减少这种等待,必要时把不同任务安排到独立的执行器。
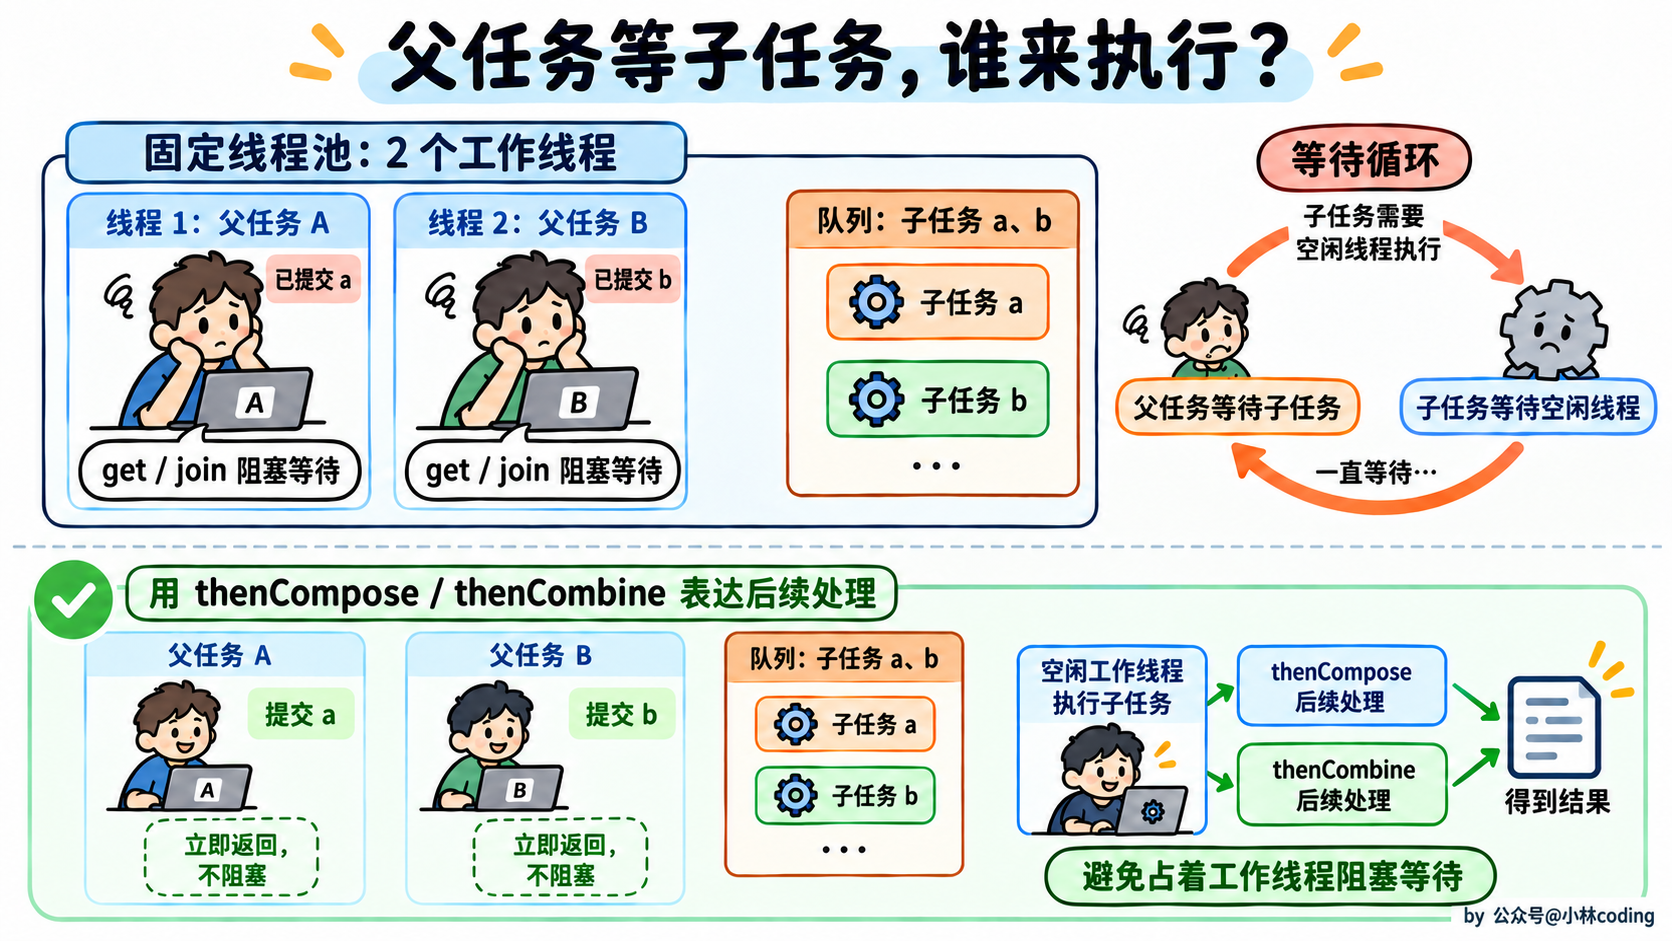
# 场景
# 多线程打印奇偶数,怎么控制打印的顺序
可以利用wait()和notify()来控制线程的执行顺序。
以下是一个基于这种方法的简单示例:
public class PrintOddEven {
    private static final Object lock = new Object();
    private static int count = 1;
    private static final int MAX_COUNT = 10;

    public static void main(String[] args) {
        Runnable printOdd = () -> {
            synchronized (lock) {
                while (count <= MAX_COUNT) {
                    if (count % 2 != 0) {
                        System.out.println(Thread.currentThread().getName() + ": " + count++);
                        lock.notify();
                    } else {
                        try {
                            lock.wait();
                        } catch (InterruptedException e) {
                            e.printStackTrace();
                        }
                    }
                }
            }
        };

        Runnable printEven = () -> {
            synchronized (lock) {
                while (count <= MAX_COUNT) {
                    if (count % 2 == 0) {
                        System.out.println(Thread.currentThread().getName() + ": " + count++);
                        lock.notify();
                    } else {
                        try {
                            lock.wait();
                        } catch (InterruptedException e) {
                            e.printStackTrace();
                        }
                    }
                }
            }
        };

        Thread oddThread = new Thread(printOdd, "OddThread");
        Thread evenThread = new Thread(printEven, "EvenThread");

        oddThread.start();
        evenThread.start();
    }
}
在上面的示例中,通过一个共享的锁对象lock来控制两个线程的交替执行。一个线程负责打印奇数,另一个线程负责打印偶数,通过wait()和notify()方法来在两个线程之间实现顺序控制。当当前应该打印奇数时,偶数线程会进入等待状态,反之亦然。
# 单例模型既然已经用了synchronized,为什么还要在加volatile?
这里说的是双重检查锁定的单例写法。关键原因是:第一次检查和最终读取实例引用,并不都在 synchronized 里面,所以不能只靠锁来保证对象的安全发布。
public class Singleton {
    private static volatile Singleton instance;

    private Singleton() {}

    public static Singleton getInstance() {
        if (instance == null) { // 第一次检查,不持有锁
            synchronized (Singleton.class) {
                if (instance == null) { // 第二次检查,持有锁
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}
synchronized 的作用,是避免多个线程同时创建实例。第一次检查减少已经初始化后的加锁开销,第二次检查则避免多个线程先后进入同步块后重复创建。
volatile 的作用,是让这个实例引用被安全地发布给没有获取锁的读线程。
instance = new Singleton() 可以粗略理解为分配内存、初始化对象、把引用赋给 instance。如果缺少安全发布,其他线程可能观察到 instance 已经不为 null,但对象初始化的结果还没有正确对它可见。
这时它会跳过同步块,直接返回这个对象。虽然创建者在同步块里,但读取者没有获取同一把锁,不能建立锁对应的 happens-before 关系。
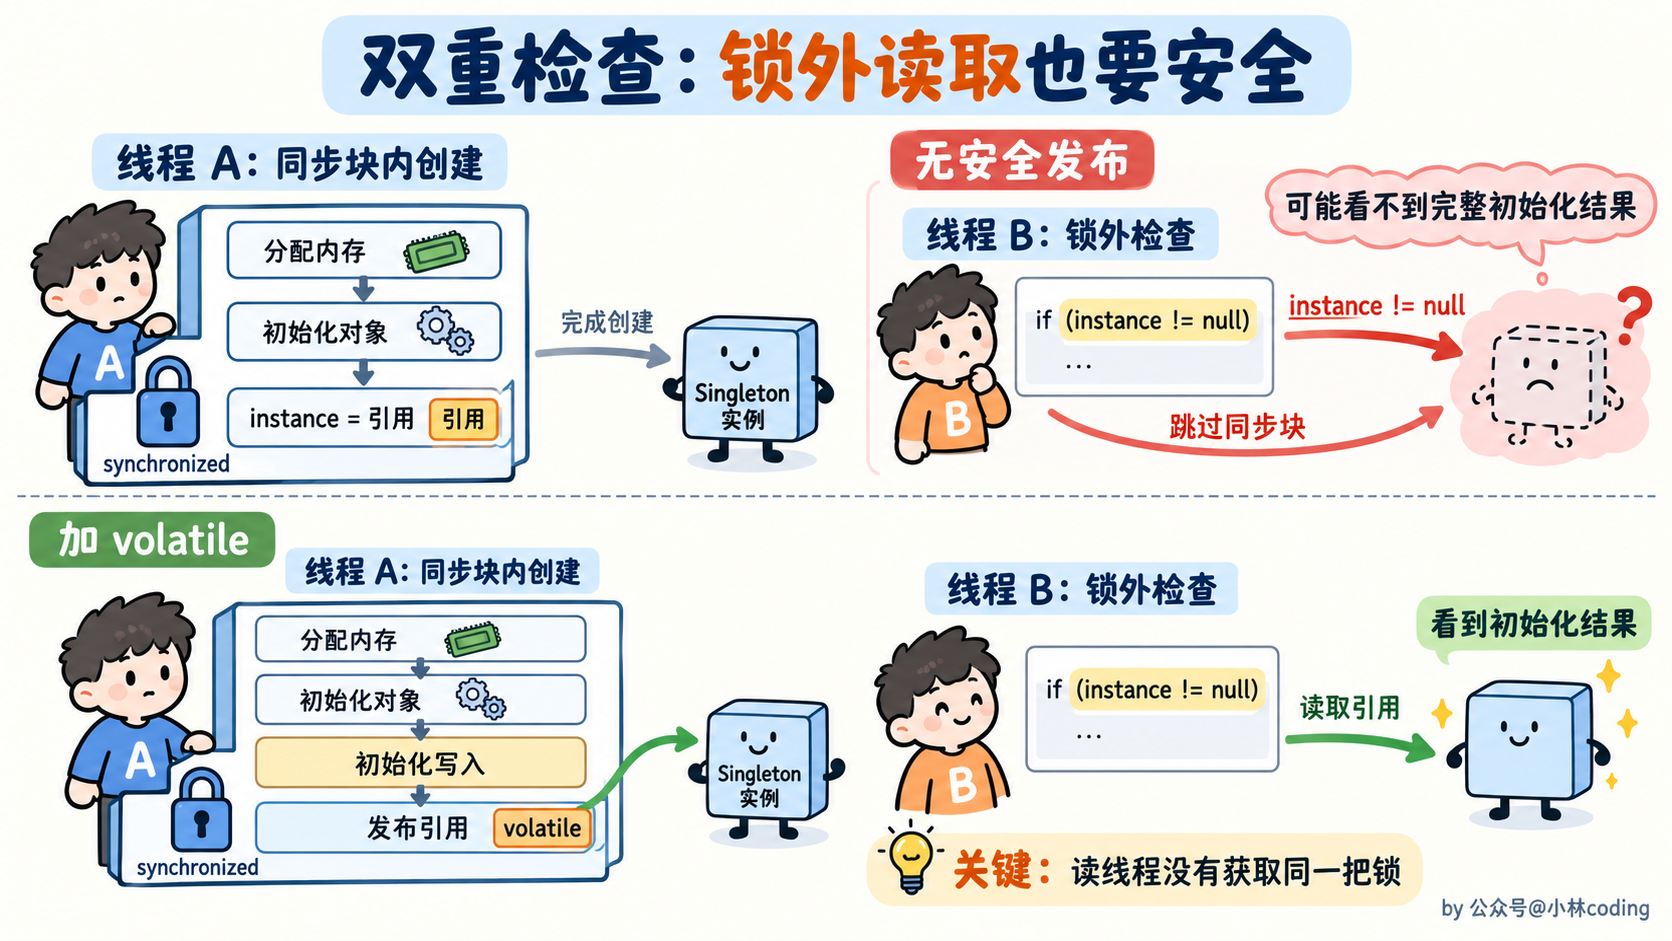
加上 volatile 后,对 instance 的写与后续读建立 happens-before,初始化过程中已经完成的写入,对读到这个实例的线程可见。
所以,不是单例用了 synchronized 就一定还要加 volatile,而是这段双重检查代码存在无锁读取。如果整个 getInstance() 都用同一把锁保护,就不需要为了这个发布问题额外加 volatile;也可以使用静态内部类或枚举来实现单例。
# 3个线程并发执行,1个线程等待这三个线程全部执行完在执行,怎么实现?
可以使用 CountDownLatch 来实现 3 个线程并发执行,另一个线程等待这三个线程全部执行完再执行的需求。以下是具体的实现步骤:
- 创建一个
CountDownLatch对象,并将计数器初始化为 3,因为有 3 个线程需要等待。 - 创建 3 个并发执行的线程,在每个线程的任务结束时调用
countDown方法将计数器减 1。 - 创建第 4 个线程,使用
await方法等待计数器为 0,即等待其他 3 个线程完成任务。
import java.util.concurrent.CountDownLatch;

public class CountDownLatchExample {
    public static void main(String[] args) {
        // 创建一个 CountDownLatch, 初始计数为 3
        CountDownLatch latch = new CountDownLatch(3);

        // 创建并启动 3 个并发线程
        for (int i = 0; i < 3; i++) {
            final int threadNumber = i + 1;
            new Thread(() -> {
                try {
                    System.out.println("Thread " + threadNumber + " is working.");
                    // 模拟线程执行任务
                    Thread.sleep((long) (Math.random() * 1000));
                    System.out.println("Thread " + threadNumber + " has finished.");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } finally {
                    // 任务完成后, 计数器减 1
                    latch.countDown();
                }
            }).start();
        }

        // 创建并启动第 4 个线程, 等待其他 3 个线程完成
        new Thread(() -> {
            try {
                System.out.println("Waiting for other threads to finish.");
                // 等待计数器为 0
                latch.await();
                System.out.println("All threads have finished, this thread starts to work.");
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }).start();
    }
}
代码解释:
- 首先,创建了一个
CountDownLatch对象latch,并将其初始计数设置为 3。 - 然后,使用
for循环创建并启动 3 个线程。每个线程会执行一些工作(这里使用Thread.sleep模拟),在工作完成后,会调用latch.countDown()方法,将latch的计数减 1。 - 最后,创建第 4 个线程。这个线程在开始时调用
latch.await()方法,它会阻塞,直到latch的计数为 0,即前面 3 个线程都调用了countDown()方法。一旦计数为 0,该线程将继续执行后续任务。
# 假设两个线程并发读写同一个整型变量,初始值为零,每个线程加 50 次,结果可能是什么?
在没有任何同步机制的情况下,两个线程并发对同一个整型变量进行 50 次加 1 操作,最终结果可能是 100,也可能远小于 100。由于每次 num++ 都可能因竞争而丢失更新,理论上结果可以低至 2(极端交错下),通常实际结果落在 (1, 100] 范围内。
小于 100 情况的分析,由于对整型变量的 num++ 操作不是原子操作,它实际上包含了三个步骤:读取变量的值、将值加 1、将新值写回变量。在多线程环境下,可能会出现线程安全问题。例如,线程 1 和线程 2 同时读取了变量的当前值,然后各自将其加 1,最后都将相同的新值写回变量,这就导致了一次加 1 操作的丢失。这种情况会多次发生,最终结果就会小于 100。
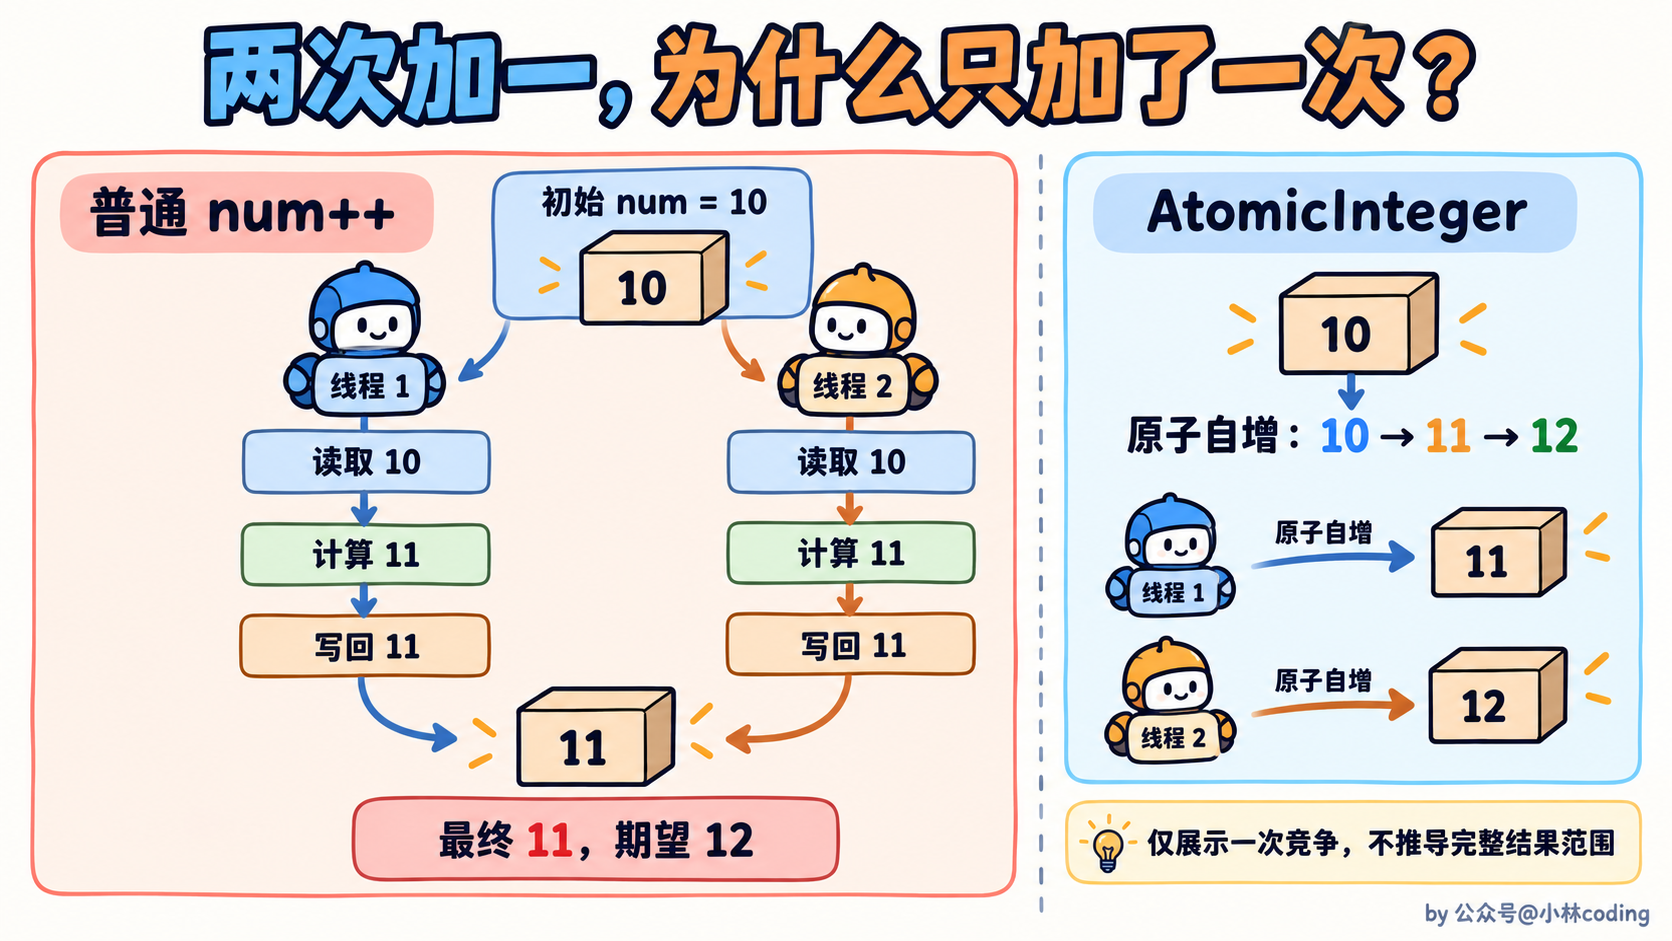
import java.util.concurrent.atomic.AtomicInteger;

public class AtomicIntegerAddition {
    private static AtomicInteger num = new AtomicInteger(0);

    public static void main(String[] args) throws InterruptedException {
        Thread thread1 = new Thread(() -> {
            for (int i = 0; i < 50; i++) {
                num.incrementAndGet();
            }
        });

        Thread thread2 = new Thread(() -> {
            for (int i = 0; i < 50; i++) {
                num.incrementAndGet();
            }
        });

        thread1.start();
        thread2.start();

        thread1.join();
        thread2.join();

        System.out.println("最终结果: " + num.get());
    }
}
第二种方式:通过 synchronized 关键字或 ReentrantLock 确保操作的互斥性,代码如下:
public class SynchronizedAddition {
    private static int num = 0;
    private static final Object lock = new Object();

    public static void main(String[] args) throws InterruptedException {
        Thread thread1 = new Thread(() -> {
            for (int i = 0; i < 50; i++) {
                synchronized (lock) {
                    num++;
                }
            }
        });

        Thread thread2 = new Thread(() -> {
            for (int i = 0; i < 50; i++) {
                synchronized (lock) {
                    num++;
                }
            }
        });

        thread1.start();
        thread2.start();

        thread1.join();
        thread2.join();

        System.out.println("最终结果: " + num);
    }
}
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。
← Java集合面试题 Java虚拟机面试题 →