# 计算机网络面试题
大家好,我是小林。
计算机网络是面试里的经典话题,无论你面的是什么方向,多多少少都会被问到。而且这块的题目有个特点:表面看起来很简单,一问深了就容易卡壳。比如"TCP 三次握手",大家都知道个大概,但要说清楚为什么不是两次、第三次握手丢失会怎样、半连接队列是什么,能流利答下来的人并不多。
这篇文章把计算机网络面试中最常被问到的问题都整理进来了,从网络模型、HTTP/HTTPS、DNS,到 TCP 的握手挥手、拥塞控制,再到实际的网络排查场景和常见的网络攻击,整体覆盖还算全面。内容上尽量把原理讲清楚,而不只是给个答案让你背。
有几块内容是面试里的高频重点,值得多花时间:
- TCP 三次握手和四次挥手:不只要知道过程,还要能解释为什么是三次而不是两次、每次丢包会发生什么、TIME_WAIT 状态是怎么来的,这些追问几乎每次都会出现。
- HTTP 和 HTTPS:两者的区别、TLS 握手的四个步骤、为什么 HTTPS 能防中间人攻击,这是应用层最高频的考点。
- TCP 可靠传输和拥塞控制:慢启动、拥塞避免、快重传、快恢复这四个阶段,要能说清楚流程和状态转变。
- 网络排查场景:比如"页面加载慢怎么排查""ping 不通但 HTTP 能访问是什么原因",这类实际场景题越来越常见,考的是你对网络协议的整体理解。
如果你是第一次系统复习网络,建议先把 TCP 这块啃透,它在面试里的比重最大,也是最容易拉开差距的地方。
# 网络模型
# 网络OSI模型和TCP/IP模型分别介绍一下
OSI七层模型
为了使得多种设备能通过网络相互通信,和为了解决各种不同设备在网络互联中的兼容性问题,国际标准化组织制定了开放式系统互联通信参考模型(Open System Interconnection Reference Model),也就是 OSI 网络模型,该模型主要有 7 层,分别是应用层、表示层、会话层、传输层、网络层、数据链路层以及物理层。
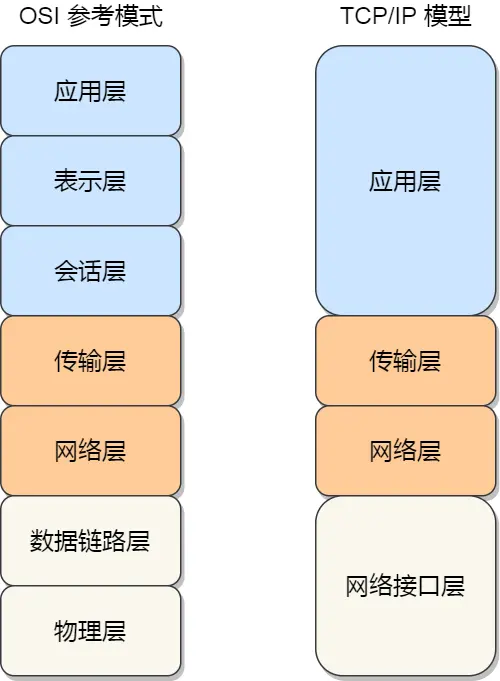
每一层负责的职能都不同,如下:
- 应用层,负责给应用程序提供统一的接口;
- 表示层,负责把数据转换成兼容另一个系统能识别的格式;
- 会话层,负责建立、管理和终止表示层实体之间的通信会话;
- 传输层,负责端到端的数据传输;
- 网络层,负责数据的路由、转发、分片;
- 数据链路层,负责数据的封帧和差错检测,以及 MAC 寻址;
- 物理层,负责在物理介质上传输比特流(bit stream)。
由于 OSI 模型实在太复杂,提出的也只是概念理论上的分层,并没有提供具体的实现方案。
事实上,我们比较常见,也比较实用的是四层模型,即 TCP/IP 网络模型,Linux 系统正是按照这套网络模型来实现网络协议栈的。
TCP/IP模型
TCP/IP 网络通常由上到下分成 4 层,分别是应用层、传输层、网络层和网络接口层。它把 OSI 模型中的应用层、表示层和会话层合并成应用层,把数据链路层和物理层的功能放到网络接口层。实际通信时,网络接口层可以使用以太网、Wi-Fi 等技术。
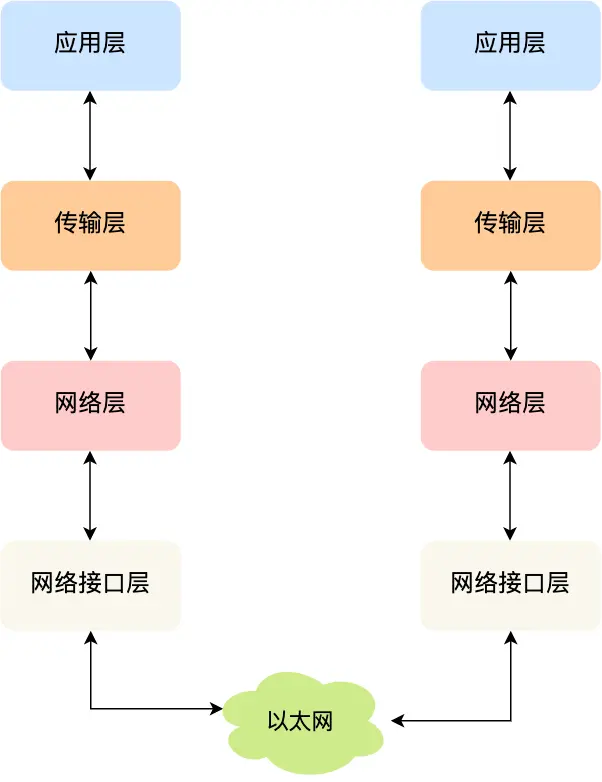
- 应用层 支持 HTTP、SMTP 等最终用户进程
- 传输层 通过端口号提供进程到进程的通信(TCP、UDP)
- 网络层 寻址和路由数据包(IP 协议)
- 网络接口层 负责在相邻节点之间传输数据,包括封帧、MAC 寻址和物理传输等
# tcp、ip分别位于哪一层?
- tcp 在传输层
- ip 在网络层
# 应用层
# 应用层有哪些协议?
常见的应用层协议有 HTTP、DNS、FTP、SMTP、SSH、WebSocket 等,HTTPS 则是在 HTTP 通信中加入 TLS 安全保护。
这里容易混淆的是 CDN。CDN 是内容分发网络,是一种加速服务的架构,不是一种协议,它通常结合 DNS 调度、HTTP 缓存和边缘节点来提供服务。
# HTTP报文有哪些部分?
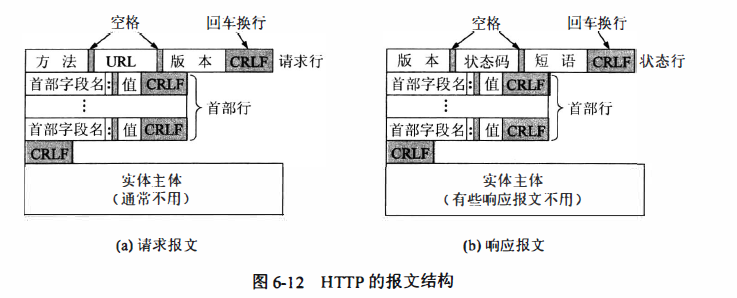
这里以 HTTP/1.1 为例,分请求报文和响应报文来说明。HTTP/2 和 HTTP/3 使用帧来传递报文,不能直接套用下面的文本格式。
请求报文:
- 请求行:包含请求方法、请求目标(URL或URI)和HTTP协议版本。
- 请求头部:包含关于请求的附加信息,如Host、User-Agent、Content-Type等。
- 空行:请求头部和请求体之间用空行分隔。
- 请求体:可选,包含请求的数据,通常用于POST请求等需要传输数据的情况。
响应报文:
- 状态行:包含HTTP协议版本、状态码和状态信息。
- 响应头部:包含关于响应的附加信息,如Content-Type、Content-Length等。
- 空行:响应头部和响应体之间用空行分隔。
- 响应体:包含响应的数据,通常是服务器返回的HTML、JSON等内容。
# HTTP常用的状态码?
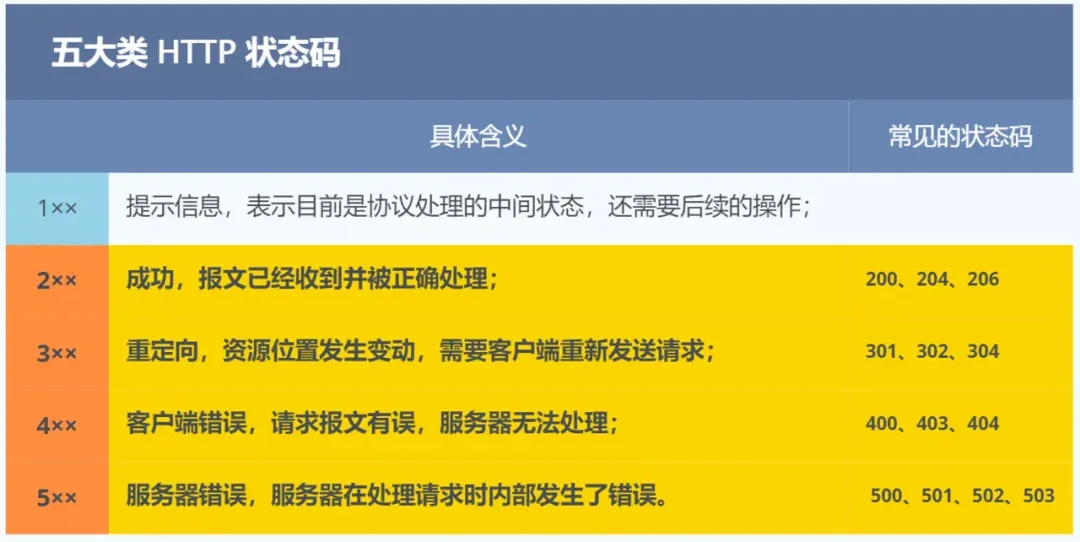
HTTP 状态码分为 5 大类:
- 1xx:提示信息,表示请求还在处理中,比如 100 Continue。
- 2xx:成功处理请求,比如 200 OK。
- 3xx:需要进一步操作,比如重定向,或者使用已经缓存的资源。注意,304 并不是跳转到另一个 URL。
- 4xx:请求存在问题,比如参数错误、身份认证失败或者资源不存在。
- 5xx:服务器处理请求时发生错误,也包括网关访问上游服务失败。
其中常见的具体状态码有:
- 200 OK:请求成功;201 Created:成功创建资源;204 No Content:请求成功,但是没有响应体。
- 206 Partial Content:成功返回部分资源,常用于断点续传。
- 301 / 302:永久重定向 / 临时重定向;304 Not Modified:协商缓存命中,客户端使用本地缓存的响应体。
- 400 Bad Request:请求格式等有问题;401 Unauthorized:缺少有效的身份凭证;403 Forbidden:服务器拒绝访问,常见于权限不足。
- 404 Not Found:资源不存在;405 Method Not Allowed:资源不支持该请求方法;429 Too Many Requests:请求过于频繁,被限流了。
- 500 Internal Server Error:服务器内部错误;502 Bad Gateway:网关访问上游失败或收到无效响应;503 Service Unavailable:服务暂时不可用;504 Gateway Timeout:网关等待上游响应超时。
# HTTP返回状态301 302分别是什么?
301 和 302 都是重定向状态码,通常通过响应头里的 Location 告诉客户端新的地址。
- 301 Moved Permanently:永久重定向,表示资源以后应该使用新的 URL 访问,比如网站更换了域名。
- 302 Found:临时重定向,表示这次先去另一个 URL,但以后仍然可以使用原来的地址,比如用户未登录时跳转到登录页。
面试里还可能追问:如果原来是 POST 请求,跳转后还是 POST 吗?
**对于 301 和 302,浏览器可能把 POST 改成 GET。**如果希望重定向后保留原来的请求方法和请求体,可以使用 307 临时重定向或者 308 永久重定向。
# http 502和 504 的区别?
- 502 Bad Gateway:作为网关或者代理工作的服务器尝试执行请求时,从上游服务器接收到无效的响应。
- 504 Gateway Time-out:作为网关或者代理工作的服务器尝试执行请求时,未能及时从上游服务器收到响应。
举一个例子,假设 nginx 是代理服务器,收到客户端的请求后,将请求转发到后端服务器(tomcat 等)。
- 当nginx收到了无效的响应时,就返回502。
- 当 nginx 超过自己配置的等待时间,还没有收到上游的响应时,就返回 504 错误。
# HTTP层请求的类型有哪些?
- GET:用于请求获取指定资源,通常用于获取数据。
- POST:用于向服务器提交数据,通常用于提交表单数据或进行资源的创建。
- PUT:用于向服务器更新指定资源,通常用于更新已存在的资源。
- DELETE:用于请求服务器删除指定资源。
- HEAD:语义与 GET 类似,但响应没有响应体,用于获取资源的元数据。
- PATCH:用于对资源进行局部修改。
- OPTIONS:用于查询资源支持的通信选项,浏览器的 CORS 预检请求也会用到它。
# GET和POST的使用场景,有哪些区别?
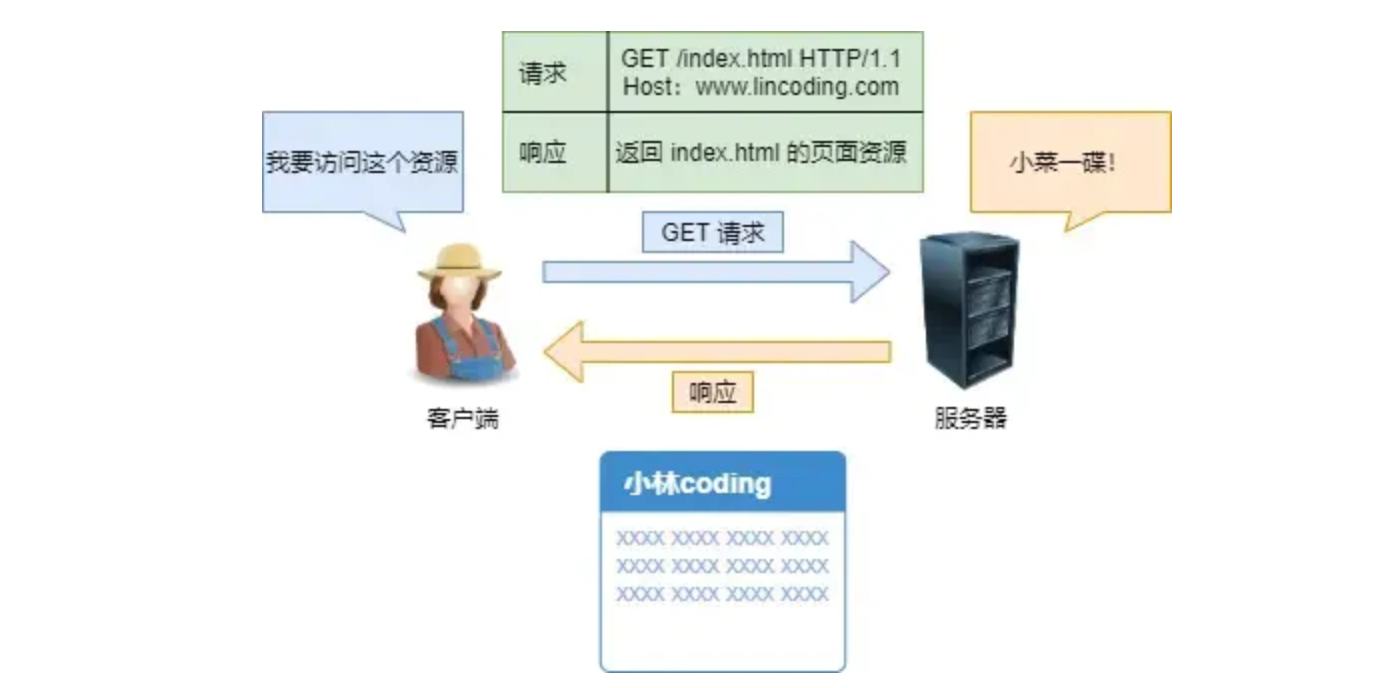
根据 RFC 规范,GET 的语义是从服务器获取指定的资源,这个资源可以是静态的文本、页面、图片视频等。GET 请求的参数一般写在 URL 的查询字符串中,中文等字符可以经过百分号编码后传输,并不是只能传 ASCII 内容。HTTP 没有统一规定 URL 的最大长度,但浏览器、代理和服务器通常都有各自的限制。
比如,你打开我的文章,浏览器就会发送 GET 请求给服务器,服务器就会返回文章的所有文字及资源。
根据 RFC 规范,POST 的语义是根据请求负荷(报文body)对指定的资源做出处理,具体的处理方式视资源类型而不同。POST 请求携带数据的位置一般是写在报文 body 中,body 中的数据可以是任意格式的数据,只要客户端与服务端协商好即可,HTTP 同样没有统一规定 body 的最大大小,但客户端、网关和服务端可以配置大小限制,比如上传文件过大时可能收到 413。
比如,你在我文章底部,敲入了留言后点击「提交」(暗示你们留言),浏览器就会执行一次 POST 请求,把你的留言文字放进了报文 body 里,然后拼接好 POST 请求头,通过 TCP 协议发送给服务器。
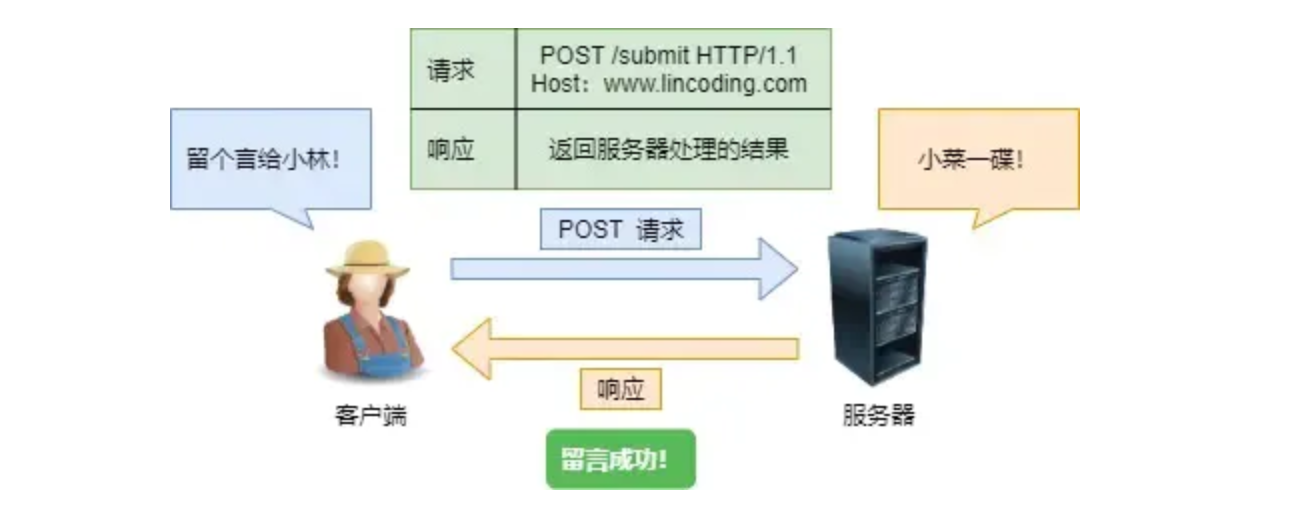
如果从 RFC 规范定义的语义来看:
- GET 方法就是安全且幂等的,这里的「安全」表示请求的语义不要求修改服务器资源,「幂等」表示执行一次和执行多次,对服务器产生的预期效果相同,并不是每次返回的内容都必须相同。比如查询商品价格,价格变了,GET 返回的结果也会变,但它仍然可以是幂等的。所以,可以对 GET 请求的数据做缓存,这个缓存可以做到浏览器本身上(彻底避免浏览器发请求),也可以做到代理上(如nginx),而且在浏览器中 GET 请求可以保存为书签。
- POST 方法的语义不保证安全和幂等。比如创建订单,重复提交可能创建多笔订单,所以不能默认随便重试。POST 响应并不是绝对不能缓存,在满足明确的缓存条件时也可以缓存,只是常见实现对它的支持比较有限。
但是实际过程中,开发者不一定会按照 RFC 规范定义的语义来实现 GET 和 POST 方法。比如:
- 可以用 GET 方法实现新增或删除数据的请求,这样实现的 GET 方法自然就不是安全和幂等。
- 可以用 POST 方法实现没有副作用的查询,也可以通过业务请求号把创建接口设计成幂等,但这些都需要业务自己保证。
另外,POST 不会因为参数放在 body 里就自动变得安全。GET、POST 走明文 HTTP 时都可能被窃听,传输保密要靠 HTTPS;只是 URL 参数还容易出现在浏览历史、日志等位置,不适合随便放密码和令牌。
# HTTP的长连接是什么?
HTTP 协议采用的是「请求-应答」的模式,也就是客户端发起了请求,服务端才会返回响应,一来一回这样子。
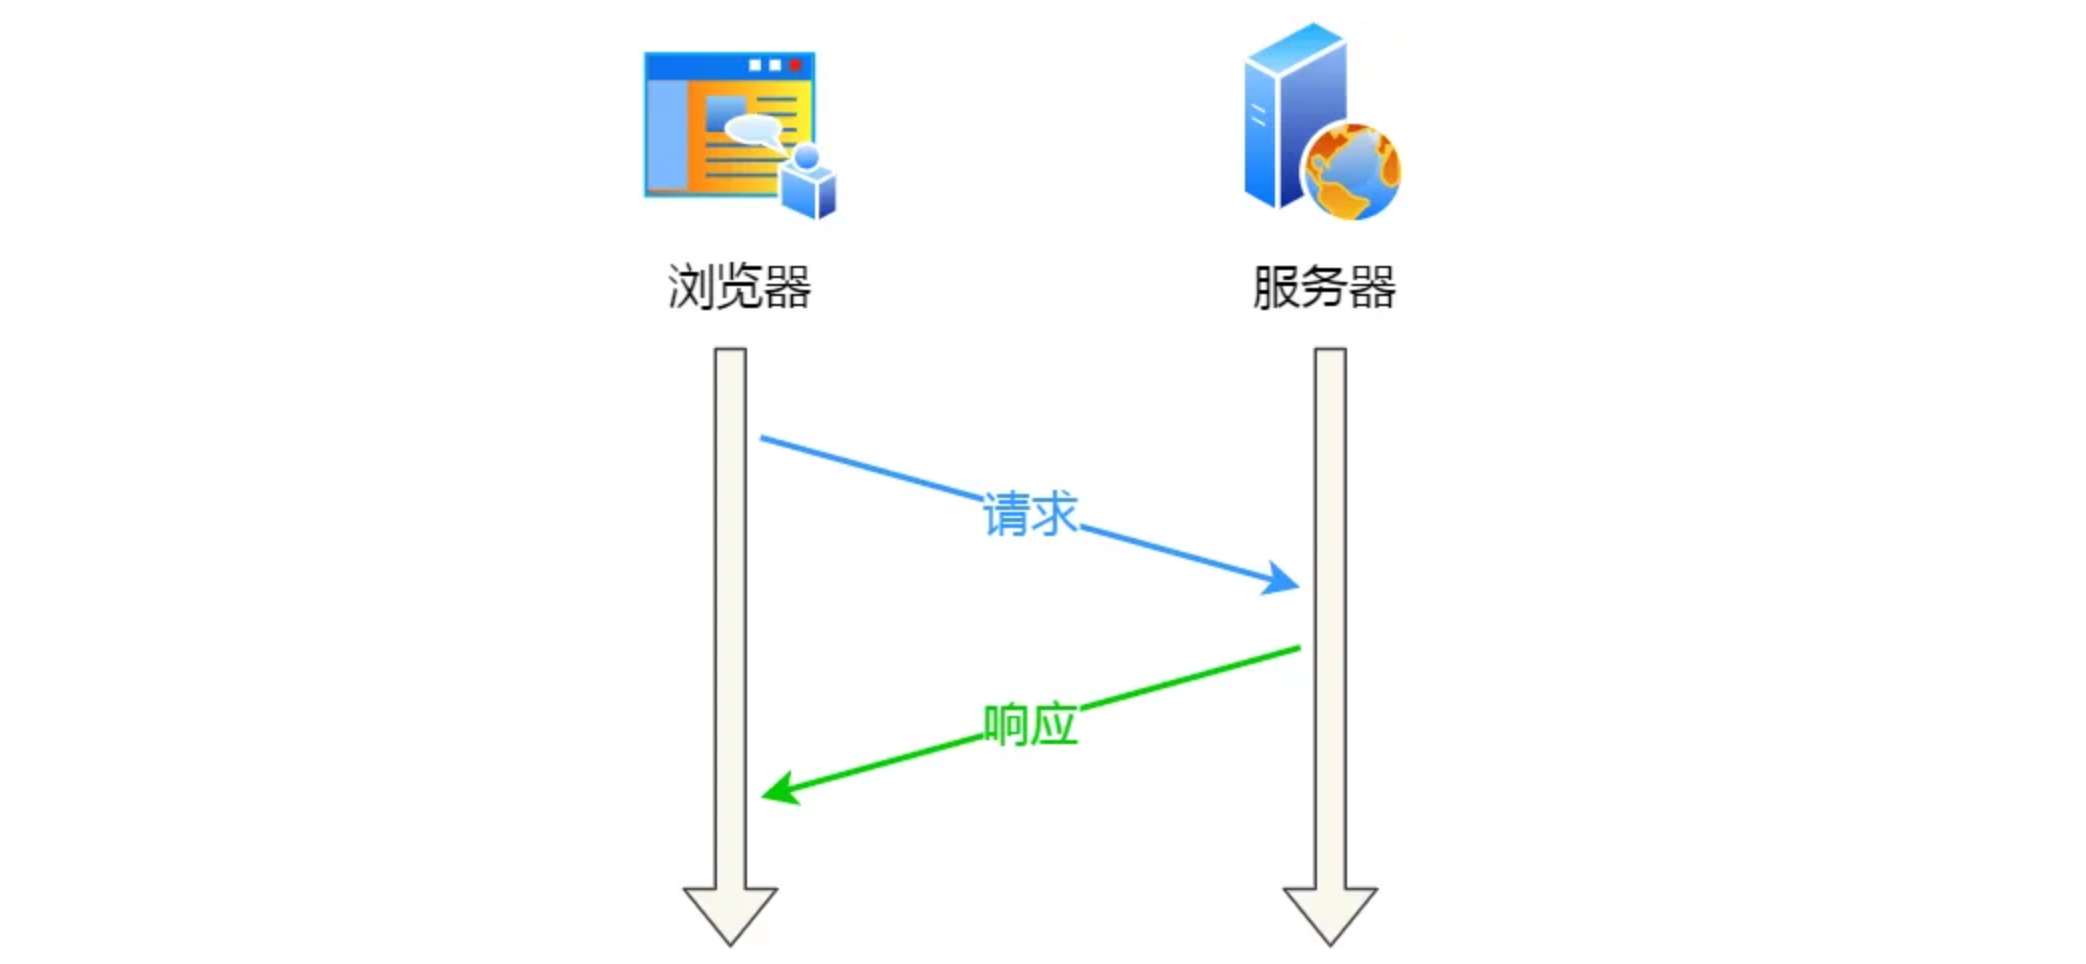
由于 HTTP 是基于 TCP 传输协议实现的,客户端与服务端要进行 HTTP 通信前,需要先建立 TCP 连接,然后客户端发送 HTTP 请求,服务端收到后就返回响应,至此「请求-应答」的模式就完成了,随后就会释放 TCP 连接。
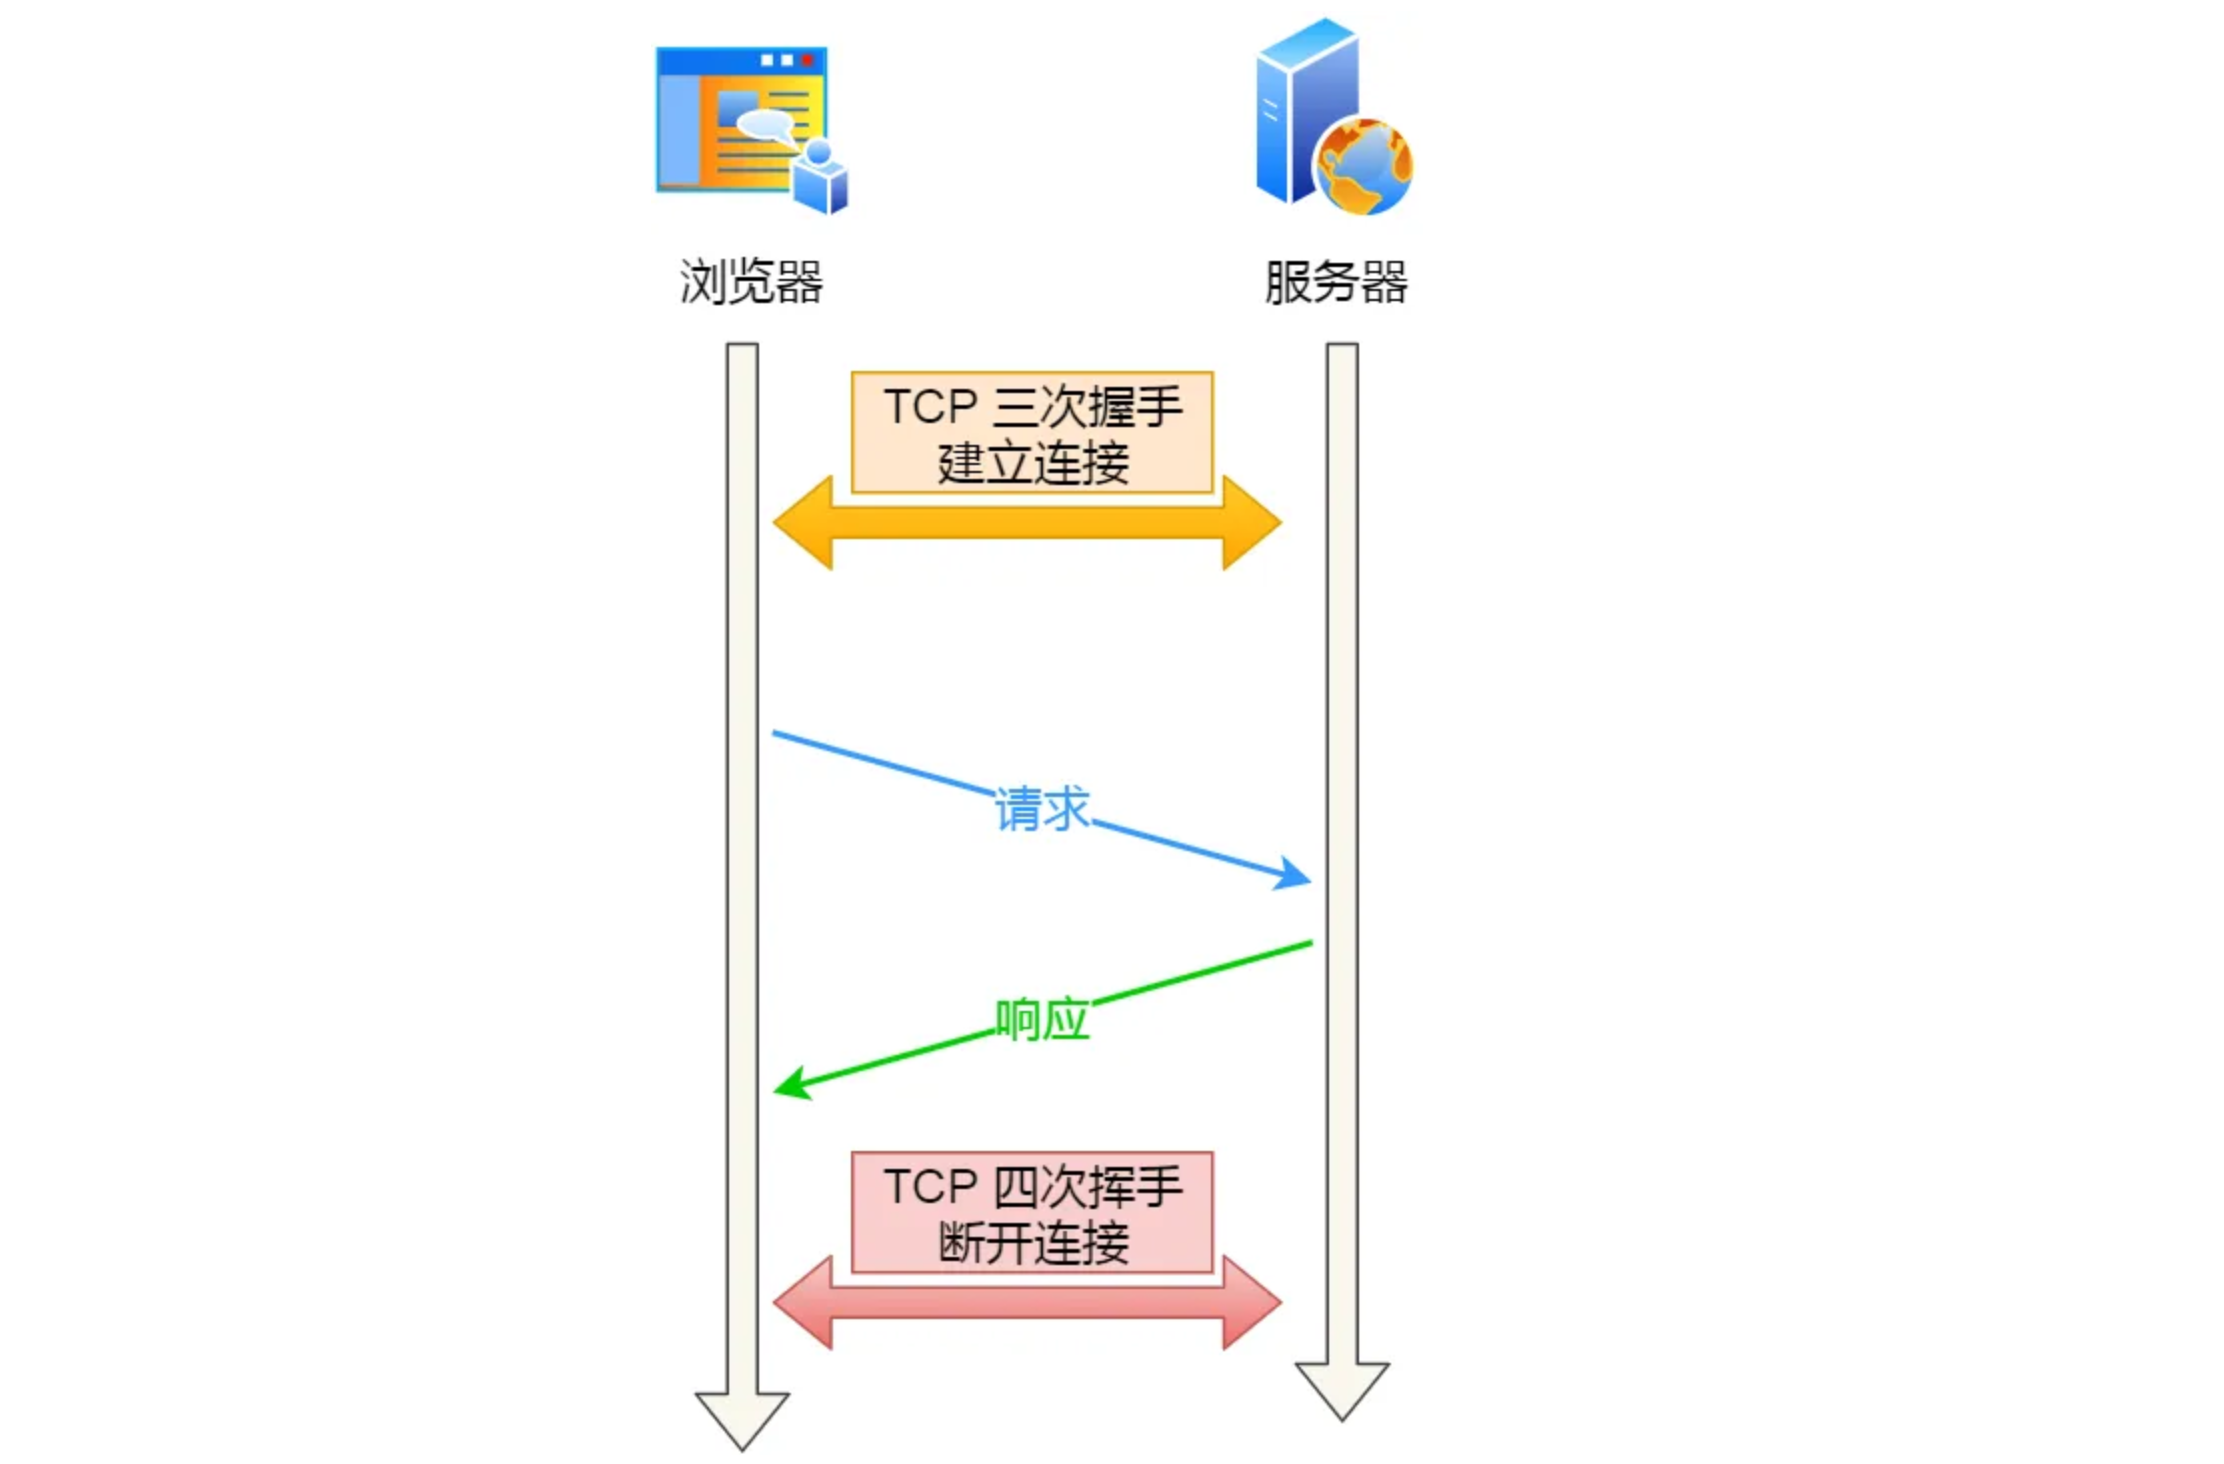
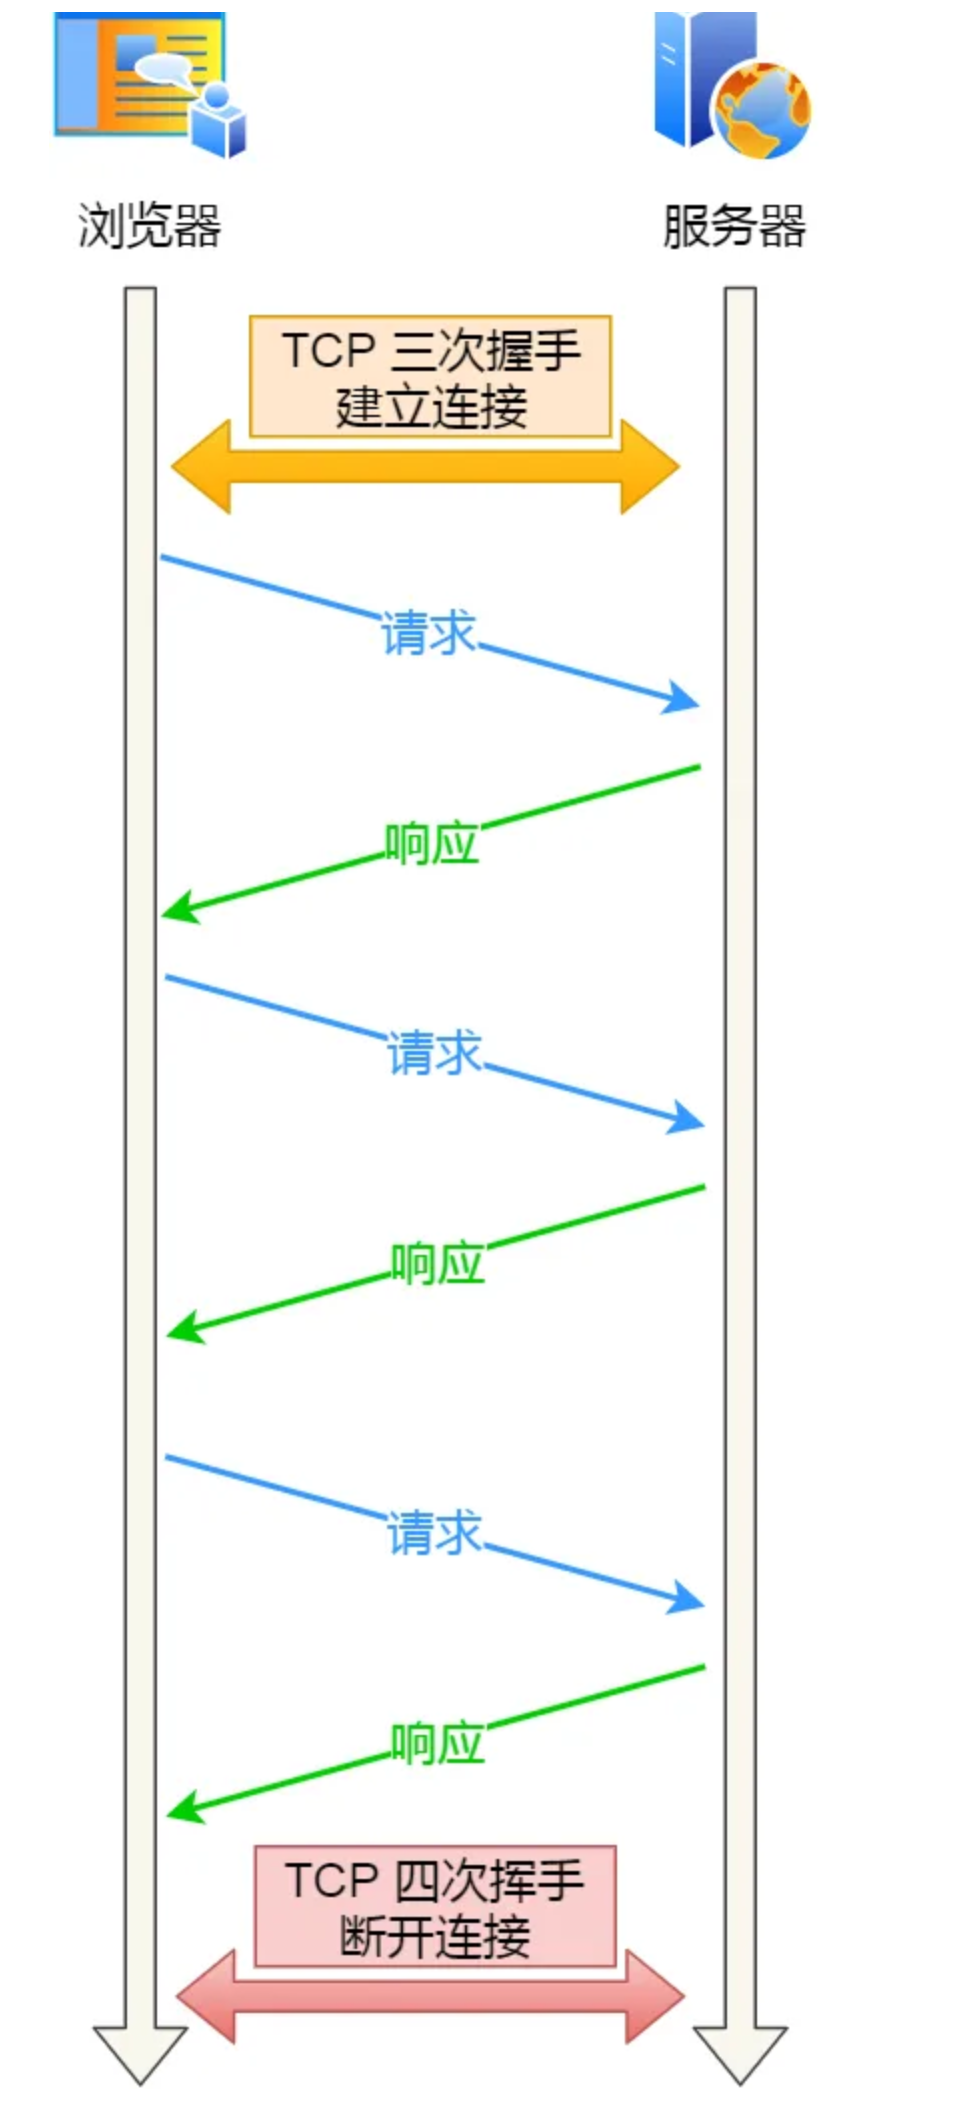
如果每次请求都要经历这样的过程:建立 TCP -> 请求资源 -> 响应资源 -> 释放连接,那么此方式就是 HTTP 短连接,如下图:
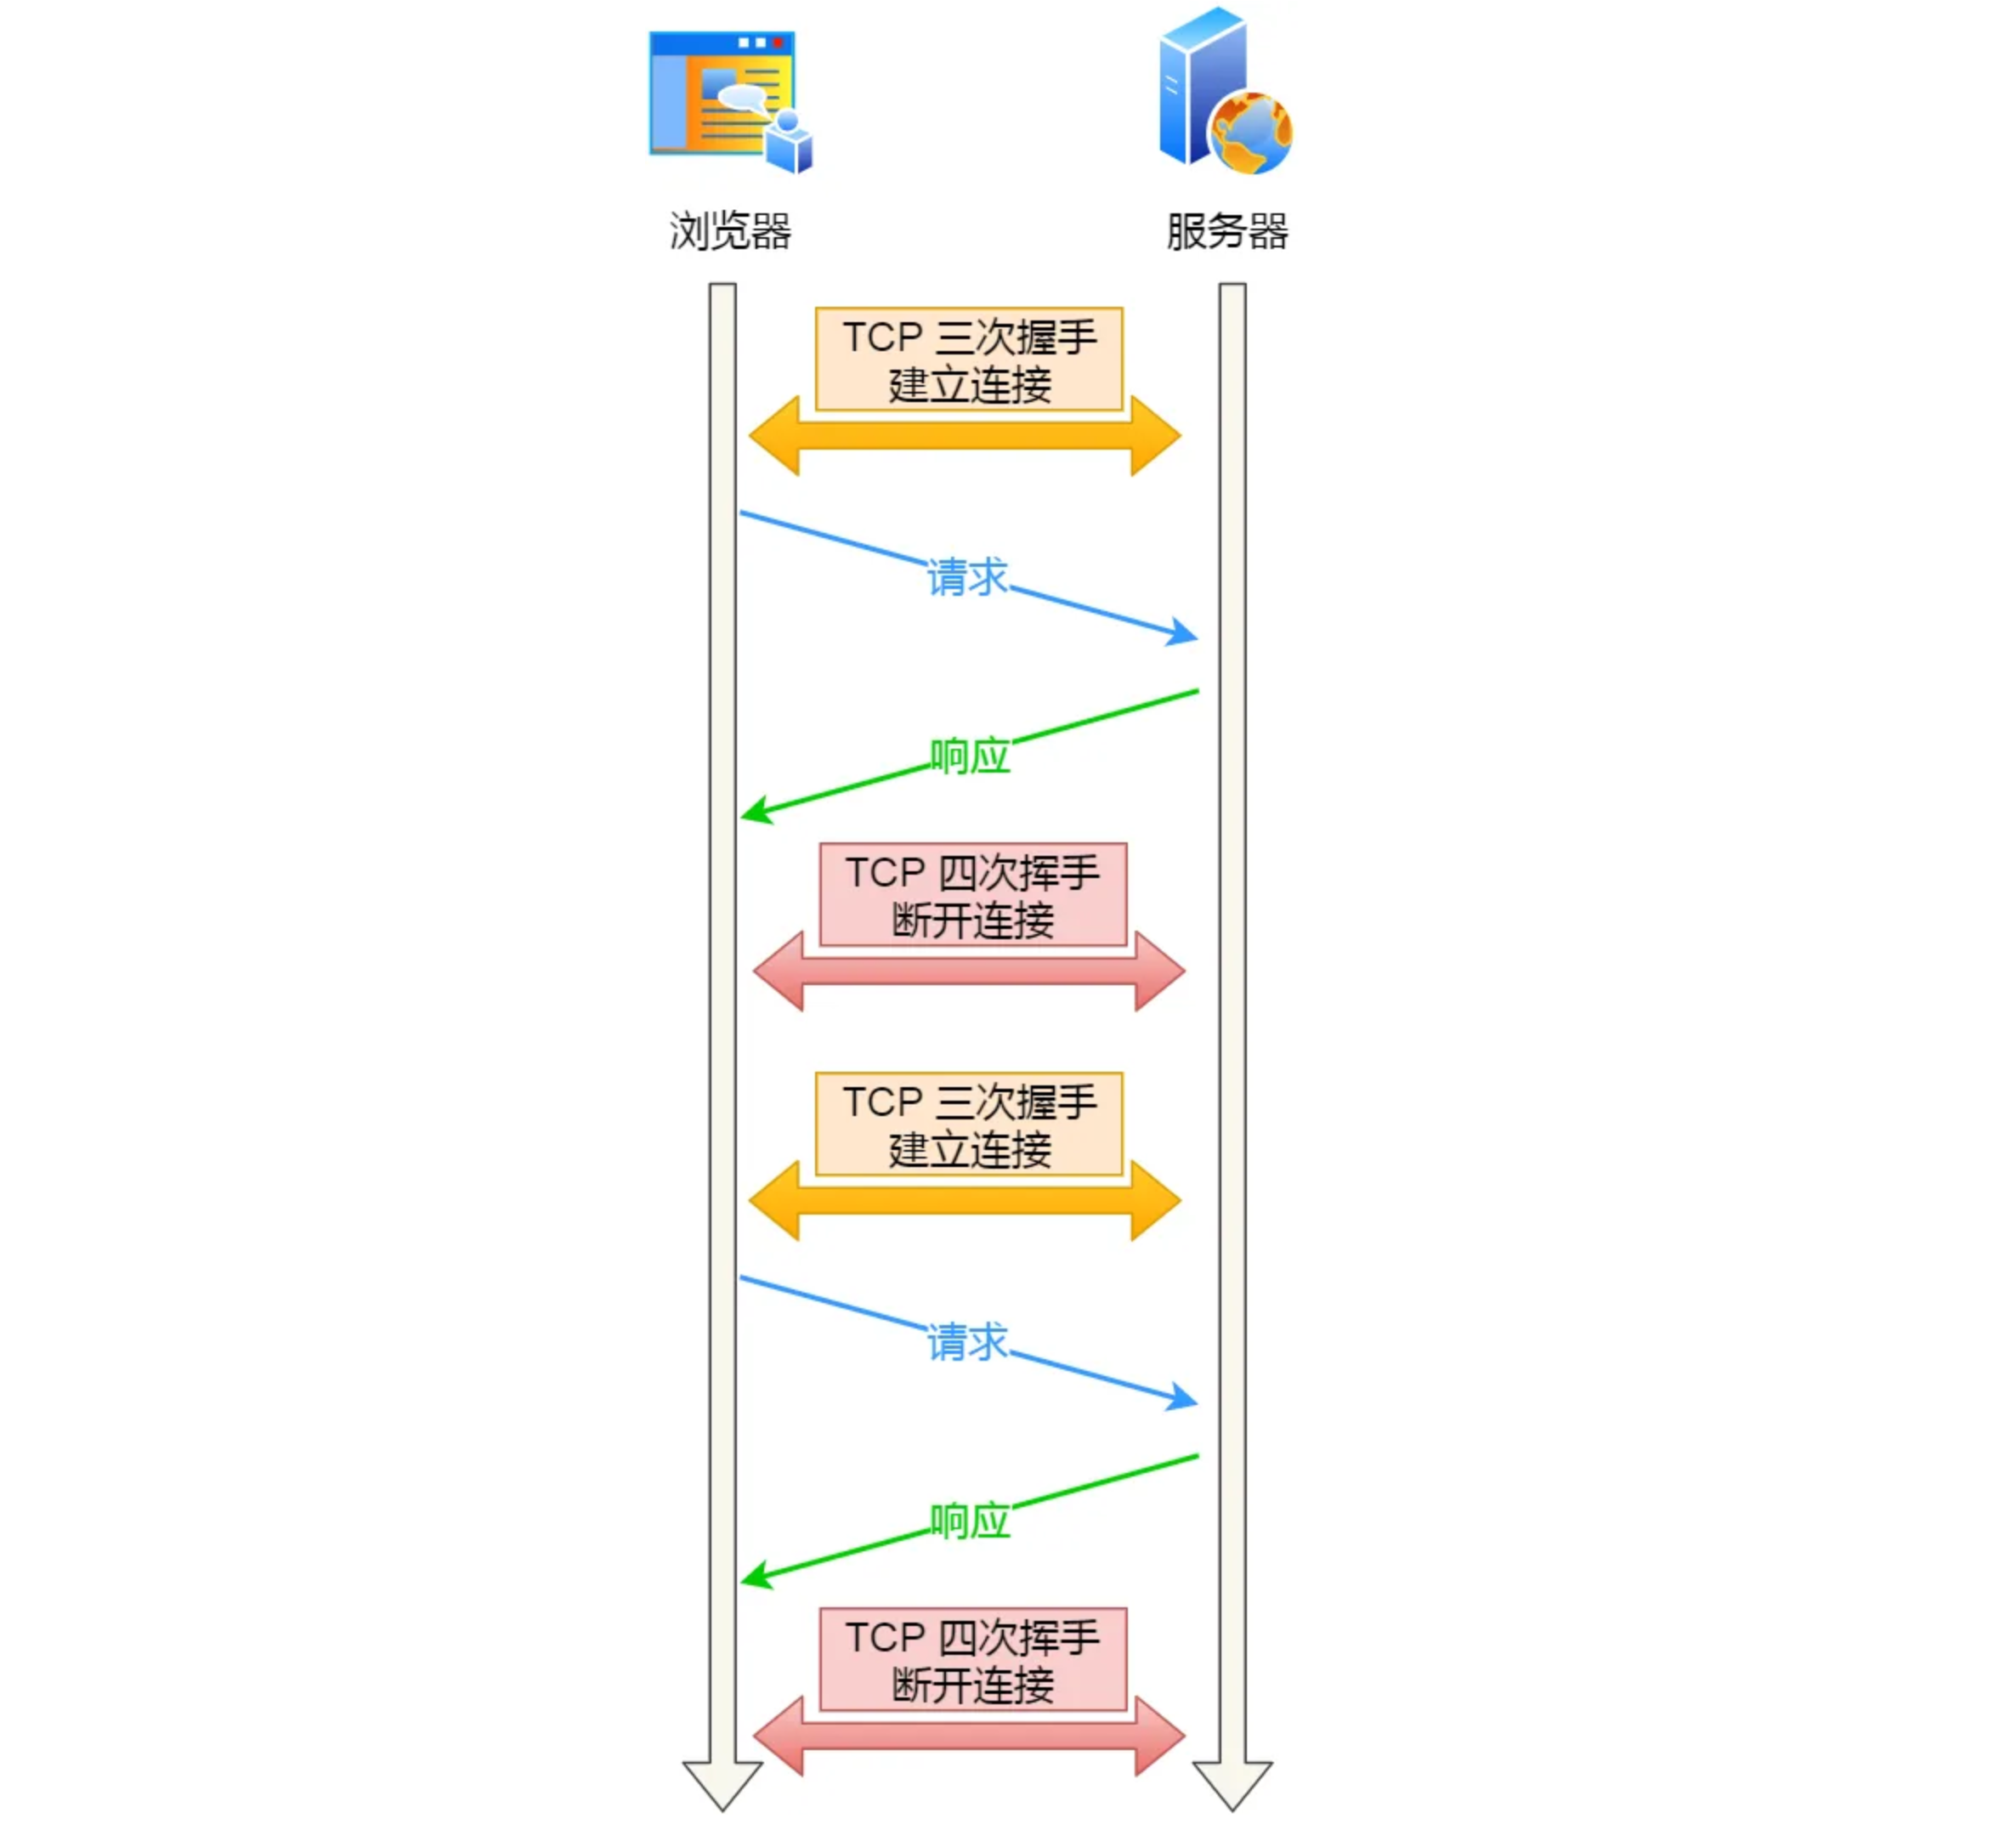
这样实在太累人了,一次连接只能请求一次资源。
能不能在第一个 HTTP 请求完后,先不断开 TCP 连接,让后续的 HTTP 请求继续使用此连接?
当然可以,HTTP 的 Keep-Alive 就是实现了这个功能,可以使用同一个 TCP 连接来发送和接收多个 HTTP 请求/应答,避免了连接建立和释放的开销,这个方法称为 HTTP 长连接。
HTTP 长连接允许在一次请求结束后继续复用连接,但客户端、服务端或者中间代理都可能因为空闲超时、请求数量限制等原因关闭连接。
# HTTP Keep-Alive 和 TCP Keepalive 有什么区别?
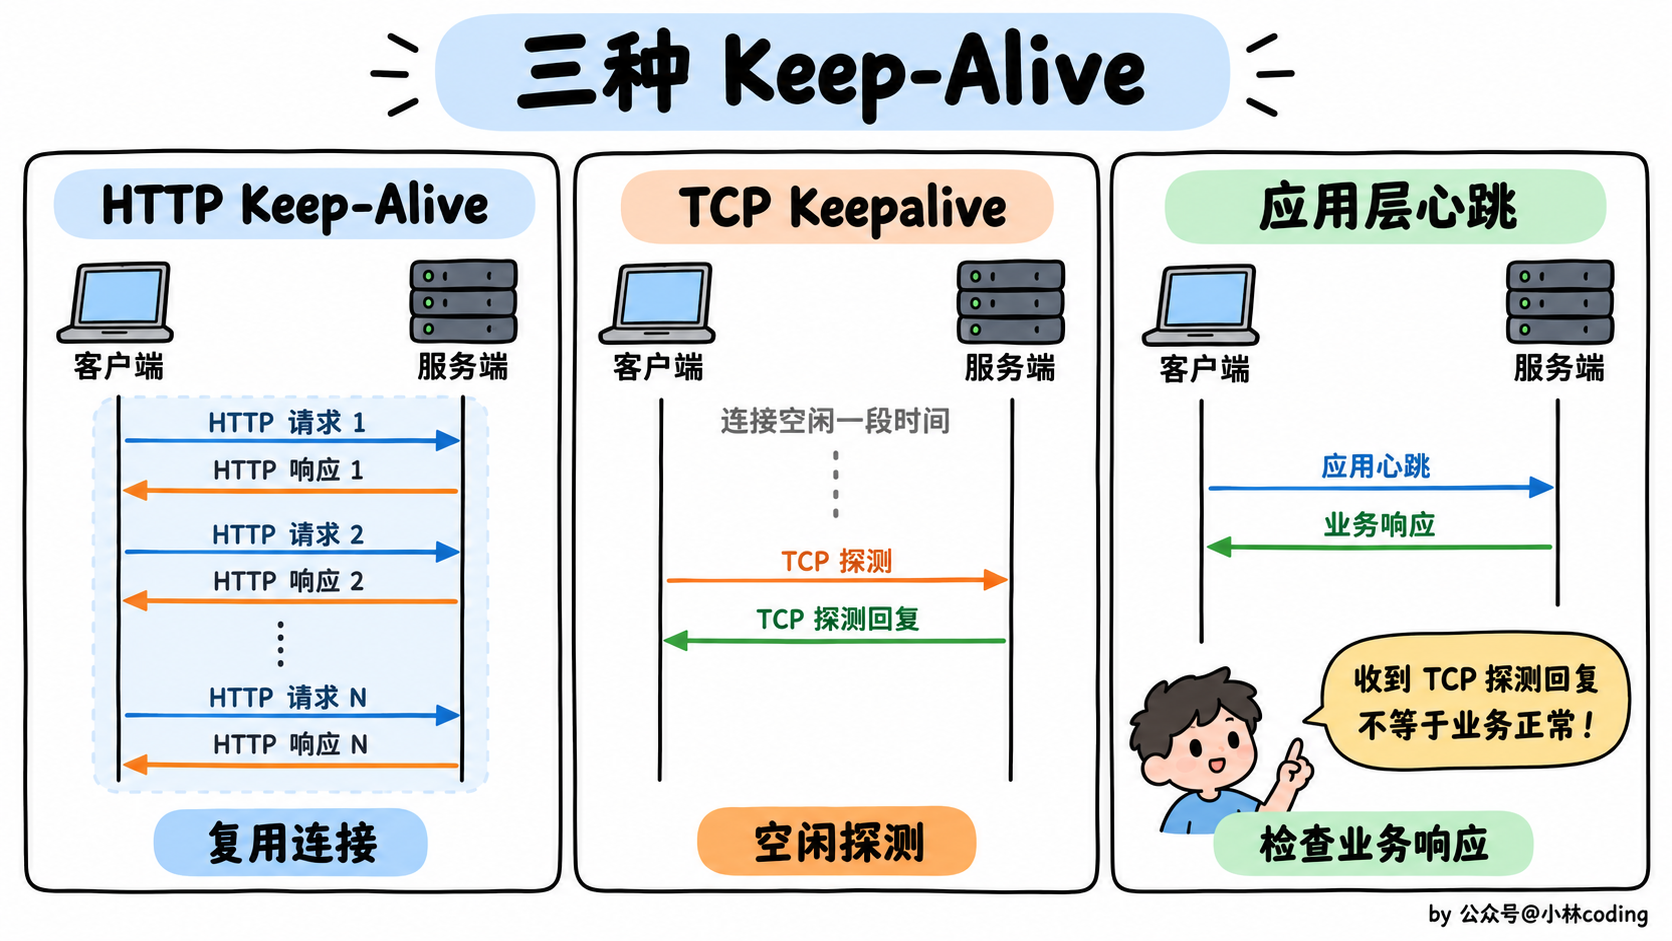
名字很像,但它们解决的问题不一样。
- HTTP Keep-Alive:解决连接复用的问题,让多个 HTTP 请求使用同一个连接,减少反复建立和关闭连接的开销。HTTP/1.1 默认使用持久连接。
- TCP Keepalive:解决空闲连接的存活探测问题。如果连接长时间没有数据交互,内核可以发送探测报文,判断对端是否还能响应,需要通过
SO_KEEPALIVE等选项开启。
举个例子,一个 HTTP 长连接完全可以没有开启 TCP Keepalive;反过来,一个数据库的 TCP 连接也可以开启 TCP Keepalive,它和 HTTP 没有关系。
还有一点,TCP 探测能收到回复,只能说明对端的 TCP 协议栈还能响应,不代表业务线程还能正常处理请求。如果要检测业务是否正常,通常还需要应用层心跳和请求超时。
# HTTP默认的端口是什么?
http 是 80,https 默认是 443。
# HTTP1.1怎么对请求做拆包,具体来说怎么拆的?
HTTP/1.1 通常跑在 TCP 上,而 TCP 是字节流,不会帮应用程序保留消息边界。所以一次 read 不一定能读到一个完整请求,也可能同时读到多个请求的一部分。
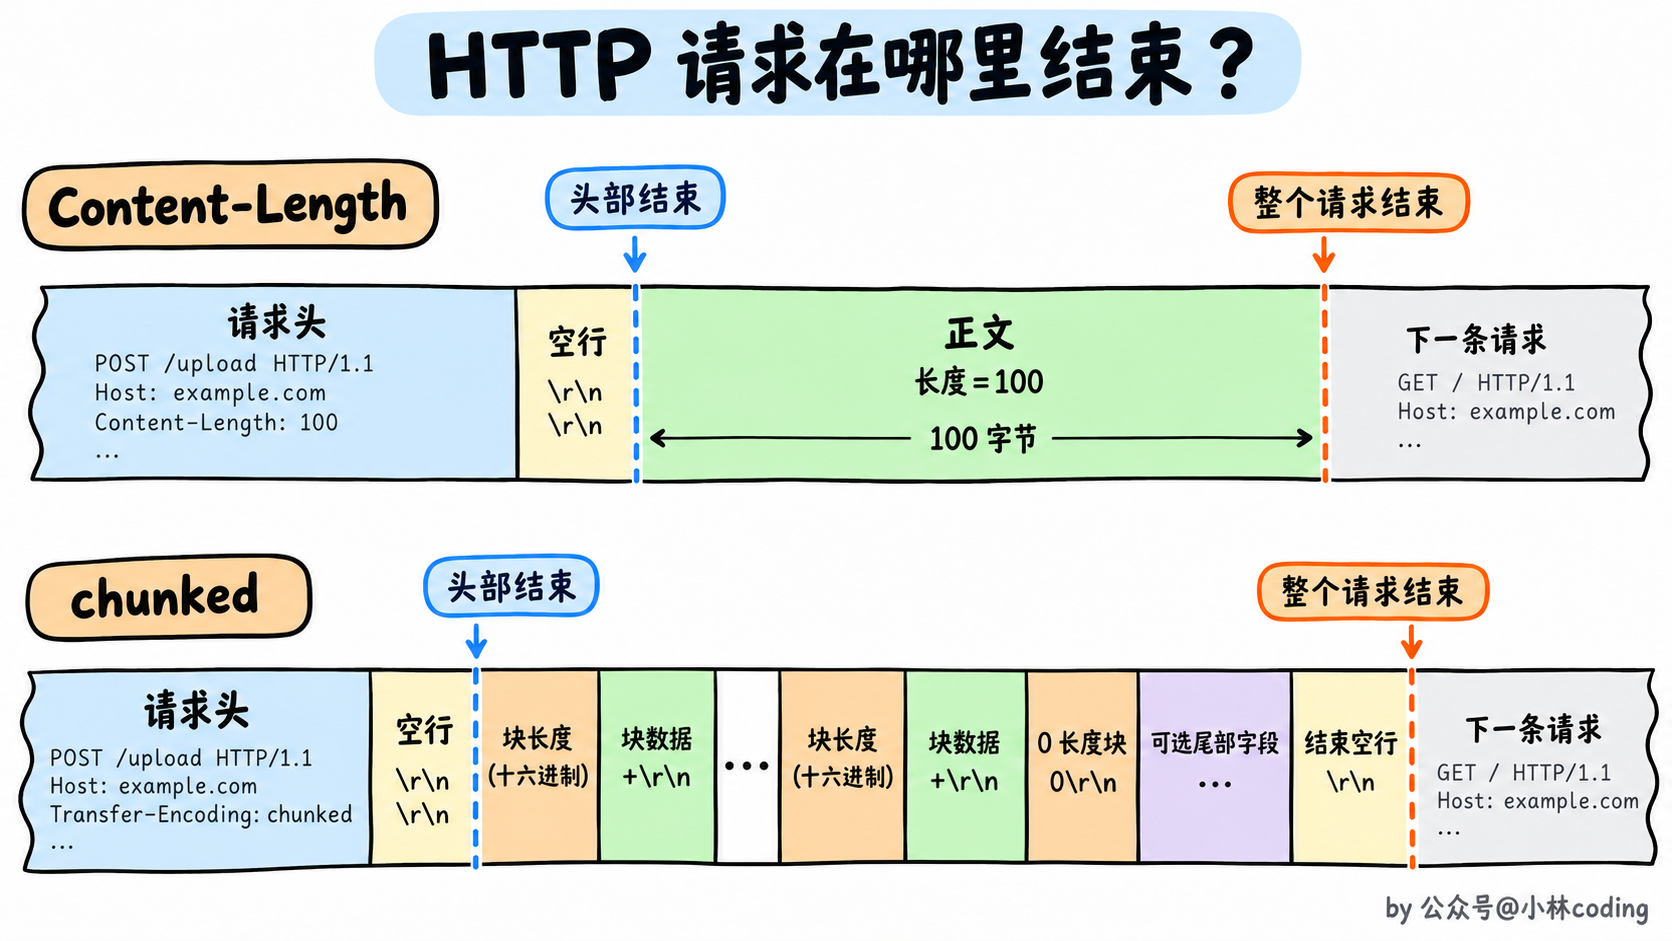
那 HTTP 怎么知道一个请求在哪里结束呢?
首先,用 \r\n\r\n 找到请求头的结束位置,再根据头部字段判断请求体的边界:
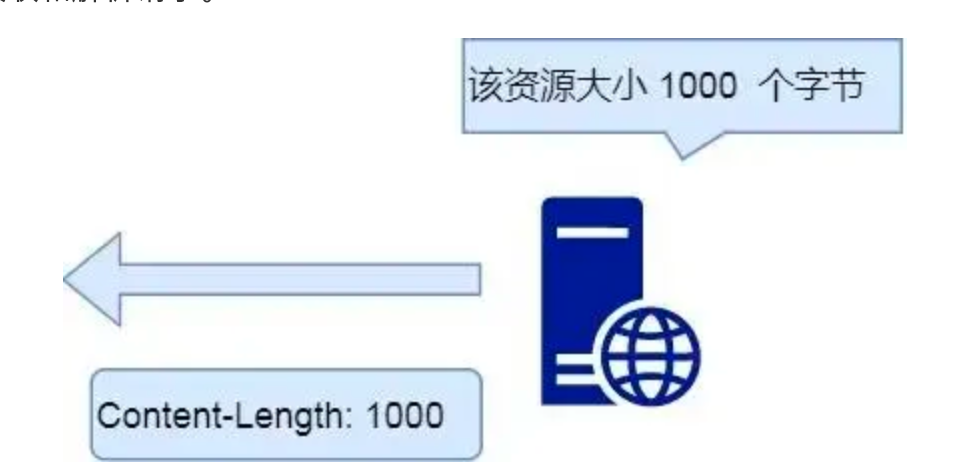
- Content-Length:声明请求体的字节数。比如值为 100,就继续读取 100 个字节,才算读完请求体。
- Transfer-Encoding: chunked:请求体分成多个块,每块先写十六进制的长度,再写数据。读到大小为 0 的最后一个块,并处理完可选的尾部字段,才算结束。
- 如果请求既没有 Transfer-Encoding,也没有 Content-Length,那么按 HTTP/1.1 的规则,这个请求没有请求体。
响应还要结合状态码和请求方法来判断,比如 HEAD 的响应、204 和 304 都没有响应体。有些响应也可以靠关闭连接表示结束,但这样就不能继续复用这条连接了。
**Content-Length 解决的是报文边界问题,不负责保证网络可靠传输。**如果连接中断,实际收到的正文不足声明长度,应用仍然要把报文当作不完整来处理。
# http 断点重传是什么?
断点续传就是下载中断之后,接着上次的位置下载,不用把整个文件重新下载一遍。HTTP 可以通过 Range 请求来实现。
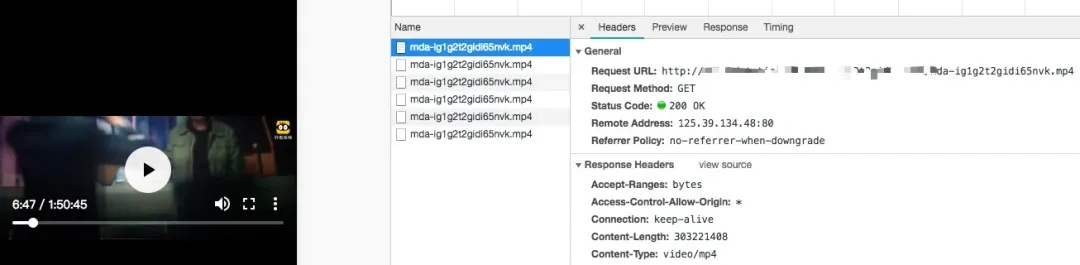
举个例子,一个文件大小为 1048576 字节,也就是 1 MiB,客户端下载了前 524288 字节之后断网了。
网络恢复后,客户端可以发送:
Range: bytes=524288-
如果服务端支持范围请求,就返回 206 Partial Content,响应头里可以带上:
Content-Range: bytes 524288-1048575/1048576
Content-Length: 524288
注意,字节位置从 0 开始,结束位置是包含在范围里的,所以剩余长度是 1048575 - 524288 + 1。
几个相关字段的作用是:
- Range:客户端指定要下载的字节范围。
- Content-Range:服务端说明这次返回的范围和资源总大小。
- Accept-Ranges: bytes:服务端表示支持按字节请求,不过客户端也可以在没看到这个字段时尝试发送 Range。
- Content-Length:说明本次响应体的长度,并不是整个文件的长度。具体报文也可能使用其他方式确定响应体边界。
如果请求范围无法满足,服务端可以返回 416;如果服务端忽略 Range,返回了 200 和完整文件,客户端就不能直接把它追加到已下载内容后面。
还要考虑一个问题:下载期间文件变了怎么办?可以用 If-Range 携带上次的强 ETag,或者符合要求的 Last-Modified 时间。资源没变就继续返回部分内容,变了就返回完整资源,避免把两个版本的文件拼到一起。
# HTTP为什么不安全?
HTTP 由于是明文传输,所以安全上存在以下三个风险:
- 窃听风险,比如通信链路上可以获取通信内容,用户号容易没。
- 篡改风险,比如强制植入垃圾广告,视觉污染,用户眼容易瞎。
- 冒充风险,比如冒充淘宝网站,用户钱容易没。
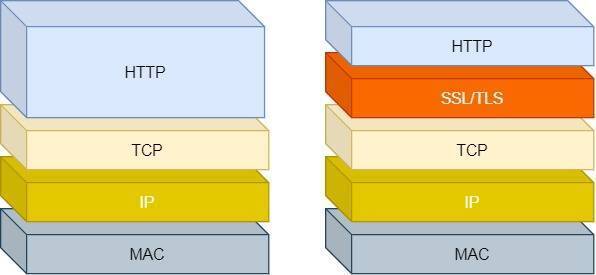
HTTPS 在 HTTP 与 TCP 层之间加入了 SSL/TLS 协议,可以很好的解决了上述的风险:
- 信息加密:交互信息无法被窃取,但你的号会因为「自身忘记」账号而没。
- 校验机制:无法篡改通信内容,篡改了就不能正常显示,但百度「竞价排名」依然可以搜索垃圾广告。
- 身份证书:证明淘宝是真的淘宝网,但你的钱还是会因为「剁手」而没。
# HTTP和HTTPS 的区别?
区别主要有以下四点:
- HTTP 是超文本传输协议,信息是明文传输,存在安全风险的问题。HTTPS 则解决 HTTP 不安全的缺陷,通过 TLS 安全协议保护 HTTP 通信,使得报文能够加密传输。
- 以基于 TCP 的 HTTP/1.1、HTTP/2 为例,HTTPS 在 TCP 建连后还要进行 TLS 握手,协商密钥并验证身份。HTTP/3 则通过基于 UDP 的 QUIC 集成 TLS 1.3 来提供安全连接。
- 两者的默认端口不一样,HTTP 默认端口号是 80,HTTPS 默认端口号是 443。
- 公开网站的 HTTPS 通常使用由可信 CA 签发的数字证书来验证服务器身份,证书也可以免费申请。自签名证书也能加密通信,但客户端需要另行建立信任。
# HTTPS握手过程说一下
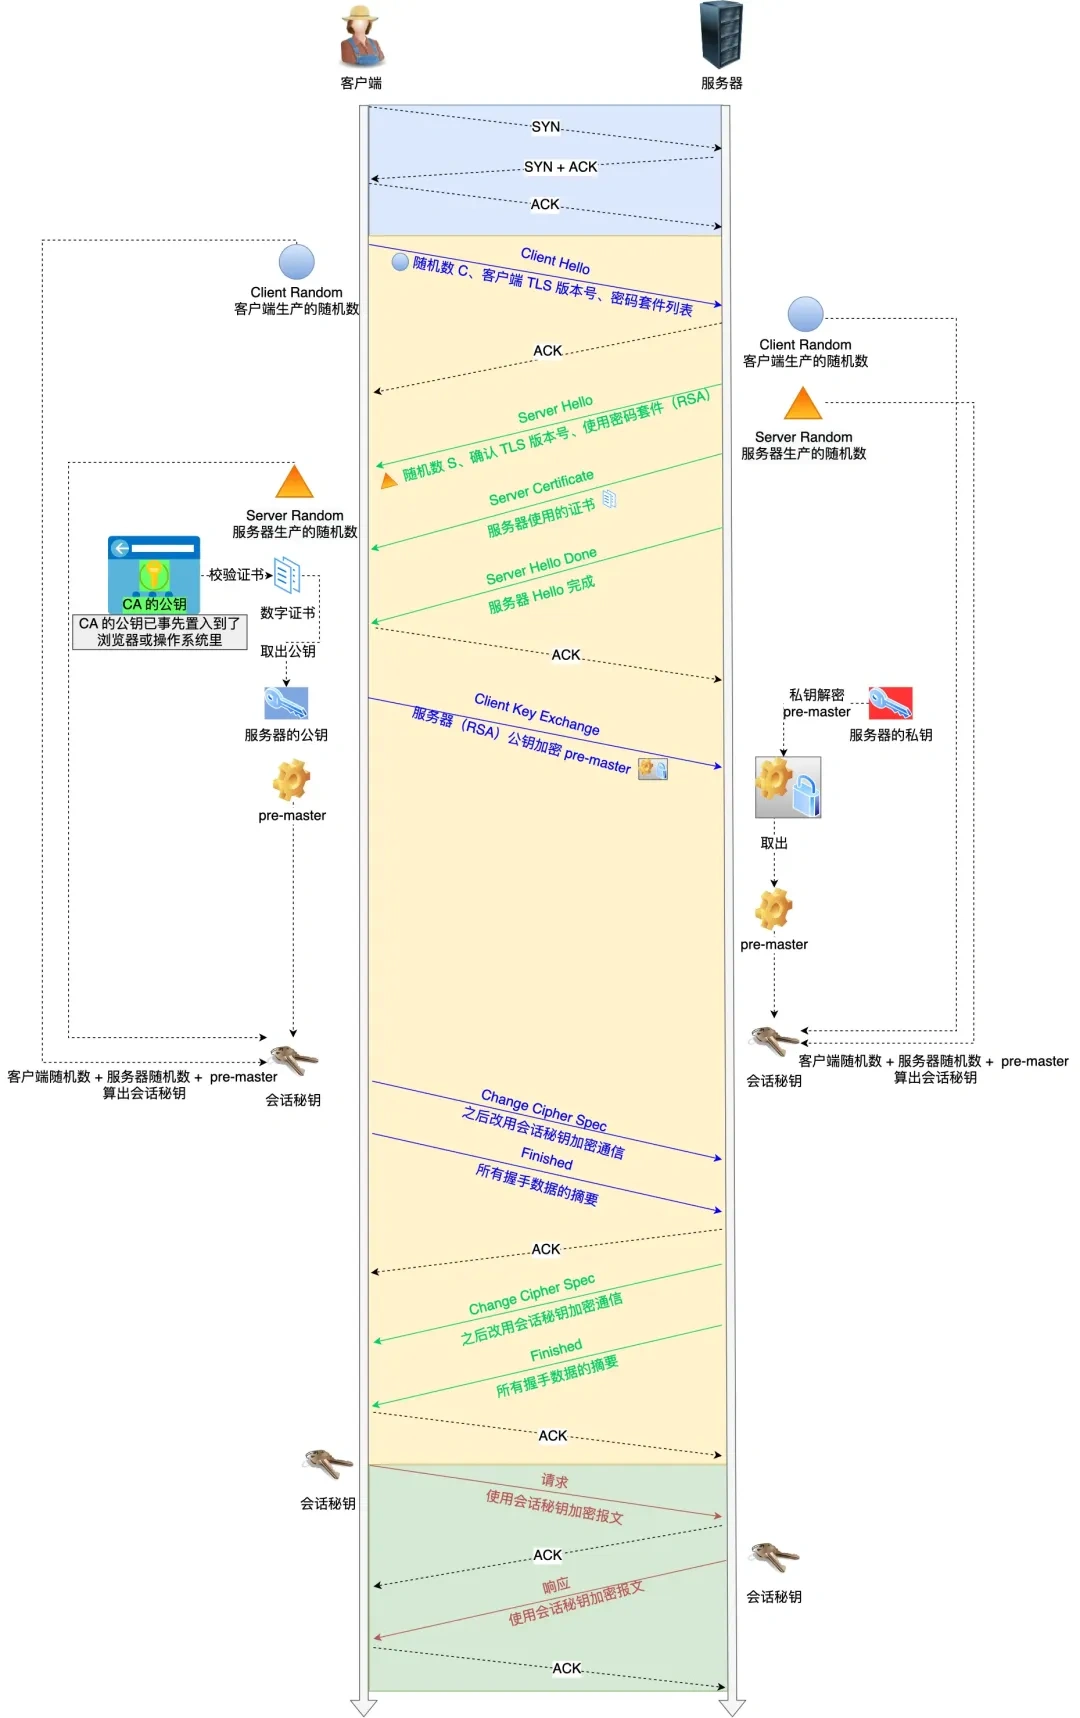
HTTPS 握手要完成三件事:协商通信参数、验证服务器身份、生成双方使用的会话密钥。不过具体过程要看 TLS 版本和密钥交换方式,不能把所有 HTTPS 都说成「四次握手」。
先结合下面的抓包图,说明 TLS 1.2 使用 RSA 密钥交换的过程,再补充 ECDHE 和 TLS 1.3 的区别。
在这个例子里,服务端证书包含公钥、域名、有效期和 CA 的签名等信息,握手时会发给客户端。证书不是只有一把公钥,它还要帮助客户端确认这把公钥属于谁。对应的私钥留在服务端,不会通过网络发送。
在 RSA 密钥协商算法中,客户端会生成随机密钥,并使用服务端的公钥加密后再传给服务端。根据非对称加密算法,公钥加密的消息仅能通过私钥解密,这样服务端解密后,双方就得到了相同的预主密钥,再结合客户端和服务端的随机数派生出后续使用的会话密钥。
我用 Wireshark 工具抓了用 RSA 密钥交换的 TLS 握手过程,你可以从下面看到,一共经历了四次握手:
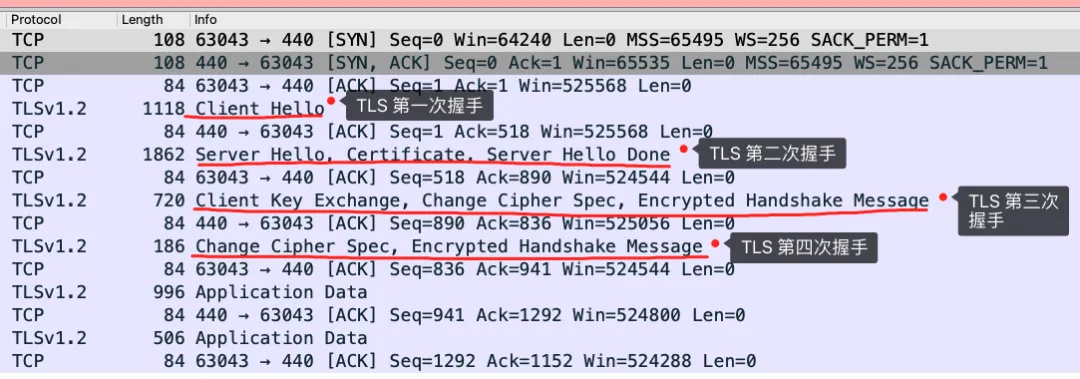
TLS 第一次握手
首先,由客户端向服务器发起加密通信请求,也就是 ClientHello 请求。在这一步,客户端主要向服务器发送以下信息:
- (1)客户端支持的 TLS 协议版本,如 TLS 1.2 版本。
- (2)客户端生成的随机数(Client Random),后面用于生成「会话密钥」的条件之一。
- (3)客户端支持的密码套件列表,如 RSA 加密算法。
TLS 第二次握手
服务器收到客户端请求后,发送 ServerHello、Certificate 等一组握手消息,主要回应以下内容:
- (1)确认 TLS 协议版本,如果浏览器不支持,则关闭加密通信。
- (2)服务器生成的随机数(Server Random),也是后面用于生成「会话密钥」的条件之一。
- (3)选定的密码套件,它规定密钥交换、认证和数据加密等使用的算法。
- (4)服务器的数字证书。
TLS 第三次握手
客户端收到服务器的回应之后,先验证证书链是否能追溯到受信任的 CA,还要检查证书有效期和证书中的域名是否与访问的域名匹配。
如果证书没有问题,客户端会从数字证书中取出服务器的公钥,然后使用它加密报文,向服务器发送如下信息:
- (1)一个随机数(Pre-Master Secret)。该随机数会被服务器公钥加密。
- (2)加密通信算法改变通知,表示随后的信息都将用「会话密钥」加密通信。
- (3)客户端握手结束通知,表示客户端的握手阶段已经结束。这一项使用协商出的密钥和此前的握手记录计算校验数据,供服务端验证握手内容没有被修改。
上面第一项的随机数是整个握手阶段的第三个随机数,会发给服务端,所以这个随机数客户端和服务端都是一样的。
服务器和客户端有了这三个随机数(Client Random、Server Random、Pre-Master Secret),接着就用双方协商的加密算法,各自计算出本次通信的「会话密钥」。
TLS 第四次握手
服务器收到客户端的第三个随机数(Pre-Master Secret)之后,通过协商的加密算法,计算出本次通信的「会话密钥」。
然后,向客户端发送最后的信息:
- (1)加密通信算法改变通知,表示随后的信息都将用「会话密钥」加密通信。
- (2)服务器握手结束通知,表示服务器的握手阶段已经结束。这一项同样使用密钥和握手记录计算校验数据,供客户端验证。
至此,这个 RSA 密钥交换的 TLS 1.2 握手就结束了,接下来的 HTTP 数据由会话密钥加密保护。
ECDHE 和 TLS 1.3 有什么不同?
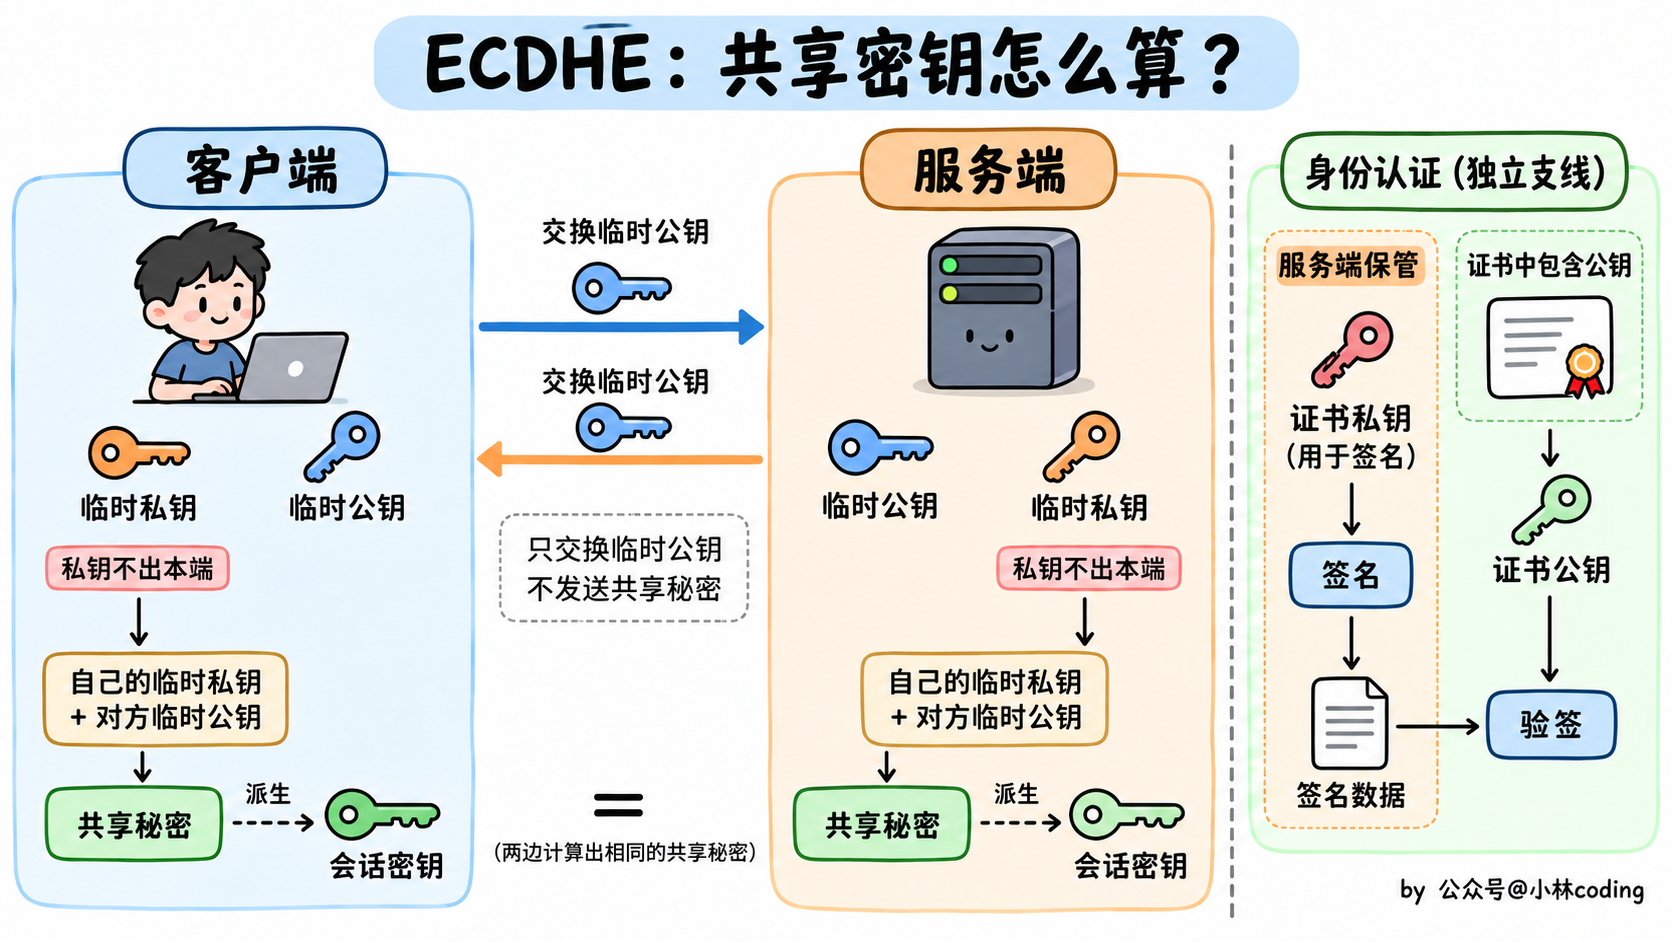
ECDHE 不会把会话密钥用证书公钥加密后发过去。双方交换临时公钥,各自结合自己的临时私钥算出相同的共享秘密,再派生出会话密钥。证书对应的私钥主要用于签名,证明握手的一方确实持有该私钥。
这种方式支持前向安全:即使将来服务器的证书私钥泄露,只要之前的临时私钥已经销毁,攻击者也不能仅凭录下来的流量还原过去的会话密钥。
TLS 1.3 移除了 RSA 密钥交换。以常见的、基于证书和 ECDHE 的完整握手为例:
- 客户端发送 ClientHello,带上支持的版本、密码套件和临时公钥,也就是 key share。
- 服务端返回 ServerHello 和自己的 key share,双方由此计算握手密钥。服务端随后发送加密保护的证书、证书签名和 Finished 消息。
- 客户端验证证书、签名和 Finished,再发送自己的 Finished,完成握手。
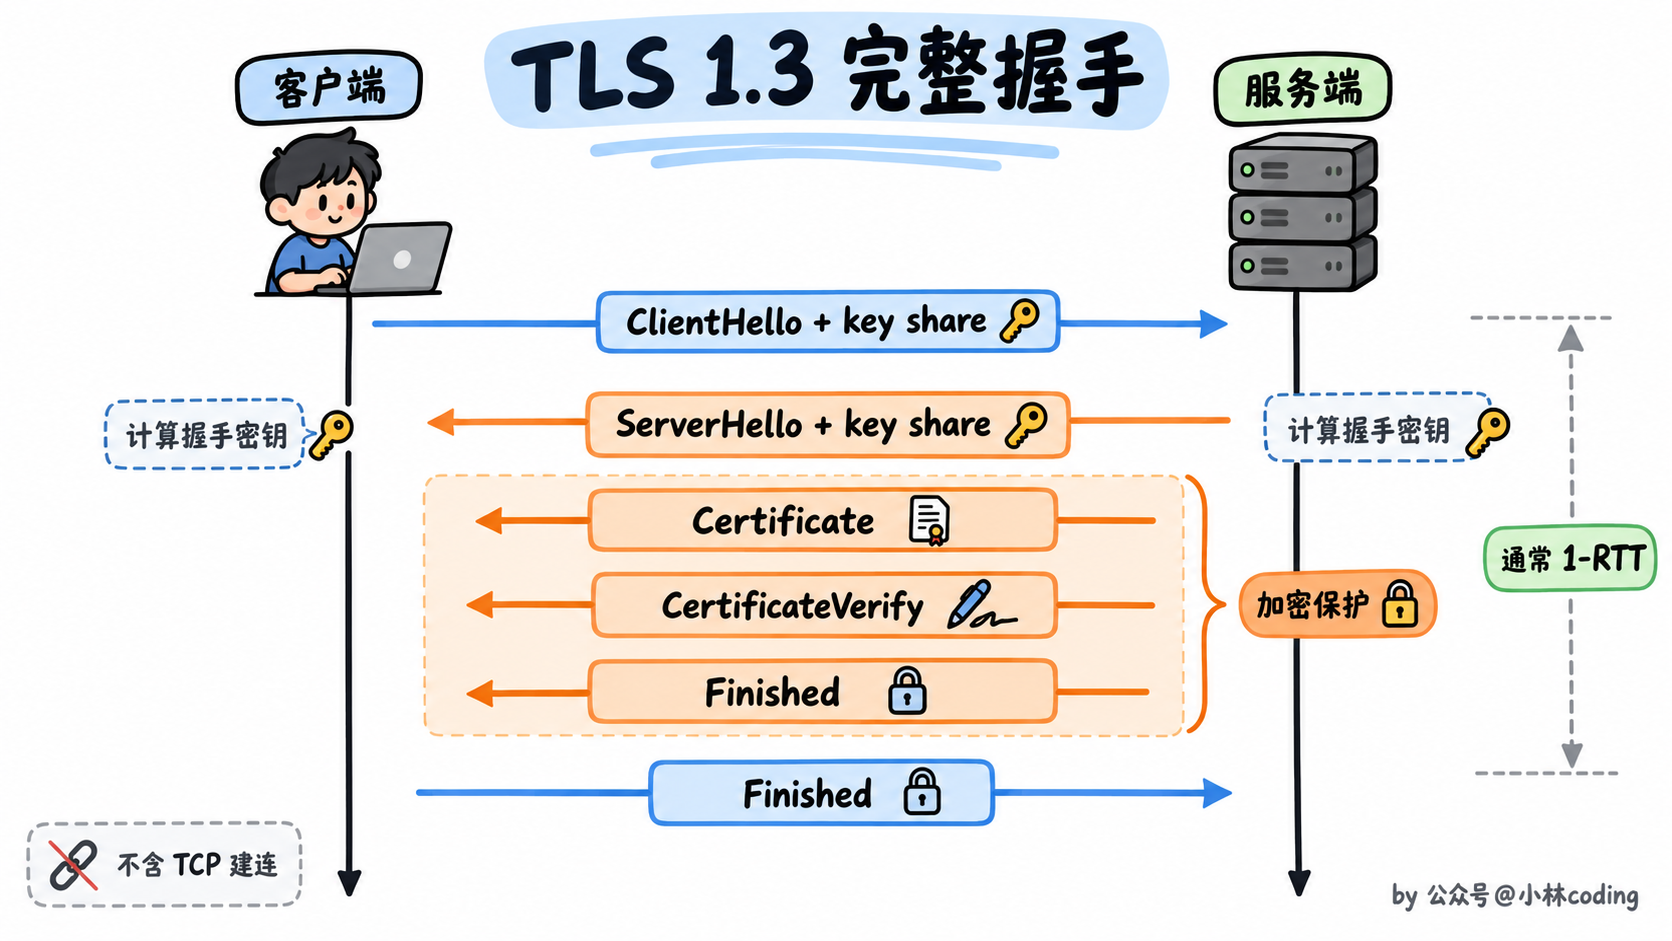
在不需要额外协商往返的情况下,TLS 1.3 完整握手是 1-RTT,比典型的 TLS 1.2 完整握手少一次往返。会话恢复还可以使用 PSK,符合条件时支持 0-RTT 早期数据,不过这些数据有重放风险,不能把它理解成所有业务都可以安全地零延迟发送。
# HTTPS是如何防范中间人的攻击?
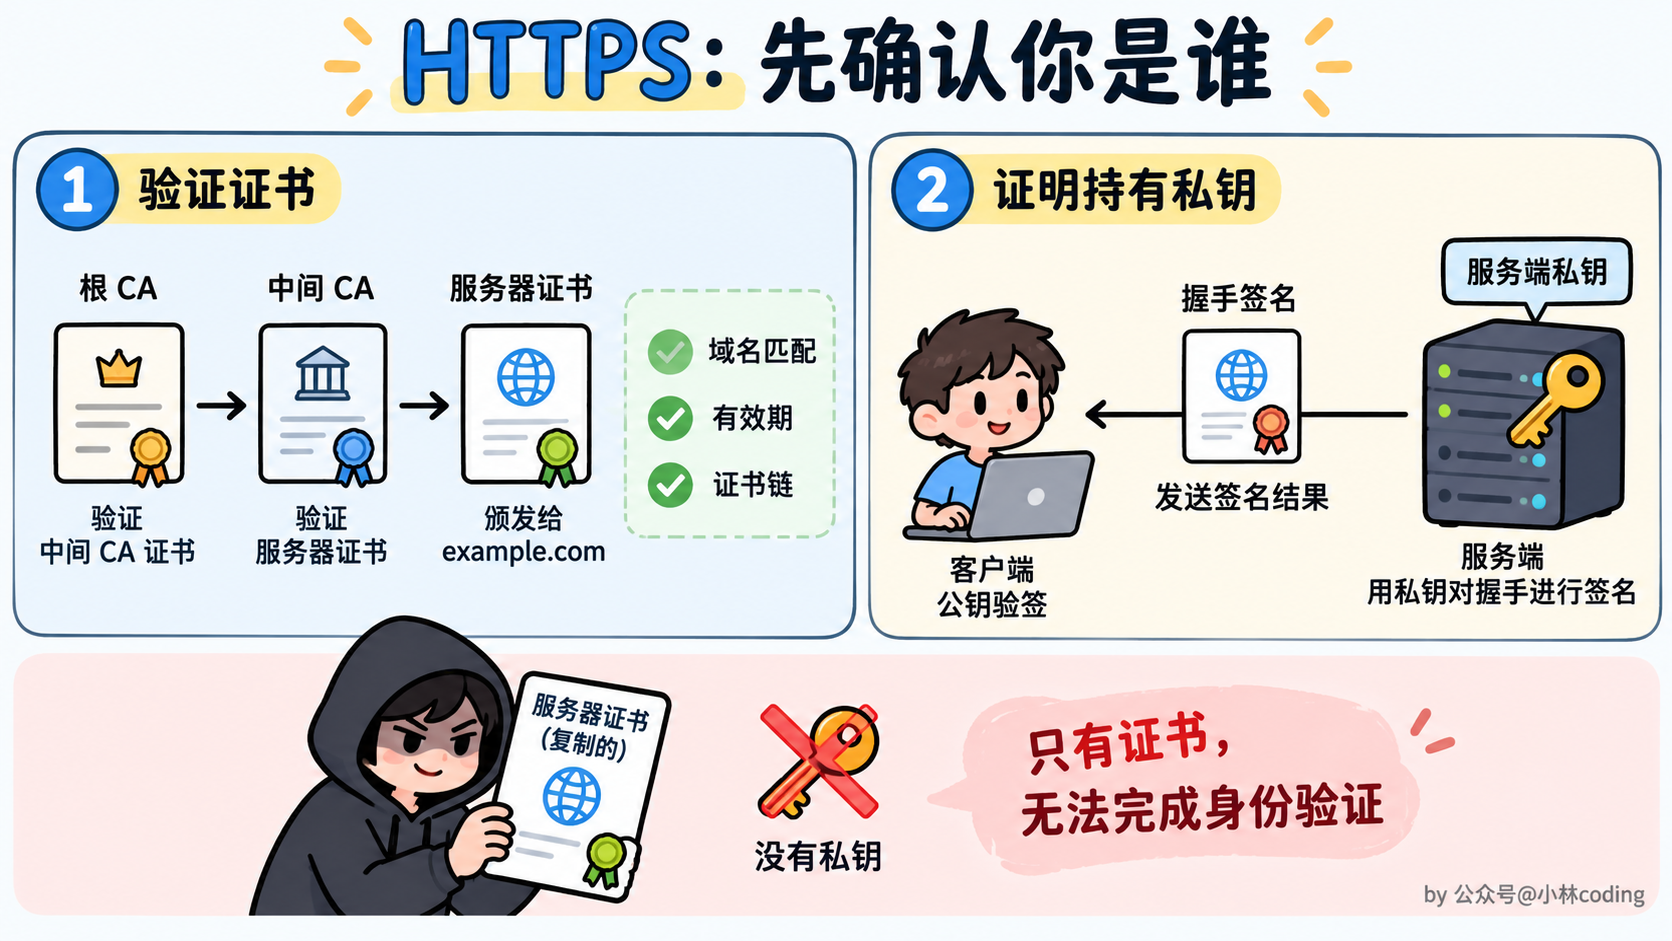
关键不只是加密,而是确认正在和谁通信,再保护通信内容。
假设攻击者在中间拦截流量,想冒充服务器,他也可以自己生成一对公私钥。如果客户端不验证这把公钥属于谁,就可能把数据加密给攻击者。所以,只说「用了非对称加密」还不够。
HTTPS 主要通过下面几个机制来防范:
- 证书校验:客户端验证证书链、有效期和域名,确认公钥绑定的是要访问的服务器,而不是攻击者的服务器。
- 证明私钥的持有:在 ECDHE 等握手中,服务端使用证书对应的私钥对握手内容签名,客户端用公钥验证。攻击者即使拿到了公开的证书,没有私钥也不能完成相应的身份认证。
- 握手完整性校验:通过 Finished 消息验证握手记录,防止协商参数等内容被中途修改。
- 数据加密和完整性保护:后续用协商出的对称密钥保护 HTTP 数据,攻击者难以读出内容,篡改的数据也无法通过校验。
这里有个前提:客户端要正确验证证书。如果用户忽略证书错误,或者客户端关闭了证书校验,那么这些身份保证就可能失效。
# Http1.1和2.0的区别是什么?
HTTP/2 保留了 HTTP 的方法、状态码等语义,主要改进的是报文传输方式:
- 头部压缩:使用 HPACK,结合静态表、动态表和编码来减少重复头字段的传输。比如多个请求都带着相同的头部,就不必每次都完整传一遍。
- 二进制分帧:把头部和数据拆成不同类型的帧,每个帧都有明确的长度和类型,方便解析和复用。HTTP/1.1 本身在网络上也是字节,区别不在于「计算机是否认识文本」,而在于报文组织方式不同。
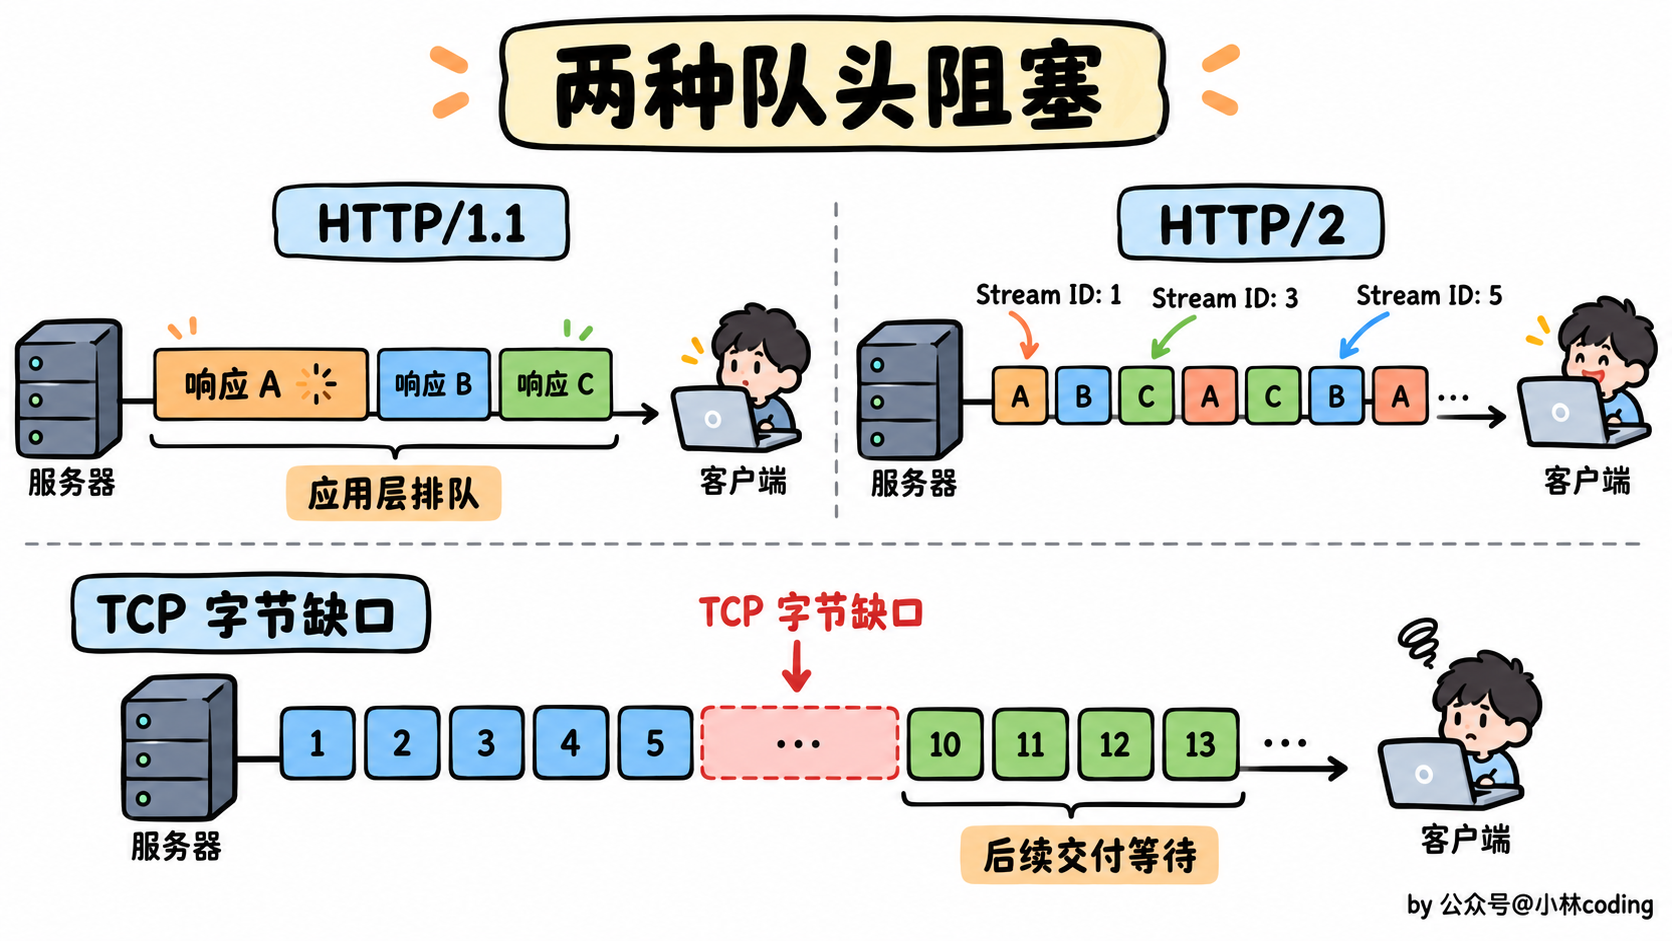
- 多路复用:每个请求和响应属于一个 Stream,帧携带 Stream ID,因此多个请求可以在同一条 TCP 连接上交错传输,不必等待前一个响应完整发完。
- 流量控制:可以在连接和 Stream 两个层面限制数据发送,避免接收方来不及处理。
HTTP/2 还设计了服务器推送功能,但主流浏览器对它的支持有限,实际面试更应该把多路复用和队头阻塞讲清楚。
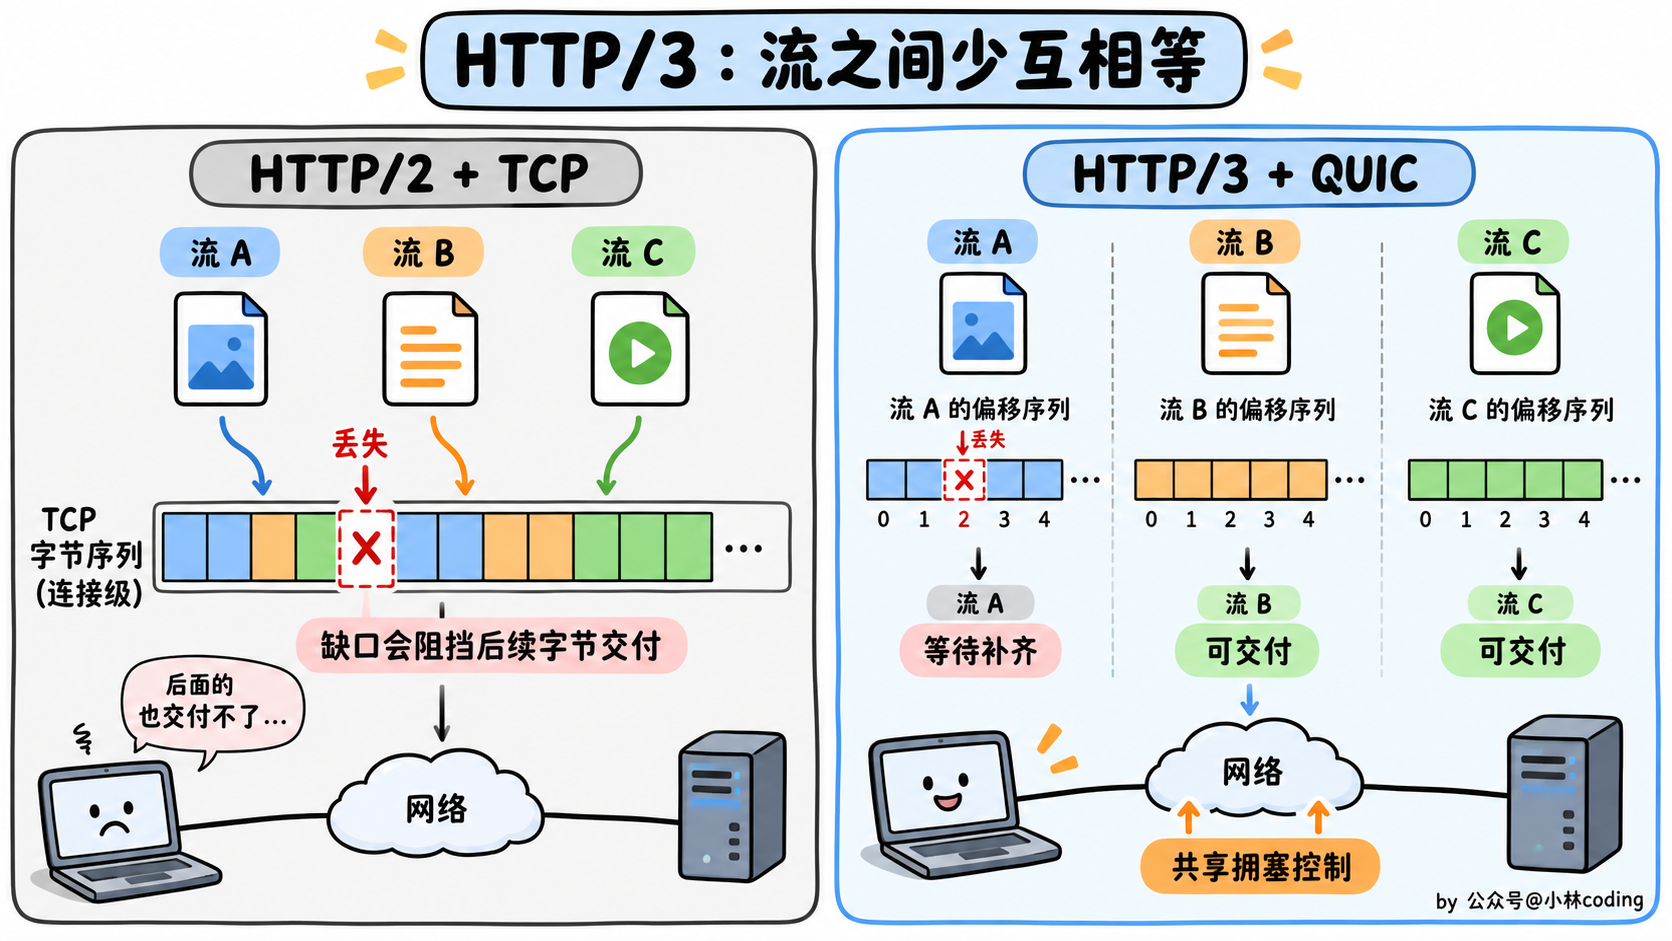
**HTTP/2 解决了 HTTP/1.1 在一条连接上按序返回响应的队头阻塞,但没有解决 TCP 层的队头阻塞。**底层 TCP 丢了一个数据段,即使后面的字节已经到达,也要先补齐缺口,连接上的多个 Stream 都可能被拖住。
# HTTP/3 相比 HTTP/2 有什么改进?
HTTP/2 使用 TCP,HTTP/3 使用基于 UDP 的 QUIC。HTTP 的请求方法和状态码这些语义并没有因此改变。
主要改进有以下几点:
- 减少跨流的队头阻塞:QUIC 为不同 Stream 分别维护数据顺序。某个流丢包时,其他不依赖它的流可以继续交付数据。不过丢包的那个流本身仍然要等待重传,共享的拥塞控制也可能影响整个连接。
- 连接建立更快:QUIC 集成 TLS 1.3,完整握手通常需要 1-RTT;满足条件的恢复连接可以发送 0-RTT 早期数据。
- 支持连接迁移:QUIC 使用 Connection ID 标识连接,在满足路径验证等条件时,客户端从 Wi-Fi 切到移动网络,即使 IP 和端口变化,也可以继续使用原来的连接。
- 使用 QPACK 压缩头部:它考虑了多个流之间独立传输的特点,减少头部压缩带来的阻塞。
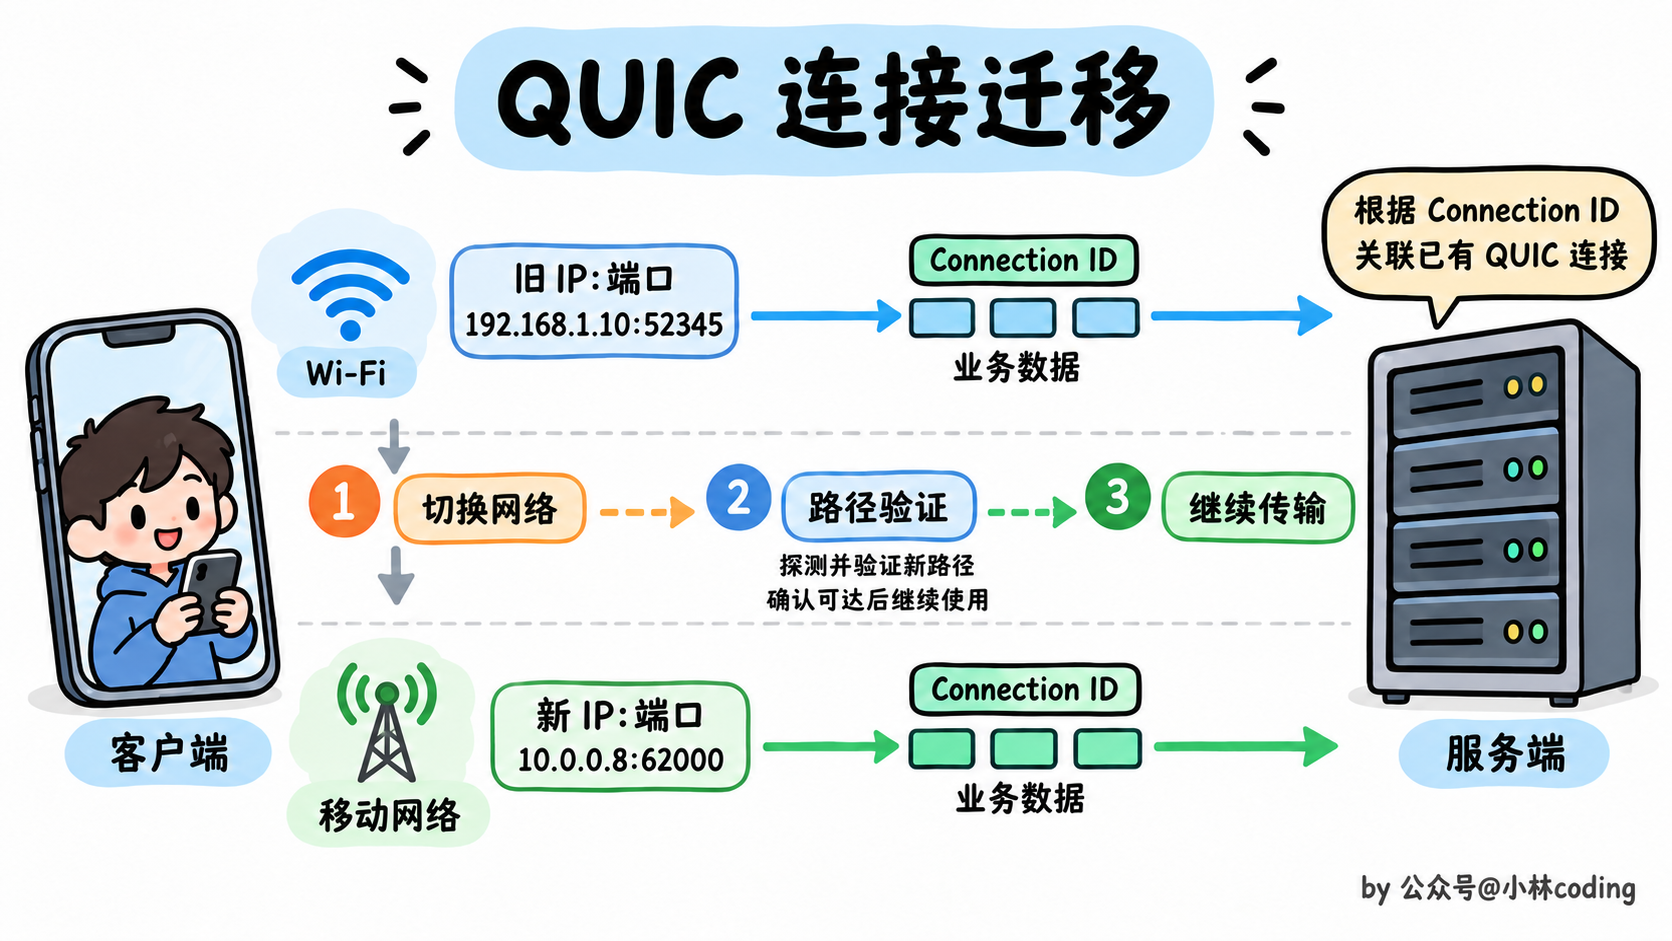
注意,HTTP/3 并不是放弃可靠性,把 HTTP 数据直接丢给 UDP。可靠传输、拥塞控制和加密等工作由 QUIC 完成。
# HTTP 强制缓存和协商缓存有什么区别?
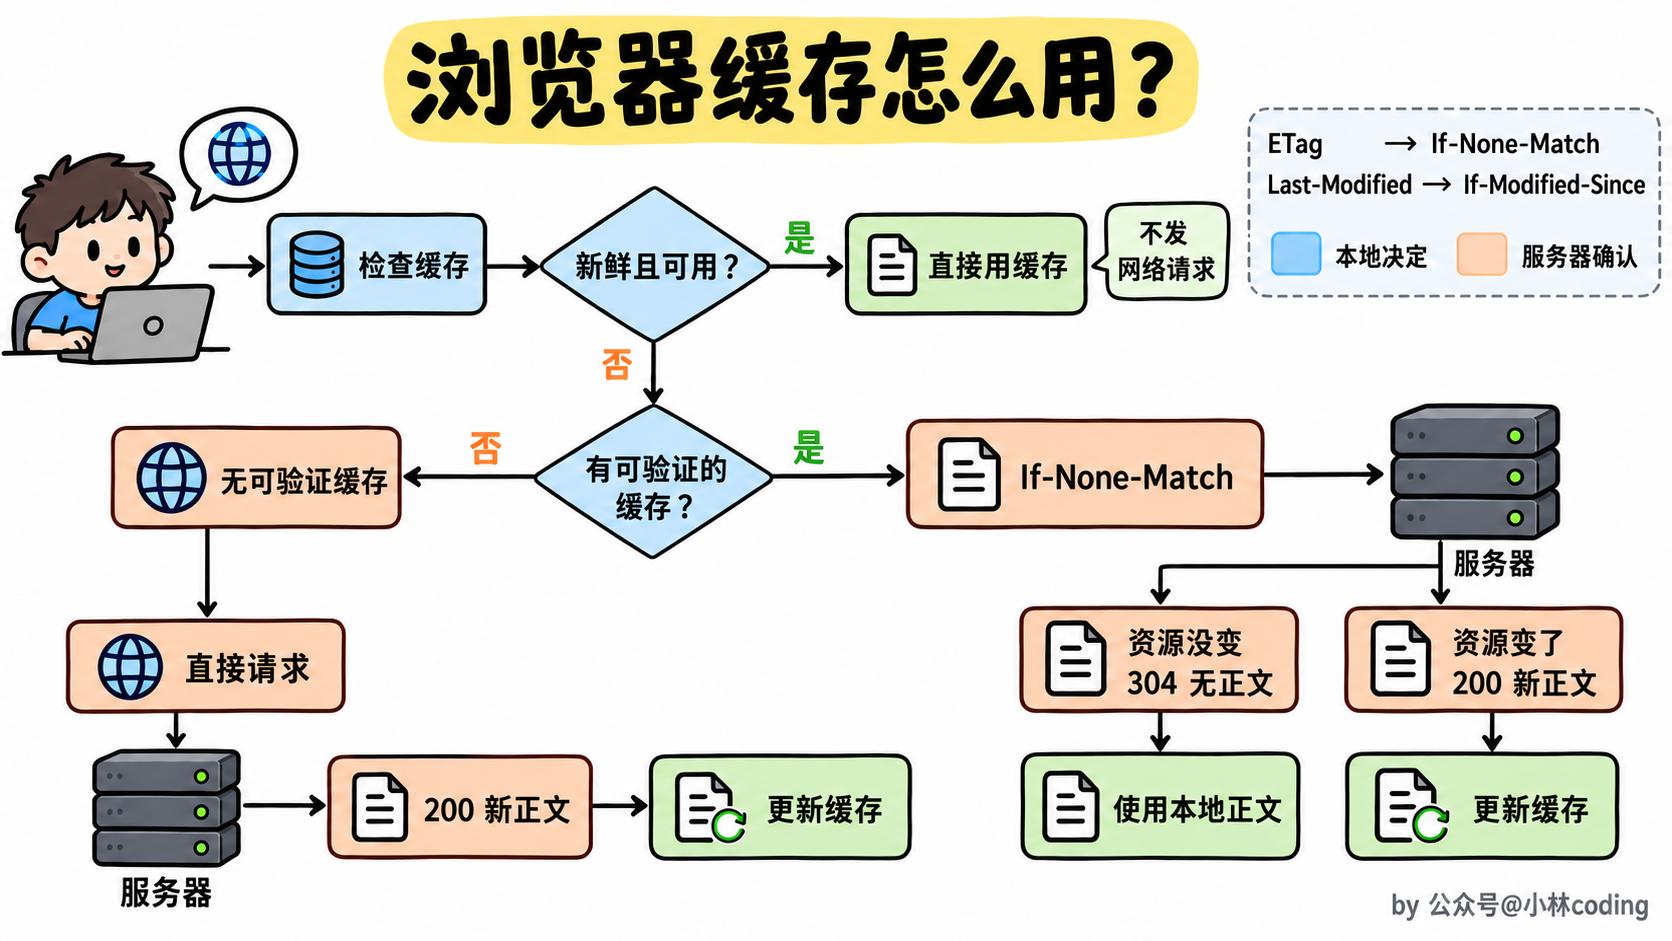
强制缓存决定「能不能直接用缓存」,协商缓存决定「缓存还能不能继续用」。
强制缓存
浏览器收到响应后,根据 Cache-Control: max-age=... 等字段判断缓存的新鲜度。缓存还新鲜时,可以直接使用,不用向服务器发送这次资源请求。Expires 也可以指定过期时间,不过通常优先使用 Cache-Control。
协商缓存
缓存需要重新验证时,浏览器向服务端发条件请求,常见的两组字段是:
- 服务端返回 ETag,浏览器下次发送 If-None-Match。
- 服务端返回 Last-Modified,浏览器下次发送 If-Modified-Since。
资源没变,服务端返回 304,不再发送响应体,浏览器继续使用本地缓存;资源变了,就返回 200 和新的内容。如果两组条件同时出现,If-None-Match 优先。
举个例子,第一次下载一张图片,服务端告诉浏览器可以缓存 10 分钟,并返回一个 ETag。10 分钟内可以直接用缓存,需要重新验证时就带上这个 ETag 去问服务端:「这张图还是原来那个版本吗?」
# Cache-Control 里的 no-cache 和 no-store 有什么区别?
no-cache 不是不允许缓存,而是使用缓存前必须向服务器重新验证;no-store 才是不允许存储这次请求或响应。
比如一个页面设置了 no-cache,浏览器仍然可以保存内容,下次发起协商请求,资源没变就使用缓存。对于不希望被缓存保存的敏感响应,则可以设置 no-store。
另外,private 表示响应只允许浏览器等私有缓存保存,不允许 CDN、代理这类共享缓存保存。不能把某个用户的个人页面当作公共内容缓存起来,再发给另一个用户。
# HTTP进行TCP连接之后,在什么情况下会中断
常见情况有以下几种:
- 正常关闭:客户端或服务端不再使用连接,关闭最后一个 socket 引用,或者调用 shutdown 关闭发送方向,通常通过 FIN 进行关闭。
- 连接被重置:收到有效的 RST 报文,连接被立即终止,应用可能看到 Connection reset。
- 重传超时:发送数据之后长期收不到确认,达到系统或应用设置的超时条件,内核会报告连接失败。
- HTTP 连接管理:使用 Connection: close,或者达到服务端的空闲超时、最大请求次数等限制,由应用决定关闭连接。
但是,网线被拔掉或者对端突然断电,不一定会立刻让本地连接消失。如果连接没有数据交互,也没有开启保活或应用层超时,本地可能仍然显示 ESTABLISHED。
# HTTP、SOCKET和TCP的区别
HTTP是应用层协议,定义了客户端和服务器之间交换的数据格式和规则;Socket是通信的一端,提供了网络通信的接口;TCP是传输层协议,负责在网络中建立可靠的数据传输连接。它们在网络通信中扮演不同的角色和层次。
- HTTP是一种用于传输超文本数据的应用层协议,用于在客户端和服务器之间传输和显示Web页面。
- Socket是计算机网络中的一种抽象,用于描述通信链路的一端,提供了底层的通信接口,可实现不同计算机之间的数据交换。
- TCP是一种面向连接的、可靠的传输层协议,负责在通信的两端之间建立可靠的数据传输连接。
# DNS的全称了解么?
DNS的全称是Domain Name System(域名系统),它是互联网中用于将域名转换为对应IP地址的分布式数据库系统。DNS扮演着重要的角色,使得人们可以通过易记的域名访问互联网资源,而无需记住复杂的IP地址。
DNS 中的域名都是用句点来分隔的,比如 www.server.com,这里的句点代表了不同层次之间的界限。
在域名中,越靠右的位置表示其层级越高。
毕竟域名是外国人发明,所以思维和中国人相反,比如说一个城市地点的时候,外国喜欢从小到大的方式顺序说起(如 XX 街道 XX 区 XX 市 XX 省),而中国则喜欢从大到小的顺序(如 XX 省 XX 市 XX 区 XX 街道)。
实际上域名最后还有一个点,比如 www.server.com.,这个最后的一个点代表根域名。
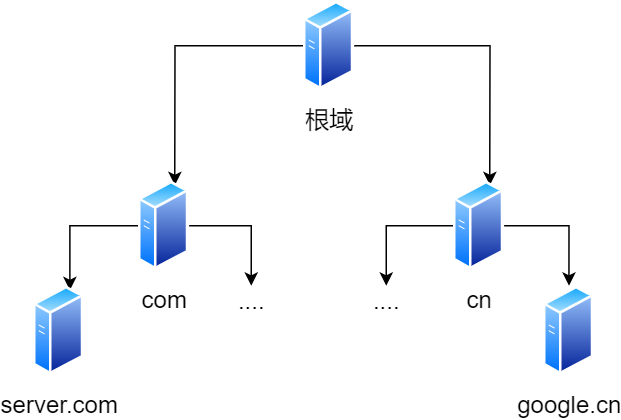
也就是,. 根域是在最顶层,它的下一层就是 .com 顶级域,再下面是 server.com。
所以域名的层级关系类似一个树状结构:
- 根 DNS 服务器(.)
- 顶级域 DNS 服务器(.com)
- 权威 DNS 服务器(server.com)
根域的 DNS 服务器信息保存在互联网中所有的 DNS 服务器中。
这样一来,任何 DNS 服务器就都可以找到并访问根域 DNS 服务器了。
因此,客户端只要能够找到任意一台 DNS 服务器,就可以通过它找到根域 DNS 服务器,然后再一路顺藤摸瓜找到位于下层的某台目标 DNS 服务器。
# DNS 域名解析的工作流程?
在真正发出 DNS 请求前,客户端通常会先检查浏览器、操作系统的解析缓存,以及 hosts 等本地配置。如果已经找到了可用结果,就不必走完下面的查询。这里以没有命中缓存的情况为例:
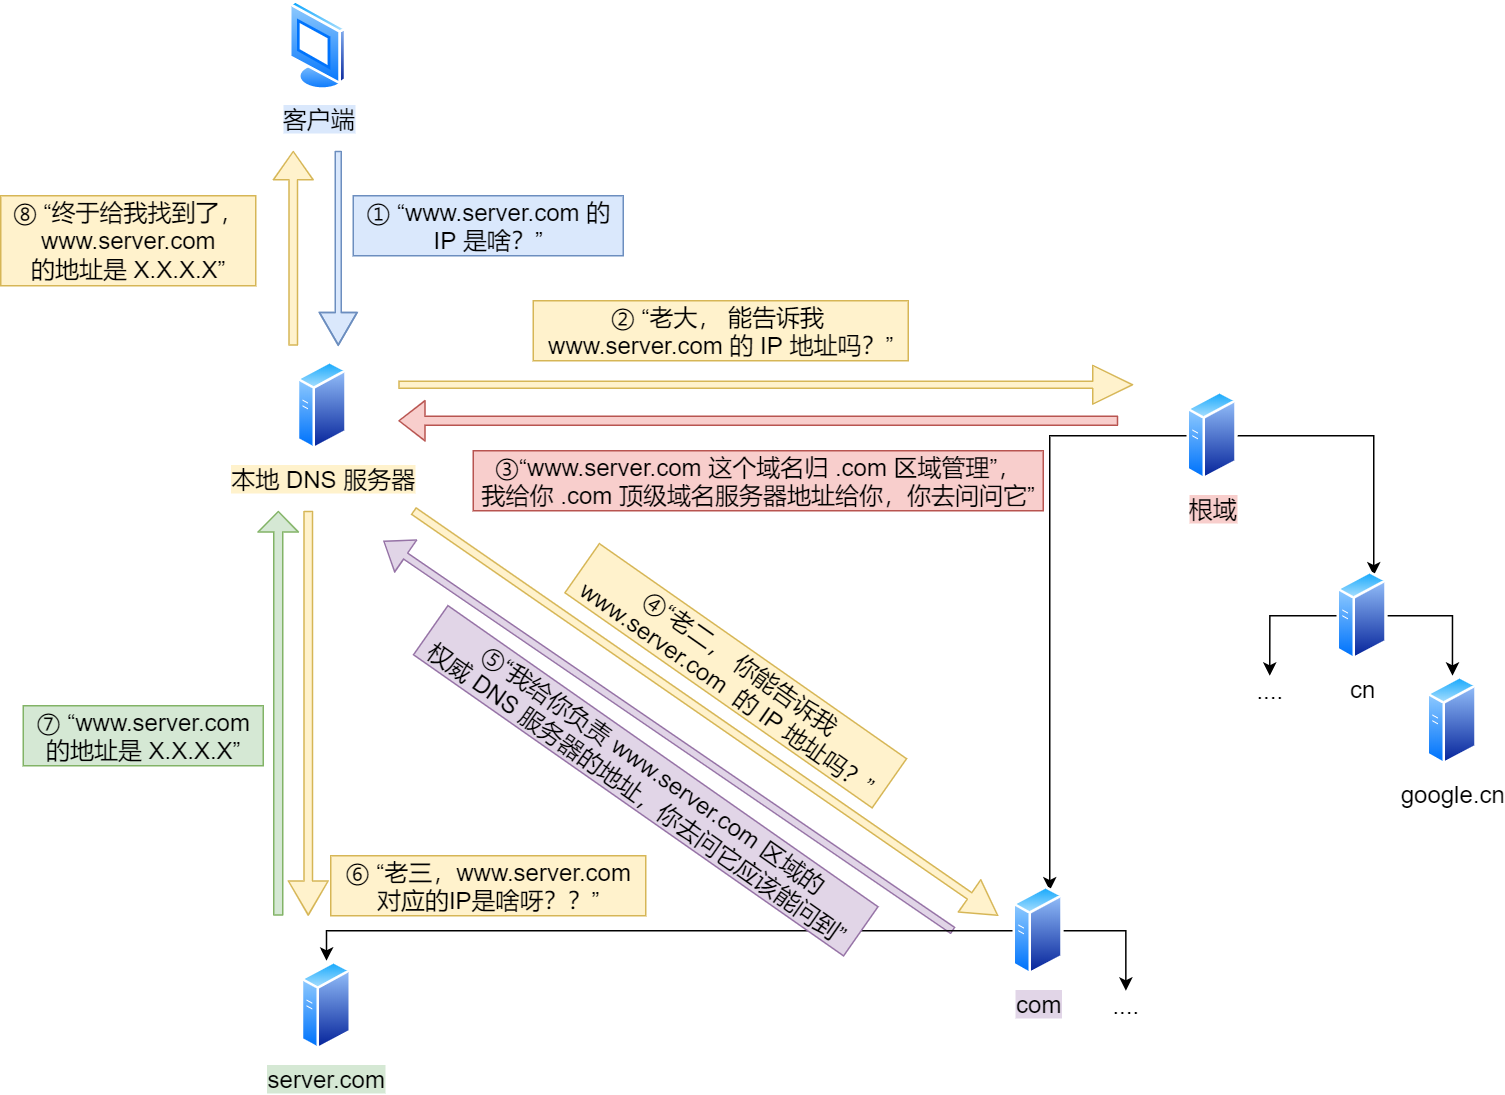
- 客户端首先会发出一个 DNS 请求,问 www.server.com 的 IP 是啥,并发给本地 DNS 服务器(也就是客户端的 TCP/IP 设置中填写的 DNS 服务器地址)。
- 本地域名服务器收到客户端的请求后,如果缓存里的表格能找到 www.server.com,则它直接返回 IP 地址。如果没有,本地 DNS 会去问它的根域名服务器:“老大, 能告诉我 www.server.com 的 IP 地址吗?” 根域名服务器是最高层次的,它不直接用于域名解析,但能指明一条道路。
- 根 DNS 收到来自本地 DNS 的请求后,发现后置是 .com,说:“www.server.com 这个域名归 .com 区域管理”,我给你 .com 顶级域名服务器地址给你,你去问问它吧。”
- 本地 DNS 收到顶级域名服务器的地址后,发起请求问“老二, 你能告诉我 www.server.com 的 IP 地址吗?”
- 顶级域名服务器说:“我给你负责 www.server.com 区域的权威 DNS 服务器的地址,你去问它应该能问到”。
- 本地 DNS 于是转向问权威 DNS 服务器:“老三,www.server.com对应的IP是啥呀?” server.com 的权威 DNS 服务器,它是域名解析结果的原出处。为啥叫权威呢?就是我的域名我做主。
- 权威 DNS 服务器查询后将对应的 IP 地址 X.X.X.X 告诉本地 DNS。
- 本地 DNS 再将 IP 地址返回客户端,客户端和目标建立连接。
客户端请本地 DNS 帮忙查出最终结果,通常属于递归查询;本地 DNS 再向根、顶级域和权威 DNS 一层一层询问,通常属于迭代查询。查询结果会按 TTL 缓存,因此不是每次访问都要从根服务器查起。
至此,我们完成了 DNS 的解析过程。现在总结一下,整个过程我画成了一个图。
# DNS的端口是多少?
默认端口号是53。
# 改过host文件吗?
host 文件的核心作用是把域名和 IP 地址绑在一起。比如你想让电脑访问 “www.xxx.com (opens new window)” 时直接指向某个特定 IP,不用走公共 DNS 解析,改 host 文件就行。
举个实际场景,程序员测试网站时,还没上线的项目只有服务器 IP,就在 host 里写 “192.168.1.100 www.test.com (opens new window)”,这样输入域名就能直接访问测试服,不用记一串难背的 IP。
# DNS的底层使用TCP还是UDP?
DNS 同时支持 UDP 和 TCP,传统 DNS 服务的端口号都是 53。
普通查询通常先使用 UDP,因为请求和响应一般比较小,不需要先建立连接。如果 UDP 响应被截断,响应中的 TC 标志位会置为 1,客户端通常会改用 TCP 重新查询。
传统 DNS 的 UDP 消息大小限制为 512 字节,EDNS(0) 可以让客户端通告能够接收的 UDP 消息大小,但不是所有查询都固定使用 4096 字节。消息越大,也越容易遇到 IP 分片和丢包,所以 TCP 仍然有必要。
另外,完整区域传送 AXFR 使用 TCP;增量区域传送 IXFR 可以使用 UDP 或 TCP,不能把所有区域传送都说成只能用 TCP。
如果面试官追问加密 DNS,可以再补充:DoT 通常使用 TLS over TCP,DoH 通过 HTTPS 传输,DoQ 使用基于 UDP 的 QUIC。QUIC 底层仍然是 UDP,只是可靠性和加密等能力由 QUIC 提供。
# HTTP到底是不是无状态的?
**HTTP 是无状态的,指协议不要求服务器记住前一次请求,才能理解后一次请求。**每个请求应该提供理解它所需的信息。
这并不是说服务器不能保存用户数据,也不是说 TCP 连接没有状态。比如服务端当然可以保存购物车,TCP 也会维护序列号和连接状态,只是它们不等于 HTTP 协议本身的会话状态。
实际业务需要记住用户的登录状态时,可以在 HTTP 之上使用 Cookie、Session 或 Token 来实现。
# 携带Cookie的HTTP请求是有状态还是无状态的?Cookie是HTTP协议簇的一部分,那为什么还说HTTP是无状态的?
HTTP 仍然是无状态协议,不过应用可以借助 Cookie 实现有状态的会话。
举个例子,第一次登录成功后,服务端把 Session ID 写进 Cookie。后续每次请求,浏览器都按 Cookie 的规则带上这个 ID,服务端拿它去找对应的登录信息,就知道「还是刚才那个用户」。
这里并不是 HTTP 自动记住了上一个请求,而是当前请求又带来了用于识别用户的信息,应用再用这个信息查找会话。所以,协议无状态和业务有登录状态并不矛盾。
# cookie和session有什么区别?
Cookie和Session都是Web开发中用于跟踪用户状态的技术,但它们在存储位置、数据容量、安全性以及生命周期等方面存在显著差异:
- 存储位置:Cookie的数据存储在客户端(通常是浏览器)。当浏览器向服务器发送请求时,会自动附带Cookie中的数据。Session的数据存储在服务器端。服务器为每个用户分配一个唯一的Session ID,这个ID通常通过Cookie或URL重写的方式发送给客户端,客户端后续的请求会带上这个Session ID,服务器根据ID查找对应的Session数据。
- 数据容量:单个Cookie的大小限制通常在4KB左右,而且大多数浏览器对每个域名的总Cookie数量也有限制。由于Session存储在服务器上,理论上不受数据大小的限制,主要受限于服务器的内存大小。
- 安全性:Cookie相对不安全,因为数据存储在客户端,容易受到XSS(跨站脚本攻击)的威胁。不过,可以通过设置HttpOnly属性来防止JavaScript访问,减少XSS攻击的风险,但仍然可能受到CSRF(跨站请求伪造)的攻击。Session通常认为比Cookie更安全,因为敏感数据存储在服务器端。但仍然需要防范Session劫持(通过获取他人的Session ID)和会话固定攻击。
- 生命周期:Cookie可以设置过期时间,过期后自动删除。也可以设置为会话Cookie,即浏览器关闭时自动删除。服务端 Session 的有效期由服务器控制,关闭浏览器并不会直接通知服务端删除 Session。会话 Cookie 通常在浏览器会话结束后被清除,但浏览器的会话恢复功能也可能把它恢复,所以两者的生命周期不能简单画等号。
- 性能:使用Cookie时,因为数据随每个请求发送到服务器,可能会影响网络传输效率,尤其是在Cookie数据较大时。使用Session时,因为数据存储在服务器端,每次请求都需要查询服务器上的Session数据,这可能会增加服务器的负载,特别是在高并发场景下。
# token,session,cookie的区别?
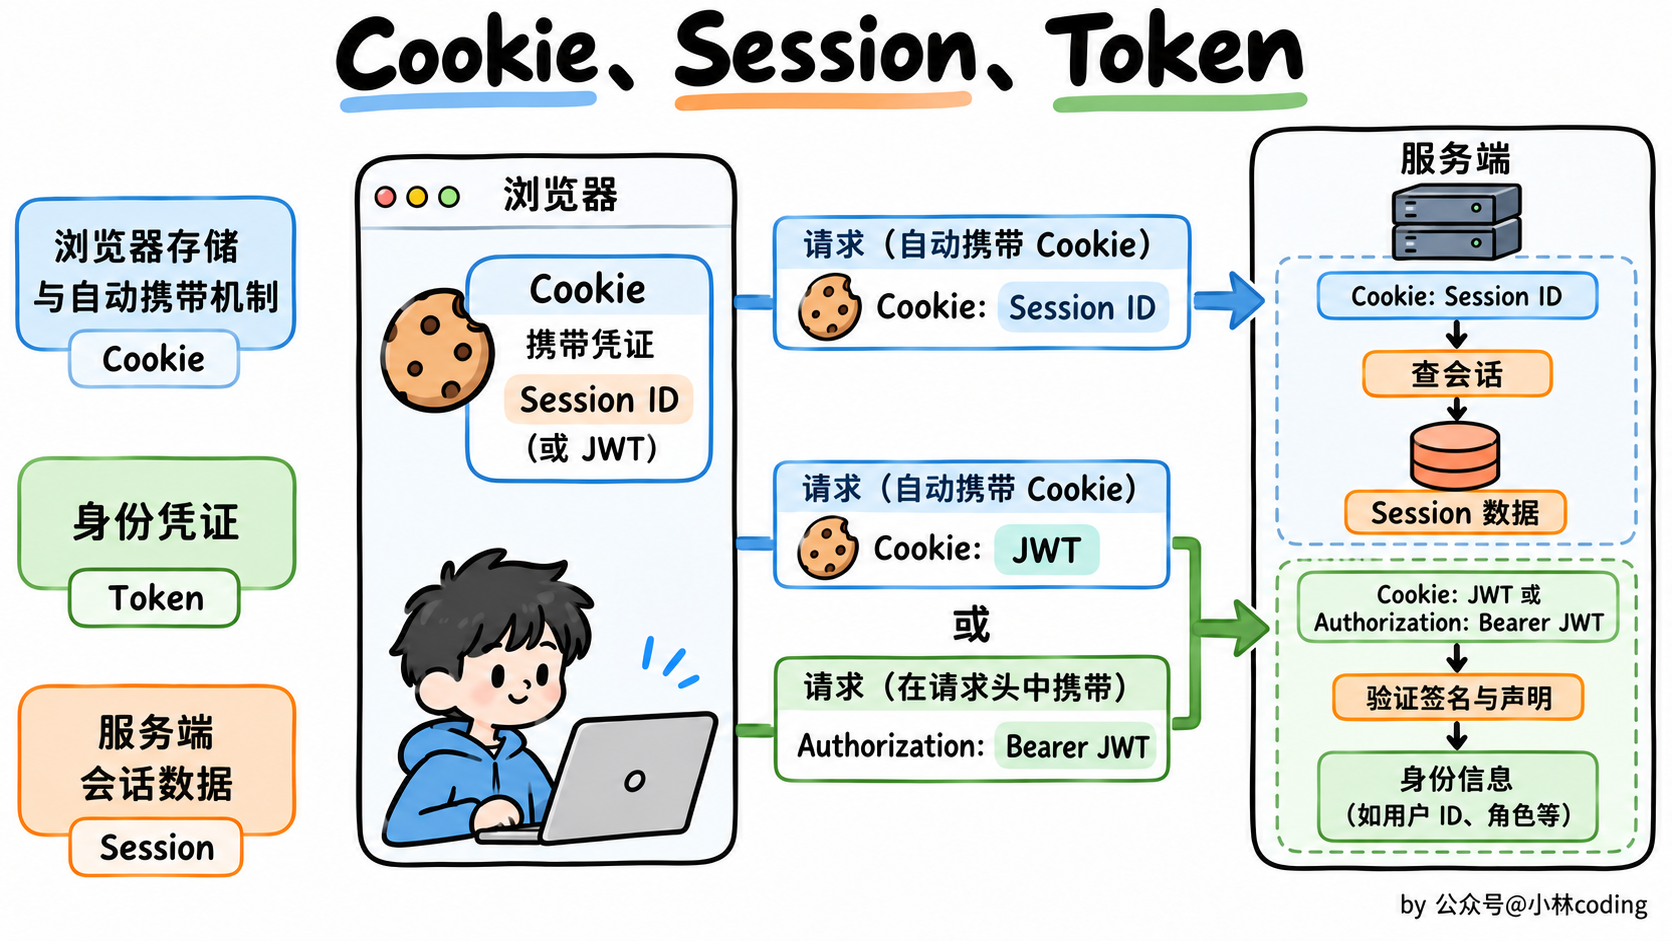
这三个概念经常放在一起比较,但它们承担的职责不一样:
- Cookie:浏览器存储和发送小段数据的机制。满足域名、路径、Secure、SameSite 等规则时,浏览器会自动携带 Cookie。
- Session:服务端保存会话状态的方式。客户端通常只持有 Session ID,服务端根据这个 ID 查找登录信息。Session ID 经常放在 Cookie 中,但也可以通过其他方式传递。
- Token:客户端用来证明身份或权限的凭证。它可以是一个随机字符串,由服务端查表验证,也可以是 JWT 这样的自包含令牌。可以放在 Authorization 请求头中,也可以放进 Cookie。
所以,Token 不一定无状态,JWT 也不一定加密,Session 也不是必须依赖 Cookie。比如把 JWT 放进 Cookie,并不会让 Cookie 和 JWT 变成同一个概念。
# 如果客户端禁用了cookie,session还能用吗?
默认情况下禁用 Cookie 后,Session 是无法正常使用的,因为大多数 Web 服务器都是依赖于 Cookie 来传递 Session 的会话 ID 的。
客户端浏览器禁用 Cookie 时,服务器将无法把会话 ID 发送给客户端,客户端也无法在后续请求中携带会话 ID 返回给服务器,从而导致服务器无法识别用户会话。
但是,有几种方法可以绕过这个问题,尽管它们可能会引入额外的复杂性和/或降低用户体验:
- URL重写:每当服务器响应需要保持状态的请求时,将Session ID附加到URL中作为参数。例如,原本的链接http://example.com/page变为http://example.com/page;jsessionid=XXXXXX,服务器端需要相应地解析 URL 来获取 Session ID,并维护用户的会话状态。这种方式的缺点是URL变得不那么整洁,且如果用户通过电子邮件或其他方式分享了这样的链接,可能导致Session ID的意外泄露。
- 隐藏表单字段:在每个需要Session信息的HTML表单中包含一个隐藏字段,用来存储Session ID。当表单提交时,Session ID随表单数据一起发送回服务器,服务器通过解析表单数据中的 Session ID 来获取用户的会话状态。这种方法仅适用于通过表单提交的交互模式,不适合链接点击或Ajax请求。
# 如果我把数据存储到 localStorage,和Cookie有什么区别?
可以从以下几个方面来比较:
- 容量:单个 Cookie 通常限制在 4 KB 左右,localStorage 通常能存几 MB,具体限制取决于浏览器。
- 发送方式:符合匹配规则的 Cookie 会自动随请求发送,localStorage 不会,需要 JavaScript 读取后主动放进请求。
- 作用范围:localStorage 按同源隔离,也就是协议、主机和端口都要相同。Cookie 主要按域名、路径等规则匹配,不按端口隔离,也不能任意跨域使用。
- 生命周期:Cookie 可以设置 Max-Age 或 Expires。localStorage 没有内置的过期时间,但用户清理数据、浏览器存储策略等仍然可能让它被删除。
- 安全性:localStorage 可以被同源 JavaScript 读取,发生 XSS 时,里面的令牌可能被窃取。Cookie 可以设置 HttpOnly 来阻止 JavaScript 读取,但自动携带身份 Cookie 又需要考虑 CSRF。
**不能因为 localStorage 不自动发送,就说它一定比 Cookie 安全。**要看保存什么数据,以及如何防范 XSS、CSRF 和凭证泄露。
# 什么数据应该存在到cookie,什么数据存放到 Localstorage
Cookie 适合保存需要随请求发送的小型数据,比如 Session ID。身份 Cookie 通常要配合 HttpOnly、Secure 和合适的 SameSite 属性,并在服务端做好会话验证。
localStorage 适合保存只在浏览器端使用的偏好和非敏感缓存,比如主题、列表展示方式。它没有内置过期机制,需要过期时可以由业务代码保存时间戳并主动清理。
无论放在哪,客户端的数据都不能直接当成权限依据。比如 localStorage 里写着「管理员」,不代表服务端就应该给这个用户管理员权限。
# Cookie 的 HttpOnly、Secure 和 SameSite 分别有什么作用?
这三个属性控制的是不同的事情:
- HttpOnly:不允许 JavaScript 通过 document.cookie 读取 Cookie,减少身份凭证被 XSS 脚本直接窃取的风险。但浏览器仍然会发送它,恶意脚本也可能借用户的身份发请求。
- Secure:要求 Cookie 通过安全连接发送,通常就是 HTTPS。它不负责限制 JavaScript 读取。
- SameSite:控制跨站请求是否携带 Cookie,用来减少 CSRF 风险。Strict 比较严格;Lax 允许部分场景,比如从其他网站点击普通 GET 链接;None 允许跨站发送,通常必须同时设置 Secure。
注意,跨站和跨域不是完全相同的概念。比如两个同协议、同主域下的子域名可能属于同站,但仍然不同源。SameSite 也不能替代所有 CSRF 防护,服务端还要根据业务使用 CSRF Token、来源校验等措施。
# JWT 令牌和传统方式有什么区别?
这里通常是把 JWT 和「服务端保存 Session、客户端保存 Session ID」的登录方式进行比较。
- Session 方式:客户端持有一个标识,服务端通过它查询会话数据。集群通常需要共享 Session,或者做会话保持。服务端删除会话后,可以立即让对应登录失效。
- JWT 方式:把必要的身份声明放进令牌,并对它签名。服务端验证签名和声明后,可以直接得到身份信息,不必为每个请求查询 Session。
JWT 的好处是方便多个服务独立验证,但代价是撤销和更新权限比较麻烦。如果引入黑名单或令牌版本校验,服务端仍然需要维护状态。
还要注意,常见的签名 JWT 只是防篡改,不是加密,任何拿到令牌的人通常都能解码 Header 和 Payload,里面不要放密码等敏感信息。跨域能否访问也由浏览器的 CORS 等规则决定,并不是用了 JWT 就自动允许跨域。
# JWT 令牌都有哪些字段?
常见的签名 JWT 由三部分组成:Header、Payload、Signature,中间用点号分隔。
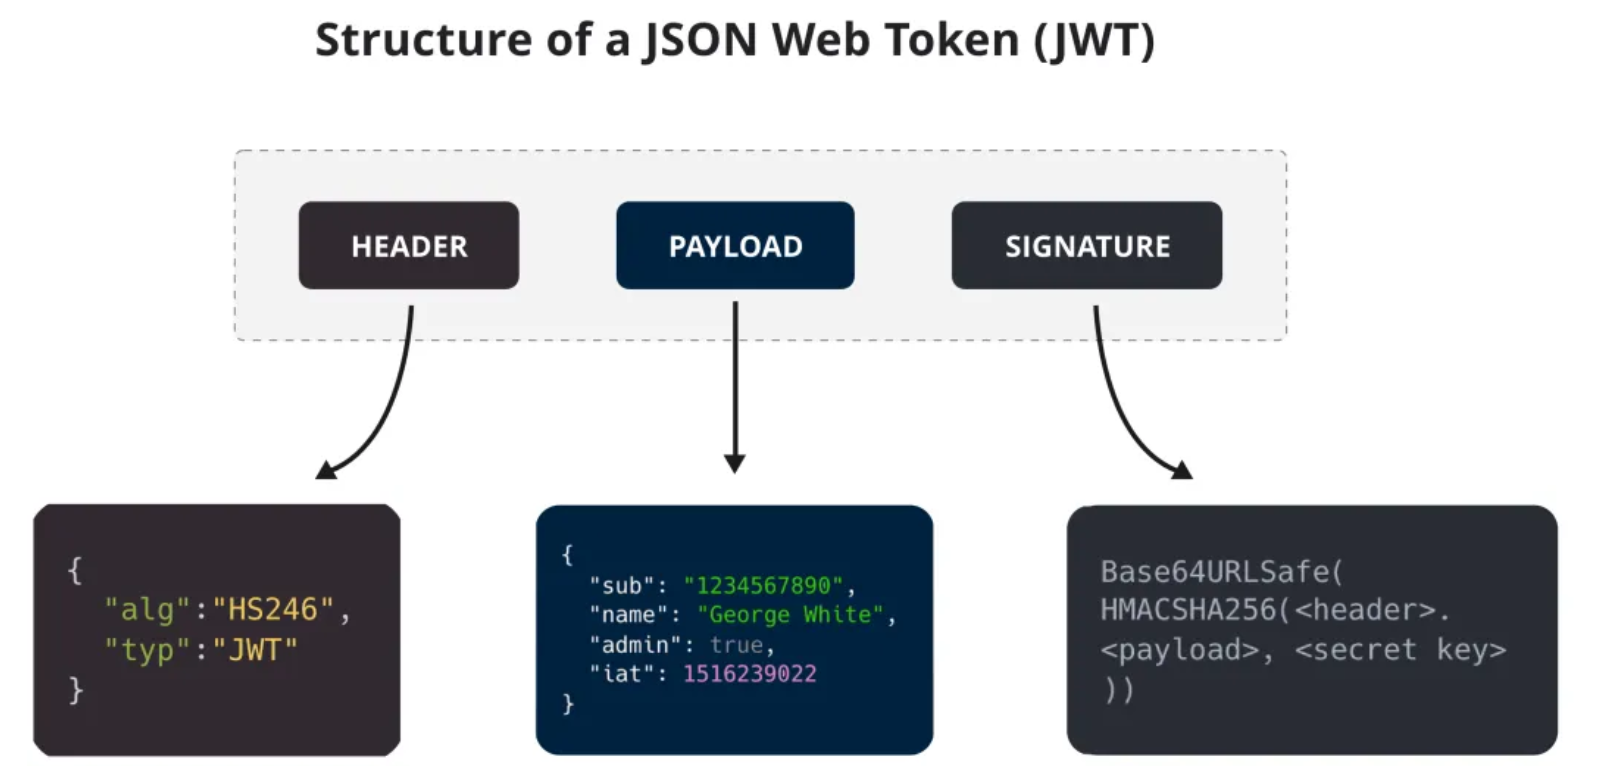
- Header:描述令牌类型和签名算法,比如 typ、alg,也可以用 kid 标识密钥。
- Payload:保存声明,常见的有 iss(签发者)、sub(主题,常用于用户标识)、aud(接收方)、exp(过期时间)、nbf(生效时间)、iat(签发时间)、jti(令牌标识)。哪些字段需要携带,要看业务约定。
- Signature:对编码后的 Header 和 Payload 进行签名或计算消息认证码,防止内容被篡改。
这里使用的是 Base64URL 编码,不是加密。如果使用 HMAC,签发和验证使用共享密钥;如果使用 RSA、ECDSA 等签名算法,则用私钥签名、公钥验证。
服务端不能只解码 Payload 就信任里面的数据,还要限制允许的算法,验证签名,并检查过期时间、签发者和接收方等业务需要的声明。
# JWT 令牌为什么能解决集群部署,什么是集群部署?
集群部署就是把同一个服务部署到多台服务器,通过负载均衡把请求分发到不同实例。一台机器故障时,其他实例还可以继续提供服务。
在传统的基于会话和Cookie的身份验证方式中,会话信息通常存储在服务器的内存或数据库中。但在集群部署中,不同服务器之间没有共享的会话信息,这会导致用户在不同服务器之间切换时需要重新登录,或者需要引入额外的共享机制(如Redis),增加了复杂性和性能开销。
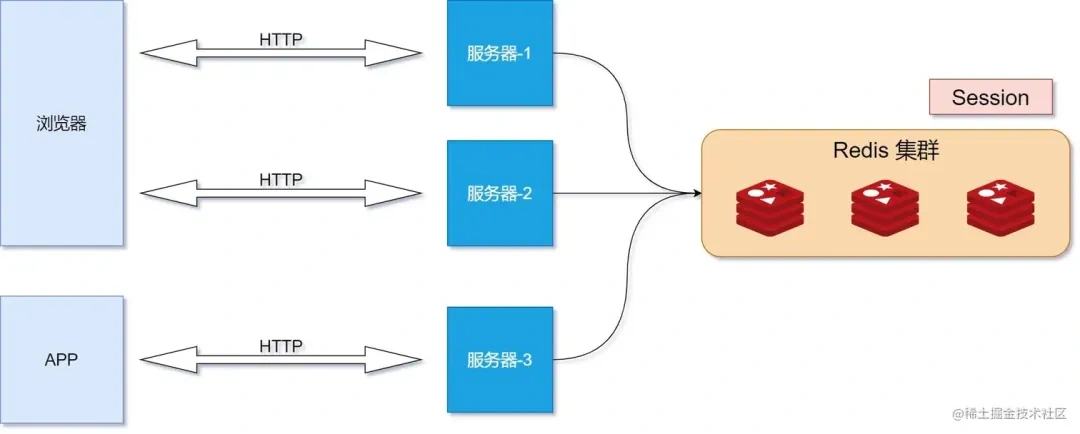
而JWT令牌通过在令牌中包含所有必要的身份验证和会话信息,使得服务器无需存储会话信息,从而解决了集群部署中的身份验证和会话管理问题。当用户进行登录认证后,服务器将生成一个JWT令牌并返回给客户端。客户端在后续的请求中携带该令牌,服务器可以通过对令牌进行验证和解析来获取用户身份和权限信息,而无需访问共享的会话存储。
集群中的实例需要有一致的验证规则,并持有对应的共享密钥或验证公钥,才能独立验证同一个 JWT。JWT 解决的是会话验证的一部分问题,并不会自动解决所有集群问题。权限更新、令牌撤销和密钥轮换仍然需要设计,Session 配合 Redis 共享也同样可以用于集群。
# jwt的缺点是什么?
最常见的问题是:**只靠签名和过期时间验证的 JWT,签发后很难立即撤销。**比如用户退出登录时,前端删除令牌,并不能让别人已经复制走的令牌失效。
另外还有几个问题:
- 权限更新不及时:令牌里保存的角色和权限可能已经过时,如果不额外查询,服务端要等旧令牌过期才看到变化。
- 体积较大:相比一个随机 Session ID,JWT 通常更长,每次请求携带会增加开销。
- 内容可能泄露:签名不等于加密,Payload 通常可以直接解码。
- 实现容易出错:只解码不验签、不检查 exp 或接受不允许的算法,都可能造成安全问题。
常见做法是设置较短的访问令牌有效期,配合刷新令牌。如果需要立即撤销,可以用 Redis 保存 jti 黑名单或者用户的令牌版本,但这样就要承担状态存储和查询的成本。
# JWT 令牌如果泄露了,怎么解决,JWT是怎么做的?
先说结论:**重新签发一个 JWT,不会自动让旧 JWT 失效。**攻击者持有的旧令牌,如果仍能通过签名、有效期和业务校验,就还可以继续使用。
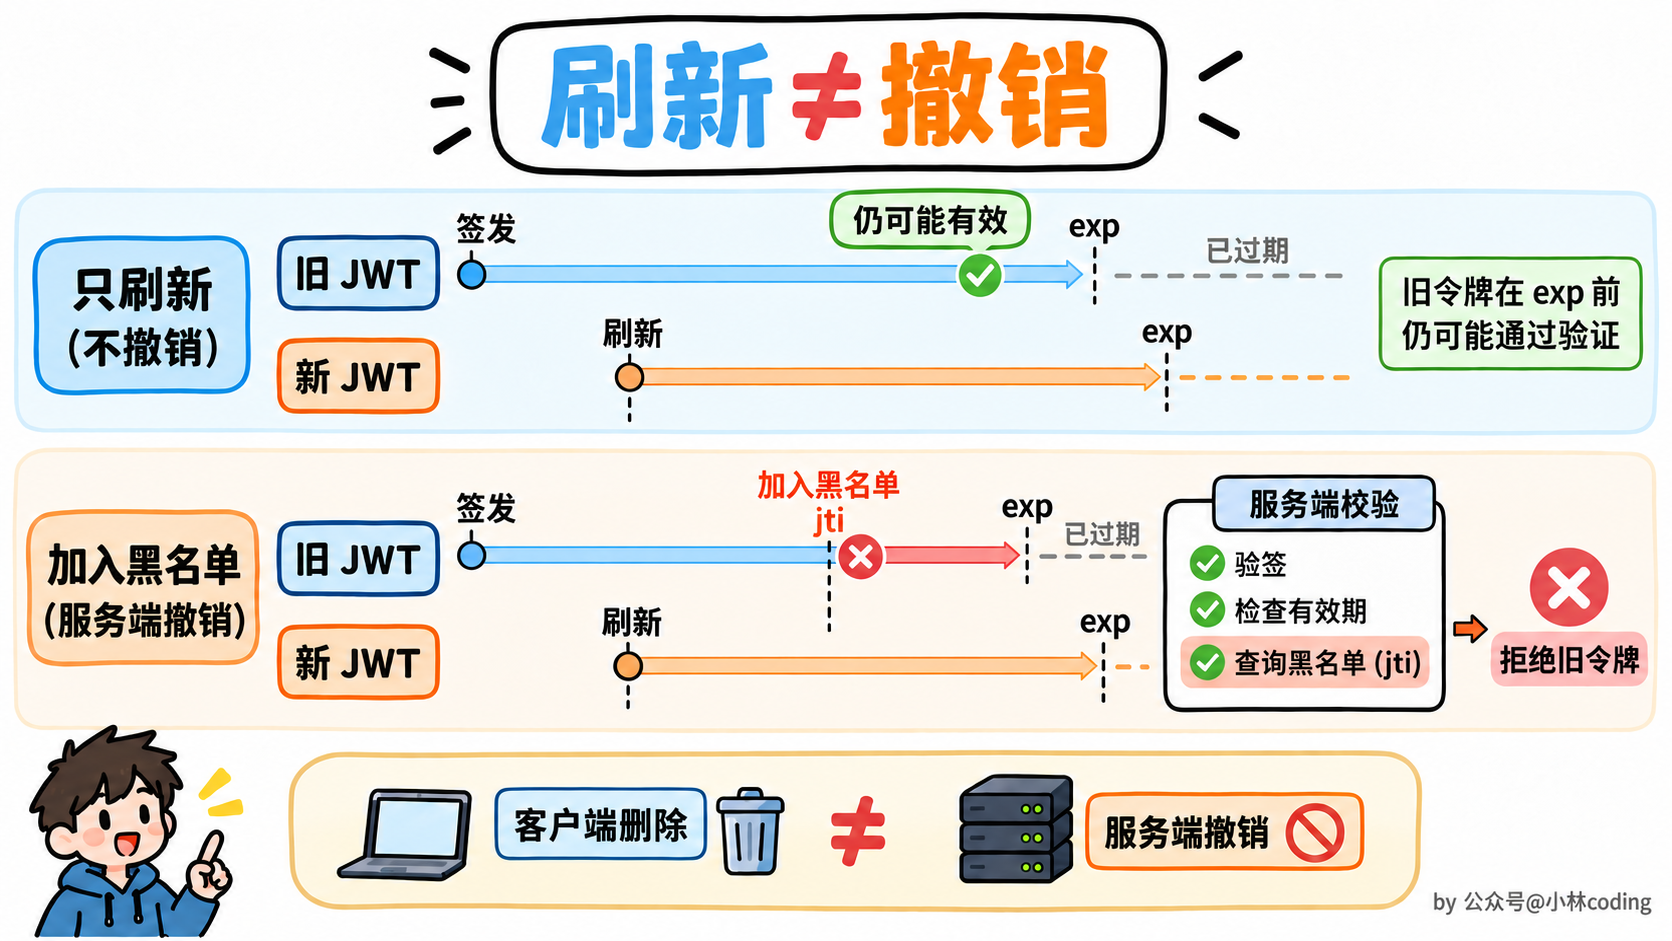
可以按下面的方式处理:
- 撤销泄露的令牌:把令牌的 jti 或令牌摘要加入服务端黑名单,并让各个实例在验证时检查。黑名单可以在原令牌过期后清理。
- 撤销相关登录会话:如果业务维护了用户的令牌版本或会话状态,可以更新版本、撤销该会话,要求相关用户重新登录。
- 处理刷新令牌:如果刷新令牌也泄露了,要一起撤销,否则攻击者仍然可以继续换取新的访问令牌。
- 限制损失窗口:访问令牌使用较短的有效期,使用 HTTPS,并避免把令牌放进 URL、日志等容易泄露的位置。
还要区分「令牌泄露」和「签名密钥泄露」。如果签名密钥泄露,攻击者可能自行伪造令牌,需要轮换密钥,并在验证端停止接受受影响的旧密钥,不能只拉黑某一个 JWT。
# 前端是如何存储JWT的?
前端收到 JWT 后,常见的保存位置有 Cookie、localStorage、sessionStorage 和内存,要根据登录体验和安全需求选择。
Cookie
服务端可以通过 Set-Cookie 写入令牌,配合 HttpOnly、Secure、SameSite。HttpOnly 可以避免 JavaScript 直接读取令牌,但自动携带 Cookie 的认证方式要防范 CSRF。
localStorage
刷新页面、重新打开浏览器后通常还能保留,方便保持登录。但它可以被 JavaScript 读取,发生 XSS 时可能被窃取,因此不适合无条件地保存长期有效的敏感凭证。
sessionStorage
通常按来源和标签页隔离,刷新当前页面不会清空,标签页会话结束后通常被清除。它同样可以被 JavaScript 读取,所以也有 XSS 风险。
内存
可以把短期访问令牌保存在 JavaScript 内存中,主动放入 Authorization 请求头。刷新页面后通常会丢失,需要通过刷新令牌等机制恢复。内存保存也不能让应用免受 XSS,恶意脚本仍然可能调用业务接口。
一种常见设计是短期访问令牌放内存,刷新令牌放 HttpOnly Cookie。但刷新接口仍要考虑 CSRF,并不是换个存储位置就能解决所有安全问题。
# 为什么有HTTP协议了?还要用RPC?
**HTTP 是协议,RPC 是远程调用的方式,它们并不互斥。**RPC 希望让程序员像调用本地方法一样调用远端服务,底层完全可以使用 HTTP,比如 gRPC 通常基于 HTTP/2。
在服务之间调用时,除了把数据发过去,还需要处理很多事情:
- 接口契约:用 IDL 定义接口和数据类型,生成客户端、服务端代码,减少手工拼请求和解析结果。
- 序列化:使用 Protobuf 等格式编码数据,具体开销要结合数据结构来判断。
- 服务治理:结合相关框架处理服务发现、负载均衡、超时、重试、调用链追踪等。
- 流式调用:一些框架支持客户端流、服务端流和双向流,适合持续传输数据的场景。
所以,选择 RPC 框架更多是为了接口约束和配套能力,不能笼统地说「RPC 一定比 HTTP 快」。性能要看底层协议、序列化方式、连接复用和实际业务。
# HTTP长连接与WebSocket有什么区别?
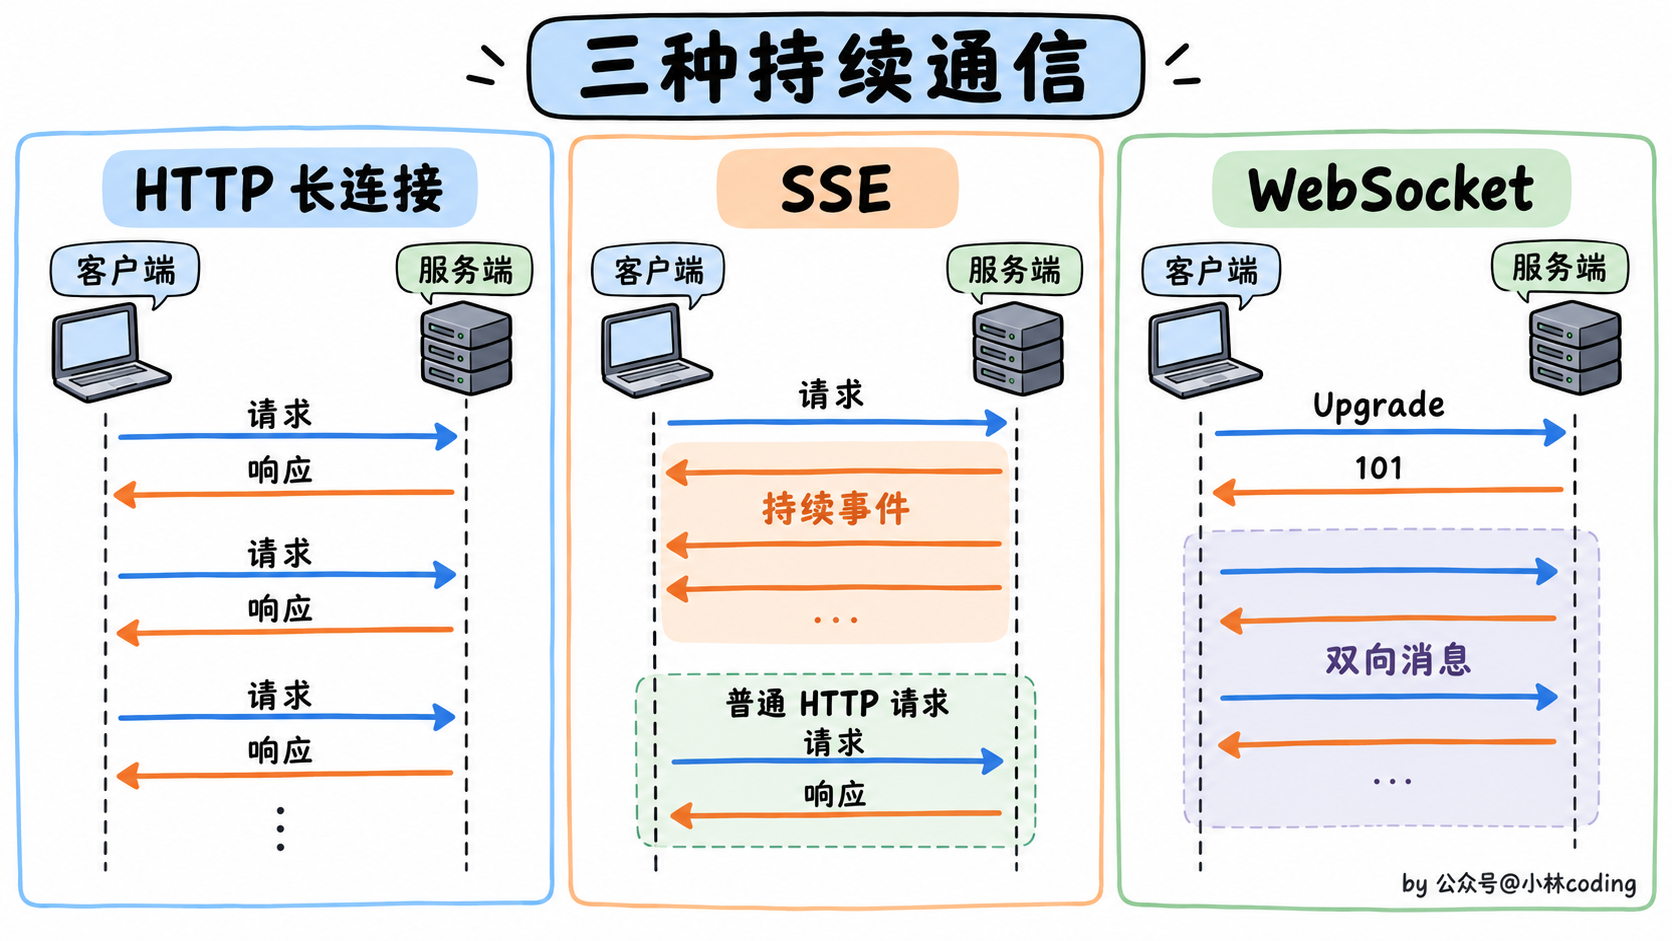
HTTP 长连接解决连接复用,WebSocket 解决持续的双向消息通信。
HTTP/1.1 长连接让多个请求和响应复用同一个 TCP 连接,但通信仍然围绕请求和响应展开。长连接本身不会让服务端可以随时向客户端发送一条新的独立业务消息。
WebSocket 常见的建连方式是先通过 HTTP/1.1 发起 Upgrade 握手,服务端返回 101 Switching Protocols 后,双方在连接上传输 WebSocket 帧。连接建立后,客户端和服务端都可以主动发送消息,适合聊天室、实时协作等场景。
这里不要简单地说 HTTP「只能半双工」。底层 TCP 本来就是全双工的,HTTP 也能通过流式响应等方式持续发送数据,区别主要在应用层的通信方式。
如果只是服务端持续推送,比如消息通知或 AI 输出,也可以使用 SSE:通过 HTTP 的 text/event-stream 响应发送事件,浏览器原生 EventSource 支持重连。需要频繁的双向交互时,WebSocket 通常更合适。
# 什么是跨域?CORS 是怎么解决跨域问题的?
浏览器用同源策略限制不同来源之间访问数据,协议、主机或端口任意一个不同,就属于不同源。比如 https://api.example.com 和 https://www.example.com 不同源。
CORS 的思路是:服务端通过响应头告诉浏览器,哪些来源可以读取这个响应。
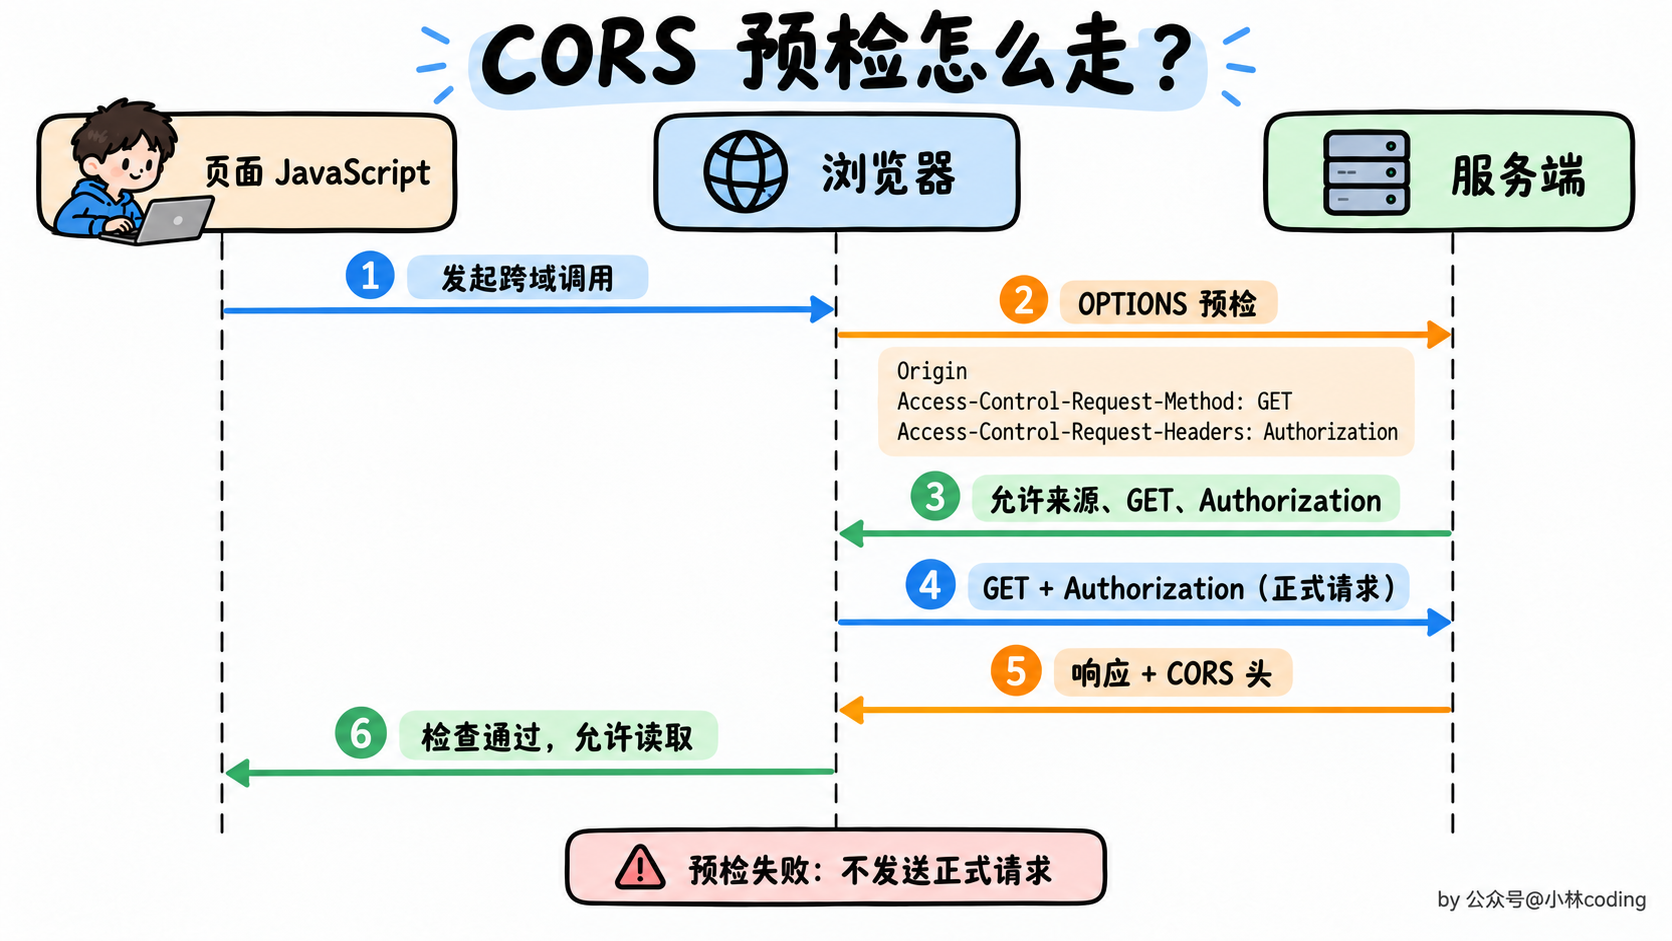
- 满足条件的简单请求可以直接发送,浏览器再检查响应中的 Access-Control-Allow-Origin 等字段。
- 使用 PUT、Authorization 或 application/json 等不满足简单请求条件的请求,浏览器通常先发 OPTIONS 预检,询问服务端是否允许对应来源、方法和请求头,允许后再发实际请求。
- 如果要携带 Cookie 等凭证,客户端和服务端都要做相应配置,服务端允许的来源不能写成通配符
*,需要返回允许的具体来源,并设置 Access-Control-Allow-Credentials。
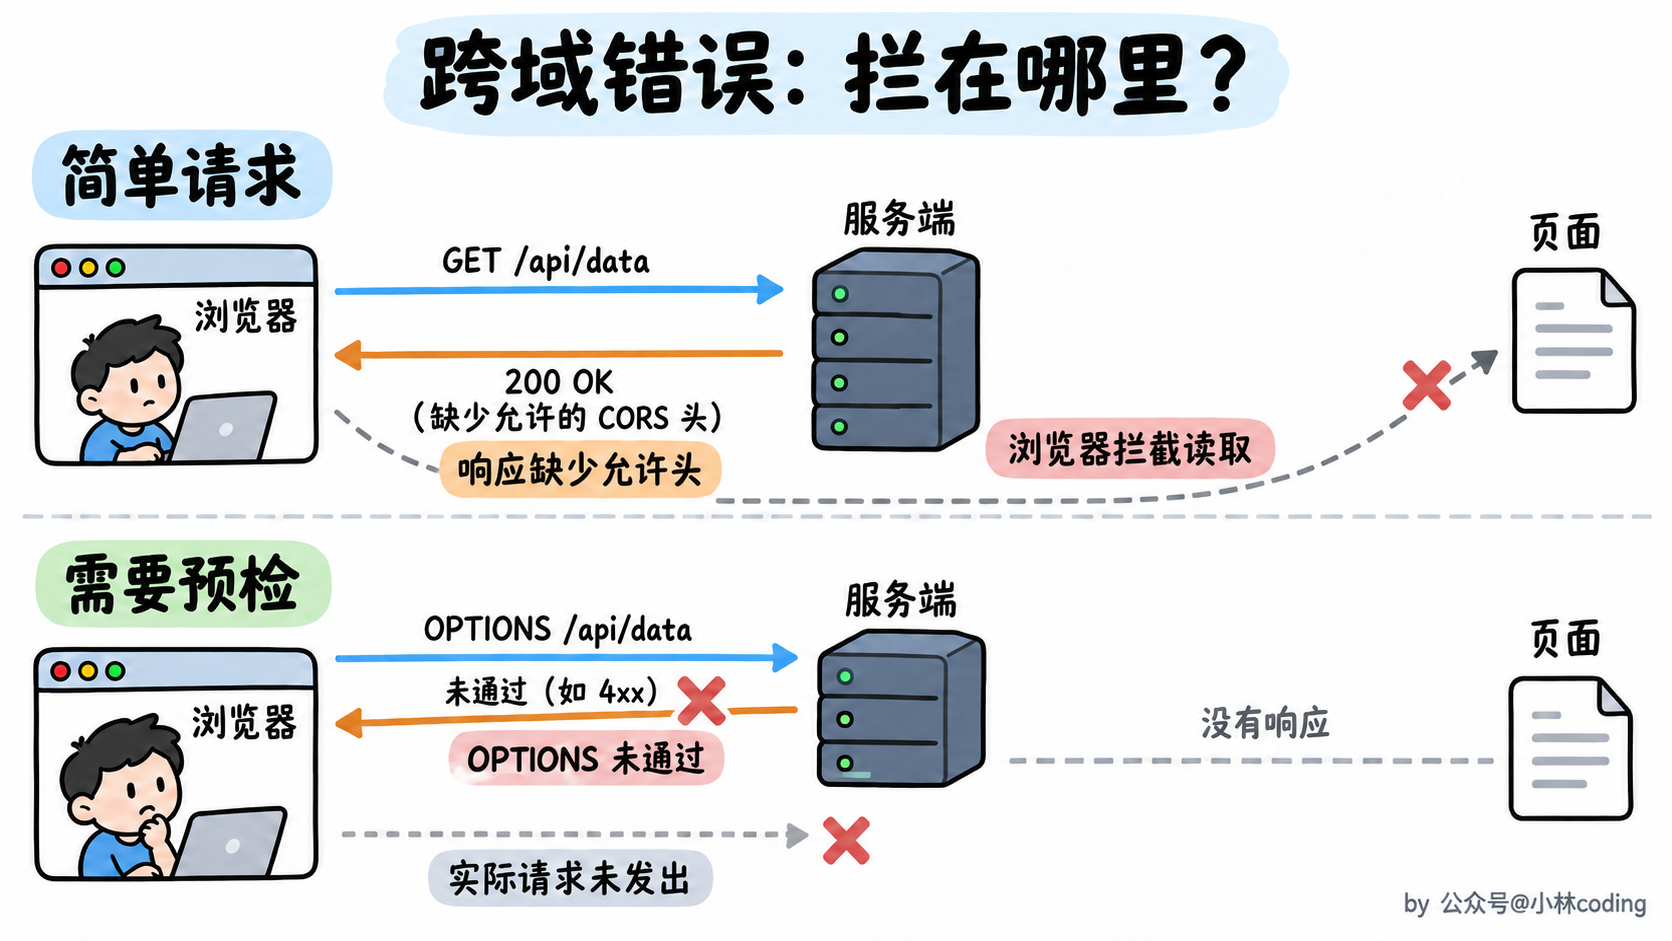
特别容易答错的一点是:**出现跨域错误,不代表请求一定没发到服务器。**简单请求可能已经执行了,只是浏览器不让页面读取响应,所以 CORS 不能当作通用的 CSRF 防护,也不能代替服务端鉴权。
# 正向代理和反向代理有什么区别?
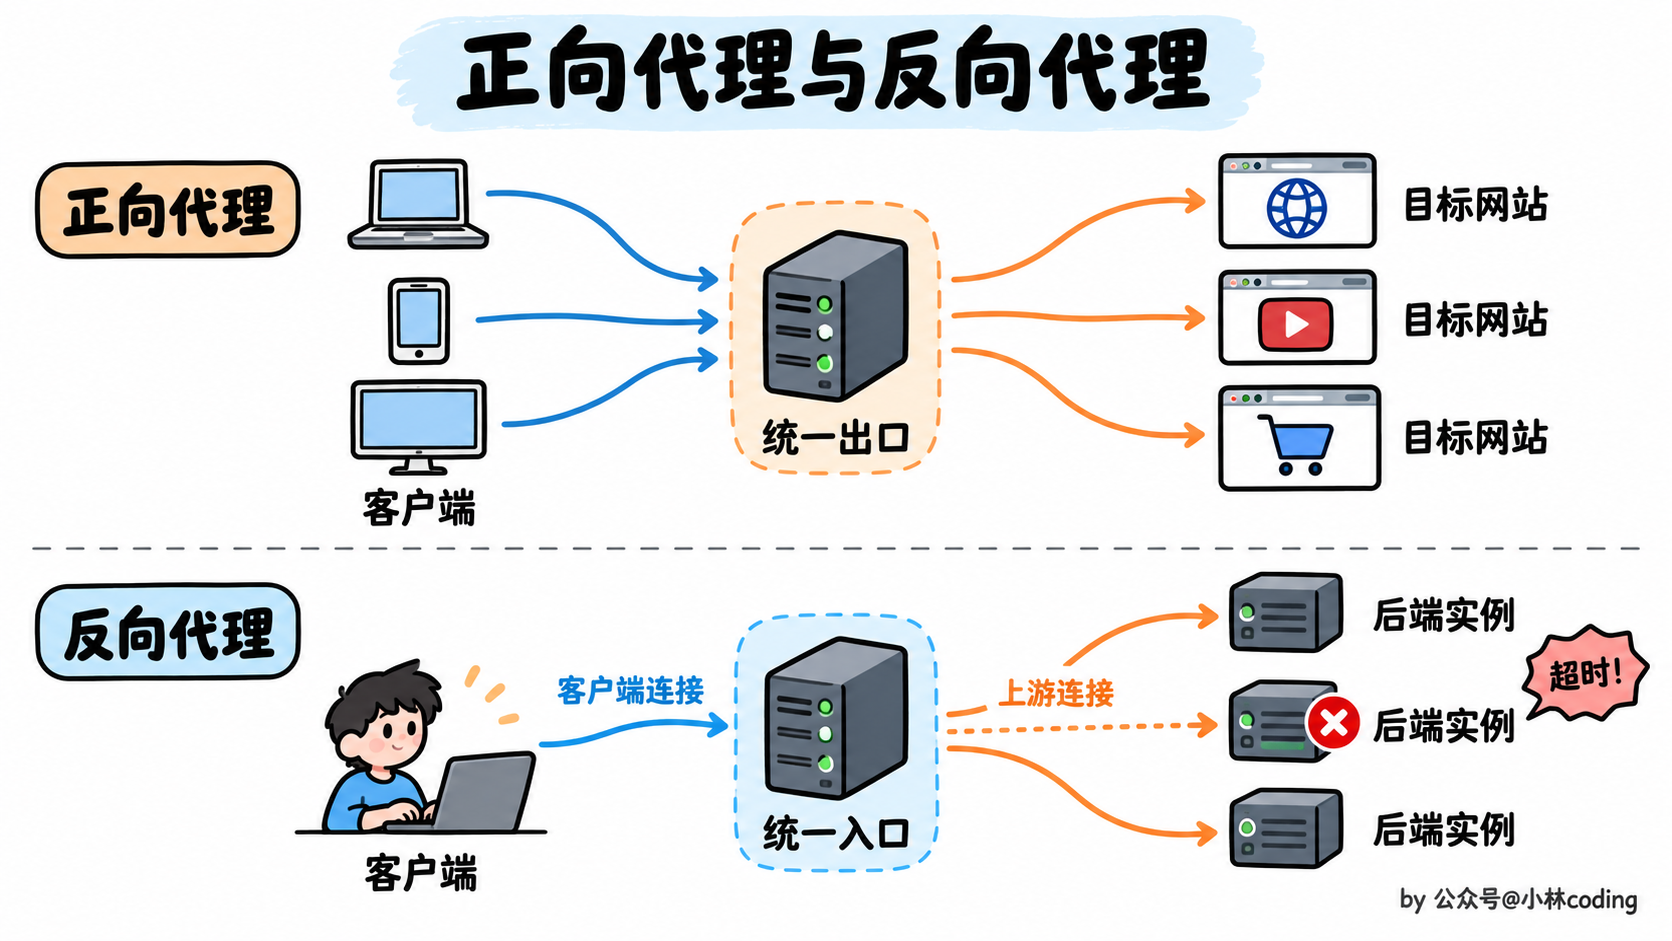
正向代理主要替客户端访问服务器,反向代理主要替服务器接收客户端请求。
比如公司员工通过统一代理访问外部网站,这是正向代理。客户端把请求交给代理,再由代理访问目标服务器。
网站前面放一层 Nginx,把请求分配给后端多个服务实例,这是反向代理。用户访问的是网站的统一入口,不需要知道后面具体是哪台机器处理。
反向代理通常还能做 TLS 终止、负载均衡、缓存和限流。实际排查时,要把「客户端到代理」和「代理到后端」当作两段连接来看,前一段正常不代表后一段也正常。
# CDN 是怎么加速访问的?
CDN 的核心是把内容缓存到靠近用户的边缘节点,减少到源站的传输距离和重复请求。
一个典型过程是:
- 用户访问网站,DNS 或其他调度机制把请求引导到合适的 CDN 节点。
- 节点命中有效缓存,就直接返回资源。
- 没有命中,或者缓存需要更新,就向源站请求内容,这个过程叫回源,然后按缓存规则保存和返回。
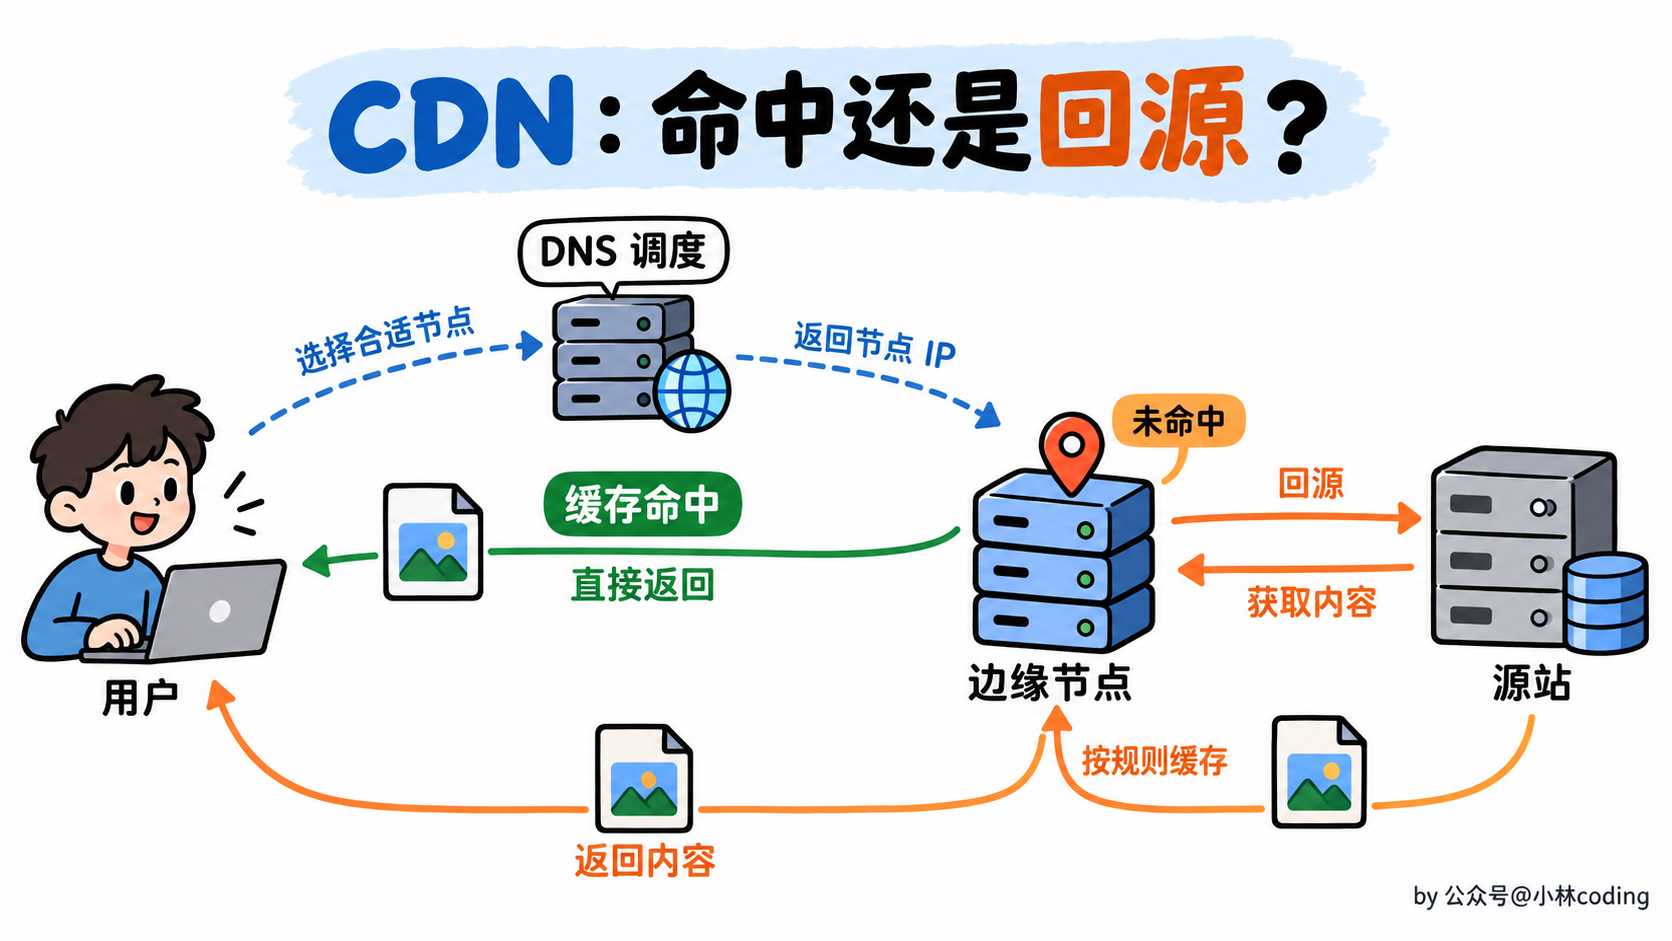
比如一张图片被全国各地的用户反复访问,没有 CDN 时都要跑到源站下载;有了 CDN,就可以在多个地区的边缘节点复用缓存。
CDN 是否有效还要看缓存命中率、回源耗时和资源类型。用户登录信息、个人订单等内容不能随便放进共享缓存,缓存 key 和缓存规则配错了,可能把一个用户的数据返回给另一个用户。
# Nginx有哪些负载均衡算法?
常见的有以下几种:
- 轮询:默认方式,依次把请求分配给后端服务器,也可以通过 weight 配置权重,让处理能力强的节点承担更多请求。
- 最少连接 least_conn:优先选择活跃连接较少的后端,适合不同请求耗时差异较大的场景。不过连接少不一定代表 CPU 负载低。
- IP 哈希 ip_hash:根据客户端 IP 选择后端,可以做一定程度的会话保持。但多个用户经过同一个 NAT 出口时,可能集中到同一个节点。
- 通用哈希 hash:根据指定的 key 选择后端,比如使用请求 URI。加上 consistent 可以使用一致性哈希,减少节点变化时的映射调整。
- 最短时间 least_time:结合响应时间和连接情况选择后端,这是 NGINX Plus 的能力,不能当作所有开源 Nginx 都默认具备的功能。
面试里最好把算法和场景对应起来,比如静态资源缓存可以考虑按 URI 做哈希,耗时不均的请求可以考虑 least_conn。会话保持不是 Session 共享的替代品,节点故障时仍然要考虑会话能不能在其他节点继续使用。
# Nginx位于七层网络结构中的哪一层?
要看使用哪个模块。
- 使用 HTTP 模块做反向代理时,会解析请求的域名、路径、头部等信息,通常说它是七层负载均衡。
- 使用 stream 模块代理 TCP、UDP 时,主要按连接或数据流转发,通常说它是四层负载均衡。
所以不能直接说「Nginx 只能工作在应用层」。同一个 Nginx 可以按配置提供不同层面的代理能力。
# 传输层
# 一条 TCP 连接是由什么唯一确定的?
通常由源 IP、源端口、目的 IP、目的端口这四个字段确定,也就是四元组。
比如一个服务监听 443 端口,可以同时接受很多客户端连接。虽然它们的服务端 IP 和端口相同,但客户端的 IP 或端口不同,内核就能区分不同连接。
因此,不能因为端口号只有 16 位,就说一台服务器最多只能建立约 6 万条 TCP 连接。连接数还取决于四元组组合、文件描述符、内存和应用处理能力;客户端向固定目标主动建连时,可用源端口则可能成为限制。
如果连接经过 NAT,转换设备还需要维护对应的映射,NAT 的端口和状态表也可能限制连接数量。
# 说一下tcp的头部
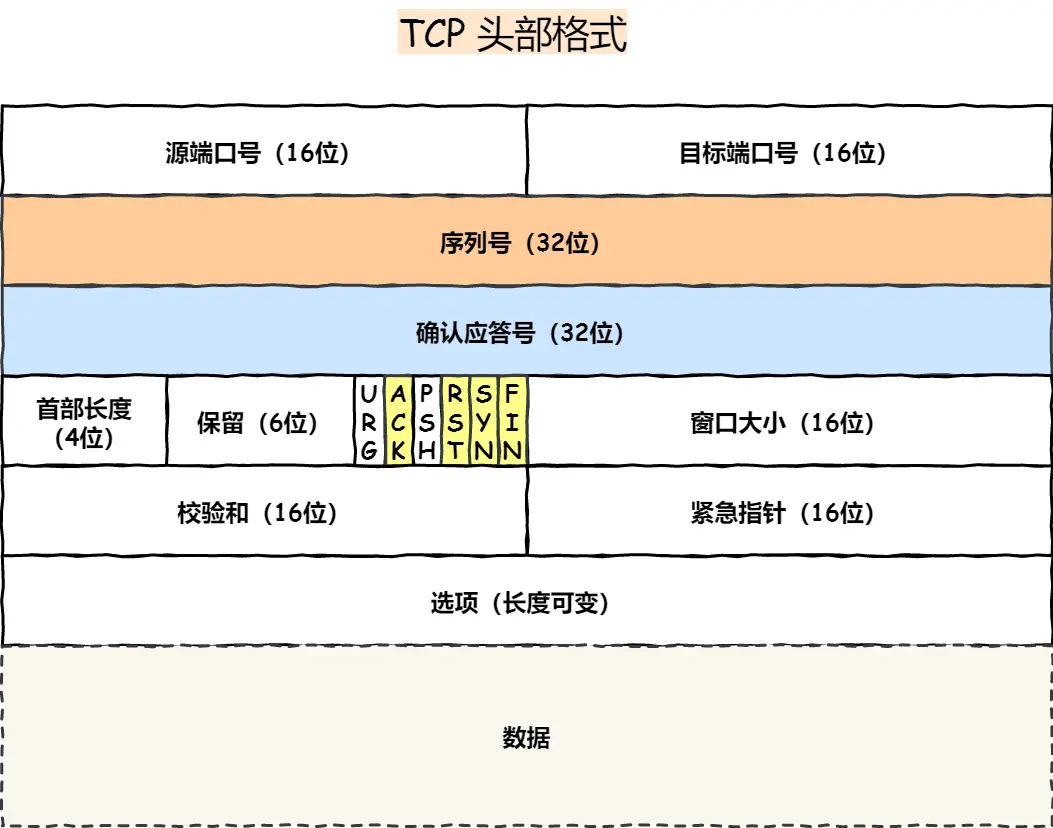
TCP 首部最少是 20 字节,带选项时最多是 60 字节。常见字段除了图里的源端口、目的端口,还有序列号、确认号、窗口大小、校验和及控制位。
窗口大小:接收方通告还能接收多少数据,用于流量控制。
校验和:检测报文在传输中是否发生损坏,它不是用于抵抗攻击的密码学校验。
下面重点说序列号、确认号和控制位。
序列号:在建立连接时由计算机生成的随机数作为其初始值,通过 SYN 包传给接收端主机,每发送一次数据,就「累加」一次该「数据字节数」的大小。用来解决网络包乱序问题。
确认应答号:指下一次「期望」收到的数据的序列号,发送端收到这个确认应答以后可以认为在这个序号以前的数据都已经被正常接收。用来解决丢包的问题。
控制位:
- ACK:该位为 1 时,「确认应答」的字段变为有效,连接建立后的数据报文通常会带 ACK,但不能说所有其他报文都必须带 ACK,比如某些 RST 报文就可以不带。
- RST:该位为 1 时,表示 TCP 连接中出现异常必须强制断开连接。
- SYN:该位为 1 时,表示希望建立连接,并在其「序列号」的字段进行序列号初始值的设定。
- FIN:该位为 1 时,表示今后不会再有数据发送,希望断开连接。当通信结束希望断开连接时,通信双方的主机之间就可以相互交换 FIN 位为 1 的 TCP 段。
# TCP三次握手过程说一下?
TCP 是面向连接的协议,所以使用 TCP 前必须先建立连接,而建立连接是通过三次握手来进行的。三次握手的过程如下图:
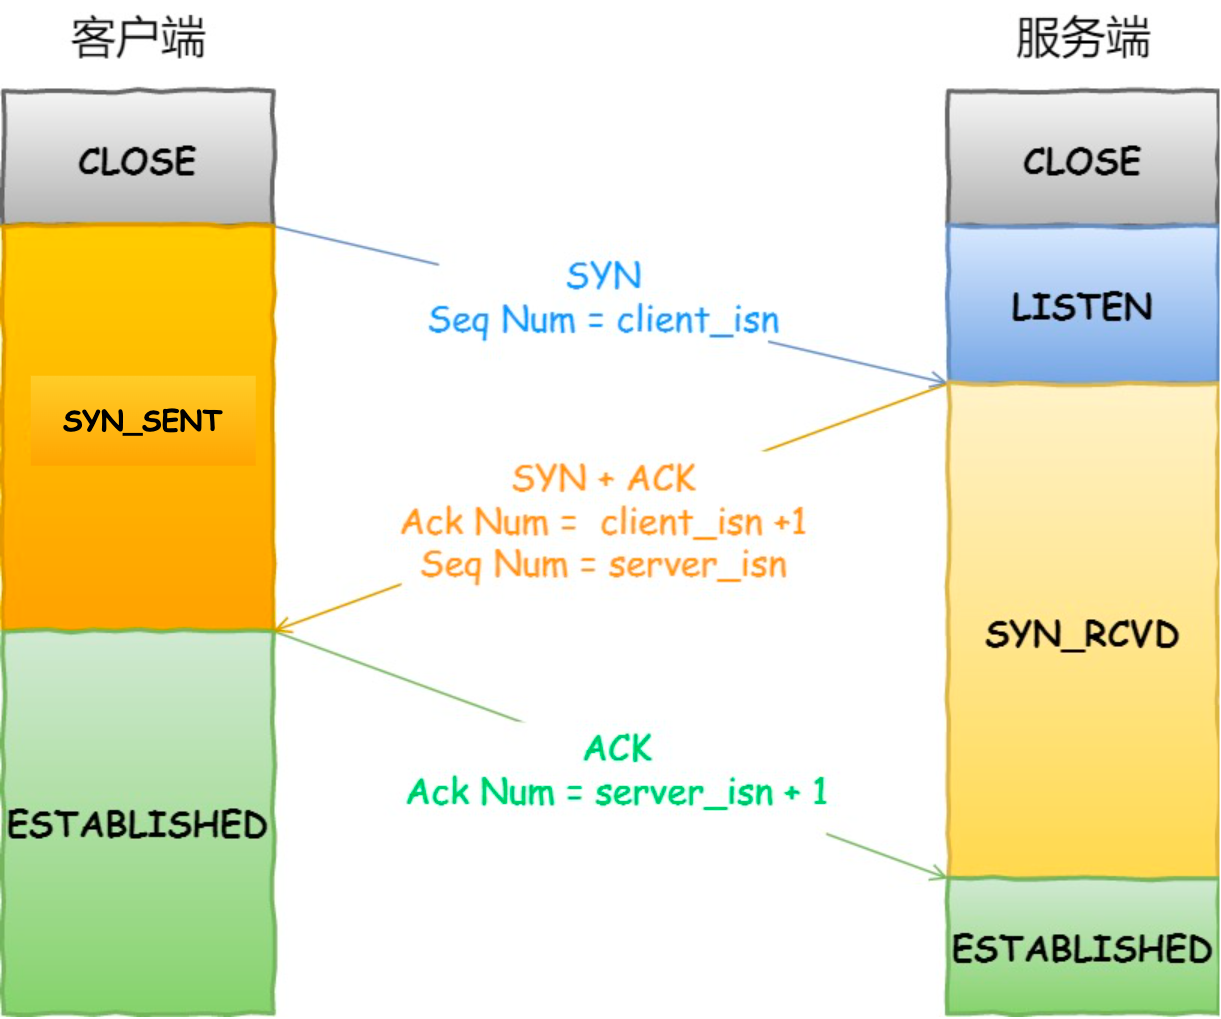
- 一开始,客户端和服务端都处于 CLOSED 状态。先是服务端主动监听某个端口,处于 LISTEN 状态
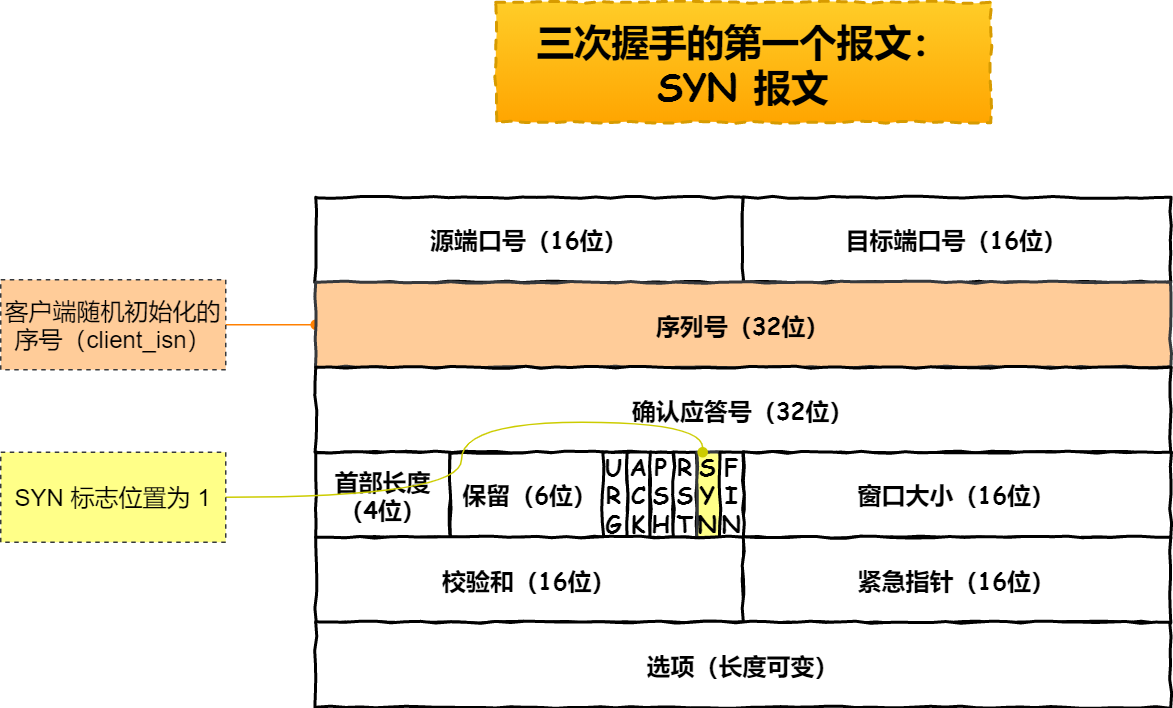
- 客户端会随机初始化序号(client_isn),将此序号置于 TCP 首部的「序号」字段中,同时把 SYN 标志位置为 1,表示 SYN 报文。接着把第一个 SYN 报文发送给服务端,表示向服务端发起连接,该报文不包含应用层数据,之后客户端处于 SYN-SENT 状态。
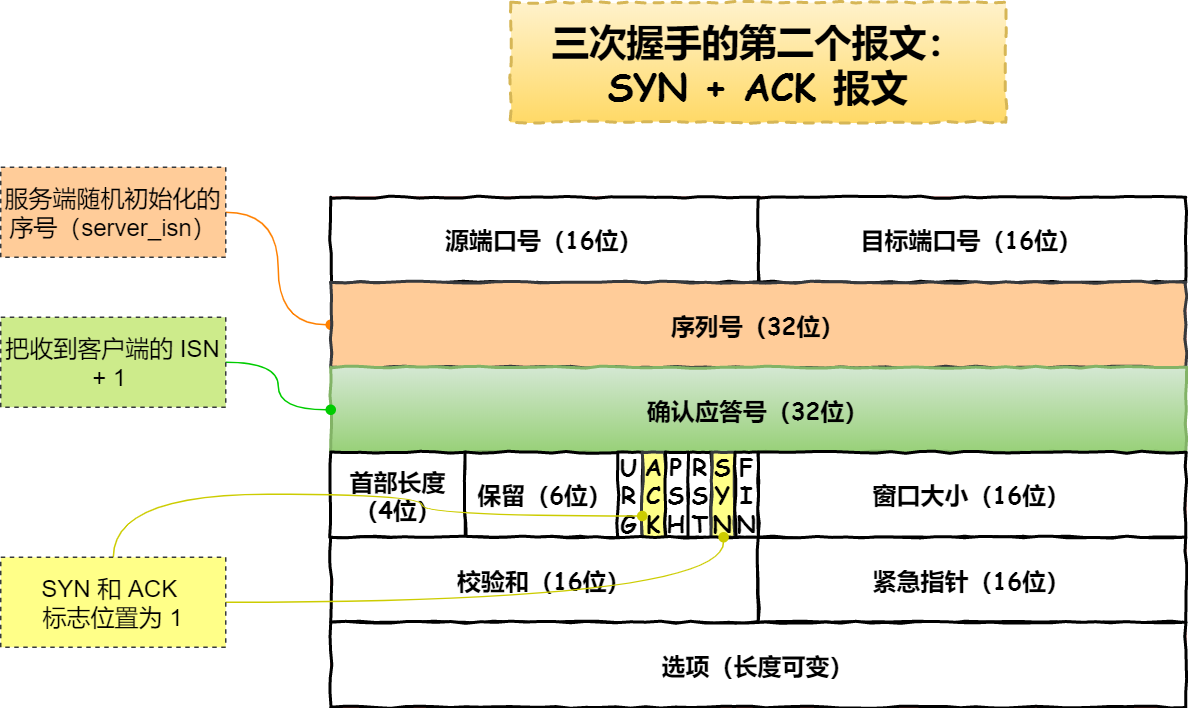
- 服务端收到客户端的 SYN 报文后,首先服务端也随机初始化自己的序号(server_isn),将此序号填入 TCP 首部的「序号」字段中,其次把 TCP 首部的「确认应答号」字段填入 client_isn + 1, 接着把 SYN 和 ACK 标志位置为 1。最后把该报文发给客户端,该报文也不包含应用层数据,之后服务端处于 SYN-RCVD 状态。
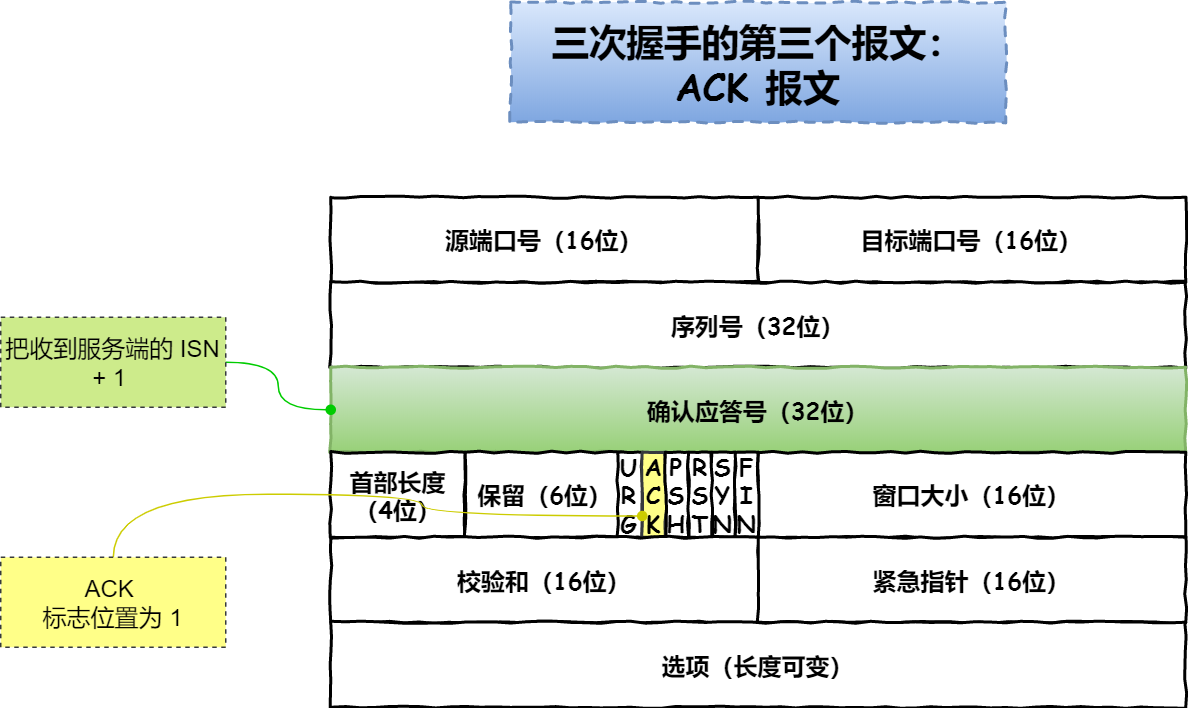
- 客户端收到服务端报文后,还要向服务端回应最后一个应答报文,首先该应答报文 TCP 首部 ACK 标志位置为 1 ,其次「确认应答号」字段填入 server_isn + 1 ,最后把报文发送给服务端,这次报文可以携带客户到服务端的数据,之后客户端处于 ESTABLISHED 状态。
- 服务端收到客户端的应答报文后,也进入 ESTABLISHED 状态。
普通 TCP 三次握手通常不在前两个报文里携带应用数据,第三次握手可以携带数据。不过这不是绝对限制,比如 TCP Fast Open 就允许在满足条件时让 SYN 携带数据。
SYN 会消耗一个序列号,所以确认号是初始序列号加 1;单纯的 ACK 不消耗序列号。
一旦完成三次握手,双方都处于 ESTABLISHED 状态,此时连接就已建立完成,客户端和服务端就可以相互发送数据了。
# tcp为什么需要三次握手建立连接?
三次握手的原因:
- 三次握手才可以阻止重复历史连接的初始化(主要原因)
- 三次握手才可以同步双方的初始序列号
- 三次握手才可以避免资源浪费
原因一:避免历史连接
我们来看看 RFC 793 指出的 TCP 连接使用三次握手的首要原因:
The principle reason for the three-way handshake is to prevent old duplicate connection initiations from causing confusion.
简单来说,三次握手的首要原因是为了防止旧的重复连接初始化造成混乱。
我们考虑一个场景,客户端先发送了 SYN(seq = 90)报文,然后客户端宕机了,而且这个 SYN 报文还被网络阻塞了,服务并没有收到,接着客户端重启后,又重新向服务端建立连接,发送了 SYN(seq = 100)报文(注意!不是重传 SYN,重传的 SYN 的序列号是一样的)。
看看三次握手是如何阻止历史连接的:
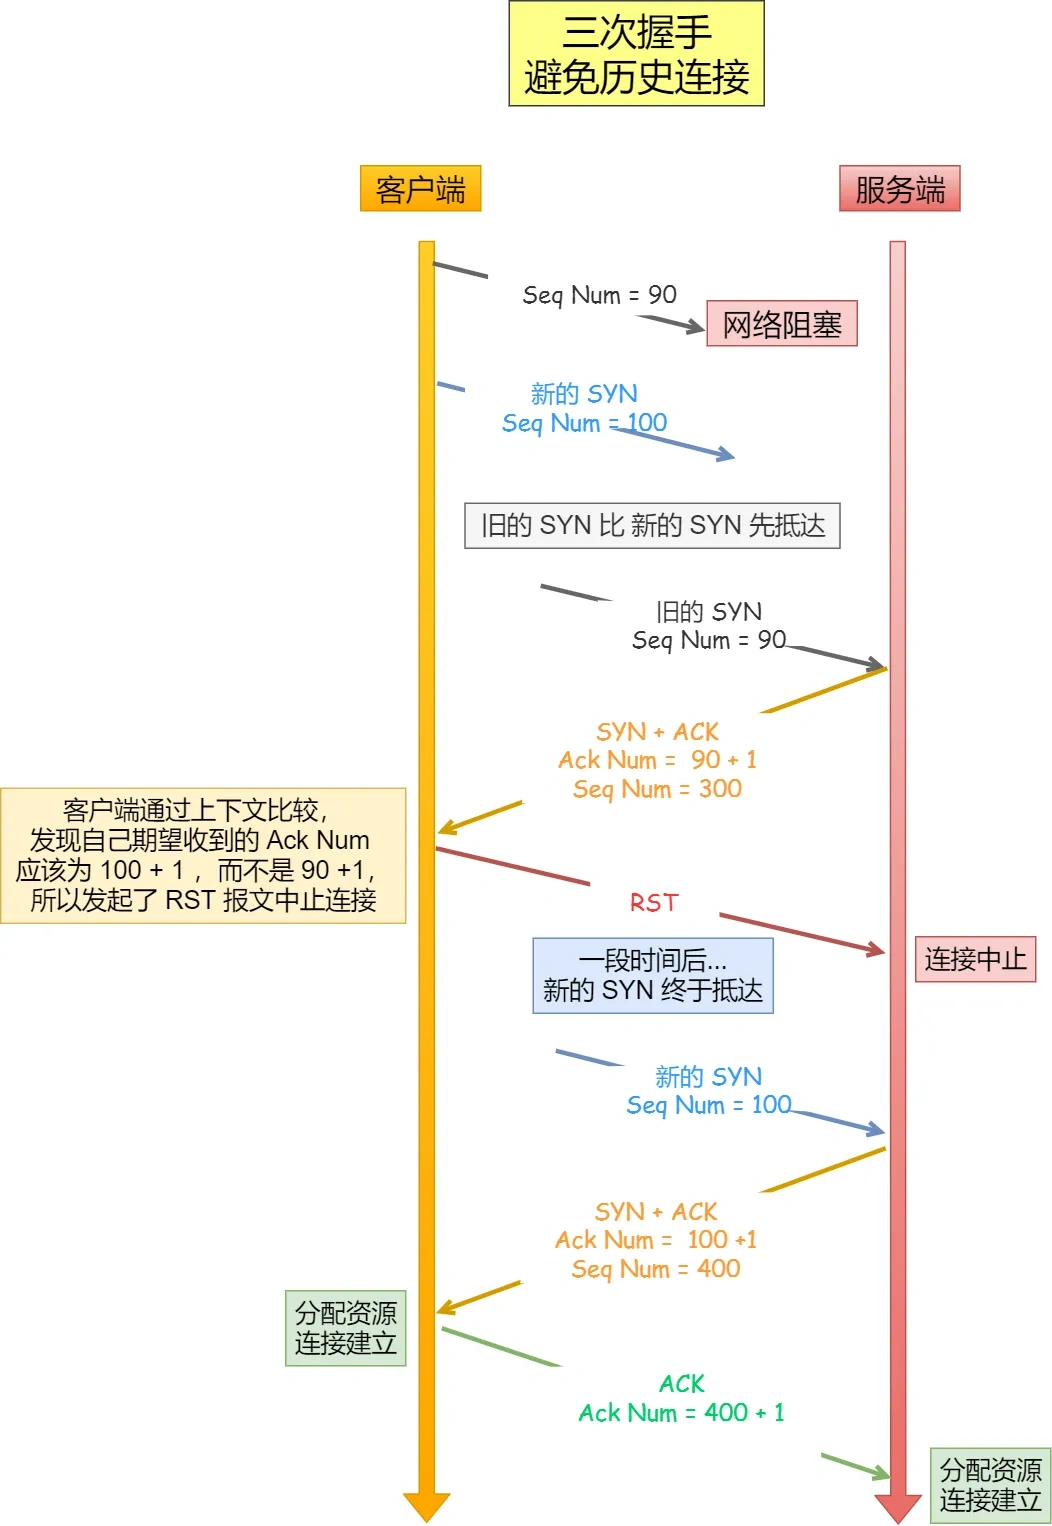
客户端连续发送多次 SYN(都是同一个四元组)建立连接的报文,在网络拥堵情况下:
- 一个「旧 SYN 报文」比「最新的 SYN」 报文早到达了服务端,那么此时服务端就会回一个 SYN + ACK 报文给客户端,此报文中的确认号是 91(90+1)。
- 客户端收到后,发现自己期望收到的确认号应该是 100 + 1,而不是 90 + 1,于是就会回 RST 报文。
- 服务端收到 RST 报文后,就会释放连接。
- 后续最新的 SYN 抵达了服务端后,客户端与服务端就可以正常的完成三次握手了。
上述中的「旧 SYN 报文」称为历史连接,TCP 使用三次握手建立连接的最主要原因就是防止「历史连接」初始化了连接。
如果是两次握手连接,就无法阻止历史连接,那为什么 TCP 两次握手为什么无法阻止历史连接呢?
我先直接说结论,主要是因为在两次握手的情况下,服务端没有中间状态给客户端来阻止历史连接,导致服务端可能建立一个历史连接,造成资源浪费。
你想想,在两次握手的情况下,服务端在收到 SYN 报文后,就进入 ESTABLISHED 状态,意味着这时可以给对方发送数据,但是客户端此时还没有进入 ESTABLISHED 状态,假设这次是历史连接,客户端判断到此次连接为历史连接,那么就会回 RST 报文来断开连接,而在假设的两次握手机制里,服务端发出 SYN + ACK 后就进入 ESTABLISHED 状态,所以它可以发送数据的,但是它并不知道这个是历史连接,它只有在收到 RST 报文后,才会断开连接。
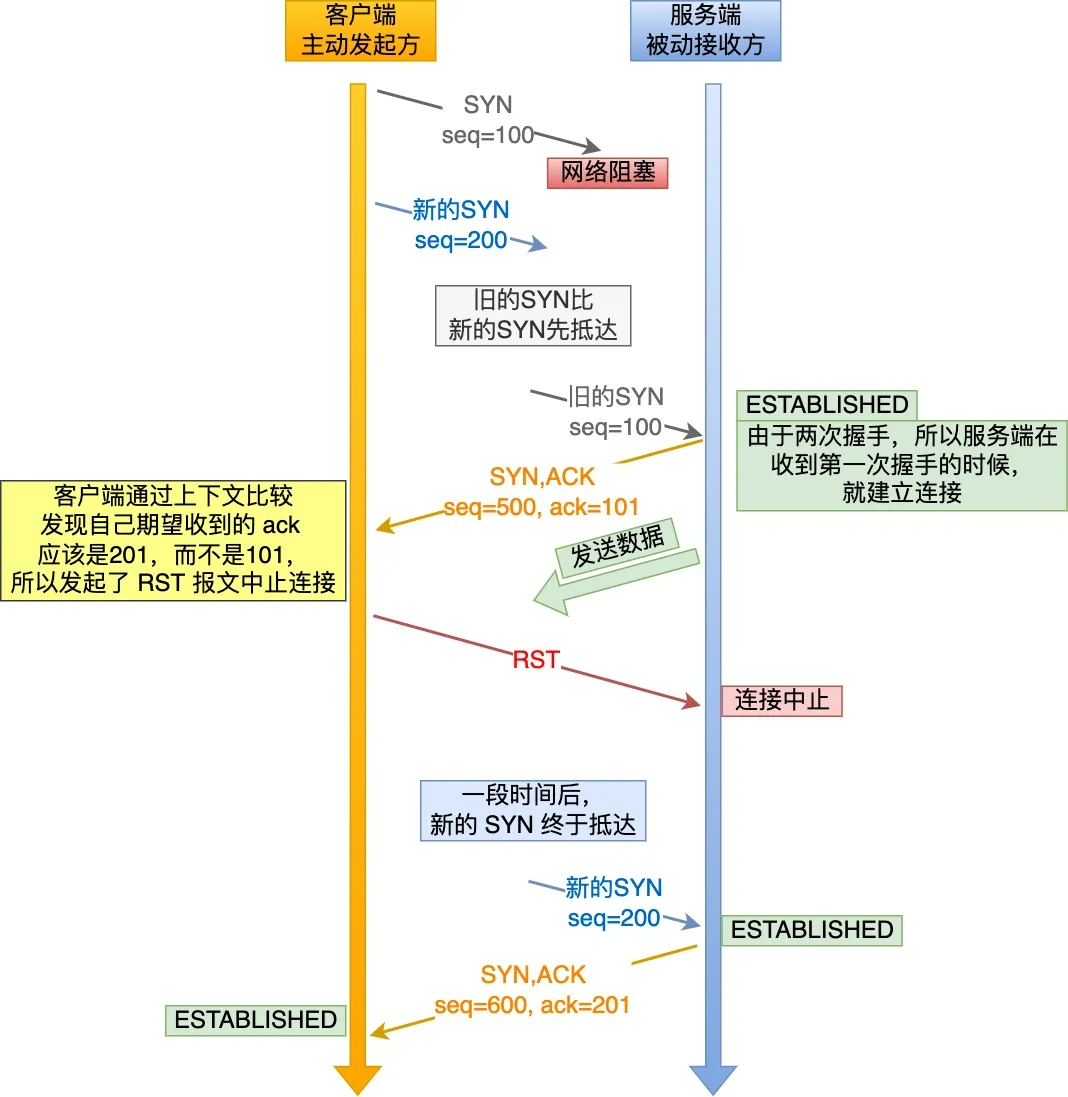
可以看到,如果采用两次握手建立 TCP 连接的场景下,服务端在向客户端发送数据前,并没有阻止掉历史连接,导致服务端建立了一个历史连接,又白白发送了数据,妥妥地浪费了服务端的资源。
因此,要解决这种现象,最好就是在服务端发送数据前,也就是建立连接之前,要阻止掉历史连接,这样就不会造成资源浪费,而要实现这个功能,就需要三次握手。
所以,TCP 使用三次握手建立连接的最主要原因是防止「历史连接」初始化了连接。
原因二:同步双方初始序列号
TCP 协议的通信双方, 都必须维护一个「序列号」, 序列号是可靠传输的一个关键因素,它的作用:
- 接收方可以去除重复的数据;
- 接收方可以根据数据包的序列号按序接收;
- 可以标识发送出去的数据包中, 哪些是已经被对方收到的(通过 ACK 报文中的确认号知道);
可见,序列号在 TCP 连接中占据着非常重要的作用,所以当客户端发送携带「初始序列号」的 SYN 报文的时候,需要服务端回一个 ACK 应答报文,表示客户端的 SYN 报文已被服务端成功接收,那当服务端发送「初始序列号」给客户端的时候,依然也要得到客户端的应答回应,这样一来一回,才能确保双方的初始序列号能被可靠的同步。
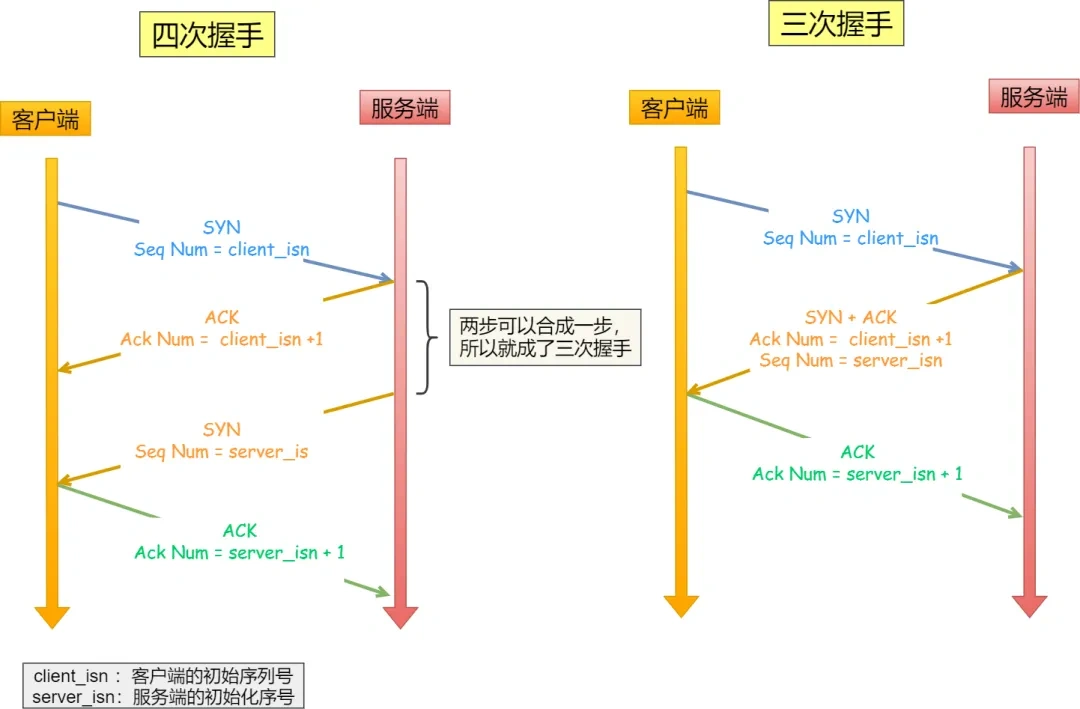
四次握手与三次握手
四次握手其实也能够可靠的同步双方的初始化序号,但由于第二步和第三步可以优化成一步,所以就成了「三次握手」。
而两次握手只保证了一方的初始序列号能被对方成功接收,没办法保证双方的初始序列号都能被确认接收。
原因三:避免资源浪费
如果只有两次握手,服务端发出 SYN + ACK 后就认为连接已经建立,但它并不知道客户端是否收到并接受了这个响应。
比如一个旧 SYN 在网络里绕了很久,才到达服务端。客户端已经不再需要这条连接,如果服务端直接建立完整连接并发送业务数据,就会白白占用资源。
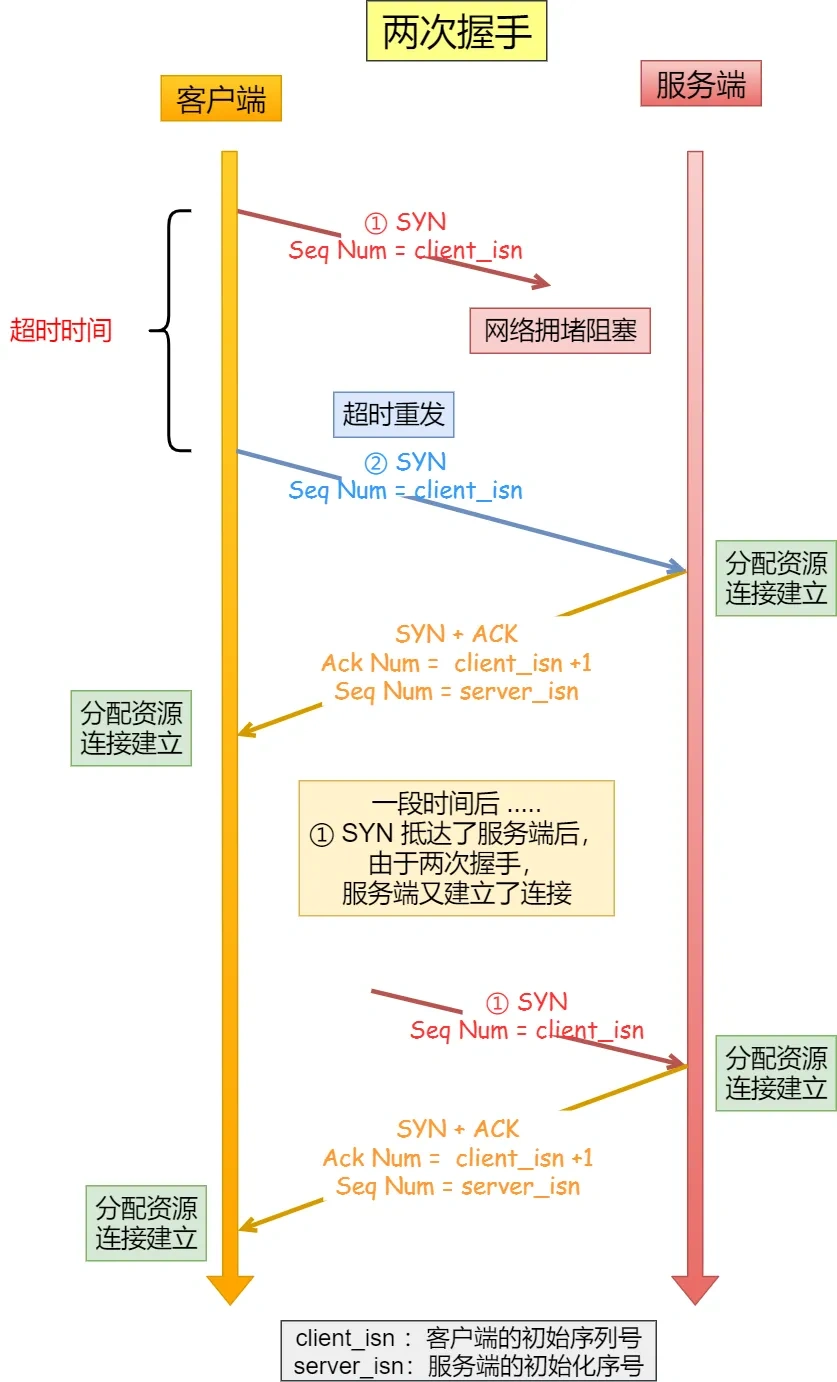
三次握手让服务端在得到客户端的确认之后,再建立正常的完整连接。不过,第三次握手到达前,服务端通常仍然要占用半连接资源,所以三次握手不能直接消除 SYN Flood 的风险。
还要注意,同一连接的 SYN 重传具有相同的序列号,服务端一般会识别为重传,不能简单说「每收到一个重复 SYN,就创建一条新连接」。
# TCP 三次握手,客户端第三次发送的确认包丢失了发生什么?
客户端收到服务端的 SYN-ACK 报文后,就会给服务端回一个 ACK 报文,也就是第三次握手,此时客户端状态进入到 ESTABLISHED 状态。
因为这个第三次握手的 ACK 是对第二次握手的 SYN 的确认报文,所以当第三次握手丢失了,如果服务端那一方迟迟收不到这个确认报文,就会触发超时重传机制,重传 SYN-ACK 报文,直到收到第三次握手,或者达到最大重传次数。
注意,纯 ACK 不会像数据或 SYN 那样启动自己的超时重传定时器。服务端重传 SYN-ACK 后,客户端会再次回复 ACK。如果第三次握手携带了数据,那么数据仍然受重传机制保护。
还有一种情况:客户端已经进入 ESTABLISHED 并发送了数据,数据报文也会携带有效 ACK。如果服务端收到的报文满足握手完成条件,也可以据此完成握手,不一定非要等最开始的那个纯 ACK。
举个例子,假设 tcp_synack_retries 参数值为 2,那么当第三次握手一直丢失时,发生的过程如下图:
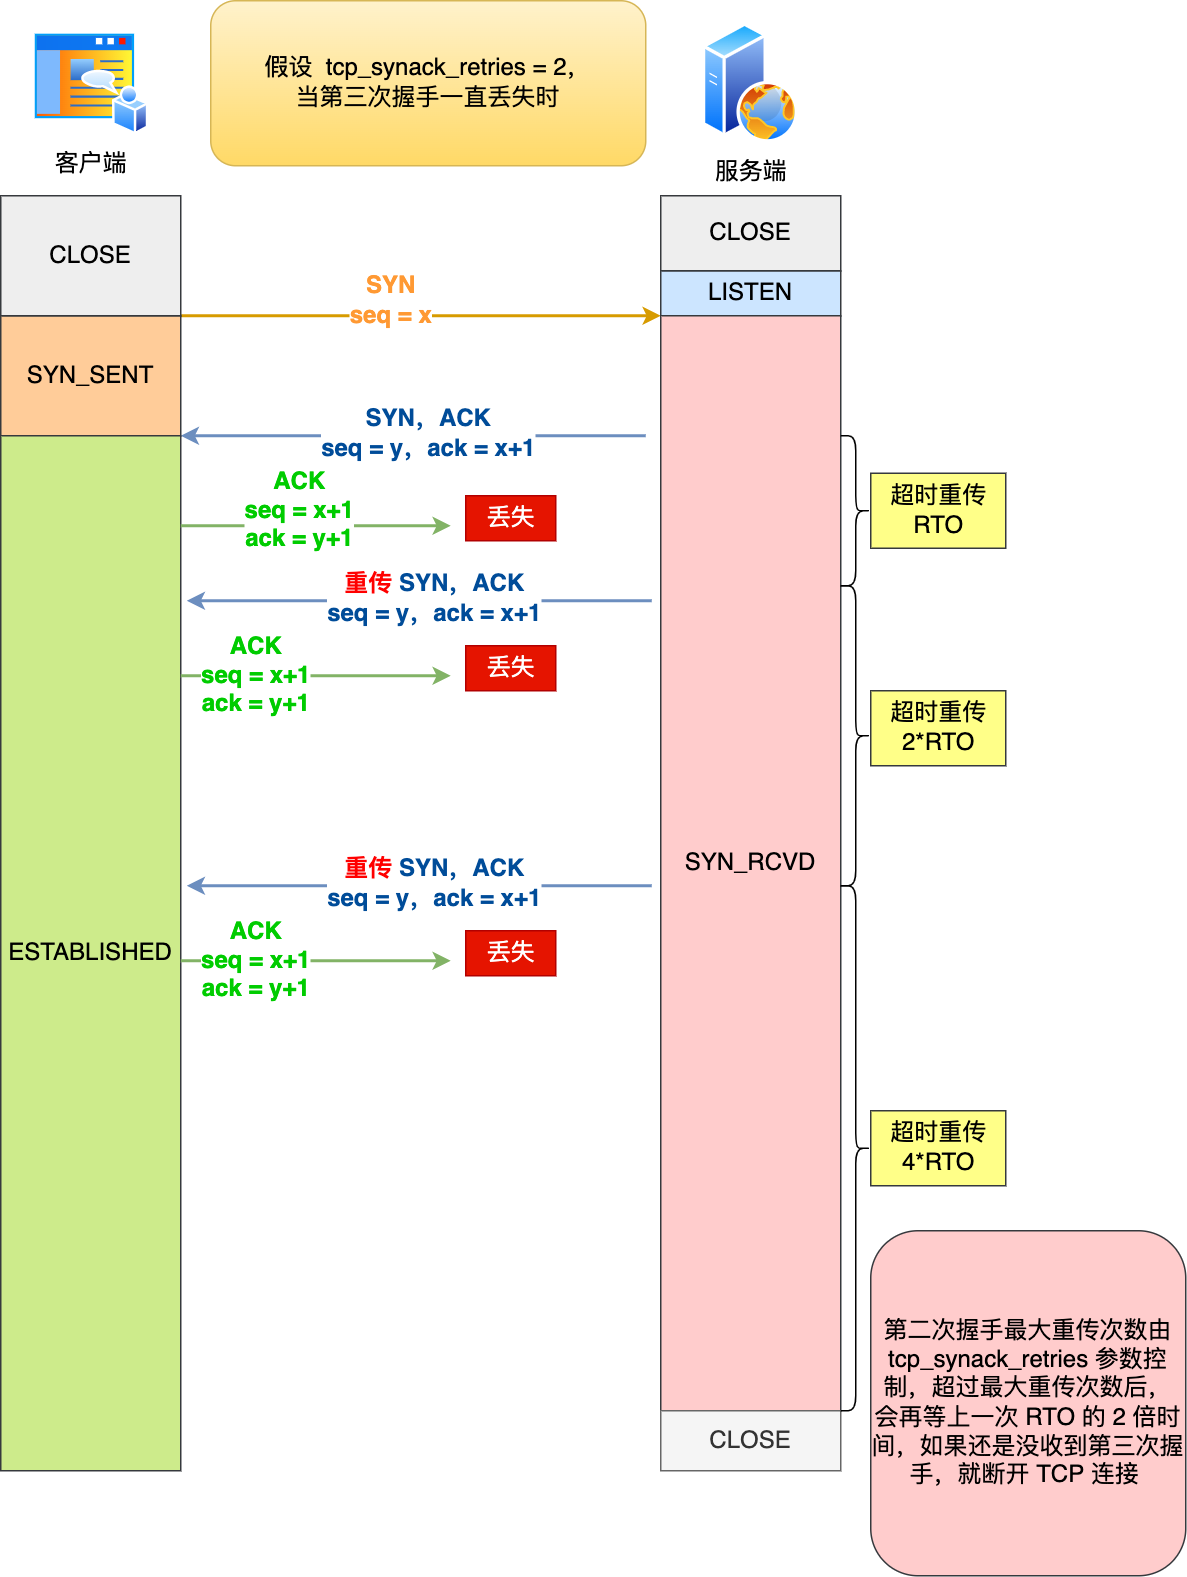
具体过程:
- 当服务端超时重传 2 次 SYN-ACK 报文后,由于 tcp_synack_retries 为 2,已达到最大重传次数,于是再等待一段时间(时间为上一次超时时间的 2 倍),如果还是没能收到客户端的第三次握手(ACK 报文),那么服务端就会断开连接。
# 服务端发送第二个报文后连接的状态进入什么状态
进入 SYN_RCVD,表示已经收到了客户端的 SYN,并发出了自己的 SYN + ACK,正在等待客户端确认。
客户端此时可能还在 SYN_SENT,也可能已经收到 SYN + ACK 并进入 ESTABLISHED,不能认为两端状态总是同步变化。
# 三次握手和 accept 是什么关系? accept 做了哪些事情?
三次握手由内核完成,accept 负责取出已经建立的连接,不负责发起或完成握手。
服务端调用 listen 后,内核开始处理连接请求。正常完成三次握手的连接会进入全连接队列,也叫 accept 队列,等待应用程序取走。
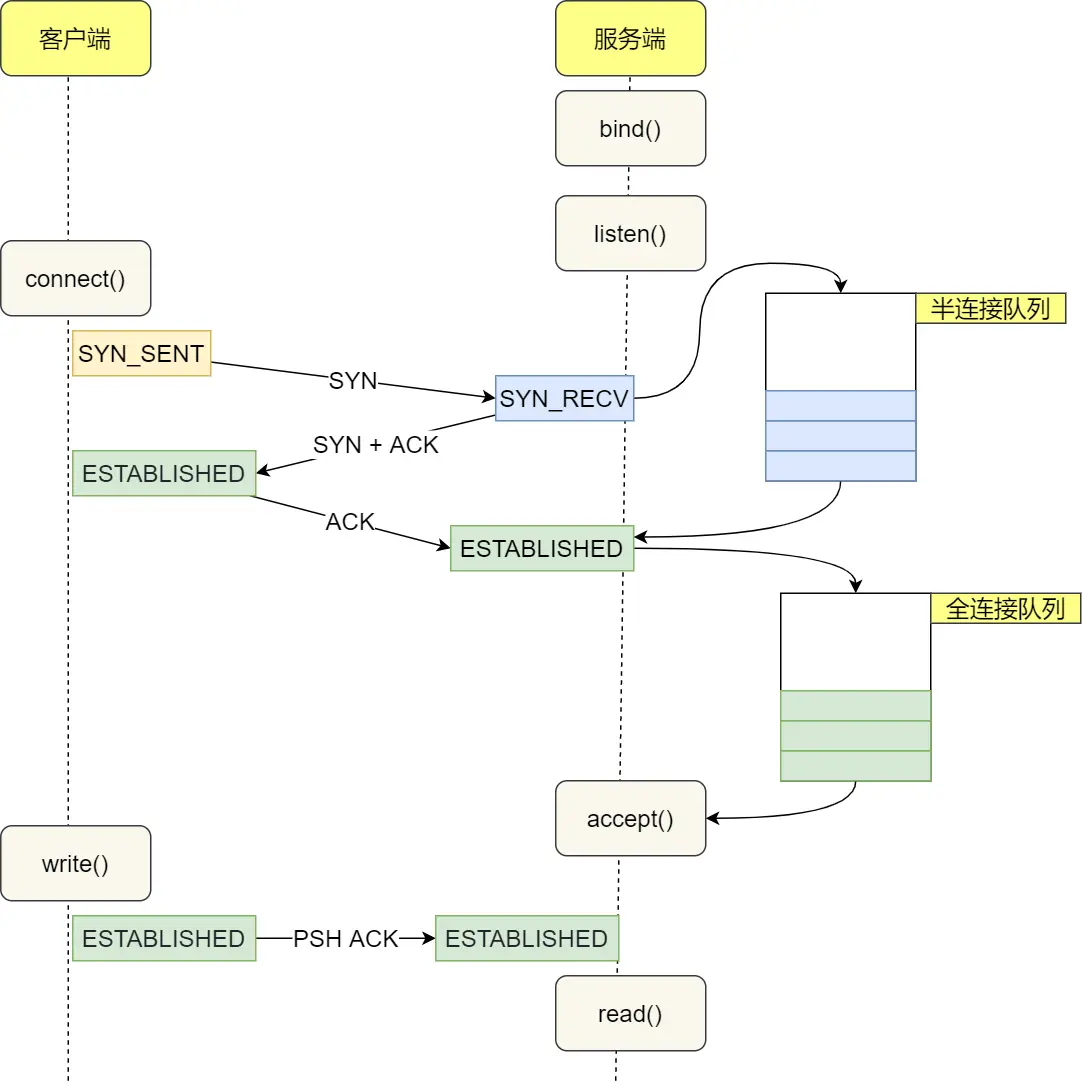
应用调用 accept 时,会从队列中取出连接,返回一个新的已连接 socket 文件描述符,后续用这个描述符收发数据。原来的监听 socket 继续接收其他连接。
队列为空时,阻塞 accept 会等待;非阻塞 accept 会返回 EAGAIN 或 EWOULDBLOCK。即使应用暂时没有调用 accept,内核也可能已经完成握手并接收数据,只是如果应用长期不取连接,全连接队列可能被占满。
# 客户端发送的第一个 SYN 报文,服务器没有收到怎么办?
客户端发送 SYN 后进入 SYN_SENT。如果一直没有收到服务端的 SYN + ACK,就会超时重传 SYN,同一次连接的 SYN 重传使用相同的初始序列号。
在 Linux 中,可以通过下面的参数查看主动建连的 SYN 重试配置:
cat /proc/sys/net/ipv4/tcp_syn_retries
具体重试次数和间隔要看内核版本、系统配置及 socket 选项,不能把「默认一定重传 5 次、一定等 63 秒」当成所有系统的规则。
如果按初始超时 1 秒、指数退避、最多重传 5 次的简化模型举例,重传前的等待时间依次是 1、2、4、8、16 秒,最后再等 32 秒,总共 63 秒。这些是每一轮的等待时长,不是从第一次发包起算的重传时刻。
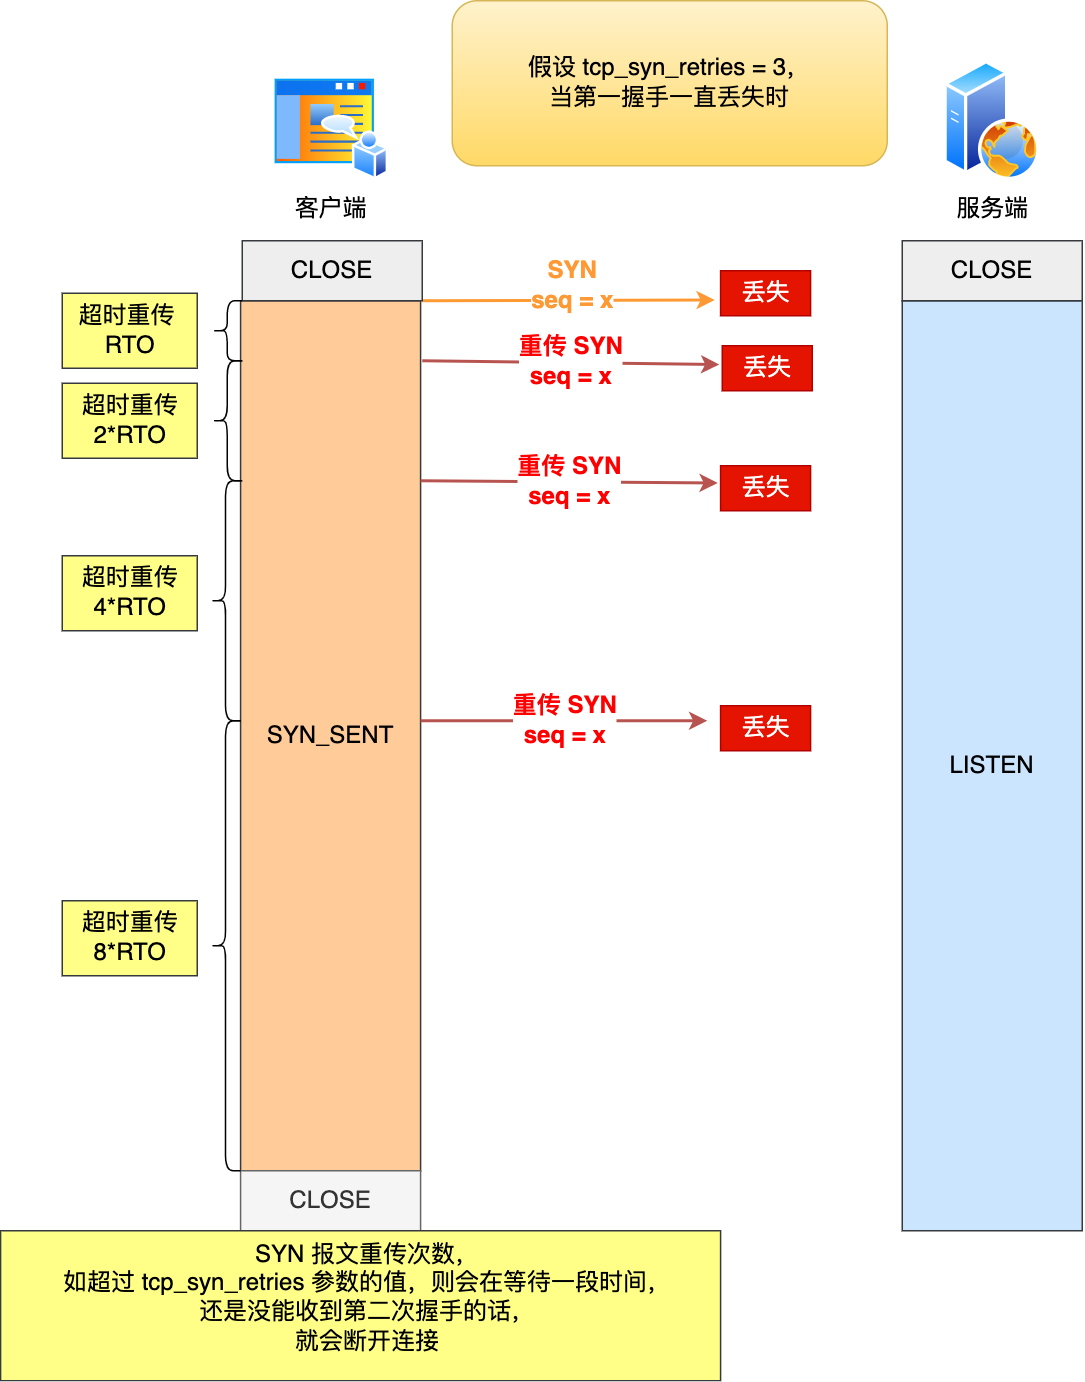
部分较新的 Linux 内核还支持 tcp_syn_linear_timeouts,可能先使用若干次相同间隔,再进入指数退避。实际排查应该以本机配置和抓包时间为准。最终超过重试或超时限制,connect 会失败;应用也可以设置更短的建连超时。
# 服务器收到第一个 SYN 报文,回复的 SYN + ACK 报文丢失了怎么办?
当服务端收到客户端的第一次握手后,就会回 SYN-ACK 报文给客户端,这个就是第二次握手,此时服务端会进入 SYN_RCVD 状态。
第二次握手的 SYN-ACK 报文其实有两个目的 :
- 第二次握手里的 ACK, 是对第一次握手的确认报文;
- 第二次握手里的 SYN,是服务端发起建立 TCP 连接的报文;
所以,如果第二次握手丢了,就会发生比较有意思的事情,具体会怎么样呢?
因为第二次握手报文里是包含对客户端的第一次握手的 ACK 确认报文,所以,如果客户端迟迟没有收到第二次握手,那么客户端就觉得可能自己的 SYN 报文(第一次握手)丢失了,于是客户端就会触发超时重传机制,重传 SYN 报文。
然后,因为第二次握手中包含服务端的 SYN 报文,所以当客户端收到后,需要给服务端发送 ACK 确认报文(第三次握手),服务端才会认为该 SYN 报文被客户端收到了。
那么,如果第二次握手丢失了,服务端就收不到第三次握手,于是服务端这边会触发超时重传机制,重传 SYN-ACK 报文。
在 Linux 下,SYN-ACK 报文的最大重传次数由 tcp_synack_retries内核参数决定,默认值是 5。
# cat /proc/sys/net/ipv4/tcp_synack_retries
5
因此,当第二次握手丢失了,客户端和服务端都会重传:
- 客户端会重传 SYN 报文,也就是第一次握手,最大重传次数由 tcp_syn_retries内核参数决定;
- 服务端会重传 SYN-ACK 报文,也就是第二次握手,最大重传次数由 tcp_synack_retries 内核参数决定。
举个例子,假设 tcp_syn_retries 参数值为 1,tcp_synack_retries 参数值为 2,那么当第二次握手一直丢失时,发生的过程如下图:
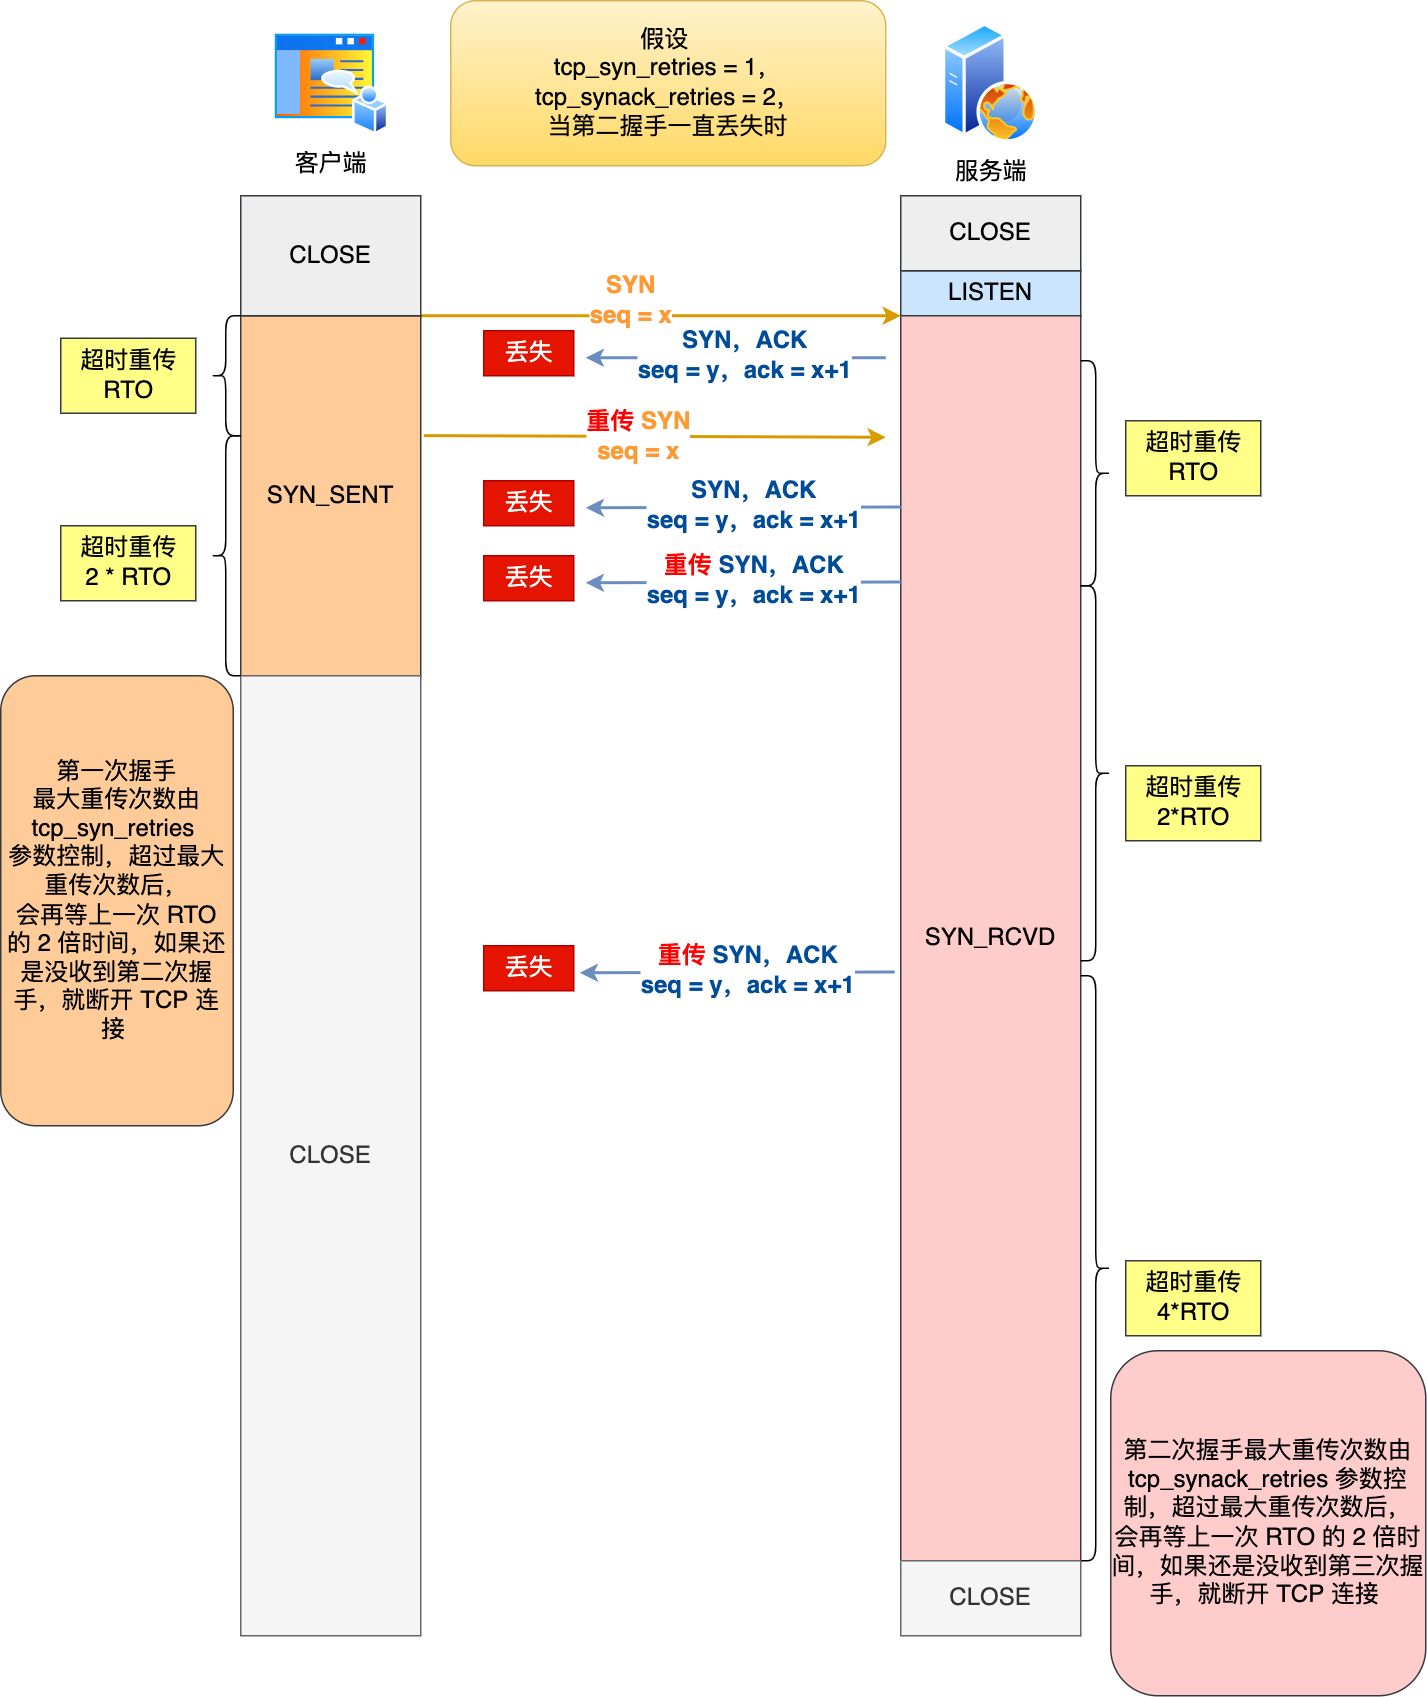
具体过程:
- 当客户端超时重传 1 次 SYN 报文后,由于 tcp_syn_retries 为 1,已达到最大重传次数,于是再等待一段时间(时间为上一次超时时间的 2 倍),如果还是没能收到服务端的第二次握手(SYN-ACK 报文),那么客户端就会断开连接。
- 当服务端超时重传 2 次 SYN-ACK 报文后,由于 tcp_synack_retries 为 2,已达到最大重传次数,于是再等待一段时间(时间为上一次超时时间的 2 倍),如果还是没能收到客户端的第三次握手(ACK 报文),那么服务端就会断开连接。
# 假设客户端重传了 SYN 报文,服务端这边又收到重复的 SYN 报文怎么办?
如果服务端仍然处于 SYN_RCVD,并且收到的是同一个连接、相同初始序列号的 SYN 重传,通常会继续回复 SYN + ACK,等待第三次握手。
这不是再创建一条完整连接。如果连接已经建立,或者新 SYN 的序列号不同,就要根据当前状态和序列号等规则处理,不能把所有 SYN 都当成相同的重传。
# 第一次握手,服务端收到 SYN 并回复 SYN + ACK 时,内部做了哪些工作?
服务端收到客户端发起的 SYN 请求后,内核会把该连接存储到半连接队列,并向客户端响应 SYN+ACK,接着客户端会返回 ACK,服务端收到第三次握手的 ACK 后,内核会把连接从半连接队列移除,然后创建新的完全的连接,并将其添加到 accept 队列,等待进程调用 accept 函数时把连接取出来。
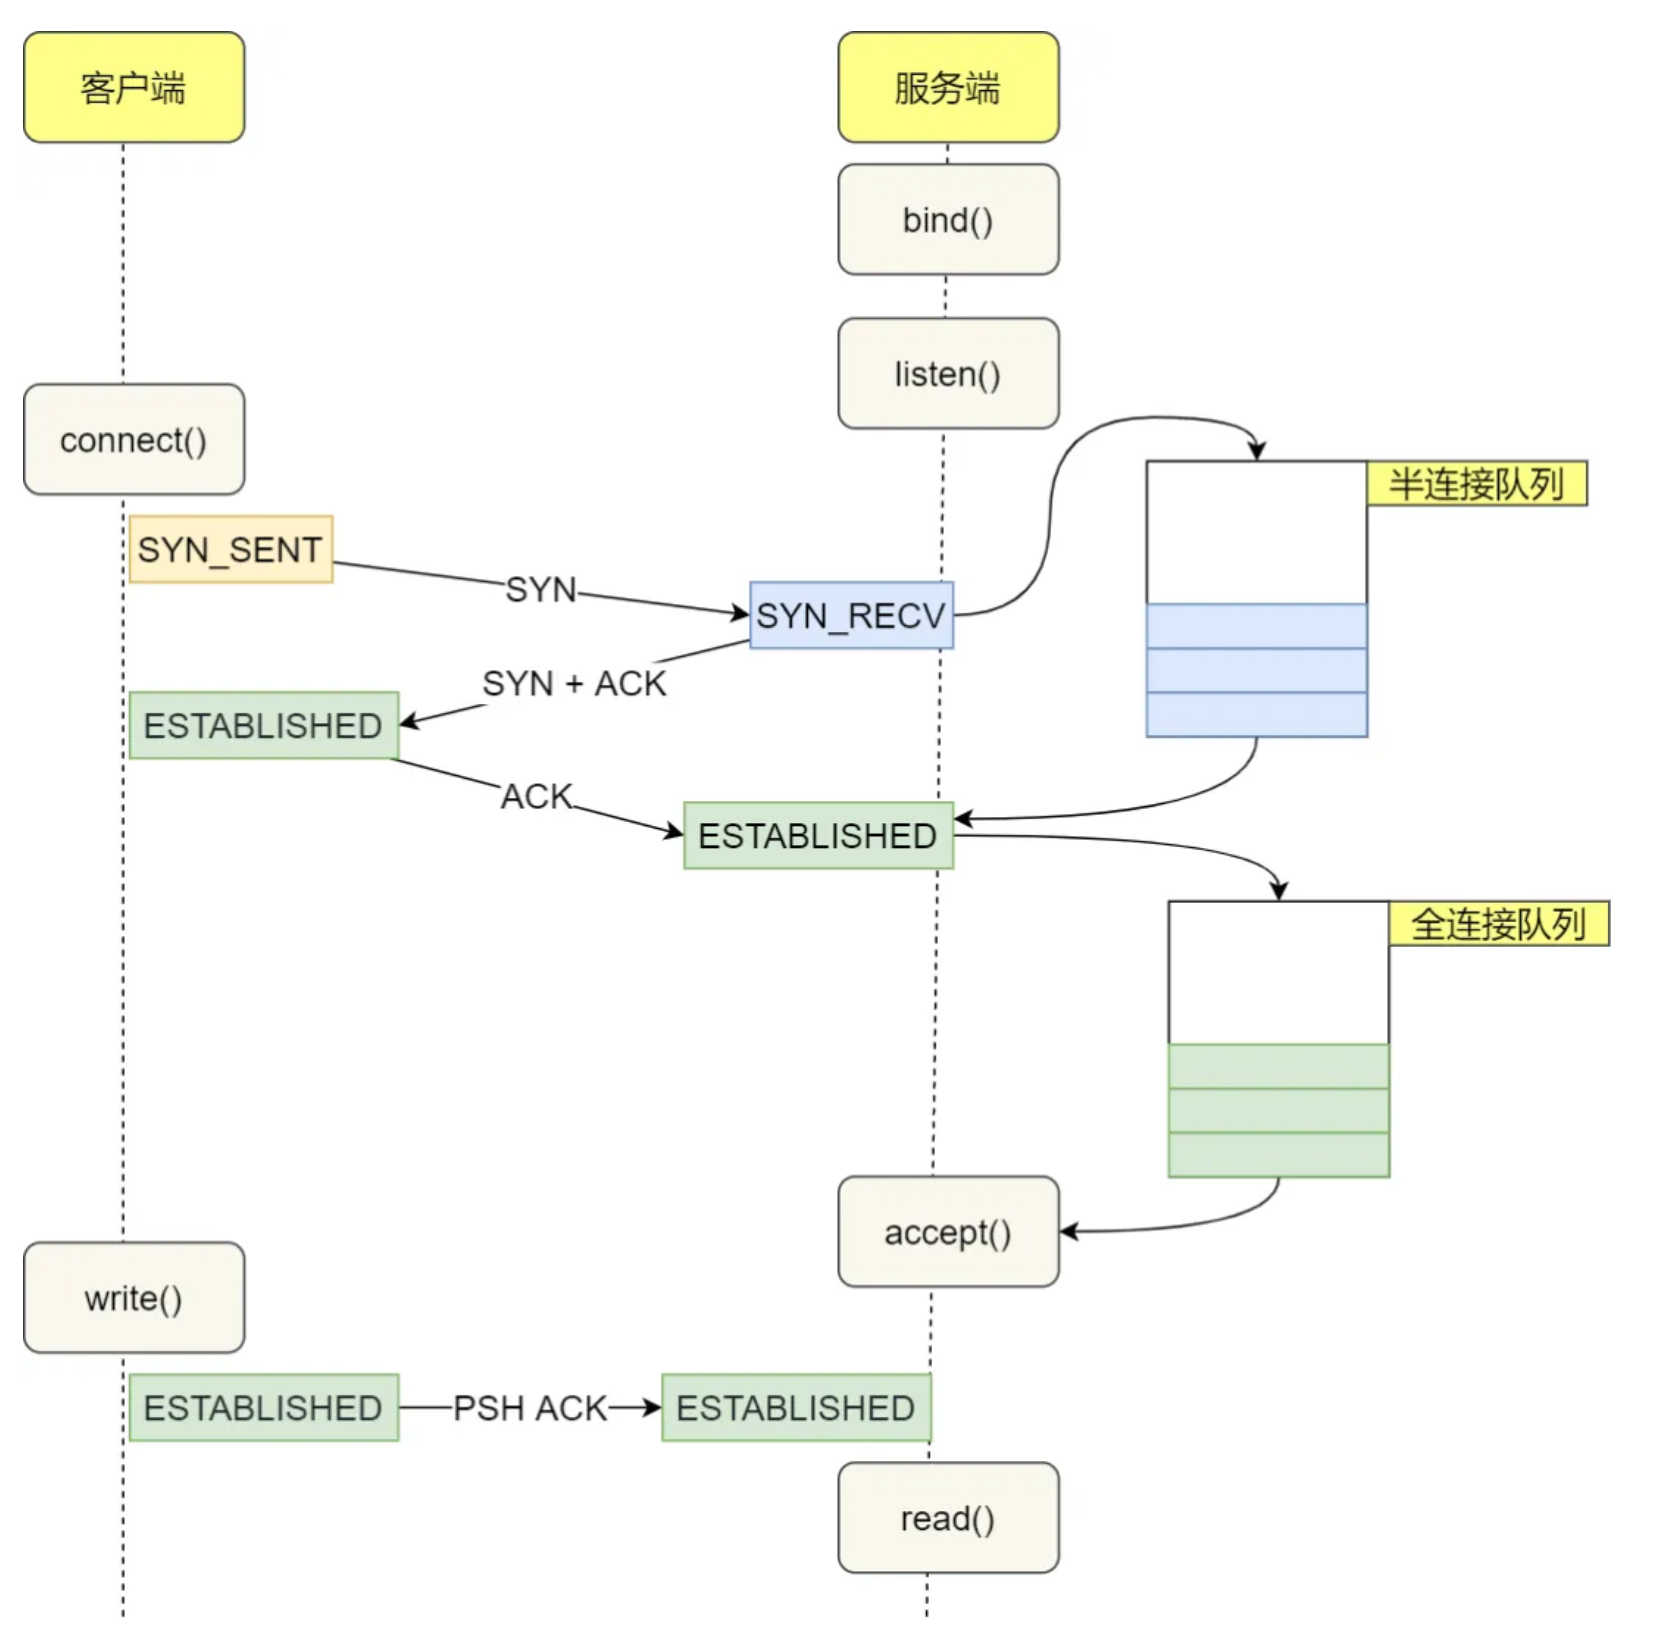
半连接队列保存握手尚未完成的请求,全连接队列保存已经建立、等待 accept 的连接,它们都有容量限制。
半连接队列满时,可能丢弃 SYN,也可能在开启 SYN Cookies 后使用 Cookie 响应。全连接队列满时,Linux 的处理还取决于 tcp_abort_on_overflow 等配置,可能暂时忽略握手确认,也可能返回 RST,不能把两种队列的行为混为一谈。
# 大量SYN包发送给服务端服务端会发生什么事情?
如果大量 SYN 请求没有完成第三次握手,就可能把 TCP 半连接队列占满,正常用户的请求也就难以建立连接,这就是 SYN Flood 的典型影响。
还要区分另一种情况:如果握手都完成了,但应用来不及 accept,压力主要在全连接队列和应用处理能力,不是同一个问题。
常见应对方式有以下几种:
开启 SYN Cookies
Linux 可以在半连接队列压力较大时,把必要信息编码进 SYN + ACK 的初始序列号,不为这次请求保存常规半连接状态。收到第三次握手后,再验证 Cookie 并尝试建立连接。
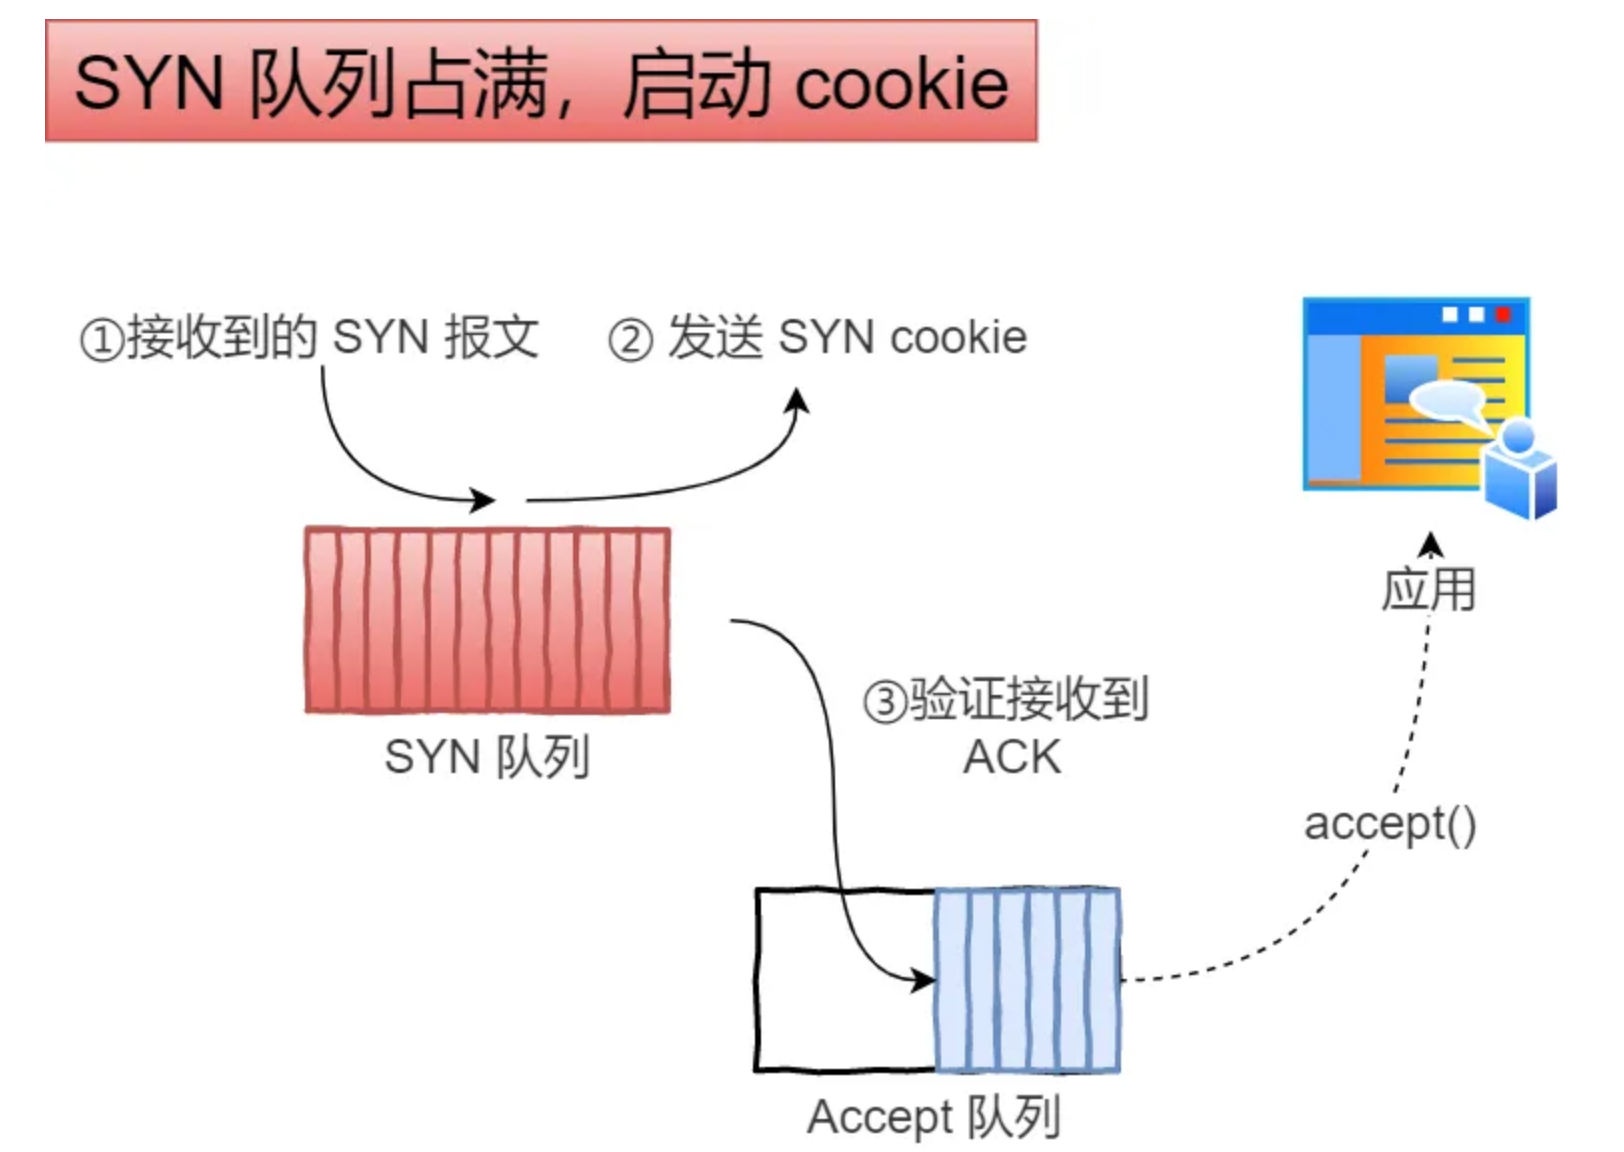
net.ipv4.tcp_syncookies 常见取值为:
- 0:关闭。
- 1:半连接队列溢出时启用。
- 2:无条件使用,具体支持情况要看内核版本。
SYN Cookies 只是缓解半连接资源耗尽,不保证任何攻击下都能正常建连。如果带宽、CPU 或全连接队列也被打满,仍然会影响服务。
调整队列和处理能力
tcp_max_syn_backlog 与半连接容量相关;listen 的 backlog 和 somaxconn 主要限制全连接队列。可以结合丢包和队列指标调整,但扩大队列并不能替代提升 accept 和业务处理速度。
netdev_max_backlog 管的是部分接收路径上来不及处理的数据包队列,不是 TCP 半连接队列,不能把它作为 SYN Flood 的通用解法。
控制异常流量
可以结合接入层限速、SYN 代理、上游流量清洗等手段过滤攻击。如果带宽已经在服务器之前被耗尽,只调服务器参数解决不了问题。
适当减少 SYN + ACK 重试可以更快释放半连接资源,但也会降低高延迟、丢包环境下正常用户的建连成功率,要结合实际情况调整。
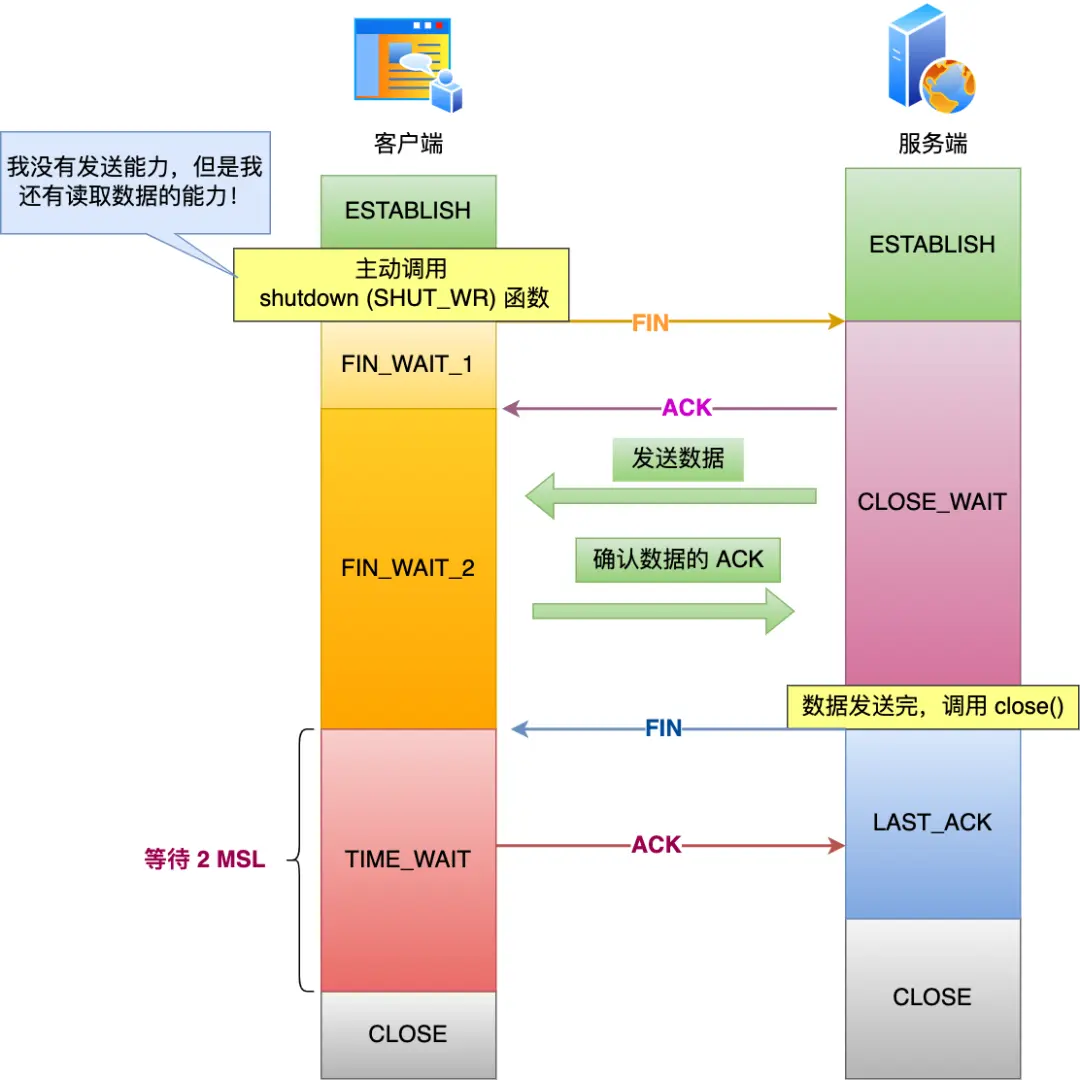
# TCP 四次挥手过程说一下?
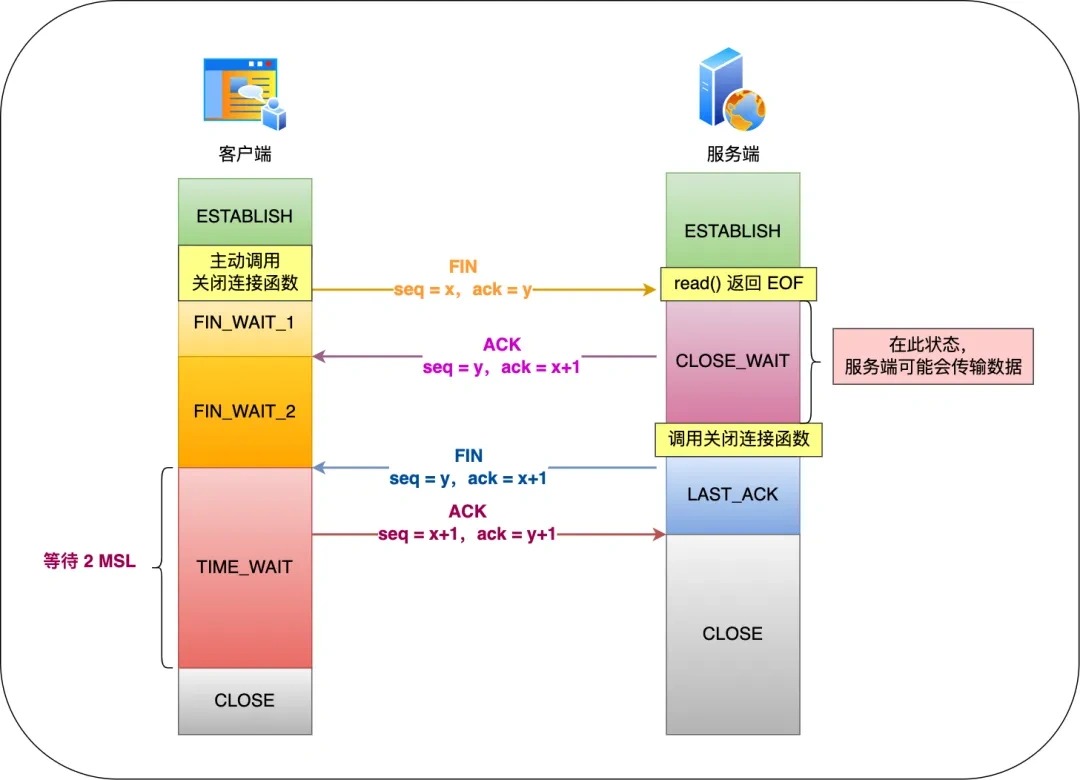
具体过程:
- 客户端主动调用关闭连接的函数,于是就会发送 FIN 报文,这个 FIN 报文代表客户端不会再发送数据了,进入 FIN_WAIT_1 状态;
- 服务端收到 FIN 后回复 ACK,进入 CLOSE_WAIT;客户端收到这个 ACK 后,进入 FIN_WAIT_2。FIN 表示对端的发送方向结束,并不是在缓冲区里放入一个普通的 EOF 字符。服务端应用先读完 FIN 之前的所有数据,之后 read 才会返回 0,表示这个方向不会再有数据;
- 接着,当服务端在 read 数据的时候,最后自然就会读到 EOF,接着 read() 就会返回 0,这时服务端应用程序如果有数据要发送的话,就发完数据后才调用关闭连接的函数,如果服务端应用程序没有数据要发送的话,可以直接调用关闭连接的函数,这时服务端就会发一个 FIN 包,这个 FIN 报文代表服务端不会再发送数据了,之后处于 LAST_ACK 状态;
- 客户端接收到服务端的 FIN 包,并发送 ACK 确认包给服务端,此时客户端将进入 TIME_WAIT 状态;
- 服务端收到 ACK 确认包后,就进入了最后的 CLOSED 状态;
- 客户端经过 2MSL 时间之后,也进入 CLOSED 状态;
# 为什么 TCP 关闭连接通常需要四次挥手?
服务器收到客户端的 FIN 报文时,内核会马上回一个 ACK 应答报文,但是服务端应用程序可能还有数据要发送,所以并不能马上发送 FIN 报文,而是将发送 FIN 报文的控制权交给服务端应用程序:
- 如果服务端应用程序有数据要发送的话,就发完数据后,才调用关闭连接的函数;
- 如果服务端应用程序没有数据要发送的话,可以直接调用关闭连接的函数,
从上面过程可知,是否要发送第三次挥手的控制权不在内核,而是在被动关闭方(上图的服务端)的应用程序,因为应用程序可能还有数据要发送,由应用程序决定什么时候调用关闭连接的函数,当调用了关闭连接的函数,内核就会发送 FIN 报文了,所以服务端的 ACK 和 FIN 一般都会分开发送。
# 第二次和第三次挥手能合并嘛
可以合并,四次挥手不是固定必须发四个独立报文。
服务端收到 FIN 后,如果已经没有数据要发送,应用也及时关闭了发送方向,内核就有机会把对客户端 FIN 的确认和自己的 FIN 放在同一个报文中,发送 FIN + ACK。
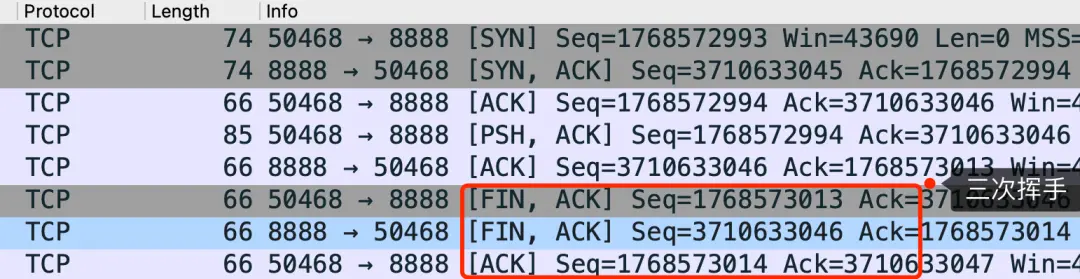
能不能合并,要看关闭时机和具体实现。延迟确认可能给合并提供机会,但不是协议规定必须满足的开关条件。关键是发送这个 ACK 的时候,自己的发送方向是否也已经可以结束。
# 第三次挥手一直没发,会发生什么?
主动关闭方收到自己 FIN 的确认后进入 FIN_WAIT_2,等待对方的 FIN;被动关闭方可能还在 CLOSE_WAIT,继续处理剩余数据。
要分两种情况:
- 应用只调用 shutdown(SHUT_WR):本端不能继续发送数据,但还保留接收能力,可以继续读取对端发来的内容。如果没有其他超时,等待可能持续很久。
- 应用关闭了最后一个 socket 引用,成为孤儿连接:内核不能一直为它保留资源。Linux 的 tcp_fin_timeout 会影响这类 FIN_WAIT_2 连接的等待时长,常见默认值为 60 秒,socket 的 TCP_LINGER2 等设置也可能影响实际行为。
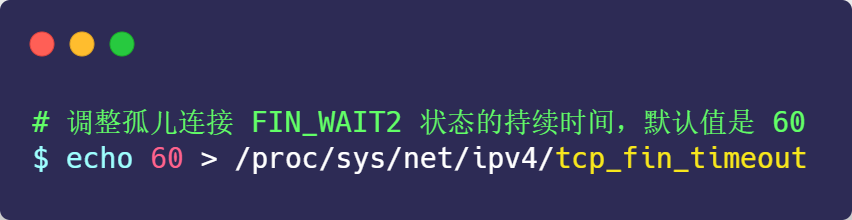
所以,不能把「对端不发 FIN,就一定一直等待」或者「所有 FIN_WAIT_2 都在 60 秒后关闭」当成通用结论。还要回头检查被动关闭方的应用为什么没有完成关闭。
# 第二次和第三次挥手之间,主动断开的那端能干什么
如果主动断开的一方,是调用了 shutdown 函数来关闭连接,并且只选择了关闭发送能力且没有关闭接收能力的话,那么主动断开的一方在第二次和第三次挥手之间还可以接收数据。
# 断开连接时客户端 FIN 包丢失,服务端的状态是什么?
如果第一次挥手的 FIN 一直没有到达服务端,服务端通常仍然处于 ESTABLISHED,因为它还不知道客户端已经决定关闭发送方向。
客户端发送 FIN 后进入 FIN_WAIT_1,迟迟收不到确认就会重传 FIN。只要某次重传到达,服务端就能回复 ACK,并进入 CLOSE_WAIT。
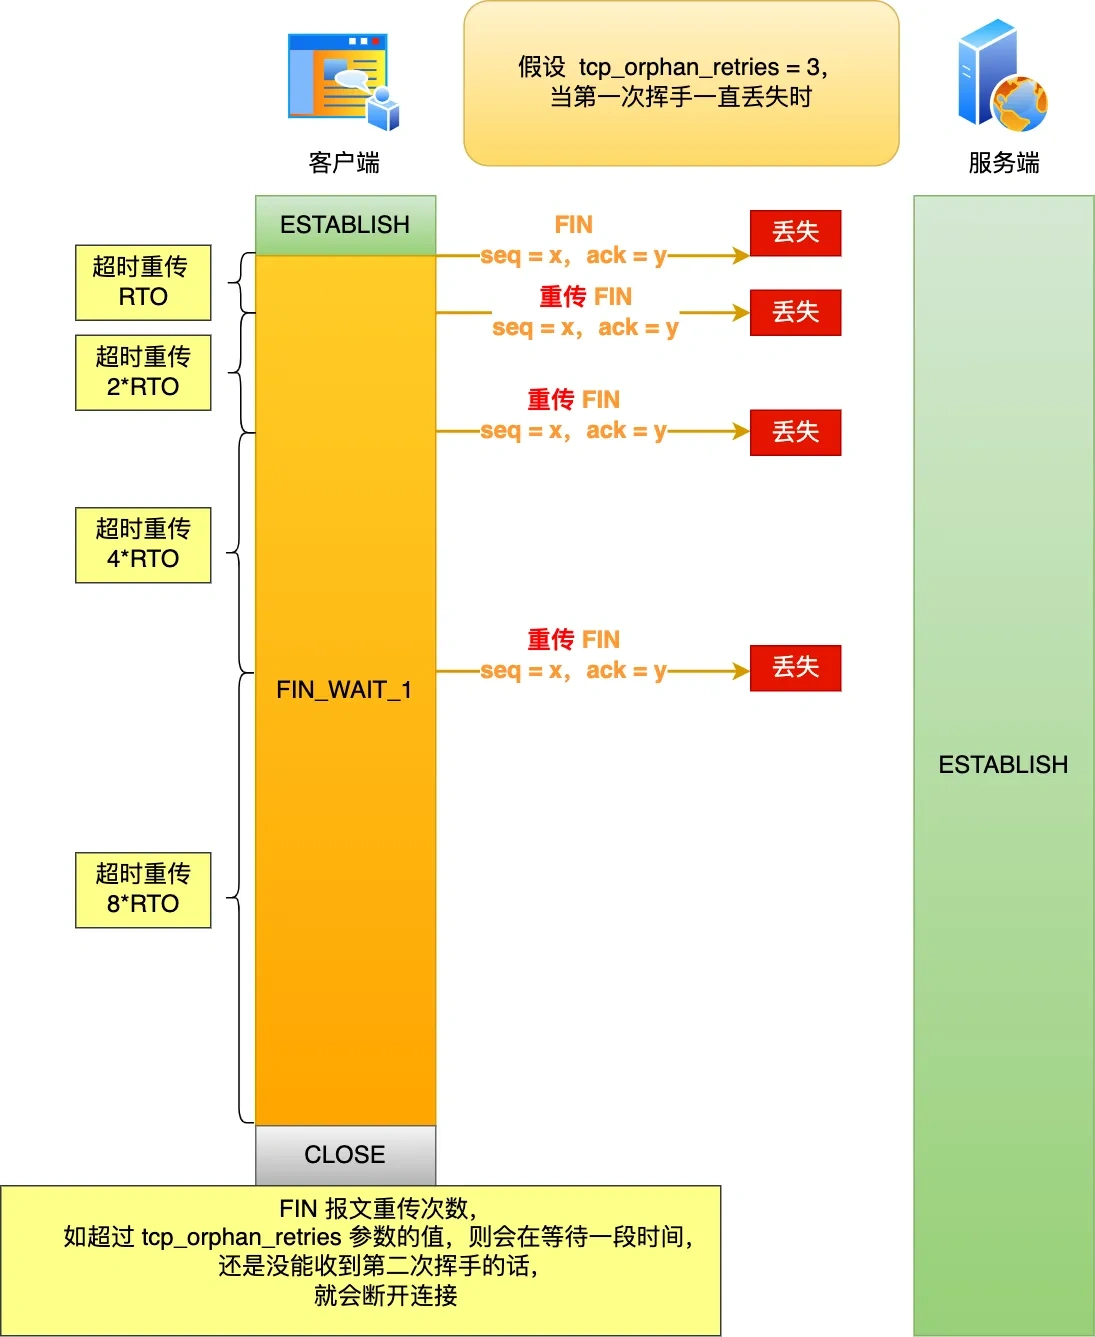
如果一直无法得到确认,客户端最终可能因为重传超时而释放连接。对于 Linux 中已经没有应用持有的孤儿连接,tcp_orphan_retries 等配置会影响处理,但不能把它当成所有 FIN 重传场景的统一次数限制。
客户端超时,不代表服务端同时关闭。服务端可能要到后续发送数据、收到 RST,或者自己的超时机制触发时,才能感知这条连接已经失效。
# 为什么四次挥手之后要等2MSL?
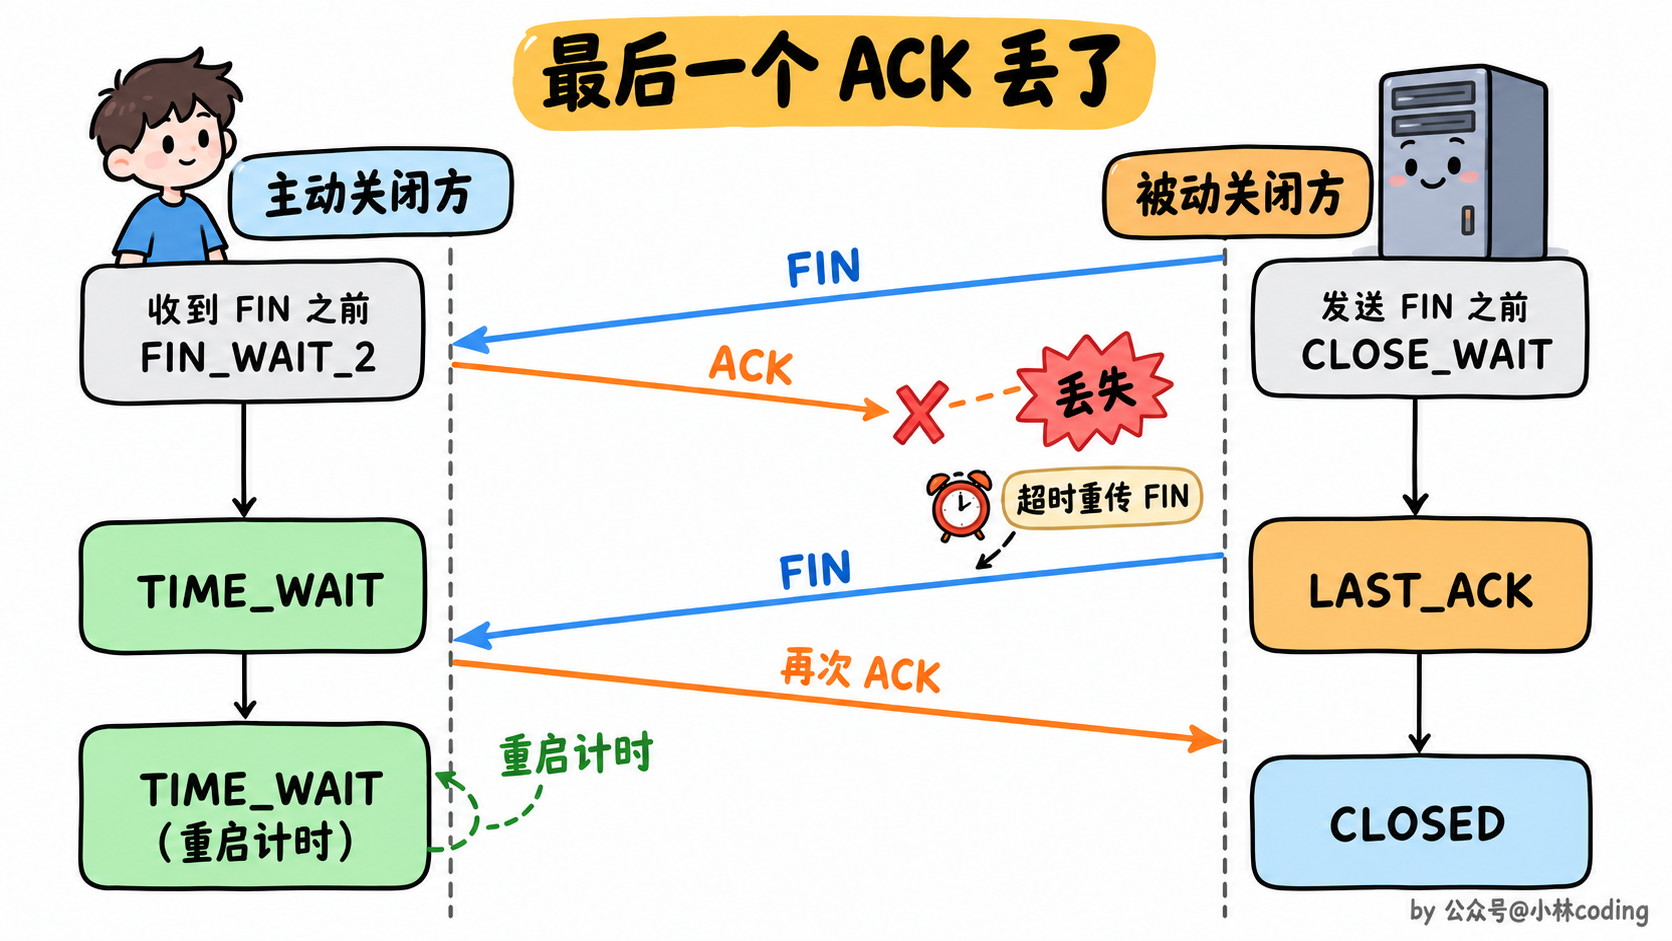
通常由主动关闭连接的一方进入 TIME_WAIT,等待 2MSL。这里以客户端主动关闭为例,它收到服务端的 FIN 并回复最后一个 ACK 后,并不会立即删除连接状态。
MSL 是 Maximum Segment Lifetime,也就是报文最大生存时间。等待 2MSL 主要有两个目的:
- 让被动关闭方有机会收到最后的 ACK。如果 ACK 丢失,服务端会重传 FIN。客户端保留 TIME_WAIT 状态,就还能识别这个 FIN,再次回复 ACK。否则服务端可能无法正常结束关闭过程。
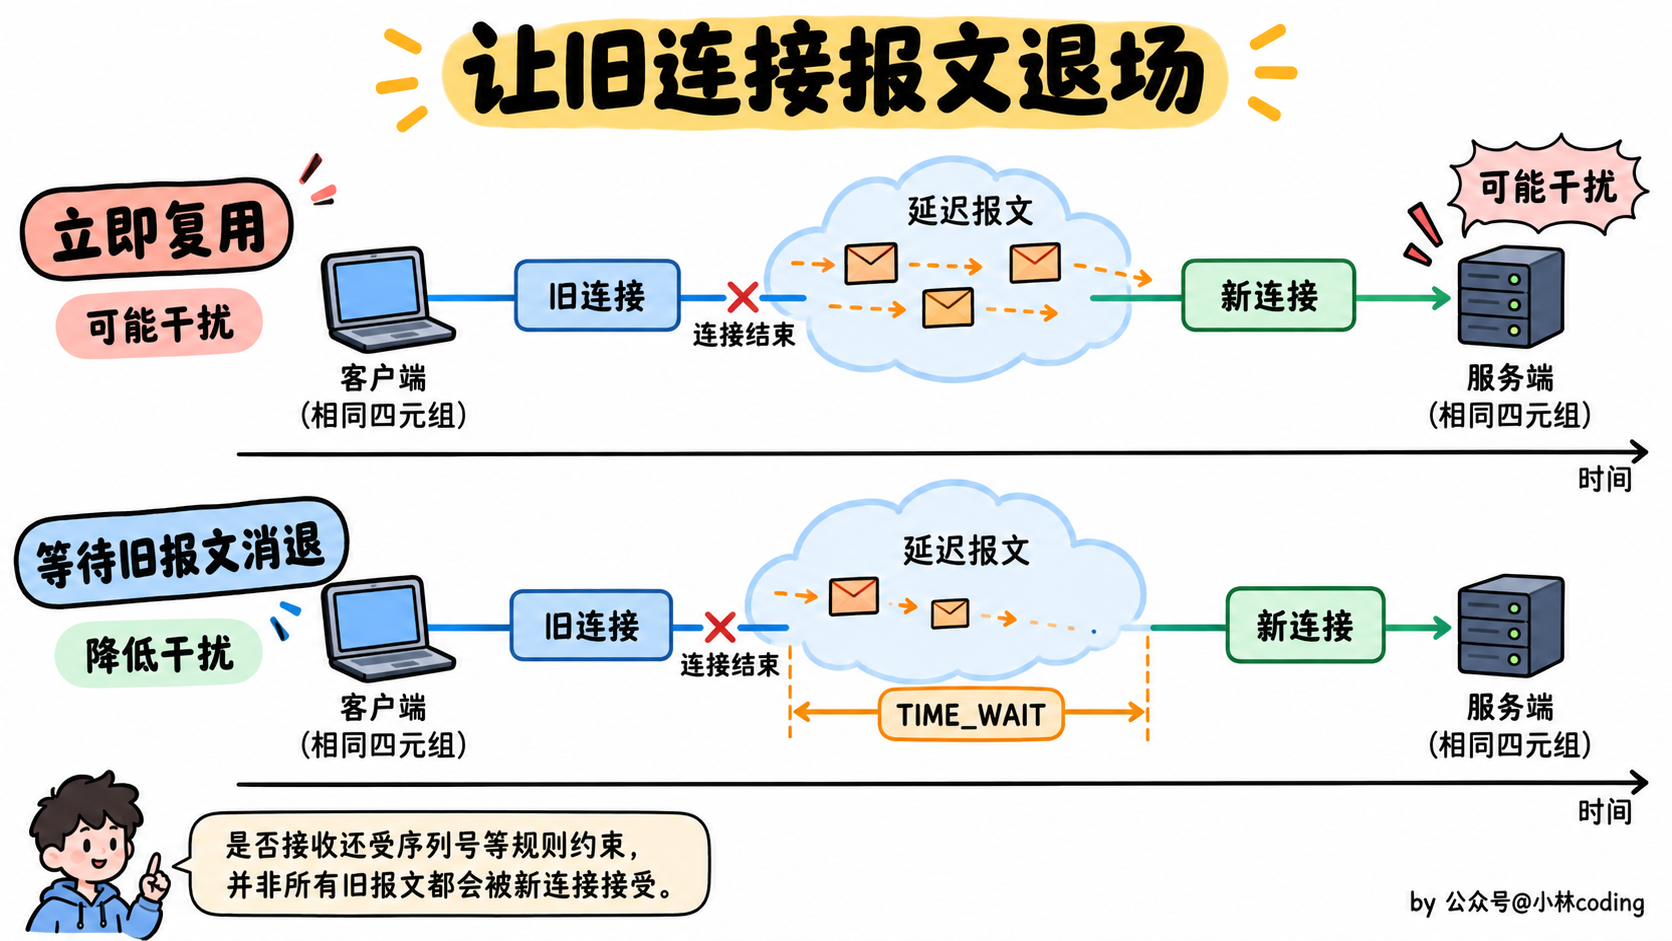
- 让旧连接的报文在网络里消失。如果立即用相同的四元组建立新连接,旧报文可能混入新连接。等待一段时间,可以降低这种干扰。
收到重传 FIN 并再次回复 ACK 后,TIME_WAIT 计时通常会重新开始。
MSL 是时间概念,IP 的 TTL 主要限制跳数,两者不能直接换算,不能说「TTL 为 64,所以 30 秒内一定消失」。Linux 中常见的 TIME_WAIT 等待时长是 60 秒,但这是实现选择,不是所有系统都统一的值。
还有个常见追问:tcp_fin_timeout 能不能缩短 TIME_WAIT?不能直接这样理解,它主要影响孤儿连接在 FIN_WAIT_2 的等待时间,不是 TIME_WAIT 的计时参数。
# 服务端出现大量的timewait有哪些原因?
问题来了,什么场景下服务端会主动断开连接呢?
- 第一个场景:HTTP 没有使用长连接
- 第二个场景:HTTP 长连接超时
- 第三个场景:HTTP 长连接的请求数量达到上限
接下来,分别介绍下。
第一个场景:HTTP 没有使用长连接
我们先来看看 HTTP 长连接(Keep-Alive)机制是怎么开启的。
在 HTTP/1.0 中默认是关闭的,如果浏览器要开启 Keep-Alive,它必须在请求的 header 中添加:
Connection: Keep-Alive
然后当服务器收到请求,作出回应的时候,它也被添加到响应中 header 里:
Connection: Keep-Alive
这样做,TCP 连接就不会中断,而是保持连接。当客户端发送另一个请求时,它会使用同一个 TCP 连接。这一直继续到客户端或服务器端提出断开连接。
HTTP/1.1 默认使用持久连接,不需要每次显式发送 Connection: Keep-Alive。这里讨论的是 HTTP/1.x,HTTP/2、HTTP/3 的连接管理不能直接套用这个头字段。
如果要关闭 HTTP Keep-Alive,需要在 HTTP 请求或者响应的 header 里添加 Connection:close 信息,也就是说,只要客户端和服务端任意一方的 HTTP header 中有 Connection:close 信息,那么就无法使用 HTTP 长连接的机制。
关闭 HTTP 长连接机制后,每次请求都要经历这样的过程:建立 TCP -> 请求资源 -> 响应资源 -> 释放连接,那么此方式就是 HTTP 短连接,如下图:
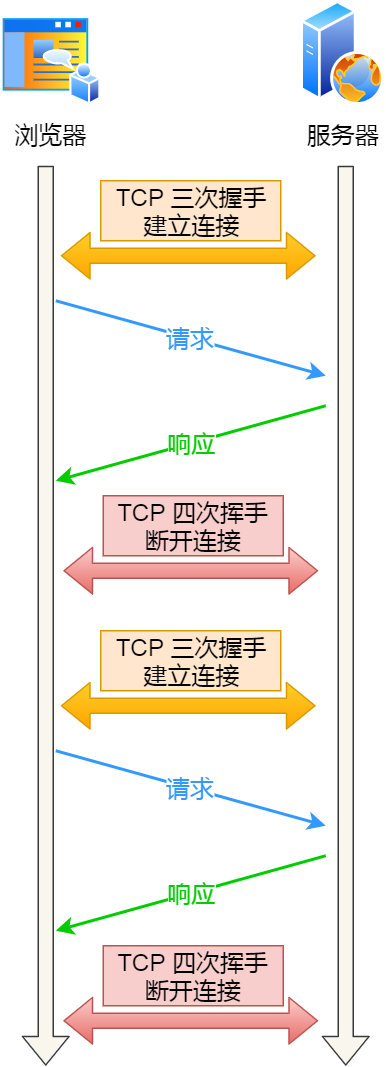
在前面我们知道,只要任意一方的 HTTP header 中有 Connection:close 信息,就无法使用 HTTP 长连接机制,这样在完成一次 HTTP 请求/处理后,就会关闭连接。
问题来了,这时候是客户端还是服务端主动关闭连接呢?
在 RFC 文档中,并没有明确由谁来关闭连接,请求和响应的双方都可以主动关闭 TCP 连接。
不过,根据大多数 Web 服务的实现,不管哪一方禁用了 HTTP Keep-Alive,都是由服务端主动关闭连接,那么此时服务端上就会出现 TIME_WAIT 状态的连接。
第二个场景:HTTP 长连接超时
HTTP 长连接允许在一次请求结束后继续复用连接,但客户端、服务端或者中间代理都可能因为空闲超时、请求数量限制等原因关闭连接。
HTTP 长连接可以在同一个 TCP 连接上接收和发送多个 HTTP 请求/应答,避免了连接建立和释放的开销。
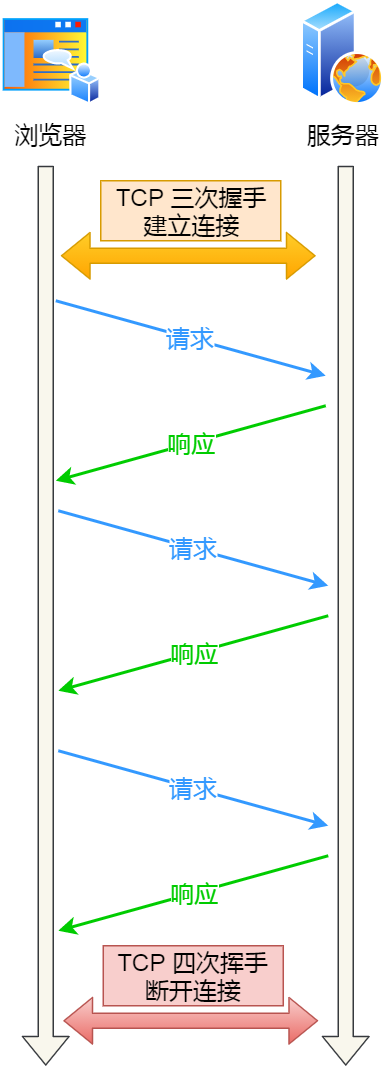
可能有的同学会问,如果使用了 HTTP 长连接,如果客户端完成一个 HTTP 请求后,就不再发起新的请求,此时这个 TCP 连接一直占用着不是挺浪费资源的吗?
对没错,所以为了避免资源浪费的情况,web 服务软件一般都会提供一个参数,用来指定 HTTP 长连接的超时时间,比如 nginx 提供的 keepalive_timeout 参数。
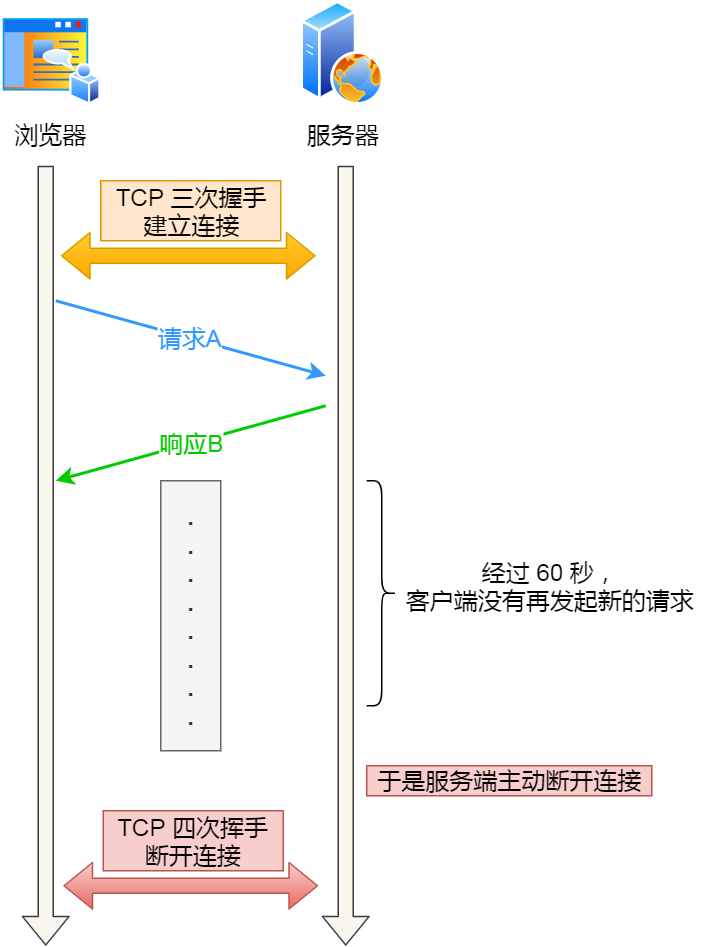
假设设置了 HTTP 长连接的超时时间是 60 秒,nginx 就会启动一个「定时器」,如果客户端在完后一个 HTTP 请求后,在 60 秒内都没有再发起新的请求,定时器的时间一到,nginx 就会触发回调函数来关闭该连接,那么此时服务端上就会出现 TIME_WAIT 状态的连接。
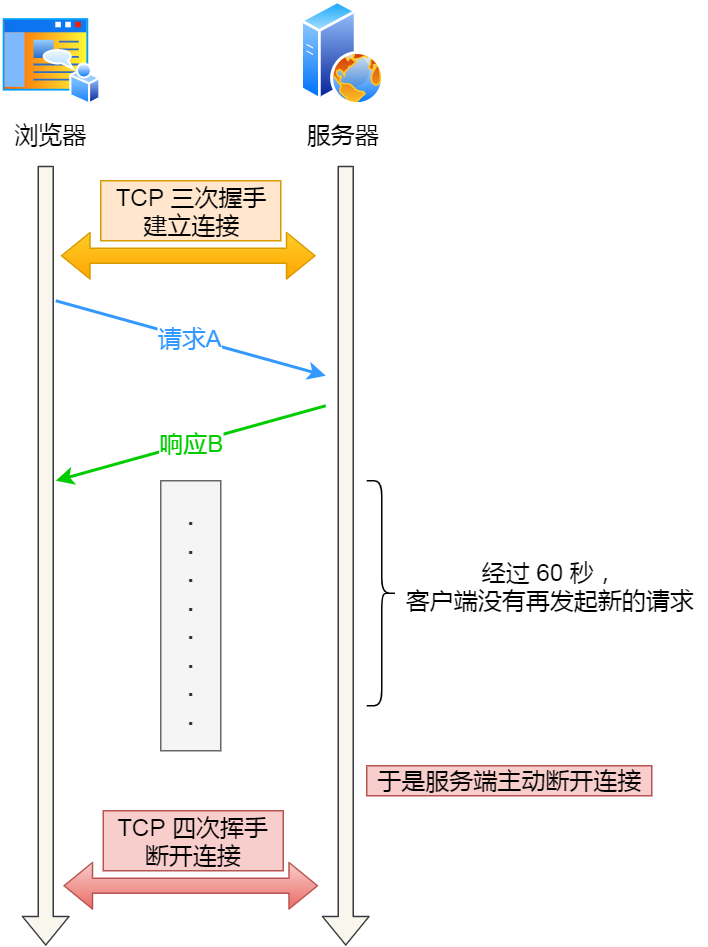
当服务端出现大量 TIME_WAIT 状态的连接时,如果现象是有大量的客户端建立完 TCP 连接后,很长一段时间没有发送数据,那么大概率就是因为 HTTP 长连接超时,导致服务端主动关闭连接,产生大量处于 TIME_WAIT 状态的连接。
可以往网络问题的方向排查,比如是否是因为网络问题,导致客户端发送的数据一直没有被服务端接收到,以至于 HTTP 长连接超时。
第三个场景:HTTP 长连接的请求数量达到上限
Web 服务端通常会有个参数,来定义一条 HTTP 长连接上最大能处理的请求数量,当超过最大限制时,就会主动关闭连接。
比如 nginx 的 keepalive_requests 这个参数,这个参数是指一个 HTTP 长连接建立之后,nginx 就会为这个连接设置一个计数器,记录这个 HTTP 长连接上已经接收并处理的客户端请求的数量。如果达到这个参数设置的最大值时,则 nginx 会主动关闭这个长连接,那么此时服务端上就会出现 TIME_WAIT 状态的连接。
keepalive_requests 的默认值与版本有关,Nginx 1.19.10 之前是 100,之后改为 1000。实际排查时要看运行版本和生效配置,不能只记一个固定默认值。
但是,对于一些 QPS 比较高的场景,比如超过 10000 QPS,甚至达到 30000 , 50000 甚至更高,如果 keepalive_requests 参数值是 100,这时候就 nginx 就会很频繁地关闭连接,那么此时服务端上就会出大量的 TIME_WAIT 状态。
如果确认连接因为请求次数限制频繁关闭,可以适当调大 keepalive_requests。不过它不是越大越好,连接周期性关闭也有释放相关内存的作用,还要结合连接数量和内存占用判断。
另外,TIME_WAIT 多不等于一定有故障。要看是否造成端口、内存等资源压力,再从减少短连接、改善连接复用和调整连接生命周期入手。服务端作为监听方时,也不能简单把 TIME_WAIT 数量等同于临时端口被耗尽。
# 服务端出现大量 CLOSE_WAIT 是什么原因?
CLOSE_WAIT 表示对端已经关闭发送方向,本端也已经确认,但本端应用还没有关闭自己的发送方向。
比如客户端发送 FIN,服务端内核回复 ACK 后进入 CLOSE_WAIT。服务端把剩余数据发送完,并关闭对应 socket 后,才会继续发送 FIN,进入 LAST_ACK。
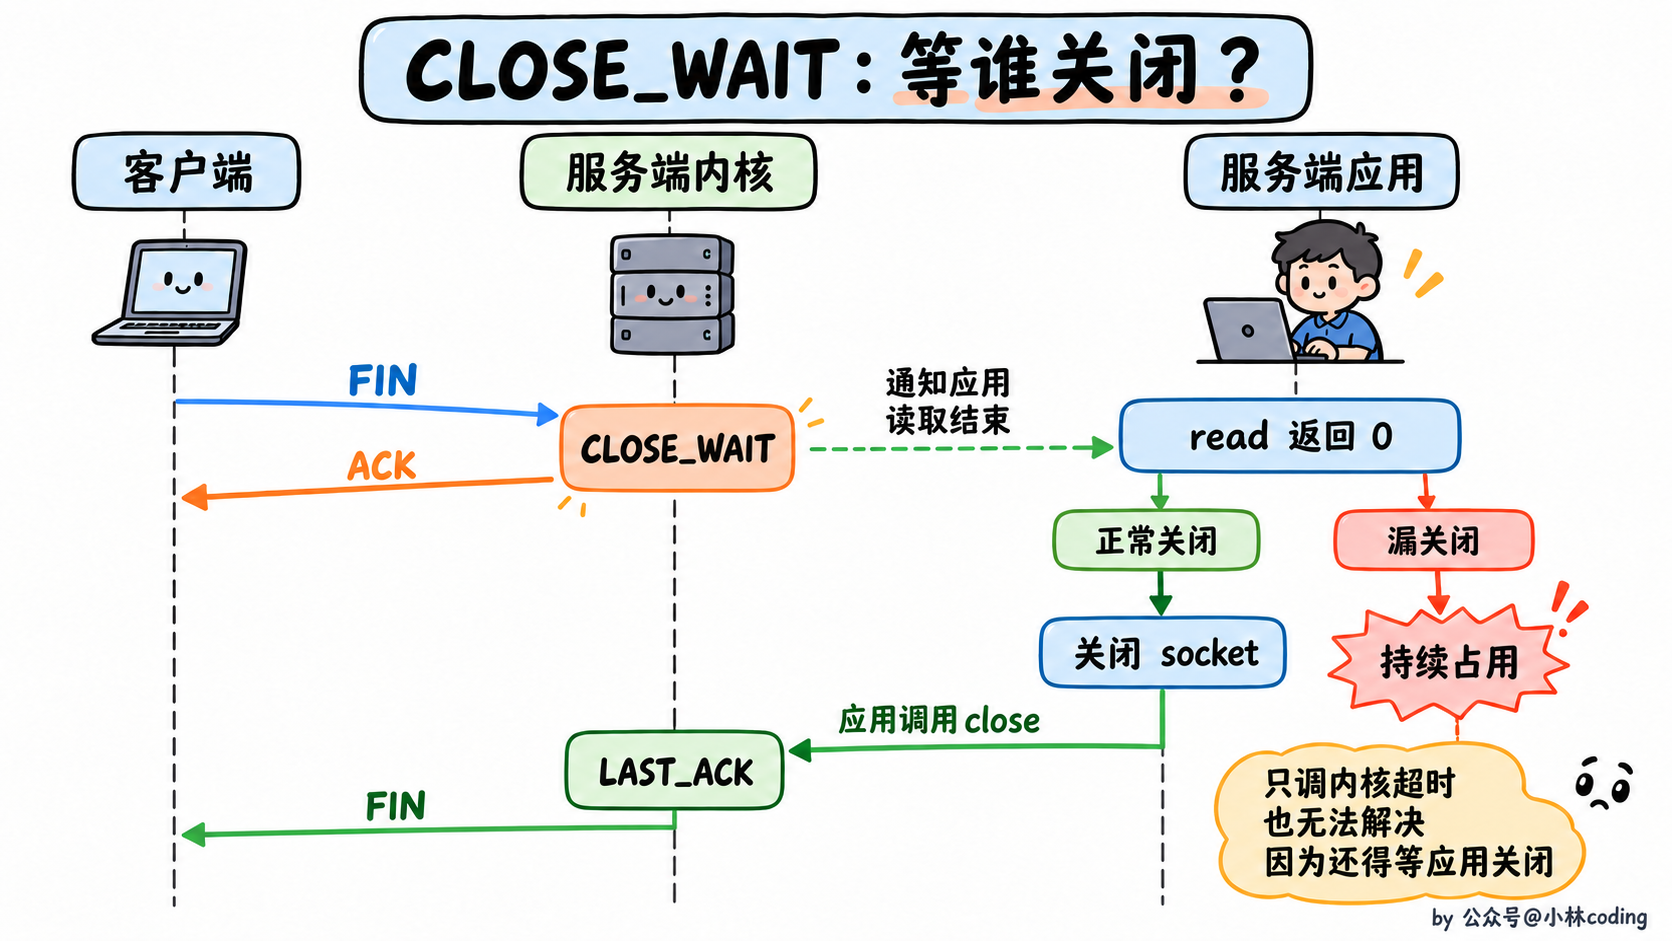
短暂的 CLOSE_WAIT 很正常,但如果大量连接长期停在这里,常见原因是:
- 程序发现 read 返回 0 后,没有关闭连接。
- 异常分支漏掉了连接释放,比如超时、解析失败时直接返回。
- 业务线程卡住了,一直没有执行到关闭逻辑。
- 连接池、流对象或 socket 的引用没有正确释放。
排查时可以用 ss -tanp 找到对应进程,再结合文件描述符、线程栈和业务日志检查。这类问题通常要修复应用的资源释放逻辑,调小 tcp_fin_timeout 不能直接清掉 CLOSE_WAIT。
# TCP和UDP区别是什么?
可以从以下几个方面比较:
- 连接:TCP 是面向连接的协议,通常先握手再传数据;UDP 本身不需要握手。UDP socket 也可以调用 connect,但这主要是设置默认对端等,并不会变成 TCP 式的连接。
- 可靠性:TCP 提供有序、不重复的可靠字节流,通过确认和重传应对丢包。如果连接最终失败,仍然会向应用报告错误,并不是永远保证发送成功。UDP 本身不提供确认、重传和按序交付。
- 消息边界:TCP 是字节流,没有应用消息边界;UDP 按数据报传输,会保留数据报边界。
- 流量和拥塞控制:TCP 有这些机制,UDP 本身没有,但上层协议可以实现,比如 QUIC。
- 首部开销:TCP 首部通常是 20~60 字节,UDP 首部固定为 8 字节。
- 通信方式:TCP 一条连接对应两个端点;UDP 还可以配合 IP 实现组播,IPv4 下也可以广播。
选择时不能简单说「要快就用 UDP,要可靠就用 TCP」。DNS 查询、实时媒体等场景经常使用 UDP,但还要考虑重试、实时性、拥塞控制等需求。使用 UDP 不等于应用就不能可靠传输,只是这些能力要由上层负责。
# TCP为什么可靠传输
TCP 主要通过序列号、确认应答、重传、校验和,以及流量控制和拥塞控制来提供可靠字节流。
- 序列号:对字节编号,接收方据此重组乱序数据、识别重复数据,保证交给应用的字节按顺序排列。
- 确认应答:ACK 里的确认号表示下一次期望收到的字节序号。比如 ACK=1001,表示序号 1001 之前的字节已经连续收到,这叫累计确认。
- 重传:发送方在超时或者判断某段数据丢失后重发。如果 ACK 丢失,后续累计 ACK 也可能确认前面的数据,不一定每丢一个 ACK 就重传一次。
- 校验和:检测传输损坏,出错的报文会被丢弃,再由重传补上。
- 流量控制:接收方通告窗口,防止发送方把接收缓冲区撑满。
- 拥塞控制:根据网络反馈调整发送量,避免不断重传让网络更加拥堵。
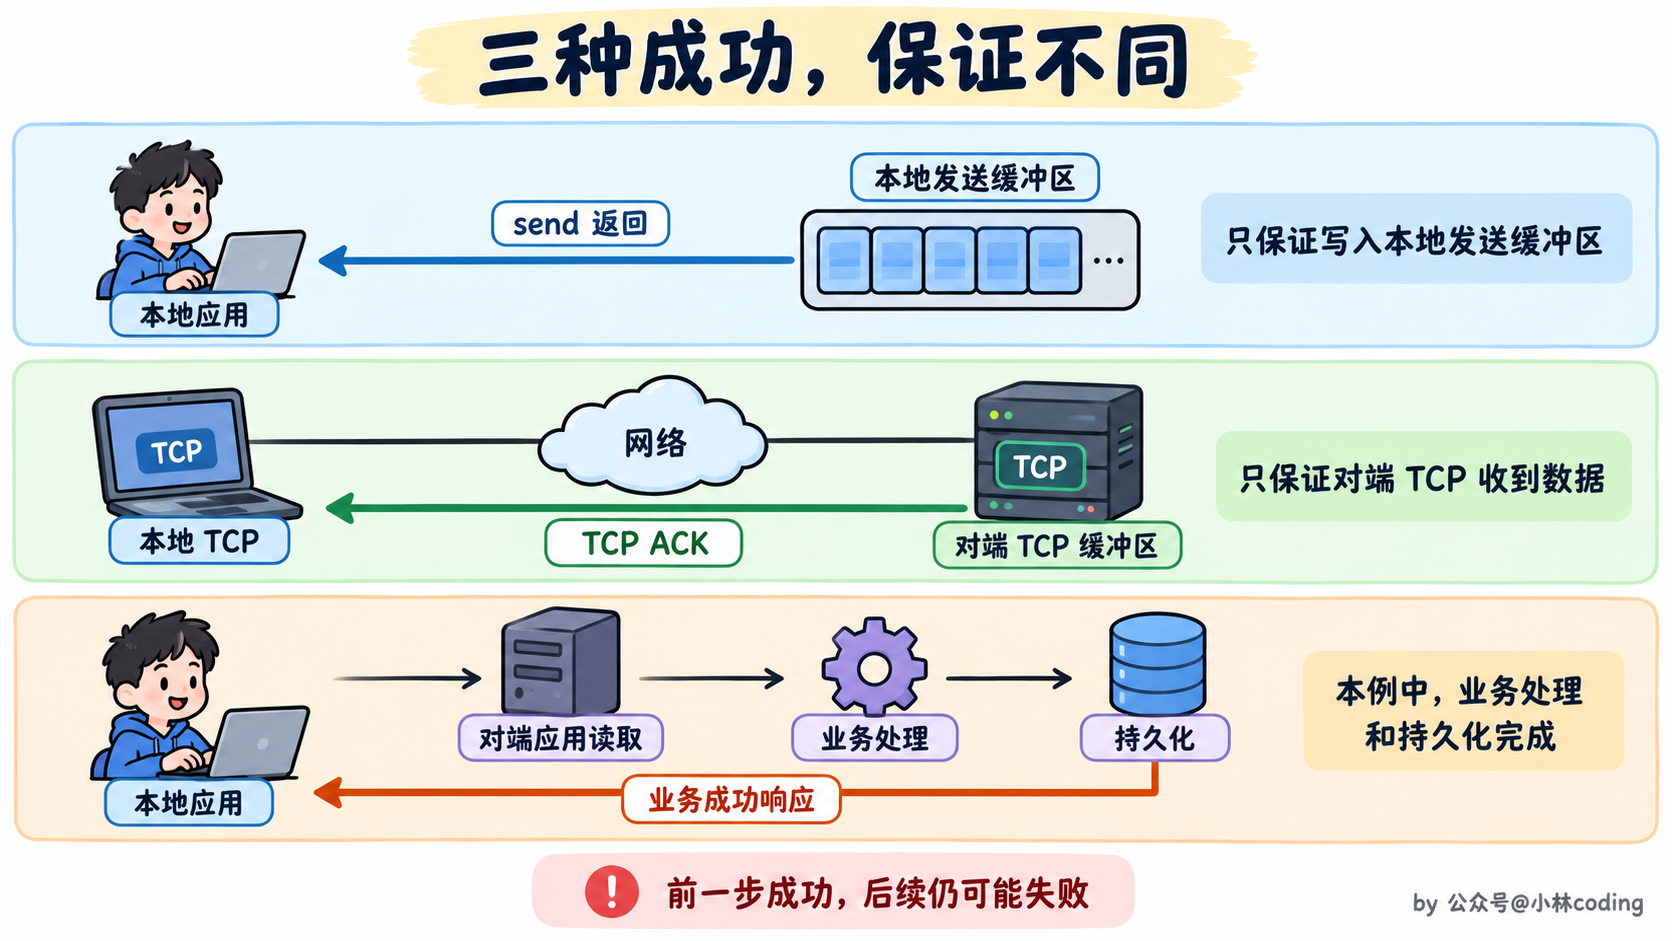
还要注意可靠性的边界:**收到 TCP ACK,说明数据到了对端的 TCP 接收端,不代表对端应用已经处理成功,更不代表数据已经写入数据库。**比如下单接口收到数据后宕机,订单是否创建成功,还要靠业务响应、查询和幂等机制判断。
# 怎么用udp实现http?
HTTP/3 的做法是:在 UDP 上实现 QUIC,再在 QUIC 上传输 HTTP,而不是直接把原来的 HTTP/1.1 报文换成 UDP 发送。
UDP 不提供的能力,由 QUIC 补上:
- 可靠传输:利用包编号、ACK、丢包检测和重传等机制保证流数据交付。丢失的是包,但重传的是仍然需要发送的帧信息,新包使用新的包编号。
- 有序交付:每个 Stream 有自己的偏移量和顺序,不同 Stream 之间可以独立处理。
- 流量控制和拥塞控制:限制单个流及连接的数据量,并根据网络状况调整发送。
- 安全通信:集成 TLS 1.3,为数据提供加密和完整性保护。
- 连接迁移:使用 Connection ID 等机制,在符合条件的网络切换中继续使用原连接。
标准 QUIC 并不依赖前向纠错来保证可靠性。面试里把确认、丢包检测和重传讲清楚就可以,不要把早期实验方案当成必备功能。
# tcp粘包怎么解决?
TCP 是字节流,一次 send 不对应一次 read。两次发送的内容可能被一次读到,一条消息也可能分多次才能读完,这就是应用里常说的粘包和拆包。
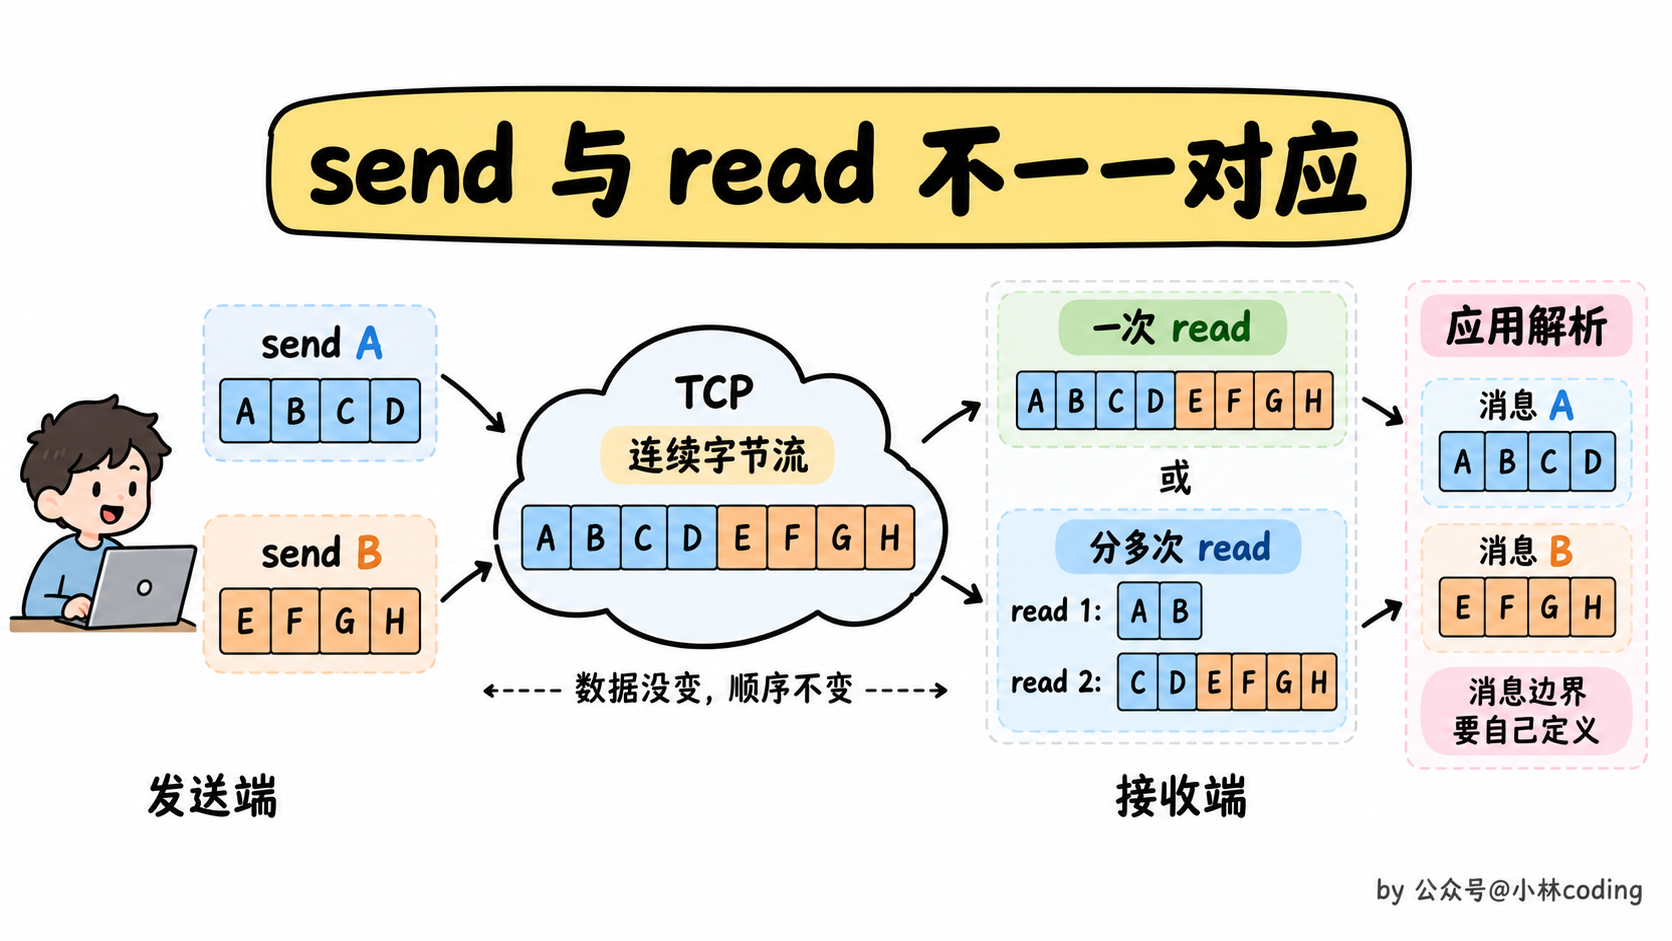
它不是 TCP 传错了数据,而是应用没有正确处理消息边界。所以解决办法是在应用层定义消息格式,并持续解析接收到的字节。
一般有三种方式分包的方式:
- 固定长度的消息;
- 特殊字符作为边界;
- 自定义消息结构。
固定长度的消息
这种是最简单方法,即每个用户消息都是固定长度的,比如规定一个消息的长度是 64 个字节,当接收方接满 64 个字节,就认为这个内容是一个完整且有效的消息。
但是这种方式灵活性不高,实际中很少用。
特殊字符作为边界
我们可以在两个用户消息之间插入一个特殊的字符串,这样接收方在接收数据时,读到了这个特殊字符,就把认为已经读完一个完整的消息。
HTTP 是一个非常好的例子。
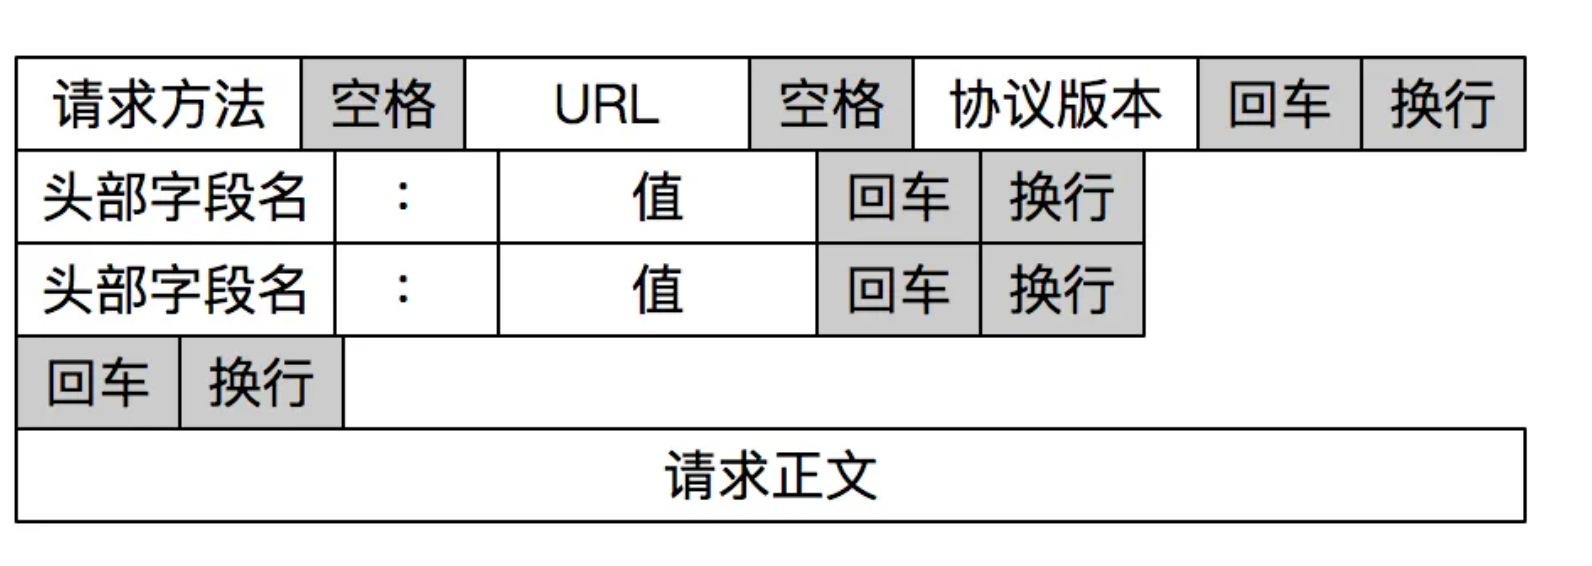
HTTP/1.1 的头字段用回车换行分隔,头部以 \r\n\r\n 结束,但这不等于整个报文都结束了。正文还要结合 Content-Length 或 chunked 等规则读取,不能在正文里看到回车换行就当作消息结束。
有一点要注意,这个作为边界点的特殊字符,如果刚好消息内容里有这个特殊字符,我们要对这个字符转义,避免被接收方当作消息的边界点而解析到无效的数据。
自定义消息结构
我们可以自定义一个消息结构,由包头和数据组成,其中包头包是固定大小的,而且包头里有一个字段来说明紧随其后的数据有多大。
比如这个消息结构体,首先 4 个字节大小的变量来表示数据长度,真正的数据则在后面。
struct {
    u_int32_t message_length;
    char message_data[];
} message;
当接收方接收到包头的大小(比如 4 个字节)后,就解析包头的内容,于是就可以知道数据的长度,然后接下来就继续读取数据,直到读满数据的长度,就可以组装成一个完整的用户消息来处理了。
实际写代码时,还要处理包头只读到一部分、一次读到多条消息等情况,并校验长度字段,限制最大消息大小。关闭 Nagle 或改成一次 send,只会影响发送行为,不能替代应用层分包。
# TCP 流量控制和拥塞控制有什么区别?
流量控制管「接收方来不来得及收」,拥塞控制管「网络承不承受得住」。
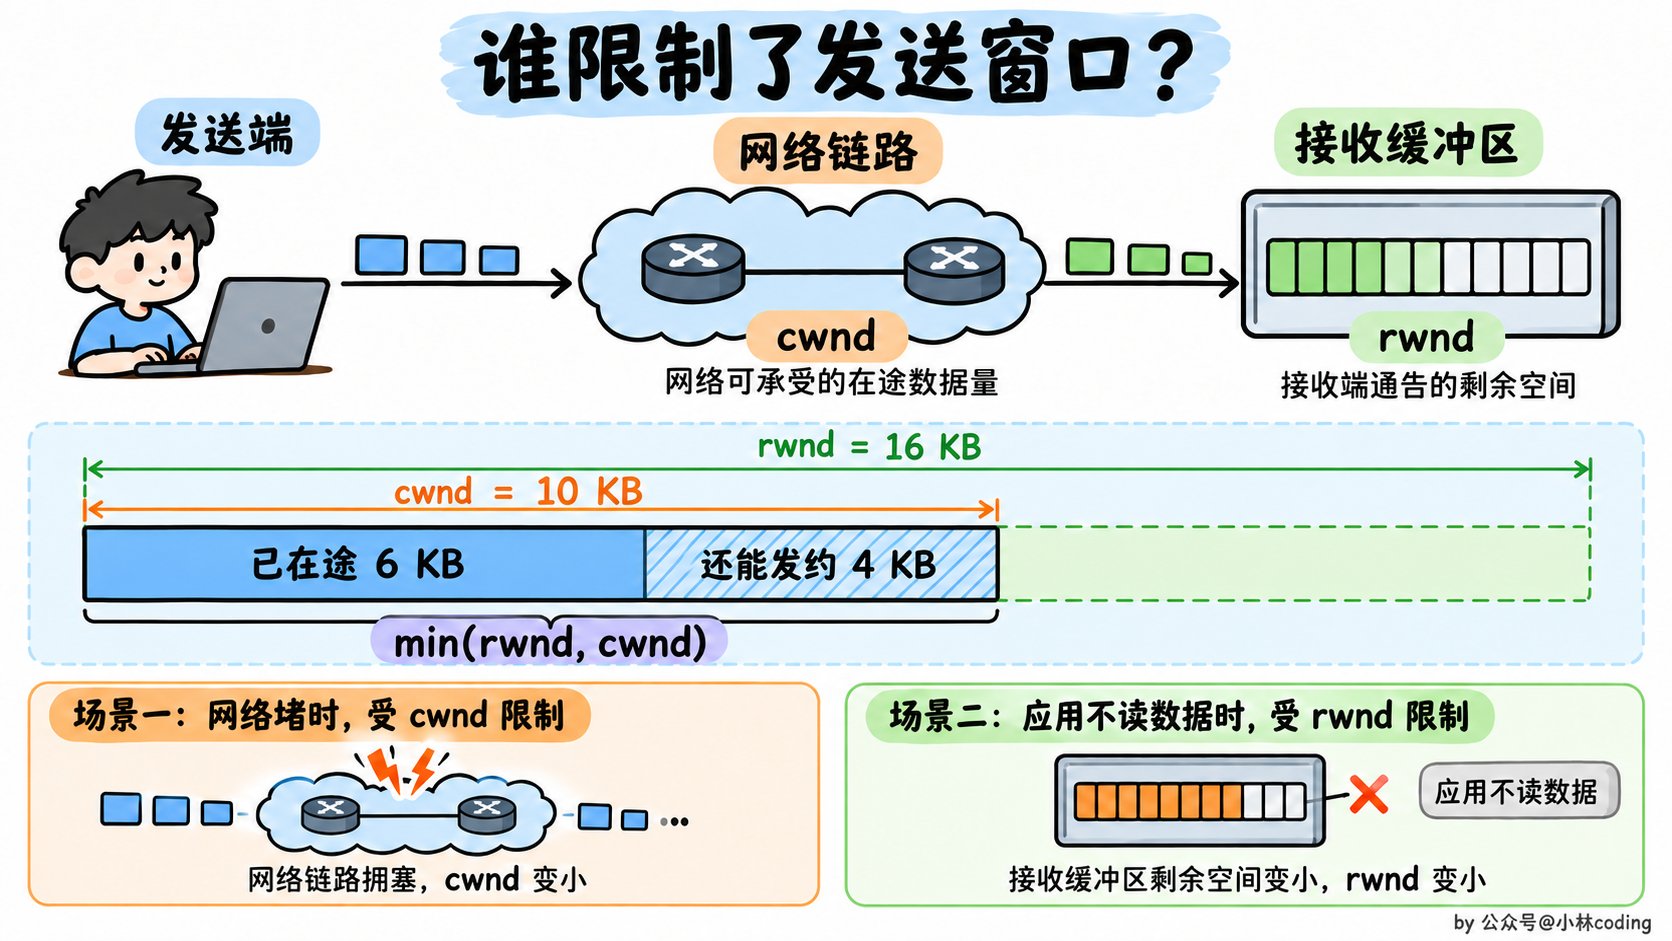
- 流量控制:由接收方通过接收窗口 rwnd 通告自己还能接收多少数据,避免发送方把接收缓冲区写满。
- 拥塞控制:发送方维护拥塞窗口 cwnd,根据 ACK、丢包、ECN 等反馈判断网络情况,控制在网络里的数据量。
发送方在途、尚未确认的数据量,通常要同时受两者约束,可以近似理解为:
允许的在途数据上限 = min(rwnd, cwnd)
如果上限是 10 KB,但已经有 6 KB 尚未确认,就不能再直接发 10 KB,而是还剩大约 4 KB 的空间。
举个例子,接收方处理很快,但网络链路已经拥堵,这时主要受 cwnd 限制;网络很空闲,但接收方业务线程不读数据,这时主要受 rwnd 限制。
# TCP 接收窗口变成 0,会发生什么?
接收方来不及读取数据,缓冲区没有空间时,可以通告零窗口。发送方收到后,会暂停发送新的普通数据,但连接不会因此立即断开。
等接收方腾出空间,会发送窗口更新。问题是,如果这个更新报文丢了,发送方一直等窗口打开,接收方一直等新数据,就可能互相等下去。
所以 TCP 有持续计时器和零窗口探测,发送方隔一段时间发出探测,让接收方回复当前窗口,避免因为窗口更新丢失而一直卡住。
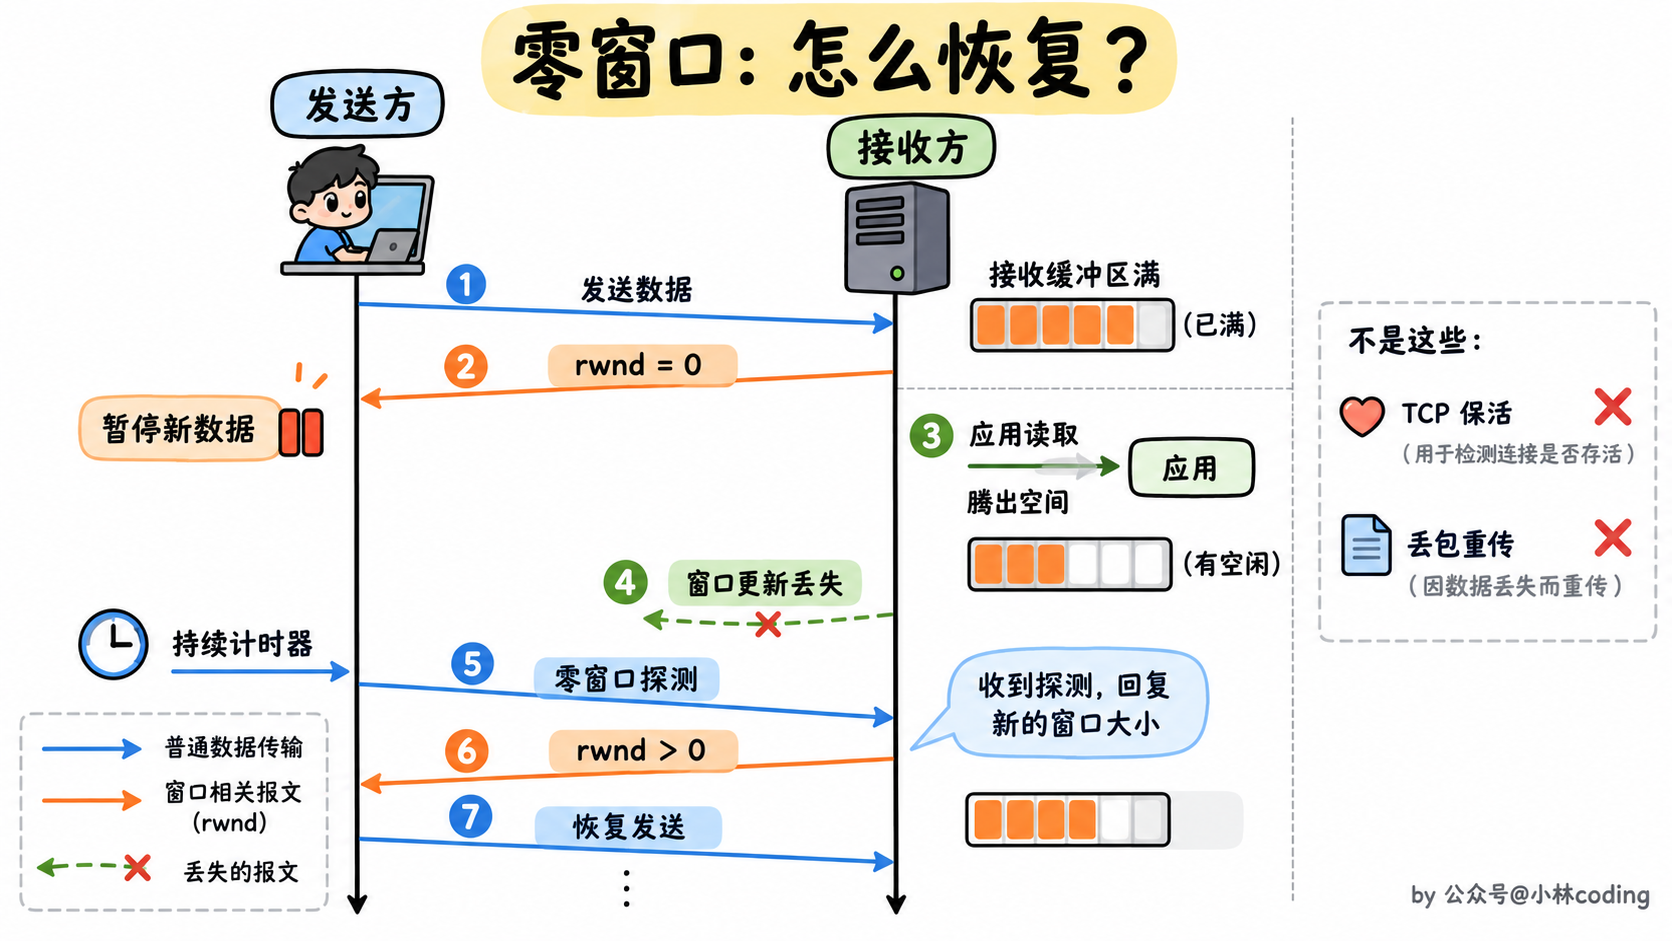
排障时,如果抓包经常出现 Zero Window,要先看接收端是不是没及时读数据、业务线程卡住了,或者处理能力不足,不能一看到传输慢就判断网络拥堵。
# TCP 超时重传、快速重传和 SACK 有什么区别?
它们主要区别在于什么时候判断丢包,以及怎么知道需要补哪些数据。
- 超时重传:发出数据之后,超过 RTO 仍未收到对应确认,就重传。RTO 根据往返时间 RTT 及其波动估算,不是固定不变的值,连续超时通常还会退避。
- 快速重传:经典机制里,发送方收到 3 个重复 ACK,就认为可能有数据丢失,不等 RTO 到期便重传缺失的数据。
- SACK,选择性确认:接收方在 ACK 选项中告诉发送方,除了连续收到的部分,还收到了哪些不连续的数据块,让发送方更准确地补缺口。
比如第 2 段丢了,第 3、4、5 段都到了,接收方仍然累计确认第 2 段之前的内容,但可以通过 SACK 告诉发送方后面哪些区间已经收到,减少重复发送。
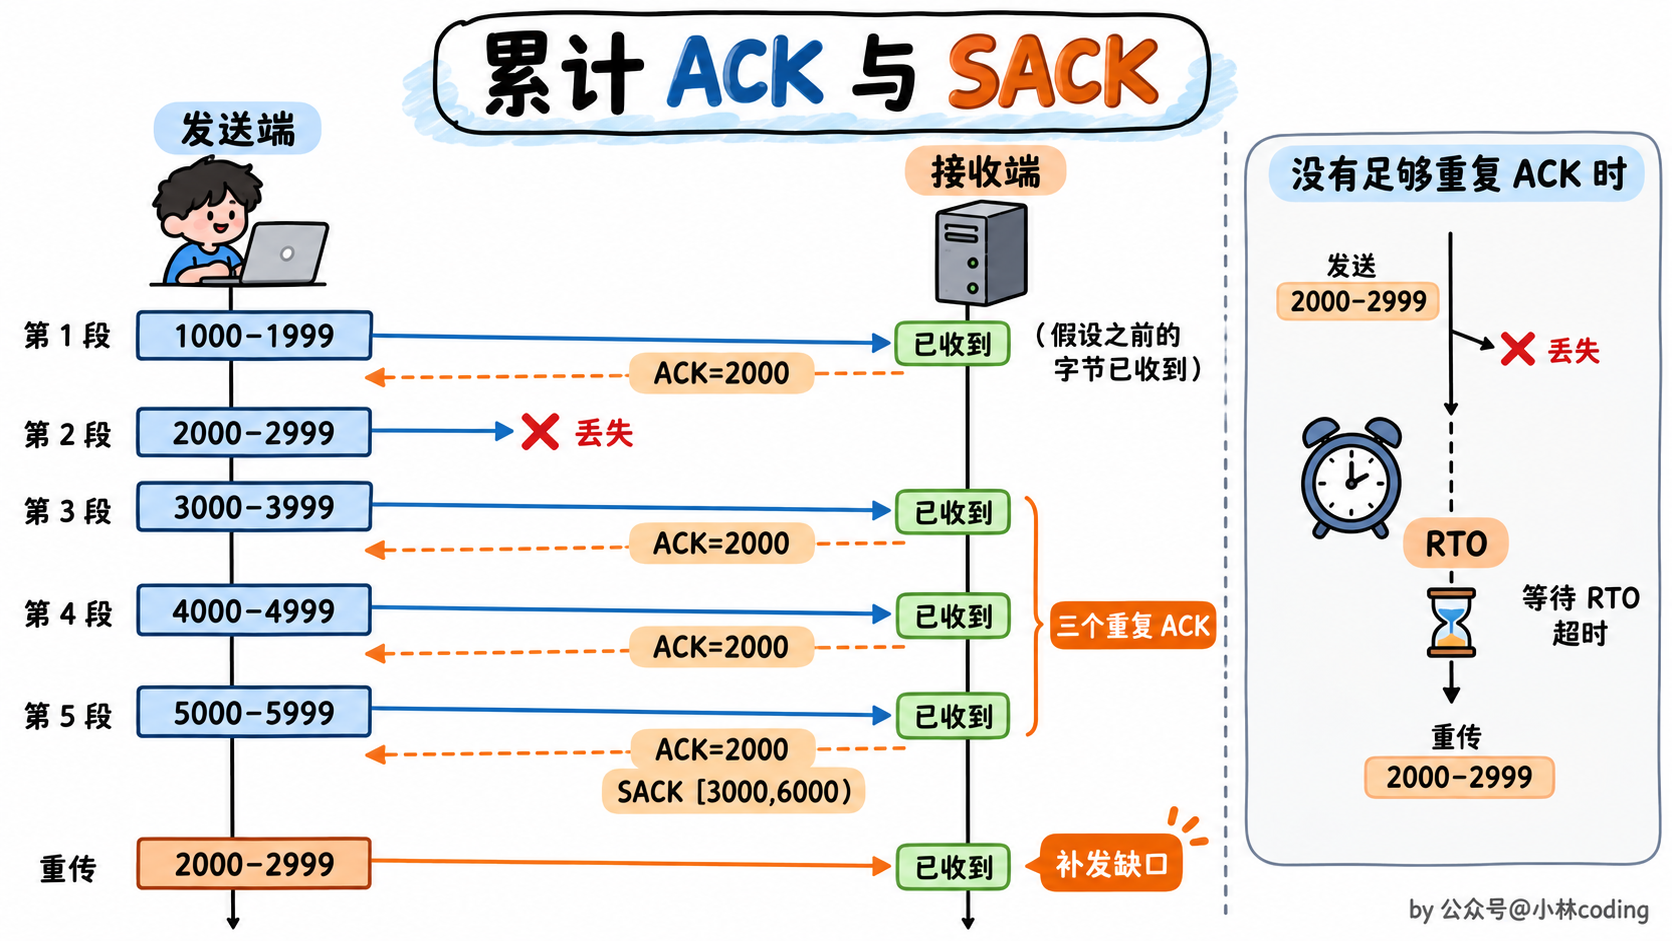
不过,重复 ACK 也可能由乱序等情况造成,不一定是报文真的丢了。实际协议栈还可能使用更丰富的丢包检测机制,面试时先把经典机制讲清楚。
# TCP 的 MSS 和 MTU 有什么区别?
MTU 限制一层能装下多大的包,MSS 限制一个 TCP 段能携带多大的 TCP 数据。
以常见以太网为例,MTU 为 1500 字节,表示 IP 包通常不能超过 1500 字节。假设 IPv4 首部是 20 字节、TCP 首部是 20 字节,那么 TCP 数据通常最多是:
1500 - 20 - 20 = 1460 字节
这个 1460 就是常见的 MSS 值。不过 IPv6、TCP 选项、隧道封装和实际路径都可能影响有效载荷大小,不能把 MSS 永远记成 1460。
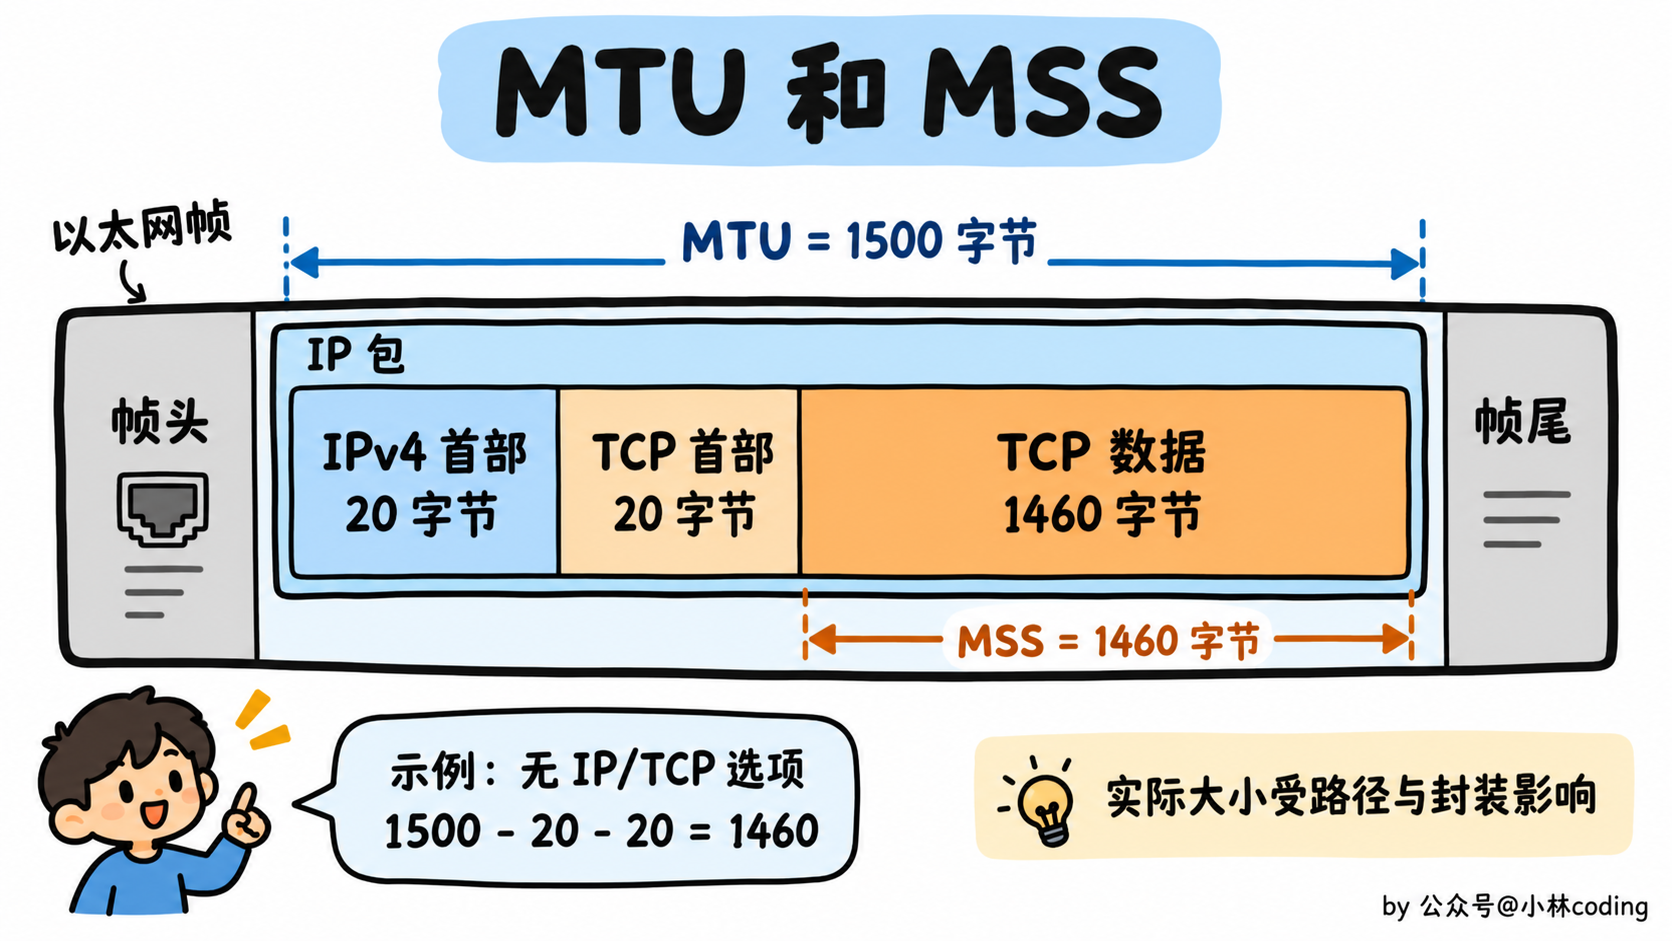
握手时,双方可以分别通告自己愿意接收的 MSS;发送方还需要考虑路径 MTU。减少 IP 分片通常有利于传输,不能认为 TCP 数据越大越好。
# TCP的拥塞控制介绍一下?
一般来说,计算机网络都处在一个共享的环境。因此也有可能会因为其他主机之间的通信使得网络拥堵。
在网络出现拥堵时,如果继续发送大量数据包,可能会导致数据包时延、丢失等,这时 TCP 就会重传数据,但是一重传就会导致网络的负担更重,于是会导致更大的延迟以及更多的丢包,这个情况就会进入恶性循环被不断地放大....
所以,TCP 不能忽略网络上发生的事,它被设计成一个无私的协议,当网络发生拥塞时,TCP 会自我牺牲,降低发送的数据量。
于是,就有了拥塞控制,控制的目的就是避免「发送方」的数据填满整个网络。
为了在「发送方」调节所要发送数据的量,定义了一个叫做「拥塞窗口」的概念。
拥塞窗口 cwnd 是发送方维护的状态变量,会根据网络反馈动态变化。发送窗口可以近似理解为 swnd = min(cwnd, rwnd),也就是拥塞窗口和接收窗口中的较小值。已经发送但尚未确认的数据,会占用这部分窗口。
拥塞窗口 cwnd 变化的规则:
- 只要网络中没有出现拥塞,cwnd 就会增大;
- 但网络中出现了拥塞,cwnd 就减少;
那么怎么知道当前网络是否出现了拥塞呢?其实只要「发送方」没有在规定时间内接收到 ACK 应答报文,也就是发生了超时重传,就会认为网络出现了拥塞。
拥塞控制有哪些控制算法?
面试里通常先讲经典 Reno 的四个机制:
- 慢启动
- 拥塞避免
- 快速重传
- 快速恢复
下面以这个模型解释。实际系统也可能使用 CUBIC、BBR 等算法,增长和退让规则并不完全相同。
慢启动
TCP 在刚建立连接完成后,首先是有个慢启动的过程,这个慢启动的意思就是一点一点的提高发送数据包的数量,如果一上来就发大量的数据,这不是给网络添堵吗?
在下面的简化例子里,以 MSS 为单位,并假设每个新 ACK 都确认一个完整数据段:慢启动时,每收到这样的 ACK,cwnd 增加 1 个 MSS,整体上约每个 RTT 翻倍。
这里假定拥塞窗口 cwnd 和发送窗口 swnd 相等,下面举个栗子:
- 为了方便说明,假设初始 cwnd = 1,表示可以传一个 MSS 大小的数据。实际初始窗口不一定只有 1 个 MSS。
- 当收到一个 ACK 确认应答后,cwnd 增加 1,于是一次能够发送 2 个
- 当收到 2 个的 ACK 确认应答后, cwnd 增加 2,于是就可以比之前多发2 个,所以这一次能够发送 4 个
- 当这 4 个的 ACK 确认到来的时候,每个确认 cwnd 增加 1, 4 个确认 cwnd 增加 4,于是就可以比之前多发 4 个,所以这一次能够发送 8 个。
慢启动算法的变化过程如下图:
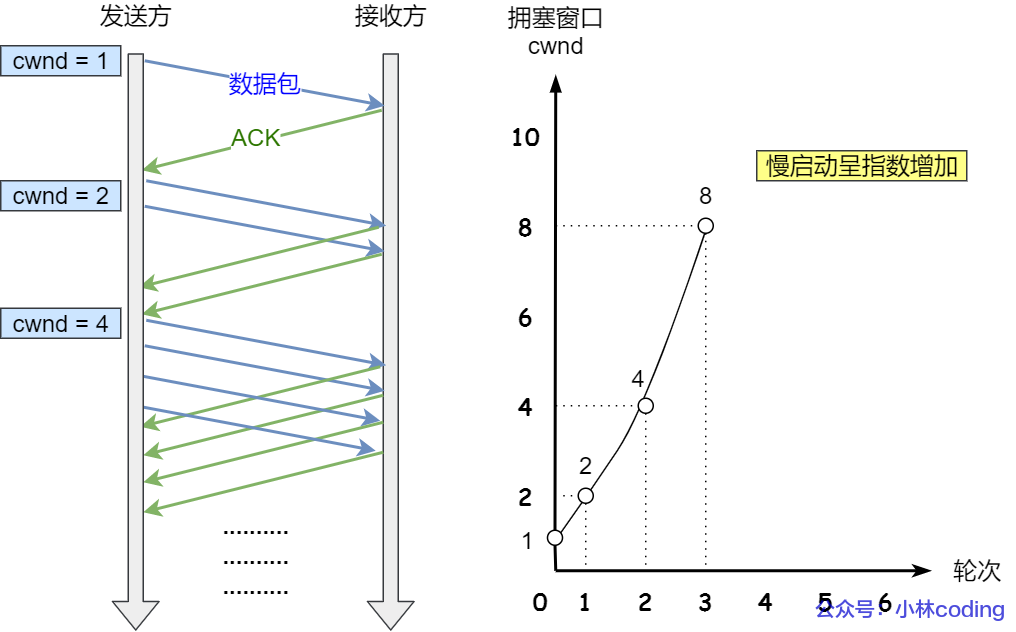
可以看出慢启动算法,发包的个数是指数性的增长。
那慢启动涨到什么时候是个头呢?
有一个叫慢启动门限 ssthresh (slow start threshold)状态变量。
- 当 cwnd < ssthresh 时,使用慢启动算法。
- 当 cwnd >= ssthresh 时,就会使用「拥塞避免算法」。
拥塞避免算法
前面说道,当拥塞窗口 cwnd 「超过」慢启动门限 ssthresh 就会进入拥塞避免算法。
ssthresh 是发送方维护的慢启动门限,并不是固定的 65535 字节,也不是 TCP 首部里的接收窗口字段。它会受到实现和拥塞反馈等因素影响。
那么进入拥塞避免算法后,它的规则是:每当收到一个 ACK 时,cwnd 增加 1/cwnd。
接上前面的慢启动的栗子,现假定 ssthresh 为 8:
- 当 8 个 ACK 应答确认到来时,每个确认增加 1/8,8 个 ACK 确认 cwnd 一共增加 1,于是这一次能够发送 9 个 MSS 大小的数据,变成了线性增长。
拥塞避免算法的变化过程如下图:
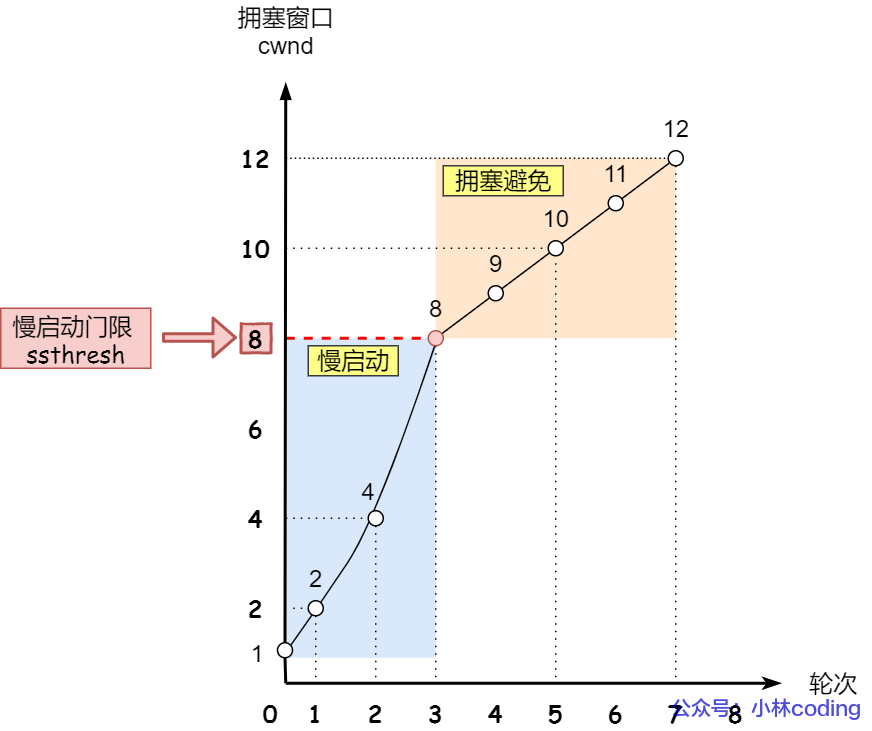
所以,我们可以发现,拥塞避免算法就是将原本慢启动算法的指数增长变成了线性增长,还是增长阶段,但是增长速度缓慢了一些。
就这么一直增长着后,网络就会慢慢进入了拥塞的状况了,于是就会出现丢包现象,这时就需要对丢失的数据包进行重传。
当触发了重传机制,也就进入了「拥塞发生算法」。
拥塞发生
经典 Reno 会根据丢包反馈收缩拥塞窗口,不过丢包也可能来自链路错误或乱序,不能把丢包和拥塞完全画等号。这里主要区分两种情况:
- 超时重传
- 快速重传
这两种情况使用的拥塞处理方式不同,接下来分别来说说。
发生超时重传的拥塞发生算法
当发生了「超时重传」,则就会使用拥塞发生算法。
这个时候,ssthresh 和 cwnd 的值会发生变化。下面把在途数据量近似看作 cwnd,并以 MSS 为单位说明减半;实际 ssthresh 通常按在途数据量计算,并有最小值限制:
- ssthresh 设为 cwnd/2,
- cwnd 重置为 1 (是恢复为 cwnd 初始化值,我这里假定 cwnd 初始化值 1)
拥塞发生算法的变化如下图:
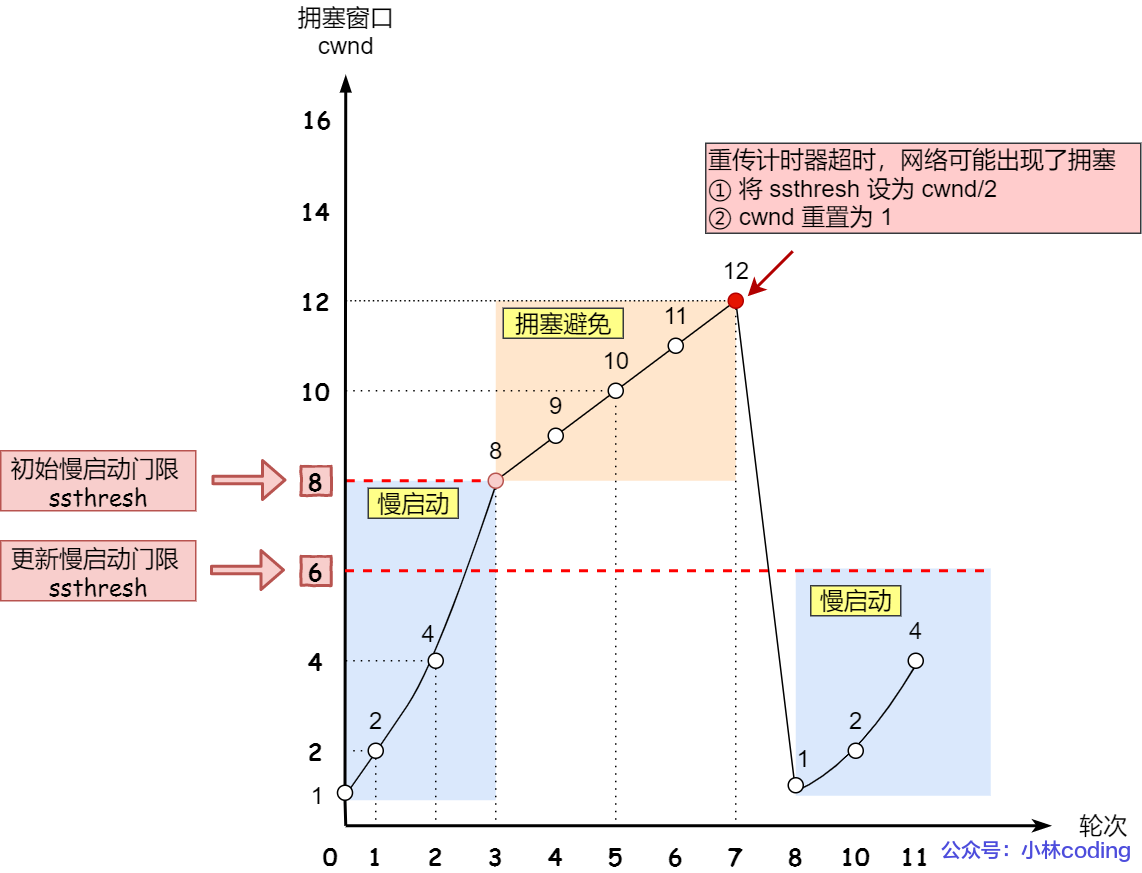
接着,就重新开始慢启动,慢启动是会突然减少数据流的。这真是一旦「超时重传」,马上回到解放前。但是这种方式太激进了,反应也很强烈,会造成网络卡顿。
就好像本来在秋名山高速漂移着,突然来个紧急刹车,轮胎受得了吗。。。
发生快速重传的拥塞发生算法
还有更好的方式,前面我们讲过「快速重传算法」。如果接收方连续收到缺口之后的数据,会重复发送指向缺口的累计 ACK。发送方收到 3 个重复 ACK 后,就可以触发快速重传,不必等到超时。
TCP 认为这种情况不严重,因为大部分没丢,只丢了一小部分,则 ssthresh 和 cwnd 变化如下:
- cwnd = cwnd/2 ,也就是设置为原来的一半;
- ssthresh = cwnd;
- 进入快速恢复算法
快速恢复
快速重传和快速恢复算法一般同时使用,快速恢复算法是认为,你还能收到 3 个重复 ACK 说明网络也不那么糟糕,所以没有必要像 RTO 超时那么强烈。
正如前面所说,进入快速恢复之前,cwnd 和 ssthresh 已被更新了:
- cwnd = cwnd/2 ,也就是设置为原来的一半;
- ssthresh = cwnd;
然后,进入快速恢复算法如下:
- 拥塞窗口 cwnd = ssthresh + 3 ( 3 的意思是确认有 3 个数据包被收到了);
- 重传丢失的数据包;
- 如果再收到重复的 ACK,那么 cwnd 增加 1;
- 在这个经典 Reno 的简化模型里,收到确认新数据的 ACK 后,把 cwnd 收缩到 ssthresh,退出快速恢复,进入拥塞避免。一次丢多个数据段时,NewReno、SACK 等机制还会采用更细致的恢复处理;
快速恢复算法的变化过程如下图:
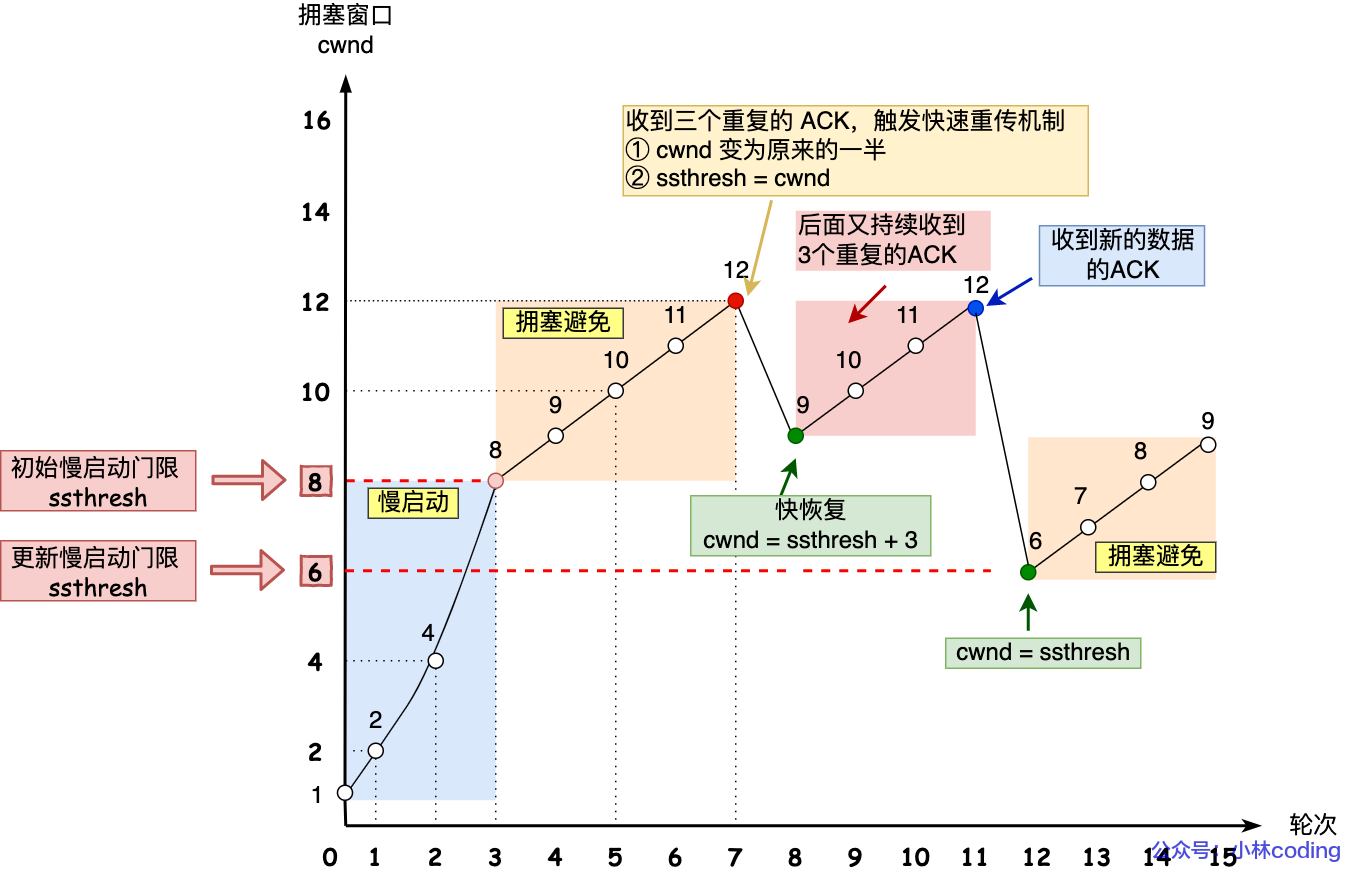
也就是没有像「超时重传」一夜回到解放前,而是还在比较高的值,后续呈线性增长。
# 网络层和链路层
# IP 地址和 MAC 地址有什么区别?
IP 地址主要负责跨网络的寻址和路由,MAC 地址主要用于当前链路上的帧传输。
比如你访问一个外网服务器,IP 包的目标地址写的是服务器 IP,但从电脑发出的以太网帧,目标 MAC 通常写的是网关 MAC,不是远端服务器的 MAC。
路由器收到帧,取出 IP 包,根据路由表选择下一跳,再为下一段链路重新封装帧。因此,MAC 地址会随着经过的链路变化;没有 NAT 等地址转换时,源和目的 IP 通常保持不变,TTL 则逐跳减少。
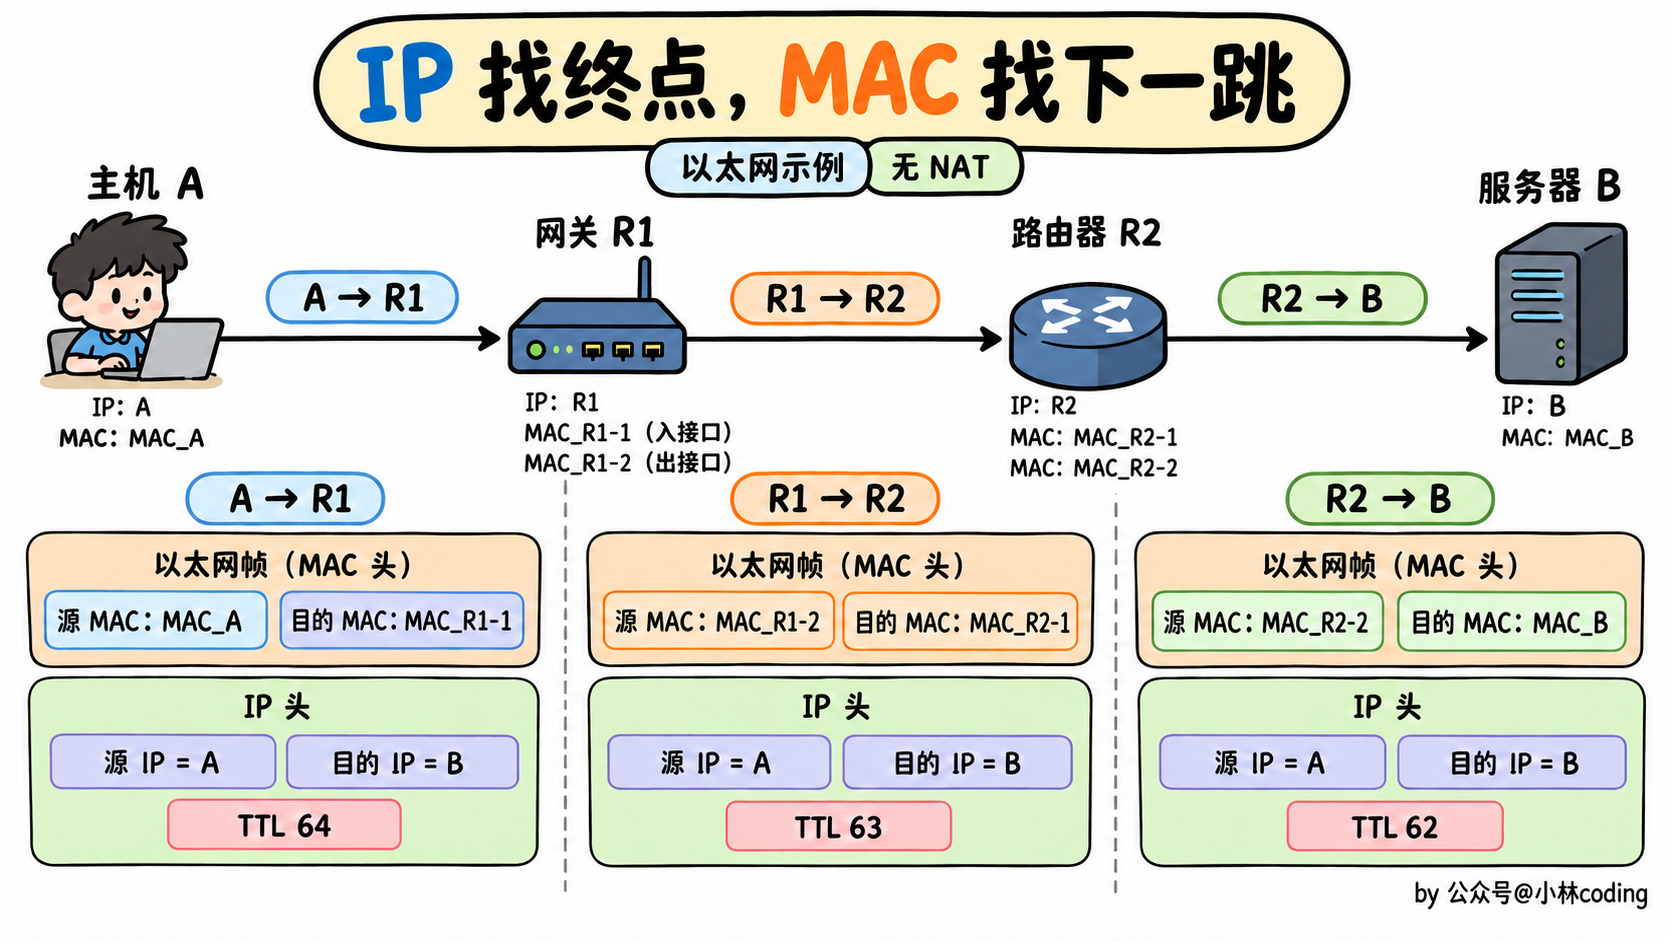
MAC 也不是绝对不能修改,更不能拿它作为跨互联网识别用户身份的可靠依据。
# ARP 是什么?访问外网时查询谁的 MAC 地址?
ARP 用于在 IPv4 的本地链路上,根据 IP 地址查询对应的 MAC 地址。如果 ARP 缓存里没有记录,主机会广播询问「谁拥有这个 IP」,对应主机再回复自己的 MAC 地址。
访问同一子网的主机时,通常查询目标主机的 MAC;访问外网时,要先看路由表,通常把数据交给默认网关,查询的是网关的 MAC。
ARP 广播不会被普通路由器转发到整个互联网,所以你的电脑不会通过 ARP 直接查出百度服务器的 MAC。IPv6 则使用邻居发现机制,不使用 ARP。
# ICMP 是什么?ping 和 traceroute 的原理是什么?
ICMP 用于传递网络错误和控制信息,不使用 TCP、UDP 那样的端口。
- ping:通常发送 ICMP Echo Request,收到 Echo Reply 后估算往返时间和丢包情况。
- traceroute:从较小的 TTL 开始探测,逐步增加 TTL。路由器发现 TTL 耗尽,通常返回 ICMP Time Exceeded,借此观察经过哪些跳。不同实现可能用 UDP、ICMP 或 TCP 发送探测。
不过,路由器可能限制或不回应探测,所以 traceroute 出现星号不一定表示业务流量在那一跳被丢弃;ping 不通也不等于 TCP 服务一定不可用。
# NAT 是什么?为什么内网多个设备能共用一个公网 IP?
NAT 就是网络地址转换,家用路由器常见的是同时转换地址和端口,也叫 NAPT/PAT。
比如两台内网电脑都访问同一个网站,路由器可以把它们的源地址和端口改成同一个公网 IP 下的两个不同端口,并保存映射关系。服务器回包后,路由器再根据映射,把响应转回对应的内网电脑。
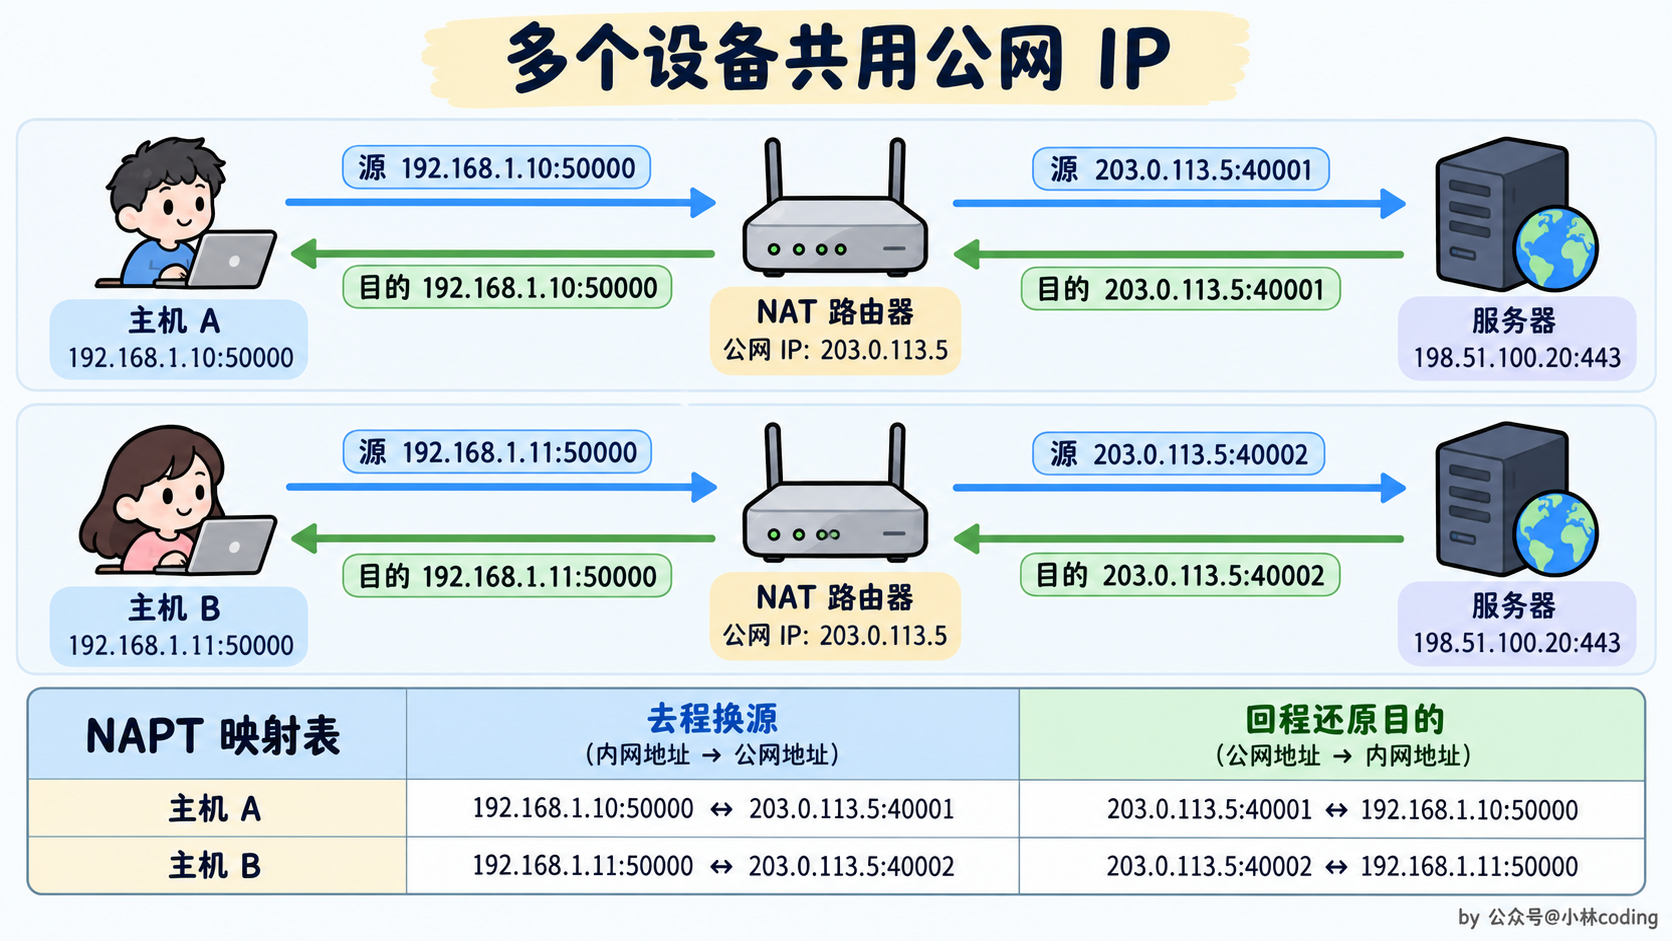
所以,多个设备可以共用一个公网 IP,靠的不只是替换 IP,还要通过端口等信息区分会话。
这也解释了为什么外部通常不能直接主动连接内网服务:如果没有已有映射、端口转发或其他连通机制,路由器不知道该把请求交给哪台内网设备。
# 网络场景
# 描述一下打开百度首页后发生的网络过程
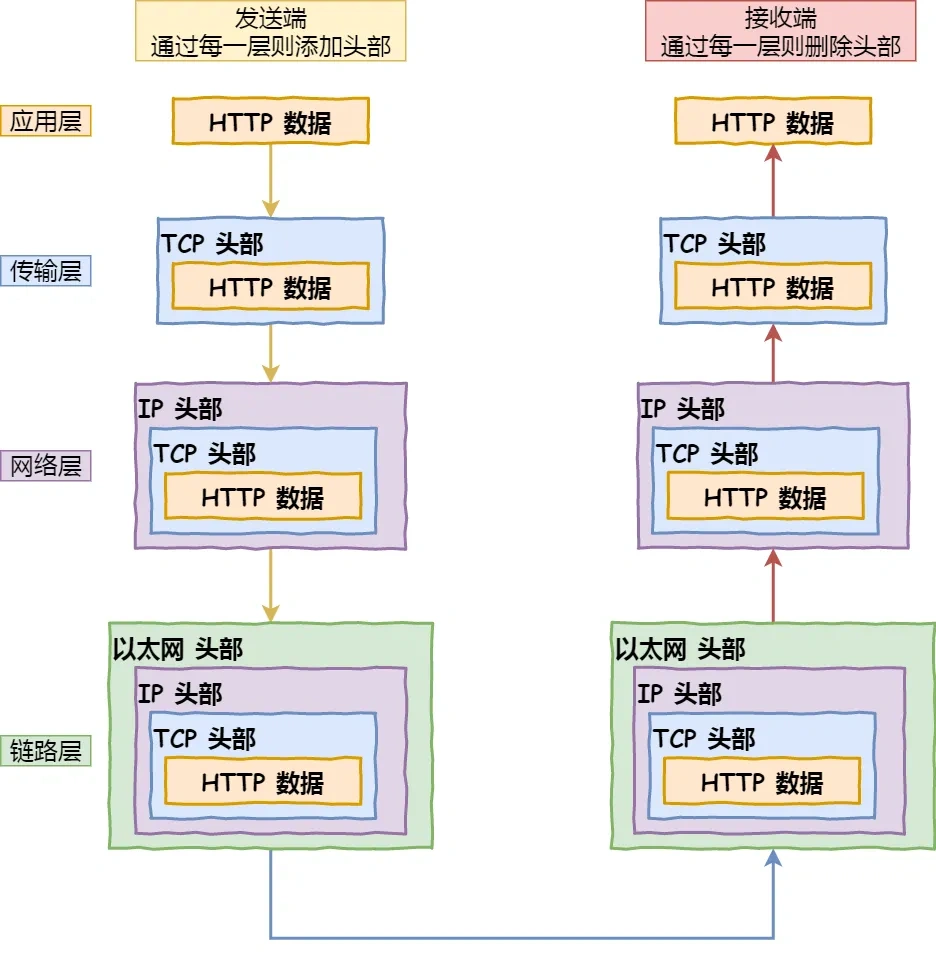
这里以访问一个 HTTPS 页面、使用 HTTP/1.1 或 HTTP/2 为例:
- 解析 URL 和检查缓存:浏览器确定协议、主机、端口和资源路径,再根据缓存规则判断是否需要请求网络。如果能直接使用有效缓存,就可以省掉对应的网络请求。
- DNS 解析:需要连接时,浏览器根据自己的配置、解析缓存、系统解析机制和 hosts 等获取 IP。如果没有可用结果,就向 DNS 解析服务查询。具体路径会受浏览器加密 DNS、代理等配置影响,不是固定经过「路由器缓存、ISP 缓存」。
- 确定下一跳:操作系统根据路由表决定从哪个网卡、向哪个下一跳发送。以 IPv4 以太网为例,同一子网时通过 ARP 查目标 MAC;访问外网时通常查网关 MAC。
- 建立 TCP 连接:客户端和服务端完成三次握手。这里可能连接到 CDN 或反向代理,而不是最终的业务服务器。
- TLS 握手:协商版本和密钥,验证服务端证书,再建立加密通信。具体往返次数取决于 TLS 版本和是否恢复会话,不能统一说成四次握手。
- 发送 HTTP 请求:浏览器发送请求,可能携带 Cookie、缓存验证字段等。
- 服务端返回响应:缓存节点直接返回内容,或者后端处理请求后返回状态码、响应头和响应体。
- 解析和渲染页面:浏览器解析 HTML,构建 DOM,加载 CSS、JavaScript、图片等资源,再进行样式计算、布局和绘制。页面里的资源请求也可能复用现有连接。
面试时要补一句:这些步骤不是每次都完整重走。连接可以复用,DNS 和资源可以缓存;使用 HTTP/3 时,则通过 QUIC 建立安全连接,不再先做 TCP 三次握手。
# 网页非常慢转圈圈的时候,要定位问题需要从哪些角度?
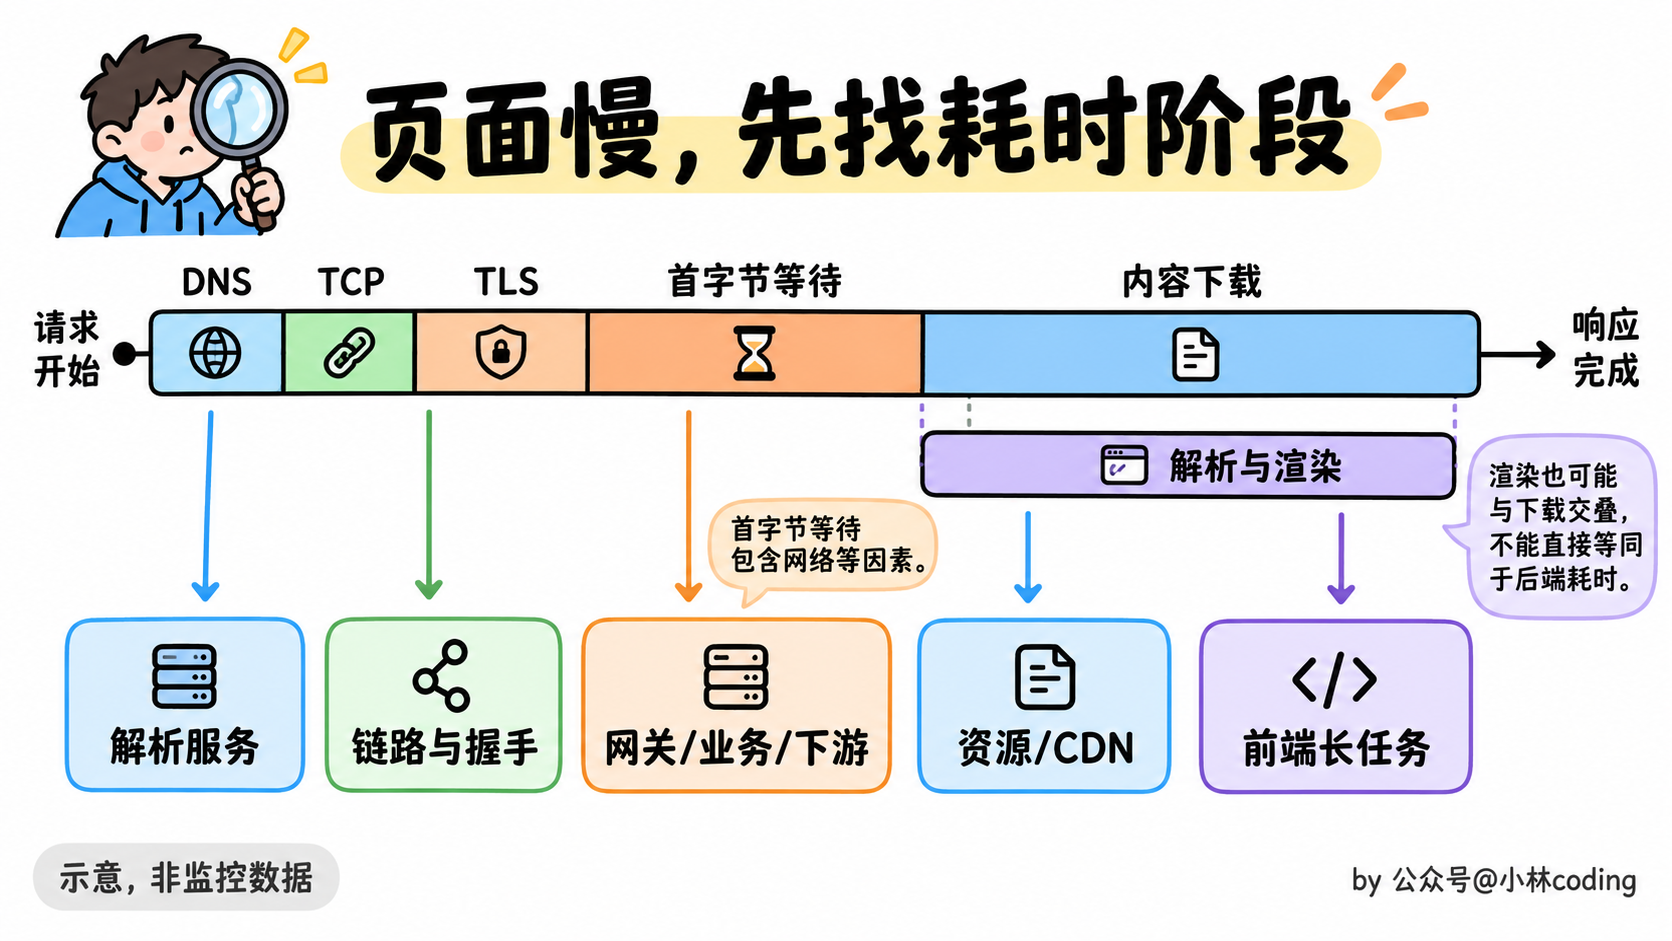
先不要一上来就判断「网络不好」。页面慢可能是 DNS、建连、服务端处理、下载资源,也可能是浏览器渲染慢,要先找时间花在哪一段。
可以先打开浏览器开发者工具的 Network,看请求的 Timing 和瀑布图:
- DNS 慢:检查解析服务器、缓存和网络情况,确认解析到的 IP 是否正确,不是解析失败就一定代表域名写错。
- 连接或 TLS 握手慢:检查往返时延、丢包、代理、防火墙和证书相关问题,必要时抓包看 SYN、重传和 TLS 消息。
- 等待首字节 TTFB 很长:请求可能已经到了服务器,要结合网关日志、调用链、数据库和下游接口排查。TTFB 也包含网络等待,不能直接等同于后端代码执行时间。
- 内容下载慢:看资源大小、带宽、压缩、CDN 命中率和重传情况,尤其注意大图片、大脚本等资源。
- 请求结束但页面仍然卡:看 Performance、控制台报错、长任务、脚本执行和布局开销。返回 200 只说明请求成功,不代表页面已经正常渲染。
同时比较「所有网站都慢,还是只有这个网站慢」「所有用户都慢,还是某个地区或网络慢」,可以帮助缩小范围。
如果浏览器信息不够,再用 curl 看分段耗时,或用 tcpdump、Wireshark 抓包,并把客户端时间和服务端日志对起来。先定位阶段,再找原因,比只看一个状态码更有效。
# server a和server b,如何判断两个服务器正常连接?出错怎么办?
在一条 TCP 连接建立之后,如果双方长时间都没有数据交互,那么它们是没办法主动感知到对端是否依然存活的。举个例子:如果客户端突然发生机器宕机或者网络断开,而此时服务端如果一直不会发送数据给客户端,那么服务端是永远无法感知到客户端宕机这个事件的,也就是服务端的 TCP 连接将一直处于 ESTABLISHED 状态,占用着系统资源。
为了避免这种情况,TCP 搞了个保活机制。这个机制的原理是这样的:定义一个时间段,在这个时间段内,如果没有任何连接相关的活动,TCP 保活机制会开始作用,每隔一个时间间隔,发送一个探测报文,该探测报文包含的数据非常少,如果连续几个探测报文都没有得到响应,则认为当前的 TCP 连接已经死亡,系统内核将错误信息通知给上层应用程序。
在 Linux 内核可以有对应的参数可以设置保活时间、保活探测的次数、保活探测的时间间隔,以下都为默认值:
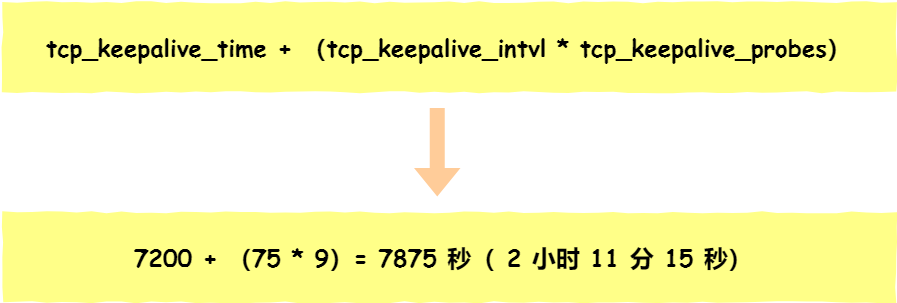
net.ipv4.tcp_keepalive_time=7200
net.ipv4.tcp_keepalive_intvl=75
net.ipv4.tcp_keepalive_probes=9
- tcp_keepalive_time=7200:表示保活时间是 7200 秒(2小时),也就 2 小时内如果没有任何连接相关的活动,则会启动保活机制
- tcp_keepalive_intvl=75:表示每次检测间隔 75 秒;
- tcp_keepalive_probes=9:表示检测 9 次无响应,认为对方是不可达的,从而中断本次的连接。
按这组常见默认参数估算,要经过大约 2 小时再加上数分钟,才可能判断连接失效。实际耗时取决于运行系统、socket 配置和探测结果,不能把这个等待时间当成业务请求超时。
注意,应用程序若想使用 TCP 保活机制需要通过 socket 接口设置 SO_KEEPALIVE 选项才能够生效,如果没有设置,那么就无法使用 TCP 保活机制。
如果开启了 TCP 保活,需要考虑以下几种情况:
- 第一种,对端程序是正常工作的。当 TCP 保活的探测报文发送给对端, 对端会正常响应,这样 TCP 保活时间会被重置,等待下一个 TCP 保活时间的到来。
- 第二种,对端主机宕机并重启。当 TCP 保活的探测报文发送给对端后,对端是可以响应的,但由于没有该连接的有效信息,会产生一个 RST 报文,这样很快就会发现 TCP 连接已经被重置。
- 第三种,是对端主机宕机(注意不是进程崩溃,进程崩溃后,操作系统会回收 socket,通常能够发起关闭,但也可能因未读数据等情况发送 RST,而主机宕机则是无法感知的,所以需要 TCP 保活机制来探测对方是不是发生了主机宕机),或对端由于其他原因导致报文不可达。当 TCP 保活的探测报文发送给对端后,石沉大海,没有响应,连续几次,达到保活探测次数后,TCP 会报告该 TCP 连接已经死亡。
TCP 保活主要判断对端的协议栈能不能响应,检测间隔也可能比较长。如果要判断业务服务是否正常,还需要应用层心跳和请求超时。
比如定期发送一个心跳请求,要求对端在约定时间内回复。持续没有回复,就把连接或服务实例判为不可用。不过心跳超时也可能由网络抖动、进程暂停等造成,要结合连续失败次数,避免频繁误判。
还要区分 HTTP 服务里的 keepalive_timeout,它主要用于回收空闲长连接,不是在检测业务心跳。比如设置为 60 秒,完成请求后 60 秒都没有新请求,就可以关闭连接。
另外,发现连接不可用后要按业务决定重连、摘除节点或报错。不能把失败请求全部无条件重试,尤其是支付、下单这类请求,要考虑操作是否已经执行以及是否支持幂等。
# 服务端正常启动了,但是客户端请求不到有哪些原因?如何排查?
**进程启动成功,不代表端口已经监听,更不代表客户端到服务端的整条链路都正常。**可以分几层检查:
- 地址和监听:确认域名、IP、端口、协议和路径,用
ss -lntp查看服务是否监听。只监听 127.0.0.1 时,远程客户端无法直接访问;容器内监听还要确认端口映射。 - DNS 和路由:确认客户端解析到的是正确环境的地址,检查客户端是否有到目标的路由。ping 只能作参考,不能替代端口和应用探测。
- TCP 连通性:用
nc -vz 目标IP 端口等工具探测。Connection refused 常见于没有监听或主动拒绝;一直超时则可能是丢包、策略丢弃或链路问题。 - 访问策略:检查云安全组、防火墙、网关和白名单是否允许对应来源、协议和端口,按需放行,而不是直接关闭防火墙。
- 代理和 TLS:检查客户端代理、反向代理到上游的连通性,以及 HTTPS 的证书、域名和协议配置。
- 应用处理:用 curl 发起真实请求,再结合接入日志、应用日志和调用链确认请求到了哪一层。浏览器还要检查是否因 CORS 拒绝读取响应。
如果已经收到 HTTP 响应,就根据状态码和日志继续排查:
- 400:检查请求格式、参数和 Content-Type。
- 401 / 403:检查身份凭证和访问权限,也要看是否被网关规则拦截。
- 404:检查 URL、路由和部署版本,不一定只是客户端拼错地址。
- 500:查看服务端异常日志。
- 502 / 503 / 504:分别检查上游连接和响应、服务可用性以及超时。既可能是配置问题,也可能是资源耗尽,不能只凭状态码就认定后端挂了。
必要时两端同时抓包:客户端是否发出 SYN,服务端是否收到并回复,HTTP 请求和响应分别走到了哪里,就能把问题范围进一步缩小。
# 接口超时了,可以直接重试吗?
超时只代表客户端没有及时得到结果,不代表服务端一定没有执行。
比如客户端发起扣款,服务端已经扣款成功,但响应在网络上丢了,客户端就会看到超时。如果立刻重新发起一次普通扣款,用户可能被扣两次。
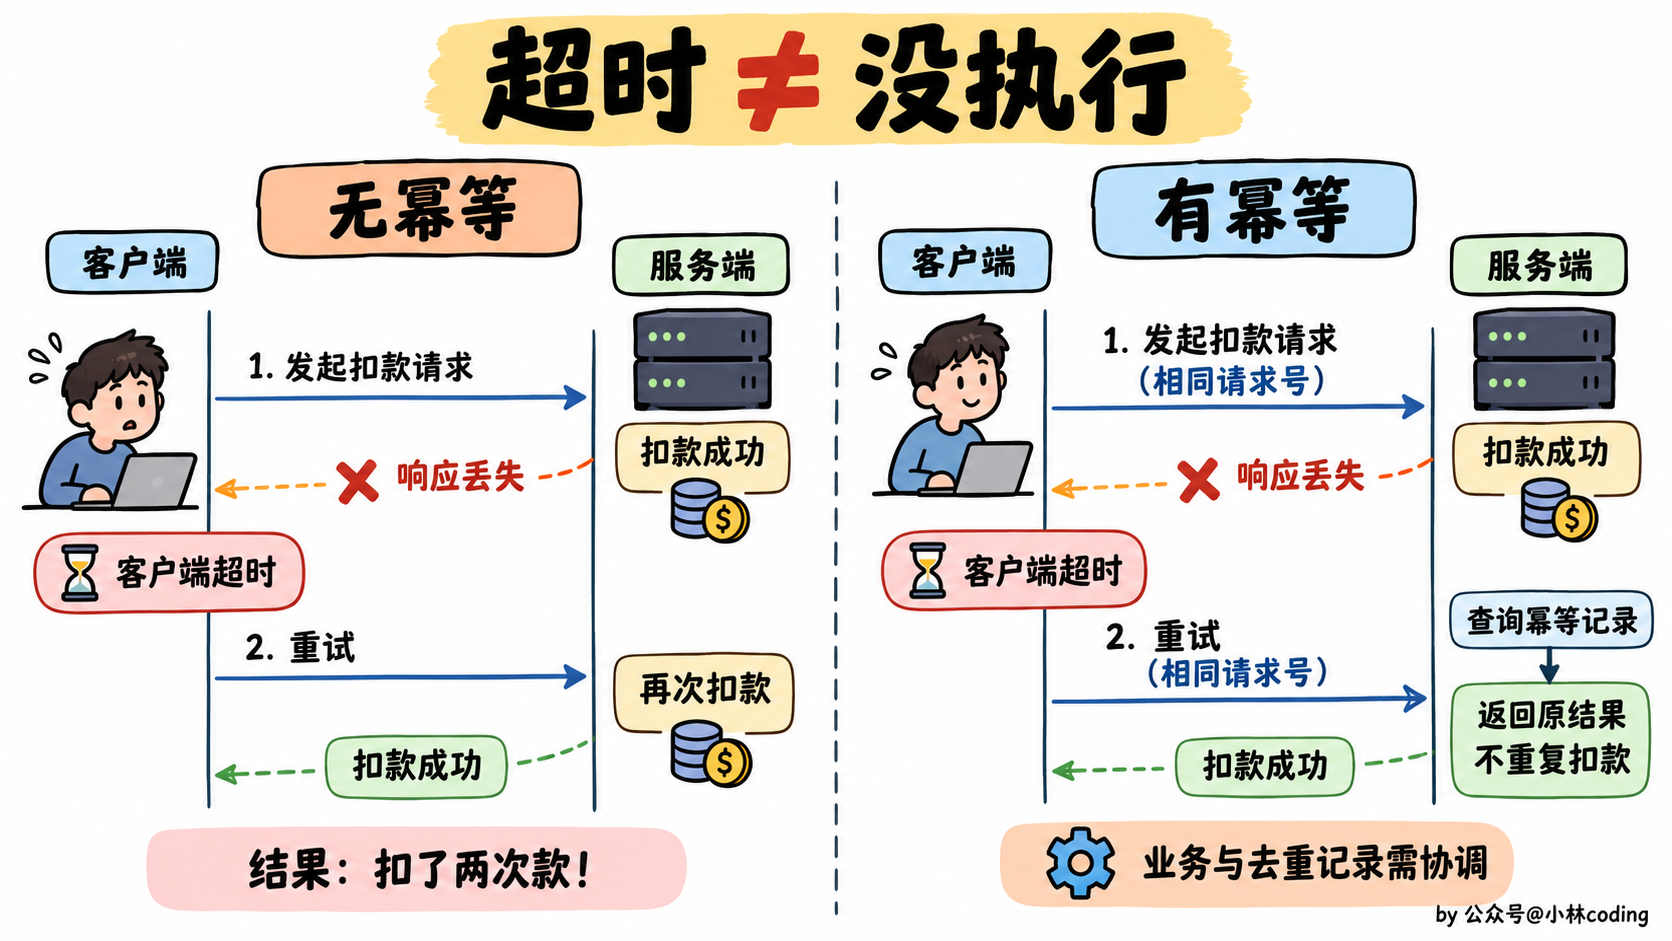
所以是否重试,要结合业务语义:
- 查询等符合幂等语义的操作,通常可以在合理范围内重试。
- 创建订单、支付等操作,需要使用业务唯一请求号、幂等键、去重记录等机制,让重复请求对应同一次业务操作。
- 不确定结果时,可以先查询原请求状态,再决定后续动作。
重试本身也会增加负载,应该限制次数和总时间,结合退避和随机抖动,避免大量客户端同时重试,把短暂故障放大。即使用 POST,只要业务实现了幂等,也可以设计成安全重试。
# TCP 连接里,send 成功是不是说明对方收到数据了?
**不是,send 成功通常只说明数据已经被本地协议栈接受。**对端是否收到、是否被应用读取、是否处理成功,是后面的事情。
还要注意,send 的返回值可能小于要发送的长度,应用需要继续发送剩余部分。非阻塞发送还可能因为缓冲区暂时没有空间而返回 EAGAIN 或 EWOULDBLOCK。
即使后面收到了 TCP ACK,也只能说明对端 TCP 层确认收到了相关字节。要知道业务成功,比如订单已创建,仍然需要业务响应和对应的持久化、幂等设计。
# 服务器ping不通但是http能请求成功,会出现这种情况吗?什么原因造成的?
会,ping 不通和 HTTP 能不能访问不是同一件事。
ping 通常使用 ICMP Echo,HTTP/1.1、HTTP/2 通常使用 TCP。服务器或网络设备可能禁止、限速 ICMP,但允许 TCP 的 80、443 端口,所以 HTTP 仍然可以成功。HTTP/3 则使用 QUIC/UDP,同样不依赖 ping 成功。
另外,域名可能解析出多个地址,ping 和浏览器访问的不一定是同一个地址;浏览器还可能通过代理访问,所以排查时要确认实际目标和路径。
反过来也一样:ping 通只能说明对应的 ICMP 探测有回应,不代表业务端口有监听,更不代表接口能正常返回。
# 网络攻击
# 什么是ddos攻击?怎么防范?
分布式拒绝服务(DDoS)攻击是通过大规模互联网流量淹没目标服务器或其周边基础设施,以破坏目标服务器、服务或网络正常流量的恶意行为。
DDoS 攻击是通过连接互联网的计算机网络进行的。这些网络由计算机和其他设备(例如 IoT 设备)组成,它们感染了恶意软件,从而被攻击者远程控制。这些个体设备称为机器人(或僵尸),一组机器人则称为僵尸网络。
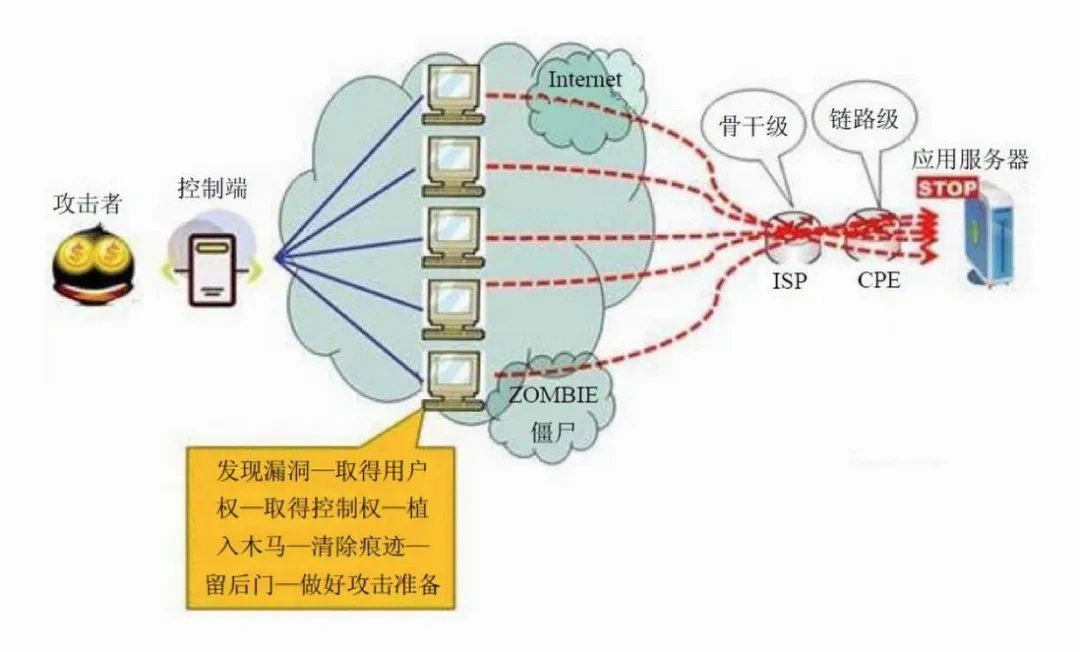
一旦建立了僵尸网络,攻击者就可通过向每个机器人发送远程指令来发动攻击。当僵尸网络将受害者的服务器或网络作为目标时,每个机器人会将请求发送到目标的 IP 地址,这可能导致服务器或网络不堪重负,从而造成对正常流量的拒绝服务。由于每个机器人都是合法的互联网设备,因而可能很难区分攻击流量与正常流量。
常见的DDoS攻击包括以下几类:
- 网络层攻击:比较典型的攻击类型是UDP反射攻击,例如:NTP Flood攻击,这类攻击主要利用大流量拥塞被攻击者的网络带宽,导致被攻击者的业务无法正常响应客户访问。
- 传输层攻击:比较典型的攻击类型包括SYN Flood攻击、连接数攻击等,这类攻击通过占用服务器的连接池资源从而达到拒绝服务的目的。
- 会话层攻击:比较典型的攻击类型是SSL连接攻击,这类攻击占用服务器的SSL会话资源从而达到拒绝服务的目的。
- 应用层攻击:比较典型的攻击类型包括DNS flood攻击、HTTP flood攻击、游戏假人攻击等,这类攻击占用服务器的应用处理资源极大的消耗服务器处理性能从而达到拒绝服务的目的。
为了防范DDoS攻击,可以采取以下措施:
- 增强网络基础设施:提升网络带宽、增加服务器的处理能力和承载能力,通过增强基础设施的能力来抵御攻击。
- 使用防火墙和入侵检测系统:配置防火墙规则,限制不必要的网络流量,阻止来自可疑IP地址的流量。入侵检测系统可以帮助及时发现并响应DDoS攻击。
- 流量清洗和负载均衡:使用专业的DDoS防护服务提供商,通过流量清洗技术过滤掉恶意流量,将合法流量转发给目标服务器。负载均衡可以将流量均匀地分发到多台服务器上,减轻单一服务器的压力。
- 配置访问控制策略:限制特定 IP 地址或 IP 段的访问,结合账号、接口和行为设置访问频率限制,避免只按 IP 限制时误伤共享出口的正常用户。
要先区分攻击打满的是带宽、连接资源,还是业务处理能力。带宽在上游就被打满时,服务器本地限流通常来不及,需要运营商或专业防护服务在上游清洗;应用层请求耗尽资源时,则要结合缓存、限流、超时、熔断等措施。单纯扩容或增加后端节点,不一定能解决所有类型的 DDoS。
# SQL注入问题是什么?
SQL 注入就是把用户输入当成 SQL 语法的一部分执行了。最典型的原因是拼接 SQL。
比如登录查询原本按用户名和密码过滤,如果直接把输入拼进去,攻击者就可能构造特殊内容改变 WHERE 条件,绕过校验,甚至读取或修改本来无权访问的数据。
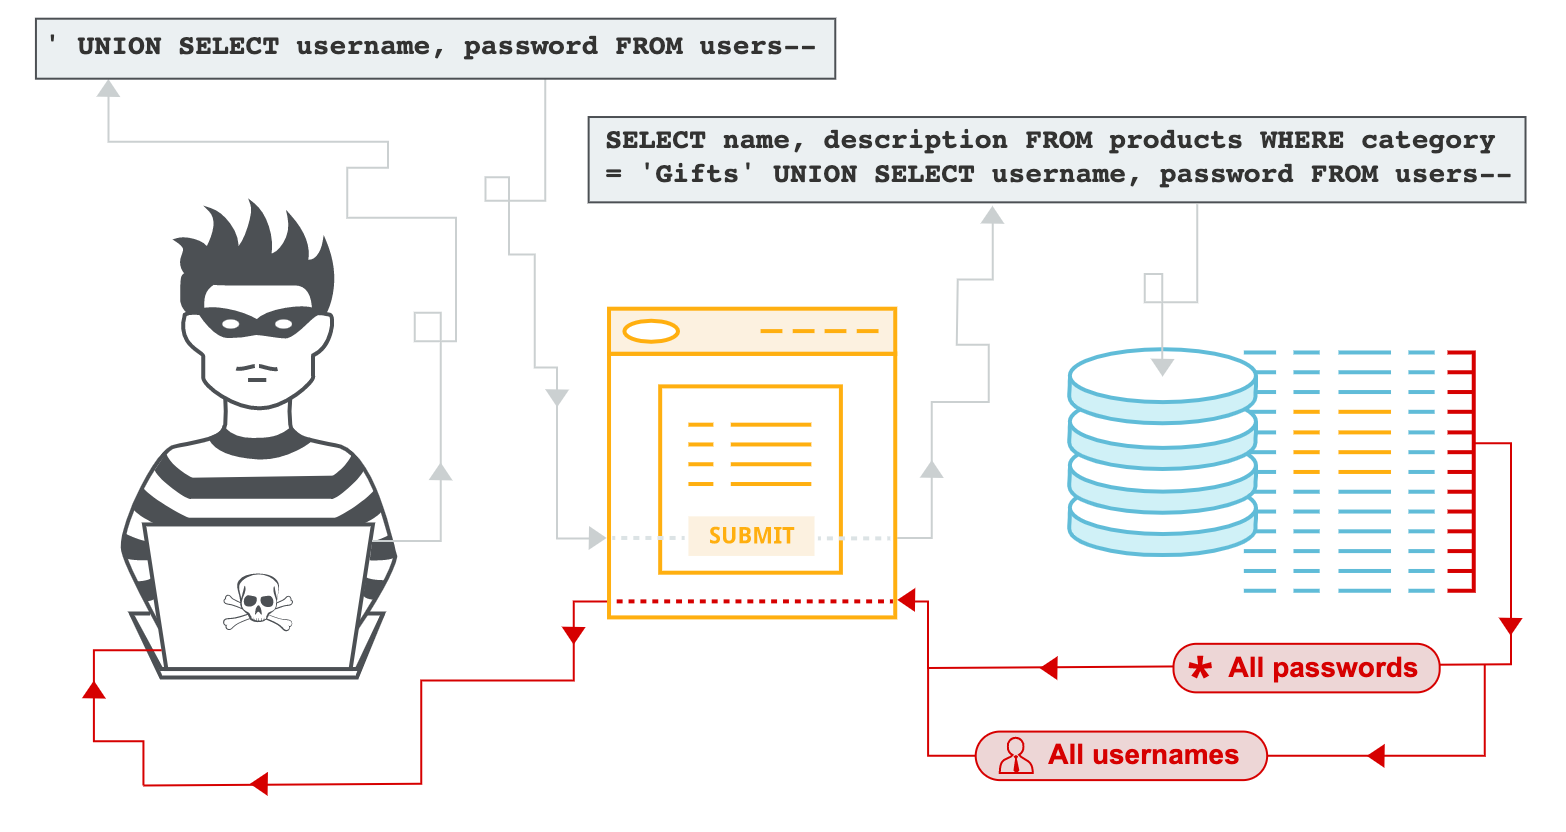
防范的重点是:
- 参数化查询:把 SQL 结构和参数值分开处理,让用户输入只作为数据,而不是 SQL 语法。使用 ORM 时,也要避免自己拼接原始 SQL。
- 动态结构使用白名单:表名、列名、排序方向等通常不能直接作为普通值参数绑定,需要映射到业务允许的固定选项。
- 最小权限:应用的数据库账号只授予需要的权限,降低出现漏洞后的影响。
- 输入校验:检查类型、长度和业务范围,作为补充措施。
不能只靠过滤引号、屏蔽几个关键词防 SQL 注入。核心是让不可信输入不能改变查询结构。
# CSRF攻击是什么?
CSRF 是跨站请求伪造,核心是利用浏览器会自动携带身份凭证,让服务端把攻击者诱导的请求当成用户自己的操作。
举个例子,你已经登录了一个网站,浏览器保存着登录 Cookie。随后打开攻击者的页面,这个页面诱导浏览器向原网站发起修改资料的请求。如果浏览器按规则带上了身份 Cookie,而服务端只检查「已经登录」,就可能执行这次操作。
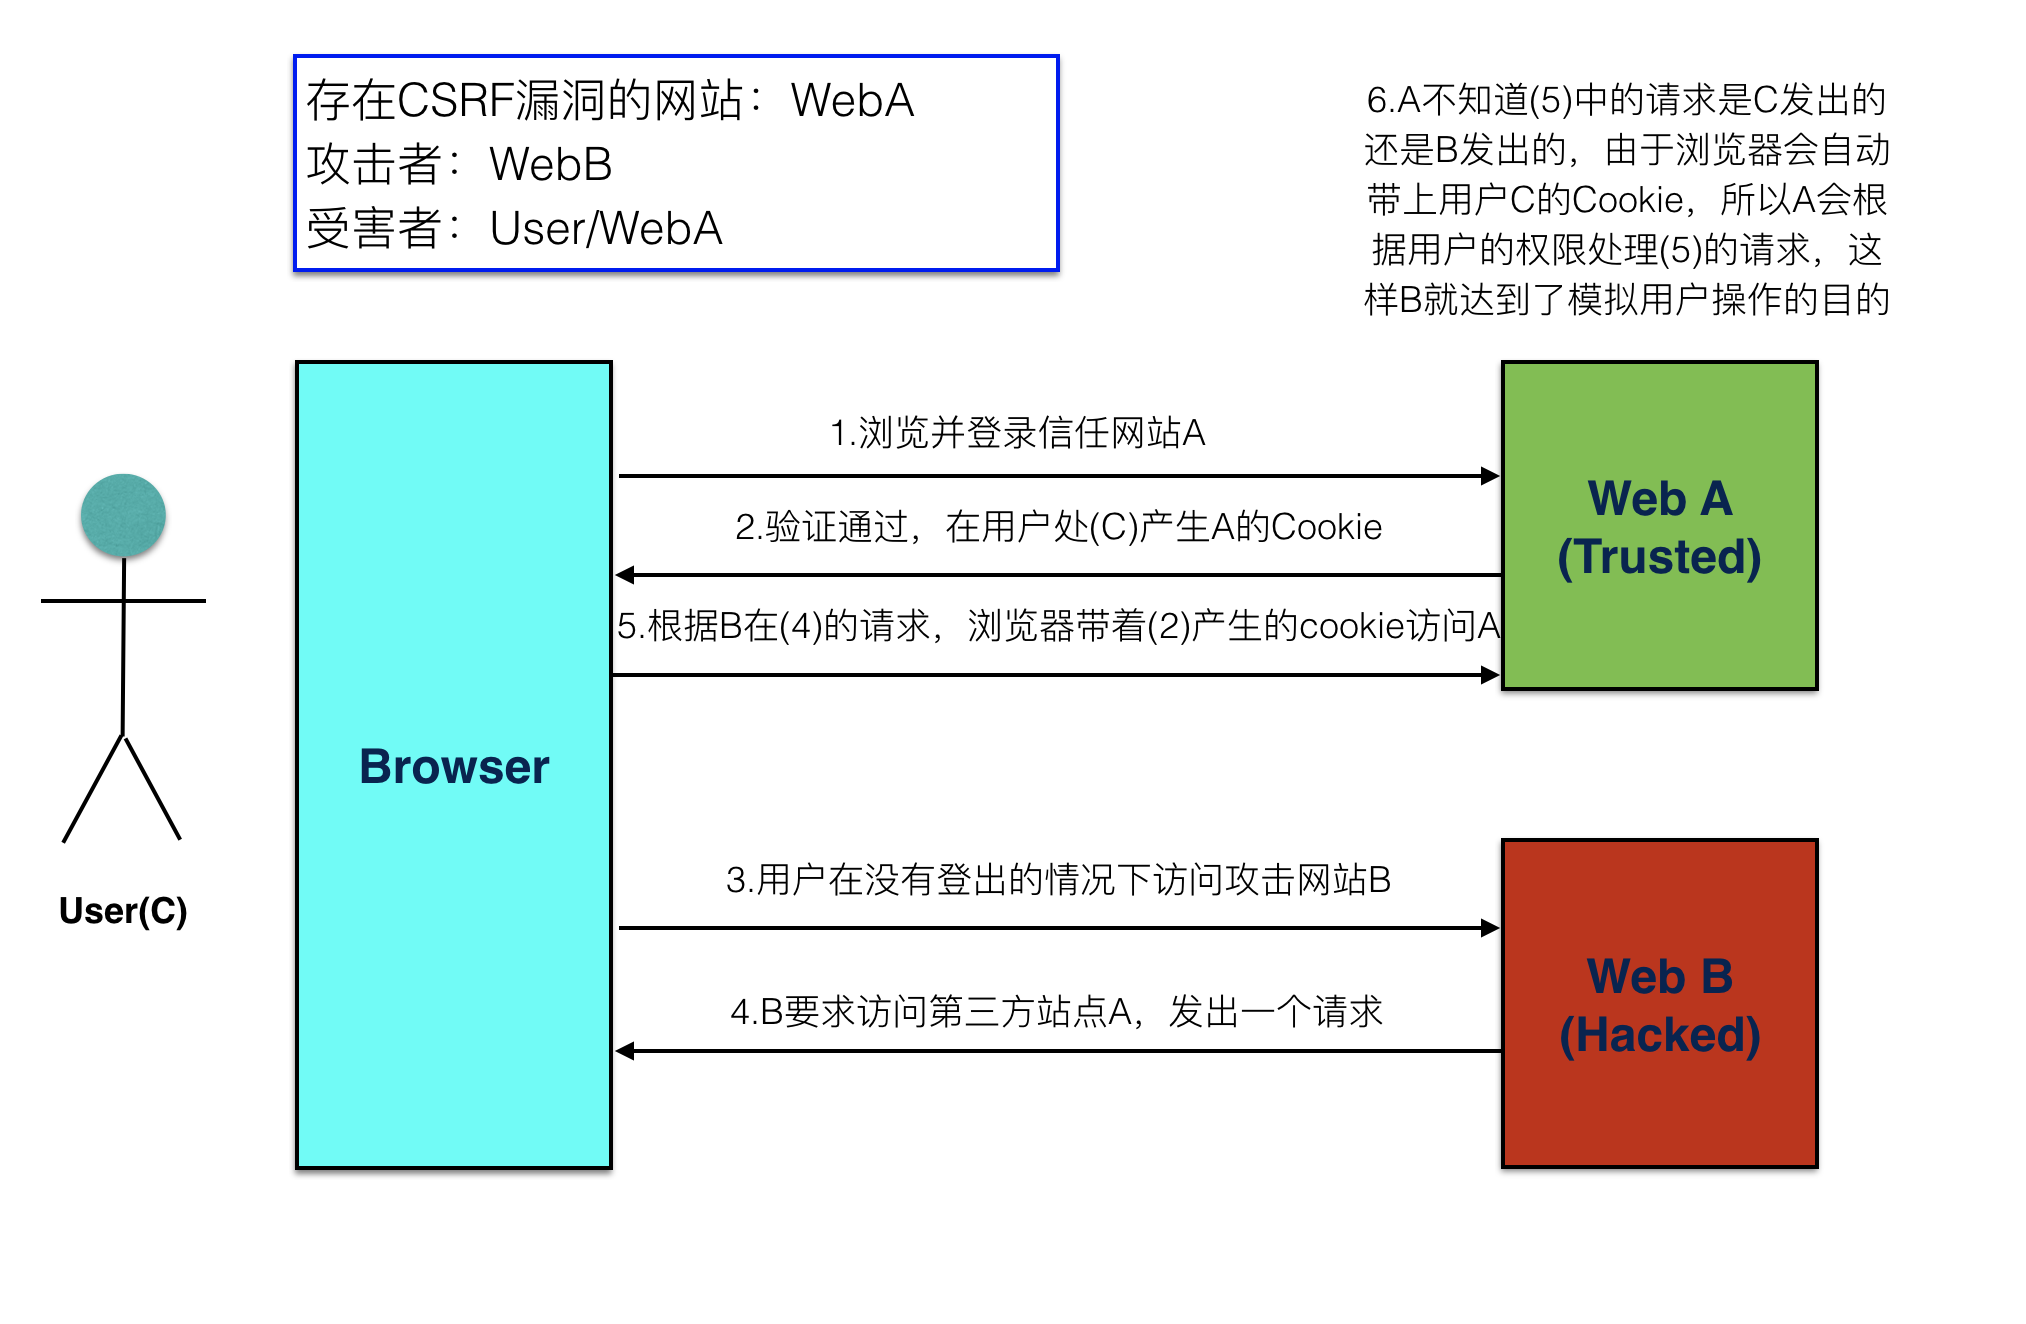
攻击者通常不需要知道你的 Cookie 内容,让浏览器替他带上 Cookie 就够了。所以「验证用户已经登录」本身不能防住 CSRF。
常见防范方式有:
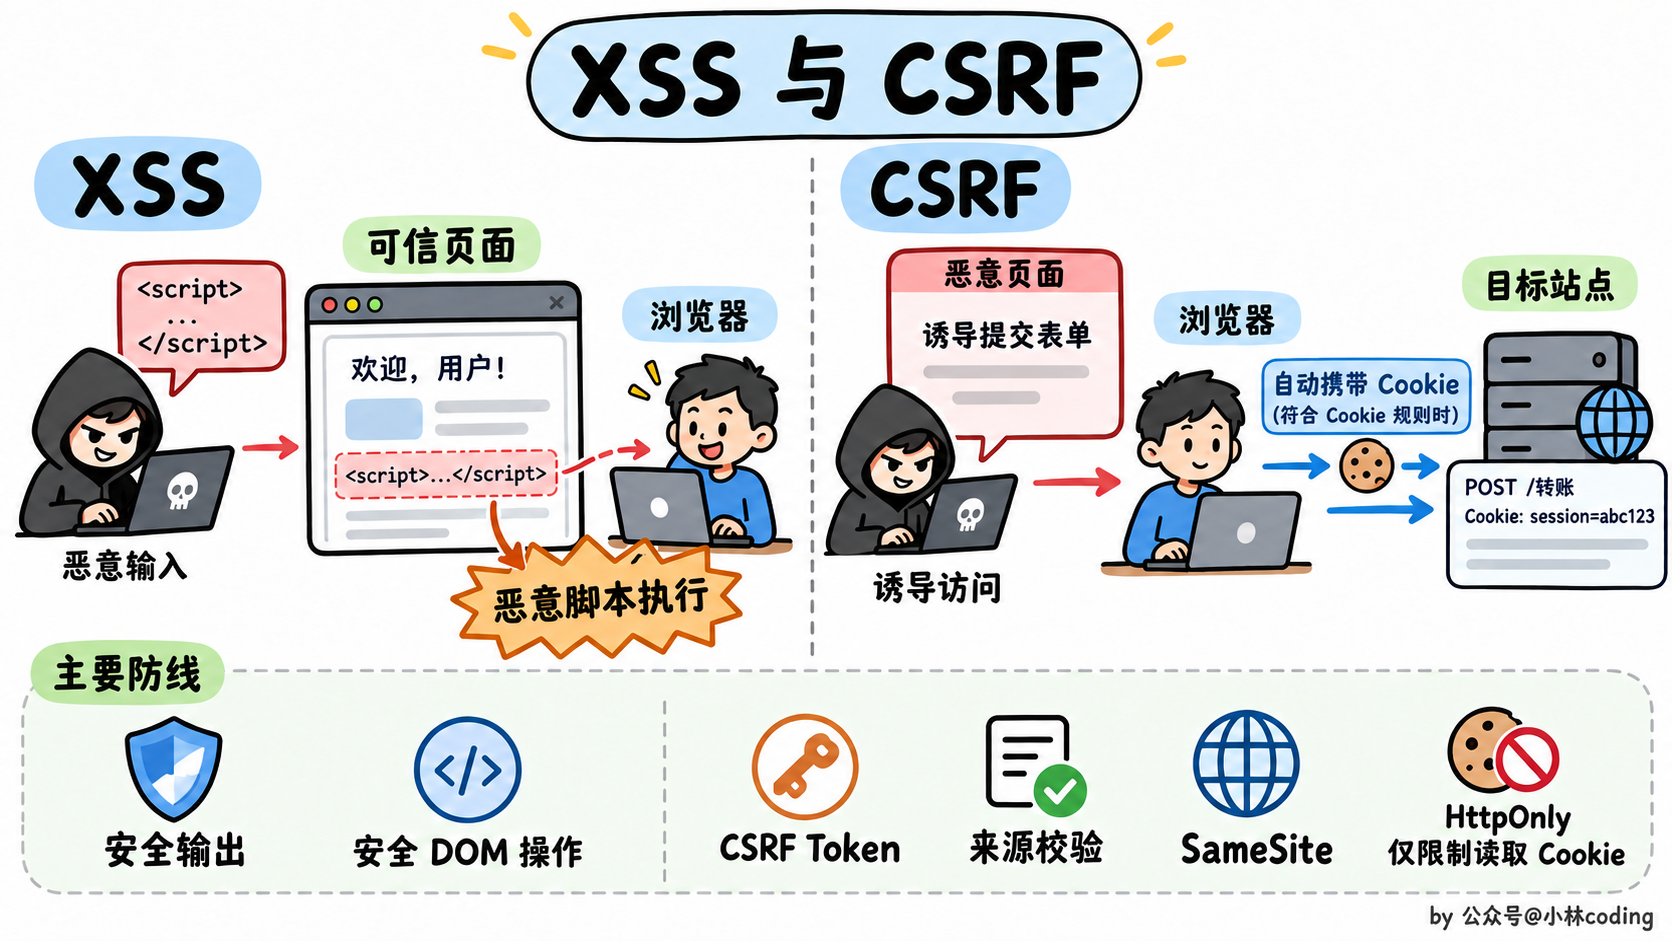
- CSRF Token:由服务端生成难以猜测的令牌,通过表单或自定义请求头传回,并进行验证。跨站攻击页面不能随意读取受同源策略保护的令牌。
- 校验来源:根据业务校验 Origin 或 Referer,确认请求来自允许的来源,对缺失等情况制定明确策略。
- SameSite Cookie:限制跨站请求携带 Cookie,降低攻击机会,但仍要结合具体请求和部署方式判断。
- 遵守请求语义:GET 不用于转账、修改密码等有副作用的操作;重要操作还可以要求二次确认或重新认证。
如果认证令牌由页面代码主动放在 Authorization 请求头里,浏览器不会替任意跨站页面自动添加这个令牌,传统的 Cookie 型 CSRF 风险会减少。但把 JWT 放进自动发送的 Cookie 后,仍然要防 CSRF。
CSP 主要是辅助防范脚本注入等问题,不是 CSRF Token 的替代品。
# XSS攻击是什么?
XSS是跨站脚本攻击,攻击者通过在Web页面中插入恶意脚本代码,然后诱使用户访问该页面,从而使得恶意脚本在用户浏览器中执行,从而盗取用户信息、会话信息等敏感数据,甚至控制用户账户。
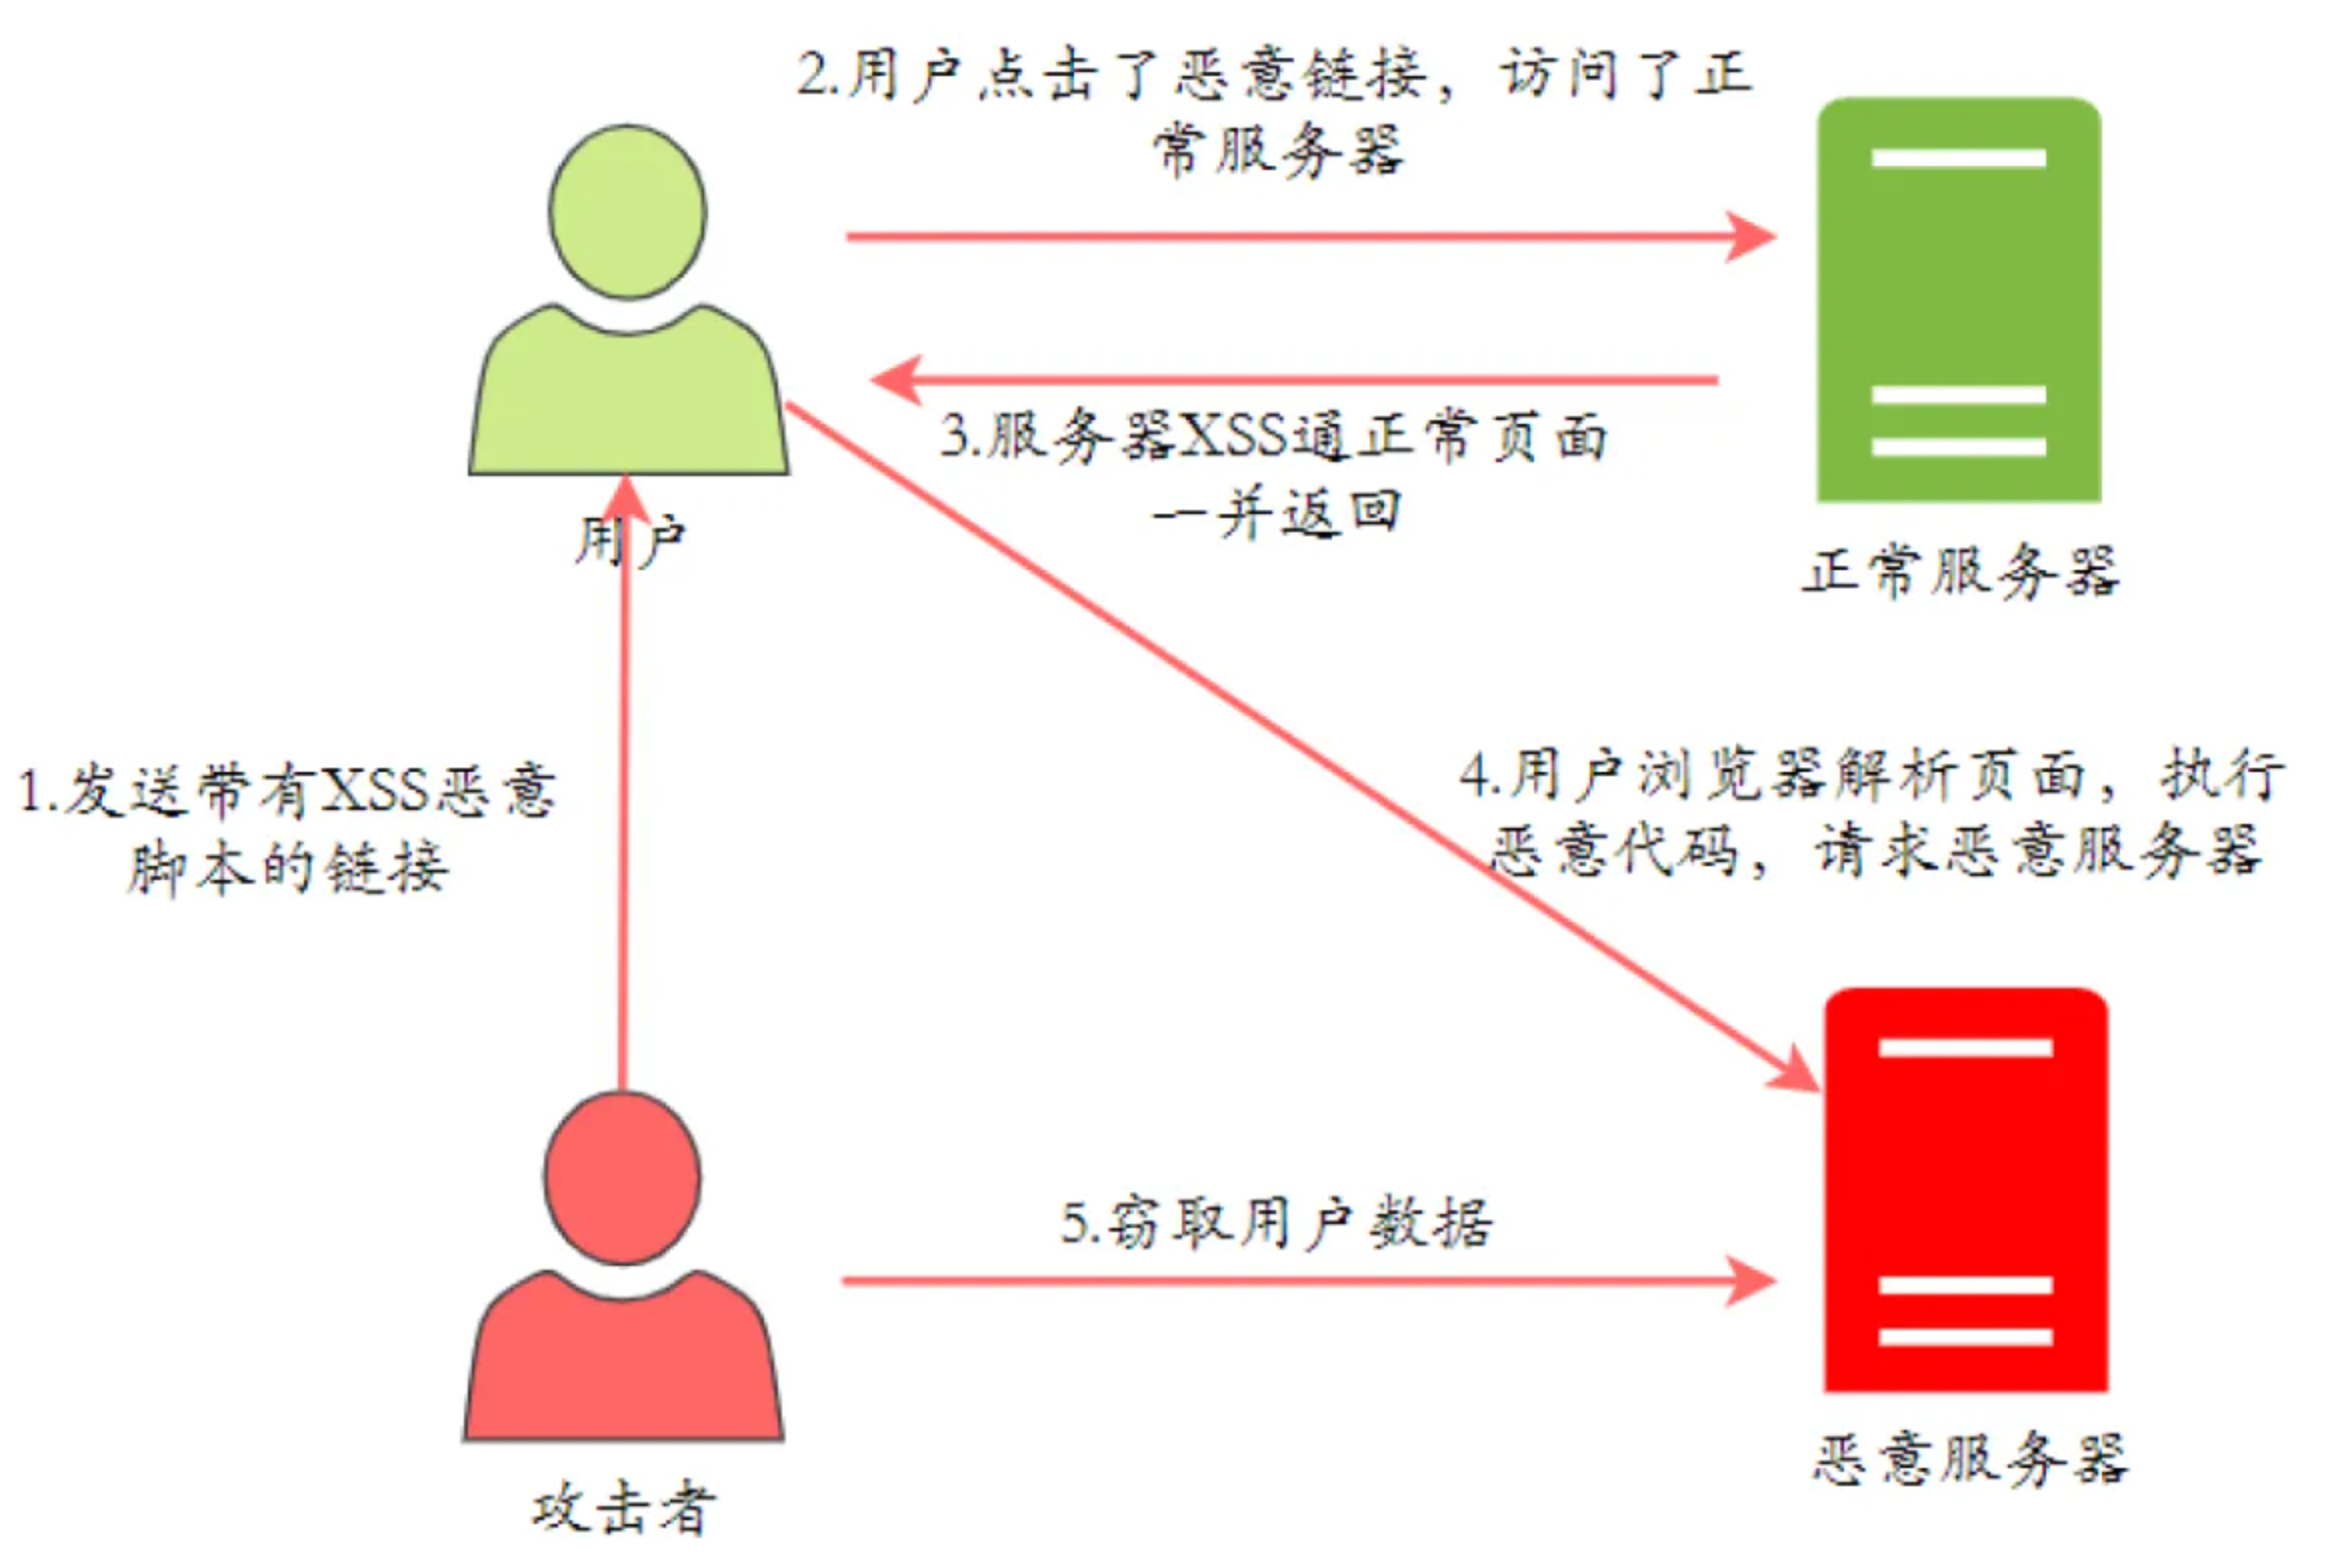
XSS 攻击可以分为 3 类:存储型(持久型)、反射型(非持久型)、DOM 型。
- 存储型 XSS (opens new window):注入型脚本永久存储在目标服务器上。当浏览器请求数据时,脚本从服务器上传回并执行。
- 反射型 XSS (opens new window):当用户点击一个恶意链接,或者提交一个表单,或者进入一个恶意网站时,注入脚本进入被攻击者的网站。Web 服务器将注入脚本,比如一个错误信息,搜索结果等 返回到用户的浏览器上。由于浏览器认为这个响应来自"可信任"的服务器,所以会执行这段脚本。
- 基于 DOM 的 XSS (opens new window):通过修改原始的客户端代码,受害者浏览器的 DOM 环境改变,导致有效载荷的执行。也就是说,页面本身并没有变化,但由于 DOM 环境被恶意修改,有客户端代码被包含进了页面,并且意外执行。
预防XSS攻击的方法主要包括以下几点:
- 输入验证:校验数据类型、长度和业务范围,作为补充措施。富文本需要使用可靠的 HTML 净化方案,不能只过滤几个标签或关键词。
- 输出编码:根据数据所在的上下文进行编码,HTML 文本、属性、URL、JavaScript 的处理方式不同。普通文本尽量通过 textContent 等安全接口插入,避免把不可信内容直接交给 innerHTML。
- Content Security Policy(CSP):通过设置CSP策略,限制网页中可执行的脚本源,有效防范XSS攻击。
- 使用 HttpOnly:避免脚本直接读取身份 Cookie,减少凭证泄露,但它不能阻止 XSS 脚本执行,也不能阻止恶意脚本以用户身份发送请求。
和 CSRF 相比,XSS 是让恶意脚本在受信任的网站页面中执行;CSRF 是让用户浏览器带着身份去发送攻击者构造的请求。两者需要分别防范,发生 XSS 后,部分 CSRF 防护也可能被绕过。
# 了解过DNS劫持吗?
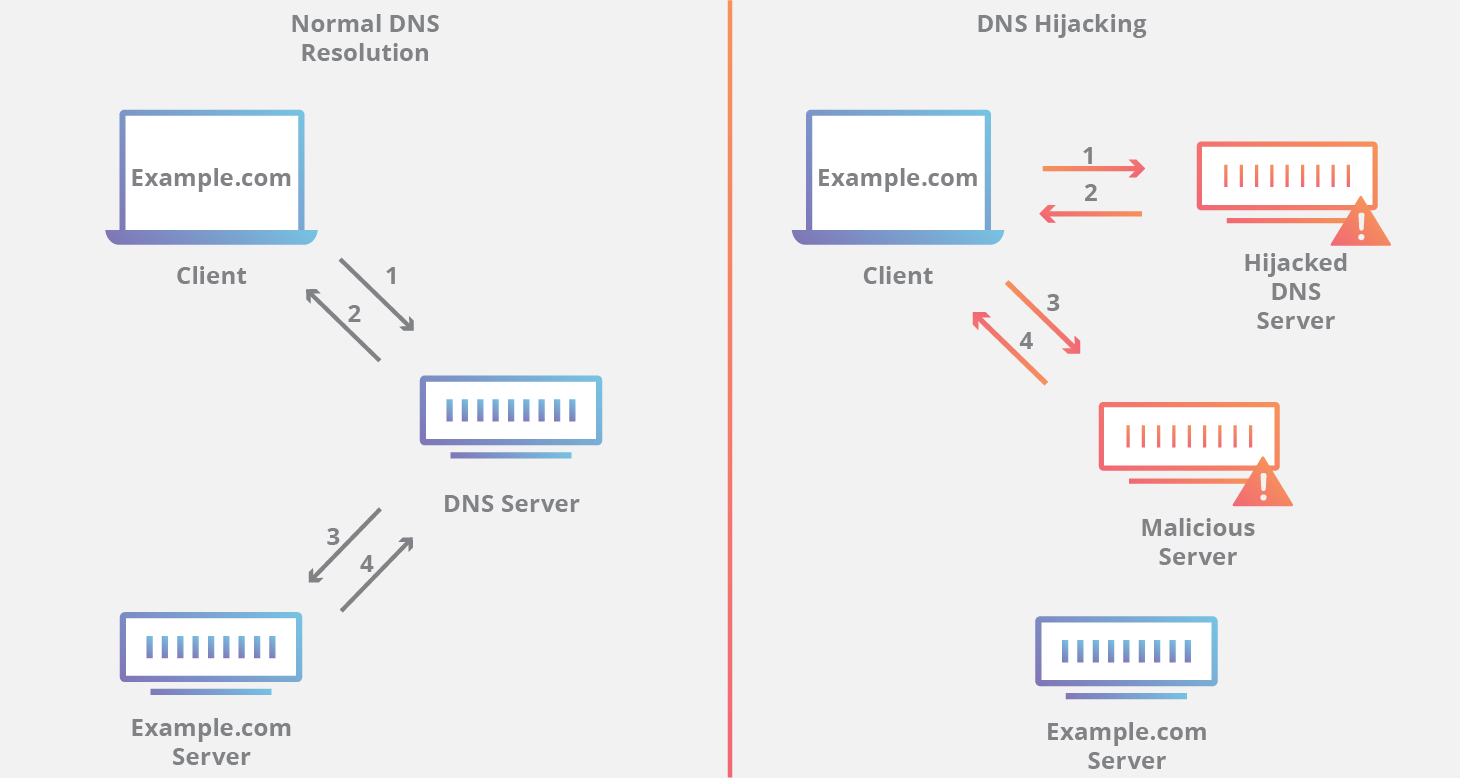
DNS 劫持可能通过篡改 hosts、路由器的 DNS 配置、DNS 记录或者解析响应,把正常域名指向错误地址。一个典型场景是攻击者在用户查询 DNS 服务器时篡改响应,将用户请求的域名映射到攻击者控制的虚假IP地址上,使用户误以为访问的是正常网站,实际上被重定向到攻击者操控的恶意网站。这种劫持可以通过植入恶意的 DNS 记录或劫持用户的 DNS 流量来实现。
防范时可以检查本地 hosts 和 DNS 配置,保护路由器、域名管理账号及权威 DNS,并按需要使用加密 DNS。DoH、DoT 主要保护客户端到所选解析器这一段传输,并不保证解析器本身一定可信;DNSSEC 则提供 DNS 数据来源认证和完整性校验,不负责加密。
DNS 被改到错误 IP,也不代表攻击者就能伪造正确的 HTTPS 身份。正确的证书校验仍然可以发现域名与证书等不匹配的问题,所以不能因为页面提示证书错误就直接忽略。
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。