# Java虚拟机面试题
大家好,我是小林。
JVM 这块在面试里属于"加分项",但如果你答不上来,也会很明显拉低印象分。尤其是做 Java 后端,被问到内存溢出怎么排查、GC 为什么频繁、类是怎么加载进来的,这些问题你总归要面对。很多人用 Java 写了好几年代码,但对 JVM 的了解只停留在"知道有个垃圾回收",一旦被追问细节就说不清楚了。
这篇文章整理了 JVM 面试中最常被问到的知识点,涵盖内存结构、类加载机制、垃圾回收算法、垃圾回收器和线上性能排查这几块核心内容。内容偏向理解原理,帮你搞清楚 JVM 在背后到底做了什么。
几个在面试里出现频率最高的方向,建议重点花时间:
- 内存结构:堆、栈、方法区、程序计数器各自存什么、有什么区别,堆里的新生代老年代怎么划分,这些是后面所有问题的基础。
- 垃圾回收:可达性分析是怎么工作的、几种 GC 算法的原理和优缺点、Minor GC 和 Full GC 的触发条件,以及 CMS 和 G1 的区别,这条线是 JVM 面试的主线。
- 类加载机制:类加载的过程(加载→验证→准备→解析→初始化)、双亲委派模型是什么、为什么要有双亲委派,这块问得也很频繁,逻辑理清楚之后其实不难答。
- 内存问题排查:堆溢出和栈溢出的原因与解决思路、内存泄漏和内存溢出的区别,这类题在面试里越来越多,结合实际案例来答会比纯背理论效果好很多。
如果你是第一次系统准备 JVM,建议先把内存结构搞清楚,再去看垃圾回收,这两块是理解其他内容的前提,其他知识点理解起来也会顺很多。
# 内存结构
# JVM的内存模型介绍一下
面试里问到这个问题,通常是想让我们介绍 JVM 运行时数据区,也就是堆、方法区、虚拟机栈、本地方法栈和程序计数器这五个部分。这里先按虚拟机规范来讲,再结合我们常用的 HotSpot 实现理解。
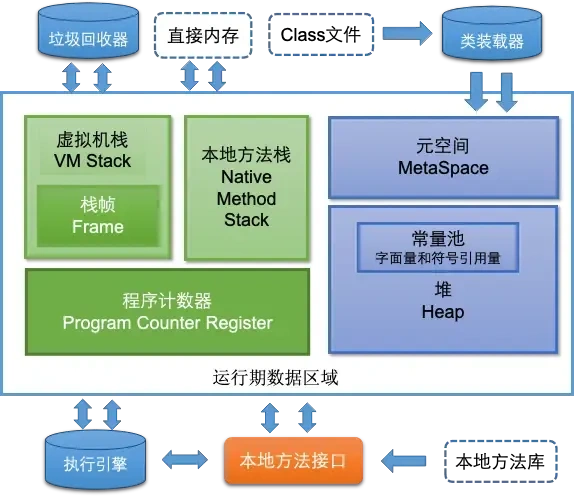
JVM 的内存结构主要分为以下几个部分:
- 程序计数器:可以看作当前线程执行字节码的位置记录,存储当前 Java 方法正在执行的 JVM 指令地址。线程切换回来时,就知道应该从哪里继续执行。如果执行的是 Native 方法,计数器的值为 undefined(未定义)。它是虚拟机规范中唯一没有规定 OutOfMemoryError 情况的区域。
- Java 虚拟机栈:每个线程都有自己的栈,生命周期与线程相同。每调用一个方法,就会创建一个栈帧,里面保存局部变量表、操作数栈、动态链接和方法出口等信息。调用深度超过栈容量时会抛出 StackOverflowError;创建线程的栈或扩展栈时无法申请到内存,则可能抛出 OutOfMemoryError。
- 本地方法栈:主要为 Native 方法服务,与虚拟机栈类似。在 HotSpot 中,本地方法栈和 Java 虚拟机栈合在一起实现。
- Java 堆:所有线程共享,主要存放对象实例和数组,也是垃圾回收的主要区域。堆可以设置初始大小和最大大小,无法为对象分配足够内存时,会抛出 OutOfMemoryError。新生代、老年代怎么划分,要看具体的垃圾回收器。
- 方法区:所有线程共享,保存类信息、运行时常量池、方法字节码等数据。方法区是规范里的概念,元空间是 JDK 8 及以后 HotSpot 存储类元数据的实现,不能说方法区这个概念被取消了。 元空间使用本地内存,也可能发生 OutOfMemoryError。
另外还有两块经常被问到的内容:
- 运行时常量池:是方法区的一部分,每个类或接口都有自己的运行时常量池,保存从 class 文件常量池加载进来的字面量信息、类和方法的符号引用等。它和字符串常量池不是同一个东西。
- 直接内存:不属于虚拟机规范定义的运行时数据区,但 NIO 的
ByteBuffer.allocateDirect()等操作会使用它。它在堆外分配,受到直接内存限制和本机可用内存的约束,也可能出现 OOM。
记忆时可以抓住一个区别:堆和方法区是线程共享的,程序计数器、虚拟机栈和本地方法栈是线程私有的。
# JVM 内存结构和 Java 内存模型有什么区别?
这两个名字很像,但回答的方向不一样。
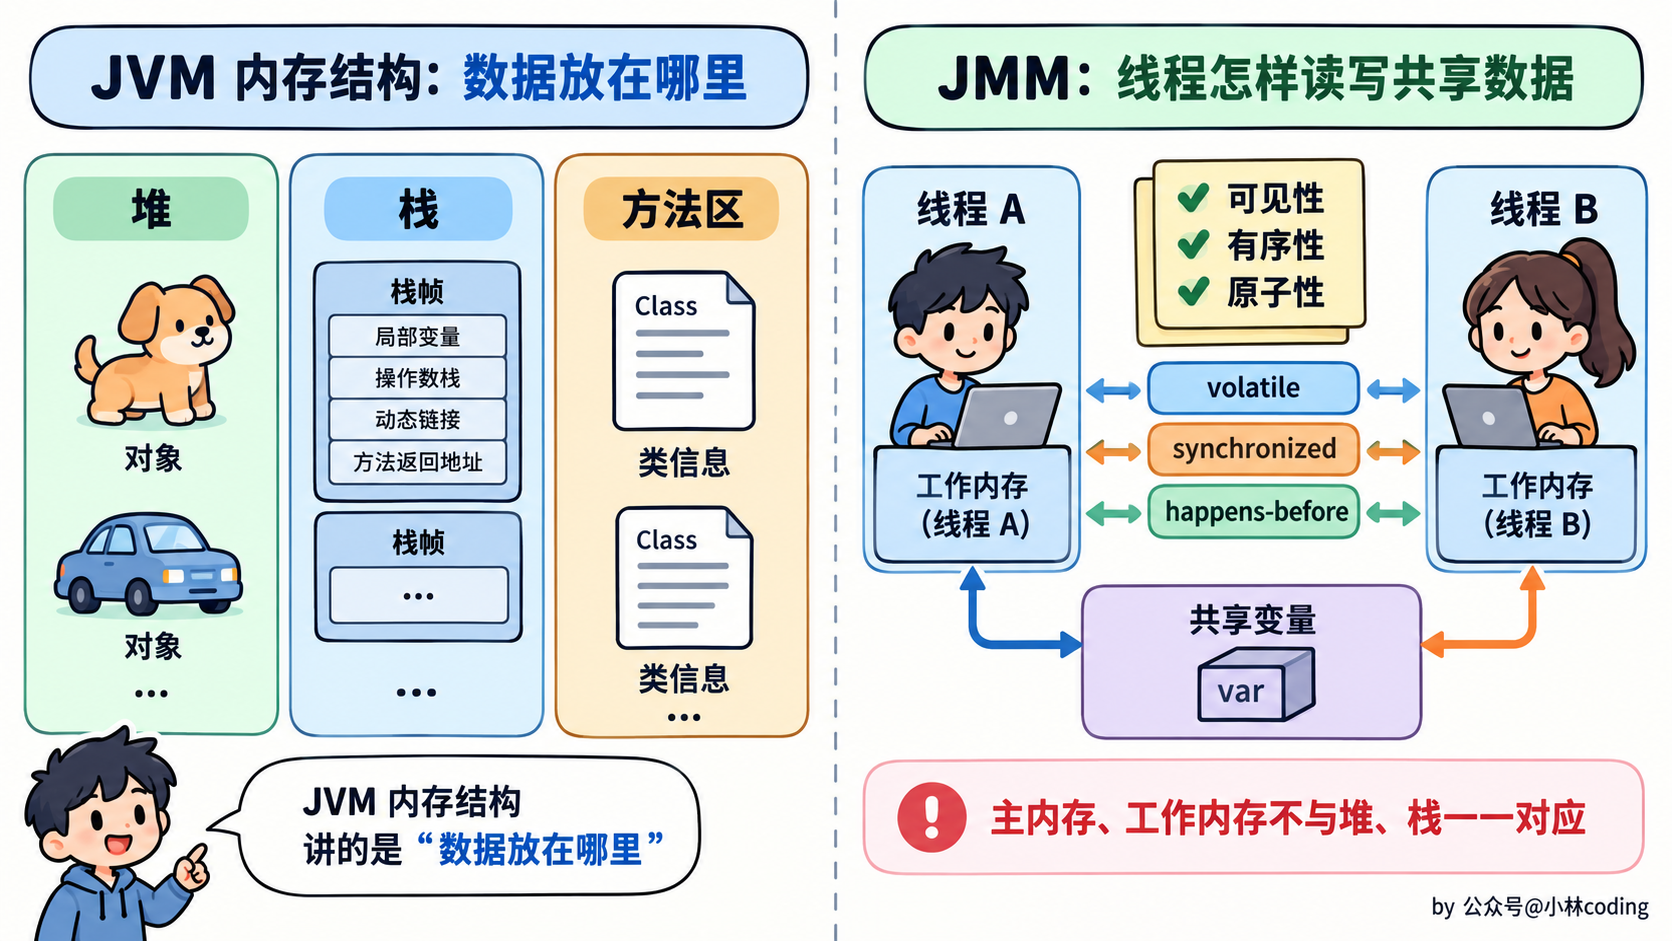
JVM 内存结构讲的是“数据放在哪里”,比如对象放在堆里,方法调用需要栈帧,类元数据保存在元空间。
Java 内存模型(JMM)讲的是“多线程怎么正确地读写共享数据”,重点是可见性、原子性、有序性,以及 happens-before 规则。比如一个线程修改了变量,另一个线程什么时候能看到,就属于 JMM 要解决的问题,volatile、synchronized 都和它有关。
JMM 里的“主内存”和“工作内存”是抽象概念,不能直接把主内存等同于堆、工作内存等同于栈。面试时先把这两个概念分开,后面就不容易答偏。
# JVM内存模型里的堆和栈有什么区别?
主要可以从用途、生命周期和线程之间的关系这几个角度来回答:
- 用途:栈主要保存方法调用产生的栈帧,里面有局部变量、操作数栈等。局部变量可以是基本类型的值,也可以是对象引用。堆主要保存对象实例和数组,比如
new User()创建的对象。 - 生命周期:方法执行结束,对应的栈帧就会出栈。堆里的对象是否回收,要看它是否还从 GC Roots 可达,不是方法一结束就一定回收,也不是执行
obj = null就立即释放。 - 线程关系:每个线程都有自己的栈,其他线程不能直接访问这个栈帧。但栈里的引用可以指向同一个堆对象,所以“引用在线程自己的栈里”并不意味着“这个对象就是线程安全的”。
- 空间与异常:单个线程的栈大小可以通过
-Xss配置,方法调用过深容易出现 StackOverflowError。堆的初始大小和最大大小可以通过-Xms、-Xmx配置,对象分配失败时可能出现 OutOfMemoryError。 - 分配方式:栈帧按方法调用顺序入栈、出栈,管理比较简单。堆需要分配对象并配合 GC 回收,但有 TLAB、指针碰撞等优化,不能简单认为“堆上的操作一定比栈慢”。
比如方法里写了 byte[] data = new byte[1024 * 1024];,栈里主要保存的是 data 这个引用,1MB 的数组内容在堆里,不会因为数组很大就直接把当前线程的栈撑满。
# 栈中存的到底是指针还是对象?
一般来说,栈帧的局部变量表里保存的是基本类型的值和对象的引用,对象实例和数组保存在堆中。
比如方法中有下面这段代码:
int count = 10;
MyObject obj = new MyObject();
count 保存的是整数值,obj 保存的是引用,通过这个引用才能访问堆中的 MyObject 实例。
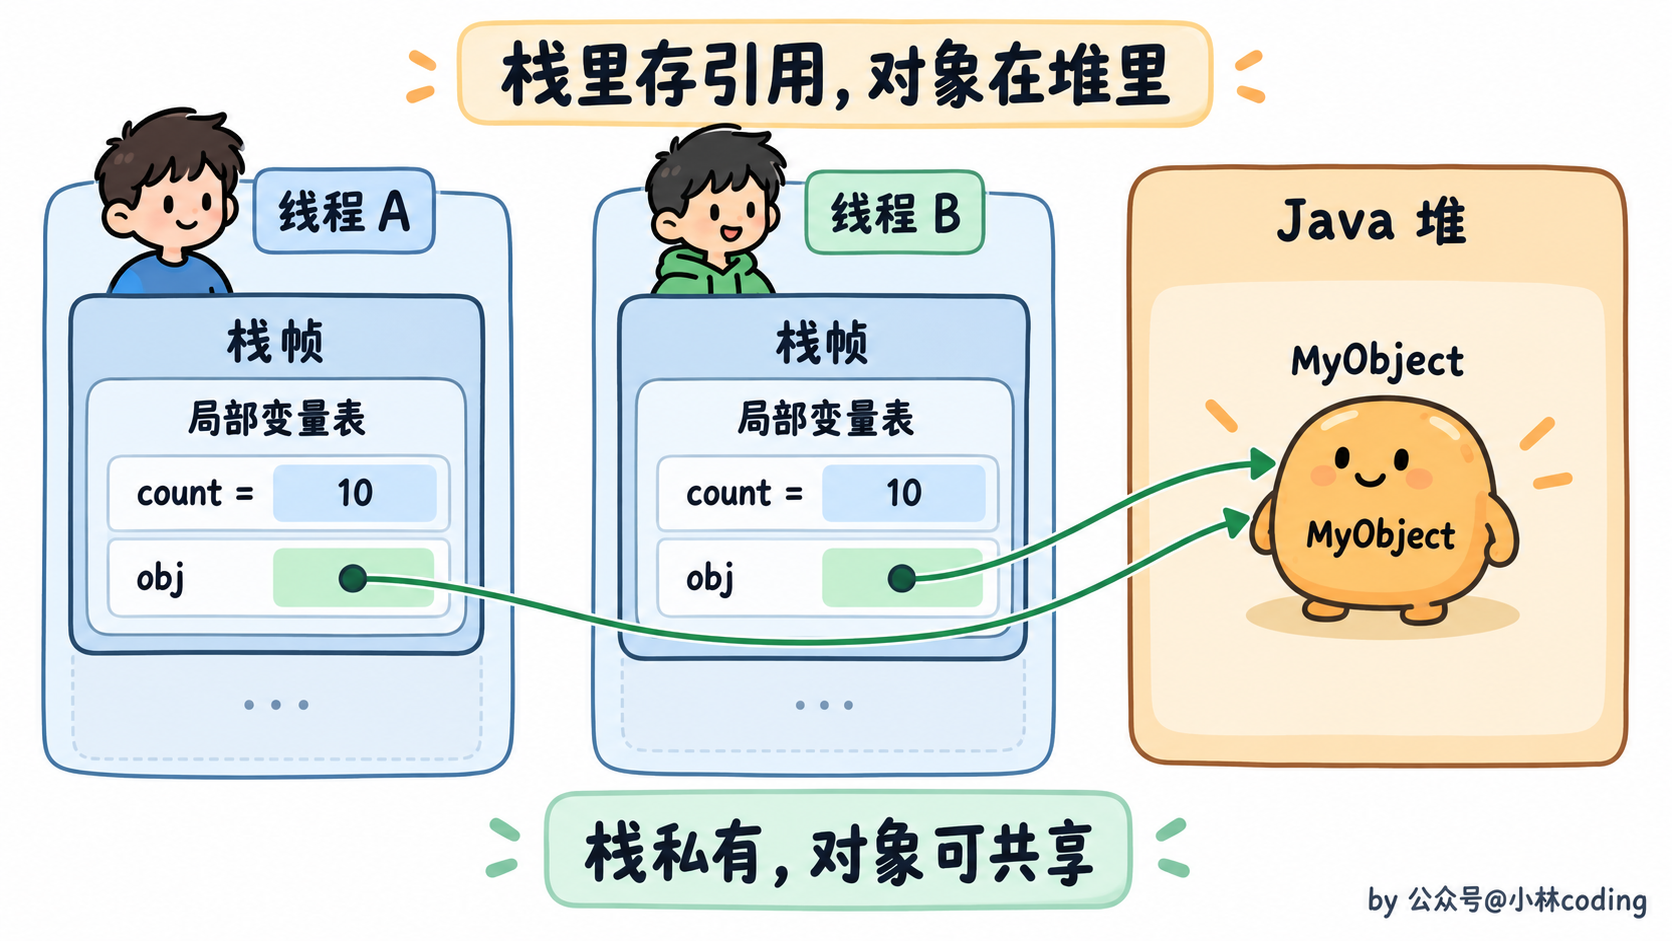
不过,“引用”不一定就是一个普通的内存地址,它的具体表示由虚拟机实现决定,也不能直接说“64 位系统的对象引用一定占 8 字节”。比如 64 位 HotSpot 开启压缩对象指针后,堆中对象字段里的引用通常可以用 4 字节表示;栈帧里的引用表示还要看解释器或编译器的实现。
另外,JIT 编译器可能通过逃逸分析和标量替换,把某些对象拆成几个值,让对象根本不用实际分配。这个属于运行时优化,不能据此把所有局部对象都说成“放在栈上”。
# 堆分为哪几部分呢?
通常可以先按传统分代收集器来回答:Java 堆分为新生代和老年代,新生代又分为 Eden 区和两个 Survivor 区。
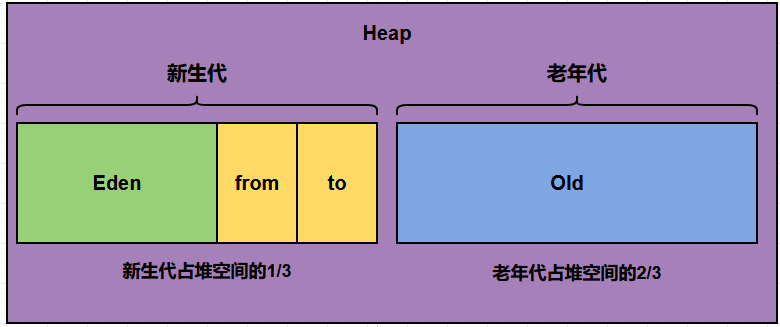
- 新生代(Young Generation):大多数新对象先在 Eden 分配,Eden 空间不足时通常触发 Young GC。存活对象会被复制到另一个 Survivor 区,或者晋升到老年代。两个 Survivor 区轮流使用,一次回收完成后通常有一个为空。常见的初始空间比例是 Eden:S0:S1 = 8:1:1,但收集器的自适应策略可能调整它,不能当成所有 JVM 都固定使用的比例。
- 老年代(Old Generation):主要保存存活时间较长的对象,也可能接收直接分配的大对象。老年代回收的方式和时机由收集器决定,不能把老年代 GC 都叫作 Full GC。
如果面试官继续问 G1,就要补充它的不同:G1 把堆划分成多个大小相等的 Region,但仍然保留新生代和老年代的逻辑划分。 Eden、Survivor、Old 都由若干 Region 组成,不需要各自占据一整块连续空间。Humongous Region 用来保存超过一个 Region 一半大小的大对象,逻辑上属于老年代。
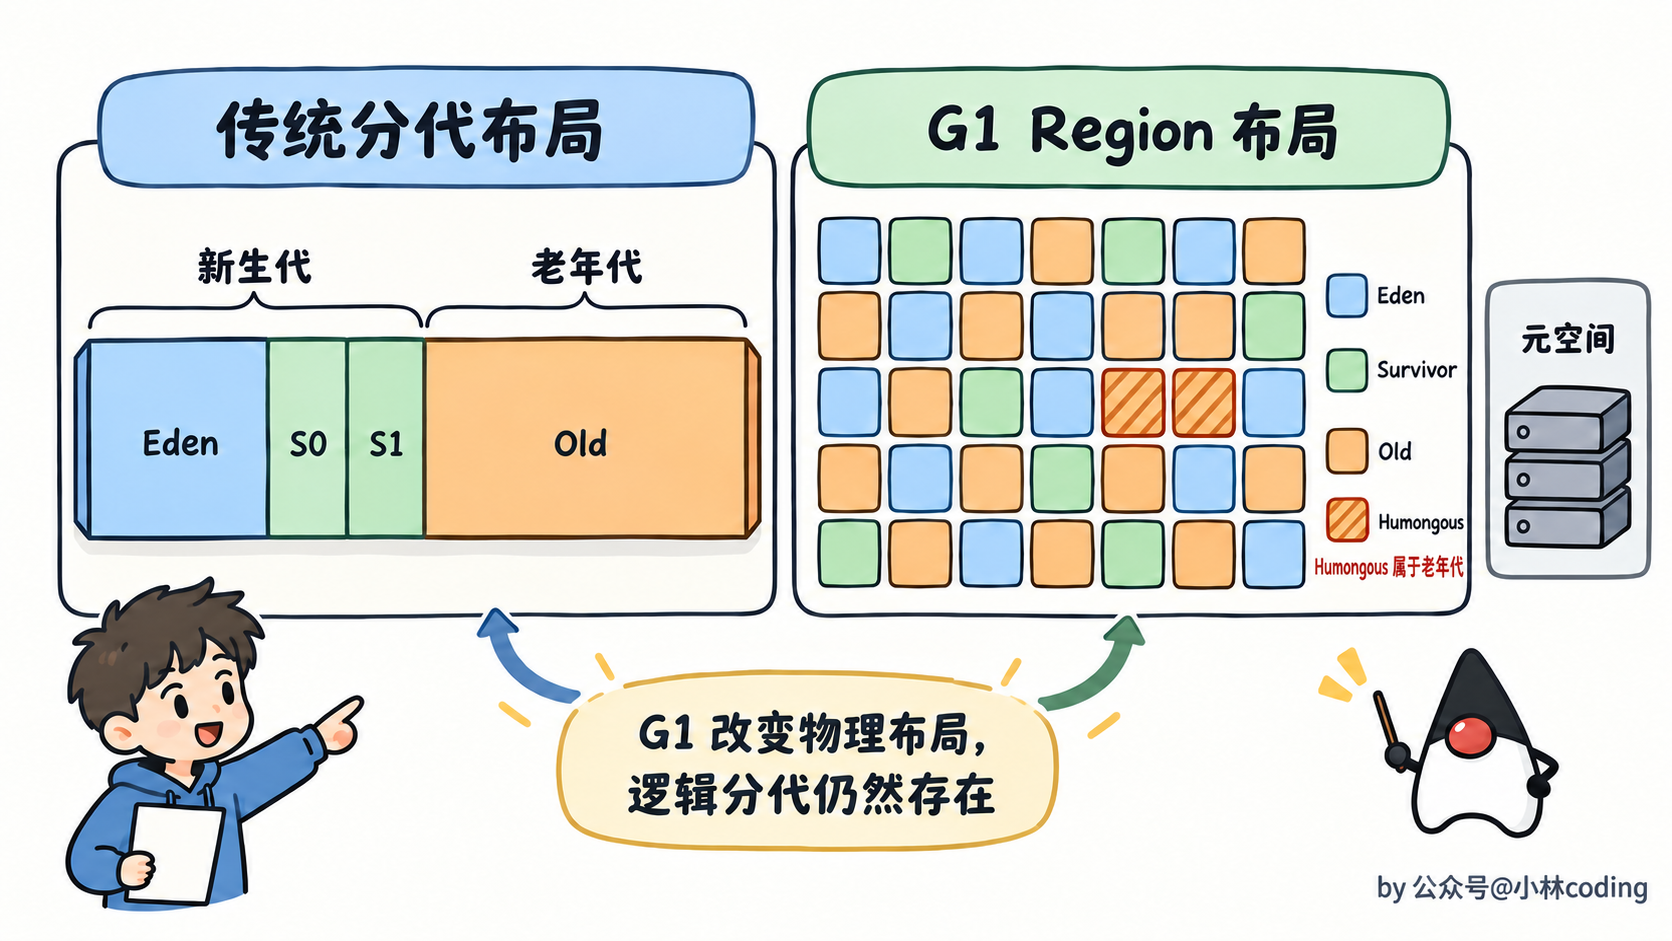
还有一个容易答错的地方:元空间不属于 Java 堆,它使用的是本地内存。不要因为它也由 JVM 管理,就把它算进堆的组成部分。
# 如果有个大对象一般是在哪个区域?
要看具体的垃圾回收器,不能一概说“大对象一定直接进入老年代”。
在传统分代收集器中,为了减少大对象在 Eden 和 Survivor 之间反复复制的开销,有些收集器会让大对象直接进入老年代。比如 JDK 8 中,-XX:PretenureSizeThreshold 可以影响 Serial、ParNew 的大对象分配,但不能把这个参数套用到 Parallel Scavenge 或 G1 上。
在 G1 中,对象大小超过单个 Region 的一半,就会被当作 Humongous 对象,直接分配到老年代的一组连续 Humongous Region 中。比如 Region 大小为 4MB,一个实际占用超过 2MB 的对象就符合这个条件,判断时还要把对象头等开销算进去。
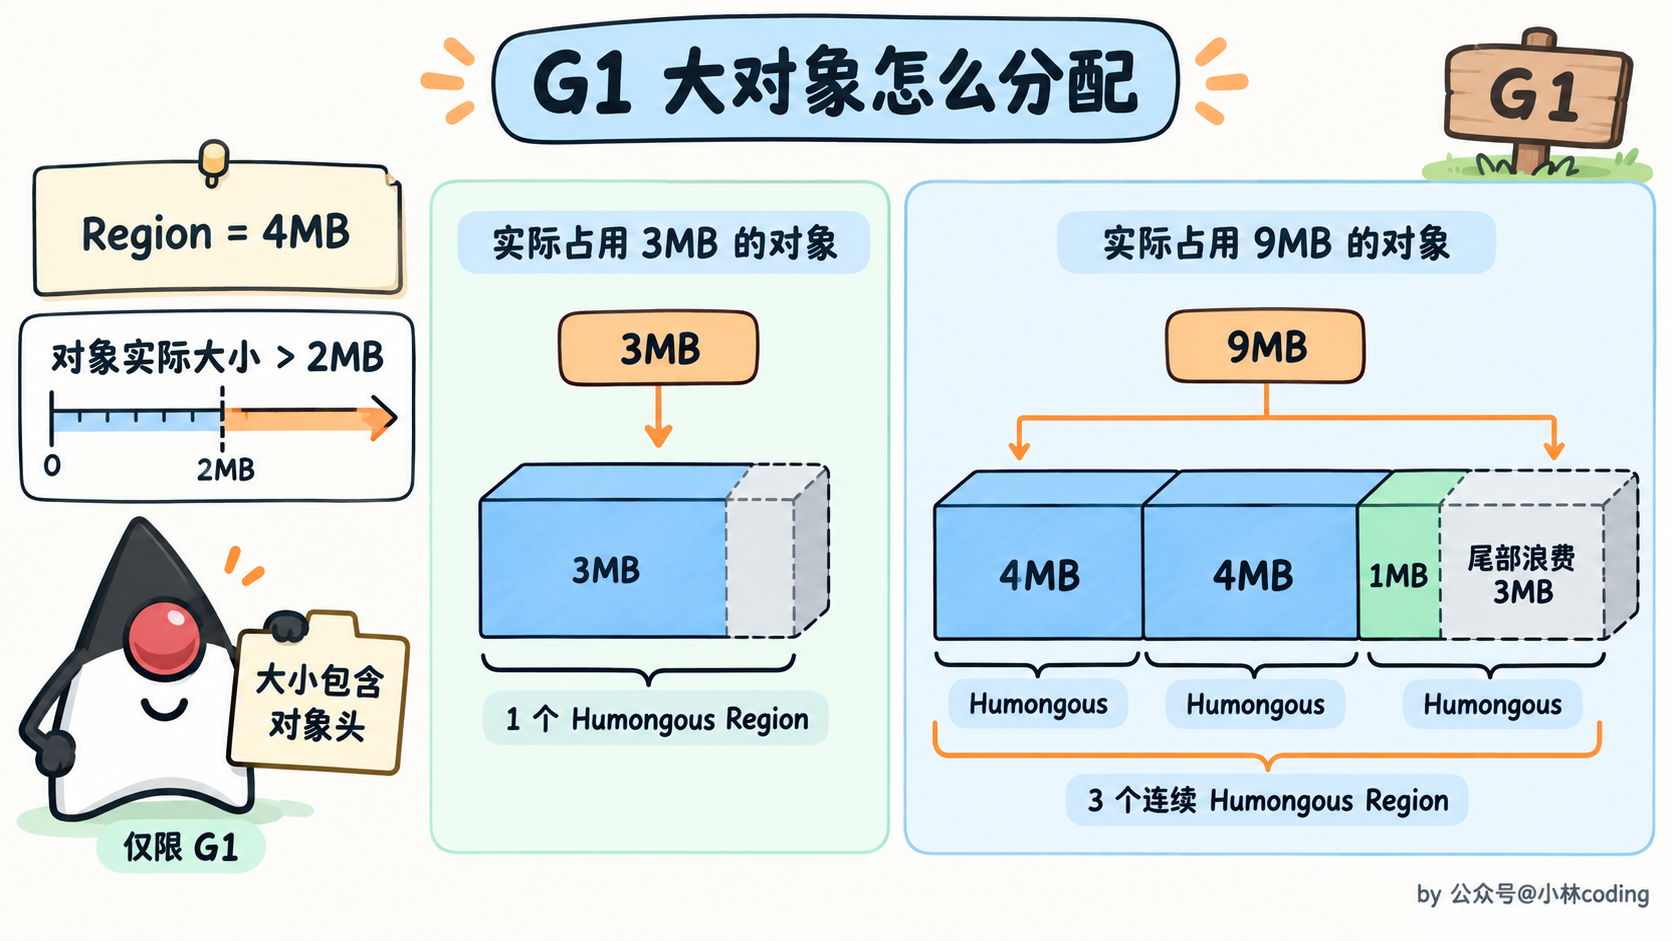
大对象带来的问题也不只是“占用内存多”。G1 为它寻找连续 Region 时,可能出现堆里还有空闲空间,却凑不出足够连续 Region 的情况;最后一个 Region 的剩余空间也可能被浪费。
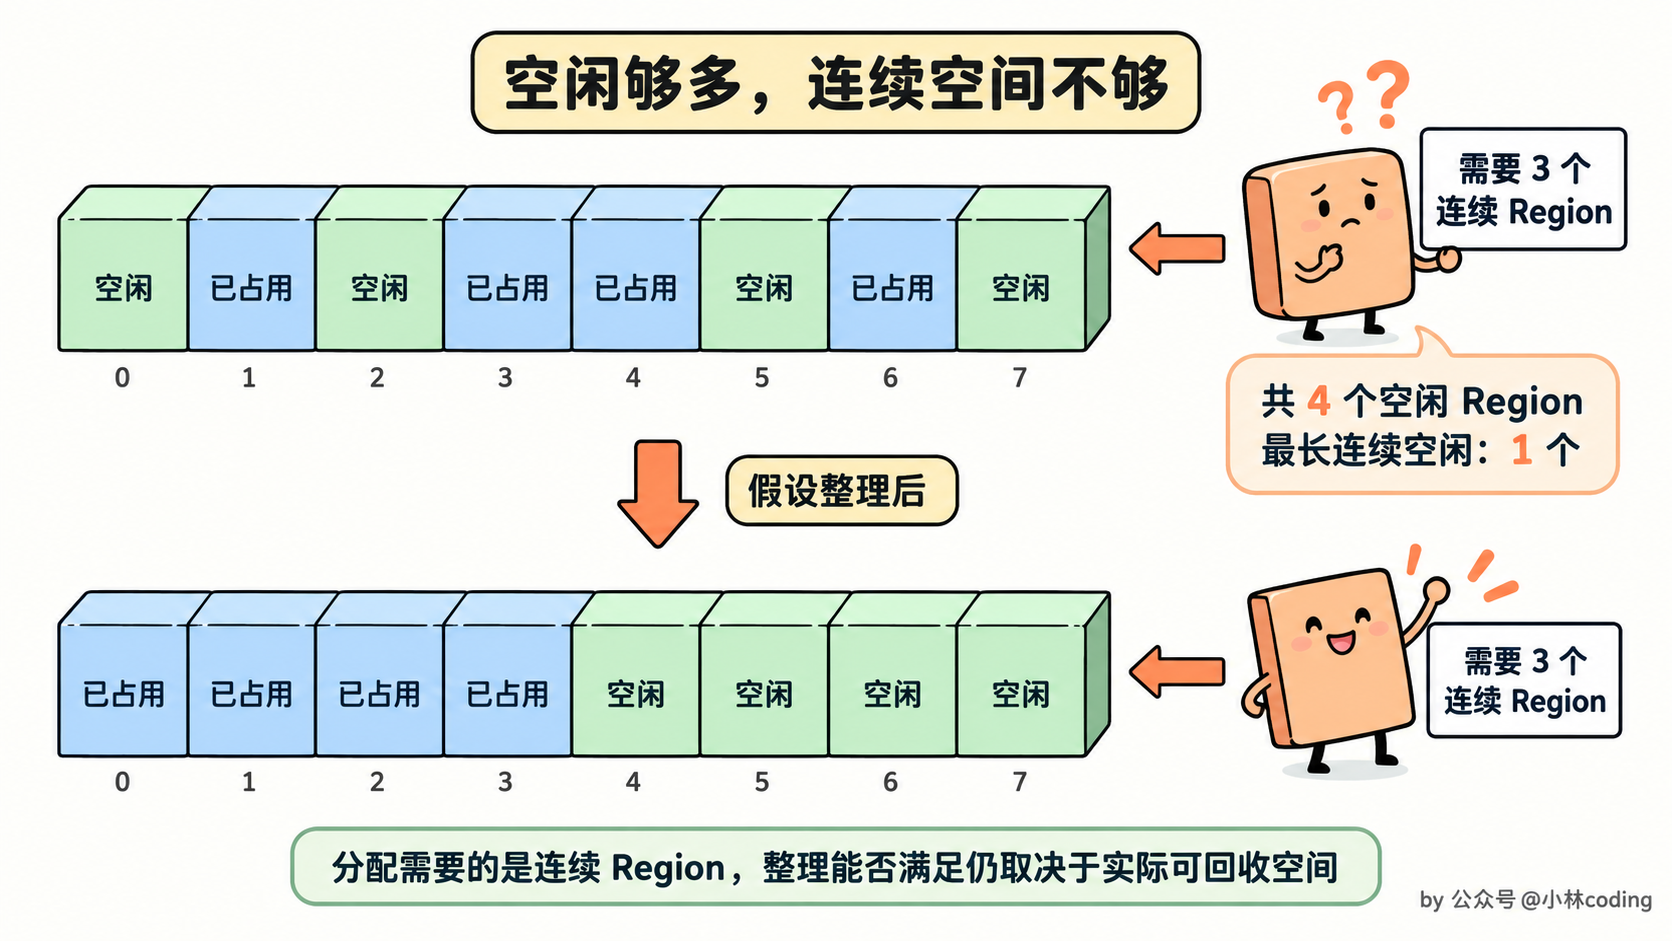
所以遇到大对象分配频繁的场景,比如一次读取整个文件、生成超大的字节数组,通常优先考虑分块处理、流式读取,再结合 GC 日志决定是否调整堆或 Region 大小。
# 程序计数器的作用,为什么是私有的?
程序计数器可以看作当前线程执行字节码的位置记录。Java 支持多线程,一个 CPU 核心会在不同线程之间切换,比如线程 1 执行了一段代码后,切换到线程 2,再过一会儿又切回线程 1。
我们考虑一下,切回线程 1 时,总要知道它之前执行到哪里,接下来应该继续执行哪条指令吧?每个线程执行的代码和当前位置都可能不一样,如果共用一个程序计数器,位置就会互相覆盖,所以它必须是线程私有的,生命周期也与线程相同。
这里说的是 JVM 执行字节码时的逻辑位置,不能把它当成操作系统线程切换时保存的全部 CPU 状态。执行 Native 方法时,它的值是未定义的;它也是虚拟机规范中唯一没有规定 OutOfMemoryError 情况的运行时数据区。
# 方法区中的方法的执行过程?
先区分一下:方法区保存的是方法的字节码等信息,方法执行时产生的数据主要放在当前线程的栈帧里。
当程序调用一个方法时,可以按下面几个步骤来理解:
- 找到调用目标:先根据方法的符号引用完成必要的解析。静态方法、构造方法等调用目标比较明确;重写后的实例方法,还需要结合对象的实际类型进行动态分派。
- 创建栈帧:在当前线程的 Java 虚拟机栈中创建新的栈帧,保存参数、局部变量、操作数栈、动态链接和方法出口等信息。
- 执行方法:解释器可以逐条执行字节码。如果方法被频繁调用,JIT 编译器可能把它编译成机器码,后续直接执行机器码;符合条件的方法还可能被内联,实际运行时不再单独创建它的调用栈帧。
- 返回调用者:方法正常返回或因异常退出时,恢复调用者的执行环境。返回值交给调用者,未被当前方法处理的异常继续向上查找处理逻辑。
所以不能理解成“方法在方法区里执行”,更准确的说法是:方法信息在那里保存,执行过程由线程来完成。
# 方法区中还有哪些东西?
从虚拟机规范的角度看,方法区主要保存类信息、字段和方法信息、方法字节码、运行时常量池等类级别的数据。
- 类信息:包括类的名称、访问修饰符、父类、接口,以及字段、方法的描述信息。
- 方法字节码:保存方法的字节码指令和相关信息,解释器执行时会用到。
- 运行时常量池:保存类加载后使用的常量信息和符号引用,比如一个方法调用的是哪个类中的哪个方法。解析后,相关引用可以定位到实际的运行时目标。
但说到具体位置时,需要结合 HotSpot 的版本来回答。在 JDK 8 及以后的 HotSpot 中:
- 类元数据、方法字节码和运行时常量池等主要保存在元空间。
- 类的静态字段保存在堆中的
java.lang.Class镜像对象里。如果静态字段是对象引用,它指向的对象也在堆中。 - 字符串常量池中的 String 对象自 JDK 7 起保存在堆中,不能说它们还在元空间里。
- JIT 编译后的机器码放在单独的 Code Cache 中,也不能直接把它算进元空间。
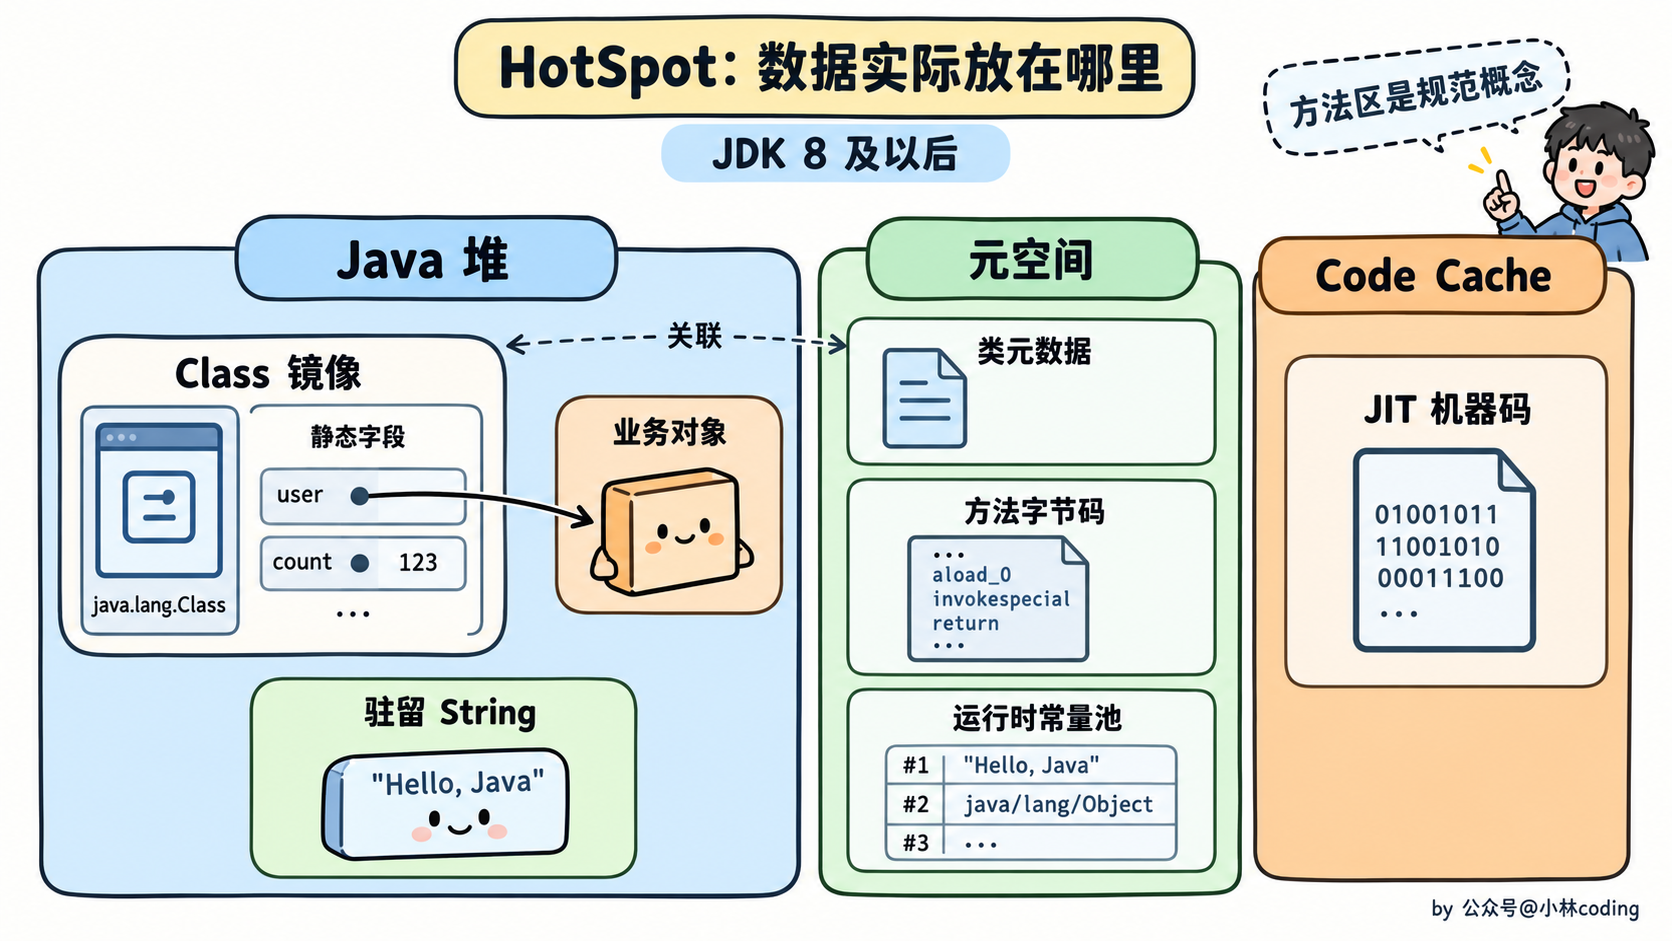
面试里常见的“方法区存类信息、常量、静态变量”是概念层面的概括,如果被追问 JDK 8 的实际内存位置,就要把这些实现细节分清楚。
# 为什么用元空间替代永久代?元空间还会溢出吗?
永久代是 JDK 7 及以前 HotSpot 保存类元数据的一种实现,它的容量受到永久代参数限制。应用加载的类比较多,或者框架大量生成动态代理类时,就容易遇到 OutOfMemoryError: PermGen space。
JDK 8 把类元数据放到使用本地内存的元空间中,减少了对固定永久代大小的依赖,也让类元数据的内存管理更灵活。
但这不意味着元空间可以无限使用内存。配置了 -XX:MaxMetaspaceSize 时,它受这个上限约束;没有显式配置,也仍然受进程可用的本地内存约束。 所以它一样可能出现 OutOfMemoryError: Metaspace。
还要区分两个参数:
-XX:MetaspaceSize:主要控制首次因元空间占用触发 GC 的阈值,后续阈值会动态调整,并不是元空间固定预分配的大小。-XX:MaxMetaspaceSize:控制元空间的最大容量。
排查时重点看是不是不断生成新类,或者旧的类加载器仍被线程、缓存等对象引用,导致类无法卸载。单纯调大上限只能缓解症状,解决不了类加载器泄漏。
# String保存在哪里呢?
在 JDK 7 及以后的 HotSpot 中,String 对象保存在堆中,字符串常量池中驻留的 String 对象也在堆中。更早的 JDK 6 则把驻留字符串放在永久代中。
这里要分清“字符串对象”和“指向它的变量”:如果 String s 是方法里的局部变量,s 这个引用保存在栈帧中;如果它是对象的成员字段,引用就跟着对象保存在堆中。
字符串常量池的作用是让相同内容的字符串复用同一个实例。比如 String a = "abc"; String b = "abc";,两个变量都指向常量池中同一个 String 对象。通过 new String("abc") 创建的实例则不会因为内容相同,就自动变成同一个对象。
# String s = new String("abc") 执行过程中分别对应哪些内存区域?
假设这行代码写在方法里面,可以分成三个部分来看:
- 局部变量
s:保存在当前方法的栈帧中,保存的是对象引用。 - 字符串字面量
"abc":class 文件里有对应的常量信息,类加载后通过运行时常量池解析它,得到字符串常量池中驻留的 String 对象。在 JDK 7 及以后,这个 String 对象位于堆中。 new String("abc"):在堆中再创建一个新的 String 实例,s指向这个新实例,而不是常量池中的实例。
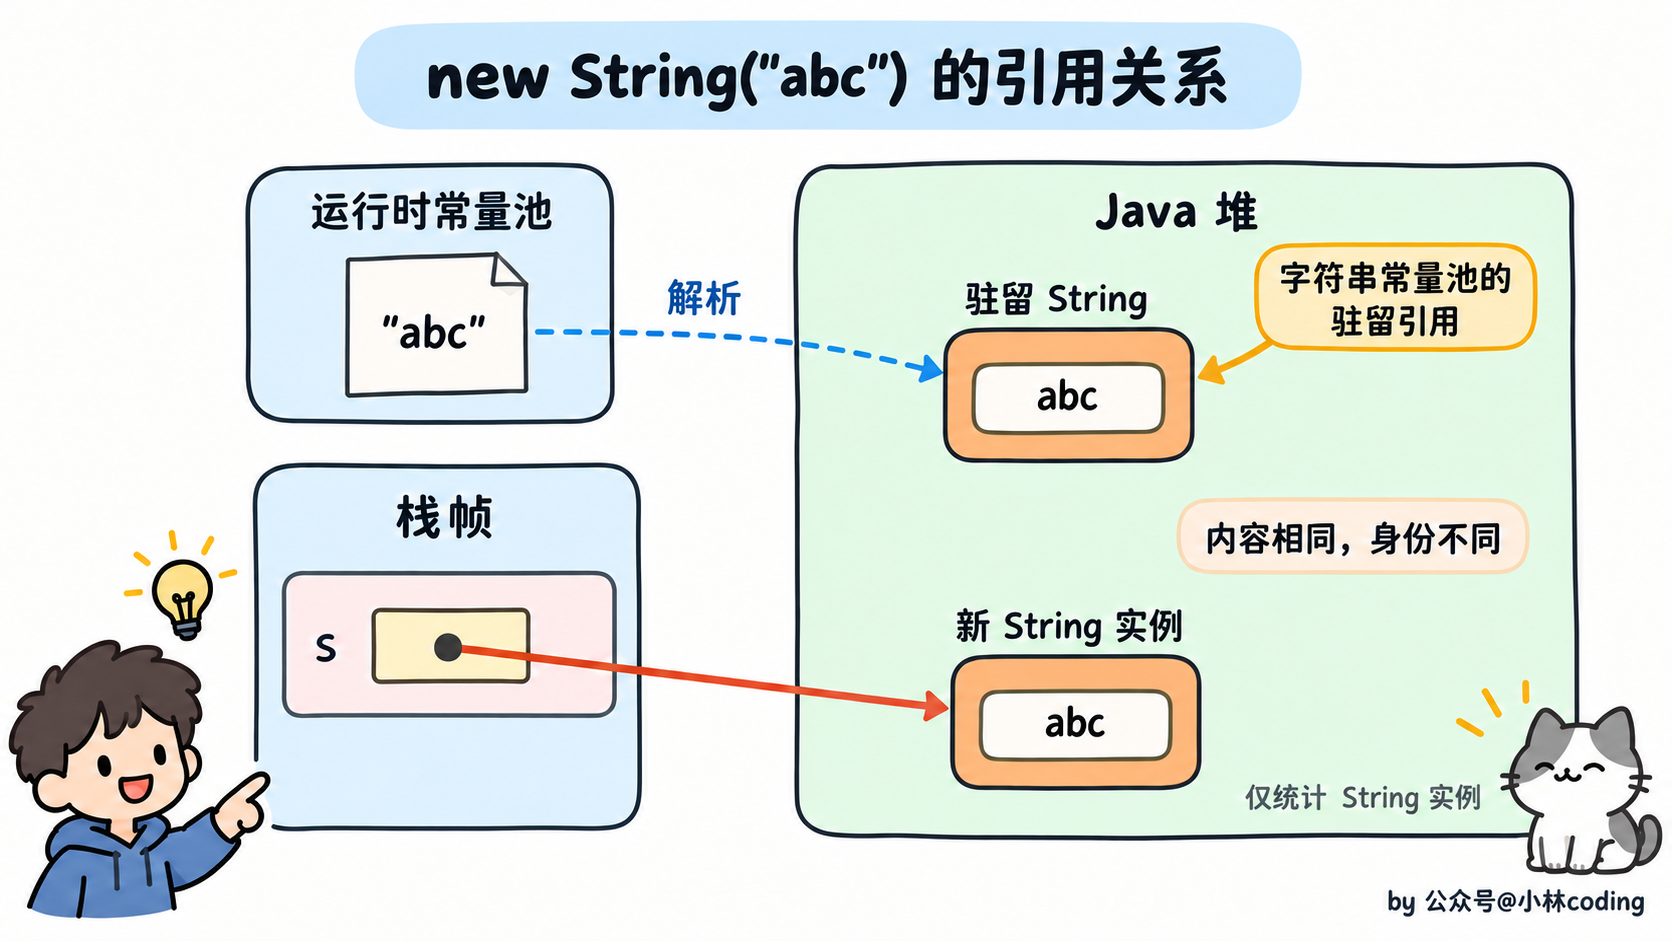
所以常见的回答是:如果 "abc" 对应的驻留字符串原本不存在,涉及两个 String 对象;如果它已经存在,则只新增一个 String 对象。 这里数的是 String 实例,不包括底层字符数组或字节数组等对象,也没有考虑 JIT 消除分配的优化。
字面量也不一定到执行这行代码时才首次创建,虚拟机可能提前解析相关常量。因此不能仅凭这行代码,就断言这一刻一定创建了两个对象。
# String.intern() 的作用是什么?
intern() 的作用是获取当前字符串内容在字符串常量池中的规范引用。
如果池里已经有相同内容的字符串,就返回池中的引用;如果没有,在现代 HotSpot 中可以把当前字符串实例驻留到池里,再返回对应引用。
举个例子:
String a = new String("abc");
String b = a.intern();
String c = "abc";

System.out.println(a == c); // false
System.out.println(b == c); // true
System.out.println(a.equals(c)); // true
== 比较的是是否为同一个对象,equals() 比较的是字符串内容。intern() 不会把变量 a 自动改成常量池中的引用,要使用它的返回值。
它可以用来复用重复字符串,但不适合把大量内容各不相同的字符串都放进常量池。那样复用收益不大,还会增加查找和内存管理的开销。
# 引用类型有哪些?有什么区别?
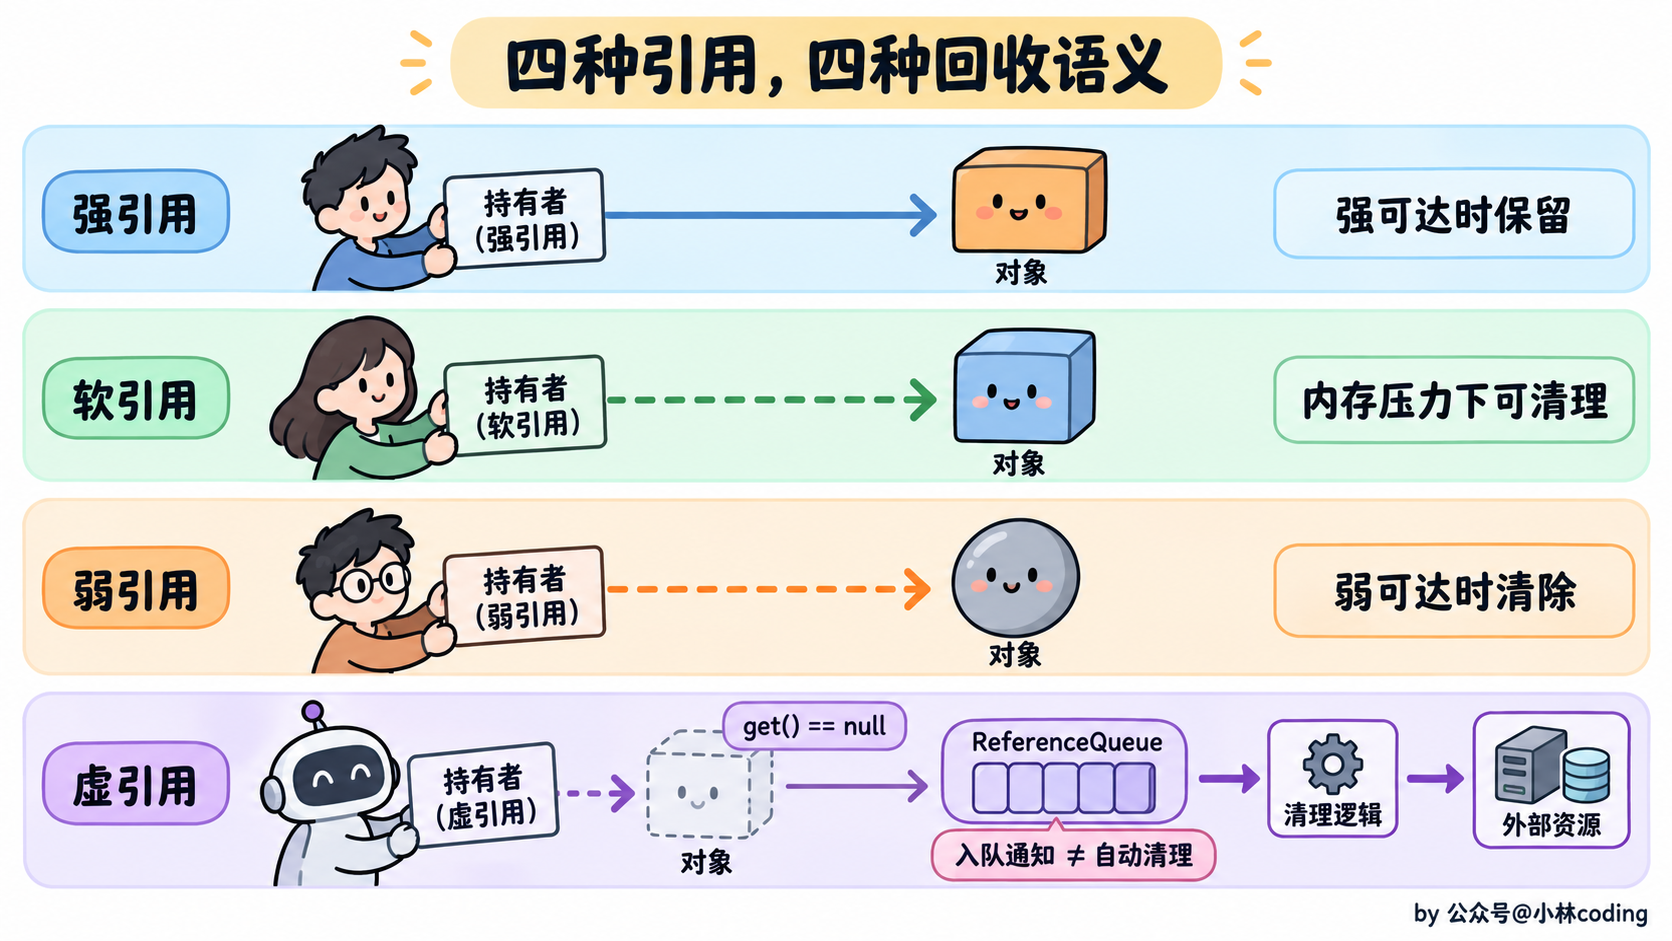
Java 中主要有强引用、软引用、弱引用和虚引用四种,区别在于它们能在多大程度上阻止对象被 GC 回收。
- 强引用:最常见的引用,比如
User user = new User()。只要对象还能通过 GC Roots 的强引用链到达,GC 就不会回收它。要注意,两个对象互相强引用,但整体已经从 GC Roots 不可达,仍然可以回收。 - 软引用:用
SoftReference表示。对象只有软引用可达时,JVM 可以在内存紧张时清理它,且会在抛出堆内存 OOM 前清除软可达对象的软引用。可以用于允许丢失的数据,但回收时机不稳定,不能代替有容量和过期策略的缓存。 - 弱引用:用
WeakReference表示。GC 发现对象只有弱引用可达时,就会清除弱引用,不需要等内存紧张。因此get()随时可能返回null,不能保证对象保留到下一次业务访问。 - 虚引用:用
PhantomReference表示,需要配合ReferenceQueue使用,get()始终返回null。对象达到相应的回收状态后,引用会入队,程序可以据此安排清理相关资源,比如释放堆外内存。
另外,软引用、弱引用也可以配合引用队列来清理失效条目。引用入队只是通知,不会自动执行我们自己的资源清理代码,还需要程序处理队列,或者使用 Cleaner 等机制。
# 弱引用了解吗?举例说明在哪里可以用?
弱引用不会阻止对象被垃圾回收。只要对象没有更强的引用保持可达,GC 发现它弱可达时就可以清除弱引用,即使当前内存还很充足。
比较常见的场景是:维护对象的附加信息,又不希望这份信息反过来延长对象的生命周期,比如 WeakHashMap 用弱引用保存 key。还有 ThreadLocalMap,也用弱引用保存 ThreadLocal 这个 key。
如果用弱引用保存可以重新加载的数据,要处理好 get() 返回 null 的情况。比如下面这个简单缓存:
import java.lang.ref.WeakReference;
import java.util.HashMap;
import java.util.Map;

public class CacheExample {

    private final Map<String, WeakReference<MyHeavyObject>> cache = new HashMap<>();

    public MyHeavyObject get(String key) {
        WeakReference<MyHeavyObject> ref = cache.get(key);
        MyHeavyObject obj = ref == null ? null : ref.get();
        if (obj == null) {
            obj = new MyHeavyObject();
            cache.put(key, new WeakReference<>(obj));
        }
        return obj;
    }

    private static class MyHeavyObject {
        private final byte[] largeData = new byte[10 * 1024 * 1024];
    }
}
这里不能只判断 ref 是不是 null,因为 WeakReference 对象还在,里面引用的业务对象却可能已经被回收了。先把 ref.get() 的结果放到局部变量里,再判断是否需要重建。
这个例子只演示单线程下的弱引用访问。Map 中的 key 和 WeakReference 本身不会因为业务对象被回收就自动删除,如果 key 不断增加,Map 仍然可能越积越大,需要结合引用队列或定期清理来移除失效条目。实际业务缓存通常还需要容量、过期时间和并发控制,不能只靠弱引用。
# 直接内存是什么?为什么 NIO 会用它?
直接内存是堆外分配的本地内存。比如调用 ByteBuffer.allocateDirect(),ByteBuffer 这个 Java 对象还在堆中,但它管理的缓冲区数据放在堆外。
使用直接缓冲区时,JVM 可以在一些原生 I/O 操作中直接访问这块内存,减少把堆内缓冲区内容复制到临时本地缓冲区的开销。所以它适合某些高频、大数据量的 I/O 场景。
不过,使用直接内存不等于实现了完整的零拷贝。内核和用户空间之间的数据传输是否还需要复制,取决于具体 I/O 方式;直接缓冲区主要减少其中一部分中间复制。
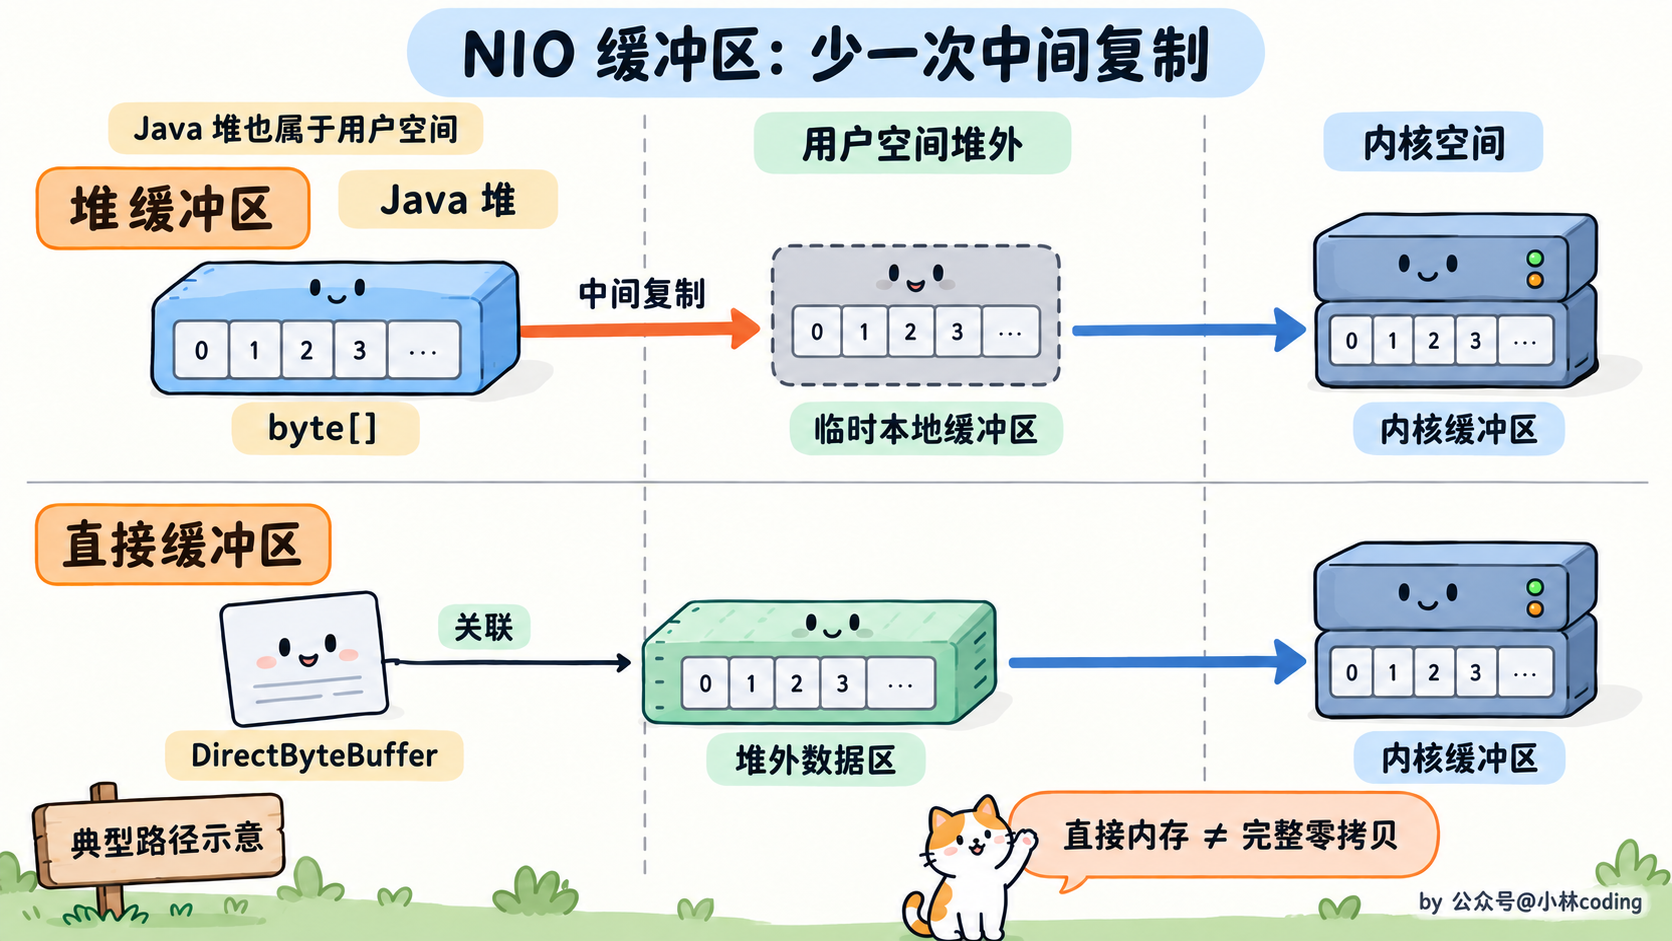
它也有代价:分配和释放通常比普通堆缓冲区更贵,生命周期不容易从普通堆占用里直接看出来,因此不适合为每个小请求频繁创建。
-XX:MaxDirectMemorySize 可以限制标准 NIO 直接缓冲区的总容量,但不是所有本地内存分配都受它控制。线程栈、元空间、JNI 或某些框架直接申请的本地内存,还需要分别观察。
# 内存泄漏和内存溢出的理解?
内存泄漏:内存泄漏是指程序在运行过程中不再使用的对象仍然被引用,而无法被垃圾收集器回收,从而导致可用内存逐渐减少。虽然在Java中,垃圾回收机制会自动回收不再使用的对象,但如果有对象仍被不再使用的引用持有,垃圾收集器无法回收这些内存,最终可能导致程序的内存使用不断增加。
内存泄漏常见原因:
- 静态集合:使用静态数据结构(如
HashMap或ArrayList)存储对象,且未清理。 - 事件监听:未取消对事件源的监听,导致对象持续被引用。
- 线程:未停止的线程可能持有对象引用,无法被回收。
内存溢出:内存溢出是指Java虚拟机(JVM)在申请内存时,无法找到足够的内存,最终引发OutOfMemoryError。这通常发生在堆内存不足以存放新创建的对象时。
内存溢出常见原因:
- 大量对象创建:程序中不断创建大量对象,超出JVM堆的限制。
- 持久引用:大型数据结构(如缓存、集合等)长时间持有对象引用,导致内存累积。
- 线程过多:每个线程都需要独立的栈空间,线程数过多时申请栈内存失败可能抛出
OutOfMemoryError: unable to create new native thread(注意:深度递归触发的是StackOverflowError,并不属于 OOM,二者是不同的 Error)。
内存泄漏可能最终导致内存溢出,但内存溢出不一定是内存泄漏。 比如一次性读取一个超过堆容量的大文件,就算没有任何对象泄漏,也可能直接 OOM。
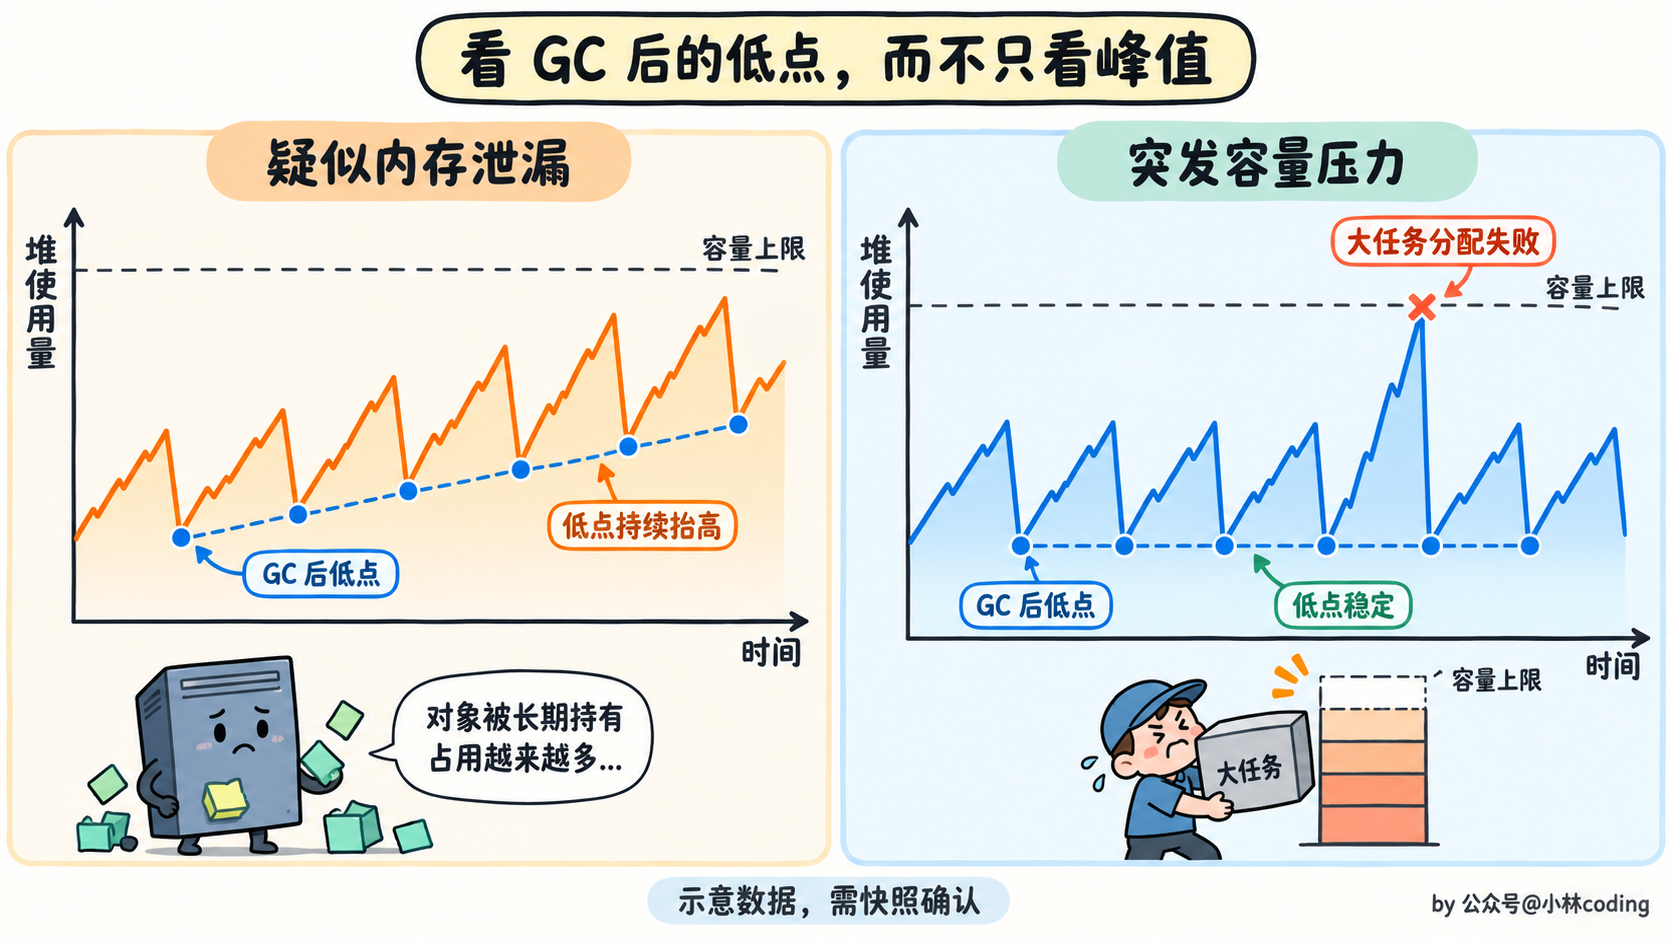
区分时可以看回收后的内存趋势:业务量稳定时,如果多次老年代回收后的占用仍持续上涨,优先怀疑对象被长期持有;如果回收后的占用比较稳定,只在突发流量或大任务时失败,则更可能是容量或分配方式的问题。最终还要结合堆快照确认。
# jvm 内存结构有哪几种内存溢出的情况?
常见的情况可以根据错误信息来区分:
- 堆内存溢出:
OutOfMemoryError: Java heap space。对象占用超过堆容量,或者没有足够空间完成当前分配。可能是内存泄漏,也可能是大对象、突发流量、一次性加载太多数据。 - GC 开销过大:
OutOfMemoryError: GC overhead limit exceeded。在启用相应开销限制的收集器中,JVM 发现长时间忙于 GC,却只能回收很少的内存,就可能抛出这个错误。关闭检查通常解决不了对象占用过高的问题。 - 元空间溢出:
OutOfMemoryError: Metaspace。常见原因是动态生成的类过多、类加载器泄漏,或者元空间上限设置过小。 - 直接内存溢出:
OutOfMemoryError: Direct buffer memory。通过ByteBuffer.allocateDirect()等方式申请直接内存时,超过容量限制或无法完成分配,可能出现这个错误。 - 无法创建本地线程:
OutOfMemoryError: unable to create new native thread。线程过多导致本地内存不足,或者达到操作系统、容器的线程数限制。此时即使 Java 堆还有空闲,也可能失败。
还有一种经常一起被问到的是 StackOverflowError,通常来自递归过深或方法调用链过长。它是栈溢出,但不属于 OutOfMemoryError,需要和“无法创建线程”的问题区分开。
# 遇到过堆溢出的情况吗?如何解决?
堆溢出(java.lang.OutOfMemoryError: Java heap space)通常发生在程序持续创建对象且无法被 GC 及时回收的场景下。
遇到堆溢出时,首先需要定位原因,一般分两步:
- 捕获内存快照:通过 JVM 参数
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=./heapdump.hprof,让程序在发生 OOM 时自动生成堆快照文件。 - 分析快照文件:使用 MAT(Memory Analyzer Tool)或 JProfiler 等工具分析快照,重点看哪些对象占用了大量内存、是否存在内存泄漏(如对象长期被无用引用持有,无法回收)。
常见的解决思路根据原因不同而不同:
- 如果是内存泄漏:比如静态集合无意识地缓存了大量对象、长生命周期对象持有短生命周期对象的引用(如单例类持有业务对象)等。这时候需要梳理对象引用链,找到未释放的根源,比如清理静态集合中不再使用的元素、解除不必要的对象关联。
- 如果是内存不足:即程序确实需要大量内存(如处理大文件、加载大量数据到内存),但当前堆配置太小。这种情况下可以通过调整 JVM 参数扩大堆内存,比如
-Xms2g -Xmx4g(初始堆 2G,最大堆 4G),但要给线程栈、元空间、直接内存等堆外开销留空间,并结合容器内存限制,避免频繁 swap 或进程被系统杀掉。
另外,从代码层面优化也很重要:比如避免一次性加载全部数据(改用分批处理)、使用缓存时设置合理的过期策略、及时释放资源(如 IO 流、数据库连接)等,从源头减少内存占用。
举个例子:一个批量处理任务,代码中把所有处理结果都存到了一个静态 List 里,导致对象越积越多,最终堆溢出。通过分析快照发现这个 List 及其持有的对象占用了大部分堆内存,修改为处理完一批就写入数据库并清空 List 后,问题解决。
# 栈溢出的情况呢?
栈溢出(java.lang.StackOverflowError)是 JVM 中另一种常见的内存错误,和堆溢出的原理与场景截然不同。栈溢出主要发生在 Java 虚拟机栈(或本地方法栈)的内存空间被耗尽时,通常与方法调用的深度直接相关。
从触发原因来看,最常见的场景是无限递归调用。因为 Java 方法调用时会在栈中创建栈帧(存储局部变量、操作数栈、方法返回地址等),每递归一次就会新增一个栈帧。如果递归没有正确的终止条件,栈帧会不断累积,最终超过虚拟机栈的最大容量,导致栈溢出。比如一个简单的无终止条件的递归方法:
public void recursiveMethod() {
    recursiveMethod(); // 无限递归,没有终止条件
}
调用这个方法很快就会抛出StackOverflowError。
另一种情况是单个方法的栈帧较大,比如局部变量槽和操作数栈需求较多,会使相同栈容量下能容纳的调用层数减少。这里不要把“大数组”当成大栈帧的例子:数组内容在堆里,局部变量表保存的是数组引用。
解决栈溢出的思路主要有:
- 排查递归逻辑:检查是否存在无限递归或递归层级过深的问题,添加正确的终止条件,或减少递归深度。必要时可将递归改写为迭代(如用循环替代),因为迭代不会持续创建新栈帧。
- 调整栈内存大小:先确认当前配置,再通过 JVM 参数
-Xss调大栈容量,比如从-Xss512k调整到-Xss1m。但这种方式要谨慎,栈内存过大会导致线程可创建数量减少(总内存固定时,单个线程栈越大,能创建的线程数越少)。 - 优化方法栈帧:在确实存在大栈帧时,简化方法逻辑,减少不必要的局部变量和临时计算;但不要指望把大数组“移到堆里”解决栈溢出,因为普通 Java 数组本来就在堆里。
举个例子:一个树形结构遍历的方法,因节点层级很深且用递归实现,导致栈溢出。解决方式是将递归遍历改为基于栈的迭代遍历,手动维护节点访问顺序,避免了栈帧的无限累积,问题得以解决。
总的来说,栈溢出的核心原因是方法调用栈深度超过了栈内存限制,解决时应优先从代码逻辑(尤其是递归)入手,而非单纯调大栈内存。
# 有具体的内存泄漏和内存溢出的例子么请举例及解决方案?
1、静态属性导致内存泄漏
会导致内存泄漏的一种情况就是用 static 集合持续保留已经不再需要的数据。在Java中,静态属性的生命周期通常伴随着应用整个生命周期(除非ClassLoader符合垃圾回收的条件)。下面来看一个具体的会导致内存泄漏的实例:
import java.util.ArrayList;
import java.util.List;

public class StaticTest {
    public static List<Double> list = new ArrayList<>();
    public void populateList() {
        for (int i = 0; i < 10000000; i++) {
            list.add(Math.random());
        }
        System.out.println("Debug Point 2");
    }
    public static void main(String[] args) {
        System.out.println("Debug Point 1");
        new StaticTest().populateList();
        System.out.println("Debug Point 3");
    }
}
这个例子重点看的是引用关系:从 Point1 到 Point2 创建了大量 Double 对象,堆占用会上升。但 populateList 方法结束后,静态字段 list 仍然持有集合及其中的对象,因此 GC 不能回收这部分数据。实际观察监控图时,还需要让进程保持运行并留出采样时间。
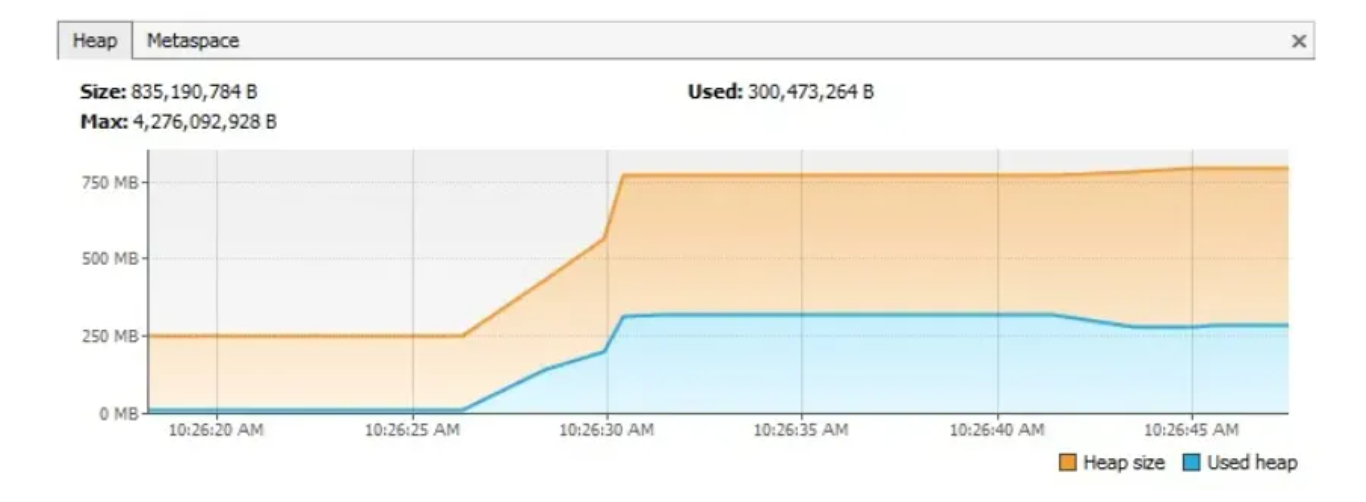
但针对上述程序,如果将定义list的变量前的static关键字去掉,再次执行程序,会发现内存发生了具体的变化。VisualVM监控信息如下图:
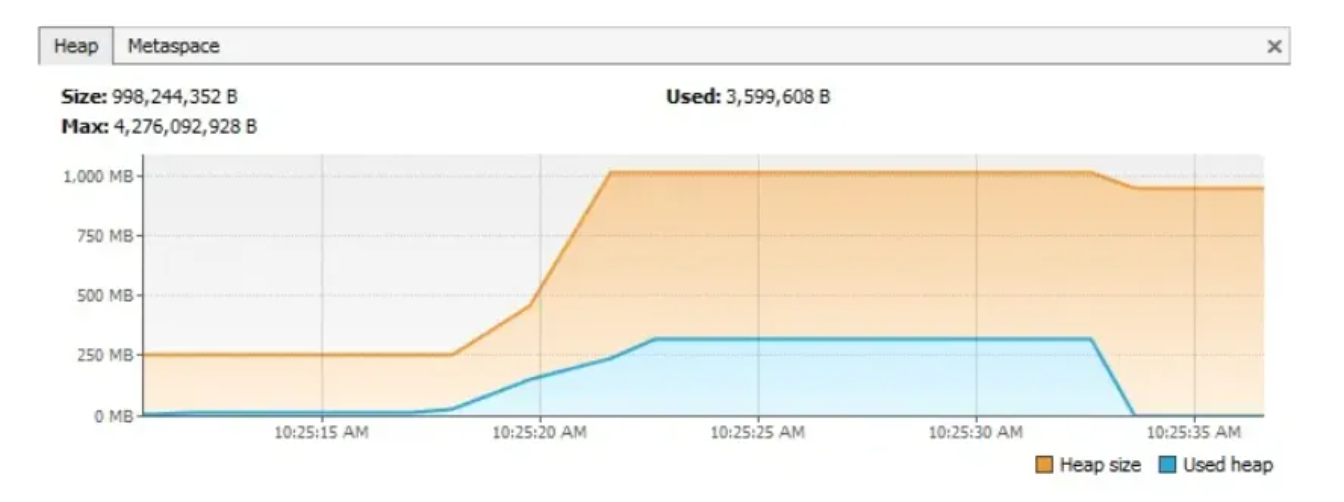
去掉 static 后,集合成为 StaticTest 实例的成员。这个例子中,调用完成后没有其他引用继续持有该实例,集合及其元素就可以变得不可达,并在后续 GC 中回收,但不是方法结束的一瞬间立即释放。两张监控图可以帮助理解这个变化,实际曲线还取决于 GC 和采样时机。反过来,如果这个实例仍被其他长生命周期对象持有,去掉 static 也解决不了问题。
那么如何优化呢?重点不是看到 static 就去掉,而是明确数据还需不需要保留。使用完的数据及时移除,缓存设置容量和过期时间,批量任务分批处理。单例改成懒加载只改变创建时机,并不能解决已经创建的集合不断积累数据的问题。
2、 未关闭的资源
无论什么时候当我们创建一个连接或打开一个流,JVM都会分配内存给这些资源。比如,数据库链接、输入流和session对象。
忘记关闭资源,可能导致文件句柄、连接池连接、堆外内存等资源迟迟不释放。GC 主要管理 Java 对象,不能保证在业务需要的时间内帮我们关闭外部资源。因此问题不一定先表现为堆 OOM,也可能是连接池耗尽、文件句柄超限或本地内存不足。
如何处理呢?实现了 AutoCloseable 的资源,优先使用 Java 7 引入的 try-with-resources;其他资源在 finally 中释放,并正确处理关闭异常,避免一个资源关闭失败后,后面的资源就不再关闭。
3、 使用ThreadLocal
ThreadLocal 提供了线程本地变量,同一个 ThreadLocal 可以让不同线程保存各自的值,访问时从当前线程的存储中取出。它不会自动复制对象,如果不同线程存进去的仍是同一个可变对象,这个对象本身并不会因此变得线程安全。
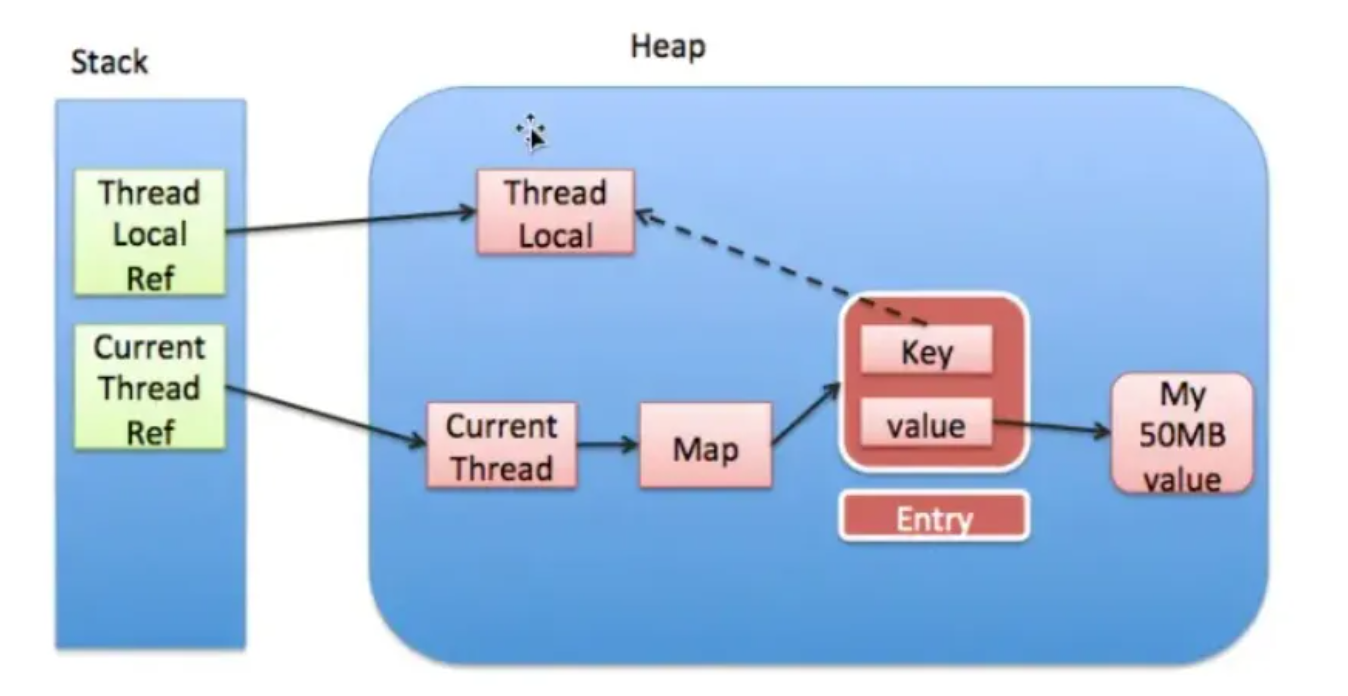
ThreadLocal的实现中,每个Thread维护一个ThreadLocalMap映射表,key是ThreadLocal实例本身,value是真正需要存储的Object。
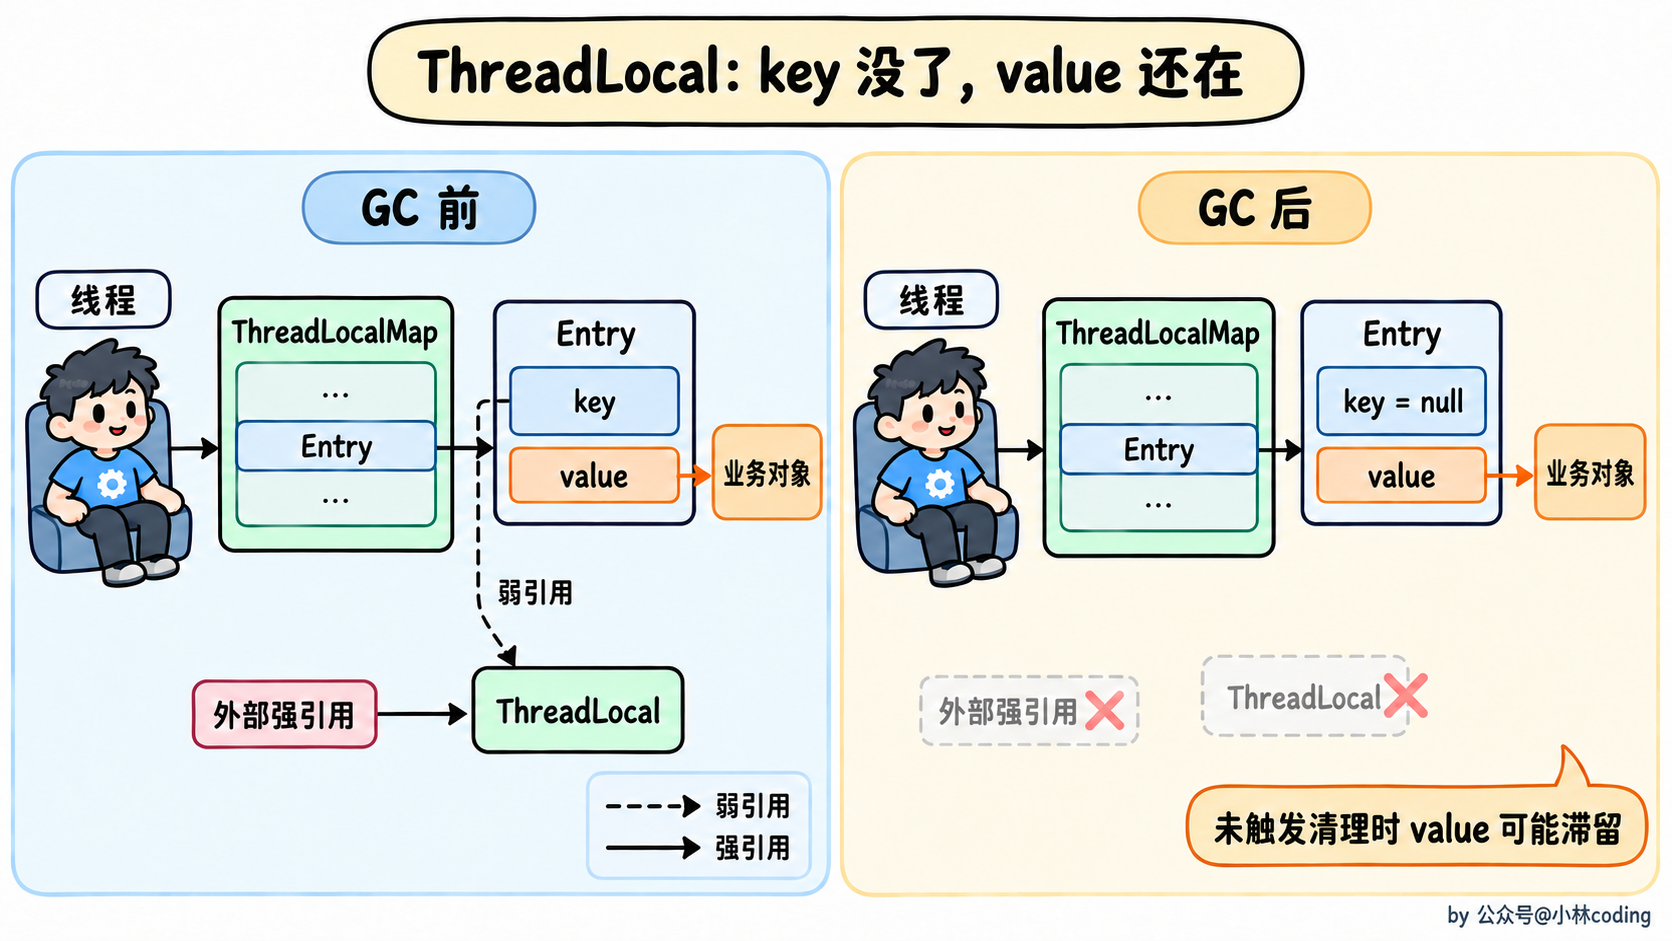
ThreadLocalMap 的 Entry 用弱引用保存 ThreadLocal 这个 key,用强引用保存 value。当 ThreadLocal 没有其他强引用保持可达,GC 就可能清除这个弱引用,Entry 中的 key 变成 null;但 Entry 和 value 不会因此立即消失。
如果当前线程迟迟不结束,比如线程池中的工作线程一直复用,这些 Entry 的 value 仍可能存在强引用链:Thread → ThreadLocalMap → Entry → value,导致业务数据无法及时回收。ThreadLocalMap 会在部分 get、set、remove 操作中清理失效 Entry,但并不是 key 一被 GC 回收,value 就立即清理。如果后续没有触发相应清理,这些值就可能长时间滞留;即使 key 还在,任务结束后没有移除旧值,也可能把数据留在池化线程里。
如何解决此问题?
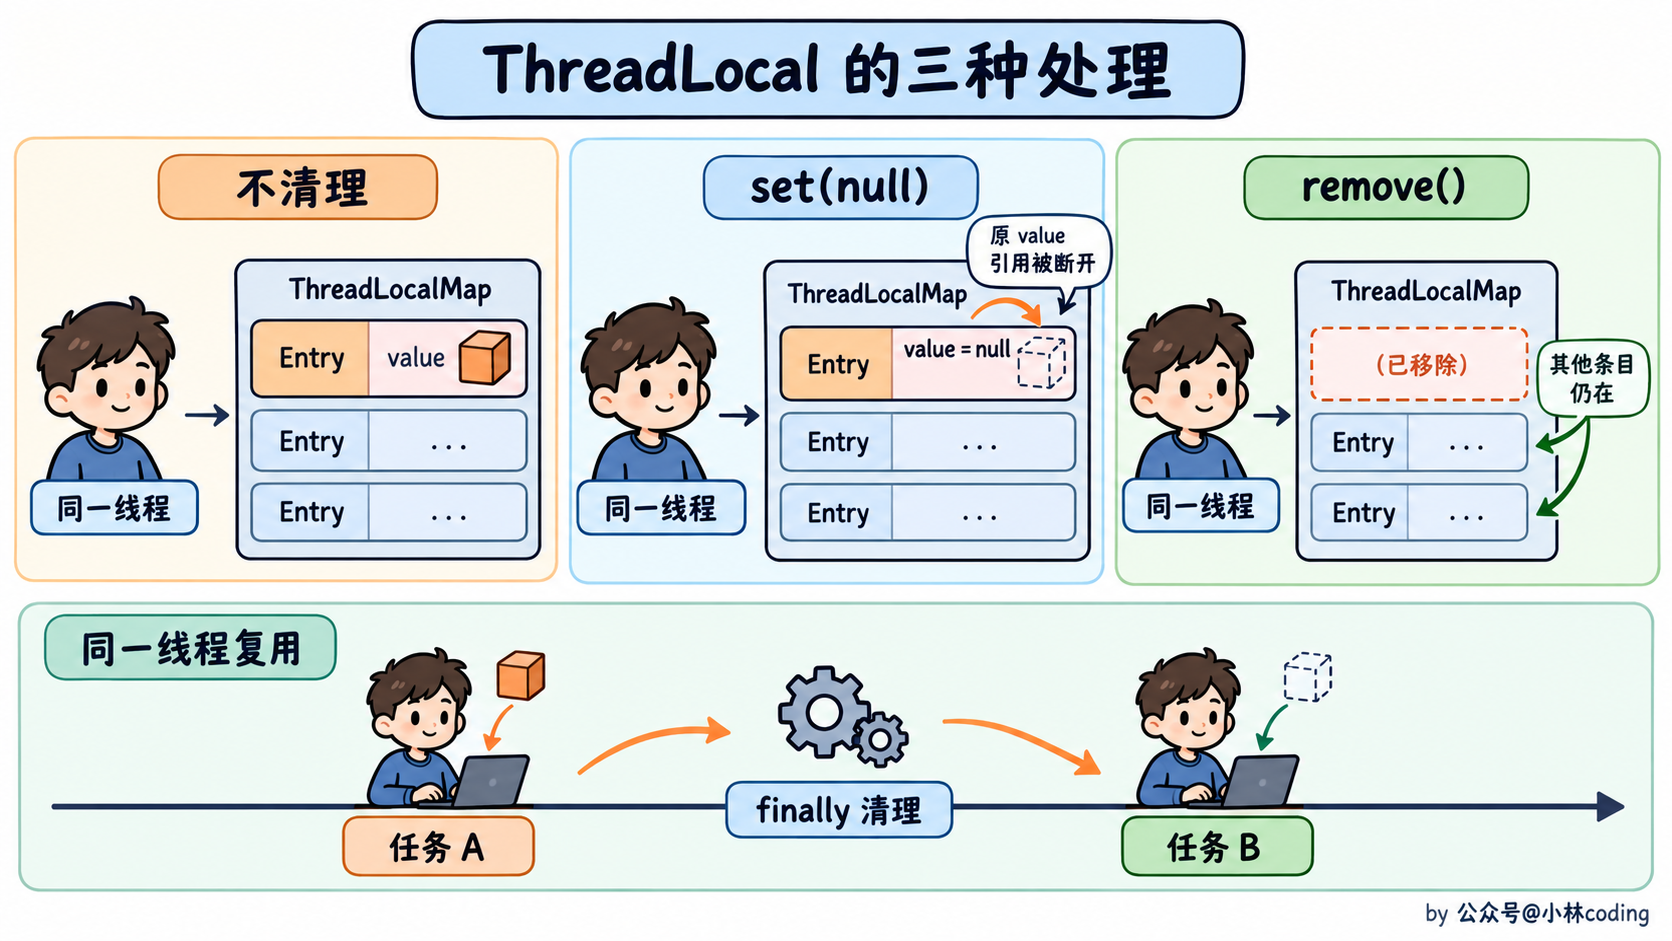
- 第一,使用ThreadLocal提供的remove方法,可对当前线程中的value值进行移除;
- 第二,
set(null)会把当前 Entry 的 value 设为 null,可以断开对原 value 的引用,但 Entry 仍然存在;remove()则会移除当前 ThreadLocal 对应的 Entry,更适合在任务结束时清理。 - 第三,把
remove()放在 finally 中,保证任务正常结束和抛出异常时都能清理,也避免线程复用时读到上一次任务留下的数据。
try {
    threadLocal.set(System.nanoTime());
    //... further processing
} finally {
    threadLocal.remove();
}
# 类初始化和类加载
# 创建对象的过程?
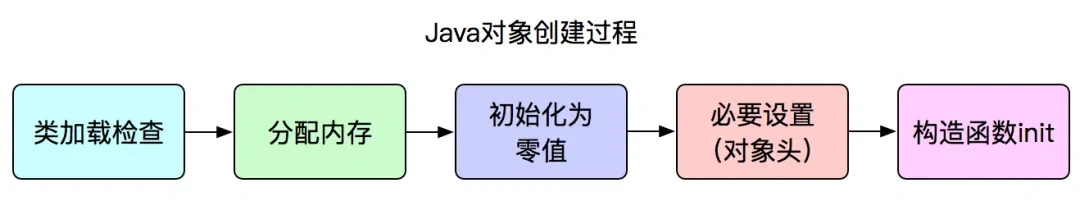
以 new 创建普通对象为例,可以按下面几个步骤来理解:
- 类加载检查:虚拟机遇到一条 new 指令时,首先将去检查这个指令的参数是否能在常量池中定位到一个类的符号引用,并确保目标类已经完成必要的加载、连接和初始化。如果是第一次主动使用这个类,就要先完成相应的类初始化过程;并不是每次 new 都重新加载、初始化这个类。
- 分配内存:在类加载检查通过后,接下来虚拟机将为新生对象分配内存。对象所需的内存大小在类加载完成后便可确定,为对象分配空间的任务等同于把一块确定大小的内存从 Java 堆中划分出来。内存规整时可以通过指针碰撞分配,有碎片时可能使用空闲列表,具体取决于收集器实现。多个线程并发分配时,可以使用 CAS 保证更新的原子性,也可以先在各自的 TLAB 中分配。
- 初始化零值:内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头),这一步操作保证了对象的实例字段在 Java 代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值。
- 进行必要设置,比如对象头:初始化零值完成之后,虚拟机要对对象进行必要的设置,例如这个对象是哪个类的实例、如何才能找到类的元数据信息、对象的 GC 分代年龄、锁状态等信息。哈希码相关信息也可能保存在对象头中,但不一定在创建时就计算。这些信息存放在对象头中。对象头的具体布局与 JDK 版本、压缩指针等配置有关。
- 执行
<init>()方法:完成内存分配和零值初始化后,再执行实例构造器,包括相应的父类构造器、实例字段初始化和实例初始化块等逻辑,把对象初始化为程序需要的状态。这里的<init>()是对象构造过程,和类初始化时执行的<clinit>()要区分开。
# 对象的生命周期
对象的生命周期包括创建、使用和销毁三个阶段:
- 创建:对象通过关键字new在堆内存中被实例化,构造函数被调用,对象的内存空间被分配。
- 使用:对象被引用并执行相应的操作,可以通过引用访问对象的属性和方法,在程序运行过程中被不断使用。
- 回收:当对象从 GC Roots 不再可达,并满足相应的回收条件时,GC 可以回收它占用的内存。对象互相引用并不一定妨碍回收,对象变得不可达也不代表内存立刻释放。文件、连接等外部资源仍需要显式关闭,不能依赖对象被 GC 回收来及时释放。
# 对象一定分配在堆上吗?什么是逃逸分析?
从 Java 虚拟机规范和通常的内存结构来看,对象实例和数组在堆上分配。但在实际运行时,JIT 编译器可能优化掉一部分对象分配。
逃逸分析就是分析一个对象会不会跑到当前方法或线程之外。比如对象被作为方法返回值返回、保存到静态字段,或者传给其他线程使用,就可能发生逃逸。
如果编译器确定对象不会逃逸,并且满足其他优化条件,就可能做下面这些优化:
- 标量替换:把对象拆成几个独立的字段值,不再真正创建整个对象。
- 锁消除:如果能证明相关锁不会被其他线程竞争,就可能消除不必要的同步操作。
比如一个方法只创建一个坐标对象,计算 x + y 后返回结果,坐标对象没有传到外部,编译器就可能直接用两个值计算,不再为这个对象分配堆内存。
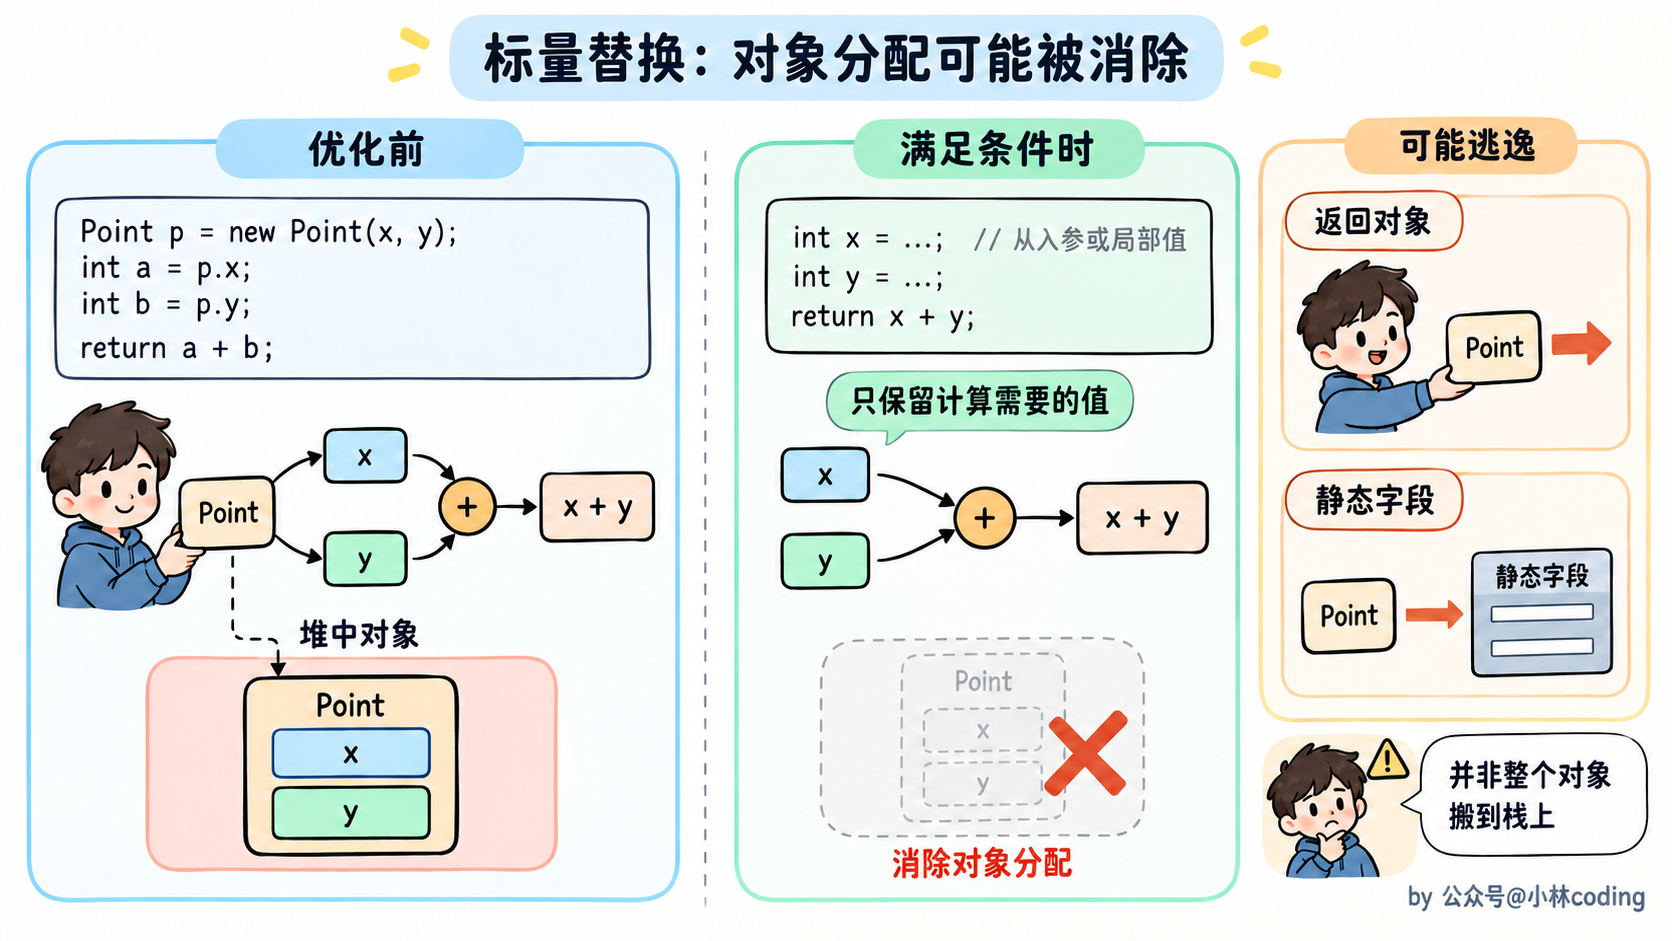
所以面试里不要简单说“没有逃逸的对象就一定在栈上分配”。在常见 HotSpot 实现中,重点是逃逸分析可能带来标量替换和分配消除,而且没有逃逸也不代表优化一定成功。
# TLAB 是什么?为什么能提高对象分配效率?
TLAB 全称是 Thread Local Allocation Buffer,也就是线程本地分配缓冲区。在常见的 HotSpot 分代收集器中,JVM 可以在堆的 Eden 区为每个线程划一小块空间,让线程优先在自己的空间里分配对象。
我们考虑一下,如果所有线程每创建一个对象,都去争抢同一个分配指针,是不是就需要频繁做同步?有了 TLAB,线程在自己的缓冲区里分配时,通常只需要移动本地的分配指针,减少了线程之间的竞争。
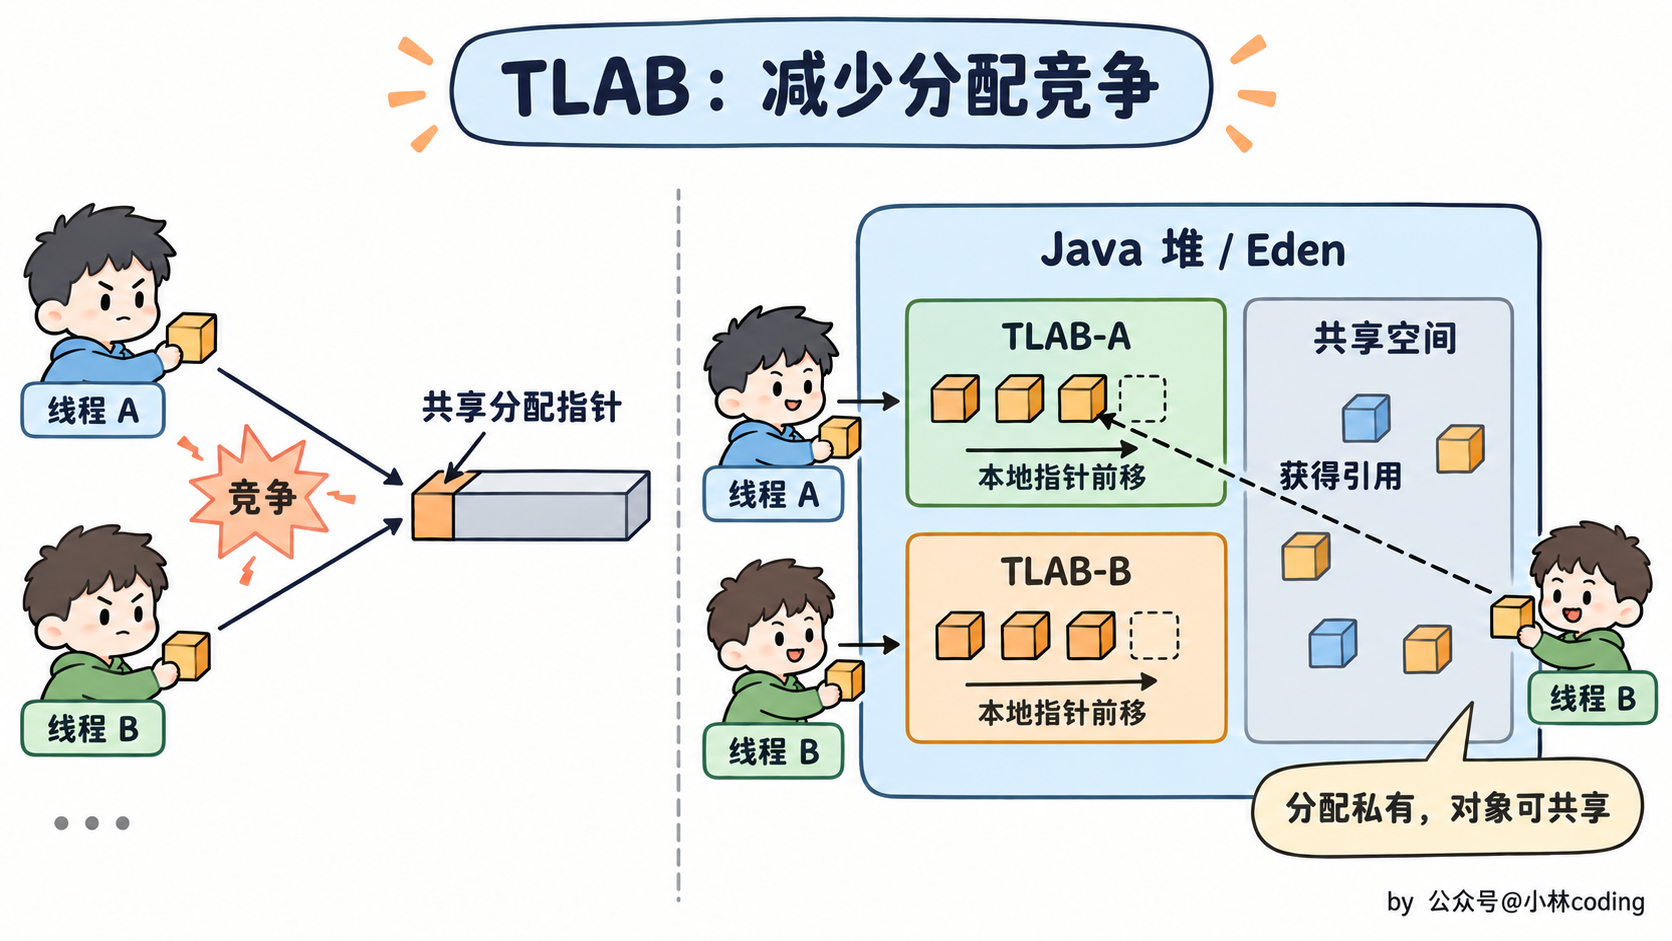
当前 TLAB 空间不够时,JVM 可能重新申请 TLAB,也可能让这次分配走 TLAB 外的路径。大对象不一定适合放进 TLAB,具体由分配策略决定。
要注意:TLAB 在堆里,不在虚拟机栈里。 “线程私有”说的是分配时由对应线程使用,不代表其中的对象不能被别的线程访问,也不代表这块空间不需要 GC。
# 类加载器有哪些?
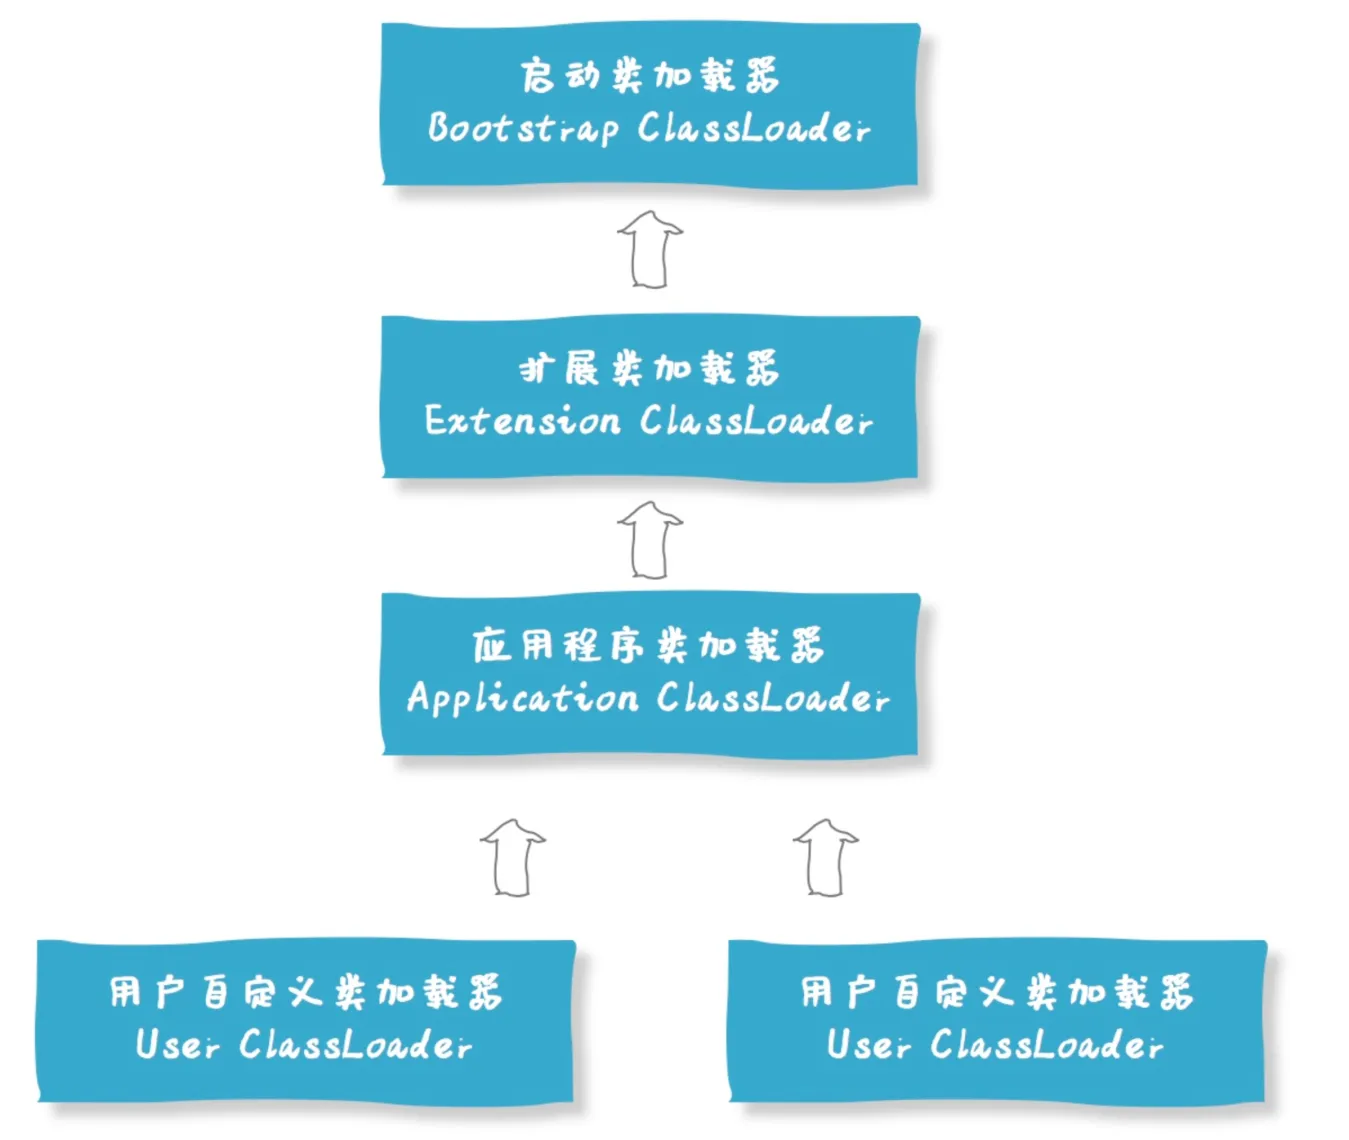
- 启动类加载器(Bootstrap Class Loader):这是最顶层的类加载器,负责加载 Java 的核心类库。在 Java 8 及之前加载
jre/lib/rt.jar中的类,从 Java 9 起rt.jar已被 JEP 220 移除,核心类库存放在$JAVA_HOME/lib/modules的模块化运行时镜像中(如java.base模块)。它由 C++ 编写,是 JVM 的一部分,在 Java 层面没有对应的 ClassLoader 对象(通过getClassLoader()获取时返回null),无法被 Java 程序直接引用。 - 平台类加载器 / 扩展类加载器:
- Java 8 及以前称为 Extension Class Loader(扩展类加载器),负责加载
jre/lib/ext或由java.ext.dirs系统属性指定目录下的 jar 包和类库。 - Java 9 起通过 JEP 220 替换为 Platform Class Loader(平台类加载器),
jre/lib/ext目录和java.ext.dirs属性都已被移除。平台类加载器负责加载一部分 Java 平台模块中的类,具体模块的归属由 JDK 实现决定,不能理解为“核心类以外的所有 JDK 类都由它加载”。 - 在常见 HotSpot 实现中,
getParent()返回null,但在默认委派逻辑上仍会先尝试启动类加载器。
- Java 8 及以前称为 Extension Class Loader(扩展类加载器),负责加载
- 应用程序类加载器(Application Class Loader,也叫 System Class Loader):负责加载用户类路径(ClassPath)上的类,以及通常分配给它的应用模块中的类,是开发者平时默认使用的类加载器。可以通过
ClassLoader.getSystemClassLoader()获取。它的父加载器是 Platform Class Loader(Java 8 下为 Extension Class Loader)。 - 自定义类加载器(Custom Class Loader):开发者可以根据需求定制类的加载方式,比如从网络加载 class 文件、数据库、甚至是加密的文件中加载类等。自定义类加载器可以用来扩展 Java 应用程序的灵活性和安全性,是 Java 动态性的一个重要体现。
传统的父加载器委派关系形成了双亲委派模型,其核心思想是当一个类加载器收到类加载的请求时,首先不会自己去尝试加载这个类,而是把这个请求委派给父类加载器去完成,每一层次的类加载器都是如此,因此所有的加载请求最终都应该传送到顶层的启动类加载器中。
只有当父加载器反馈自己无法完成这个加载请求(它的搜索范围中没有找到所需的类)时,子加载器才会尝试自己去加载。
# Java 中 双亲委派 是什么?有啥用?
Java 中的 “双亲委派” 是类加载机制的核心原则,简单说就是 「一个类加载器要加载类时,先让父加载器去尝试加载,只有父加载器加载不了,自己才会去加载」。这里的 “双亲” 并不是指真正的继承关系,而是类加载器之间的一种层级委派关系。
具体来说,Java 的类加载器有一套默认的层级结构:最顶层是 Bootstrap ClassLoader(启动类加载器,负责加载 JDK 核心类,如 java.lang.String),往下是 Extension ClassLoader(扩展类加载器,加载 JDK 扩展目录的类;JDK 9 起已被 Platform ClassLoader 取代),再往下是 AppClassLoader(应用类加载器,加载我们自己写的类和第三方 jar 包),我们也可以自定义类加载器,放在最下层。下文沿用 JDK 8 的传统命名。
当某个类加载器(比如自定义加载器)收到加载类的请求时,它不会先自己动手,而是把请求 “委派” 给父加载器;父加载器同样会继续委派给它的父加载器,直到传到最顶层的启动类加载器。如果父加载器能找到并加载这个类,就直接返回;如果所有父加载器都加载不了(比如不在它们的加载范围内),子加载器才会自己去尝试加载。
举个例子:我们自己写了一个java.lang.String类,当AppClassLoader要加载它时,会先委派给Extension ClassLoader,再委派给Bootstrap ClassLoader。而启动类加载器发现自己已经加载过 JDK 自带的String类了,就直接返回这个类,不会去加载我们自定义的String类。
这种机制的核心作用有两个:
- 保证类的唯一性和安全性:让子加载器尽量复用父加载器已经定义的类,减少重复加载,确保核心类(如 JDK 的
String、Integer)不会被篡改。比如上面的例子,防止我们自定义的String类替换掉 JDK 的核心类,否则可能引发安全问题(比如修改String的底层实现导致系统混乱)。 - 实现类的复用:核心类只需要被顶层加载器加载一次,所有子加载器都能共享这个类,减少内存消耗。
简单说,双亲委派就像 「孩子找东西先问家长,家长解决不了再自己找」,通过层级委派确保了 Java 核心类的安全和类加载的有序性,是 Java 运行时环境稳定的基础。
# 双亲委派模型的作用
双亲委派主要有三个作用:
- 复用父加载器定义的类:比如应用中用到
java.lang.String时,复用启动类加载器加载的版本,避免每一层加载器都重新定义一份。 - 保护核心类库:普通应用按默认委派路径加载时,会优先找到 JDK 的核心类,避免被应用路径下的同名类覆盖。除此之外,Java 对
java.*包的类定义也有额外限制,不能把核心类安全完全归功于双亲委派。 - 划分类加载职责:不同加载器负责不同范围的类,便于管理依赖关系。
不过它不保证“整个 JVM 中相同类名只能存在一份”。不同的自定义类加载器仍然可以各自定义同名类,它们在 JVM 中是不同类型。双亲委派是一种常用的加载策略,不是所有类加载器都必须遵守的强制规则。
# 讲一下类加载过程?
类从被加载到虚拟机内存开始,到卸载出内存为止,它的整个生命周期包括以下 7 个阶段:
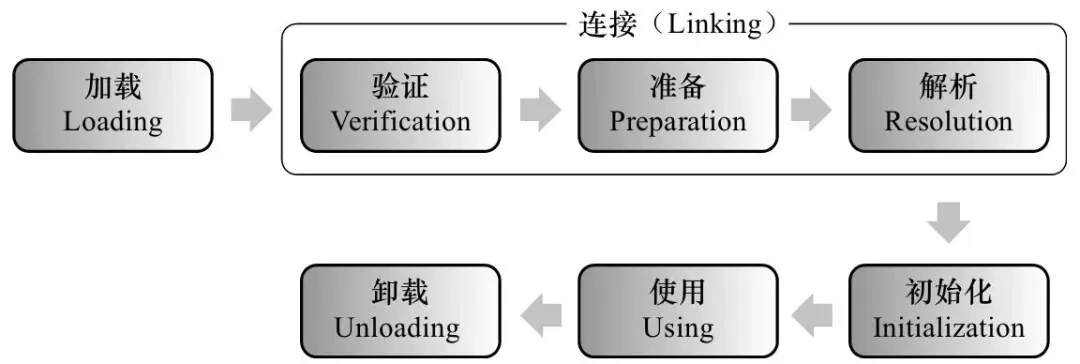
- 加载:通过类的全限定名(包名 + 类名),获取到该类的.class文件的二进制字节流,将二进制字节流所代表的静态存储结构,转化为方法区运行时的数据结构,在内存中生成一个代表该类的java.lang.Class对象,作为方法区这个类的各种数据的访问入口
- 连接:验证、准备、解析 3 个阶段统称为连接。
- 验证:确保class文件中的字节流包含的信息,符合当前虚拟机的要求,保证这个被加载的class类的正确性,不会危害到虚拟机的安全。验证阶段大致会完成以下四个阶段的检验动作:文件格式校验、元数据验证、字节码验证、符号引用验证
- 准备:为类中的静态字段分配内存,并设置默认的初始值,比如int类型初始值是0。对于带 ConstantValue 属性的静态字段,比如
static final int LIMIT = 100,会按常量值赋值,而不是只设为 0。不能说所有 static final 字段都在编译期完成了赋值,比如static final Integer LIMIT = 100或调用方法得到的值,还需要在初始化阶段执行相关代码 - 解析:解析阶段是虚拟机将常量池的「符号引用」直接替换为「直接引用」的过程。符号引用是以一组符号来描述所引用的目标,符号可以是任何形式的字面量,只要使用的时候可以无歧义地定位到目标即可。直接引用可以是直接指向目标的指针、相对偏移量或是一个能间接定位到目标的句柄,直接引用是和虚拟机实现的内存布局相关的。如果有了直接引用, 那引用的目标必定已经存在在内存中了。
- 初始化:初始化是整个类加载过程的最后一个阶段,初始化阶段简单来说就是执行类的类构造器方法
<clinit>(),要注意的是这里的<clinit>()并不是开发者写的构造函数(那个是实例构造器<init>()),而是编译器自动收集类中所有静态变量的赋值语句和静态代码块合并生成的。 - 使用:使用类或者创建对象
- 卸载:一个类要被JVM卸载,条件非常苛刻,需要同时满足以下三点:
- 该类所有的实例都已经被回收:这是最显而易见的前提。如果堆中还存在这个类的任何一个实例对象,那么定义这个对象的Class对象肯定不能被卸载。
- 定义该类的 ClassLoader 可以被回收:对于普通类,如果定义它的类加载器仍然可达,就不能卸载它。这里不是要求先单独回收加载器,再按固定顺序卸载类,而是判断加载器以及相关类、实例是否整体失去外部可达引用。
- 对应的 Class 对象也不可达:没有存活的外部对象通过反射缓存、静态字段、JNI 等方式继续持有它。满足这些条件只是具备卸载资格,实际是否卸载,还要看收集器和配置。启动类加载器定义的普通核心类不会按这种方式卸载。
# 讲一下类的加载和双亲委派原则
我们把 Java 的类加载过程分为三个主要步骤:加载、链接、初始化。
首先是加载阶段(Loading),它是 Java 将字节码数据从不同的数据源读取到 JVM 中,转化为方法区中的运行时数据结构,并在堆中生成对应的 Class 对象作为访问入口,这里的数据源可能是各种各样的形态,如 jar 文件、class 文件,甚至是网络数据源等;如果输入数据不是 ClassFile 的结构,则会抛出 ClassFormatError。
加载阶段是用户参与的阶段,我们可以自定义类加载器,去实现自己的类加载过程。
第二阶段是链接(Linking),这是核心的步骤,简单说是把原始的类定义信息平滑地转化入 JVM 运行的过程中。这里可进一步细分为三个步骤:
- 验证(Verification),这是虚拟机安全的重要保障,JVM 需要核验字节信息是符合 Java 虚拟机规范的,否则就被认为是 VerifyError,这样就防止了恶意信息或者不合规的信息危害 JVM 的运行,验证阶段有可能触发更多 class 的加载。
- 准备(Preparation),创建类或接口中的静态变量,并初始化静态变量的初始值。但这里的“初始化”和下面的显式初始化阶段是有区别的,侧重点在于分配所需要的内存空间,不会去执行更进一步的 JVM 指令。
- 解析(Resolution),在这一步会将常量池中的符号引用(symbolic reference)替换为直接引用。
最后是初始化阶段(initialization),这一步真正去执行类初始化的代码逻辑,包括静态字段赋值的动作,以及执行类定义中的静态初始化块内的逻辑,编译器在编译阶段就会把这部分逻辑整理好,类的初始化会先保证父类完成初始化,但接口不是一律跟着父类规则来初始化:初始化一个接口不会自动初始化所有父接口;类初始化时,声明了 default 方法的相关父接口则需要按规则先初始化。
再来谈谈双亲委派模型,简单说就是当类加载器(Class-Loader)试图加载某个类型的时候,除非父加载器找不到相应类型,否则尽量将这个任务代理给当前加载器的父加载器去做。使用委派模型的目的是优先复用父加载器定义的类、保护核心类库,而不是保证整个 JVM 中所有同名类都只有一份。
# 哪些情况会触发类初始化?
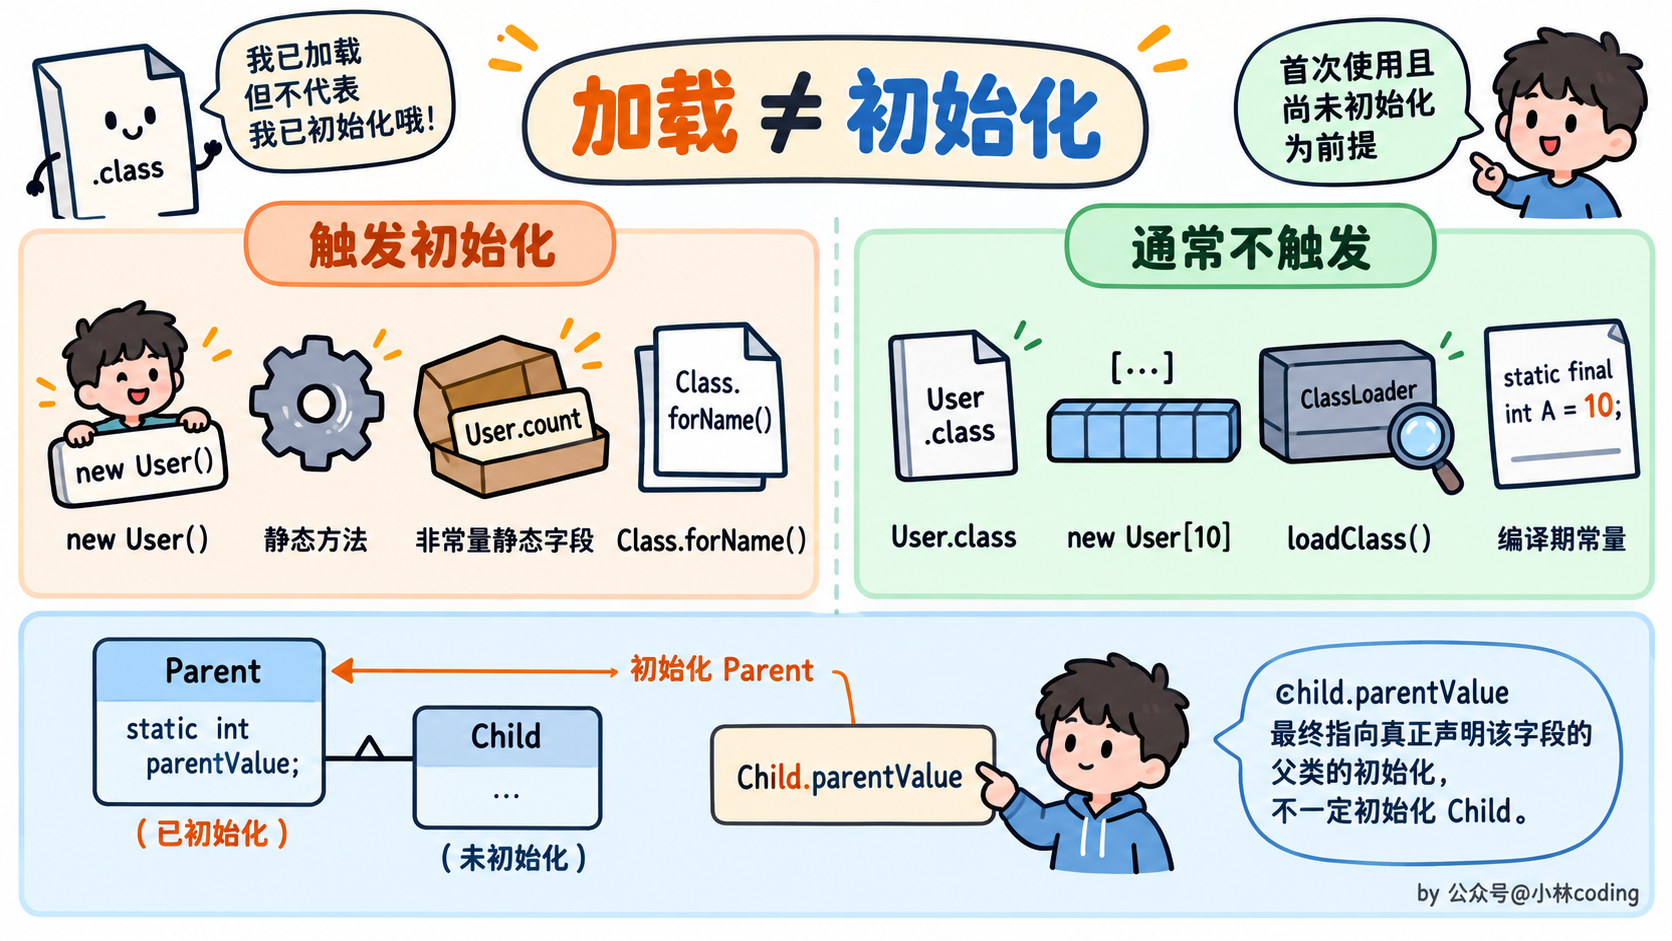
可以先抓住一个关键词:主动使用。加载一个类,不代表它已经执行了静态代码块。
常见的初始化触发场景有:
- 使用
new创建对象。 - 读取或修改类的静态字段,但读取编译期常量除外。
- 调用类的静态方法。
- 通过某些反射操作主动使用类,比如
Class.forName("com.example.User")默认会触发初始化。 - 初始化子类时,先初始化还没有完成初始化的父类。
- JVM 启动时,初始化包含 main 方法的入口类。
反过来,下面这些操作通常不会触发目标类初始化:
- 读取编译期常量,比如
static final int LIMIT = 100,常量值可以被编译器放进调用方的字节码中。 - 使用
User.class获取 Class 对象。 - 创建
new User[10],创建的是数组,不是 10 个 User 实例。 - 使用 ClassLoader 的
loadClass()加载类,或者使用Class.forName(name, false, loader)明确不初始化。
还有一个常见追问:通过子类名读取父类声明的静态字段,比如 Child.parentValue,初始化的是真正声明这个字段的父类,不一定初始化 Child。
# 类初始化是线程安全的吗?
同一个类的初始化过程由 JVM 保证同步,正常情况下只会成功执行一次。 如果多个线程同时第一次使用这个类,JVM 会让一个线程执行初始化,其他需要初始化结果的线程等待。
这也是静态内部类单例能够实现延迟加载的原因之一:第一次使用内部类中的静态实例时,才触发内部类初始化,由 JVM 保证这次初始化的同步和结果的可见性。
但这只能保证初始化过程,不能保证对象后续的所有操作都线程安全。静态字段里放了一个普通 HashMap,初始化完成后多个线程同时修改它,仍然需要另外做并发控制。
如果静态初始化代码抛出异常,类会进入初始化失败的状态。比如静态代码块抛出 RuntimeException,第一次通常会看到 ExceptionInInitializerError,后续再次主动使用这个类时可能看到 NoClassDefFoundError: Could not initialize class。所以看到 NoClassDefFoundError,也要检查之前是不是已经发生过初始化失败。
# 双亲委派模型可以打破吗?为什么要打破?
可以。双亲委派主要体现在 ClassLoader 默认的 loadClass() 流程中,自定义类加载器可以改变这个委派顺序。
默认的流程是:先检查是否已经加载,再让父加载器尝试,最后才调用自己的 findClass()。如果只是想改变“从哪里读取 class 文件”,通常重写 findClass() 就够了,仍然保留双亲委派。
如果需要优先加载自己范围内的某些类,就可能重写 loadClass(),为这些类采用子加载器优先的策略。比如应用容器希望不同应用使用各自版本的依赖,就会使用类加载隔离;核心 Java 类仍然通常交给父加载器。
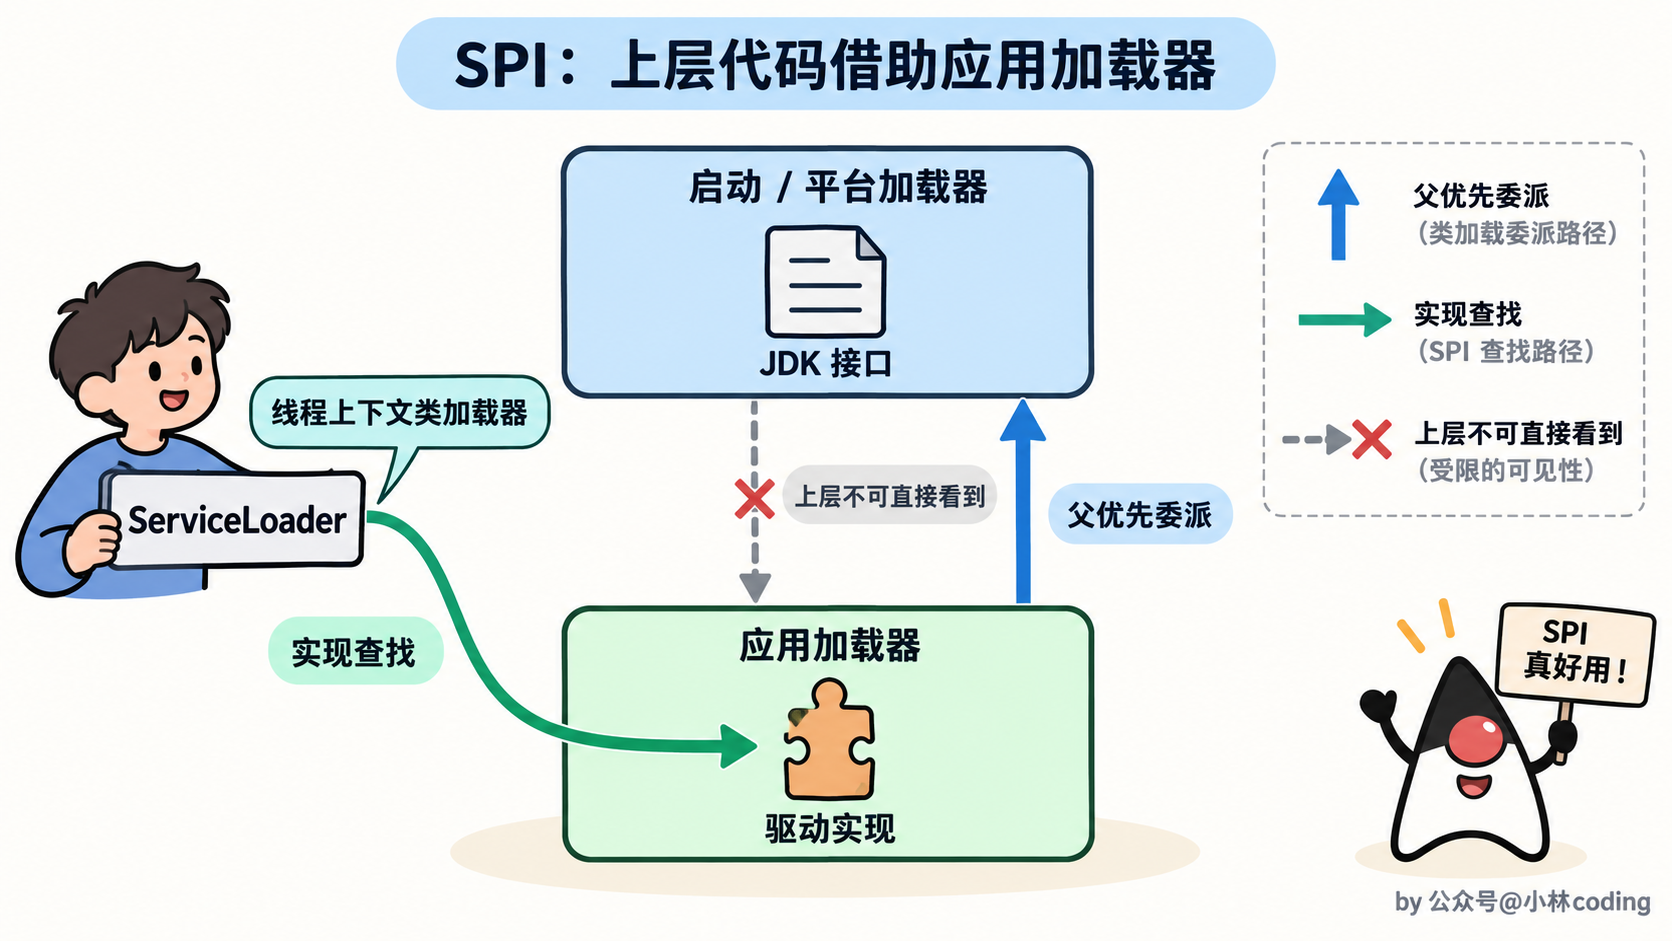
还有一种经常被问到的情况是 SPI 和线程上下文类加载器。比如 JDBC 的接口在 JDK 中,具体数据库驱动却在应用依赖里,加载接口的上层加载器不一定看得到驱动实现。ServiceLoader 可以借助线程上下文类加载器查找应用提供的实现。
这里要分清:线程上下文类加载器是让上层代码借助另一个加载器找实现,不等于这个加载器自身一定采用了子加载器优先。 面试里常把它称为突破了双亲委派的可见性限制,但具体的 loadClass 流程仍可能遵守父优先。
# 两个相同类名的类,一定是同一个类吗?
不一定。JVM 判断普通类的身份,要同时看类的全限定名和定义它的类加载器。
比如两个自定义加载器,各自定义了一份 com.example.User,即使 class 文件内容完全相同,在 JVM 看来也是两个不同的类型。一个加载器创建的 User 对象,不能直接转换成另一个加载器定义的 User,否则可能出现“User 不能转换成 User”的 ClassCastException。
但也不是“经过两个加载器就一定不同”。如果两个加载器最终都委派给同一个父加载器,由父加载器定义并返回同一个 User,它们拿到的就是同一个类。
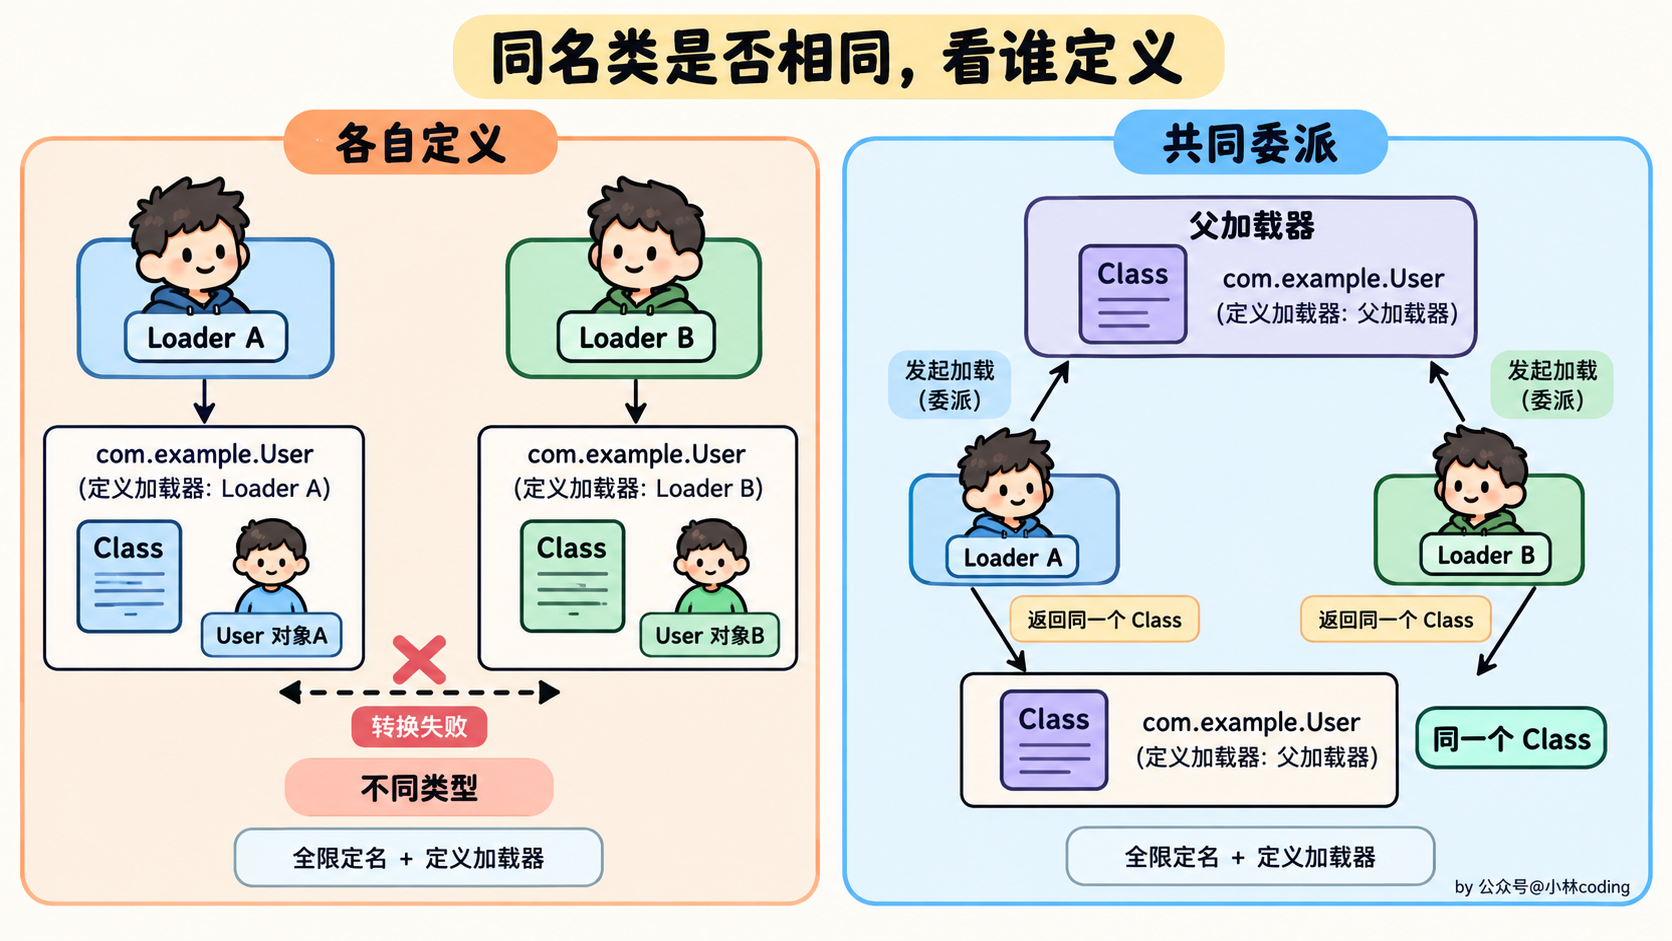
这种问题常出现在插件系统、应用容器、热部署场景中。排查时除了看类名,还要看 getClassLoader() 的结果,以及共享接口是不是由双方共同的父加载器定义。
# 垃圾回收
# 什么是Java里的垃圾回收?如何触发垃圾回收?
垃圾回收(Garbage Collection,GC)是 JVM 自动管理对象内存的一种机制。它主要做两件事:找出不再需要保留的对象,再回收它们占用的内存。是否需要保留,主要通过对象从 GC Roots 的可达性来判断,而不是根据业务上“以后会不会用到”。
常见的触发场景有:
- 对象分配空间不足:比如 Eden 空间不足,通常会触发 Young GC;对象晋升或老年代分配失败,可能触发进一步的回收。
- 达到收集器的启动阈值:并发收集器通常会提前启动回收,而不是等整个堆都满了。比如 G1 会根据老年代占用、对象分配速度、标记所需时间等信息,决定什么时候启动并发标记。
- 元空间达到相关阈值:JVM 可能通过 GC 尝试卸载无用的类,释放类元数据占用的空间。
- 显式请求:
System.gc()或Runtime.getRuntime().gc()可以提出回收请求,但具体如何执行,要看收集器和 JVM 参数,也可以被配置为忽略。
-Xms、-Xmx 等参数会影响容量和回收频率,但“设置参数”本身不是一次 GC 事件。G1 的 -XX:InitiatingHeapOccupancyPercent 也不能简单理解成“整个堆固定用到 45% 就触发 Full GC”:它涉及并发标记的启动阈值,现代 G1 默认还会自适应调整。
# 判断垃圾的方法有哪些?
在Java中,判断对象是否为垃圾(即不再被使用,可以被垃圾回收器回收)常见思路有引用计数法和可达性分析算法,但 HotSpot 主要使用可达性分析,不是靠引用计数来判断对象能不能回收。
引用计数法(Reference Counting)
- 原理:为每个对象分配一个引用计数器,每当有一个地方引用它时,计数器加1;当引用失效时,计数器减1。当计数器为0时,表示对象不再被任何变量引用,可以被回收。
- 缺点:不能解决循环引用的问题,即两个对象相互引用,但不再被其他任何对象引用,这时引用计数器不会为0,导致对象无法被回收。
可达性分析算法(Reachability Analysis)
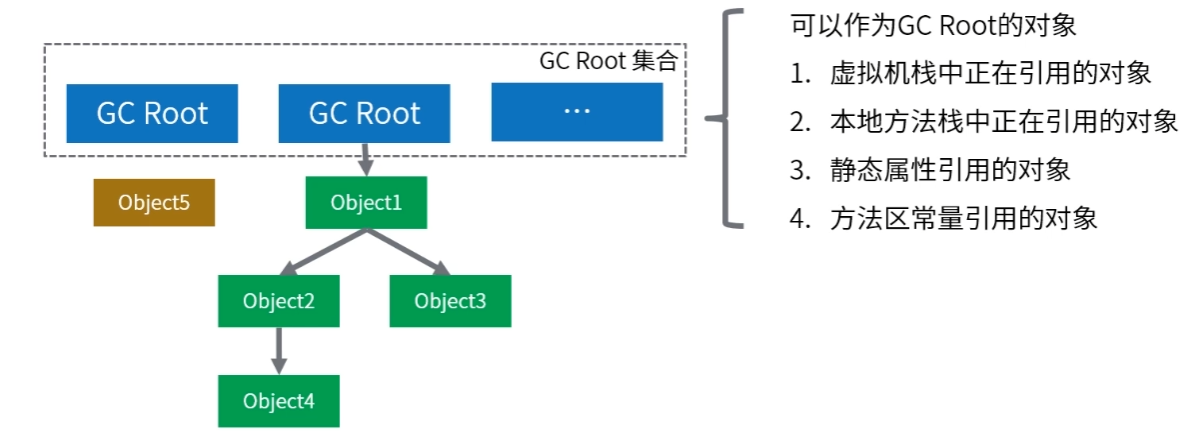
Java虚拟机主要采用此算法来判断对象是否为垃圾。
- 原理:从一组称为 GC Roots(垃圾收集根)的对象出发,向下追溯它们引用的对象,以及这些对象引用的其他对象,以此类推。如果一个对象到 GC Roots 没有任何引用链相连(即从 GC Roots 到这个对象不可达),那么这个对象就被认为是不可达的,可以被回收。GC Roots 对象主要包括:
- 虚拟机栈(栈帧中的本地变量表)中引用的对象;
- 存活类的静态字段引用的对象,面试里通常概括为“方法区中类静态属性引用的对象”;
- 本地方法中 JNI 的局部引用和全局引用所指向的对象;
- 存活线程及 JVM 内部仍需要保持存活的对象;
- 被同步锁持有等原因需要保持存活的对象。
这里列的是常见来源,具体根集合由 JVM 实现维护。不要把“所有常量池条目”都理解成永久的 GC Roots,字符串常量池中的字符串也可以在不再被使用时回收。
比如 A 和 B 互相引用,但外部已经没有任何从 GC Roots 到它们的引用链,引用计数可能处理不了,可达性分析却能识别出它们可以回收。
# 垃圾回收算法是什么,是为了解决了什么问题?
垃圾回收算法主要解决两个问题:哪些对象已经可以回收,以及怎样回收、整理这些对象占用的空间。
比如可达性分析用来判断存活对象,标记-清除、复制、标记-整理等算法负责具体回收。不同算法会在回收效率、空间利用率、对象移动开销之间做不同取舍。
GC 的好处是程序员不用手动释放每一个对象,减少了手动内存管理带来的错误。但它不能判断业务上某个对象是不是“已经没用了”。如果一个静态 Map 一直保存过期数据,这些对象仍然可达,GC 就不会帮我们删除它们。
所以 有 GC 不代表不会内存泄漏,也不代表不会 OOM。长期持有无用对象、一次性分配超大数组,都可能让应用出问题。文件、数据库连接等外部资源,也需要我们按使用约定主动释放。
# java的gc 机制你知道哪些?
Java 的 GC(垃圾回收)简单说就是「自动识别并回收可以回收的对象,释放内存空间」,减少手动管理对象内存的负担。主要可以从 “哪些对象会被回收”“怎么回收”“回收器有哪些” 这几个角度来理解。
首先,判断一个对象是否该被回收,核心是看它「是否还能从 GC Roots 到达」。最经典的是 「可达性分析」:以 GC Roots(比如虚拟机栈里的局部变量、静态变量、常量等)为起点,遍历对象的引用链,如果某个对象从 GC Roots 出发不可达,就会被标记为可回收对象。比如方法里的局部变量,方法执行完后出栈,它引用的对象如果没有其他引用,就会被标记。
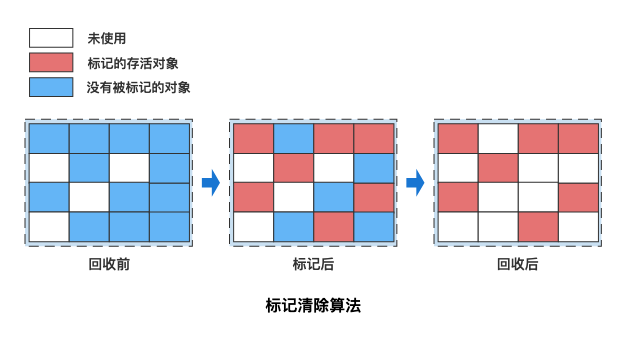
然后是具体的回收算法。最基础的有 “标记 - 清除”:先通过可达性分析标记存活对象,再清理没有被标记的对象。但这样会产生很多内存碎片,后续分配大对象时可能找不到连续空间。
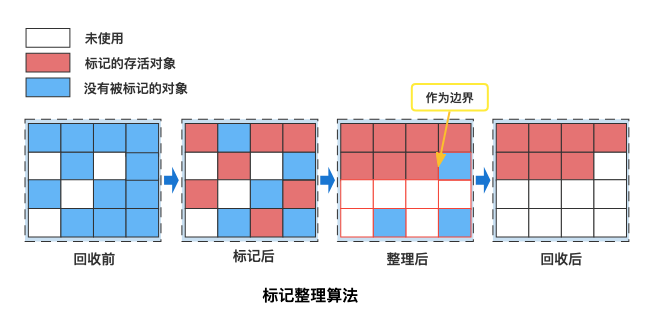
为了解决碎片问题,有 “标记 - 整理”:标记后不是直接清除,而是把存活对象往一端移动,然后清理边界外的内存,这样内存更整齐,但移动对象会有性能开销。
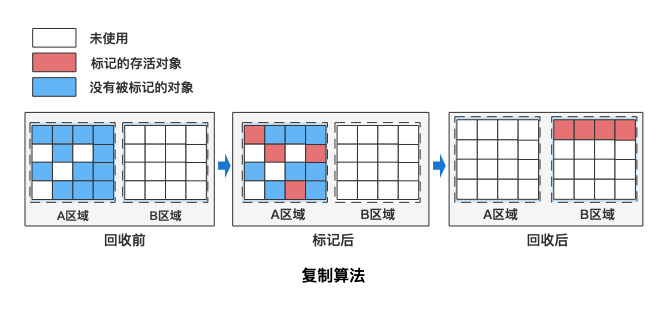
还有 “复制算法”:把内存分成两块,每次只用其中一块,回收时把存活对象复制到另一块,然后清空当前块。这种方式没有碎片,但会浪费一半内存,适合存活对象少的场景(比如新生代)。
在传统分代收集器中,通常会结合对象的代际使用这些算法。因为对象的生命周期不同,新生代(刚创建的对象)存活率低,老年代(存活久的对象)存活率高。新生代一般用 “复制算法”:分成 Eden 区和两个 Survivor 区(比如 8:1:1),新对象先放 Eden,满了就触发 Minor GC,把存活对象复制到一个 Survivor,多次存活后移到老年代。老年代用 “标记 - 清除” 或 “标记 - 整理”,因为对象存活率高,复制成本太高。
具体的垃圾回收器就是这些算法的实现,不同回收器适用场景不同。比如
- Serial GC 是单线程回收,实现简单,在小堆、CPU 资源有限的场景下也可以很高效;
- Parallel GC 多线程回收,注重吞吐量(单位时间内处理任务多);
- CMS追求低延迟,回收时大部分工作和用户线程并发执行,减少停顿时间,但会占用更多 CPU;
- G1则把内存分成多个区域,优先回收垃圾多的区域,平衡吞吐量和延迟,适合大内存场景。
- ZGC、Shenandoah 则把更多工作放到并发阶段,进一步降低停顿,适合对延迟敏感的应用;实际停顿仍然受版本、负载和运行环境影响。
总的来说,GC 机制的核心是 「自动管理内存」,通过可达性分析判断垃圾,结合分代思想和不同算法,再由具体的回收器实现,最终目的是在保证程序正常运行的前提下,高效释放内存,减少对用户线程的影响。
# 垃圾回收算法有哪些?
- 标记-清除算法:标记-清除算法分为“标记”和“清除”两个阶段,首先通过可达性分析标记存活对象,再统一回收没有被标记的对象。标记-清除算法有两个缺陷,一个是效率问题,标记和清除的过程效率都不高,另外一个就是,清除结束后会造成大量的碎片空间。有可能会造成在申请大块内存的时候因为没有足够的连续空间导致再次 GC。
- 复制算法:为了解决碎片空间的问题,出现了“复制算法”。复制算法的原理是,将内存分成两块,每次申请内存时都使用其中的一块,当内存不够时,将这一块内存中所有存活的对象复制到另一块上,然后再把已使用的内存整个清理掉。复制算法解决了空间碎片的问题。但是也带来了新的问题。因为每次在申请内存时,都只能使用一半的内存空间。内存利用率严重不足。
- 标记-整理算法:复制算法在 GC 之后存活对象较少的情况下效率比较高,但如果存活对象比较多时,会执行较多的复制操作,效率就会下降。而老年代的对象在 GC 之后的存活率就比较高,所以就有人提出了“标记-整理算法”。标记-整理算法的“标记”过程与“标记-清除算法”的标记过程一致,但标记之后不会直接清理。而是将所有存活对象都移动到内存的一端。移动结束后直接清理掉剩余部分。
- 分代收集思想:严格说,分代不是和前三种并列的具体回收动作,而是基于“多数对象很快死亡,少数对象长期存活”的特点,把对象划分为不同代,再选择适合的回收算法。新生代存活率低,常用复制;老年代存活率高,可以采用标记-清除或标记-整理。对象晋升年龄和具体策略由收集器决定,不能统一说都是固定 15 次 GC。
# 对象什么时候会进入老年代?
在传统分代收集器和 G1 中,常见情况主要有下面几种:
- 达到晋升年龄:对象在新生代回收后仍然存活,留在 Survivor 中时年龄会增加。达到收集器采用的晋升阈值后,就可能进入老年代。
-XX:MaxTenuringThreshold用来设置最大晋升年龄,但默认值和实际阈值与收集器有关。 - Survivor 放不下:一次 Young GC 后存活对象太多,Survivor 空间不足,部分对象可能提前晋升,不用等到最大年龄。
- 动态年龄判断:收集器可以根据各年龄对象占用的空间,动态降低实际晋升阈值,所以不是所有对象都会在 Survivor 中待满固定次数。
- 大对象直接分配:部分传统收集器有大对象预晋升策略,G1 的 Humongous 对象则直接按老年代对象分配。
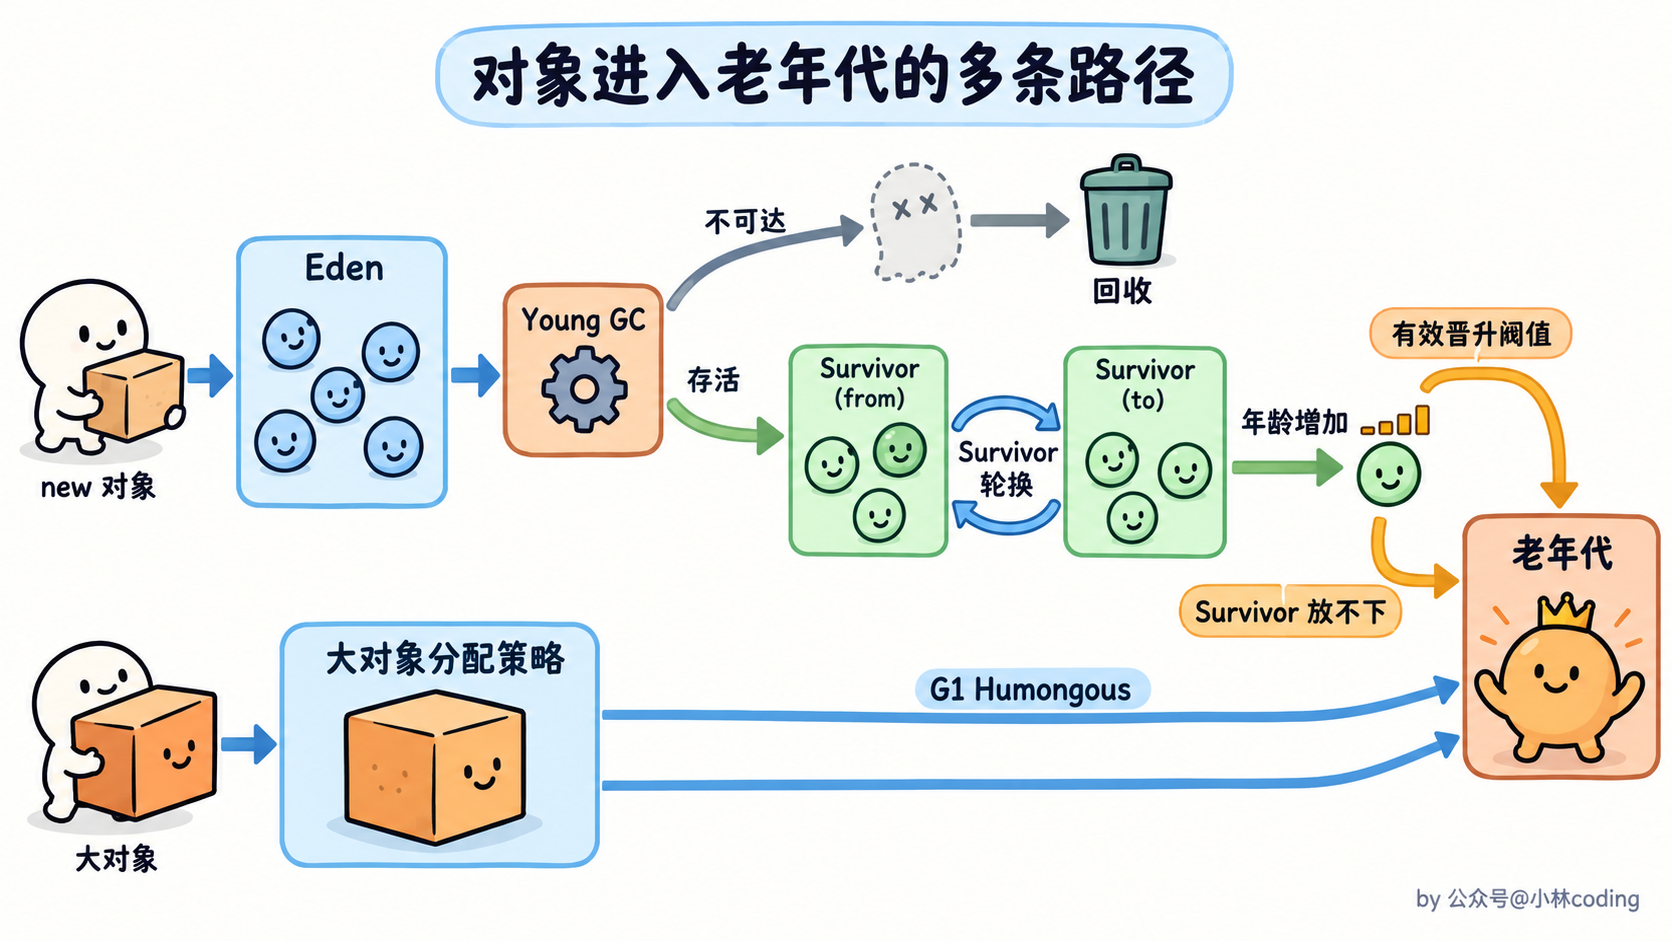
如果老年代增长很快,除了怀疑内存泄漏,还要看年轻代是不是过小、Survivor 是不是容纳不下存活对象,以及业务是不是频繁创建大对象。晋升快说明对象进入老年代快,不等于这些对象一定泄漏了。
# 垃圾回收器有哪些?
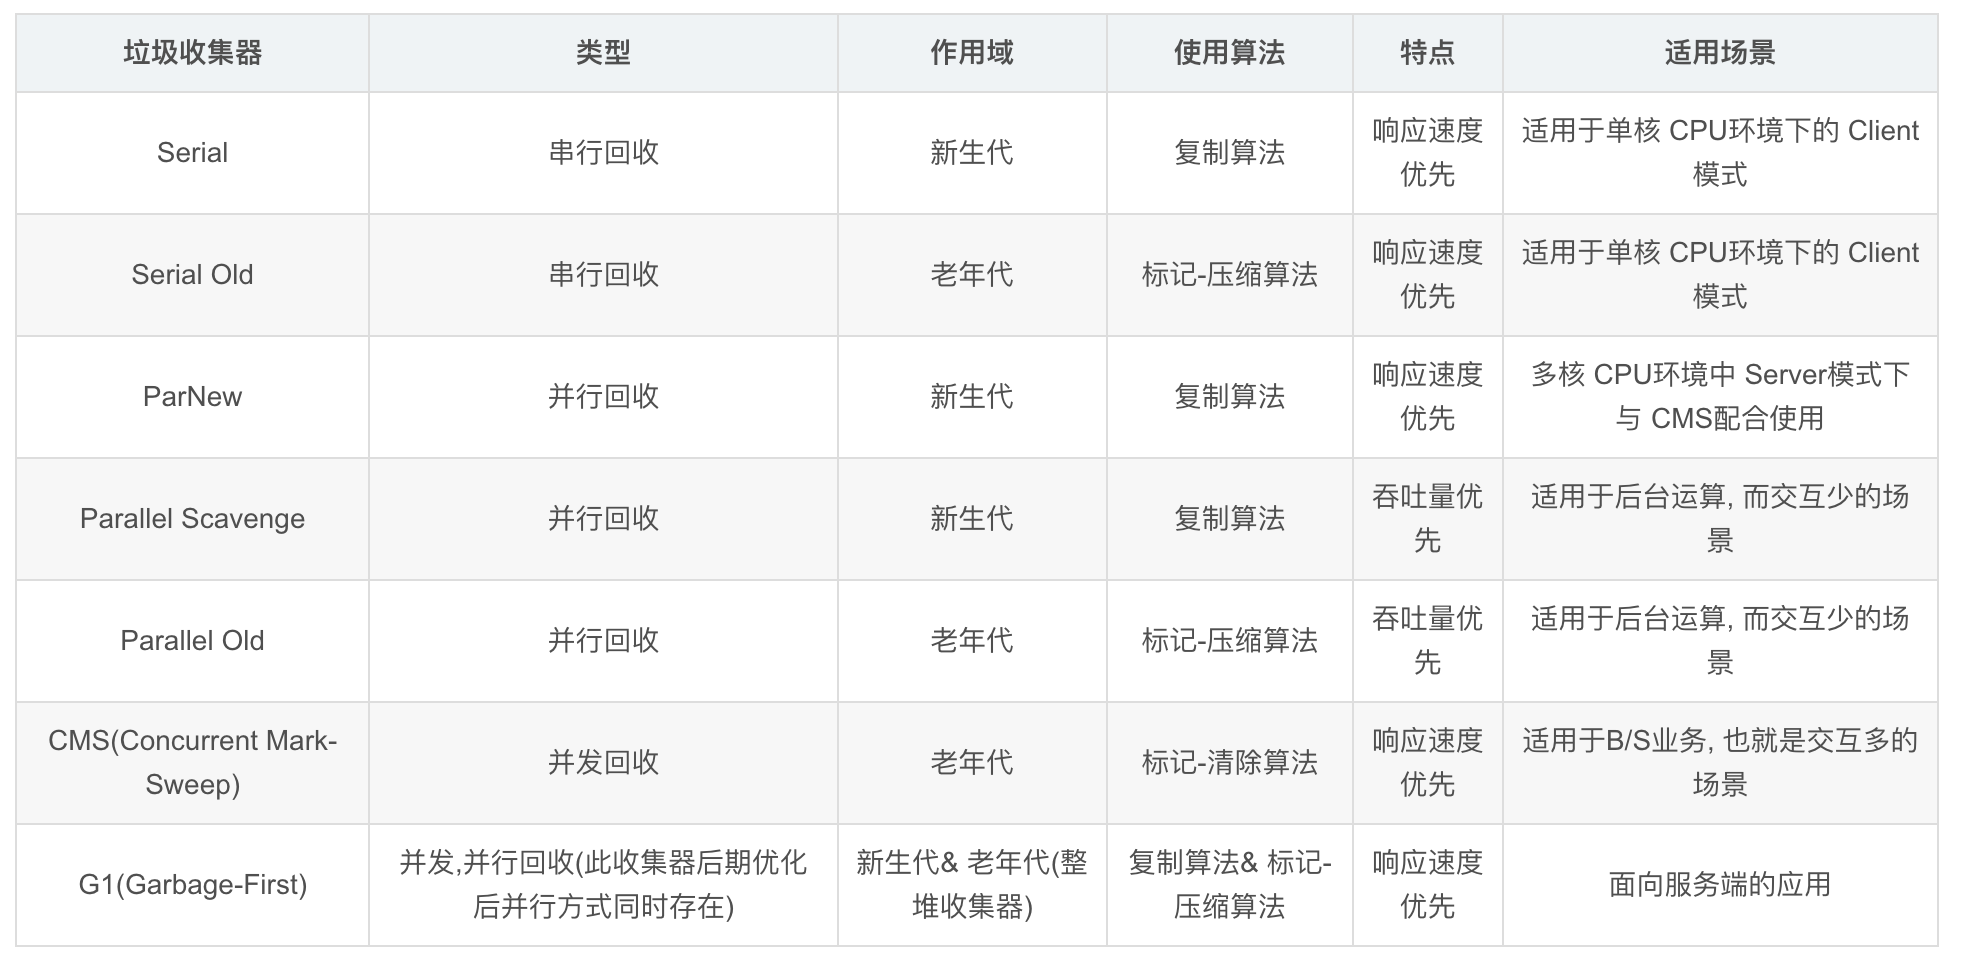
常见的垃圾回收器可以分为下面几类,图中的部分组合属于早期 JDK,回答时要带上版本背景:
- Serial / Serial Old:分别用于新生代和老年代,单线程执行回收。新生代使用复制算法,老年代使用标记-整理。实现简单,在小堆、CPU 资源有限的场景中有优势,回收时需要暂停应用线程。
- ParNew:新生代并行收集器,可以看作 Serial 的多线程版本,历史上常与 CMS 配合使用。随着 CMS 在 JDK 14 被移除,这个组合已经不能用于现代 HotSpot。
- Parallel Scavenge / Parallel Old:新生代和老年代的并行收集器,分别主要使用复制、标记-整理算法。重点追求吞吐量,适合后台计算、批处理等能够容忍一定停顿的场景。
- CMS(Concurrent Mark Sweep):老年代收集器,基于标记-清除,大部分工作可以和应用线程并发执行,目标是降低停顿。缺点是内存碎片、浮动垃圾,以及并发阶段对 CPU 的占用。JDK 9 废弃、JDK 14 从 HotSpot 移除,主要作为历史知识点理解。
- G1(Garbage First):覆盖整个堆,按 Region 管理,但仍然分代。常规回收时复制选中 Region 的存活对象,释放原 Region,减少碎片;同时根据停顿目标选择本次回收范围。JDK 9 起成为服务端配置下的默认收集器,兼顾吞吐量和停顿。
- ZGC:把标记、对象转移等主要工作并发化,追求很低的停顿时间。JDK 11 实验性引入、JDK 15 转为正式特性,JDK 21 引入可选的分代模式。它用染色指针和屏障等机制保证并发回收的正确性,低停顿是设计目标,不能理解成所有负载下都保证固定的延迟上限。
- Shenandoah:同样强调并发回收和低停顿,JDK 12 引入、JDK 15 转为正式特性。是否可用还要看所使用的 JDK 发行版,不是所有发行版都包含它。
面试时不必只背名字,可以说清它们的侧重点:Parallel 更关注吞吐量,G1 追求吞吐量与停顿的平衡,ZGC、Shenandoah 更关注低停顿。 最终选哪一个,还要结合 JDK 版本、堆大小、CPU 资源和业务的延迟要求。
# 标记清除算法的缺点是什么?
主要缺点有两个:
- 一个是效率问题,标记和清除过程的效率都不高;
- 另外一个是空间问题,标记清除之后会产生大量不连续的内存碎片,空间碎片太多可能会导致,当程序在以后的运行过程中需要分配较大对象时无法找到足够的连续内存而不得不提前触发另一次垃圾收集动作。
# 垃圾回收算法哪些阶段会stop the world?
哪些阶段需要 Stop The World(STW),主要取决于收集器怎么实现,不能只根据算法名字判断。 同样是对象复制,G1 的常规转移需要停顿,ZGC、Shenandoah 则可以把主要转移工作并发化。
STW 的意思是 JVM 暂停执行 Java 代码的应用线程,让它们不能继续修改相关对象图。它不等于“GC 只用一个线程”,多个 GC 工作线程仍可以并行回收。
常见收集器可以这样理解:
- Serial、ParNew、Parallel 系列:主要回收工作在 STW 期间完成。其中 ParNew、Parallel 是多个 GC 线程一起回收,但应用线程仍然暂停。
- CMS:初始标记和重新标记需要 STW,并发标记、并发清除可以与应用线程一起运行。
- G1:Young GC 和 Mixed GC 中的对象转移需要 STW;并发标记主要和应用一起运行,但启动标记、Remark、Cleanup 等环节有停顿。
- ZGC、Shenandoah:把标记、转移等主要工作放到并发阶段,仍保留必要的短暂停顿,不能说它们完全没有 STW。
下面以 G1 为例来理解:
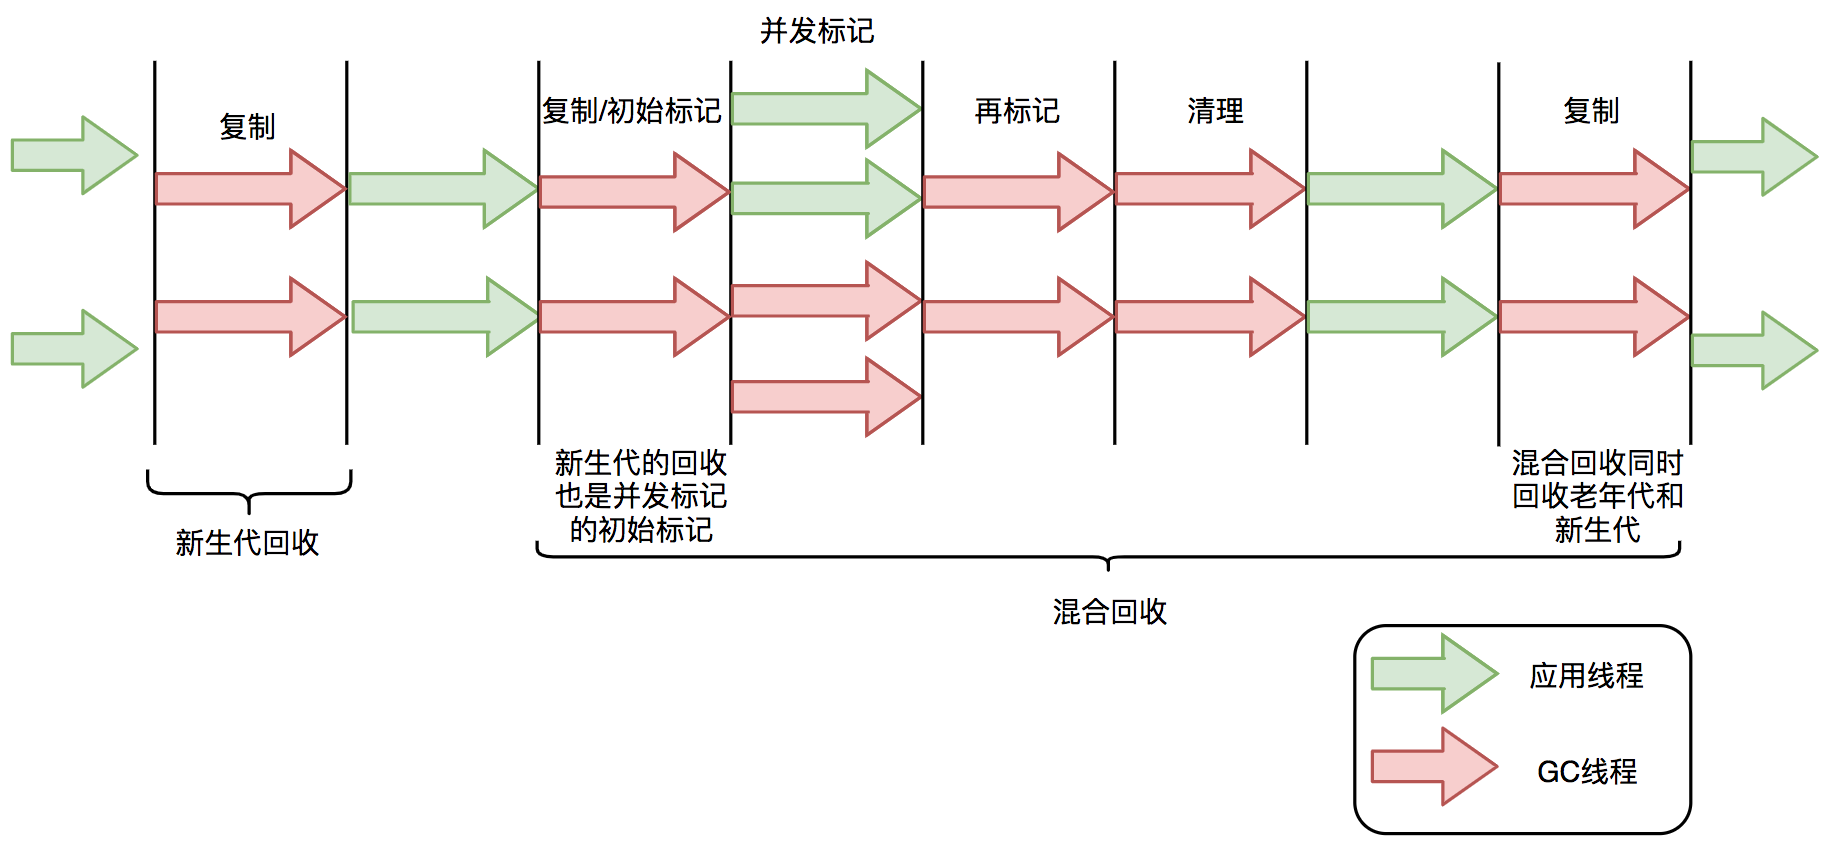
- 启动并发标记:通常借一次 Young GC 的停顿完成初始标记,建立本轮标记的起点。
- 并发标记:GC 线程与应用线程一起运行,统计存活情况。这个阶段虽然不长时间暂停应用,但仍会占用 CPU,不能认为对业务完全没有影响。
- Remark(重新标记):暂停应用,处理并发标记期间记录的信息,完成标记和相关处理。耗时取决于剩余工作量,不是一定很短。
- Cleanup(清理):完成本轮存活统计和回收候选集合的相关处理,其中有短暂停顿,也有工作可以并发完成,具体细节随 JDK 版本变化。
- Mixed GC:在多次 STW 中,回收年轻代和选中的部分老年代 Region,复制存活对象并更新引用。
排查 G1 停顿时,常见开销包括根和跨 Region 引用扫描、存活对象复制、引用处理等。不能只凭“G1 用复制算法”,就断言每次都是对象复制最慢,要看 GC 日志里各阶段的耗时。
# 什么是安全点?为什么 GC 要等线程到达安全点?
安全点(Safepoint)可以理解为JVM 能够安全观察线程状态的位置。在这里,JVM 能确定线程正在使用哪些对象引用,保证进行全局操作时不会漏掉存活对象。
比如进行需要 STW 的 GC 时,如果直接在任意机器指令处把线程停下来,局部变量和寄存器里的引用不一定容易准确识别。因此 JVM 会让执行 Java 代码的线程到达可安全处理的位置,再开始相关操作。对于阻塞或执行本地代码的线程,也有相应的状态协调机制,不是必须让所有线程先回到 Java 代码里。
面试里可以把一次停顿分成两部分理解:等待线程进入安全状态的时间,以及真正执行 GC 等操作的时间。 如果到达安全点的时间很长,即使 GC 工作本身不多,业务也可能出现明显卡顿。
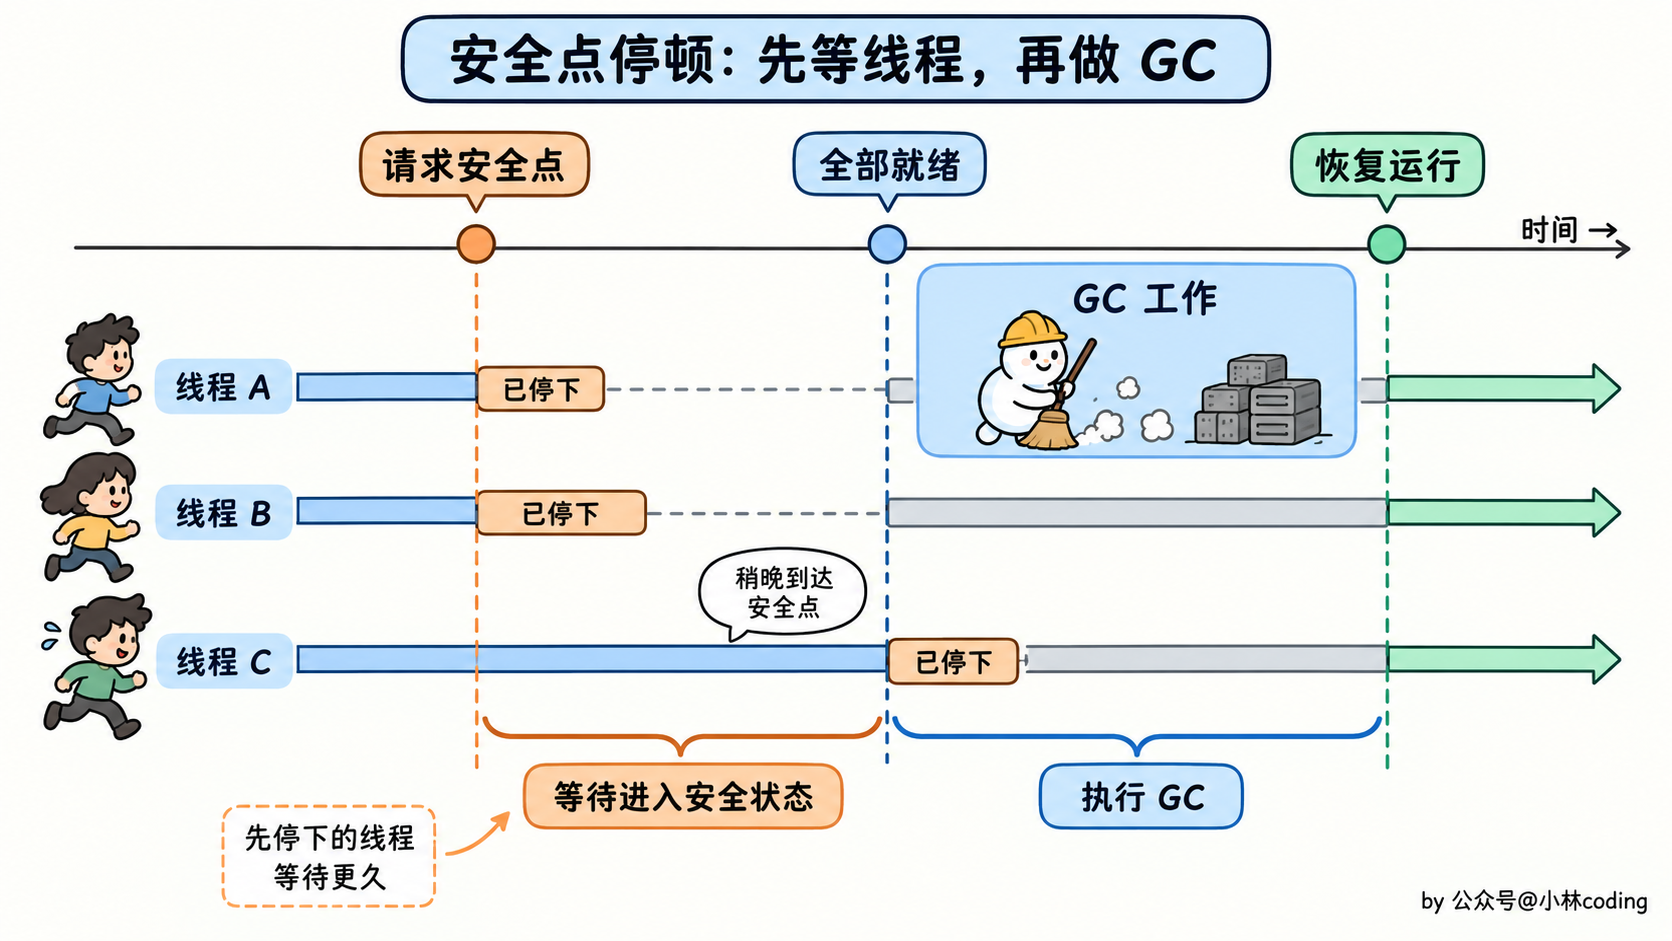
安全点也不只服务于 GC,某些类重定义、全局状态检查等操作也可能用到它。排查时可以结合 safepoint 日志,区分到底是“等线程停下来慢”,还是“停下来之后回收慢”。
# minorGC、majorGC、fullGC的区别,什么场景触发full GC
可以先按回收范围区分,但要注意:Major GC 这个名字在不同资料、不同收集器里含义不完全一致,不能把它直接当成 Full GC 的同义词。
Minor GC / Young GC
主要回收年轻代。传统分代收集器中,Eden 空间不足时通常触发,将存活对象复制到 Survivor 或晋升到老年代。它不以回收老年代为主要目标,但对象晋升仍会影响老年代占用,也需要处理来自老年代的引用。
Major GC / Old GC
通常用来描述以老年代为主要目标的回收,比如 CMS 的老年代收集周期。但这个名称不够统一,面试时最好说清具体是哪一种收集器、回收了哪些区域。
Mixed GC
这是 G1 的常见概念:一次回收年轻代,以及选中的部分老年代 Region。它会暂停应用线程,但没有回收整个堆,所以不是 Full GC。
Full GC
通常指对整个 Java 堆进行的完整回收,常见 HotSpot 收集器的这类兜底回收需要 STW,停顿开销可能较大。期间可能伴随类卸载,但元空间是否实际释放,还要看哪些类可以卸载和相关配置。类卸载也不一定只能在 Full GC 时发生。
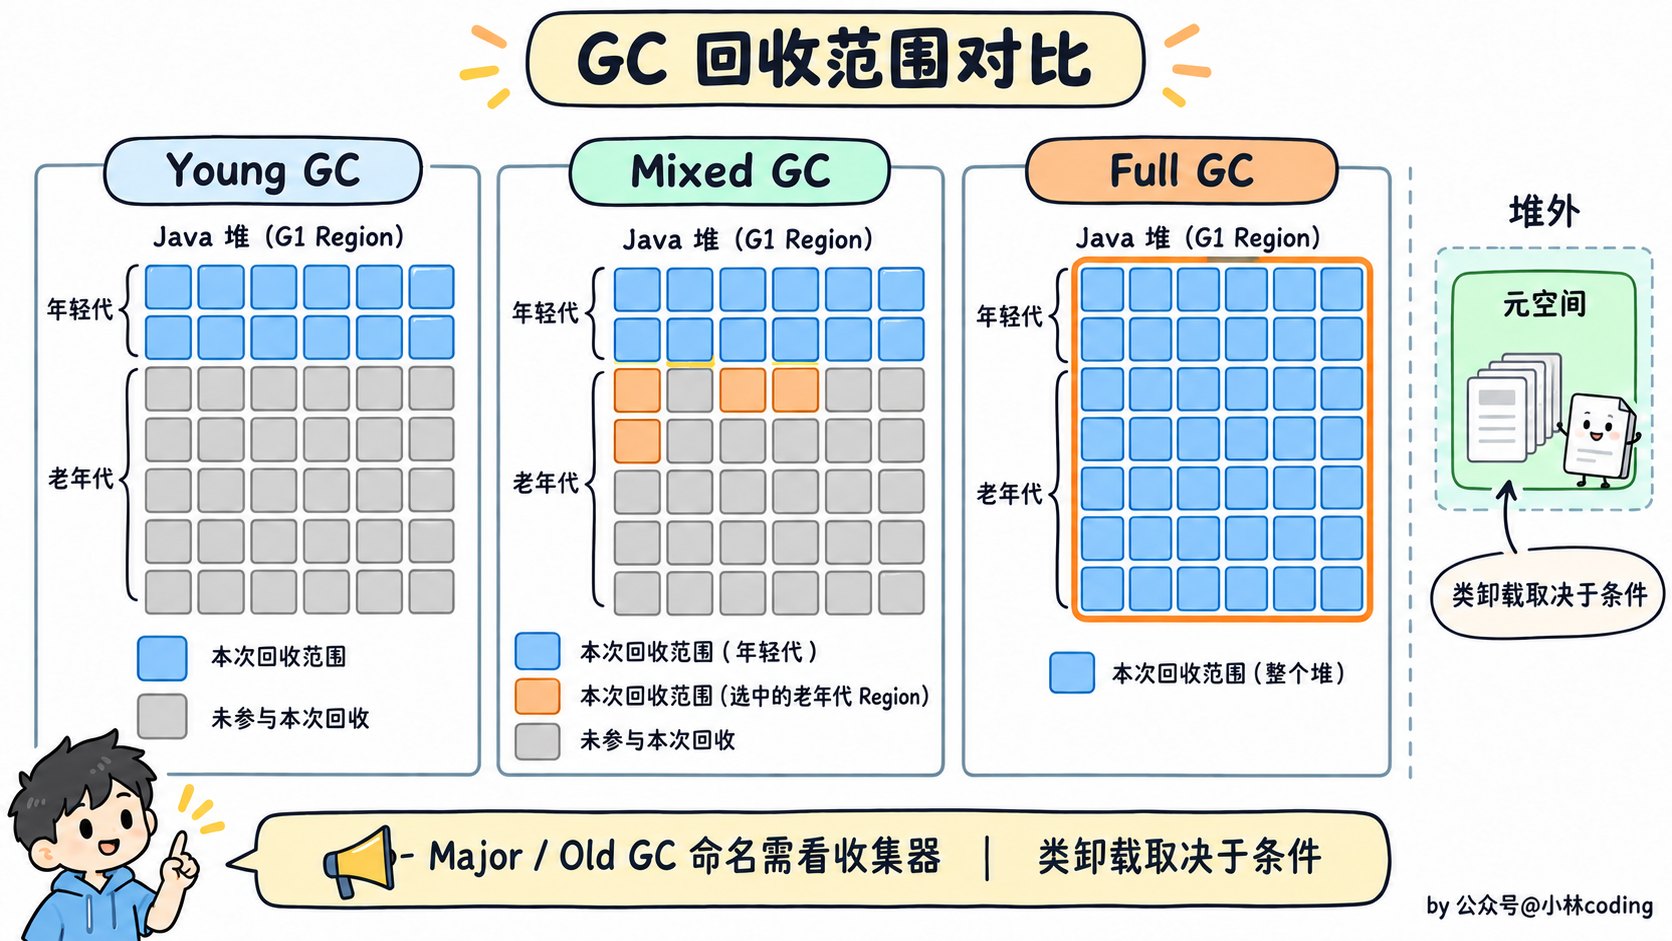
常见触发场景有:
- 老年代分配或晋升失败:回收后仍没有足够空间,收集器可能执行 Full GC 尝试腾出空间。具体策略由收集器决定,不能把早期的空间分配担保检查当成所有 JVM 的统一流程。
- G1 回收跟不上分配:并发标记来不及完成、可用 Region 不足,或者无法找到足够连续的 Region 分配 Humongous 对象时,可能进入 Full GC。转移失败可能出现在它之前,但并不是每次转移失败都会立刻 Full GC。
- CMS 并发失败:老年代在并发回收完成前被填满,出现 Concurrent Mode Failure 等情况时,可能退回停顿式的老年代回收。这个属于旧版本 CMS 的场景。
- 元空间压力:JVM 可能触发回收尝试卸载类,但具体表现可能是并发周期,也可能是 Full GC,要看收集器和配置。
- 显式回收请求:
System.gc()在某些配置下会触发 Full GC,也可能被-XX:+DisableExplicitGC忽略,或者在支持的收集器上通过-XX:+ExplicitGCInvokesConcurrent请求并发回收。
所以排查时不要只看“Full GC 次数”,还要看 GC 日志中的回收原因、回收前后的占用和停顿时间,确认是容量不足、对象泄漏、大对象分配,还是代码或工具主动发起的回收。
# 垃圾回收器 CMS 和 G1的区别?
区别一:回收范围和堆布局不同
- CMS 主要回收老年代,历史上通常配合 ParNew 回收新生代,采用传统的分代布局。
- G1 管理整个堆,把堆划成多个 Region,但仍保留 Eden、Survivor、Old 的逻辑分代,不需要再搭配另一个年轻代收集器。
区别二:回收算法和碎片情况不同
- CMS 基于标记-清除,回收后容易留下不连续的空闲空间,分配大对象时可能受到碎片影响。
- G1 的常规回收把选中 Region 中的存活对象复制到其他 Region,再释放原 Region,能够减少碎片。但 Humongous 对象需要连续 Region,依然可能遇到碎片或空间浪费,不能说“G1 完全没有碎片”。
区别三:停顿目标和回收方式不同
- CMS 通过并发标记、并发清除减少老年代回收的停顿,但不能根据一个停顿目标灵活选择本次老年代回收范围。
- G1 会估算不同 Region 的回收收益和耗时,根据
-XX:MaxGCPauseMillis选择本次回收集合。但这是尽量满足的目标,不是每次都不能超过的硬性上限。
区别四:并发阶段与对象转移不同
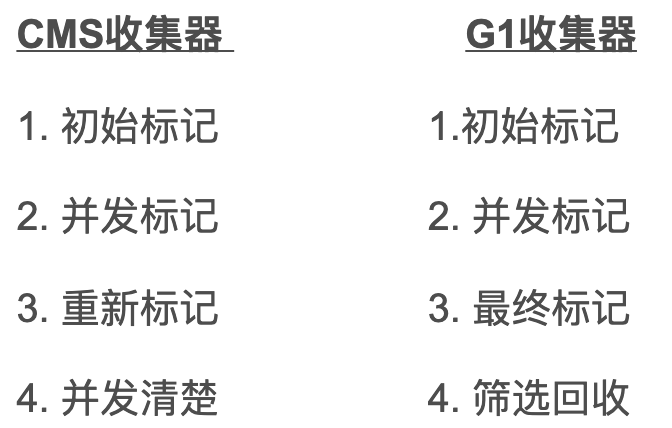
CMS 的常规老年代周期主要是“初始标记、并发标记、重新标记、并发清除”。G1 则通过并发标记获得老年代存活信息,之后用多次 Mixed GC 回收部分老年代。上图是简化流程,不能理解成 G1 每一轮 Young GC 都必须先完整标记一次老年代。
区别五:失败时的兜底方式不同
- CMS 和 G1 都可能存在浮动垃圾,也都需要给并发阶段的对象分配留空间。CMS 如果回收赶不上分配,可能发生 Concurrent Mode Failure,退回停顿式回收;不是只要出现浮动垃圾就立刻退化。
- G1 如果空间回收跟不上分配,也可能出现转移失败,最终进入自己的 Full GC。G1 不会切换成 Serial Old 收集器,而且从 JDK 10 起,G1 的 Full GC 已支持并行执行,但仍会暂停应用。
还有版本区别:CMS 已在 JDK 14 从 HotSpot 中移除,现在讨论新项目选择时,通常应比较 G1、Parallel、ZGC 等仍可用的收集器。
# 什么情况下使用CMS,什么情况使用G1?
这个问题要先带上 JDK 版本。CMS 在 JDK 14 已被移除,所以在现代 HotSpot 中,不能再把它当作一个可用的新项目选项。
在旧版 JDK 8 应用中,CMS 曾适用于对响应时间敏感、希望减少老年代停顿的服务。但它需要考虑 CPU 开销、碎片和并发失败风险,堆快满时可能出现很长的停顿。
G1 适合希望在吞吐量和停顿之间取得平衡的服务,尤其是堆较大、对象分配与晋升速率会变化的场景。它通过 Region 管理和分批回收老年代,更容易控制单次回收的工作量。
如果是批处理或计算任务,更看重单位时间完成多少工作,也可以评估 Parallel GC;如果业务对延迟特别敏感,G1 停顿仍达不到要求,可以评估 ZGC 或发行版支持的 Shenandoah。
最后还是要用业务负载压测,看吞吐量、P99 响应时间、GC 停顿、CPU 占用和内存开销。不能只根据“堆比较大”或“某个收集器比较新”,就认定它一定更合适。
# G1回收器的特色是什么?
G1 最核心的特点是:用 Region 管理堆,在保留分代的基础上,根据回收收益和停顿目标分批回收。
可以从下面几个方面来回答:
- Region 布局:堆被划分成多个等大的 Region,Region 可以承担 Eden、Survivor、Old 等角色,角色会随着运行发生变化。年轻代和老年代不用分别占据一整块连续空间。
- 优先回收收益高的区域:并发标记后,G1 可以知道老年代 Region 的存活情况,结合回收成本选择候选区域。不是每次只按“垃圾最多”排序,还要考虑复制存活对象等开销。
- 停顿目标:通过
-XX:MaxGCPauseMillis设置期望停顿时间,G1 根据历史统计调整年轻代大小和回收集合。它会尽量满足目标,但无法保证每次都不超时;目标太激进还可能增加回收频率、降低吞吐量。 - 减少碎片:常规回收通过复制存活对象,释放整个源 Region。它能改善普通对象的碎片问题,但大对象需要连续 Region,仍可能带来空间浪费和分配失败。
- 并行与并发结合:并发标记与应用一起运行,Young GC、Mixed GC 的转移阶段则暂停应用,由多个 GC 线程并行完成。
所以 G1 “可预测停顿”的关键,是预测本次工作量并选择回收范围,不是把所有阶段都变成并发,也不是设置一个参数就能彻底避免长停顿。
# G1 的 Young GC、并发标记和 Mixed GC 是什么关系?
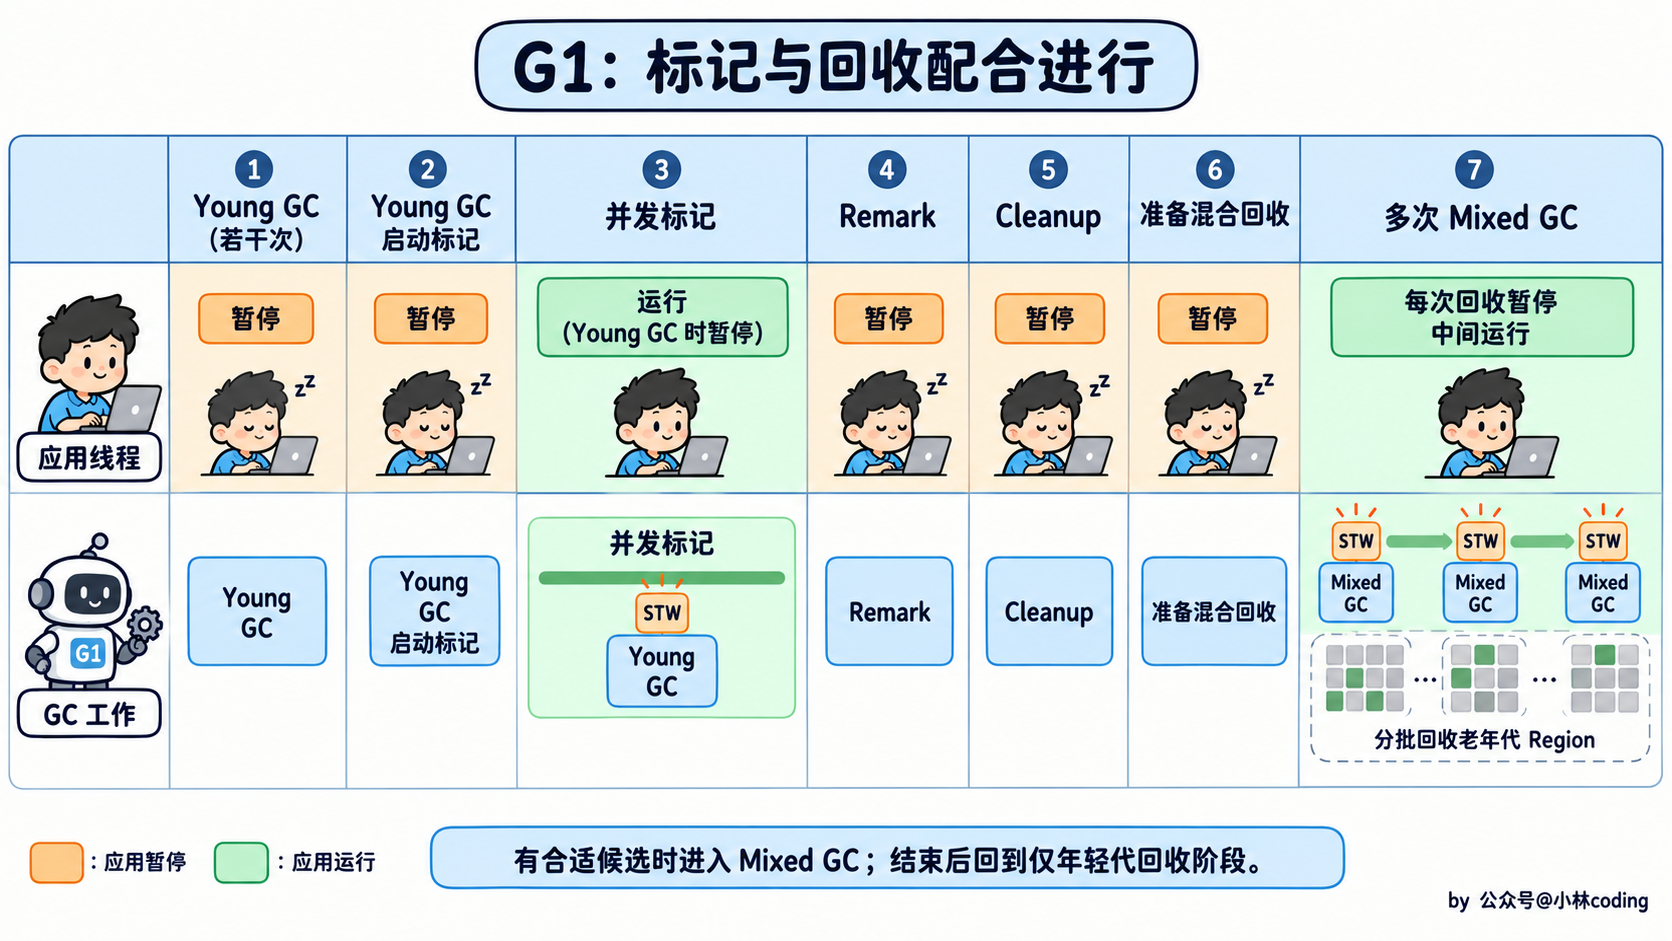
它们不是三种互相替代的回收方式,而是 G1 在运行过程中配合使用的不同环节。
刚开始主要进行 Young GC,回收 Eden 和 Survivor,存活对象继续留在 Survivor 或晋升到老年代。这个过程不需要每次都先完整标记老年代。
当 G1 判断老年代需要开始准备回收时,会借一次 Young GC 的停顿启动并发标记。并发标记主要是获得老年代 Region 的存活信息,帮助决定哪些区域值得回收;标记期间,Young GC 仍然可能发生。
标记结束并完成 Remark、Cleanup 等处理后,如果有值得回收的老年代区域,G1 就进入混合回收阶段。通过多次 Mixed GC,每次回收年轻代和部分老年代 Region,避免一次把整个老年代都处理完。
所以可以按“Young GC 处理年轻代 → 并发标记获取老年代存活信息 → 多次 Mixed GC 逐步回收部分老年代”来记。Mixed GC 仍然需要 STW,它也不是 Full GC。
# Young GC 为什么不用扫描整个老年代?
因为年轻代里的对象,可能被老年代对象引用。如果 Young GC 只扫描线程栈等根引用,不考虑这些跨代引用,就可能把仍然存活的对象误回收。
但每次都遍历整个老年代,代价又太高。因此 JVM 会维护一些辅助记录,记住哪些老年代区域可能有指向年轻代的引用。
传统分代收集器常使用卡表(Card Table):把堆划成较小的块,也就是 Card。修改对象引用时,通过写屏障记录相关 Card 的变化,GC 再扫描这些可能存在跨代引用的位置。
G1 还会维护 Remembered Set(记忆集),帮助找到其他 Region 指向当前回收集合的引用,不必为每次局部回收都扫描整个堆。
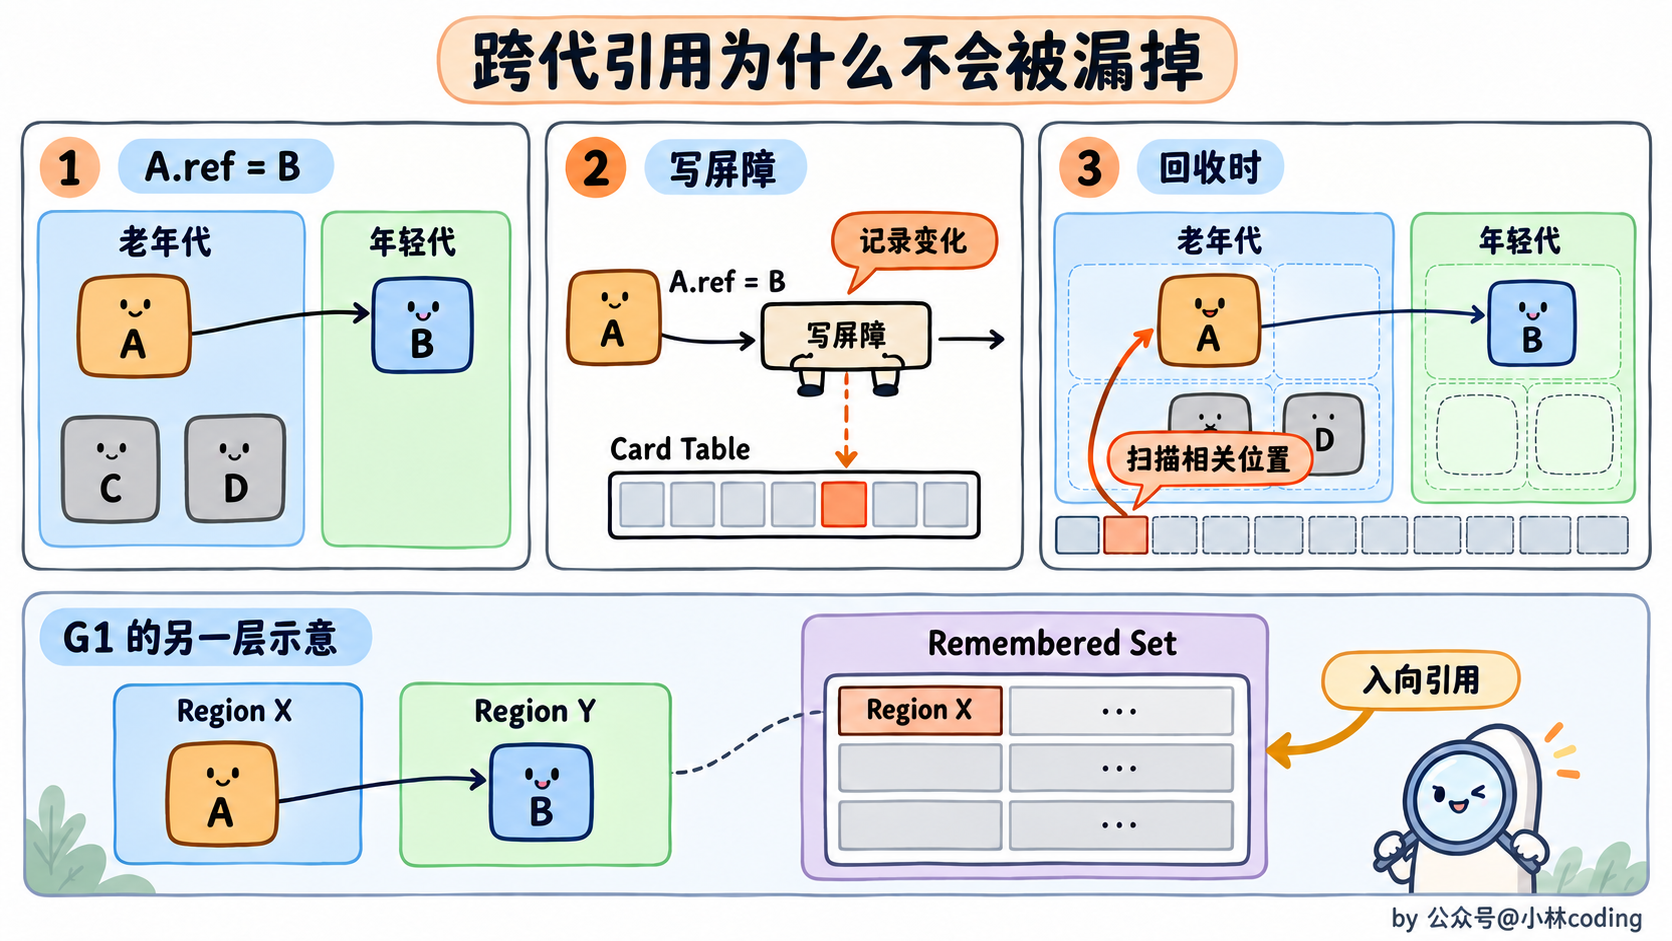
这里的“写屏障”是 JVM 在写入引用时插入的辅助逻辑,和 JMM 中用于保证内存可见性、有序性的内存屏障不是同一个概念。它减少了局部回收的扫描范围,但维护记录和扫描这些引用本身也有开销。
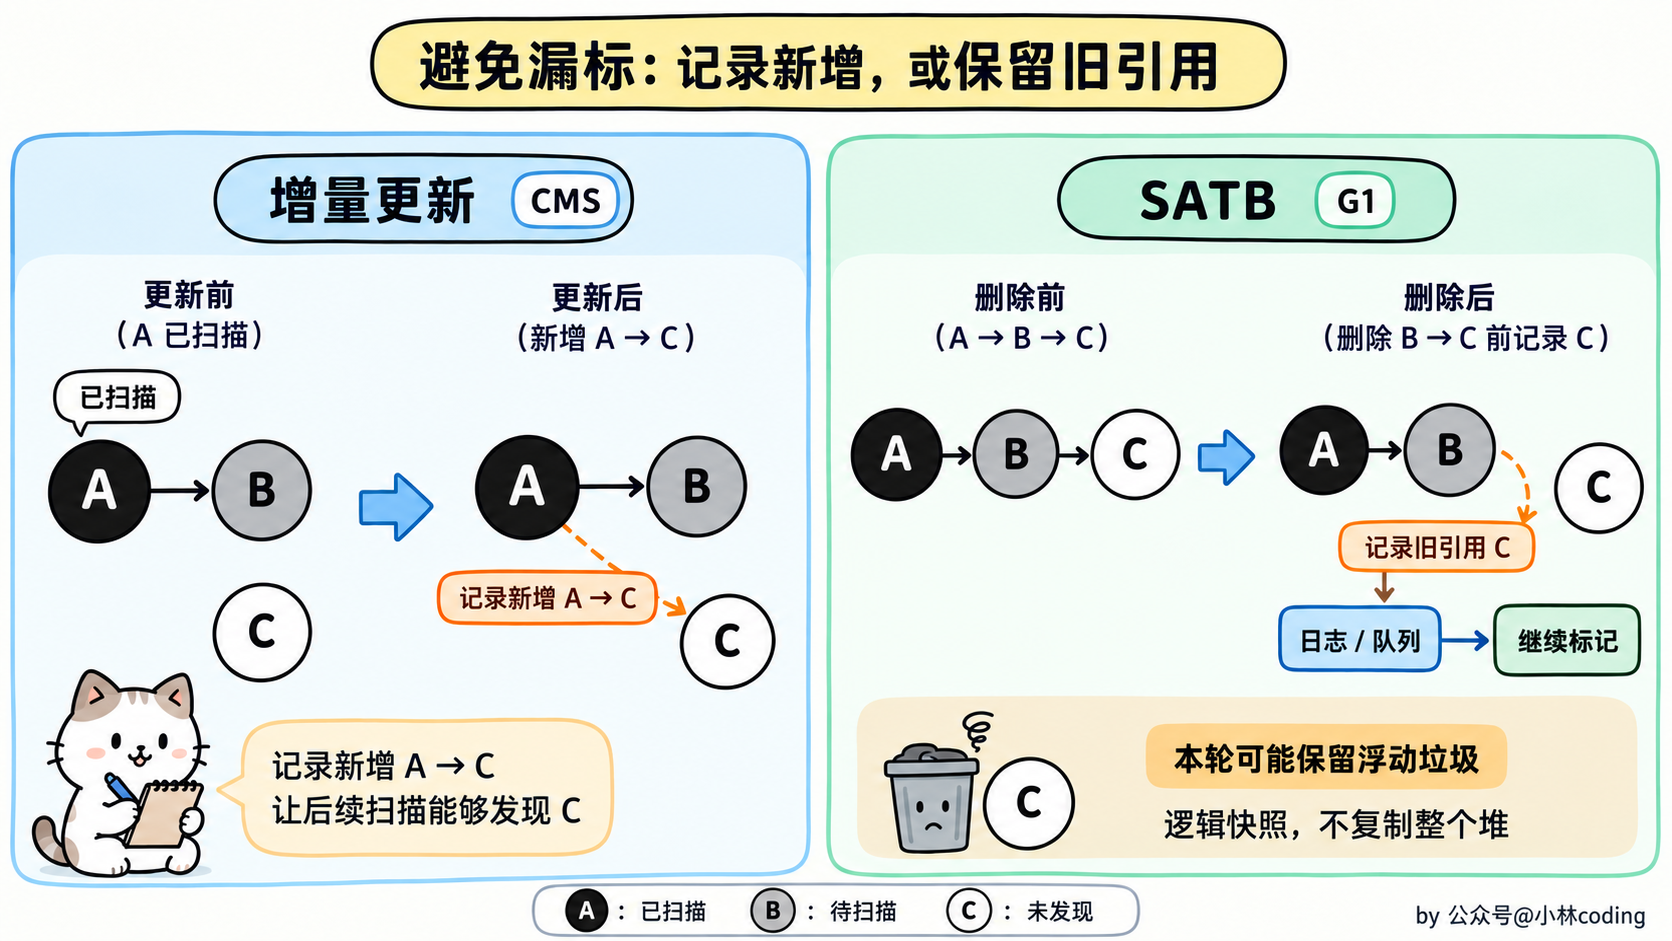
# 并发标记时,应用还在修改引用,怎么避免漏标?
问题就在于:GC 线程一边找存活对象,应用线程一边改变对象之间的引用。如果没有额外处理,GC 可能漏掉仍然活着的对象。
可以用三色标记来帮助理解:白色表示还没发现,灰色表示发现了但引用还没扫描完,黑色表示自身和它的引用已经扫描完。颜色是逻辑上的分类,不一定真的写在对象里。
比如应用让一个已经扫描完的黑色对象指向某个白色对象,同时又断开了 GC 原本可以继续追踪到这个白色对象的路径,GC 就有可能漏掉它。收集器需要通过屏障记录这类变化,再补充处理。
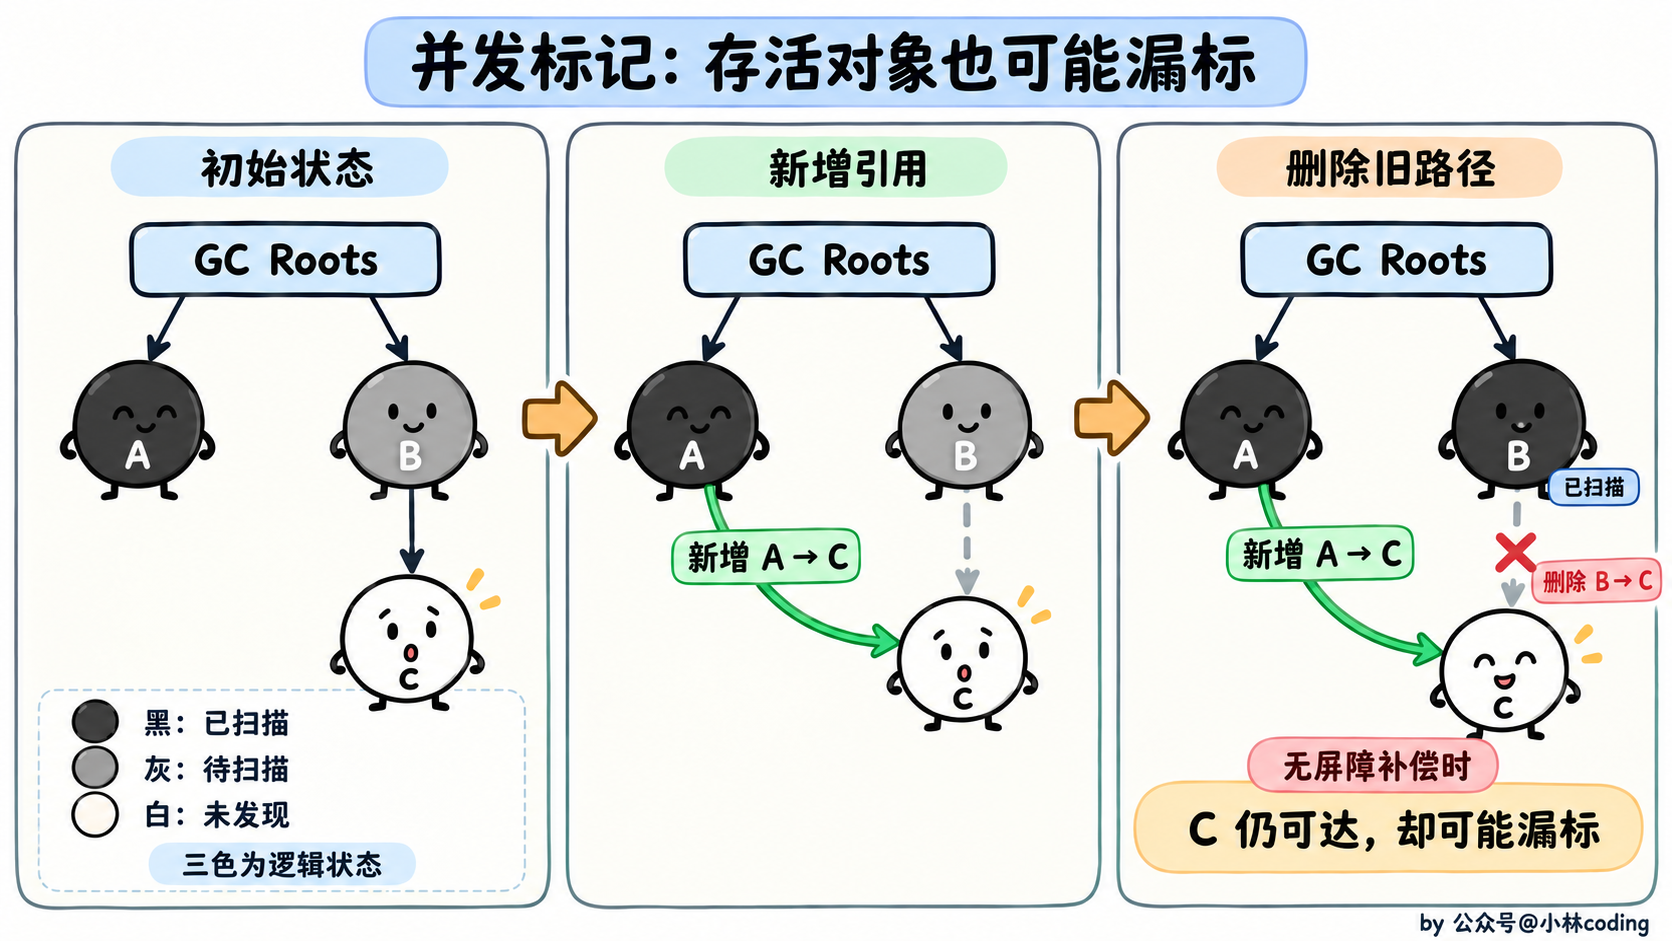
常见思路有两种:
- 增量更新:重点记录新增的引用关系,避免已扫描对象新增的引用被遗漏。CMS 使用这种思路。
- SATB(Snapshot At The Beginning):按标记开始时的对象图判断存活,引用被覆盖或删除时,把旧引用记录下来,后续继续追踪,避免原来的路径丢失。G1 使用这种思路。
SATB 不是把整个堆复制一份,而是用记录来维持“开始时的存活视图”。对象后来即使已经变成垃圾,本轮也可能保守地保留,形成浮动垃圾,留到后续回收。
# G1 和 ZGC 有什么区别?
两者都支持并发工作,但侧重点不同:G1 更关注吞吐量和停顿之间的平衡,ZGC 更强调把停顿压低。
- 对象转移:G1 的 Young GC、Mixed GC 在 STW 期间复制存活对象,存活对象多时,复制和引用处理会影响停顿。ZGC 则把主要的对象转移工作与应用线程并发执行,减少停顿中的工作量。
- 正确性保障:两者都需要屏障等机制处理应用与 GC 的协作。ZGC 使用染色指针和相关屏障,在对象可能已经移动时,仍让应用能访问到正确位置;分代 ZGC 还需要维护跨代引用等信息。
- 资源取舍:并发回收仍然要消耗 CPU,也需要为回收期间的新分配预留空间。低停顿不等于没有开销,不能直接说 ZGC 的吞吐量一定比 G1 高或低。
- 版本差异:以 JDK 21 为例,
-XX:+UseZGC启用 ZGC,额外使用-XX:+ZGenerational可以启用该版本的分代模式。其他版本的默认模式和参数可能不同,不能照搬。
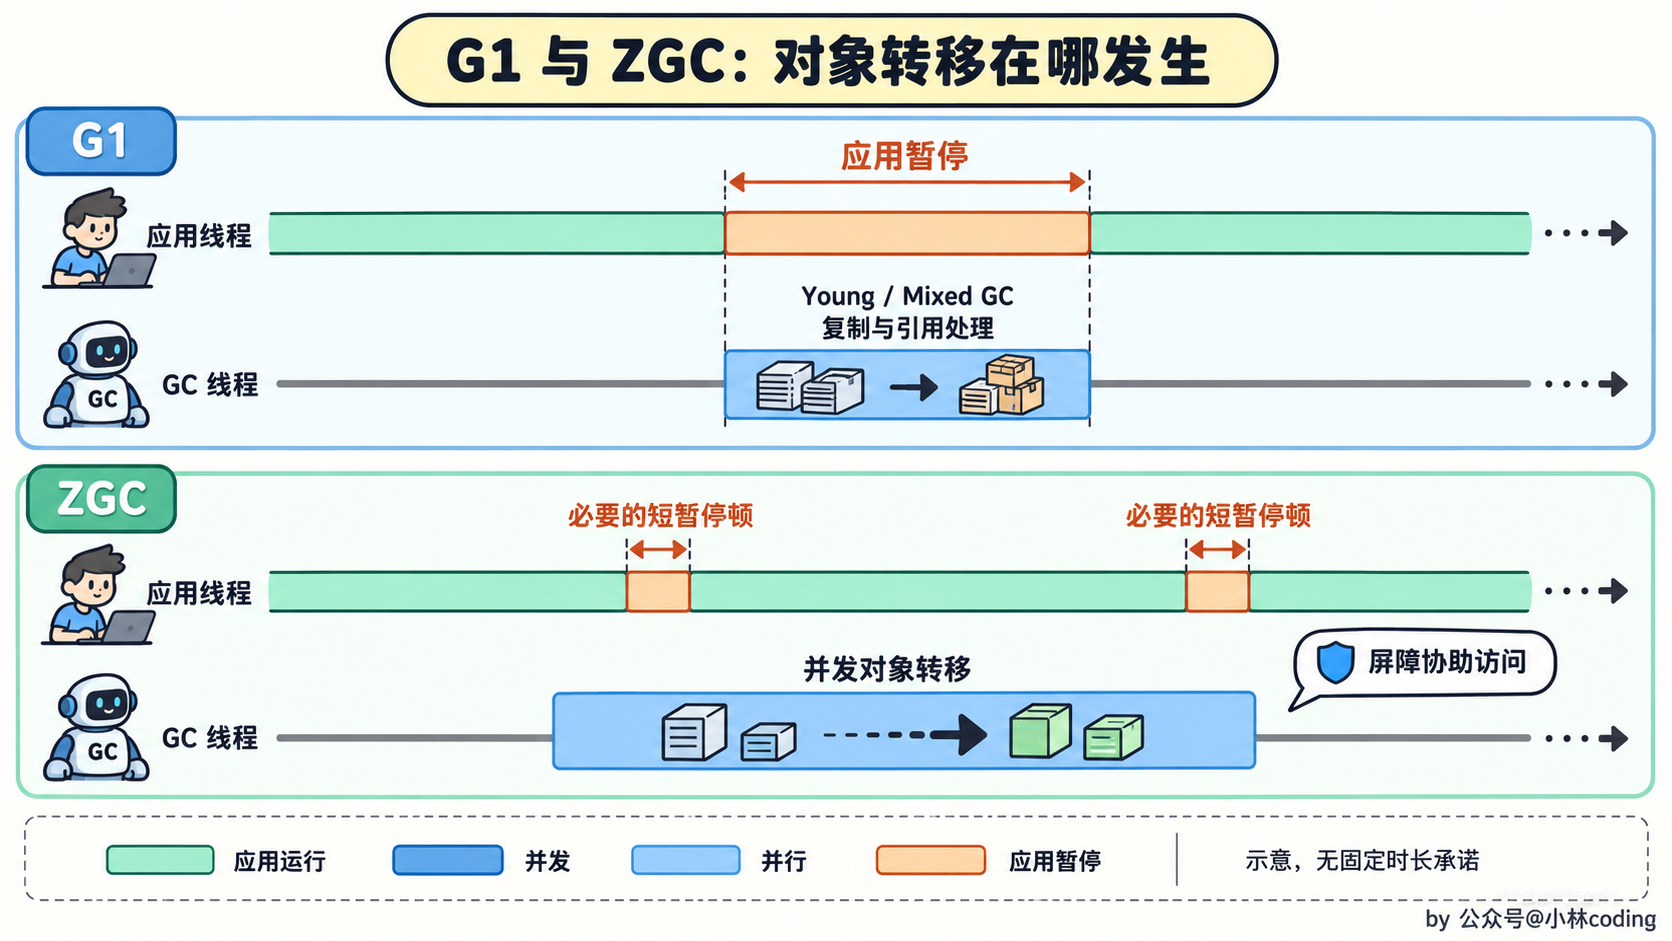
选择时主要看业务对 GC 停顿是否敏感。如果 G1 已经满足延迟要求,可以继续使用;如果 P99 延迟经常受到 GC 停顿影响,就值得在相同负载下评估 ZGC,同时比较 CPU、吞吐量和内存占用。
# GC只会对堆进行GC吗?
不只。堆是 GC 回收对象的主要区域,但 JVM 也可以在符合条件时卸载类,释放元空间中的类元数据。
- 堆中的对象:通过可达性分析等机制判断是否需要保留,再由具体收集器回收。
- 类元数据:普通类的实例、Class 对象和定义它的类加载器整体不再可达,并满足相应条件时,才可能卸载。并不是一轮 GC 后没有实例,就一定卸载这个类;类卸载也不一定只发生在 Full GC。
- 字符串常量池中的对象:现代 HotSpot 中驻留字符串本身在堆上,不再被使用的字符串也可能回收,不能认为进了常量池就永远活着。
直接内存也经常被追问。DirectByteBuffer 的 Java 包装对象在堆里,其本地内存可能由 Cleaner 等机制在对象不可达后安排释放,但这不是 GC 像管理堆对象一样直接扫描所有堆外资源,释放也未必及时。
所以文件、连接和框架管理的堆外缓冲区,仍应按接口约定主动关闭或释放。像 Netty 的引用计数缓冲区,还要遵守它自己的 release() 规则,不能单纯等 JVM 的 GC。
# 执行与性能排查
# JVM 为什么既有解释器,又有 JIT 编译器?
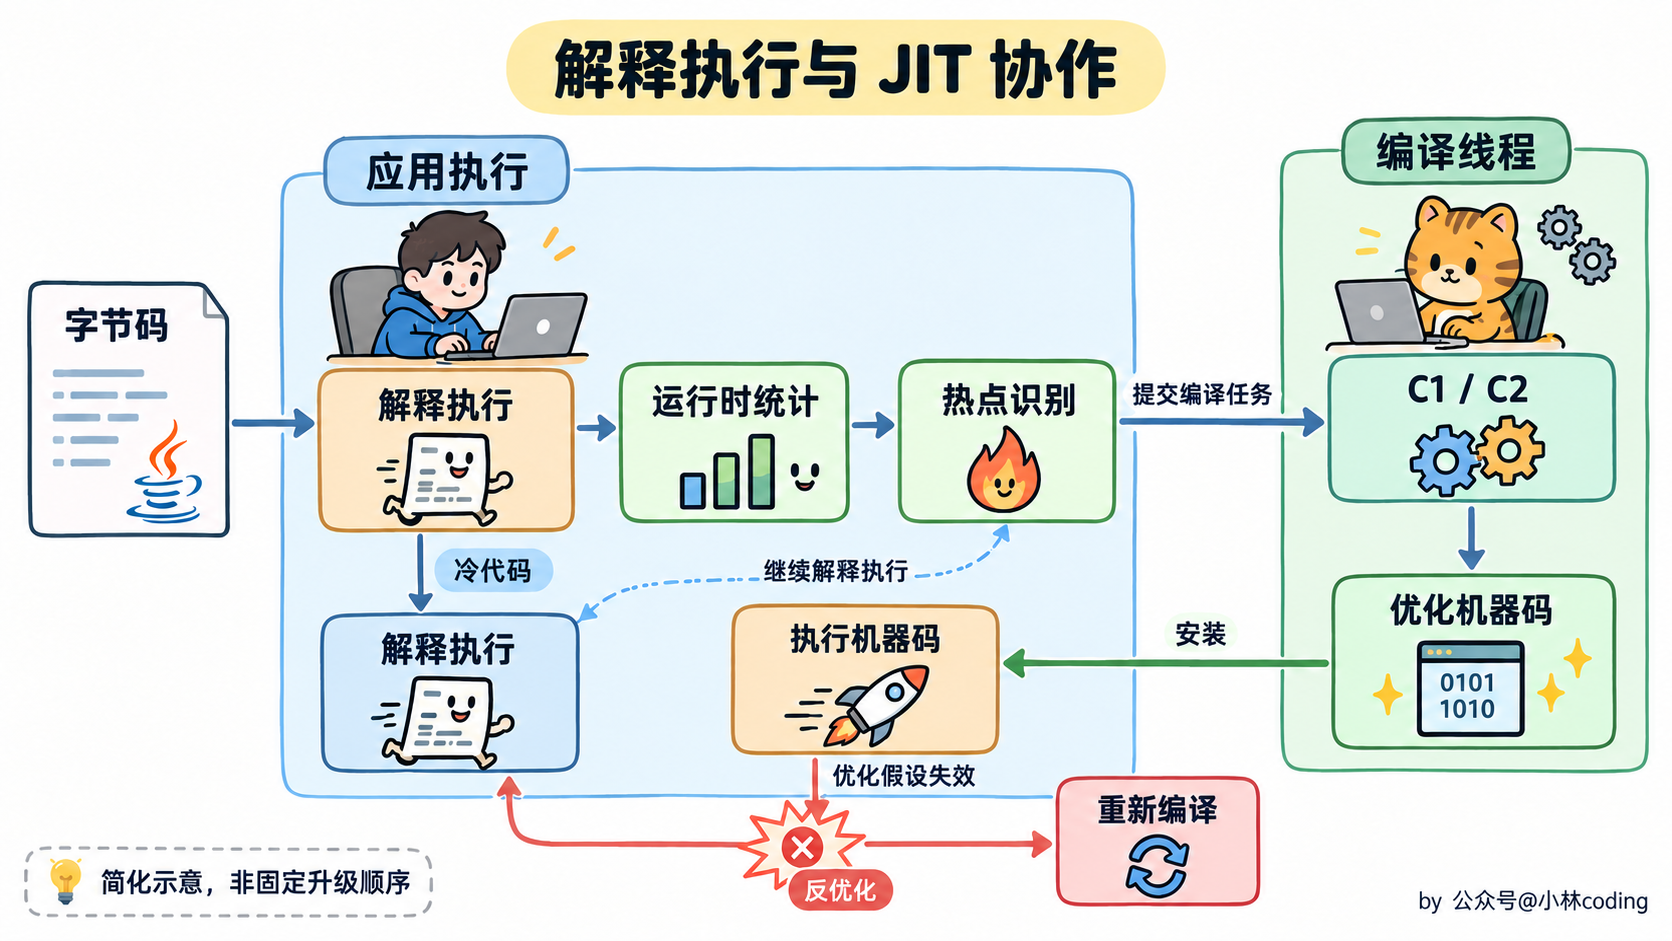
Java 源码先编译成字节码,JVM 再负责执行。解释器可以直接逐条执行字节码,不需要先花时间把所有方法编译成机器码,所以比较容易快速开始运行。
但一个方法如果调用了很多次,每次都解释执行就会有重复开销。JIT(即时编译器)会根据运行时统计,识别热点方法或热点循环,把相关代码编译成机器码,并进行内联、逃逸分析等优化,提高后续执行效率。
常见 HotSpot 会使用分层编译:结合解释执行、C1 和 C2 等编译层级,在启动速度、编译成本和运行性能之间做取舍,而不是所有代码一启动就直接由 C2 编译。
这也是 Java 服务通常需要“预热”的原因:刚启动时,一些代码还没有积累足够的热点信息,等运行一段时间后,编译优化逐渐完成,性能才更稳定。
还有一种情况是反优化:JIT 可能根据运行时情况作出某些假设,如果后来假设不成立,就需要退回解释执行或重新编译。所以“编译成机器码”也不代表此后永远不会改变。
# 线上 GC 很频繁,怎么排查?
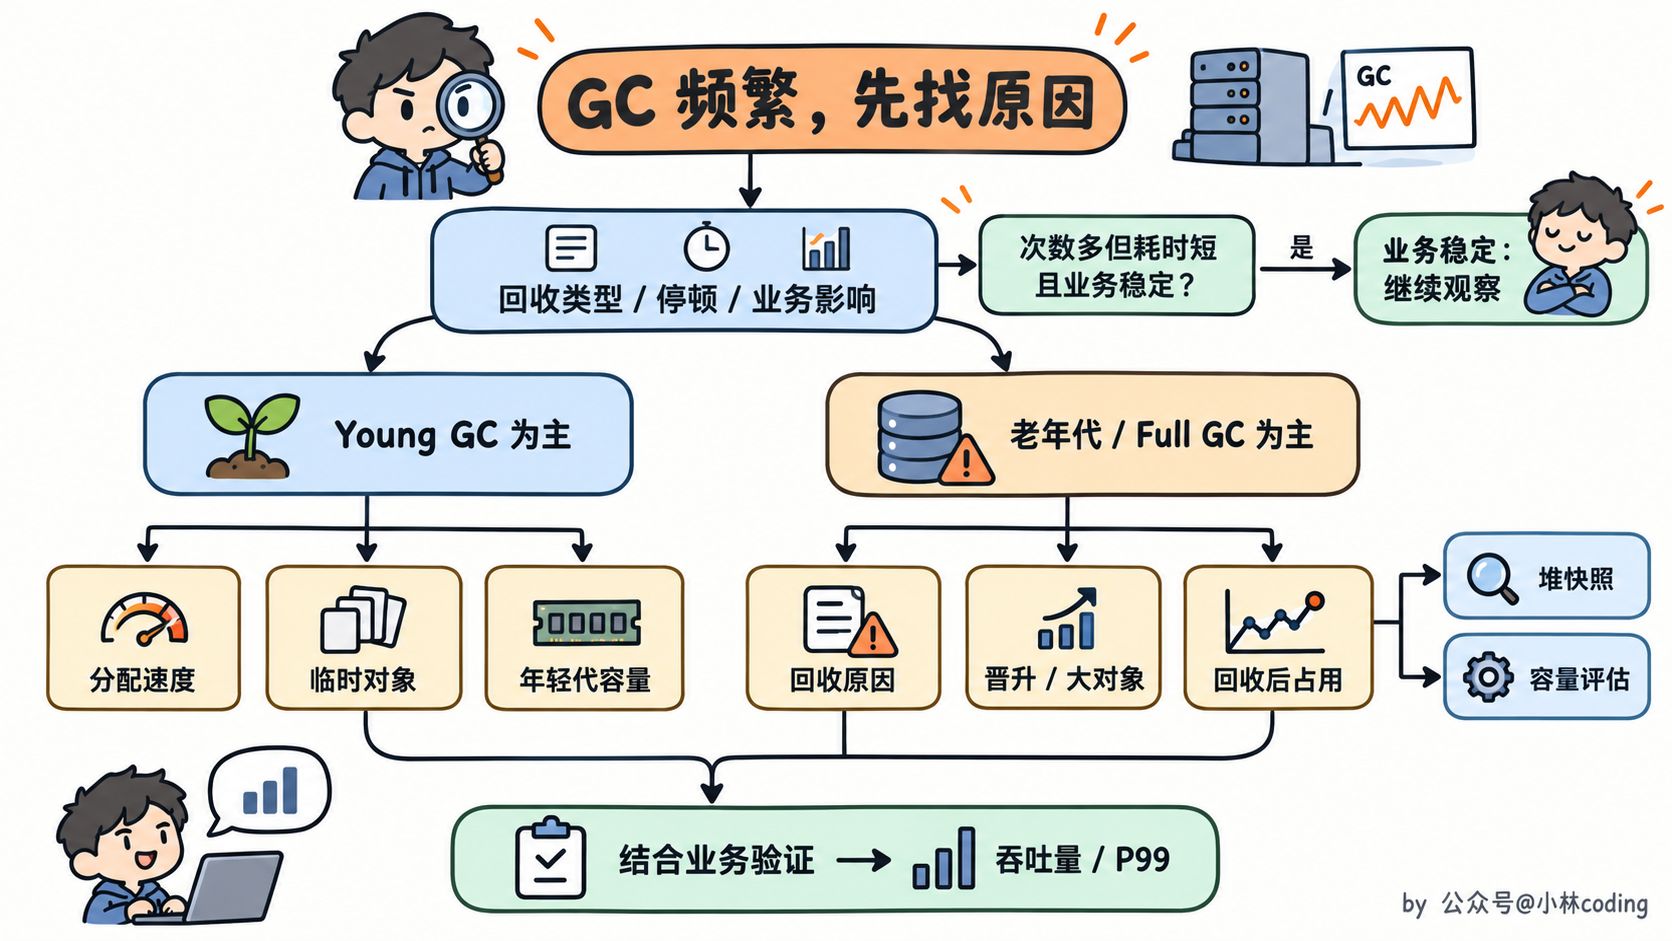
先确认是 Young GC 频繁、老年代回收频繁,还是 Full GC 频繁,再看停顿和业务延迟。Young GC 次数多,但每次很短、回收效果好,未必就是问题。
可以按下面这个顺序来看:
看 GC 日志:确认收集器、回收原因、频率、停顿时间,以及回收前后的占用。JDK 9 及以后可以使用下面的日志参数,路径需要提前准备好:
-Xlog:gc*,safepoint:file=/var/log/app/gc.log:time,uptime,level,tags:filecount=5,filesize=20MJDK 8 通常使用
-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/var/log/app/gc.log,不要把两套参数直接混用。看分配与晋升速度:Young GC 频繁,重点看是不是创建了大量临时对象,或者年轻代容量不合适。老年代增长快,则看对象是否大量存活、Survivor 是否不足,以及是否频繁分配大对象。
看回收后的占用:如果老年代回收后占用依然很高,甚至不断上涨,就需要分析堆快照和引用链。如果回收后能明显降下来,但很快又被填满,可能是流量增加、分配过快或容量不足。
看回收原因:比如 System.gc() 表示显式请求,G1 的转移失败可能表示可用空间不足,元空间相关原因则要检查类加载和类卸载。不同原因,解决方向不一样。
结合业务数据验证:对照请求量、批处理任务、缓存变化、发布记录,找到发生异常的时间点。修复后比较 GC 耗时、吞吐量和 P99 延迟,而不是只要求 GC 次数变少。
举个例子:接口每次都把大量数据库结果加载成对象,再做筛选,可能导致 Young GC 非常频繁。改成在数据库中过滤、分页读取后,对象分配量下降,回收压力也会减少。这时候单纯调大堆,往往不如先减少不必要的分配有效。
# 常用的 JVM 排查工具有哪些?
工具主要是帮我们看线程、内存、GC 和代码执行情况,不同问题选不同工具:
- jcmd:查看 JVM 参数、线程栈、堆信息,也可以生成堆快照、启动 JFR。先用
jcmd <pid> help查看当前 JVM 支持的命令。 - jstat:持续观察 GC 次数、耗时和各区域占用等统计信息,适合先看变化趋势;具体指标还要结合收集器理解。
- jstack:查看线程栈和锁信息,用来分析线程阻塞、死锁,以及某个线程在执行什么代码。
- JFR(Java Flight Recorder):记录 CPU 采样、对象分配、GC、锁竞争等事件,适合把一段时间内的性能变化串起来分析,事件是否开启取决于录制配置。
- MAT:分析堆快照,查看对象数量、占用、支配树和到 GC Roots 的路径,定位哪些对象被谁长期持有。
比如下面这些命令,12345 只是示例进程号,使用时替换成实际 PID:
jcmd 12345 VM.flags
jcmd 12345 GC.heap_info
jcmd 12345 Thread.print -l
jstat -gcutil 12345 1000 10
前三个分别查看参数、堆概要和线程信息;最后一个每隔 1 秒采样一次,共采样 10 次。执行时需要具备目标进程的访问权限,通常使用同一用户和对应 JDK 的工具。
如果要主动导出堆快照,可以使用 jcmd 12345 GC.heap_dump /tmp/heapdump.hprof。不过导出可能造成停顿,默认还可能请求一次 Full GC,文件也可能很大,需要提前考虑磁盘空间和业务影响,不能把它当成没有成本的普通查询。
# 分析堆快照时,怎么定位内存泄漏?
可以用 MAT 打开 hprof 文件,先看哪些类型和对象占用了大量内存,再沿引用链找到它们为什么还活着。
这里有两个概念比较重要:
- Shallow Heap(浅堆大小):对象自身占用的内存,不包括它引用的其他对象。
- Retained Heap(保留堆大小):如果这个对象变得不可达,连带能够释放的内存。它不是简单把所有被引用对象的大小相加,因为某些对象还可能被别的对象持有。
比如一个 ArrayList 对象本身可能不大,但它独占持有的大量业务对象,可能使保留堆大小非常大。因此不能只看“哪个对象自身最大”,还要看支配树中的主要持有者。
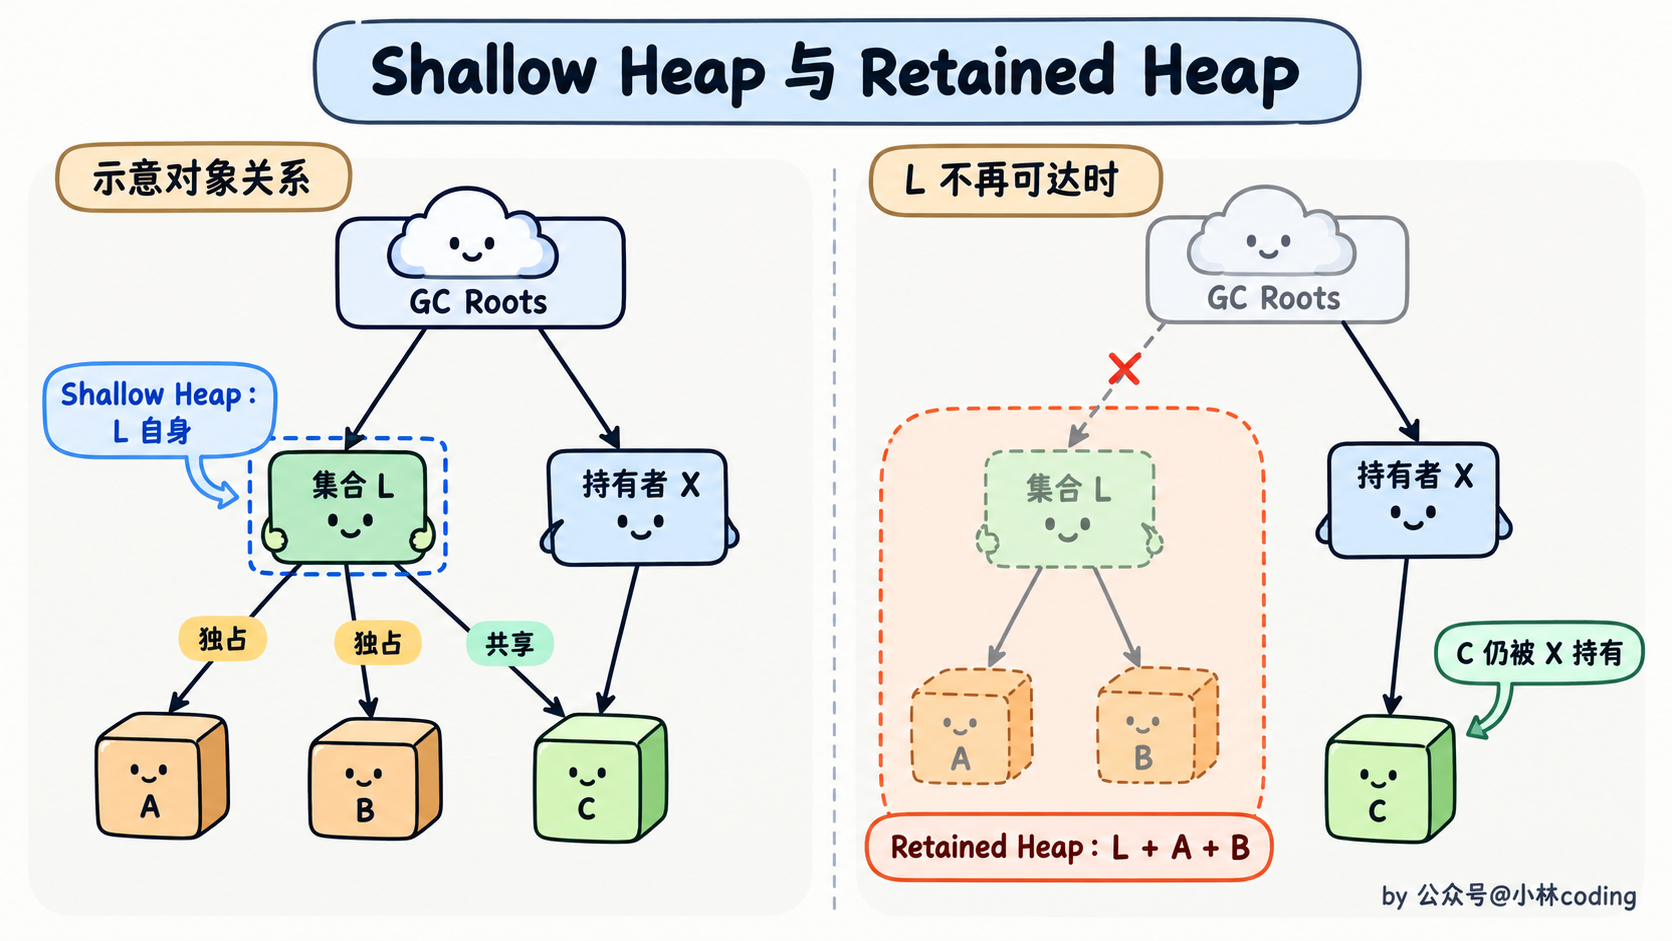
具体可以分三步:
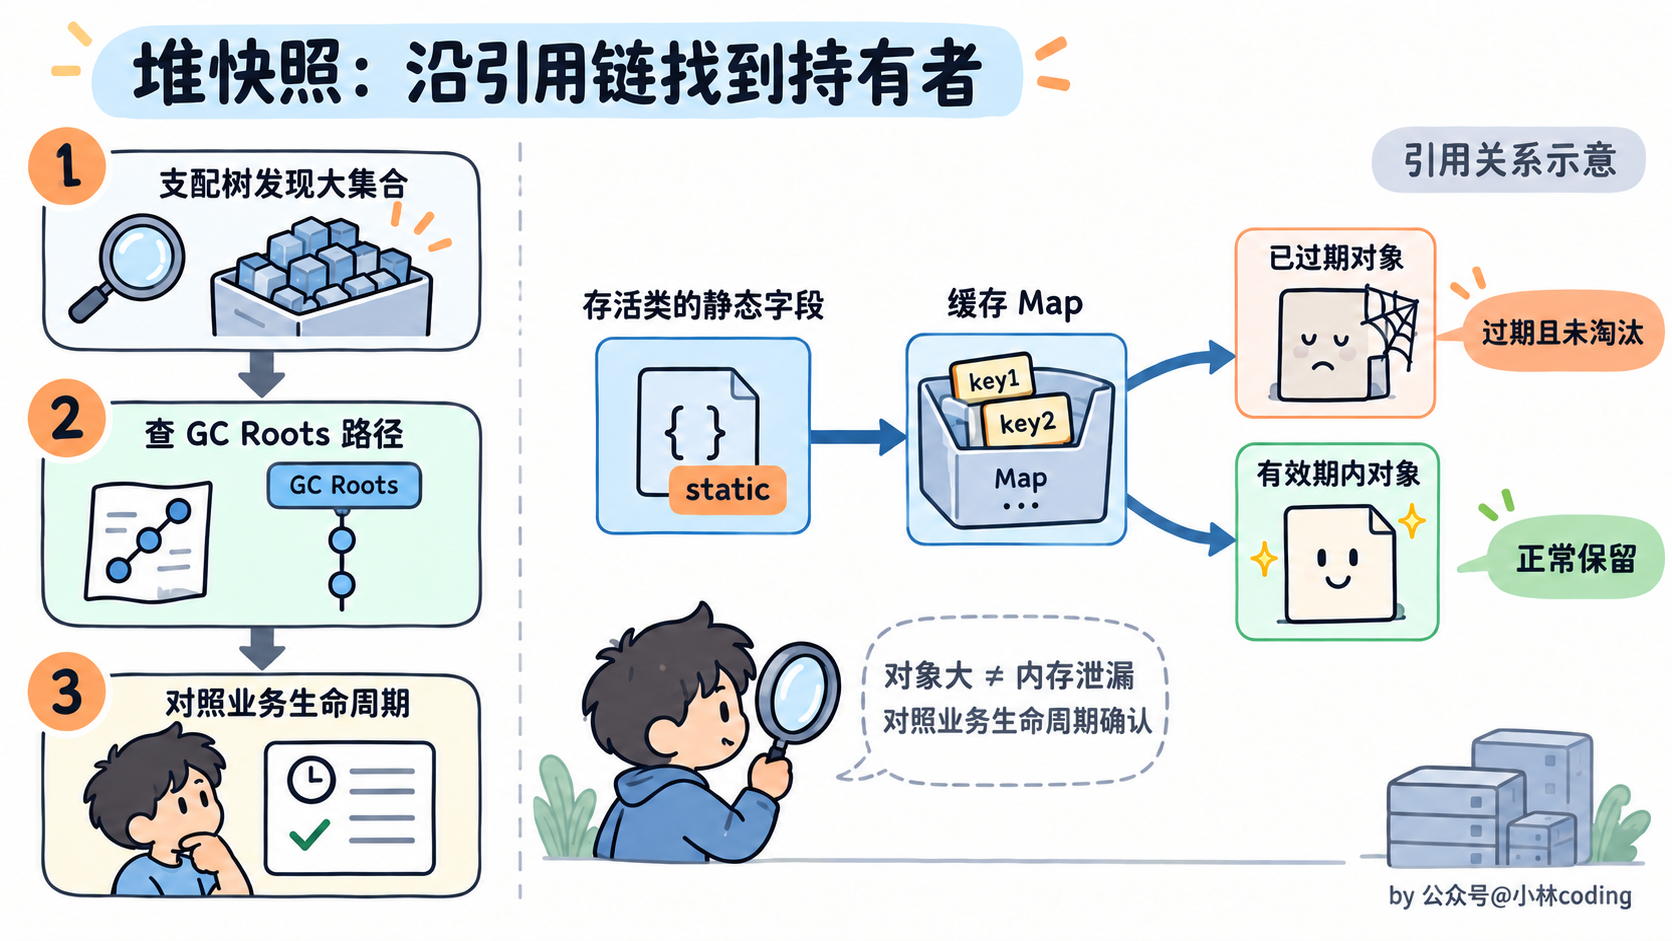
- 找主要占用者:通过类直方图、支配树、Leak Suspects 等结果定位大集合、大数组和异常多的业务对象。
- 查到 GC Roots 的路径:找出是什么让对象保持可达,比如静态 Map、池化线程里的 ThreadLocal、监听器或仍然存活的类加载器。分析泄漏时,要区分强引用路径和软、弱引用路径。
- 结合业务判断:确认这些对象是不是已经过期、任务结束后是否仍在保留。必要时对比不同时刻的快照,看对象数量和保留堆大小是否持续增长。
堆快照只能告诉我们“对象被谁持有”,不能自动判断业务上它还需不需要。一个很大的缓存可能是正常设计,也可能忘了淘汰,需要结合容量、过期策略和实际使用情况来确认。
# Java 进程 CPU 飙高,怎么排查?
先判断 CPU 主要花在 业务代码、GC,还是其他线程活动 上,不要看到 CPU 高就直接调 JVM 参数。
以 Linux 上的平台线程为例,可以按下面的步骤排查:
- 用
top找到 CPU 占用高的 Java 进程,再用top -H -p 12345找到占用高的线程。 - 把线程 ID 转成十六进制,比如线程 ID 是 23456,可以执行
printf '%x\n' 23456。 - 使用
jstack 12345或jcmd 12345 Thread.print -l获取线程栈,通过nid=0x...找到对应线程。 - 间隔采集几次,判断是否持续停在同一段代码,再结合 JFR 的 CPU 采样和 GC 日志确认原因。
如果是业务线程,常见原因有死循环、大量计算、复杂正则、数据量突然增大等;如果 GC 占用了很多 CPU,就继续看对象分配速度、回收频率和回收效果。
线程栈只是一瞬间的状态,某次恰好采到一个方法,不代表 CPU 都消耗在那里。多次采样或持续的性能录制,才能更可靠地定位热点。死锁、线程一直等待通常表现为响应慢,但不一定造成 CPU 飙高。
# 堆没满,但 Java 进程占用内存很高,可能是什么原因?
因为 Java 进程的内存不只有 -Xmx 控制的堆。还有线程栈、元空间、Code Cache、直接内存、GC 自身的数据结构,以及 JNI 等本地库申请的内存。
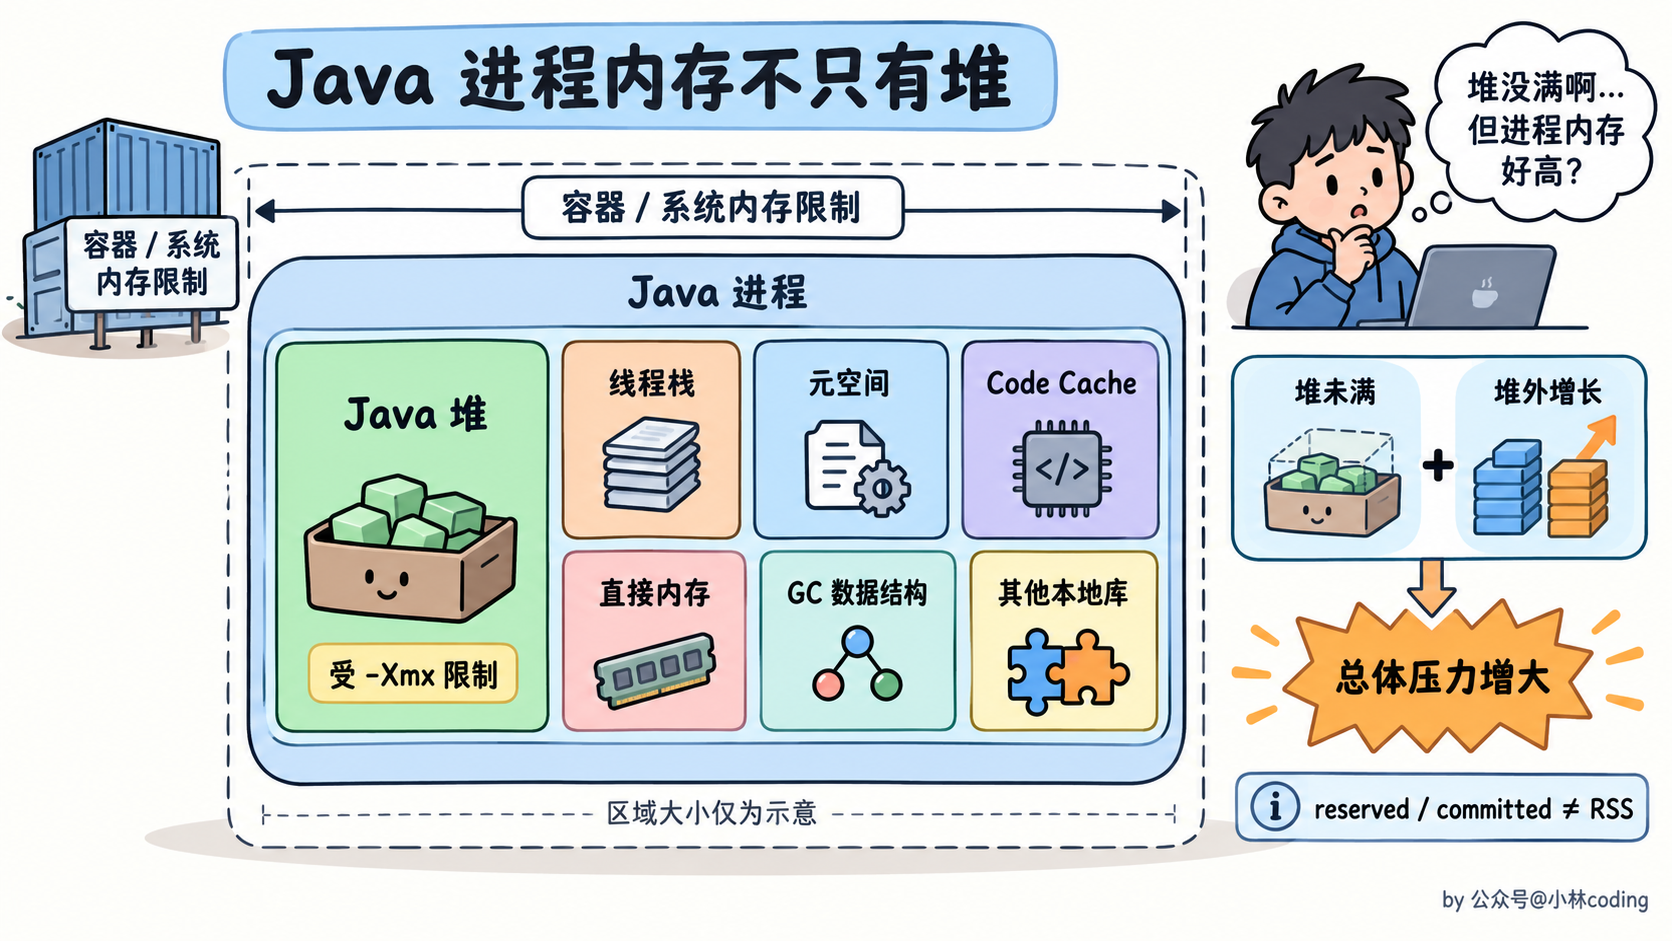
比如堆最多只有 2GB,但线程数非常多、直接缓冲区持续增长,进程仍然可能占用远超 2GB 的内存。在容器中,还可能达到容器限制,被系统杀掉,表现为 OOMKilled,而不一定抛出 Java 的 OutOfMemoryError。
排查时可以分开看:
- 堆:结合 GC 日志和堆概要,看实际使用、已提交容量和回收后的变化。
- 线程:看线程数量和栈大小,确认是不是线程池失控或不断创建线程。
- 类与代码:看加载类数量、元空间、Code Cache,检查动态生成类和类加载器是否持续增长。
- 直接内存与本地内存:标准 NIO 缓冲区可以结合 BufferPoolMXBean 查看容量,框架还需要看自己的分配器指标。
对于 HotSpot 管理的本地内存,可以在启动时加 -XX:NativeMemoryTracking=summary,再执行 jcmd 12345 VM.native_memory summary 查看分类统计;还可以记录 baseline,之后通过 summary.diff 比较增长。
但 NMT 不能完整覆盖第三方本地库的所有分配,统计的 reserved、committed 也不等于操作系统看到的 RSS。堆快照、NMT 和系统内存指标需要结合起来看,不能只拿其中一个数字就断定泄漏。
# JVM 调优一般从哪些方面入手?
先明确目标:是提高吞吐量、降低响应时间,还是减少内存占用?不同目标可能互相牵制,没有一套参数能适合所有应用。
通常可以按下面几个方向来做:
- 先建立基线:记录吞吐量、P99 延迟、GC 停顿、分配速度、回收后占用和 CPU 使用率,并结合业务高峰负载。
- 先解决代码问题:比如一次性加载全部数据、缓存没有容量限制、重复创建大量临时对象、ThreadLocal 没有清理。这些问题不是换一个收集器就能解决的。
- 合理分配内存:根据存活对象规模和分配压力设置
-Xms、-Xmx,给堆外内存和容器限制留余量。固定初始堆和最大堆可以减少运行时扩缩容,但也意味着更早占用相应容量,要结合资源预算。 - 选择合适的收集器:吞吐量优先可以评估 Parallel,平衡吞吐和停顿可以评估 G1,更低停顿需求可以评估 ZGC 等。
- 根据证据调整参数:比如 G1 先考虑堆容量和停顿目标,不要一上来用
-Xmn固定年轻代,限制它根据停顿目标自适应调整;其他参数也要结合日志和压测结果。 - 验证整体效果:在相同负载下比较调整前后表现,一次只改变少量因素,并保留可回退的配置。
比如调大堆后 GC 次数减少了,但单次停顿更长、P99 延迟变差,就不能说调优成功。面试时能讲清“发现了什么问题、根据什么数据调整、结果怎么验证”,比只背参数更有说服力。
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。
← Java并发编程面试题 Spring面试题 →