# Redis面试题
大家好,我是小林。
Redis 是面试里被问到频率非常高的一个话题,而且坑很深。很多人用 Redis 用了很久,但面试的时候被问到"跳表为什么比 B+ 树更适合 Redis"或者"渐进式 rehash 是怎么回事",就开始语塞了。Redis 本身上手很快,但面试考的那些细节,往往是日常使用中根本不会主动去想的东西。
这篇文章把 Redis 面试中的高频问题都整理进来了,从数据结构的底层实现、线程模型、持久化机制,到缓存淘汰、集群架构,再到缓存雪崩/击穿/穿透这些实际业务场景问题,基本上覆盖了你在 Redis 面试里会遇到的大部分内容。
几个最值得花时间搞清楚的模块:
- 数据结构底层实现:五种基本类型各自用什么底层结构存储、什么时候会发生编码转换、跳表的层高是怎么确定的,这块是 Redis 面试里最容易被深挖的地方。
- 持久化:AOF 和 RDB 各自的实现原理、优缺点和适用场景,AOF 重写机制是怎么回事,这是高频考点。
- 缓存三大问题:缓存雪崩、缓存击穿、缓存穿透的区别和对应解决方案,这个在面试里几乎必问,要能分清楚三个概念不要搞混。
- 集群架构:主从复制的增量同步和全量同步过程、哨兵选主算法、切片集群的哈希槽分配,这些是进阶面试的必考内容。
如果你刚开始准备,建议先把数据结构和持久化这两块搞清楚,然后再看缓存问题和集群部分,这样整体学下来会比较顺。
# 数据结构
# 讲一下Redis底层的数据结构
Redis 提供了丰富的数据类型,常见的有五种数据类型:String(字符串),Hash(哈希),List(列表),Set(集合)、Zset(有序集合)。
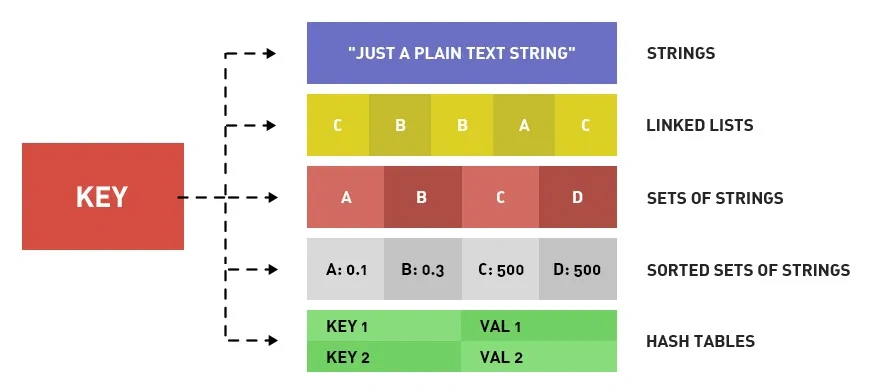
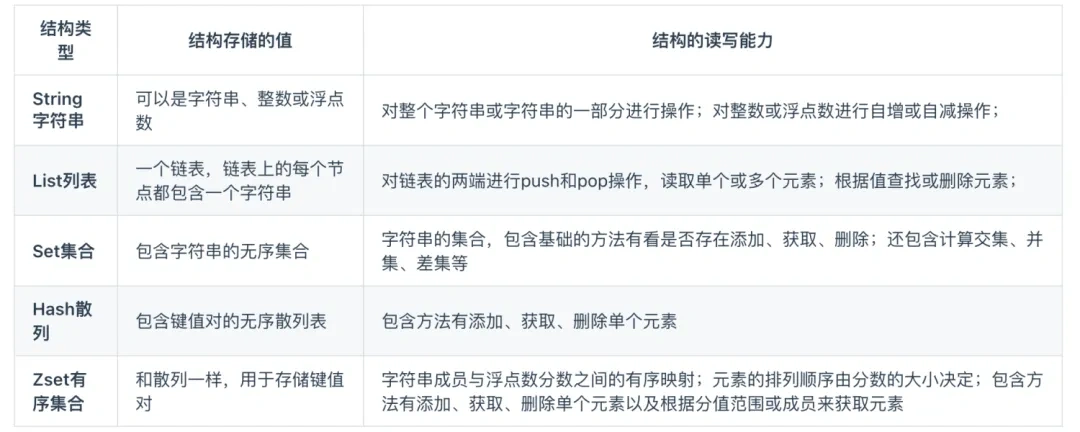
随着 Redis 版本的更新,后面又提供了 BitMap(2.2 版新增)、HyperLogLog(2.8 版新增)、GEO(3.2 版新增)、Stream(5.0 版新增)。这里要区分一下,BitMap 和 HyperLogLog 底层基于 String,GEO 底层基于 Zset,Stream 则是独立的数据类型,并不是每一种能力都对应一种新的底层类型。
另外,数据类型和底层数据结构不是一回事。String、Hash、List 这些是我们使用 Redis 时看到的数据类型,而 SDS、哈希表、跳表、listpack、quicklist 等才是底层实现。同一种数据类型,还会根据数据大小和版本选择不同的编码。
以 Redis 7.0 为例,可以这样记:
| 数据类型 | 常见底层编码 | 什么时候使用 |
|---|---|---|
| String | int、embstr、raw | 可表示为整数时尝试使用 int,短字符串使用 embstr,较长字符串使用 raw |
| Hash | listpack、哈希表 | 字段数量少、字段和值都较小时使用 listpack,超过配置限制后转换为哈希表 |
| List | quicklist | 用双向链表串起多个节点,普通节点内部使用 listpack 保存元素 |
| Set | intset、哈希表 | 元素都是整数且数量较少时使用 intset,否则使用哈希表 |
| Zset | listpack、跳表 + 哈希表 | 小型有序集合使用 listpack,超过配置限制后使用跳表 + 哈希表 |
比如 Hash 的 listpack 编码,默认要求字段数量不超过 512,并且每个字段和值都不超过 64 字节;Set 的 intset 编码,默认最多保存 512 个整数。这些限制可以通过配置调整。后续版本也会增加编码,比如 Redis 7.2 的小型 Set 可以使用 listpack,所以面试时最好先说明讨论的是哪个版本。
Redis 五种数据类型的应用场景:
- String 类型的应用场景:缓存对象、常规计数、分布式锁、共享 session 信息等。
- List 类型的应用场景:消息队列(但是有两个问题:1. 生产者需要自行实现全局唯一 ID;2. 不能以消费组形式消费数据)等。
- Hash 类型:缓存对象、购物车等。
- Set 类型:聚合计算(并集、交集、差集)场景,比如点赞、共同关注、抽奖活动等。
- Zset 类型:排序场景,比如排行榜、电话和姓名排序等。
Redis 后续版本又支持四种数据类型,它们的应用场景如下:
- BitMap(2.2 版新增):二值状态统计的场景,比如签到、判断用户登陆状态、连续签到用户总数等;
- HyperLogLog(2.8 版新增):海量数据基数统计的场景,比如百万级网页 UV 计数等;
- GEO(3.2 版新增):存储地理位置信息的场景,比如滴滴叫车;
- Stream(5.0 版新增):消息队列,相比于基于 List 类型实现的消息队列,可以自动生成同一个 Stream 内唯一且递增的消息 ID,并支持消费组、消息确认和待处理消息追踪。不同 Stream 之间的 ID 不保证全局唯一。
# ZSet用过吗
用过 zset 实现排行榜的功能。
以博文点赞排名为例,小林发表了五篇博文,分别获得赞为 200、40、100、50、150。
# arcticle:1 文章获得了200个赞
> ZADD user:xiaolin:ranking 200 arcticle:1
(integer) 1
# arcticle:2 文章获得了40个赞
> ZADD user:xiaolin:ranking 40 arcticle:2
(integer) 1
# arcticle:3 文章获得了100个赞
> ZADD user:xiaolin:ranking 100 arcticle:3
(integer) 1
# arcticle:4 文章获得了50个赞
> ZADD user:xiaolin:ranking 50 arcticle:4
(integer) 1
# arcticle:5 文章获得了150个赞
> ZADD user:xiaolin:ranking 150 arcticle:5
(integer) 1
文章 arcticle:4 新增一个赞,可以使用 ZINCRBY 命令(为有序集合key中元素member的分值加上increment):
> ZINCRBY user:xiaolin:ranking 1 arcticle:4
"51"
查看某篇文章的赞数,可以使用 ZSCORE 命令(返回有序集合中指定成员的分值 score):
> ZSCORE user:xiaolin:ranking arcticle:4
"51"
获取小林文章赞数最多的 3 篇文章,可以使用 ZREVRANGE 命令(倒序获取有序集合 key 从start下标到stop下标的元素):
# WITHSCORES 表示把 score 也显示出来
> ZREVRANGE user:xiaolin:ranking 0 2 WITHSCORES
1) "arcticle:1"
2) "200"
3) "arcticle:5"
4) "150"
5) "arcticle:3"
6) "100"
获取小林 100 赞到 200 赞的文章,可以使用 ZRANGEBYSCORE 命令(返回有序集合中指定分数区间内的成员,分数由低到高排序):
> ZRANGEBYSCORE user:xiaolin:ranking 100 200 WITHSCORES
1) "arcticle:3"
2) "100"
3) "arcticle:5"
4) "150"
5) "arcticle:1"
6) "200"
# Redis 中 set和zset区别是什么?
Redis 中的 Set 和 ZSet(Sorted Set,有序集合)都是用于存储多个元素的集合类型,但它们的核心区别在于是否对元素进行排序以及排序方式,这直接影响了它们的适用场景。
Set 是无序、唯一元素的集合,适合存储不重复且无需排序的数据(如用户 ID 列表、标签集合)。常用命令:
- 添加元素:
SADD set1 "a" "b" "c"(向 set1 中添加 3 个元素,重复添加会自动去重) - 查看所有元素:
SMEMBERS set1(返回结果无序,如 ["b", "a", "c"]) - 判断元素是否存在:
SISMEMBER set1 "a"(存在返回 1,否则 0) - 集合运算:
SINTER set1 set2(求两个集合的交集)、SUNION set1 set2(求并集)
ZSet 是有序、唯一元素的集合,每个元素关联一个 “分数(score)”,并按分数从小到大排序(元素唯一,但分数可重复),适合需要排序或排名的场景(如排行榜、带权重的任务)。常用命令:
- 添加元素(带分数):
ZADD zset1 10 "a" 20 "b" 15 "c"(向 zset1 中添加元素,分数分别为 10、20、15) - 按排名范围获取元素(从小到大):
ZRANGE zset1 0 -1 WITHSCORES(返回所有元素及分数,结果按分数排序:"a" 10, "c" 15, "b" 20) - 按分数范围获取元素:
ZRANGEBYSCORE zset1 12 25(返回分数 12-25 之间的元素:"c", "b") - 增减元素分数:
ZINCRBY zset1 5 "a"(将 "a" 的分数 +5,变为 15) - 获取元素排名:
ZRANK zset1 "b"(返回 "b" 的排名,从 0 开始,此处返回 2)
具体来说,ZSet 相比 Set 多了很多基于分数的操作:比如根据分数范围获取元素(zrangebyscore)、根据排名获取元素(zrange)、计算元素的排名(zrank)、给元素的分数增减(zincrby)等。而 Set 没有分数概念,只能按元素本身进行操作,无法直接获取 “第 N 个元素” 或 “某个范围内的元素”。
简单来说,核心区别总结:
- 有序性:Set 完全无序,ZSet 通过分数维持有序
- 操作特性:ZSet 多了基于分数的排序、范围查询、排名计算等命令,Set 只有集合本身的交并差等操作
- 适用场景:Set 用于去重且无需排序的场景,ZSet 用于需要排序、排名或权重相关的场景
# Zset 底层是怎么实现的?
以 Redis 7.0 为例,Zset 类型有两种底层编码:listpack,以及跳表 + 哈希表(dict)。
- 小型有序集合使用 listpack,成员和分值成对保存在同一个紧凑容器中,不额外维护 dict。默认的元素数量上限是
128,单个成员长度上限是64字节,可通过zset-max-listpack-entries和zset-max-listpack-value调整;这两个上限都包含边界值。 - 超过紧凑编码限制后,转换为跳表 + 哈希表。跳表按分值组织成员,支持平均 O(log N) 的插入、删除和排名定位,以及 O(log N + M) 的范围查询(M 为返回元素数);哈希表按成员查找分值,使
ZSCORE这类查询具有平均 O(1) 的复杂度。
这里的「跳表编码」并不是只有一张跳表,而是同时维护跳表和哈希表;listpack 编码按成员查询时则需要遍历,复杂度为 O(N),用一定的查询开销换取小集合的内存节省。
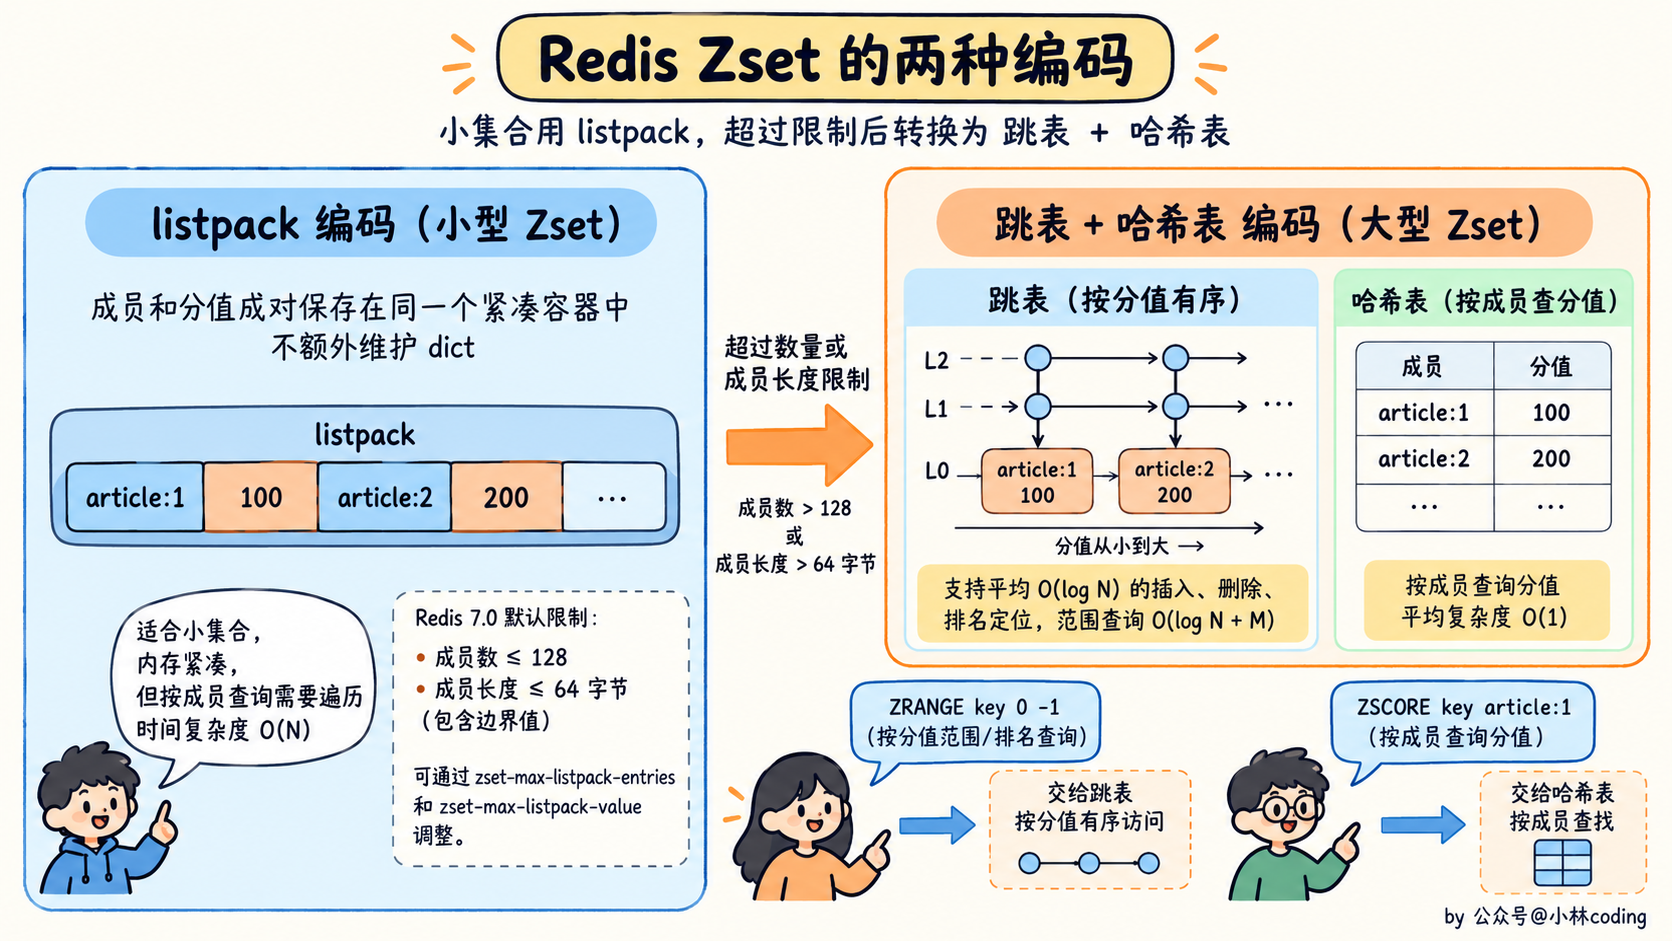
Redis 7.0 之前,小型 Zset 使用的是压缩列表(ziplist),从 Redis 7.0 起替换为 listpack。Zset 直接使用 listpack,不需要经过 quicklist。
# 跳表是怎么实现的?
链表在查找元素的时候,因为需要逐一查找,所以查询效率非常低,时间复杂度是 O(N),于是就出现了跳表。跳表是在链表基础上改进过来的,实现了一种「多层」的有序链表,这样的好处是能快速定位数据。
那跳表长什么样呢?我这里举个例子,下图展示了一个层级为 3 的跳表。
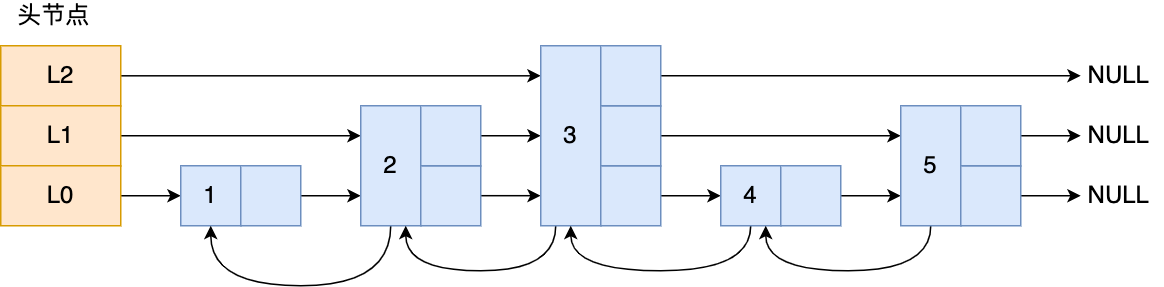
图中头节点有 L0~L2 三个头指针,分别指向了不同层级的节点,然后每个层级的节点都通过指针连接起来:
- L0 层级共有 5 个节点,分别是节点1、2、3、4、5;
- L1 层级共有 3 个节点,分别是节点 2、3、5;
- L2 层级只有 1 个节点,也就是节点 3 。
如果我们要在链表中查找节点 4 这个元素,只能从头开始遍历链表,需要查找 4 次,而使用了跳表后,只需要查找 2 次就能定位到节点 4,因为可以在头节点直接从 L2 层级跳到节点 3,然后再往前遍历找到节点 4。
可以看到,这个查找过程就是在多个层级上跳来跳去,最后定位到元素。跳表的平均查找复杂度是 O(log N),最坏情况下仍然可能退化为 O(N),随机层高让这种退化不容易发生。
那跳表节点是怎么实现多层级的呢?这就需要看「跳表节点」的数据结构了,如下:
typedef struct zskiplistNode {
    //Zset 对象的元素值
    sds ele;
    //元素权重值
    double score;
    //后向指针
    struct zskiplistNode *backward;

    //节点的level数组,保存每层上的前向指针和跨度
    struct zskiplistLevel {
        struct zskiplistNode *forward;
        unsigned long span;
    } level[];
} zskiplistNode;
Zset 对象要同时保存「元素」和「元素的权重」,对应到跳表节点结构里就是 sds 类型的 ele 变量和 double 类型的 score 变量。每个跳表节点都有一个后向指针(struct zskiplistNode *backward),指向前一个节点,目的是为了方便从跳表的尾节点开始访问节点,这样倒序查找时很方便。
跳表是一个带有层级关系的链表,而且每一层级可以包含多个节点,每一个节点通过指针连接起来,实现这一特性就是靠跳表节点结构体中的zskiplistLevel 结构体类型的 level 数组。
level 数组中的每一个元素代表跳表的一层,也就是由 zskiplistLevel 结构体表示,比如 level[0] 就表示第一层,level[1] 就表示第二层。zskiplistLevel 结构体里定义了「指向下一个跳表节点的指针」和「跨度」,跨度用来记录沿这个指针前进时,跨过了底层的多少个节点。
比如,下面这张图,展示了各个节点的跨度。
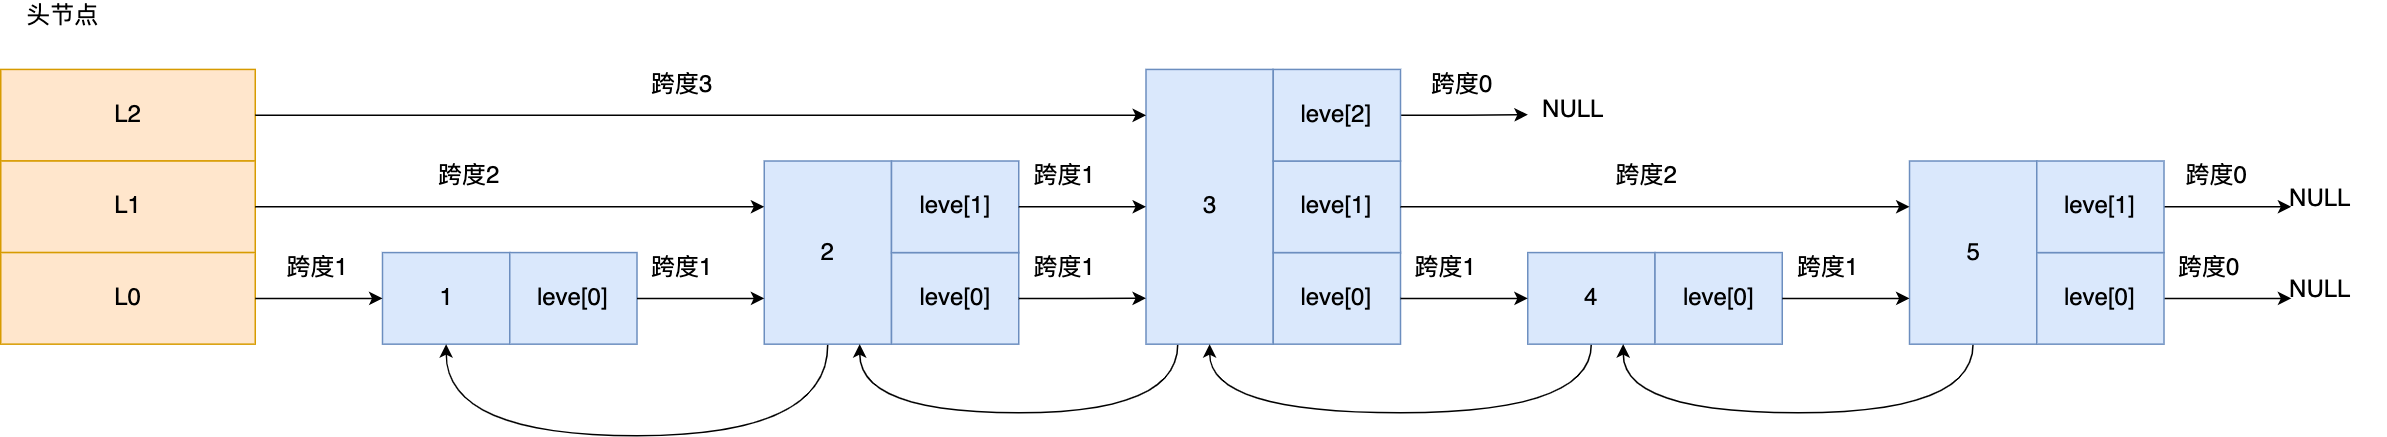
第一眼看到跨度的时候,可能以为它是用来找下一个节点的,其实普通遍历只需要前向指针就可以完成。跨度主要用于计算排名:查找成员时,把沿途经过的跨度累加起来,就能知道这个成员排在第几位,所以 ZRANK 不需要从头数到尾。
另外,跳表先按 score 排序,score 相同时再按成员的字节序排序,这样即使多个成员分数相同,也能确定它们在跳表中的位置。
Redis 跳表在创建节点的时候,随机生成每个节点的层数,并没有严格维持相邻两层的节点数量比例为 2 : 1 的情况。
具体的做法是,节点从 1 层开始,每轮以 25% 的概率再增加 1 层,直到没有命中这个概率,或者达到最大层数,最终确定该节点的层高。
这样的做法,层数越高,出现的概率越低。以 Redis 7.0 为例,层高最大限制是 32,由 ZSKIPLIST_MAXLEVEL 定义。
虽然我前面讲解跳表的时候,图中的跳表的「头节点」都是 3 层高,但是实际创建头节点时,会一次性分配最大层数的 level 数组。头节点预留了 32 层,不代表当前跳表已经使用了 32 层,实际有效层数由已有节点的最大层高决定。
# 跳表是怎么设置层高的?
跳表的层高是随机生成的,不是根据当前元素数量计算出来的。
以 Redis 7.0 为例,每个新节点先有 1 层,每次以 25% 的概率增加一层,最多 32 层。也就是说,节点至少有 2 层的概率是 1/4,至少有 3 层的概率是 1/16,越往上节点越少。
那为什么要随机?因为这样不需要在每次插入、删除之后重新维护严格的层级比例,也能让高层索引保持稀疏,取得平均 O(log N) 的查找效率。
# Redis为什么使用跳表而不是用B+树?
主要是因为 Redis 的数据在内存中,跳表又能比较简单地满足 Zset 的有序访问需求。
可以从三个方面来回答。
1、使用场景不同
B+ 树一个节点可以保存很多索引项,树的高度比较低,适合按页读写的磁盘数据库,可以减少查找时的磁盘 I/O。
Redis 的 Zset 主要在内存中操作,不需要通过降低树高来减少磁盘读取。因此,Redis 更关注内存中的增删改查,以及实现和维护的复杂度。
不过,B+ 树在内存中也有缓存局部性等优势,不能说它只能用于磁盘,或者在内存里就一定比跳表慢。
2、实现比较简单
跳表通过随机层高维护多层链表,插入、删除时主要调整搜索路径上的指针和跨度,不需要像 B+ 树那样处理节点分裂、合并,也不需要像红黑树那样维护颜色和旋转规则。
对于 Redis 来说,用比较简单的实现,就能获得平均 O(log N) 的查找和更新效率,这是很合适的取舍。
3、适合范围查询和排名查询
Zset 经常要查询“积分最高的前 10 名”“分数在 100 到 200 之间的成员”。跳表定位到起点之后,可以沿底层链表顺序访问,范围查询的平均复杂度是 O(log N + M),M 是返回的元素数量。
Redis 还在跳表节点里保存了跨度,用于计算排名;保存了后向指针,用于倒序遍历。这些设计都和排行榜的需求很匹配。
所以,面试时我会说,跳表能满足 Redis 的范围查询、排名和更新需求,同时实现比较简单。这里是工程上的选择,并不是说跳表在所有内存场景下都比 B+ 树好。
# 压缩列表是怎么实现的?
压缩列表是 Redis 为了节约内存而开发的,它是由连续内存块组成的顺序型数据结构,有点类似于数组。

压缩列表的头部有三个字段,末尾还有一个结束标记:
- zlbytes,记录整个压缩列表占用的内存字节数;
- zltail,记录压缩列表「尾部」节点距离起始地址有多少字节,也就是列表尾的偏移量;
- zllen,记录压缩列表包含的节点数量;
- zlend,标记压缩列表的结束点,固定值 0xFF(十进制 255)。
在压缩列表中,第一个元素紧跟在固定长度的头部后面,最后一个元素可以通过 zltail(尾偏移量)定位,所以定位首尾元素的复杂度是 O(1)。zllen 记录的是元素数量,不是首元素的位置;当它达到 65535 时,还需要遍历才能得到实际数量。而查找其他元素时,就没有这么高效了,只能逐个查找,此时的复杂度就是 O(N) 了,因此压缩列表不适合保存过多的元素。
另外,压缩列表节点(entry)的构成如下:
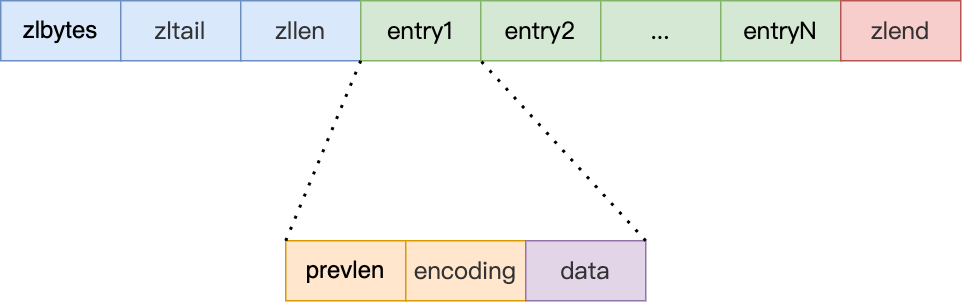
压缩列表节点包含三部分内容:
- prevlen,记录了「前一个节点」的长度,目的是为了实现从后向前遍历;
- encoding,记录了当前节点实际数据的「类型和长度」,类型主要有两种:字符串和整数。
- data,记录了当前节点的实际数据,类型和长度都由 encoding 决定;
当我们往压缩列表中插入数据时,压缩列表就会根据数据类型是字符串还是整数,以及数据的大小,会使用不同空间大小的 prevlen 和 encoding 这两个元素里保存的信息,这种根据数据大小和类型进行不同的空间大小分配的设计思想,正是 Redis 为了节省内存而采用的。
压缩列表的缺点是会发生连锁更新的问题,因此连锁更新一旦发生,就会导致压缩列表占用的内存空间要多次重新分配,这就会直接影响到压缩列表的访问性能。
所以说,虽然压缩列表紧凑型的内存布局能节省内存开销,但是如果保存的元素数量增加了,或是元素变大了,会导致内存重新分配,最糟糕的是会有「连锁更新」的问题。
因此,压缩列表只会用于保存的节点数量不多的场景,只要节点数量足够小,即使发生连锁更新,也是能接受的。
虽说如此,Redis 针对压缩列表在设计上的不足,在后来的版本中,新增设计了两种数据结构:quicklist(Redis 3.2 引入) 和 listpack(Redis 5.0 引入)。quicklist 通过拆成多个小容器来减轻大块内存操作和连锁更新的影响,而 listpack 则从节点编码上消除了连锁更新的根源。
# 介绍一下 Redis 中的 listpack
使用压缩列表的旧版 quicklist 虽然通过控制节点内部容器的大小或者元素个数,减少了连锁更新带来的性能影响,但并没有完全解决这个问题。
原因在于旧版 quicklistNode 仍用压缩列表保存元素,而连锁更新来源于压缩列表的结构设计,所以要想彻底解决这个问题,需要设计一个新的数据结构。
于是,Redis 在 5.0 新设计一个数据结构叫 listpack,目的是替代压缩列表,它最大特点是 listpack 中每个节点不再包含前一个节点的长度了,压缩列表每个节点正因为需要保存前一个节点的长度字段,就会有连锁更新的隐患。
从 Redis 7.0 起,小型 Hash、Zset 直接使用 listpack 作为紧凑编码,quicklist 的普通 packed 节点内部也由压缩列表改为 listpack。Redis 7.2 中,小型 List 还可以直接使用一个 listpack,超过 list-max-listpack-size 控制的大小或元素数量限制后再转换成 quicklist。因此,listpack 既是独立的数据结构,也能作为 quicklist 节点内部的容器。
listpack 采用了压缩列表的很多优秀的设计,比如还是用一块连续的内存空间来紧凑地保存数据,并且为了节省内存的开销,listpack 节点会采用不同的编码方式保存不同大小的数据。
我们先看看 listpack 结构:

listpack 头包含两个属性,分别记录了 listpack 总字节数和元素数量,然后 listpack 末尾也有个结尾标识。图中的 listpack entry 就是 listpack 的节点了。
每个 listpack 节点结构如下:
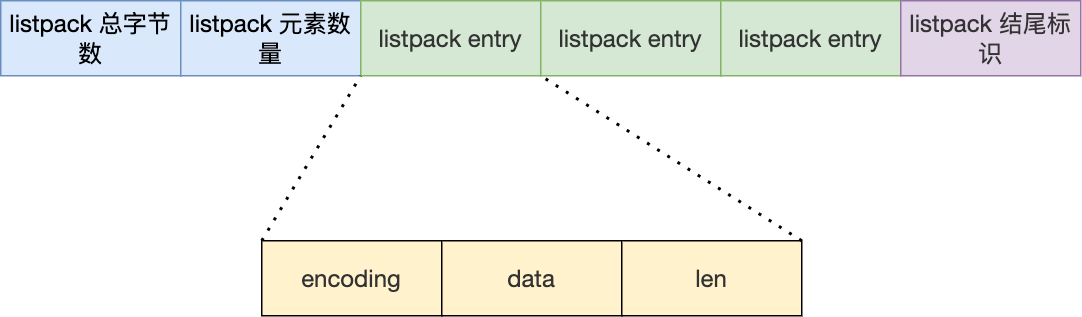
主要包含三个方面内容:
- encoding,定义该元素的编码类型,会对不同长度的整数和字符串进行编码;
- data,实际存放的数据;
- len,encoding+data的总长度;
可以看到,listpack 没有压缩列表中记录前一个节点长度的字段了,listpack 只记录当前节点的长度,当我们向 listpack 加入一个新元素的时候,不会影响其他节点的长度字段的变化,从而避免了压缩列表的连锁更新问题。
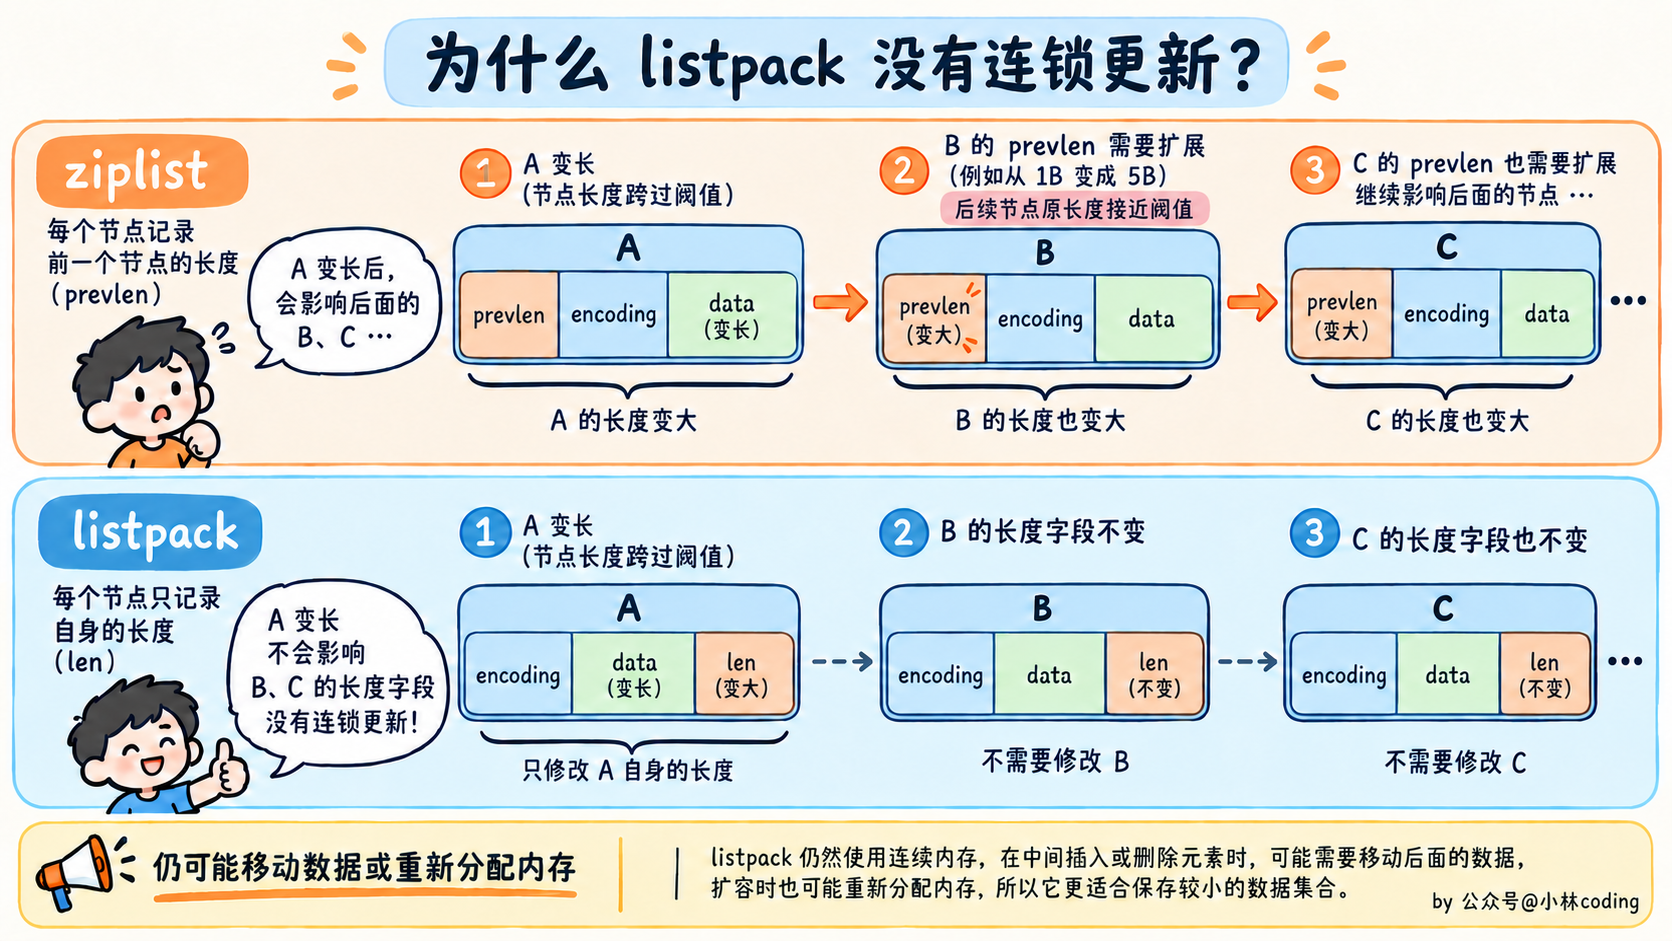
不过,避免连锁更新不代表插入、删除就变成了 O(1)。listpack 仍然使用连续内存,在中间插入或者删除元素时,可能需要移动后面的数据,扩容时也可能重新分配内存,所以它更适合保存较小的数据集合。
# 哈希表是怎么扩容的?
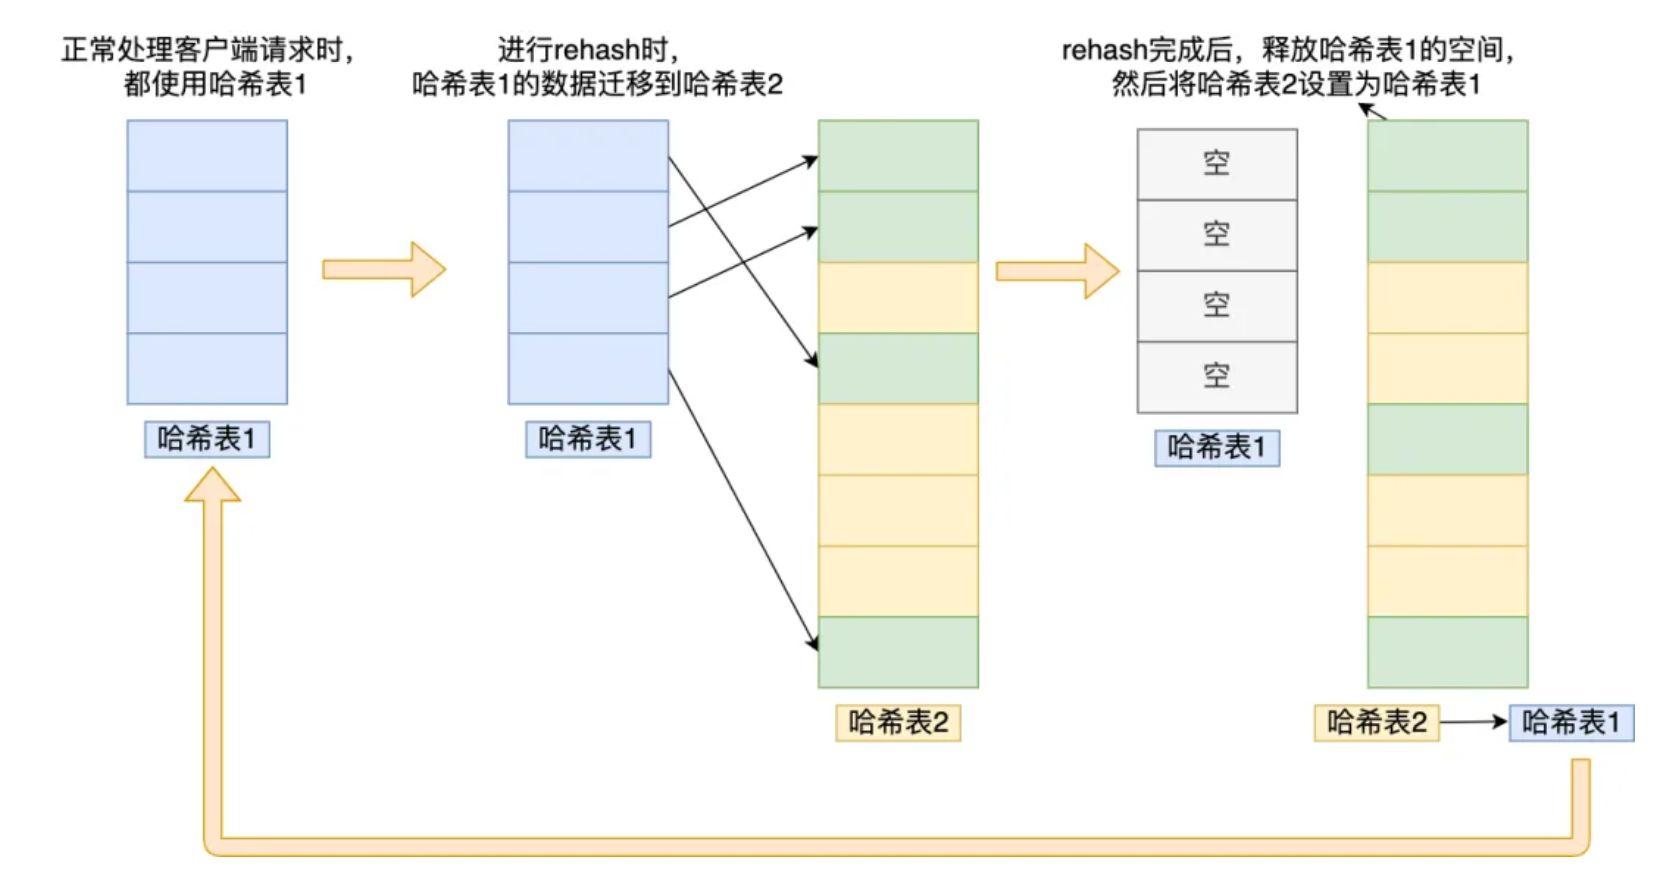
进行 rehash 的时候,需要用上 2 个哈希表了。
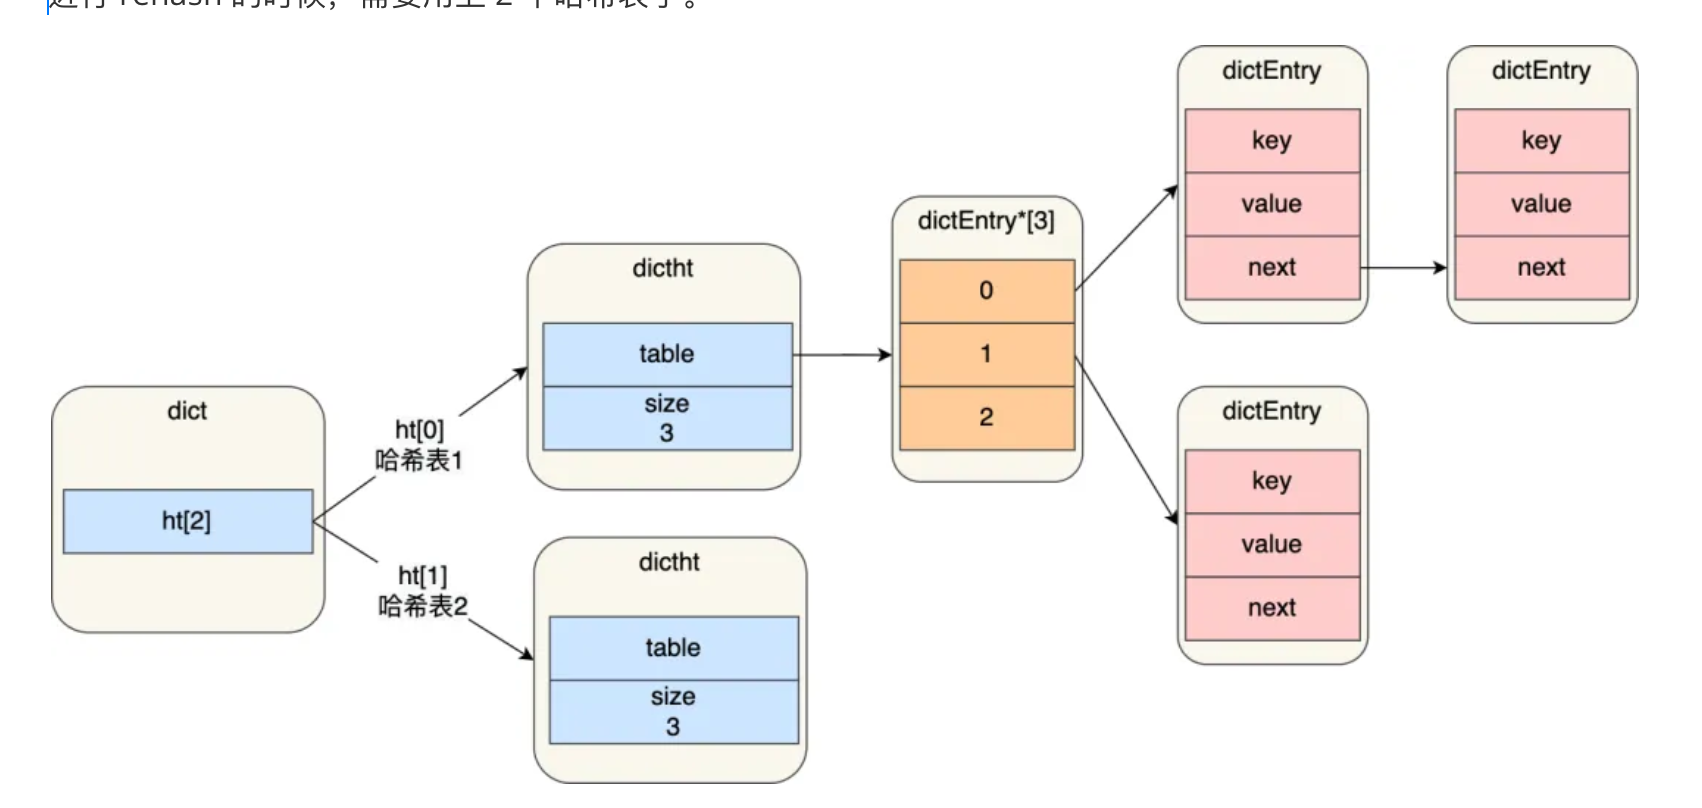
在正常服务请求阶段,插入的数据,都会写入到「哈希表 1」,此时的「哈希表 2 」 并没有被分配空间。
随着数据逐步增多,触发了 rehash 操作,这个过程分为三步:
- 给「哈希表 2」 分配空间,一般会比「哈希表 1」 大 2 倍;
- 将「哈希表 1 」的数据迁移到「哈希表 2」 中;
- 迁移完成后,「哈希表 1 」的空间会被释放,并把「哈希表 2」 设置为「哈希表 1」,然后在「哈希表 2」 新创建一个空白的哈希表,为下次 rehash 做准备。
为了方便你理解,我把 rehash 这三个过程画在了下面这张图:
这个过程看起来简单,但是其实第二步很有问题,如果「哈希表 1 」的数据量非常大,那么在迁移至「哈希表 2 」的时候,因为要重新计算桶位置并迁移大量节点,此时可能会对 Redis 造成阻塞,无法服务其他请求。
为了避免 rehash 在数据迁移过程中,因集中迁移节点的耗时,影响 Redis 性能的情况,所以 Redis 采用了渐进式 rehash,也就是将数据的迁移的工作不再是一次性迁移完成,而是分多次迁移。
渐进式 rehash 步骤如下:
- 给「哈希表 2」 分配空间;
- 在 rehash 进行期间,在处理哈希表的新增、删除、查找或者更新时,Redis 通常会顺便迁移一部分旧表数据,比如把旧表某个桶中的键值对迁移到新表,而不是每次把整张表搬过去;
- 随着处理客户端发起的哈希表操作请求数量越多,最终在某个时间点会把「哈希表 1 」的所有 key-value 迁移到「哈希表 2」,从而完成 rehash 操作。
这样就巧妙地把一次性大量数据迁移工作的开销,分摊到了多次处理请求的过程中,避免了一次性 rehash 的耗时操作。
另外,Redis 还会在周期性任务中按时间预算推进数据库字典的 rehash,不是只有客户端请求到来时才会迁移。渐进式 rehash 主要分摊的是迁移开销,新表的分配也会消耗时间和内存,不能理解为扩容完全没有成本。
在进行渐进式 rehash 的过程中,会有两个哈希表,所以在渐进式 rehash 进行期间,哈希表元素的删除、查找、更新等操作都会在这两个哈希表进行。比如,查找一个 key 的值的话,先会在「哈希表 1」 里面进行查找,如果没找到,就会继续到哈希表 2 里面进行找到。
另外,在渐进式 rehash 进行期间,新增一个 key-value 时,会被保存到「哈希表 2 」里面,而「哈希表 1」 则不再进行任何添加操作,这样保证了「哈希表 1 」的 key-value 数量只会减少,随着 rehash 操作的完成,最终「哈希表 1 」就会变成空表。
# 哈希表扩容的时候,有读请求怎么查?
查找一个 key 的值的话,先会在「哈希表 1」 里面进行查找,如果没找到,就会继续到哈希表 2 里面进行找到。
# String 是使用什么存储的?为什么不用 c 语言中的字符串?
Redis 的 String 对象有 int、embstr 和 raw 三种编码。其中 embstr 和 raw 用 SDS 保存字符串,int 编码则直接保存整数值。所以,如果面试官问字符串为什么不用 C 字符串,主要就是在问 SDS 的优势。
下图就是 Redis 5.0 的 SDS 的数据结构:
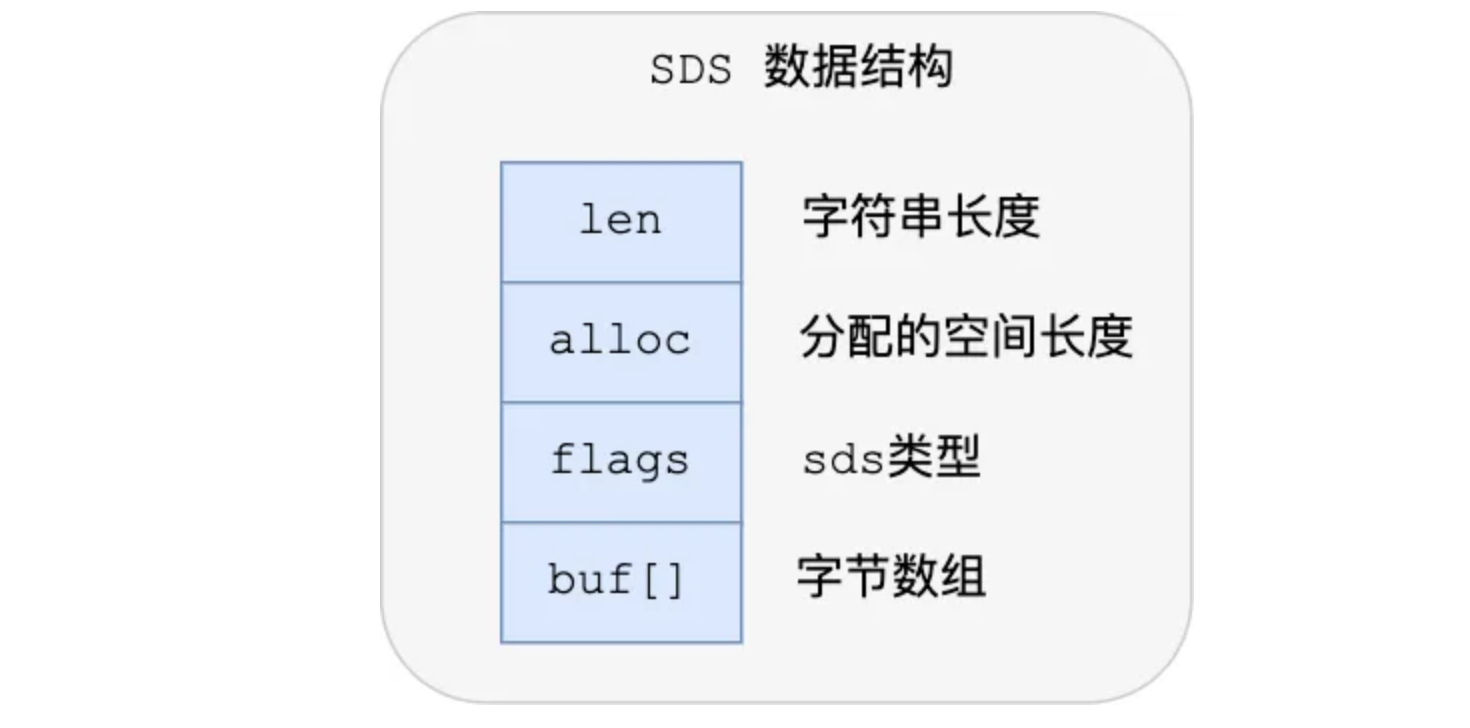
结构中的每个成员变量分别介绍下:
- len,记录了字符串长度。这样获取字符串长度的时候,只需要返回这个成员变量值就行,时间复杂度只需要 O(1)。
- alloc,分配给字符数组的空间长度。这样在修改字符串的时候,可以通过
alloc - len计算出剩余的空间大小,可以用来判断空间是否满足修改需求,如果不满足的话,就会自动将 SDS 的空间扩展至执行修改所需的大小,然后才执行实际的修改操作,所以使用 SDS 既不需要手动修改 SDS 的空间大小,也不会出现前面所说的缓冲区溢出的问题。 - flags,用来表示不同类型的 SDS。一共设计了 5 种类型,分别是 sdshdr5、sdshdr8、sdshdr16、sdshdr32 和 sdshdr64,用不同大小的头部适配不同长度的字符串,减少元数据开销。
- buf[],字符数组,用来保存实际数据。不仅可以保存字符串,也可以保存二进制数据。
总的来说,SDS 在字符数组之外保存长度、容量和类型等信息,用来解决 C 语言字符串的缺陷。上面是常见 SDS 头部的示意;sdshdr5 比较特殊,会把长度编码在 flags 中,不单独保存 len 和 alloc。
O(1)复杂度获取字符串长度
C 语言的字符串长度获取 strlen 函数,需要通过遍历的方式来统计字符串长度,时间复杂度是 O(N)。
而 Redis 的 SDS 结构因为加入了 len 成员变量,那么获取字符串长度的时候,直接返回这个成员变量的值就行,所以复杂度只有 O(1)。
二进制安全
因为 SDS 不依赖 “\0” 字符来判断实际数据的结尾,而是有个专门的 len 成员变量来记录长度,所以可存储包含 “\0” 的数据。但是 SDS 为了兼容部分 C 语言标准库的函数, SDS 字符串结尾还是会加上 “\0” 字符。
因此, SDS 的 API 都是以处理二进制的方式来处理 SDS 存放在 buf[] 里的数据,程序不会对其中的数据做任何限制,数据写入的时候是什么样的,它被读取时就是什么样的。
通过使用二进制安全的 SDS,而不是 C 字符串,使得 Redis 不仅可以保存文本数据,也可以保存任意格式的二进制数据。
不会发生缓冲区溢出
C 语言的字符串标准库提供的字符串操作函数,大多数(比如 strcat 追加字符串函数)都是不安全的,因为这些函数把缓冲区大小是否满足操作需求的工作交由开发者来保证,程序内部并不会判断缓冲区大小是否足够用,当发生了缓冲区溢出就有可能造成程序异常结束。
所以,Redis 的 SDS 结构里引入了 alloc 和 len 成员变量,这样 SDS API 通过 alloc - len 计算,可以算出剩余可用的空间大小,这样在对字符串做修改操作的时候,就可以由程序内部判断缓冲区大小是否足够用。
而且,当判断出缓冲区大小不够用时,Redis 会自动扩大 SDS 的空间大小,以满足修改所需的大小。
# String 的 int、embstr 和 raw 编码有什么区别?
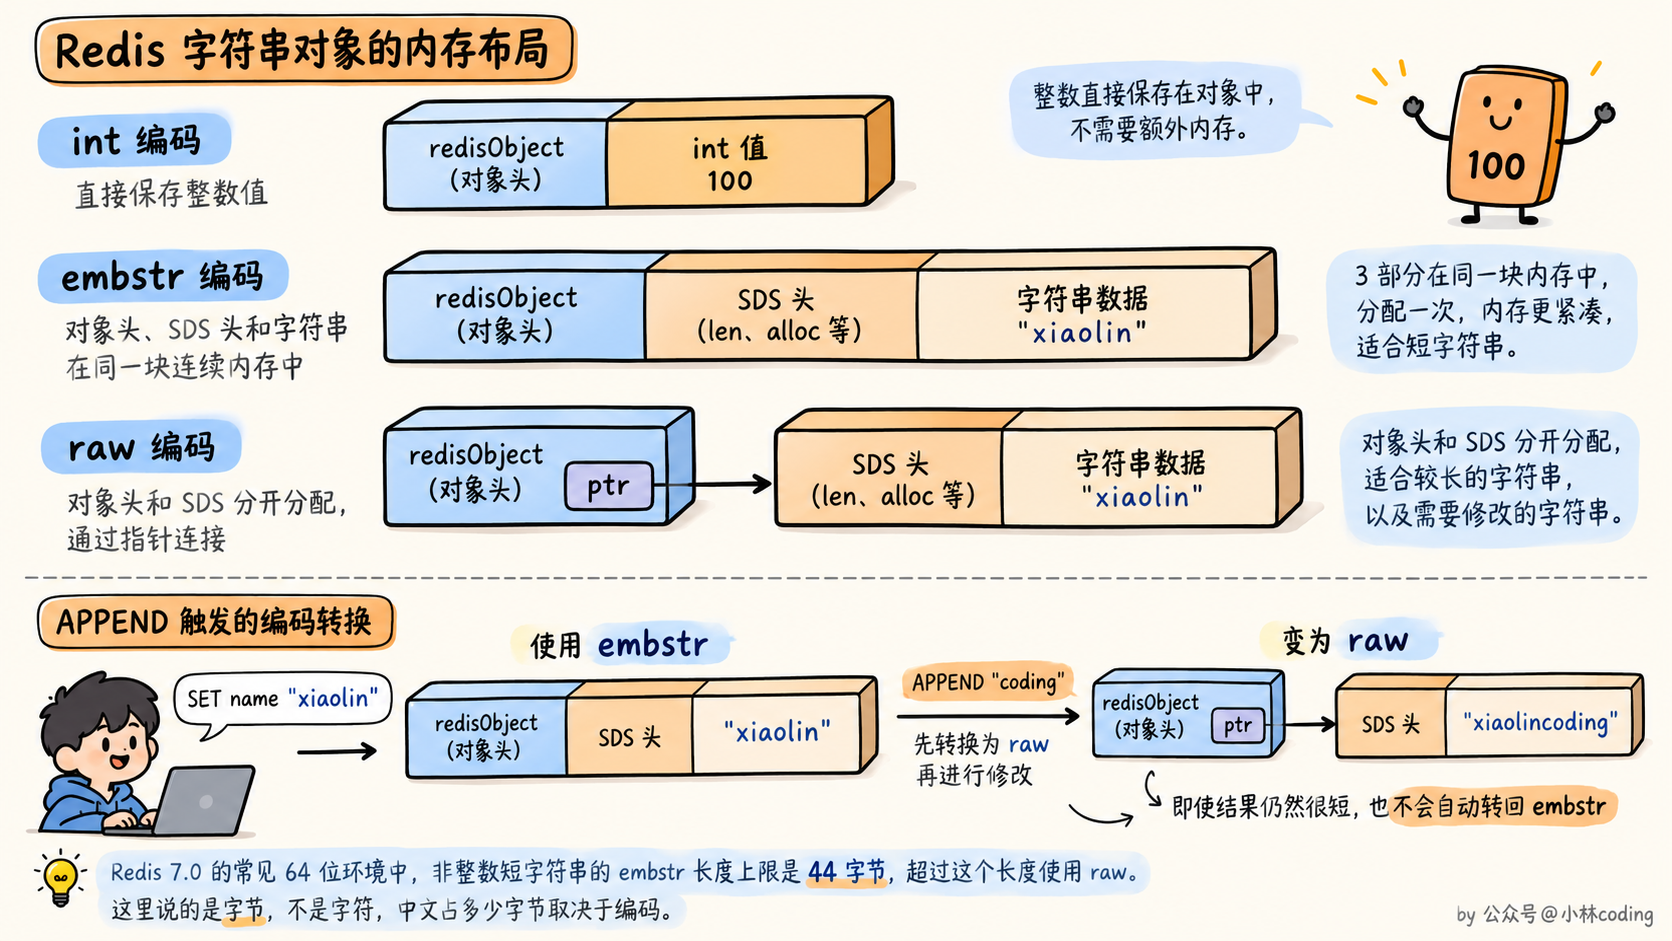
String 是数据类型,int、embstr、raw 是它的三种底层编码,客户端使用时看到的仍然都是 String。
- int:当字符串可以表示为符合范围的整数时,Redis 会尝试直接保存整数值,减少字符串的内存开销。
- embstr:用于较短的字符串,把 Redis 对象头和 SDS 放在同一块内存里,一次分配就能完成,内存比较紧凑。
- raw:对象头和 SDS 分开分配,适合较长的字符串,以及需要修改的字符串。
以 Redis 7.0 的常见 64 位环境为例,非整数短字符串的 embstr 长度上限是 44 字节,超过这个长度使用 raw。这里说的是字节,不是字符,中文占多少字节取决于编码。
embstr 也不是一直不变。比如对 embstr 字符串执行 APPEND 时,会先转换成 raw,再进行修改,即使修改后的长度仍然很短,也不会因为短就自动转回 embstr。
可以使用 OBJECT ENCODING 查看实际编码:
SET counter 100
OBJECT ENCODING counter
# int
SET name xiaolin
OBJECT ENCODING name
# embstr
APPEND name coding
OBJECT ENCODING name
# raw
# 缓存一个对象,用 String 还是 Hash?
两种都可以,主要看是整体读写,还是经常只操作部分字段。
如果商品详情总是整体返回,可以把对象序列化成 JSON,用 String 保存。这样一次 GET 就能拿到完整结果,也方便设置整个对象的过期时间。
如果经常只修改或读取几个字段,比如购物车里某个商品的数量,用 Hash 会更方便,可以用 HGET、HMGET、HSET、HINCRBY 操作字段,不需要每次都读取和序列化整个对象。
不过,Hash 不一定总比 String 节省内存。小 Hash 使用 listpack 时通常比较紧凑,但超过限制转成哈希表后,字段和节点本身也会增加开销,最好结合实际数据用 MEMORY USAGE 比较。
另外,以 Redis 7.0 为例,过期时间设置在整个 Hash key 上,不能让每个字段独立过期;Redis 7.4 才开始提供 Hash 字段过期能力。设计时要结合使用的版本,不能把新版本能力默认套到所有环境里。
# redis的Zset,在项目里具体用法是什么?
Redis 的 Zset(有序集合)在项目里的核心用法是需要给元素排序、取排名、按分数范围筛选的场景,因为它既能像 Set 一样保证元素唯一,又能给每个元素关联一个分数,自动按分数排序,查询效率还高。
最常用的场景是排行榜,比如游戏里的玩家积分排名、电商的商品销量榜单、社区的用户贡献值排名。比如做游戏积分榜,把玩家 ID 作为元素,积分作为分数,用 ZADD 命令添加或更新玩家积分,想查前 10 名就用 ZREVRANGE(降序取前 10),想知道某个玩家的排名就用 ZREVRANK,还能通过 ZSCORE 查他的具体积分,这些操作都是实时的,效率很高。
然后是延迟任务队列,比如电商订单 30 分钟未支付自动取消、定时发送通知。这里用任务 ID 作为元素,把“任务执行时间戳”作为分数,消费者通过 ZRANGEBYSCORE 找出分数小于等于当前时间戳的任务。
这里有个并发问题:如果多个消费者都先查任务,再执行,最后删除,就可能重复执行。可以用 Lua 脚本把“查询到期任务”和“移出待执行集合”放在一起,让领取任务的过程具备原子性。
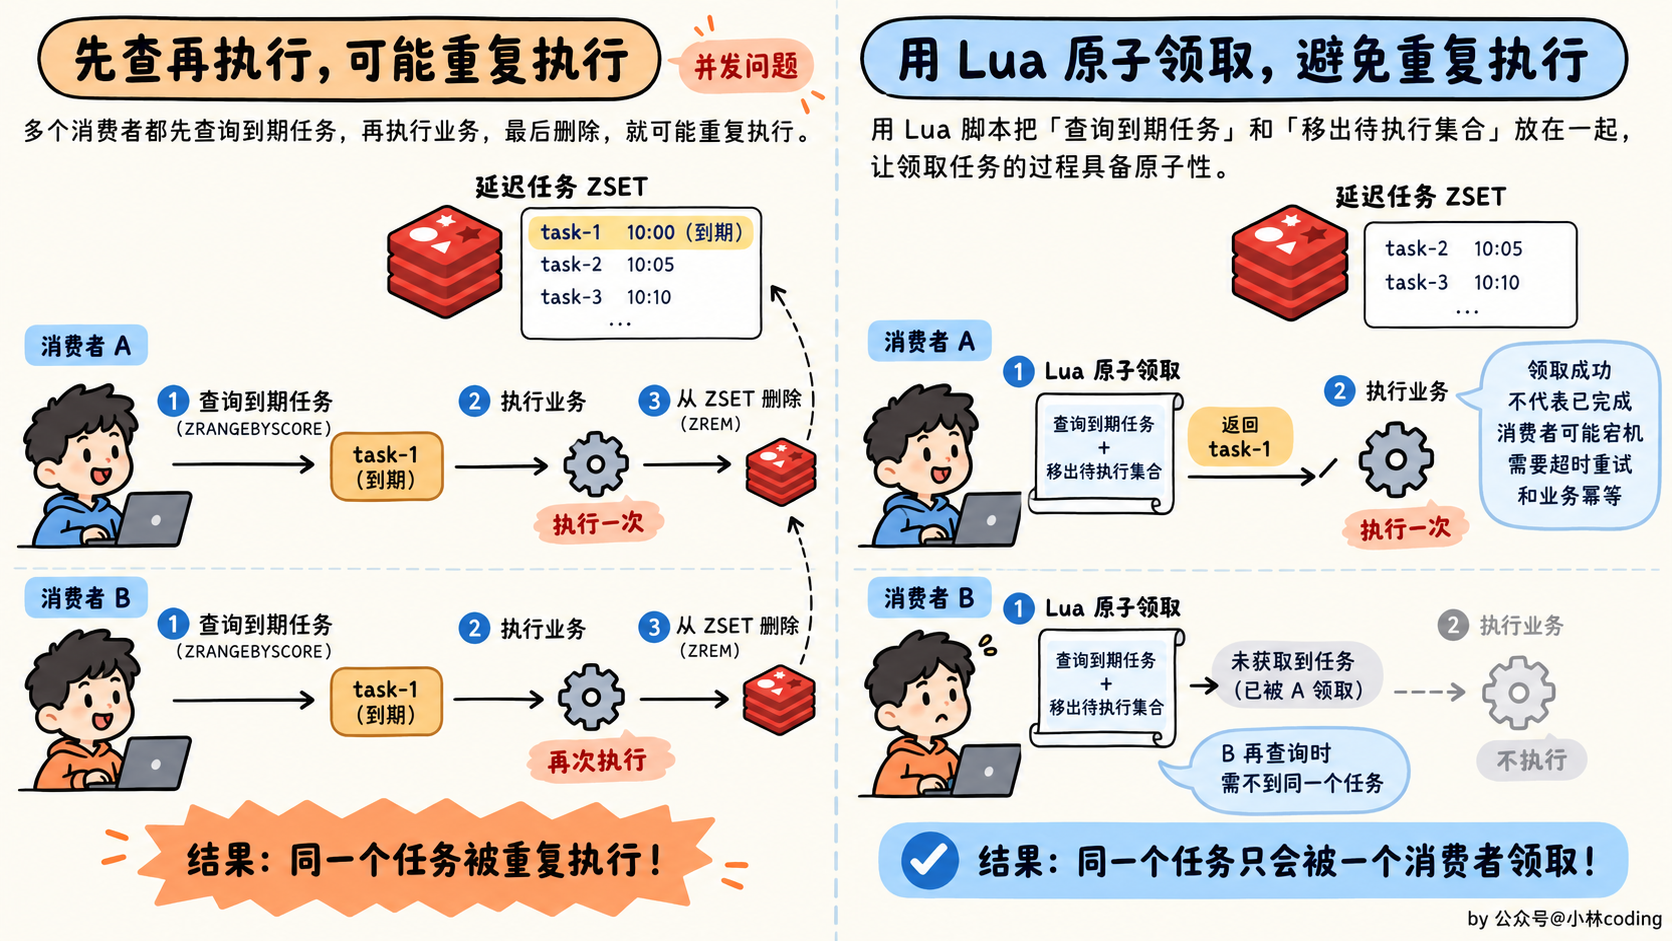
但领取之后消费者也可能宕机,所以重要任务还需要处理中的任务记录、超时重试和业务幂等。像取消订单,还应该在数据库里判断订单是否仍然未支付,不能只根据延迟任务就直接取消。
还有范围查询场景,比如查询 “积分在 1000-2000 之间的玩家”“销量前 50 到 100 名的商品”,直接用 ZRANGEBYSCORE 或 ZREVRANGEBYSCORE 就能快速筛选出来,比在数据库里做排序查询高效得多,尤其是数据量大的时候。
另外,还能用来做带权重的消息队列,给重要的消息设置更高的分数,消费者优先处理分数高的消息,保证核心业务的优先级。
# 线程模型
# Redis为什么快?
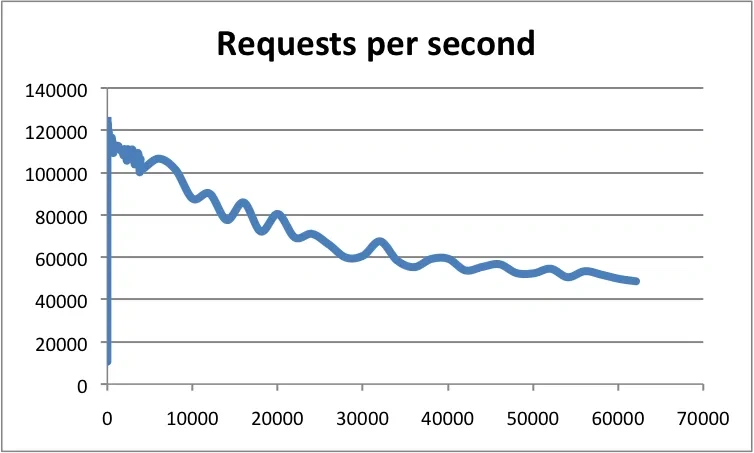
在合适的硬件、简单命令和较小数据的基准测试中,Redis 的吞吐量可以达到每秒十万级请求,如下图所示。不过,这不是所有业务场景下都能达到的固定指标,实际性能还要看命令复杂度、数据大小、网络和持久化配置。
以传统的单线程命令执行模型为例,Redis 快主要有以下几个原因:
- Redis 的大部分操作都在内存中完成,并且采用了高效的数据结构,普通键值查询的开销很小。但复杂命令、大 key 和长时间运行的 Lua 脚本,也可能让 CPU 成为瓶颈;
- Redis 采用单线程模型可以避免了多线程之间的竞争,省去了多线程切换带来的时间和性能上的开销,而且也不会导致死锁问题。
- Redis 采用了 I/O 多路复用机制处理大量的客户端 Socket 请求,IO 多路复用机制是指一个线程处理多个 IO 流,就是我们经常听到的 select/epoll 机制。简单来说,在 Redis 只运行单线程的情况下,该机制允许内核中,同时存在多个监听 Socket 和已连接 Socket。内核会一直监听这些 Socket 上的连接请求或数据请求。一旦有请求到达,就会交给 Redis 线程处理,这就实现了一个 Redis 线程处理多个 IO 流的效果。
# Redis哪些地方使用了多线程?
Redis 单线程主要指普通命令由主线程串行执行。在 Redis 6.0 之前,主要的网络 I/O 和命令执行都由主线程负责;Redis 6.0 引入可选的 I/O 多线程之后,网络读写可以交给 I/O 线程,但普通命令仍然由主线程执行。下面的线程配置以 Redis 6.0 的实现为例。
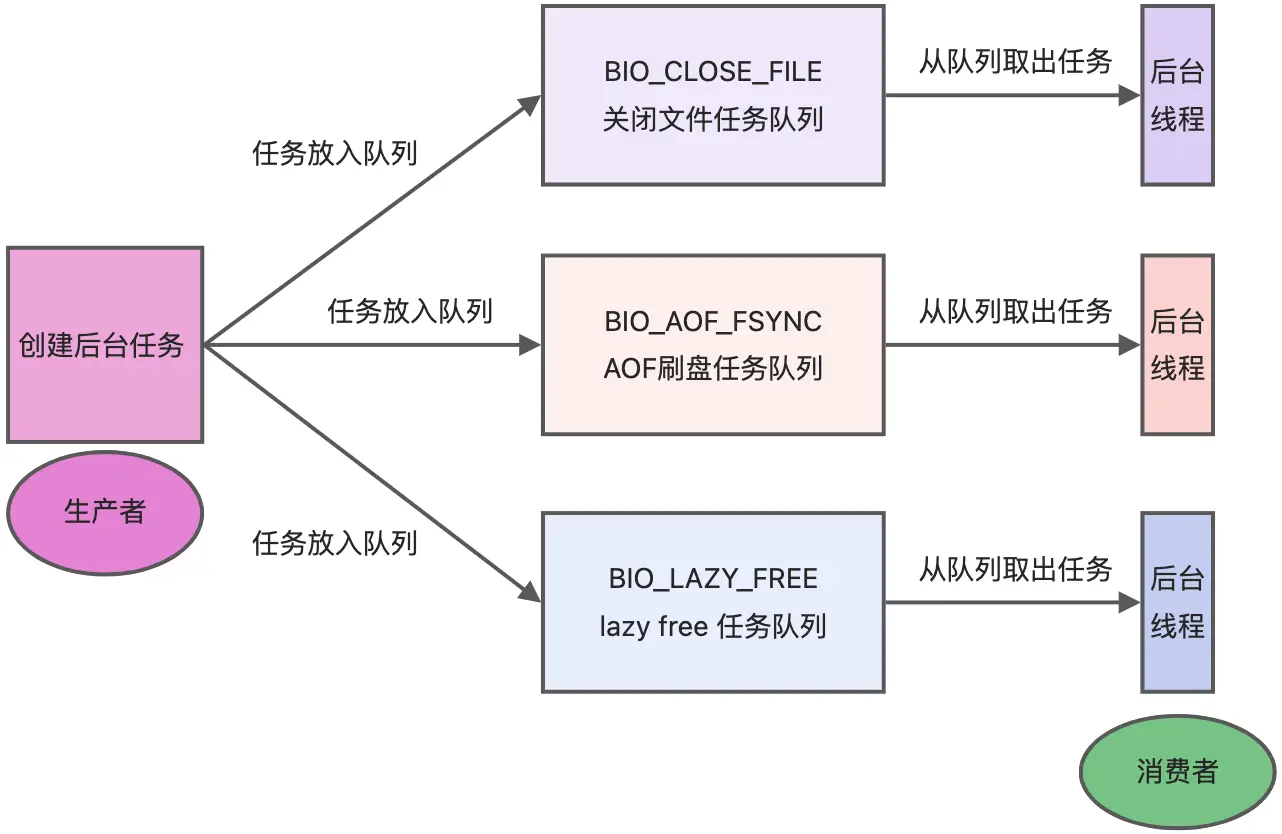
但是,Redis 程序并不是单线程的,Redis 在启动的时候,是会启动后台线程(BIO)的:
- Redis 在 2.6 版本,会启动 2 个后台线程,分别处理关闭文件、AOF 刷盘这两个任务;
- Redis 在 4.0 版本之后,新增了一个新的后台线程,用来异步释放 Redis 内存,也就是 lazyfree 线程。例如执行 unlink key / flushdb async / flushall async 等命令,会把这些删除操作交给后台线程来执行,好处是不会导致 Redis 主线程卡顿。因此,当我们要删除一个大 key 的时候,不要使用 del 命令删除,因为 del 是在主线程处理的,这样会导致 Redis 主线程卡顿,因此我们应该使用 unlink 命令来异步删除大key。
之所以 Redis 为「关闭文件、AOF 刷盘、释放内存」这些任务创建单独的线程来处理,是因为这些任务的操作都是很耗时的,如果把这些任务都放在主线程来处理,那么 Redis 主线程就很容易发生阻塞,这样就无法处理后续的请求了。
后台线程相当于一个消费者,主线程把耗时任务放进队列,BIO 线程被唤醒后取出任务执行;没有任务时会等待,并不是一直空转轮询。
虽然 Redis 的普通命令主要由单线程执行,但是从 Redis 6.0 开始,也可以启用多个 I/O 线程来处理网络请求,这是因为随着网络硬件的性能提升,Redis 的性能瓶颈有时会出现在网络 I/O 的处理上。
所以为了提高网络 I/O 的并行度,Redis 6.0 对于网络 I/O 采用多线程来处理。但是对于命令的执行,Redis 仍然使用单线程来处理,所以大家不要误解Redis 有多线程同时执行命令。
I/O 多线程在网络读写成为瓶颈时,可以提升吞吐量;如果瓶颈是复杂命令的执行,增加 I/O 线程就不一定有效,具体提升幅度要通过压测确认。
需要特别注意的是,Redis 6.0 的 I/O 多线程特性默认是关闭的——io-threads 配置项默认值为 1,意味着默认情况下仍然只由主线程处理所有的网络 I/O。官方 redis.conf 中明确写着 "By default threading is disabled",需要在配置文件里手动把 io-threads 设为大于 1 的值才会启用。
开启后,I/O 多线程默认只针对发送响应数据(write client socket),并不会以多线程的方式处理读请求(read client socket)。如果要让读请求也走 I/O 多线程,就需要把 redis.conf 配置文件中的 io-threads-do-reads 配置项设为 yes:
# 启用 I/O 多线程,表示启用 N-1 个 I/O 线程(主线程也算一个 I/O 线程)
io-threads 4
# 读请求也使用 I/O 多线程
io-threads-do-reads yes
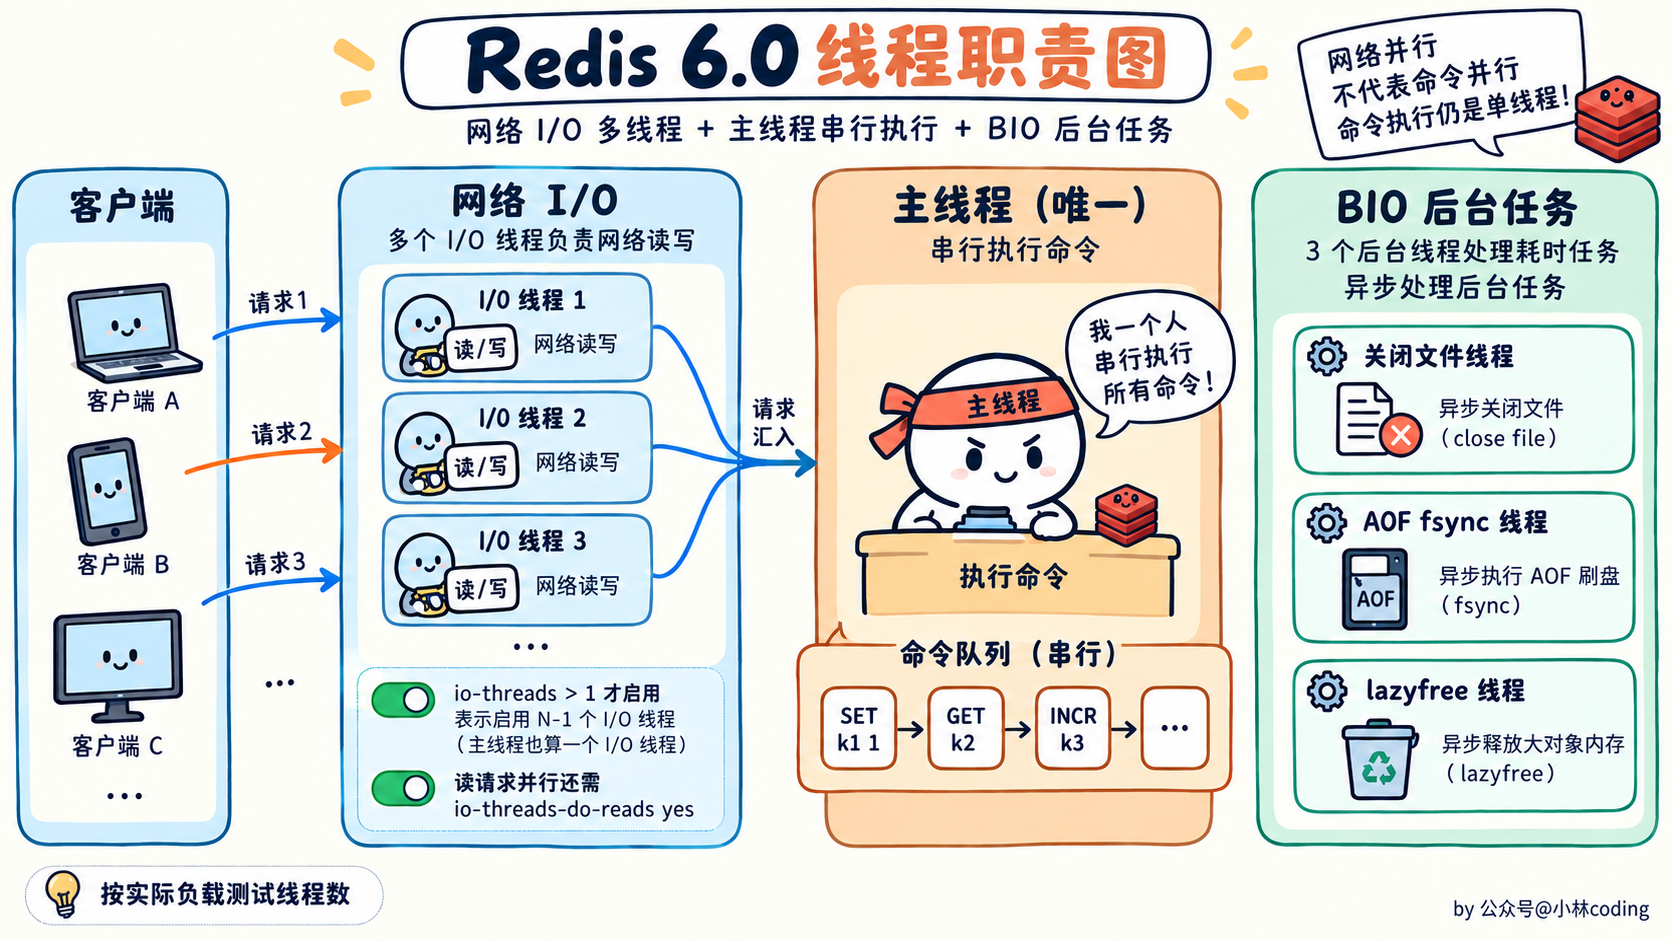
关于线程数的设置,官方的建议是 4 核 CPU 设置为 2 或 3,8 核 CPU 设置为 6,线程数一定要小于机器核数,线程数并不是越大越好。
因此,如果不手动开启 I/O 多线程,Redis 6.0 启动时只会比单线程模型额外创建 3 个后台线程(即 BIO 线程):
- Redis-server:Redis 的主线程,负责执行命令和网络 I/O;
- bio_close_file、bio_aof_fsync、bio_lazy_free:三个 BIO 后台线程,分别异步处理关闭文件任务、AOF 刷盘任务、释放内存任务。
如果在配置文件中显式开启了 io-threads N(N > 1),则会在此之上再额外创建 N-1 个 I/O 线程,例如设置 io-threads 4 时,会再启动 io_thd_1、io_thd_2、io_thd_3 三个 I/O 线程,用来分担 Redis 网络 I/O 的压力。
# Redis怎么实现的io多路复用?
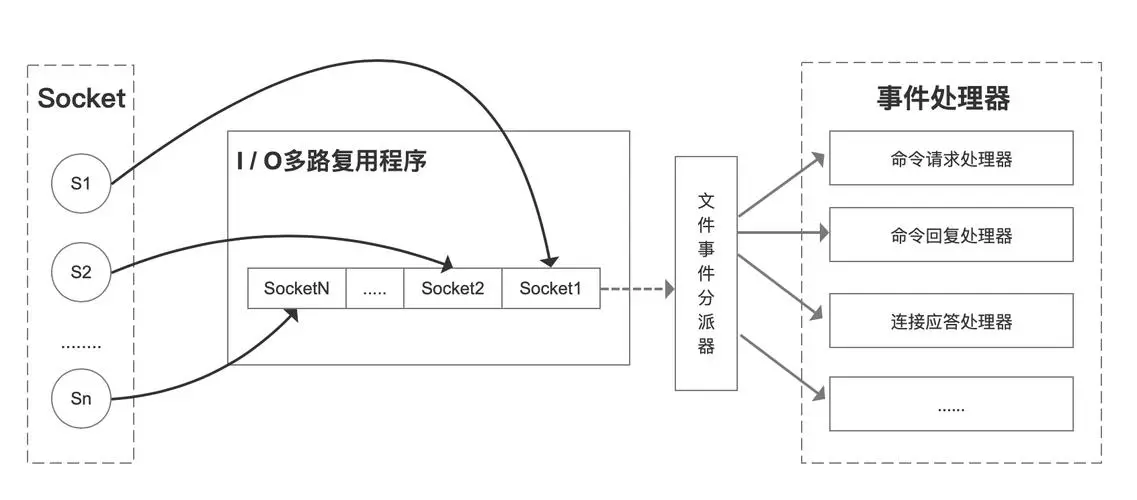
Redis 使用 I/O 多路复用 + 非阻塞 Socket,让一个事件循环处理多个客户端连接。
这里“多路”指多个网络连接,“复用”指复用同一个线程来等待和处理这些连接的事件。如果一个线程阻塞在某个客户端的读取操作上,其他客户端就只能跟着等待,所以 Redis 不会对每个连接都做阻塞式等待。
以 Linux 上的 epoll 为例,过程可以分成三步:
- Redis 把监听 Socket、客户端 Socket 的文件描述符注册到事件循环,关注可读、可写等事件。
- 调用 epoll 等待就绪事件。内核发现某个连接有数据可读,或者发送缓冲区可以继续写入时,通知 Redis。
- Redis 调用对应的事件处理函数,读取请求、解析命令、执行命令,再把响应发送给客户端。如果一次没有读完或者写完,就等下一次就绪事件继续处理。
这里要注意,epoll 通知的是 Socket 的就绪状态,不会替 Redis 解析命令,也不会替 Redis 执行命令。命令处理仍然是 Redis 自己的工作。
这个模型可以理解为 Reactor 模式。I/O 多路复用解决的是等待多个连接的问题,但不能避免所有阻塞。如果主线程执行了一条很慢的命令,其他客户端仍然需要等待。
# Redis的网络模型是怎样的?
Redis 6.0 版本之前,是用的是单Reactor单线程的模式
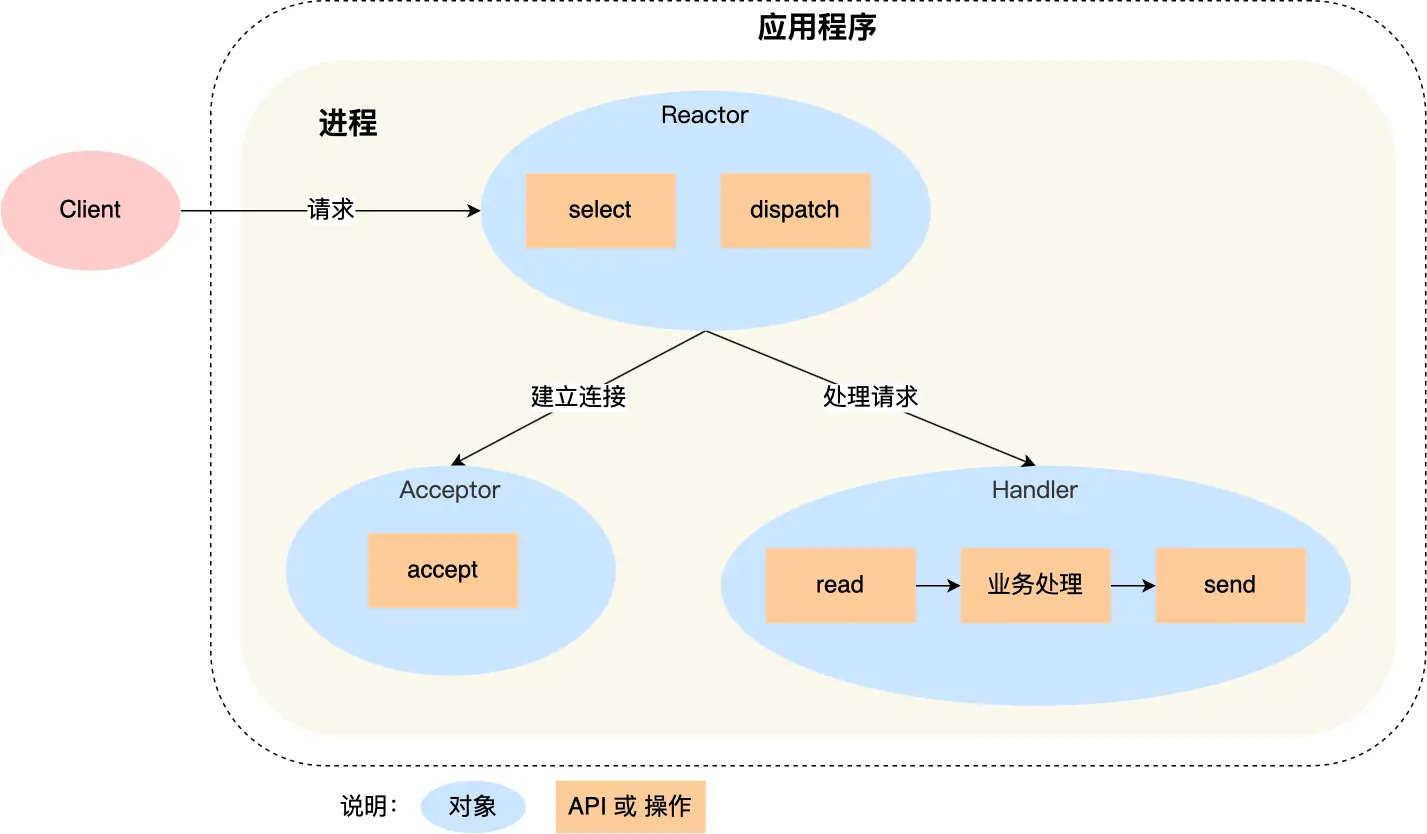
单 Reactor 单进程的方案因为全部工作都在同一个进程内完成,所以实现起来比较简单,不需要考虑进程间通信,也不用担心多进程竞争。
但是,这种方案存在 2 个缺点:
- 第一个缺点,因为只有一个进程,无法充分利用 多核 CPU 的性能;
- 第二个缺点,Handler 对象在业务处理时,整个进程是无法处理其他连接的事件的,如果业务处理耗时比较长,那么就造成响应的延迟;
所以,单 Reactor 单进程的方案不适用计算密集型的场景,只适用于业务处理非常快速的场景。
Redis 是由 C 语言实现的,在 Redis 6.0 版本之前采用的正是「单 Reactor 单进程」的方案,因为 Redis 业务处理主要是在内存中完成,操作的速度是很快的,性能瓶颈不在 CPU 上,所以 Redis 对于命令的处理是单进程的方案。
从 Redis 6.0 开始,可以通过配置开启网络 I/O 多线程,这是因为随着网络硬件的性能提升,Redis 的性能瓶颈有时会出现在网络 I/O 的处理上。
所以为了提高网络 I/O 的并行度,Redis 6.0 对于网络 I/O 采用多线程来处理。但是对于命令的执行,Redis 仍然使用单线程来处理,所以大家不要误解 Redis 有多线程同时执行命令。
# 事务
# 如何实现redis 原子性?
Redis 普通命令由主线程串行执行,所以单条命令执行时,不会被其他客户端的命令插进来。比如 INCR,一个命令就能完成读取、加一、写回,多个客户端同时调用,也不会发生“都读到 10,最后都写成 11”的问题。
但如果应用先 GET,再在代码里加一,最后 SET,这就是两个命令了,中间可能被其他客户端修改,不能因为 Redis 是单线程就认为这一组操作也安全。
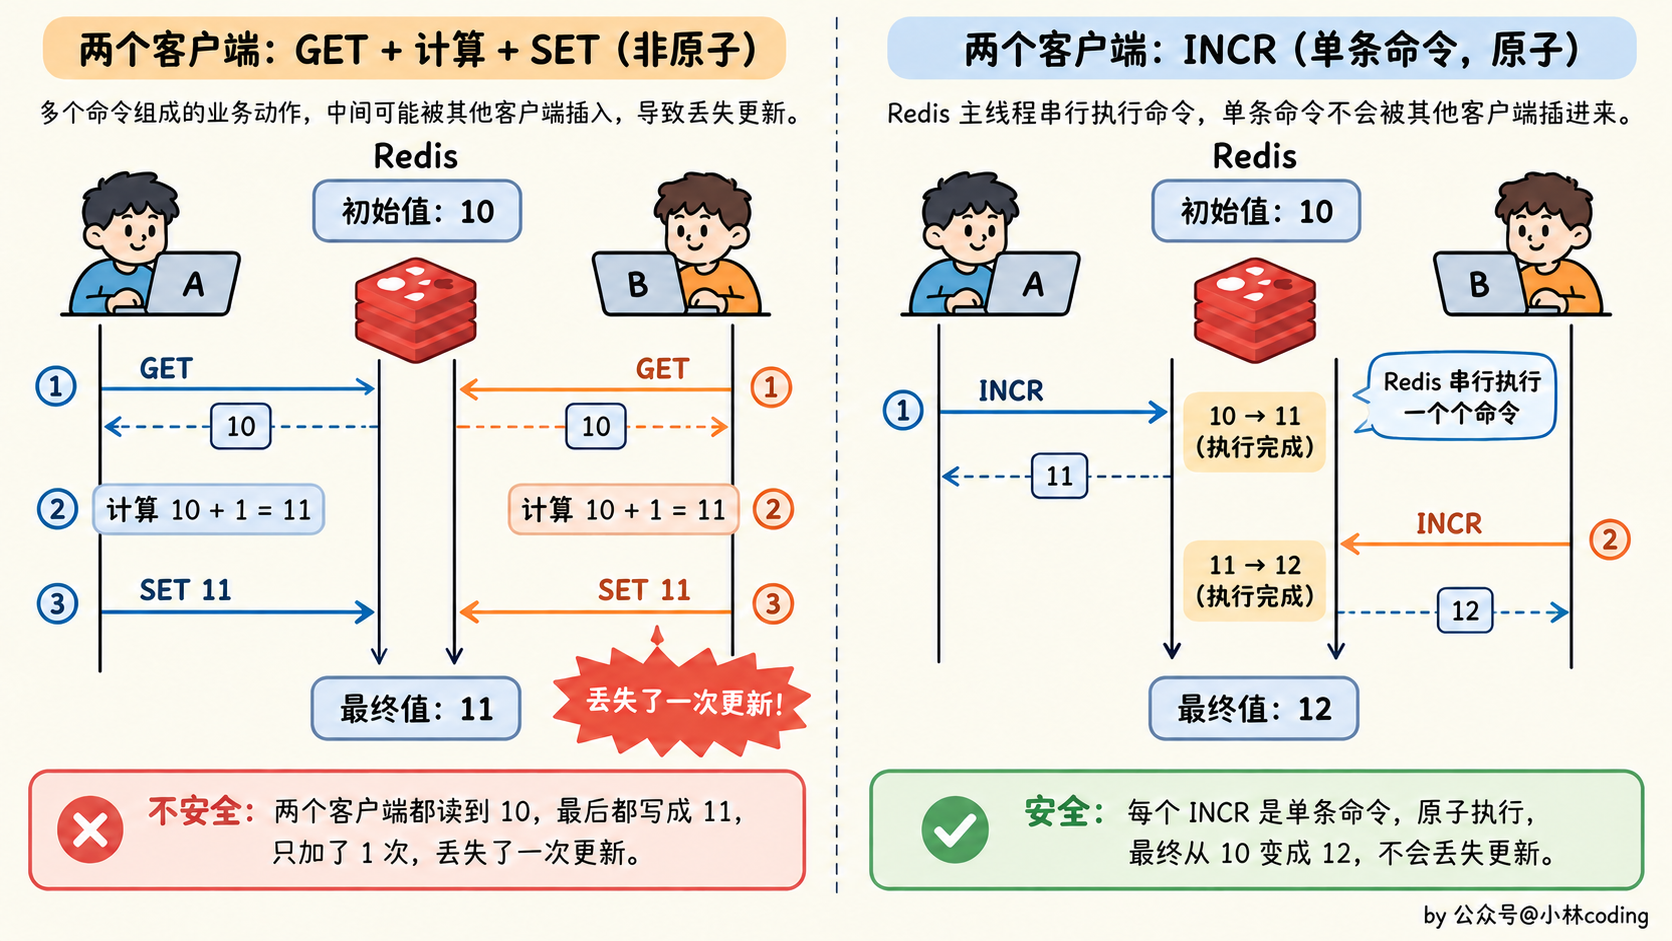
如果要保证多个相关操作不被其他命令打断,可以考虑用 Lua 脚本,把判断和修改放在 Redis 服务端一起执行。
比如分布式锁解锁,需要先判断锁是不是自己的,是自己的才能删除锁。用 Lua 可以避免“刚判断完,锁就过期并被别人拿走,接着又删掉别人的锁”的问题。
-- 释放锁时,先比较 unique_value 是否相等,避免锁的误释放
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
不过,Lua 的原子执行不等于出错后自动回滚。如果脚本先成功修改了一个 key,后面的命令报错,前面的修改不会撤销。因此,脚本应尽量先检查参数、数据类型和业务条件,再执行写操作。
另外,Lua 执行期间会占用主线程,不适合在脚本里做长时间循环或者扫描大量数据。在 Redis Cluster 中,脚本访问的多个 key 也需要位于同一个哈希槽。
# 除了lua有没有什么也能保证redis的原子性?
可以使用 Redis 事务,也就是 MULTI 和 EXEC,把多个命令放在一起执行。不过,回答这个问题时,要区分“执行过程不被打断”和“失败时全部回滚”。
MULTI 开启事务后,后面的命令先进入队列,直到收到 EXEC 才按顺序执行。事务执行期间,其他客户端的命令不会插到事务中间,但 Redis 不提供数据库事务那样的回滚机制。
发生错误时,要分两种情况:
- 入队时出错:比如命令不存在、参数数量不正确,Redis 会标记事务有错误,执行 EXEC 时拒绝执行整个事务。
- 执行时出错:比如对 String 使用 LPOP,只有这条命令失败,其他已入队的命令仍然会执行,已经成功的修改也不会回滚。
举个例子,先把 a:stock 设置为字符串,把 b:stock 设置为 9:
127.0.0.1:6379> SET a:stock 10
OK
127.0.0.1:6379> SET b:stock 9
OK
127.0.0.1:6379> MULTI
OK
127.0.0.1:6379> LPOP a:stock
QUEUED
127.0.0.1:6379> DECR b:stock
QUEUED
127.0.0.1:6379> EXEC
1) (error) WRONGTYPE Operation against a key holding the wrong kind of value
2) (integer) 8
可以看到,LPOP 执行失败了,但 DECR 还是执行成功了。因此,Redis 事务可以保证命令连续执行,但不保证出错时“要么全成功,要么全失败”。
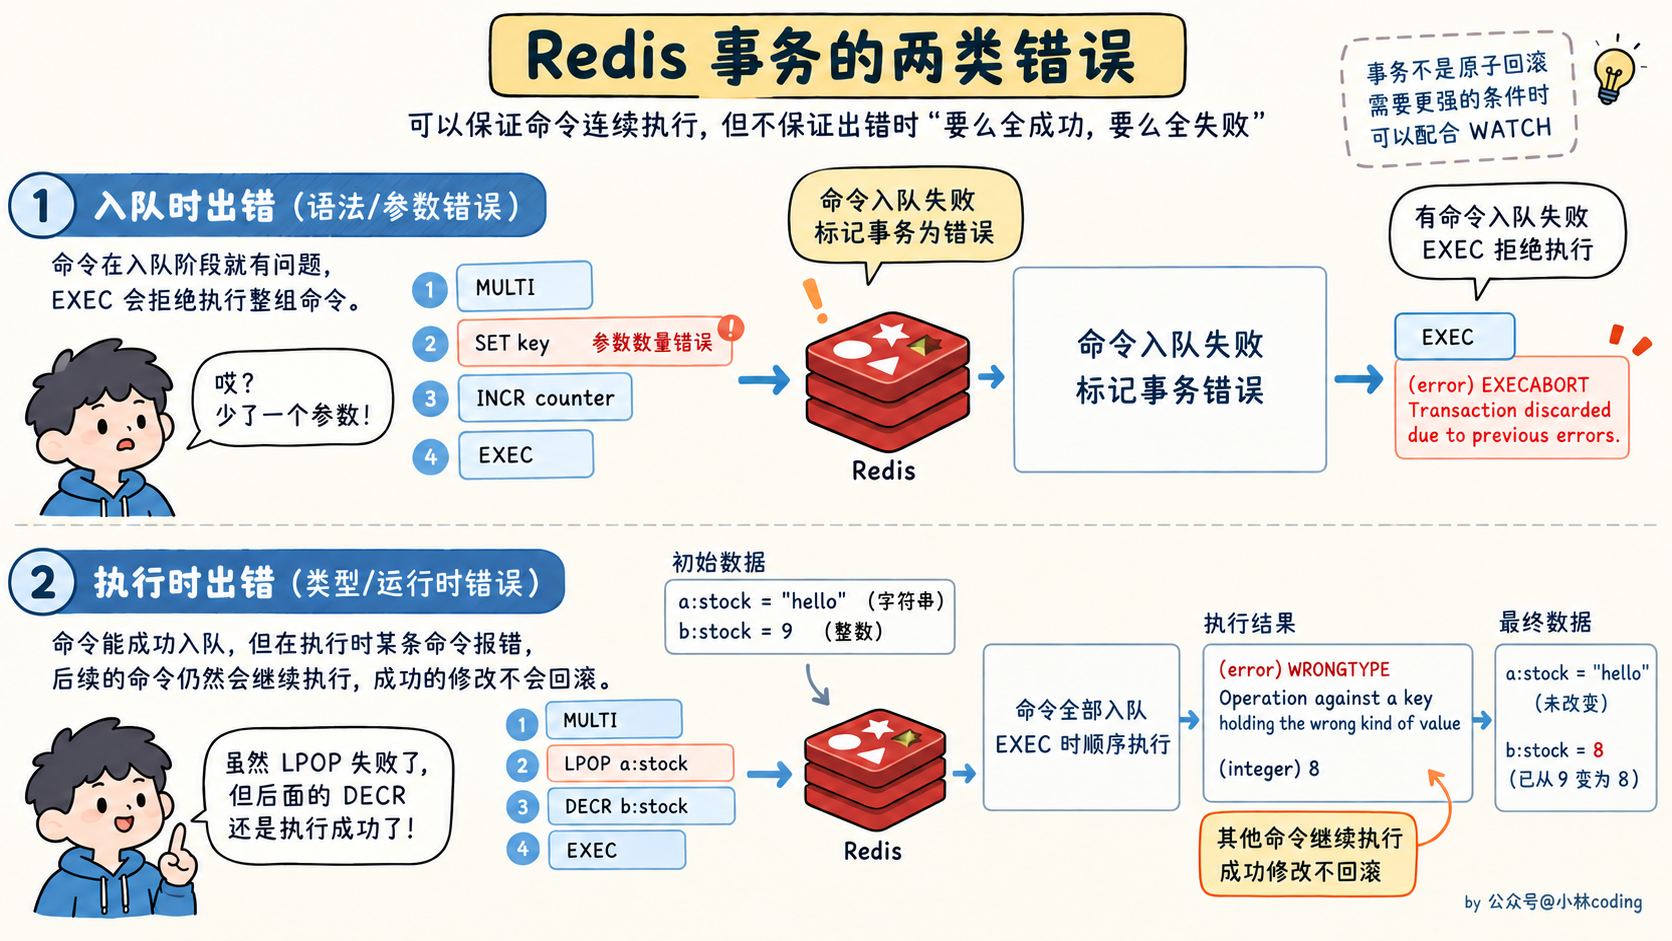
如果业务还需要根据读到的值决定是否更新,可以配合 WATCH 实现乐观锁。
# WATCH 是怎么实现乐观锁的?
WATCH 会监视指定的 key。如果这些 key 在 WATCH 之后、EXEC 之前发生变化,EXEC 就会放弃执行整个事务,返回空结果,由客户端决定是否重新读取并重试。
比如读取库存后,再根据读到的值扣减库存,可以按下面的顺序处理:
WATCH stock
读取当前库存
如果库存不足,UNWATCH 并返回失败
如果库存足够,计算扣减后的库存
MULTI
SET stock 新库存
EXEC
如果 EXEC 返回空结果,说明期间有变化,限次重试
这里的读取和业务判断发生在 MULTI 之前,WATCH 不会锁住这个 key,也不会阻止其他客户端修改它,所以叫乐观锁。
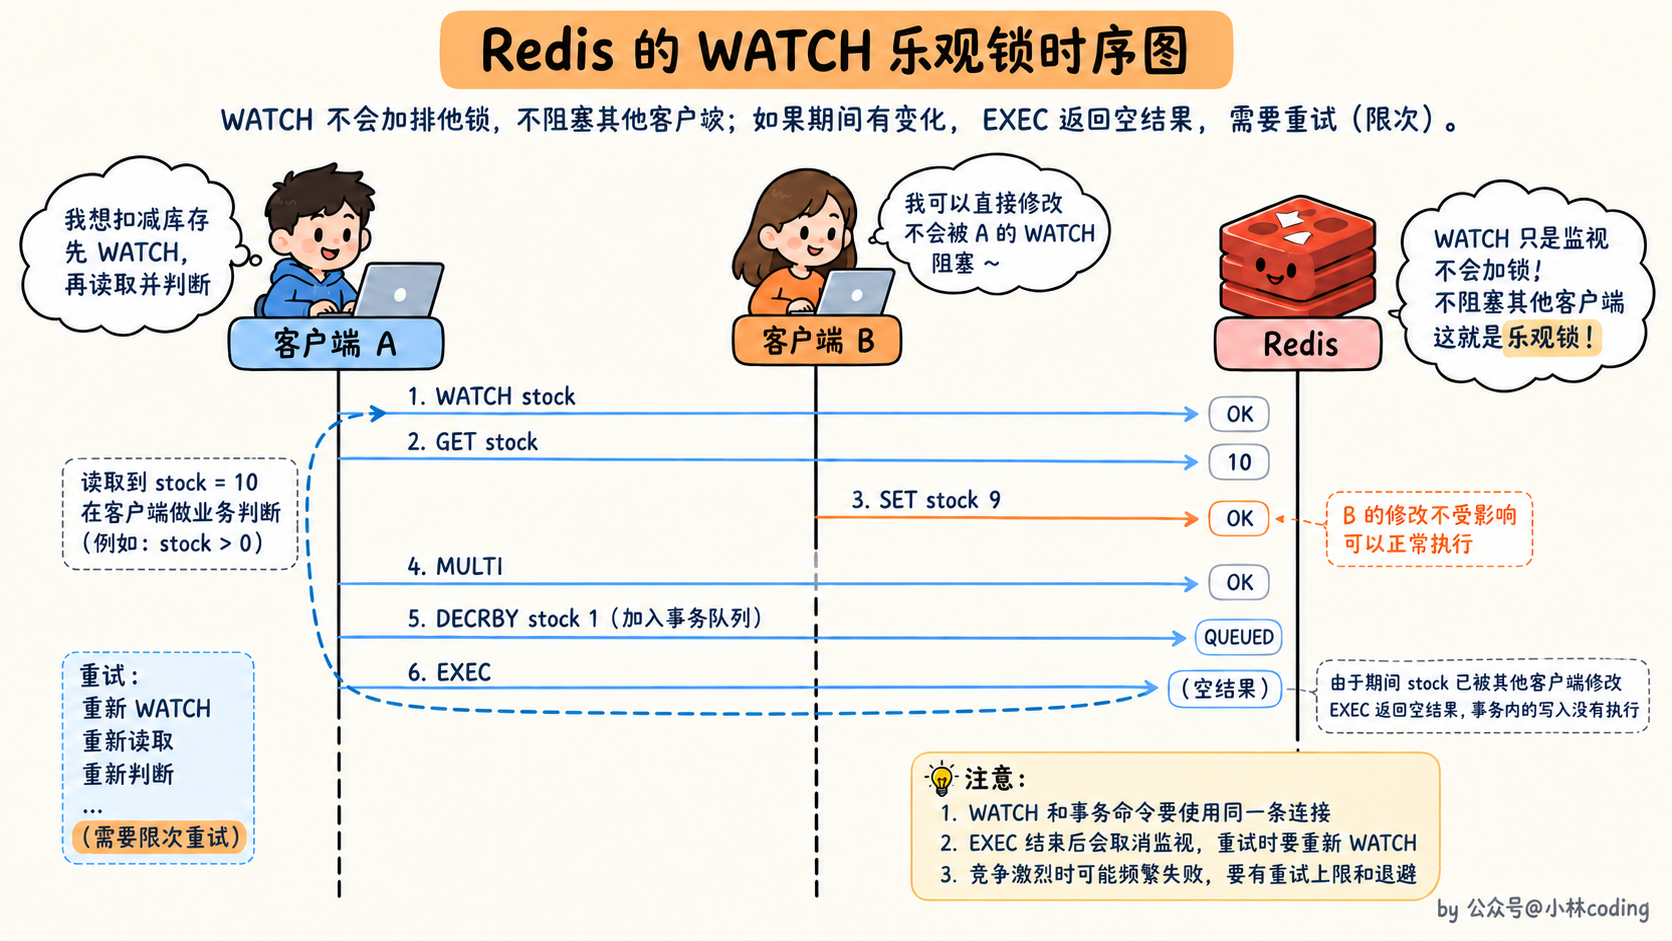
需要注意,WATCH 和事务命令要使用同一条连接。EXEC 结束后会取消监视,重试时要重新 WATCH;竞争激烈时可能频繁失败,因此要有重试上限和退避,不能无限重试。
对于简单扣减,如果能用一段 Lua 一次完成判断和修改,通常比客户端 WATCH、读取、再提交更直接。
# Pipeline 是什么?它能保证原子性吗?
Pipeline,也就是流水线,主要用来减少网络往返和网络读写的开销。
如果应用依次执行 100 条命令,每条都发出去等结果,再发下一条,就会产生很多次网络往返。Pipeline 可以先批量发送命令,再批量读取结果,特别适合互相独立的批量查询、写入。
不过,Pipeline 不是事务,也不是让 Redis 同时并行执行这些命令。同一连接上的命令仍然按顺序处理,但整批命令不保证不被其他客户端的请求穿插,也不提供失败回滚。
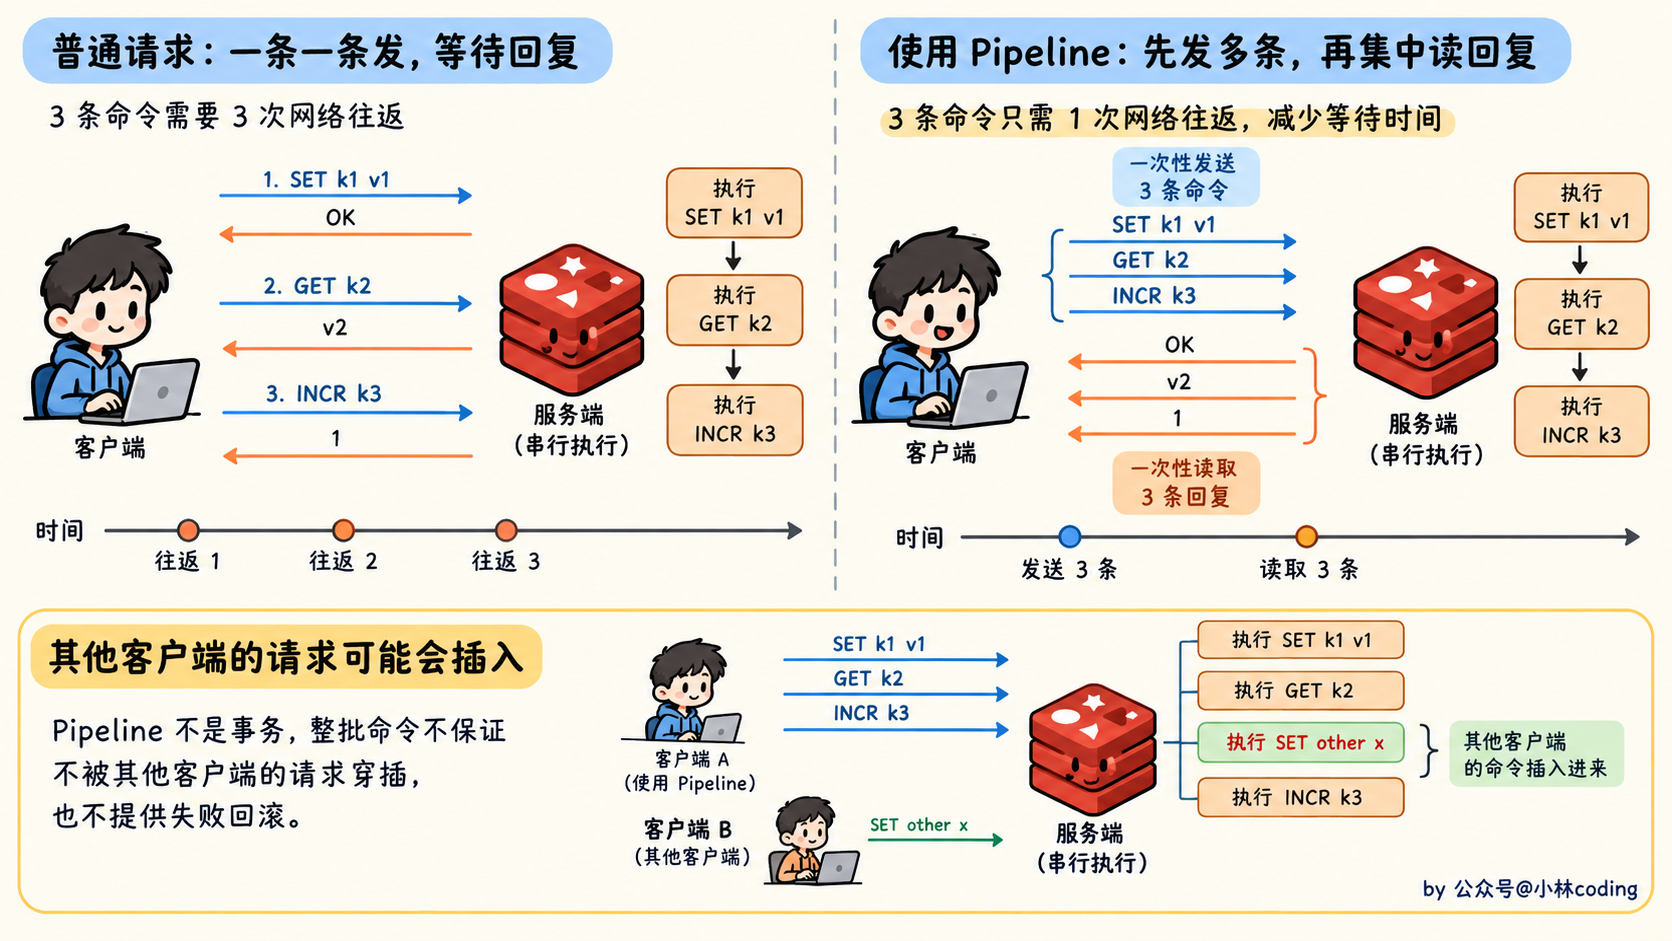
可以这样区分:
| 方式 | 主要解决什么问题 | 是否允许根据前面的结果做服务端判断 |
|---|---|---|
| Pipeline | 减少网络往返和系统调用开销 | 不能靠普通 Pipeline 在服务端完成这种判断 |
| MULTI / EXEC | 多条命令连续执行,避免其他命令插入 | 命令先排队,不能直接拿前面的结果决定后面的入队命令 |
| Lua | 把判断和修改放在服务端一起执行 | 可以 |
另外,Pipeline 的批次不能无限增大,Redis 需要缓存响应,客户端也要接收和处理结果,批次太大可能增加内存和延迟。请求超时后,还可能无法确认哪些命令已经执行,因此重试时也要考虑幂等。
# 日志
# Redis有哪些持久化方式?分别的优缺点是什么?
Redis 的读写操作都是在内存中,所以 Redis 性能才会高,但是当 Redis 重启后,内存中的数据就会丢失,那为了保证内存中的数据不会丢失,Redis 实现了数据持久化的机制,这个机制会把数据存储到磁盘,这样在 Redis 重启就能够从磁盘中恢复原有的数据。Redis 主要有 AOF 和 RDB 两种持久化机制,也可以使用混合持久化:
- AOF 日志:每执行一条写操作命令,就把该命令以追加的方式写入到一个文件里;
- RDB 快照:将某一时刻的内存数据,以二进制的方式写入磁盘;
- 混合持久化:Redis 4.0 新增的方式,集成了 AOF 和 RDB 的优点。开启后(通过配置
aof-use-rdb-preamble yes),AOF 重写生成的基础数据采用 RDB 格式,后续变化采用 AOF 命令格式。Redis 7.0 之前,它们保存在同一个 AOF 文件中;Redis 7.0 起,基础数据和增量命令分开保存,由 manifest 文件管理。重启恢复时先加载基础数据,再回放增量命令,兼顾恢复速度和数据安全性。
AOF 日志是如何实现的?
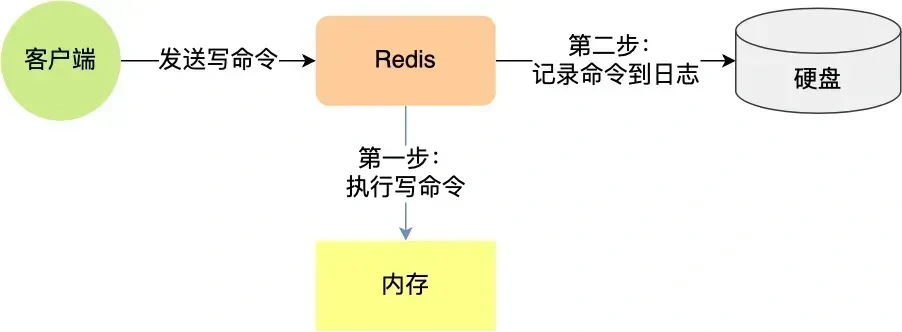
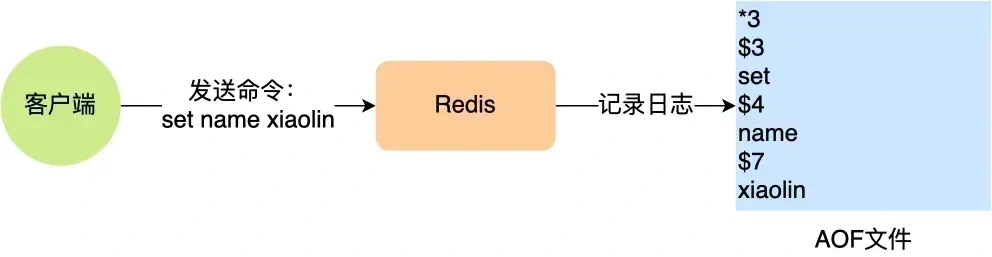
Redis 在执行完一条写操作命令后,就会把该命令以追加的方式写入到一个文件里,然后 Redis 重启时,会读取该文件记录的命令,然后逐一执行命令的方式来进行数据恢复。
我这里以「set name xiaolin」命令作为例子,Redis 执行了这条命令后,记录在 AOF 日志里的内容如下图:
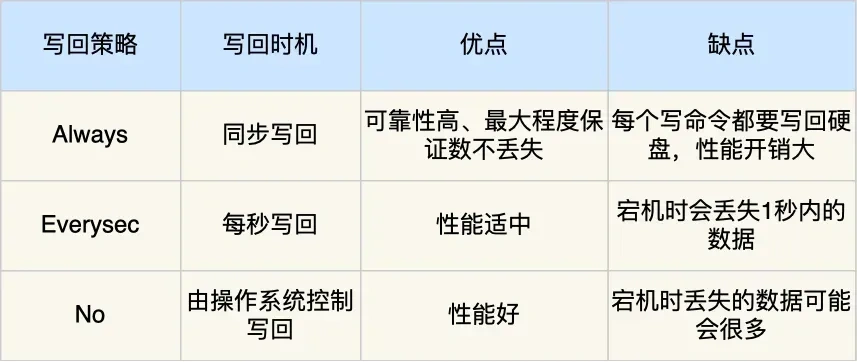
Redis 提供了 3 种写回硬盘的策略, 在 Redis.conf 配置文件中的 appendfsync 配置项可以有以下 3 种参数可填:
准确地说,Redis 执行写命令后,会先把命令追加到用户态的 aof_buf 缓冲区,然后在事件循环结束前调用 write() 把 aof_buf 的内容写入内核 page cache,最后由 fsync() 决定何时真正落盘。三种策略的区别就在于 fsync() 的时机:
- Always,每次把 AOF 缓冲区写入文件后,主线程都会调用
fsync(),在确认写入结果前完成同步刷盘。同一批处理的命令可以合并写入和刷盘,数据安全性高,但磁盘同步开销也大; - Everysec,先把命令写入
aof_buf,再由主线程调用write()写到内核 page cache,然后每隔 1 秒由后台线程调用一次fsync()将 page cache 中的内容刷到硬盘,通常把故障时的数据丢失控制在约 1 秒的范围;但如果磁盘卡顿、后台刷盘延迟,就不能把 1 秒当成绝对上限; - No,不主动调用
fsync(),只负责write()到内核 page cache,由操作系统自行决定何时刷盘,Redis 不保证具体落盘时间,数据丢失窗口也更难控制。
我也把这 3 个写回策略的优缺点总结成了一张表格:
RDB 快照是如何实现的呢?
纯命令格式的 AOF 记录的是写入操作,恢复时需要重新执行这些命令,日志很多时,恢复就会比较慢。而 RDB 保存的是某一时刻的数据快照,可以直接加载数据,通常恢复更快。混合持久化则把两者结合起来,不能把所有 AOF 都理解为只有命令。
所谓的快照,就是记录某一个瞬间东西,比如当我们给风景拍照时,那一个瞬间的画面和信息就记录到了一张照片。所以,RDB 快照就是记录某一个瞬间的内存数据,记录的是实际数据,而 AOF 文件记录的是命令操作的日志,而不是实际的数据。因此在 Redis 恢复数据时, RDB 恢复数据的效率会比 AOF 高些,因为直接将 RDB 文件读入内存就可以,不需要像 AOF 那样还需要额外执行操作命令的步骤才能恢复数据。
Redis 提供了两个命令来生成 RDB 文件,分别是 save 和 bgsave,他们的区别就在于是否在「主线程」里执行:
- 执行了 save 命令,就会在主线程生成 RDB 文件,由于和执行操作命令在同一个线程,所以如果写入 RDB 文件的时间太长,会阻塞主线程;
- 执行了 bgsave 命令,会 fork 一个子进程来生成 RDB 文件,快照写入由子进程完成。不过,fork 本身仍然会短暂阻塞主线程,数据量大时需要关注这部分延迟;
AOF和RDB优缺点
AOF:
- 优点:可以通过 always、everysec、no 等刷盘策略,在数据安全性和性能之间进行取舍。相比两次 RDB 快照之间的丢失窗口,everysec 通常能保留更多近期写入;还可以通过后台重写压缩日志体积。
- 缺点:纯命令格式的 AOF 通常比 RDB 大,恢复时需要重放命令,耗时可能更长。主线程的 write、always 策略下的 fsync,以及重写时的 fork,都可能带来延迟。AOF 损坏时可以使用 redis-check-aof 检查和修复,但修复可能截掉部分数据,并不是无损恢复。
RDB:
- 优点:文件紧凑,适合做备份和传输;恢复时直接加载数据,通常比重放大量 AOF 命令快。使用 BGSAVE 时,写快照的工作主要在子进程里完成。
- 缺点:故障时可能丢失最近一次成功快照之后的修改。fork 会带来短暂阻塞,生成快照期间如果写入频繁,写时复制还会增加内存占用。
如果 Redis 只是缓存,数据能够从数据库重建,可以根据恢复成本决定是否持久化;如果保存的是不能轻易重建的数据,就要结合允许的数据丢失范围,选择持久化、备份和复制方案,不能只看性能。
# AOF 重写是怎么实现的?
AOF 一直追加写命令,文件会越来越大,但恢复当前数据并不需要重放所有历史操作,所以 Redis 提供了 AOF 重写。
举个例子,先 SET counter 0,再 INCR 100 次,最后内存里的 counter 是 100。重写时,只需要生成能够恢复“counter 等于 100”的数据,不需要保留前面所有自增命令。
所以,AOF 重写是根据当前内存数据生成新的持久化内容,不是读取旧 AOF 再逐条合并命令。可以用 BGREWRITEAOF 手动触发,也可以根据文件大小和增长比例自动触发。
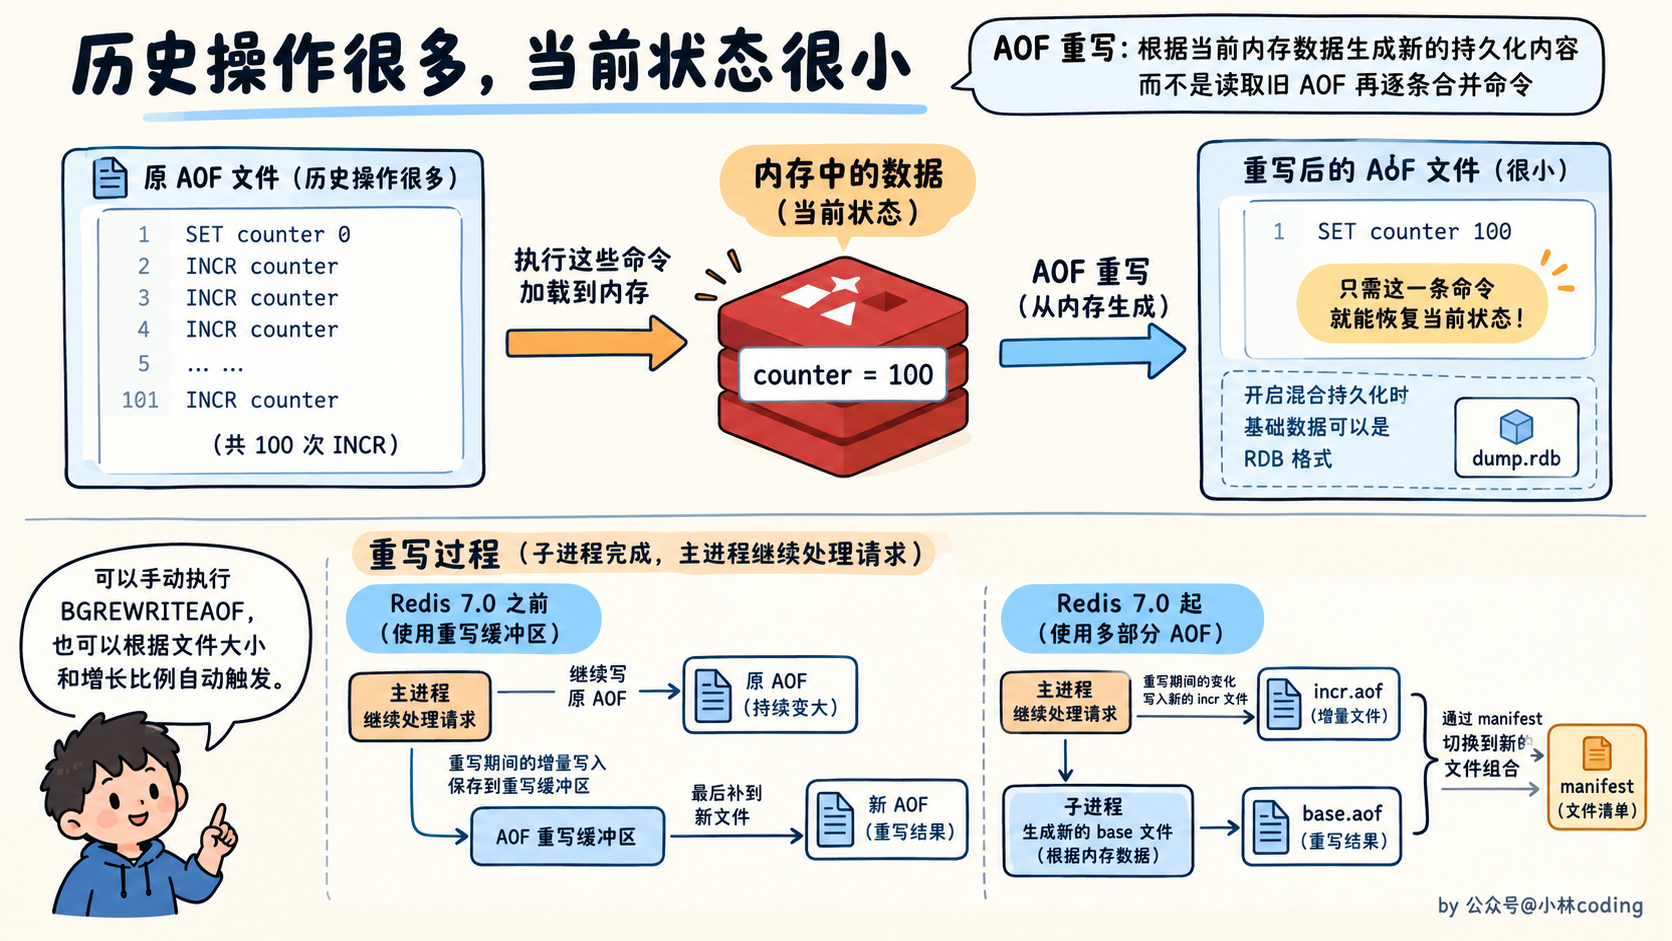
重写由子进程完成,主进程继续处理请求。那重写期间的新写入怎么办?这里要区分版本。
- Redis 7.0 之前:主进程继续写原 AOF,同时把重写期间的增量写入保存到 AOF 重写缓冲区,最后补到新文件,再切换到新 AOF。
- Redis 7.0 起:使用多部分 AOF。子进程生成新的 base 文件,主进程把重写期间的变化写到新的 incr 文件,完成后通过 manifest 切换到新的文件组合,减少了旧方案重写缓冲区和补写带来的开销。
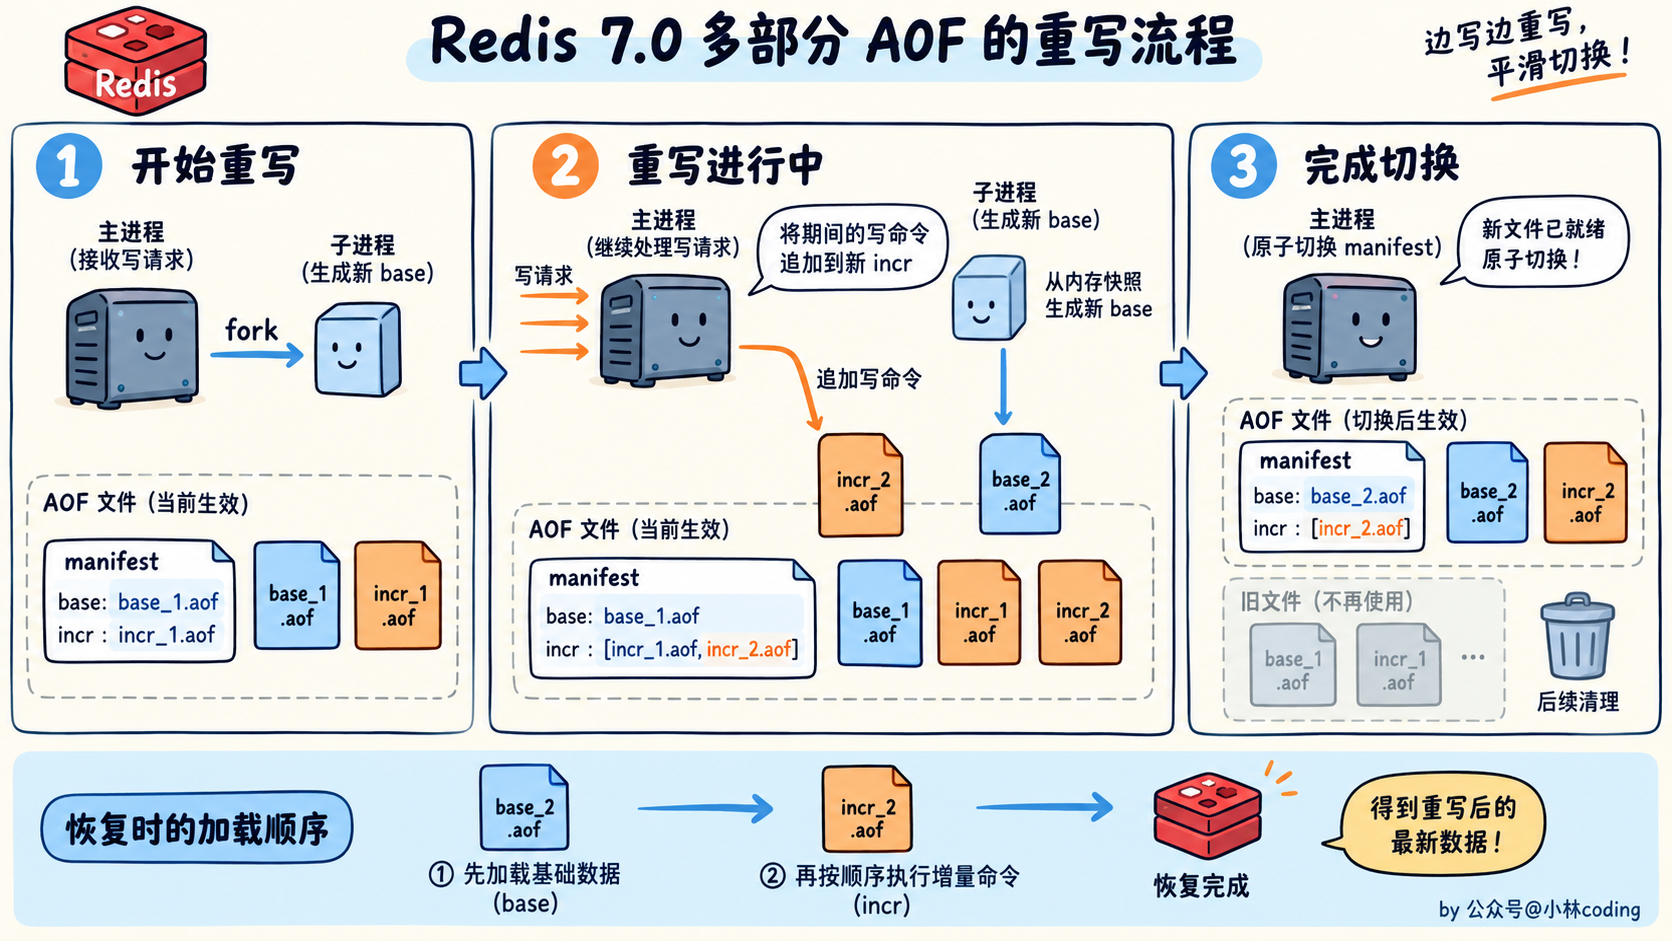
如果开启混合持久化,base 数据采用 RDB 格式;否则采用 AOF 命令格式。无论哪种格式,重写都要关注 fork、写时复制、磁盘空间和子进程 I/O,不能因为在后台执行就认为完全没有性能影响。
# BGSAVE 时还能修改数据吗?什么是写时复制?
可以。BGSAVE 会 fork 一个子进程生成快照,主进程仍然处理客户端请求。这里用到的是操作系统的 写时复制(Copy On Write,COW)。
fork 之后,父子进程最初共享已有的物理内存页,操作系统不会立即把所有数据完整复制一份。主进程要修改某个共享页时,才会复制这个页,让父子进程各自使用不同的物理页。
这样,子进程看到的仍然是 fork 时的数据视图,主进程则可以继续修改自己的数据。写时复制的单位通常是内存页,不是只复制被改动的那个 key。
举个例子,fork 时 name 是 xiaolin,之后主进程把它改成 coding,子进程生成的快照仍然对应之前的 xiaolin,不会一半使用新数据、一半使用旧数据。
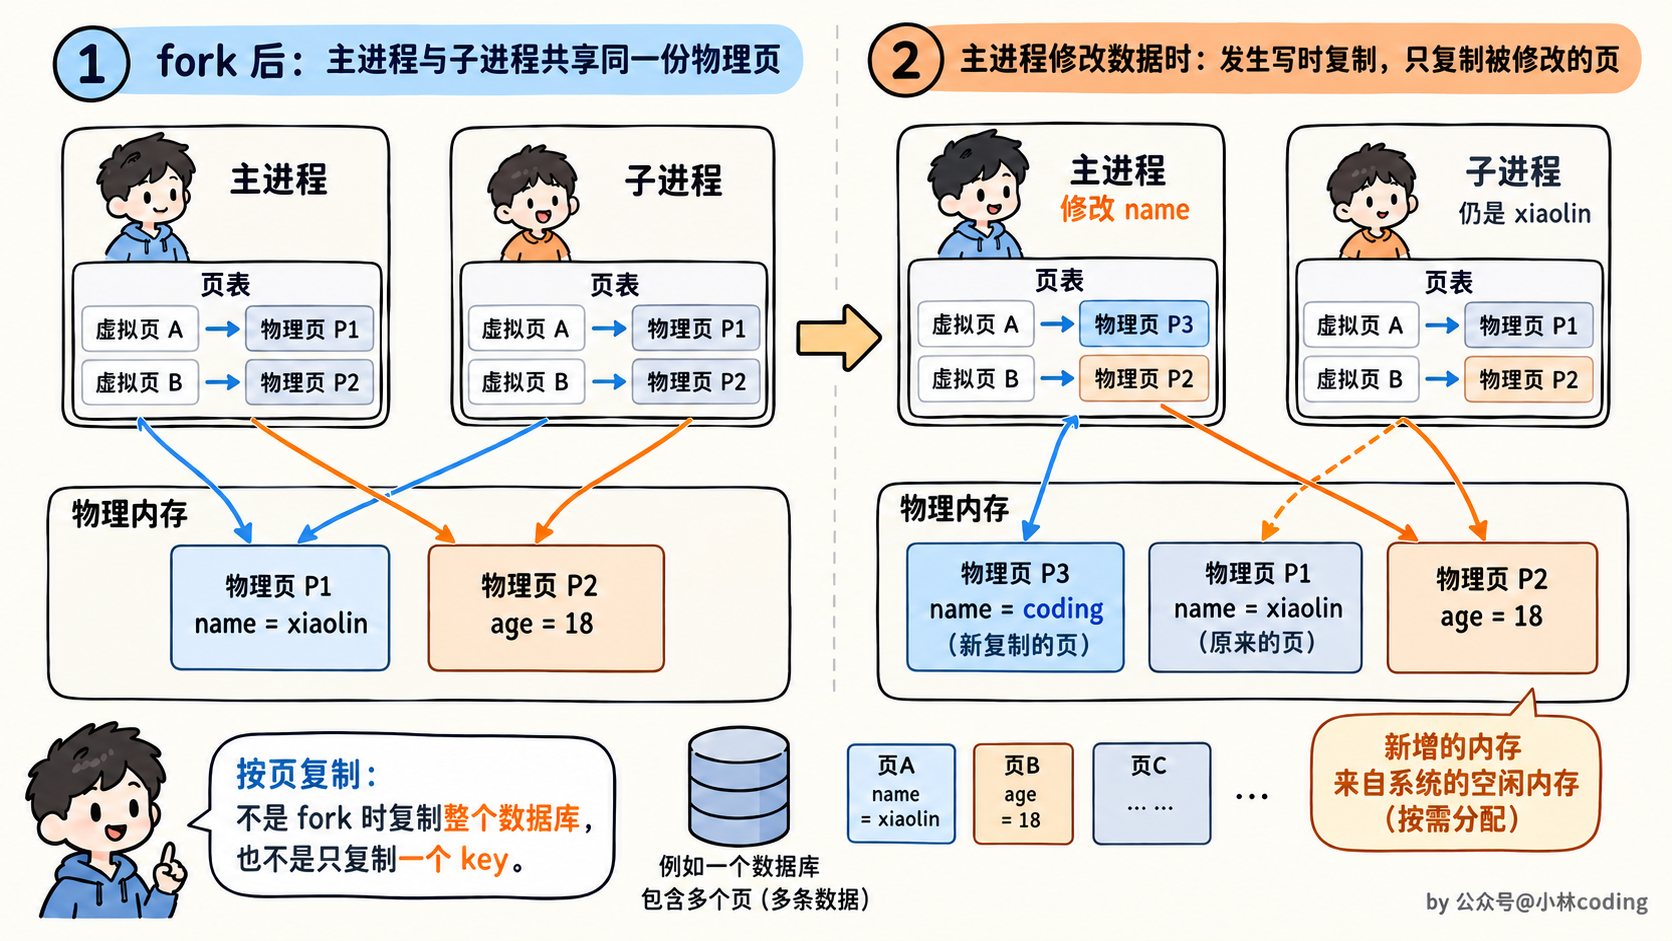
需要注意两点:
- fork 本身有成本:需要创建进程、复制页表等,数据量大时会短暂阻塞主线程。
- 写入会增加内存占用:快照期间修改的共享页越多,COW 产生的额外内存越多。如果内存预留不足,可能导致子进程失败,甚至触发系统 OOM。
AOF 后台重写也会使用类似机制,所以持久化时要同时看主线程延迟和额外内存,不能只看当前 key 占用了多少内存。
# 同时开启 RDB 和 AOF,重启时加载哪个?
正常情况下,开启 AOF 后,Redis 重启会优先使用 AOF 恢复数据,因为它通常比独立的 RDB 快照保留更多近期变化,而不是把 dump.rdb 和 AOF 各加载一次。
如果使用混合持久化,AOF 的基础部分本身可能就是 RDB 格式,恢复时先加载这部分,再回放后面的增量命令。Redis 7.0 的多部分 AOF 则按照 manifest 指定的 base 和 incr 文件顺序恢复。
如果 AOF 损坏,也不能直接认为 Redis 一定会自动退回旧的 dump.rdb。需要根据损坏情况、截断加载配置和备份做恢复,避免把不完整的数据恢复当成正常启动。
# 缓存淘汰和过期删除
# 过期删除策略和内存淘汰策略有什么区别?
区别:
- 内存淘汰策略是在内存使用超过 maxmemory 时,根据策略选择 key 淘汰,腾出空间;如果是 noeviction,或者找不到可淘汰的 key,就拒绝相关写入。
- 过期键删除策略是将已过期的键值对进行删除,Redis 采用的删除策略是惰性删除 + 定期删除。过期删除看的是 key 的有效期,内存淘汰看的是内存压力,即使 key 没过期,也可能被淘汰。
# 介绍一下Redis 内存淘汰策略
Redis 通过 maxmemory 控制内存使用上限,通过 maxmemory-policy 选择超过上限时的处理方式。
常见的 64 位环境下,maxmemory 默认是 0,表示不设置这个上限;32 位环境默认限制为 3GB。生产环境通常需要显式配置,并给操作系统、复制缓冲区和持久化时的写时复制预留内存,不能把物理内存全部分给 maxmemory。这个限制也不是进程实际占用物理内存的硬上限,部分缓冲区等开销不计入淘汰判断。
以 Redis 7.0 为例,内存淘汰策略共有八种,这八种策略大体分为「不进行数据淘汰」和「进行数据淘汰」两类策略。
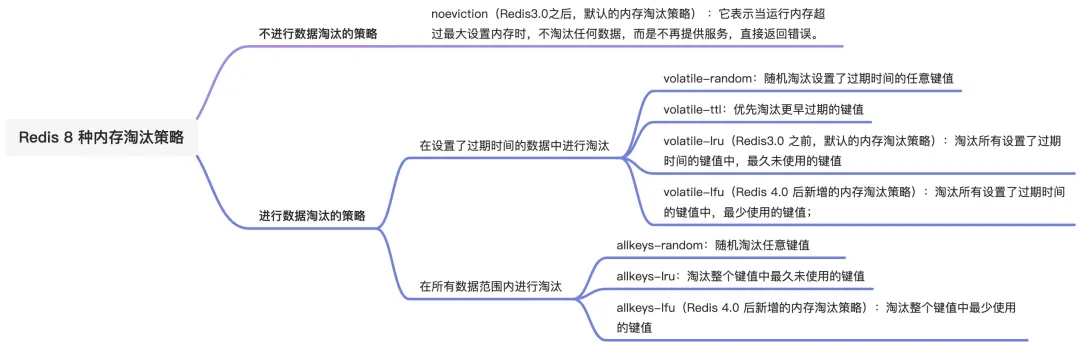
1、不进行数据淘汰的策略:
- noeviction(Redis3.0之后,默认的内存淘汰策略) :超过内存上限时,不主动淘汰数据,可能继续增加内存的写命令会返回 OOM 错误,普通查询和删除通常仍可执行。它不等于关闭过期删除,已经过期的 key 仍然会按过期策略处理。
2、进行数据淘汰的策略:
针对「进行数据淘汰」这一类策略,又可以细分为「在设置了过期时间的数据中进行淘汰」和「在所有数据范围内进行淘汰」这两类策略。
在设置了过期时间的数据中进行淘汰:
- volatile-random:随机淘汰设置了过期时间的任意键值;
- volatile-ttl:优先淘汰更早过期的键值。
- volatile-lru(Redis3.0 之前,默认的内存淘汰策略):淘汰所有设置了过期时间的键值中,最久未使用的键值;
- volatile-lfu(Redis 4.0 后新增的内存淘汰策略):淘汰所有设置了过期时间的键值中,最少使用的键值;
在所有数据范围内进行淘汰:
- allkeys-random:随机淘汰任意键值;
- allkeys-lru:淘汰整个键值中最久未使用的键值;
- allkeys-lfu(Redis 4.0 后新增的内存淘汰策略):淘汰整个键值中最少使用的键值。
如果选择 volatile 系列策略,但没有可淘汰的过期键,就无法通过淘汰腾出空间,写入仍然可能报 OOM。纯缓存场景可以考虑 allkeys-lru 或 allkeys-lfu;如果 Redis 中还放了锁、库存等不能随意丢掉的数据,就应该考虑拆分实例,避免它们被缓存淘汰影响。
# LRU 和 LFU 有什么区别?Redis 是怎么实现的?
LRU 看最近有没有用过,LFU 看一段时间内用得多不多。
举个例子,一个商品一直被频繁访问,但刚好最近一小段时间没有请求;另一个商品以前没人看,刚刚被访问了一次。LRU 更可能保留后者,LFU 更可能保留前者,因为两者关注的指标不一样。
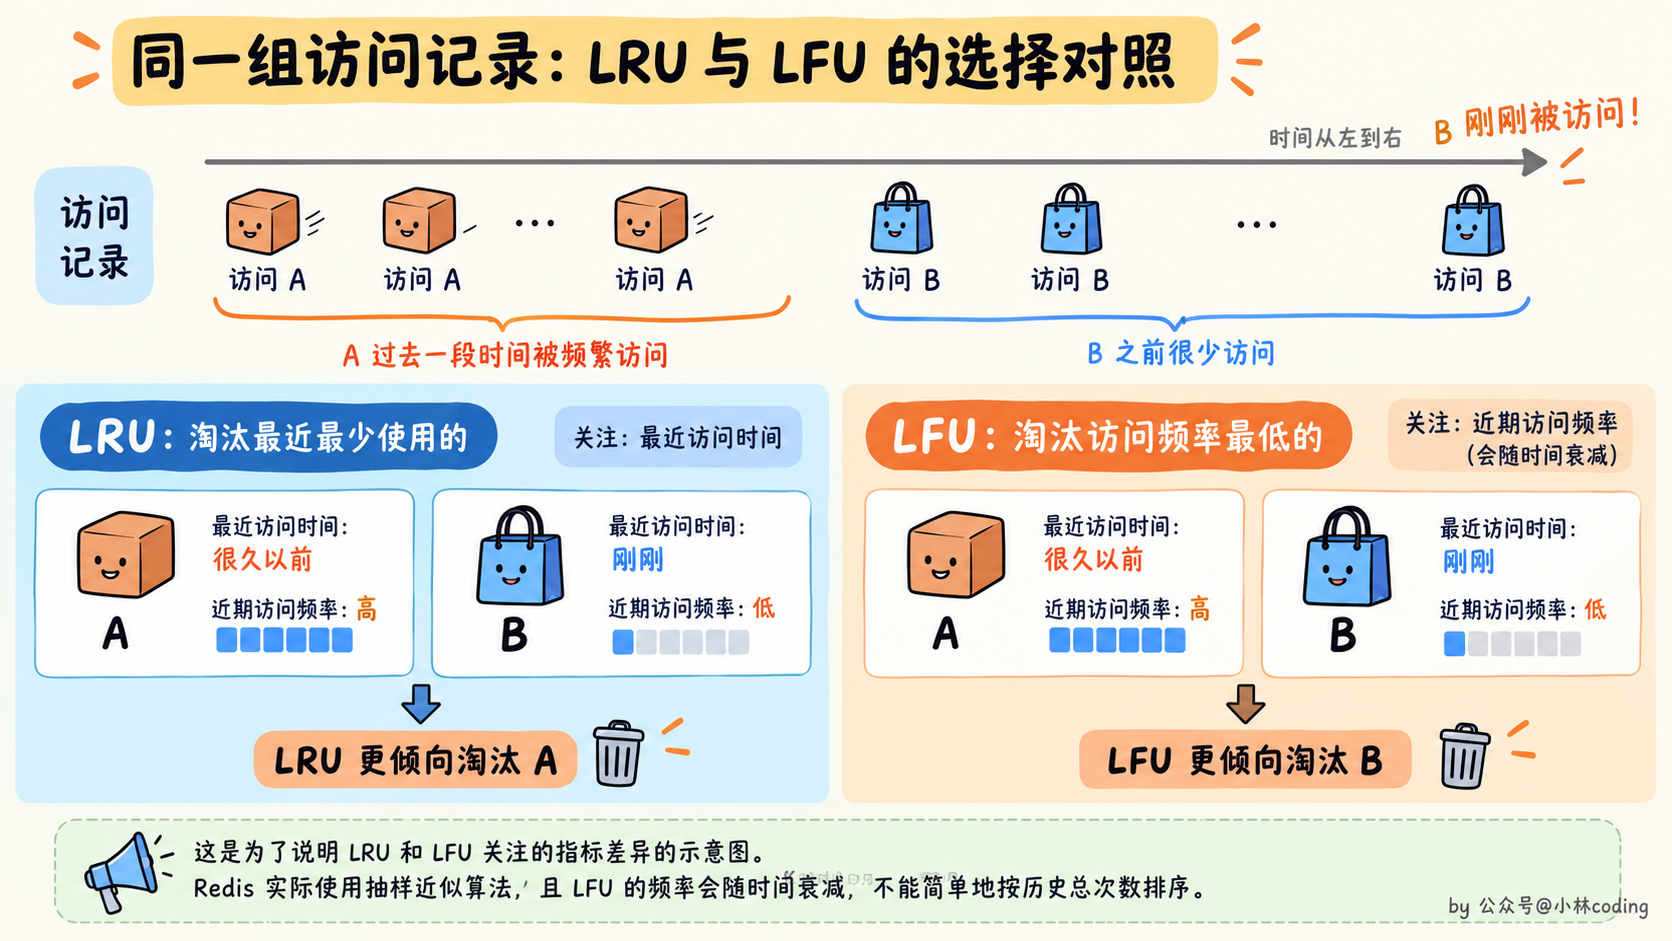
Redis 没有为所有 key 维护一条严格的 LRU 链表,而是使用近似 LRU:记录访问时间,淘汰时抽样一些 key,再结合候选池挑选较久没被访问的 key。maxmemory-samples 可以控制采样数量,采样越多通常越接近真实 LRU,但 CPU 开销也会增加。
LFU 同样是近似实现。它使用有限位数的计数器,通过概率递增估算访问频率,并根据时间衰减,避免一个以前的热点长期占着内存。
所以 LFU 不是每访问一次就一直精确加一,也不是永远保留历史访问次数最多的 key。热点比较稳定时可以考虑 LFU,热点变化较快时可以比较 LRU 的表现,最终还是看真实业务的命中率和淘汰情况。
# 介绍一下Redis过期删除策略
Redis 选择「惰性删除+定期删除」这两种策略配合使用,以求在合理使用 CPU 时间和避免内存浪费之间取得平衡。
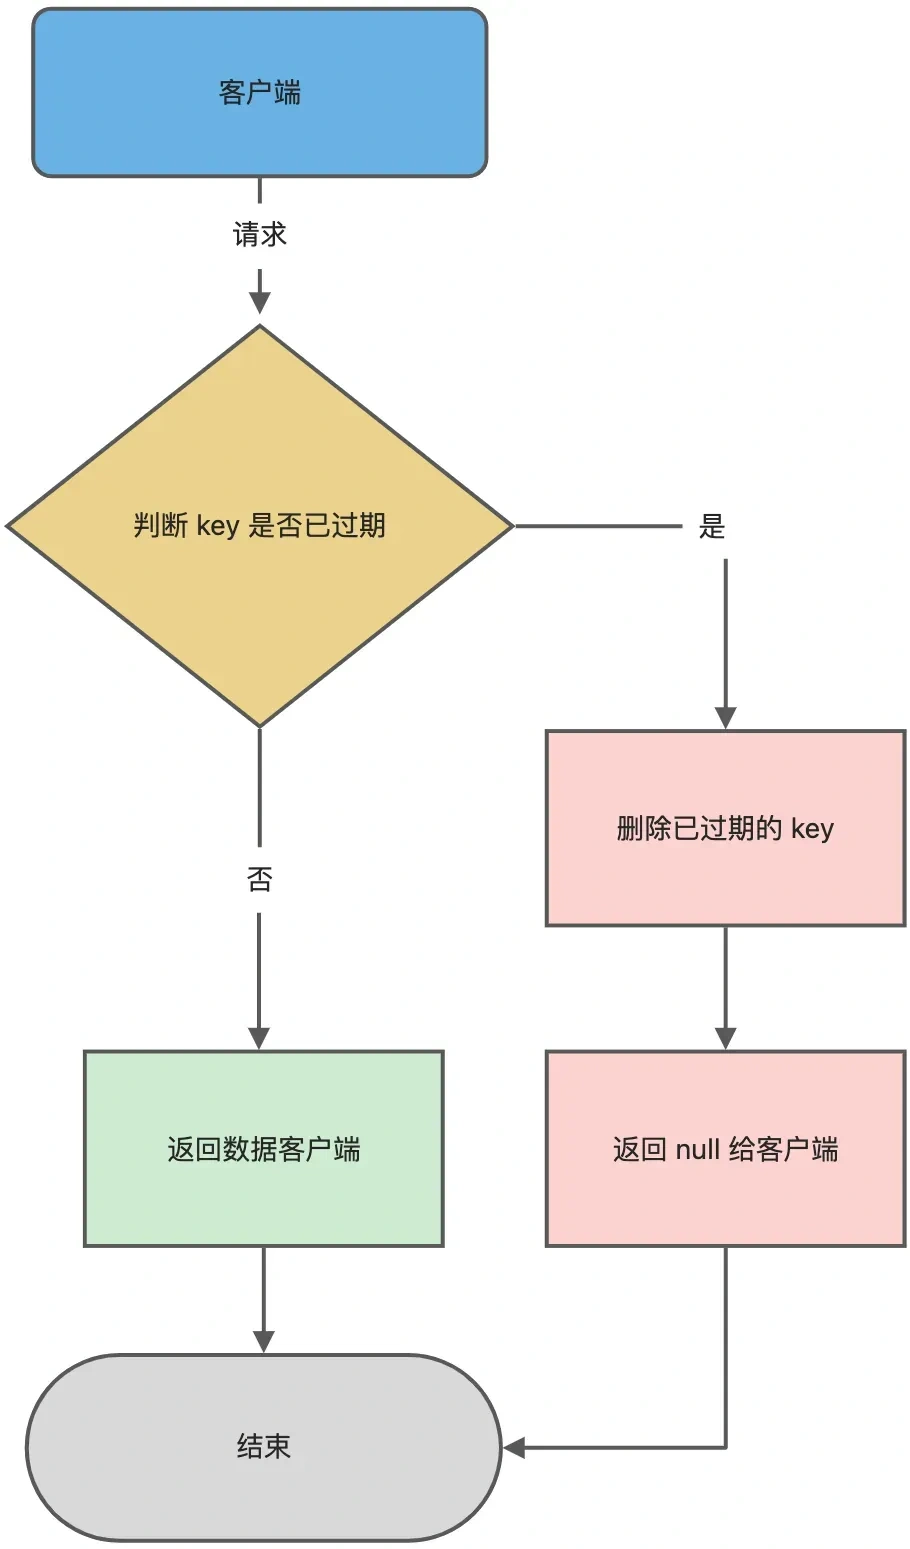
Redis 的惰性删除策略会在访问 key 时检查有效期,涉及 expireIfNeeded 等函数。下面用伪代码表示主节点上的基本判断,实际实现还需要处理主从角色和命令类型:
访问 key 时:
    如果没有过期,继续执行命令
    如果已经过期,把它当作不存在
    从数据库中移除过期 key
    根据配置和释放成本,同步或异步回收底层内存
Redis 在访问或者修改 key 之前,都会调用 expireIfNeeded 函数对其进行检查,检查 key 是否过期:
- 如果过期,在主节点上删除该 key,底层内存是否异步释放由 lazyfree-lazy-expire 等配置决定;对于 GET 这样的读取命令,会表现为 key 不存在;
- 如果没有过期,继续执行正常的读取或者修改操作;
惰性删除的流程图如下:
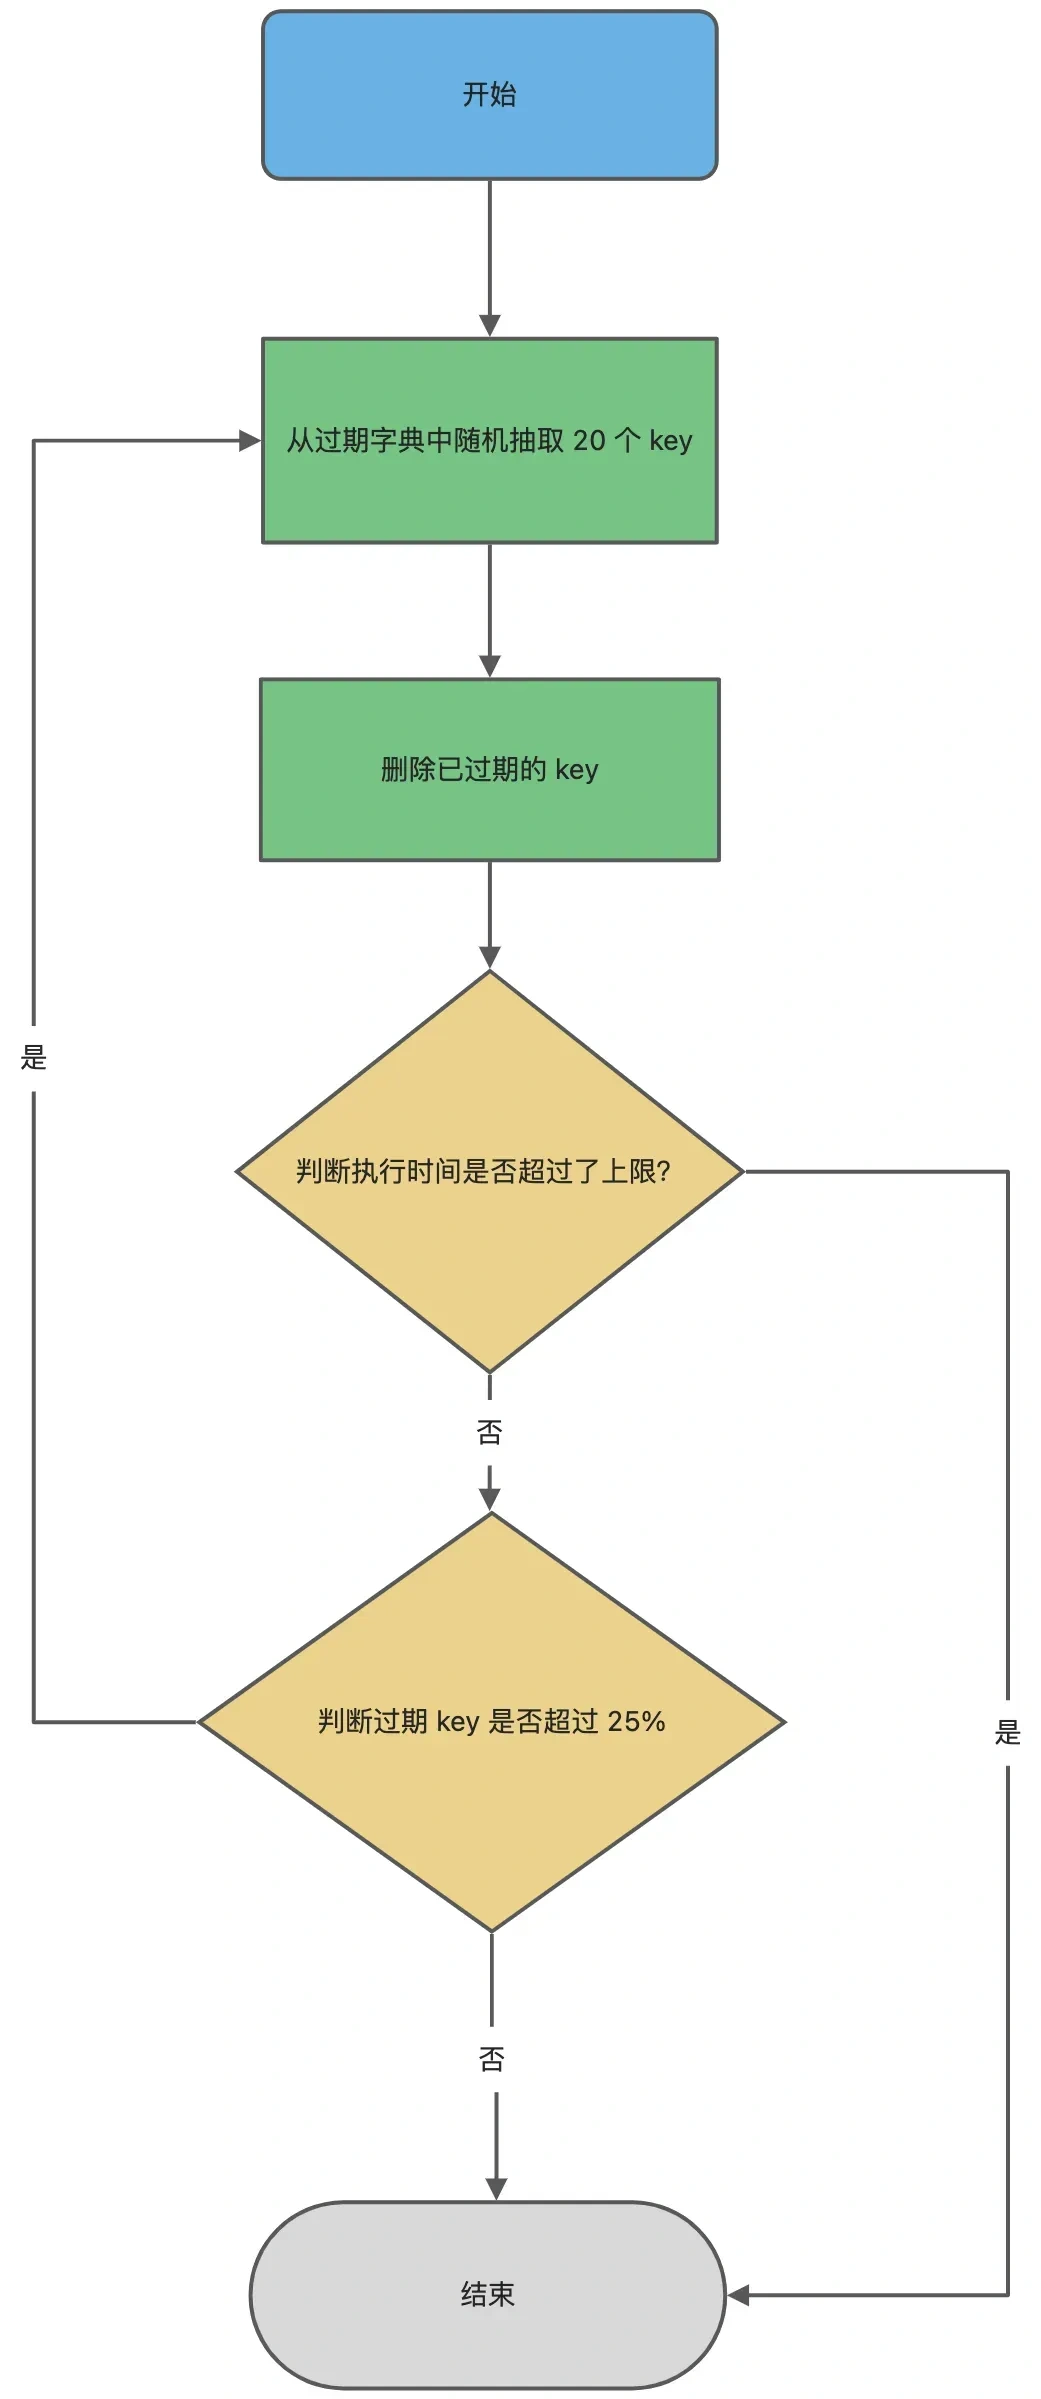
Redis 的定期删除是每隔一段时间「随机」从数据库中取出一定数量的 key 进行检查,并删除其中的过期key。
1、检查的频率是多少?
Redis 的周期性任务由 hz 控制,默认是 10,可以理解为基础频率约每秒 10 次。但动态 hz、快速过期检查等机制也会影响实际执行频率,不能理解为每个 key 都会每 100ms 被检查一次。
2、每轮怎么检查?
Redis 会从设置了过期时间的 key 中抽样,检查并删除过期数据。如果过期数据比例较高,就继续检查;如果比例下降,或者用完本轮的时间预算,就退出,把时间留给客户端请求。
以 Redis 7.0 为例,active-expire-effort 默认值为 1,基础的每轮扫描数量是 20,继续扫描所用的过期比例阈值是 10%。提高 active-expire-effort 会调整扫描量、时间预算和阈值,所以这些值不是所有版本都固定不变的。
默认参数下,慢速检查的时间预算大约是两次周期性任务间隔的 25%;当 hz 为 10 时,约为 25ms。它是按预算控制的过程,也不是每轮一定耗时 25ms。
大致流程可以这样理解:
重复执行:
    从过期字典中取出一批 key
    检查过期时间,删除已经过期的 key
    如果达到时间预算,就退出
    如果过期比例已经足够低,也退出
所以,定期删除是在 CPU 开销和内存回收之间做平衡,不会每次把所有 key 都遍历一遍。
下面的旧版示意图可以帮助理解抽样检查和时间预算的流程,图中的固定采样值、比例阈值应以所用版本和配置为准:
# Redis的缓存失效会不会立即删除?
不会,Redis 的过期删除策略是选择「惰性删除+定期删除」这两种策略配合使用。
- 惰性删除策略的做法是,不主动删除过期键,每次从数据库访问 key 时,都检测 key 是否过期,如果过期则删除该 key。
- 定期删除策略的做法是,每隔一段时间「随机」从数据库中取出一定数量的 key 进行检查,并删除其中的过期key。
# 那为什么不在过期时立即删除?
在过期 key 比较多的情况下,删除过期 key 可能会占用相当一部分 CPU 时间,在内存不紧张但 CPU 时间紧张的情况下,将 CPU 时间用于删除和当前任务无关的过期键上,无疑会对服务器的响应时间和吞吐量造成影响。所以,定时到期之后立即删除策略对 CPU 不友好。
# 已经过期但还没删除的 key,能读到吗?
对于普通客户端的读取,逻辑过期和物理删除是两回事。key 的内存还没回收,不代表客户端还能正常读到这个过期值。
在主节点读取时,Redis 会检查过期时间。发现已经过期,就把它当作不存在处理,并触发删除;如果使用异步释放,底层内存可能稍后才由后台线程回收。
从节点通常依赖主节点传播删除命令来清理复制数据,但对普通客户端读取,也会根据过期时间判断是否应当返回,所以不能认为“主节点还没发 DEL,从节点就一定能读到过期值”。不过,没有过期的新值仍然可能因为复制延迟而读不到,这是另一类问题。
# 修改 key 的值,会不会影响过期时间?
要看使用什么命令,不能统一回答会或者不会。
- 普通 SET 覆盖值:会清除原来的过期时间。如果需要保留,可以使用 Redis 6.0 起支持的 KEEPTTL;如果需要新有效期,可以在 SET 中带上 EX 或 PX。
- INCR、HSET、LPUSH 等原地修改:通常会保留整个 key 已有的过期时间,不会因为修改内容就自动续期。
- EXPIRE、PEXPIRE:重新设置 key 的有效期。
- PERSIST:移除 key 的过期时间,让它变成没有 TTL 的 key。
比如一个缓存原本只剩 30 秒就过期,应用又执行了普通 SET 更新内容,却没有带 EX,缓存就可能变成长期不过期。所以缓存写入时,应该把值和有效期放到同一条 SET 命令里,避免漏设 TTL。
查看 TTL 时,返回 -1 表示 key 存在但没有过期时间,返回 -2 表示 key 不存在。
# 集群
# Redis主从同步中的增量和完全同步怎么实现?
完全同步
完全同步,也就是全量同步,主要发生在以下几种情况:
- 首次建立复制关系:从节点没有可用于续传的复制信息,需要获取主节点的完整数据。
- 复制历史不匹配:主节点无法根据从节点提供的复制 ID 找到兼容的复制历史。
- 所需数据已经被覆盖:断连时间较长,从节点缺失的命令不再位于复制积压缓冲区中,只能重新全量同步。
所以,全量还是增量,不是只看主节点有没有变化,而是看复制历史能不能衔接,以及需要的增量数据还在不在。
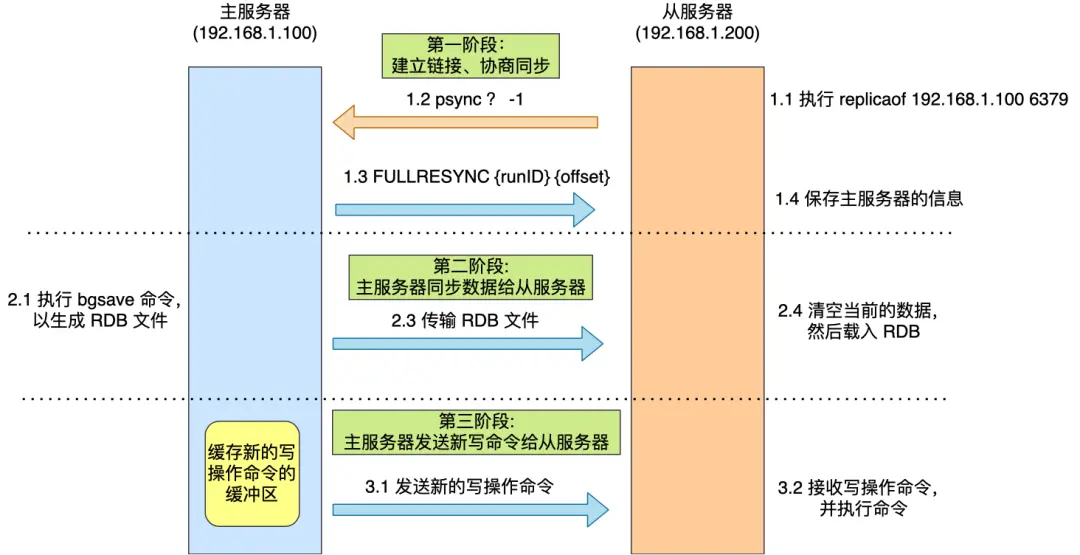
主从服务器间的第一次同步的过程可分为三个阶段:
- 第一阶段是建立链接、协商同步;
- 第二阶段是主服务器同步数据给从服务器;
- 第三阶段是主服务器发送新写操作命令给从服务器。
实现过程:
- 从节点发送 PSYNC:首次同步通常发送
PSYNC ? -1,表示没有可用的复制 ID 和偏移量。主节点回复 FULLRESYNC,告诉从节点接下来进行全量同步,并返回复制 ID 和基准偏移量。 - 主节点生成 RDB:主节点通过子进程生成当前数据的快照。快照可以先写磁盘再传输,也可以使用无盘复制直接发送给从节点。
- 记录期间的写命令:生成和传输快照时,主节点继续处理请求,把快照之后的写命令保存在待发送的复制数据中,避免这段时间的变化丢失。
- 从节点加载 RDB:从节点接收完整快照,替换原来的数据集。
- 补齐增量命令:主节点继续发送快照之后的写命令,从节点执行后,就进入持续接收命令的阶段。
这里要区分两个概念:replication buffer 是给从节点发送复制数据用的,repl_backlog_buffer 是保留最近复制历史、支持断线后增量同步用的。它们的职责不同,不能把全量同步期间待发送的命令只理解为存在 backlog 里。Redis 7.0 对复制缓冲区做了共享实现,但这两个职责仍然需要分清。
增量同步
增量同步允许从服务器从断点处继续同步,而不是每次都进行完全同步。它基于PSYNC命令,使用复制 ID(replication ID)和复制偏移量(offset)判断能不能接着同步。这里的复制 ID 标识的是复制历史,不要和 Sentinel 选主时用于比较的进程 run ID 混为一谈。
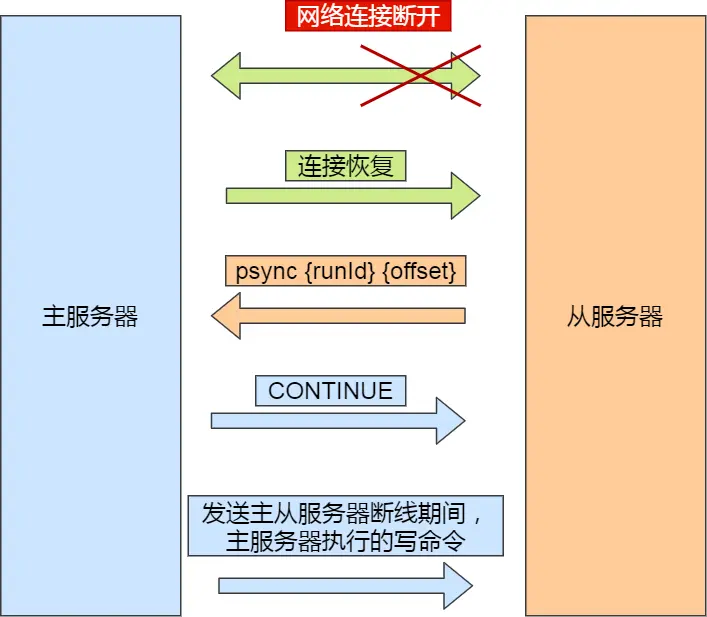
主要有三个步骤:
- 从服务器在恢复网络后,会发送 psync 命令给主服务器,此时的 psync 命令里的 offset 参数不是 -1;
- 主服务器收到该命令后,然后用 CONTINUE 响应命令告诉从服务器接下来采用增量复制的方式同步数据;
- 然后主服务将主从服务器断线期间,所执行的写命令发送给从服务器,然后从服务器执行这些命令。
那么关键的问题来了,主服务器怎么知道要将哪些增量数据发送给从服务器呢?
答案藏在这两个东西里:
- repl_backlog_buffer,保存最近的复制历史,传统实现是环形缓冲区,用于从节点断连后查找缺失的数据;
- replication offset,标记上面那个缓冲区的同步进度,主从服务器都有各自的偏移量,主服务器使用 master_repl_offset 来记录自己「写」到的位置,从服务器使用 slave_repl_offset 来记录自己「读」到的位置。
那 repl_backlog_buffer 缓冲区是什么时候写入的呢?
在主服务器进行命令传播时,不仅会将写命令发送给从服务器,还会将写命令写入到 repl_backlog_buffer 缓冲区里,因此 这个缓冲区里会保存着最近传播的写命令。
网络断开后,当从服务器重新连上主服务器时,从服务器会通过 psync 命令将自己的复制偏移量 slave_repl_offset 发送给主服务器,主服务器先判断复制 ID 是否兼容,再检查从节点请求的偏移量是否还在 backlog 保存的范围内,决定采用哪种同步操作:
- 如果判断出从服务器要读取的数据还在 repl_backlog_buffer 缓冲区里,那么主服务器将采用增量同步的方式;
- 相反,如果判断出从服务器要读取的数据已经不存在 repl_backlog_buffer 缓冲区里,那么主服务器将采用全量同步的方式。
当主节点确认需要的历史还在 backlog 中,就从对应偏移量开始把数据发给从节点。旧版本会将历史复制到从节点待发送的缓冲区;Redis 7.0 的共享复制缓冲区可以复用已有的数据块,不需要为每个副本重复保存一份。
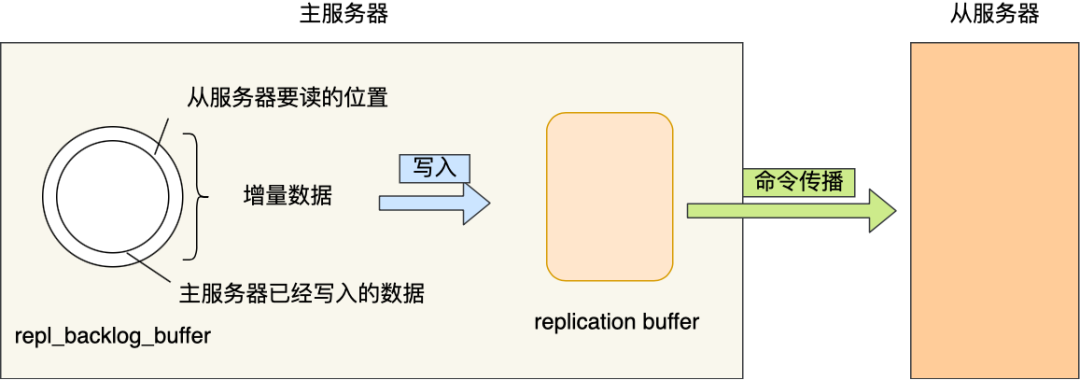
复制积压缓冲区可以理解为一个只保留最近复制历史的有限窗口,默认 repl-backlog-size 是 1MB。传统实现使用环形缓冲区,Redis 7.0 使用共享的复制缓冲块实现这个窗口;无论哪种实现,旧的复制历史都不会无限保留。断连时间越长、复制流量越大,从节点需要的数据越容易超出这个窗口。
那么在网络恢复时,如果从服务器想读的数据已经被覆盖了,主服务器就会采用全量同步,这个方式比增量同步的性能损耗要大很多。
因此,为了减少断线重连时的全量同步,可以根据“每秒复制流量 × 希望容忍的断连时间”,再加上一定余量,设置 repl-backlog-size。比如每秒复制流量约 2MB,希望覆盖 60 秒断连,就至少需要考虑 120MB 的历史窗口,并预留流量波动的空间。要结合内存预算设置,不是越大越好。
# redis主从和集群可以保证数据一致性吗 ?
不能保证主从强一致,也不能保证故障切换时已经确认的写入一定不丢失,因为 Redis 的主从复制默认是异步的。
举个例子,客户端往主节点写入一条数据,主节点返回成功,但这条数据还没有复制到从节点。这时主节点宕机,哨兵或者 Cluster 把从节点提升为主节点,新主节点上就没有这条数据了。
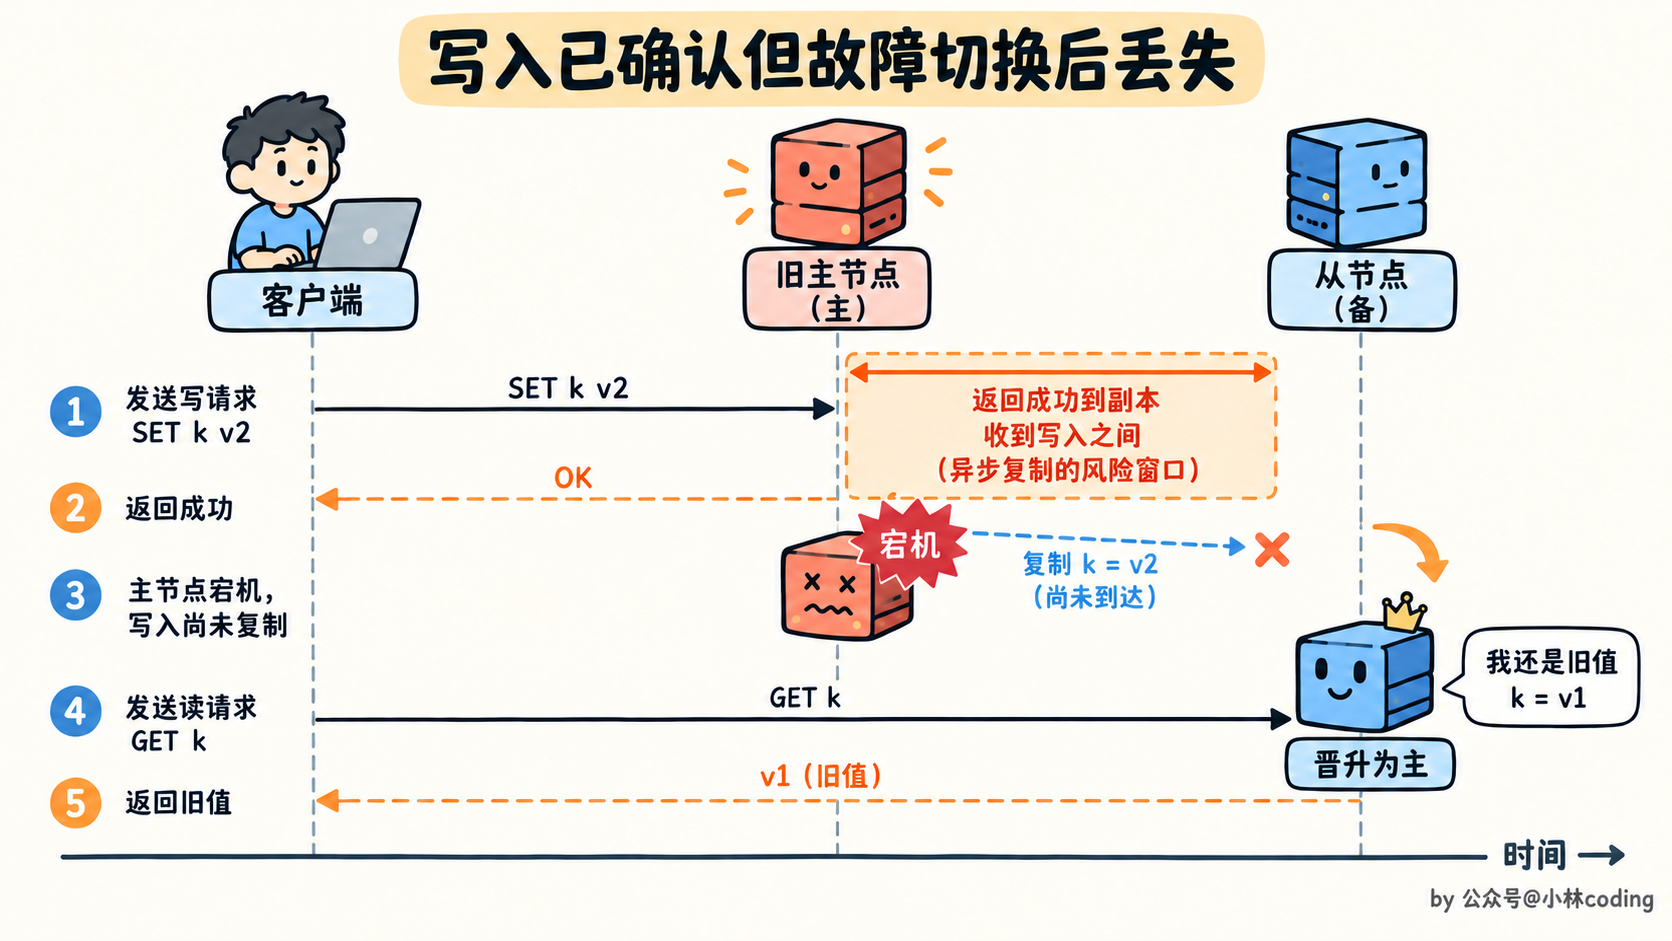
读写分离也有类似问题:刚写完主节点,马上去从节点读取,可能读到旧值。所以,对“写完马上读”的场景,可以优先读主节点;但这也不能消除故障切换造成的数据丢失窗口。
可以通过 WAIT 等机制等待副本确认,或者用 min-replicas-to-write、min-replicas-max-lag 限制副本状态不好时的写入,来降低风险。不过,这些措施不会把 Redis 变成强一致系统。
另外,不能简单说“Redis Cluster 属于 AP,所以网络分区时一直可用”。Cluster 在失去多数主节点联系时会停止接受写入;默认要求所有槽都可服务,槽不可用也可能影响整个集群。它的可用性有条件,面试时直接讲清楚异步复制和故障切换的边界更准确。
# 哨兵机制原理是什么?
在 Redis 的主从架构中,由于写请求通常由主节点处理,如果主节点(master)挂了,那么将没有主节点来服务客户端的写操作请求,也没有主节点给从节点(slave)进行数据同步了。
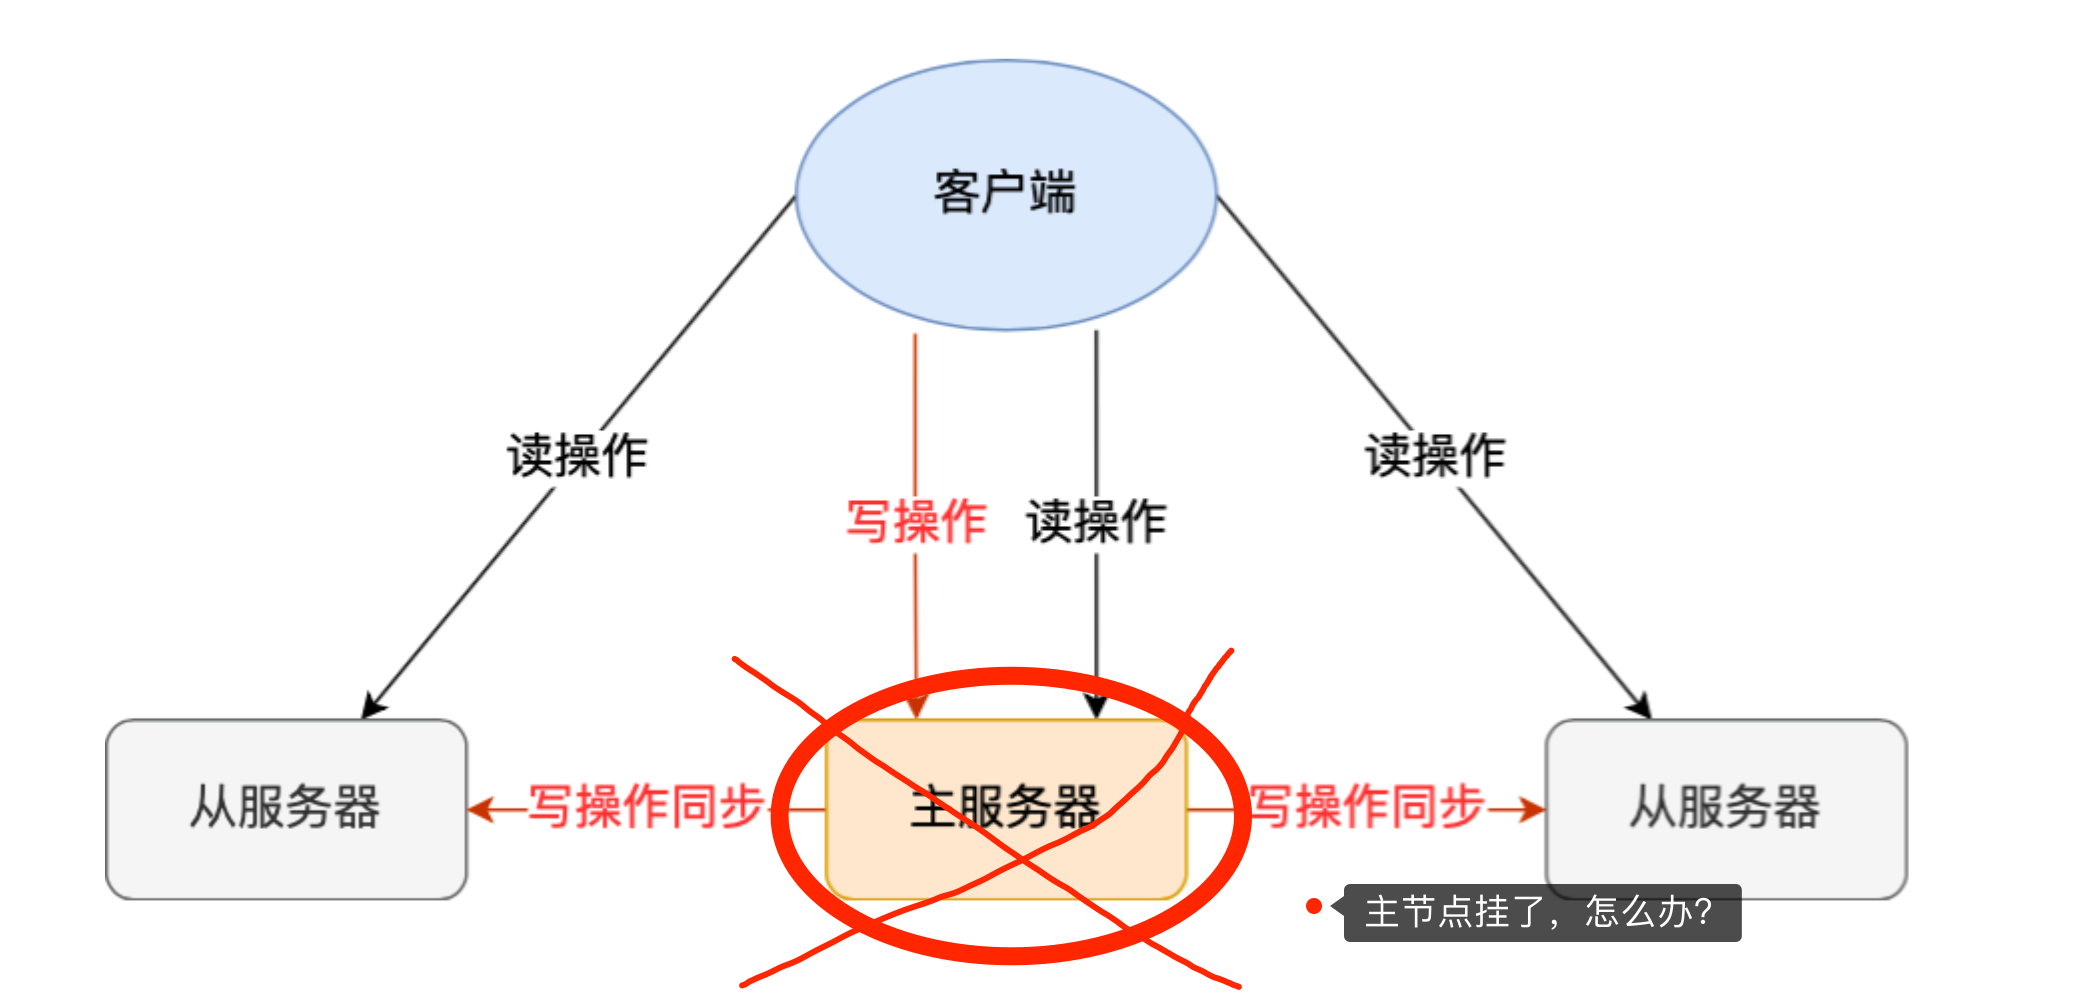
这时如果要恢复服务的话,需要人工介入,选择一个「从节点」切换为「主节点」,然后让其他从节点指向新的主节点,同时还需要通知上游那些连接 Redis 主节点的客户端,将其配置中的主节点 IP 地址更新为「新主节点」的 IP 地址。
这样也不太“智能”了,要是有一个节点能监控「主节点」的状态,当发现主节点挂了,它自动将一个「从节点」切换为「主节点」的话,那么可以节省我们很多事情啊!
Redis 在 2.8 版本以后提供的哨兵(Sentinel)机制,它的作用是实现主从节点故障转移。它会监测主节点是否存活,如果发现主节点挂了,它就会选举一个从节点切换为主节点,并且把新主节点的相关信息通知给从节点和客户端。
哨兵其实是一个运行在特殊模式下的 Redis 进程,所以它也是一个节点。从“哨兵”这个名字也可以看得出来,它相当于是“观察者节点”,观察的对象是主从节点。
当然,它不仅仅是观察那么简单,在它观察到有异常的状况下,会做出一些“动作”,来修复异常状态。
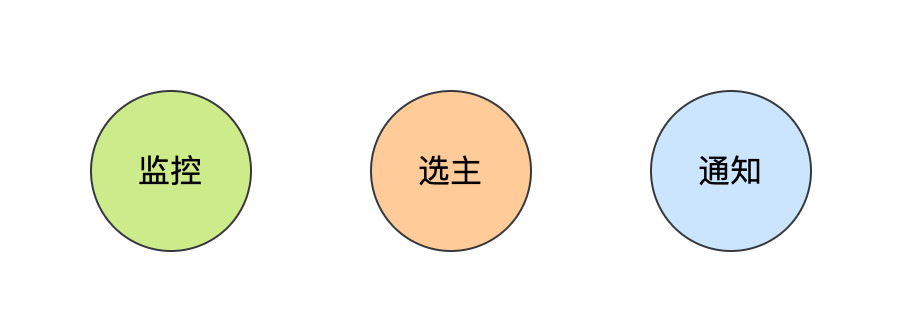
哨兵节点主要负责三件事情:监控、选主、通知。
# 哨兵机制的选主节点的算法介绍一下
当 Redis 主从架构中的主节点故障时,Sentinel 会协调故障转移,从可用的从节点中选出新主节点。这里说的是哨兵管理的主从架构,Redis Cluster 有自己的故障检测和选举机制,不依赖 Sentinel。主要有以下步骤:
- 故障节点主观下线
- 故障节点客观下线
- Sentinel集群选举Leader
- Sentinel Leader决定新主节点
- 故障节点主观下线
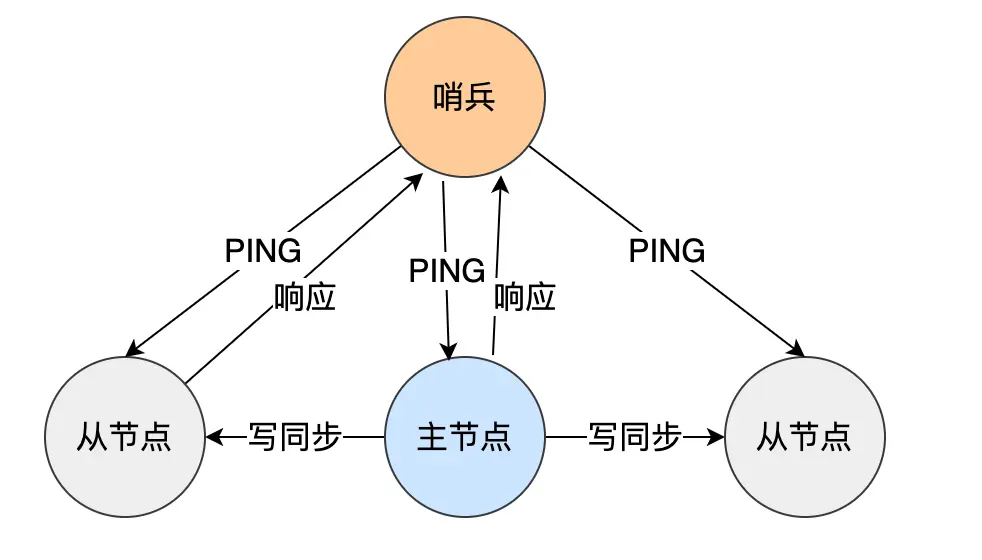
Sentinel集群的每一个Sentinel节点会定时对redis集群的所有节点发心跳包检测节点是否正常。如果一个节点在down-after-milliseconds时间内没有回复Sentinel节点的心跳包,则该redis节点被该Sentinel节点主观下线。
- 故障节点客观下线
当节点被一个Sentinel节点记为主观下线时,并不意味着该节点肯定故障了,还需要Sentinel集群的其他Sentinel节点共同判断为主观下线才行。
该Sentinel节点会询问其他Sentinel节点,如果认为主节点下线的 Sentinel 数量达到配置的 quorum(包括自己),就可以把主节点标记为客观下线。
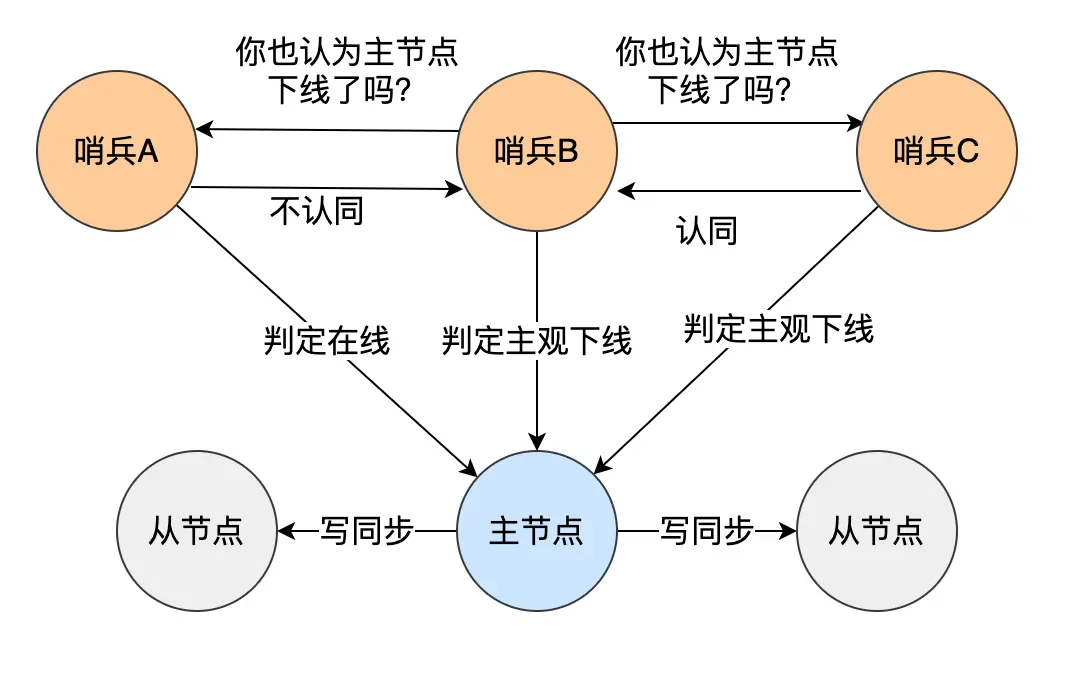
客观下线判断针对的是主节点。从节点和其他 Sentinel 可以被标记为主观下线,但不会对它们执行主节点这样的客观下线和故障转移流程。
- Sentinel集群选举Leader
在开始主从故障转移前,需要先选出一个 Sentinel 作为 Leader,由它负责协调切换。
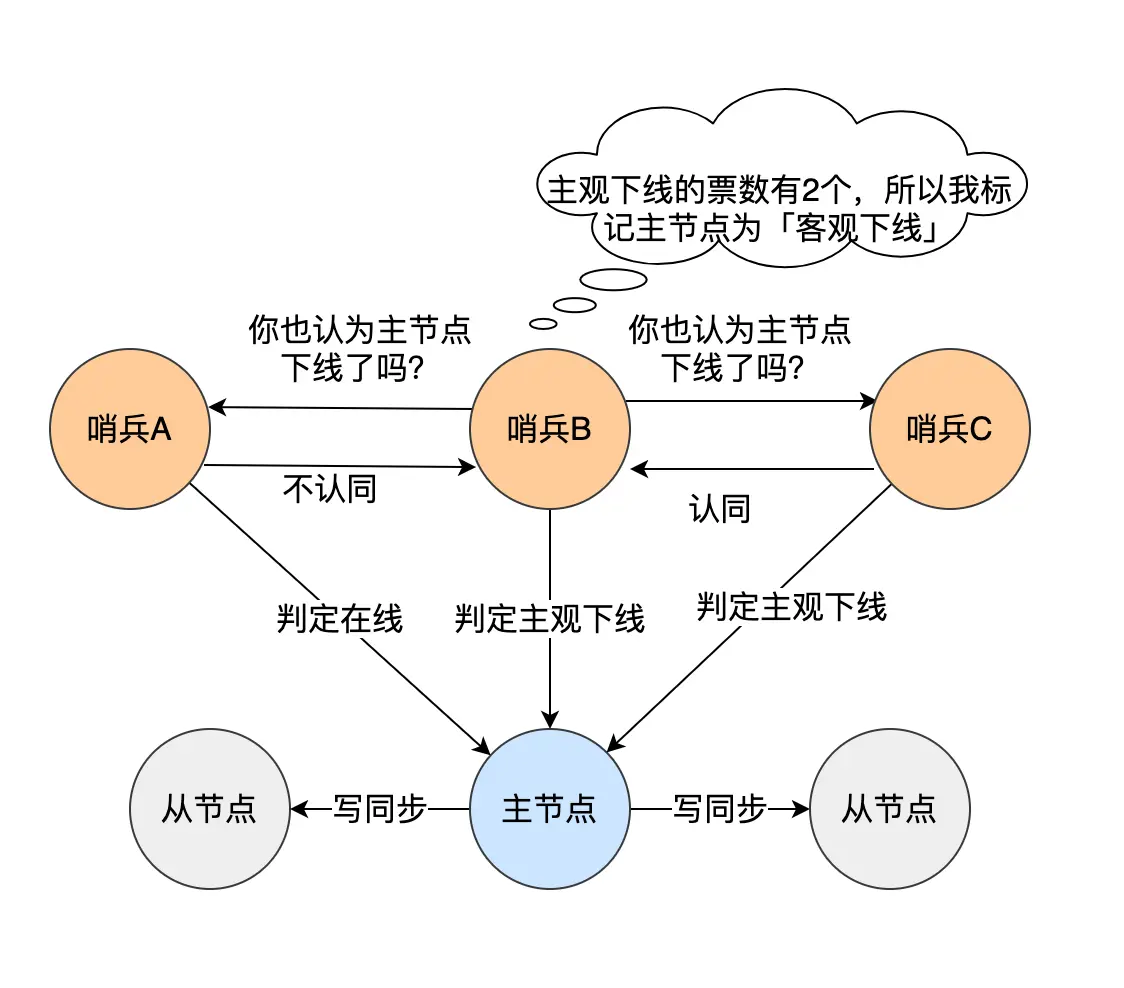
每一个Sentinel节点都可以成为Leader,当一个 Sentinel 节点确认主节点客观下线并准备发起故障转移后,会请求其他Sentinel节点要求将自己选举为Leader。每一轮选举有对应的纪元,一个 Sentinel 在同一个纪元里只会投票给一个候选者。如果还没有投票,就可以同意该请求,否则不会再给另一个候选者投票。
如果一个Sentinel节点获得的选举票数达到Leader最低票数(quorum 和 floor(Sentinel 节点数 / 2) + 1 的最大值),则该Sentinel节点选举为Leader;否则重新进行选举。
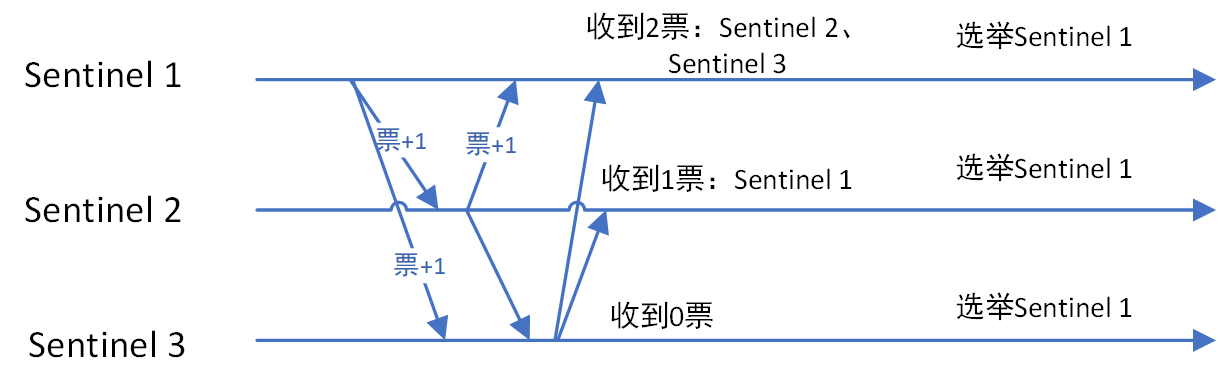
举个例子,假设哨兵节点有 3 个,quorum 设置为 2,那么任何一个想成为 Leader 的哨兵只要拿到 2 张赞成票,就可以选举成功了。如果没有满足条件,就需要重新进行选举。
- Sentinel Leader决定新主节点
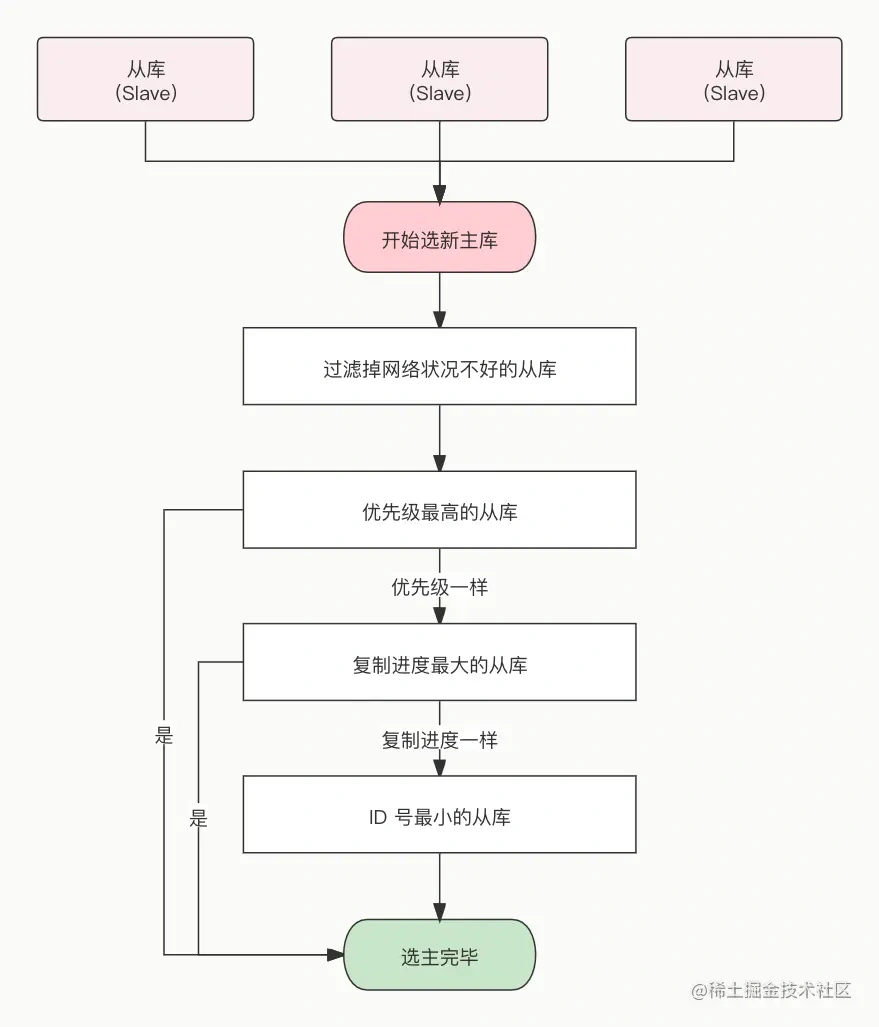
当Sentinel集群选举出Sentinel Leader后,由Sentinel Leader从redis从节点中选择一个redis节点作为主节点:
- 先过滤不合适的节点:排除不可用、与主节点断连过久,以及 replica-priority 为 0 的从节点。优先级为 0 表示不参与晋升。
- 比较优先级:选择 replica-priority 数值更小的节点,数值越小,优先级越高。旧版本配置名叫 slave-priority。
- 优先级相同,再比较复制偏移量:选择偏移量更大的节点,说明它通常接收了更多复制数据。
- 偏移量也相同,再比较 run ID:选择 run ID 字典序更小的节点,让选择结果是确定的。
注意,这些条件是按顺序比较,不是选不到优先级最大的才去比较偏移量。选出新主节点后,Sentinel 会将它提升为主节点,让其他从节点重新复制它,并通知支持 Sentinel 的客户端发现新主节点。
# Redis 脑裂是什么?怎么降低影响?
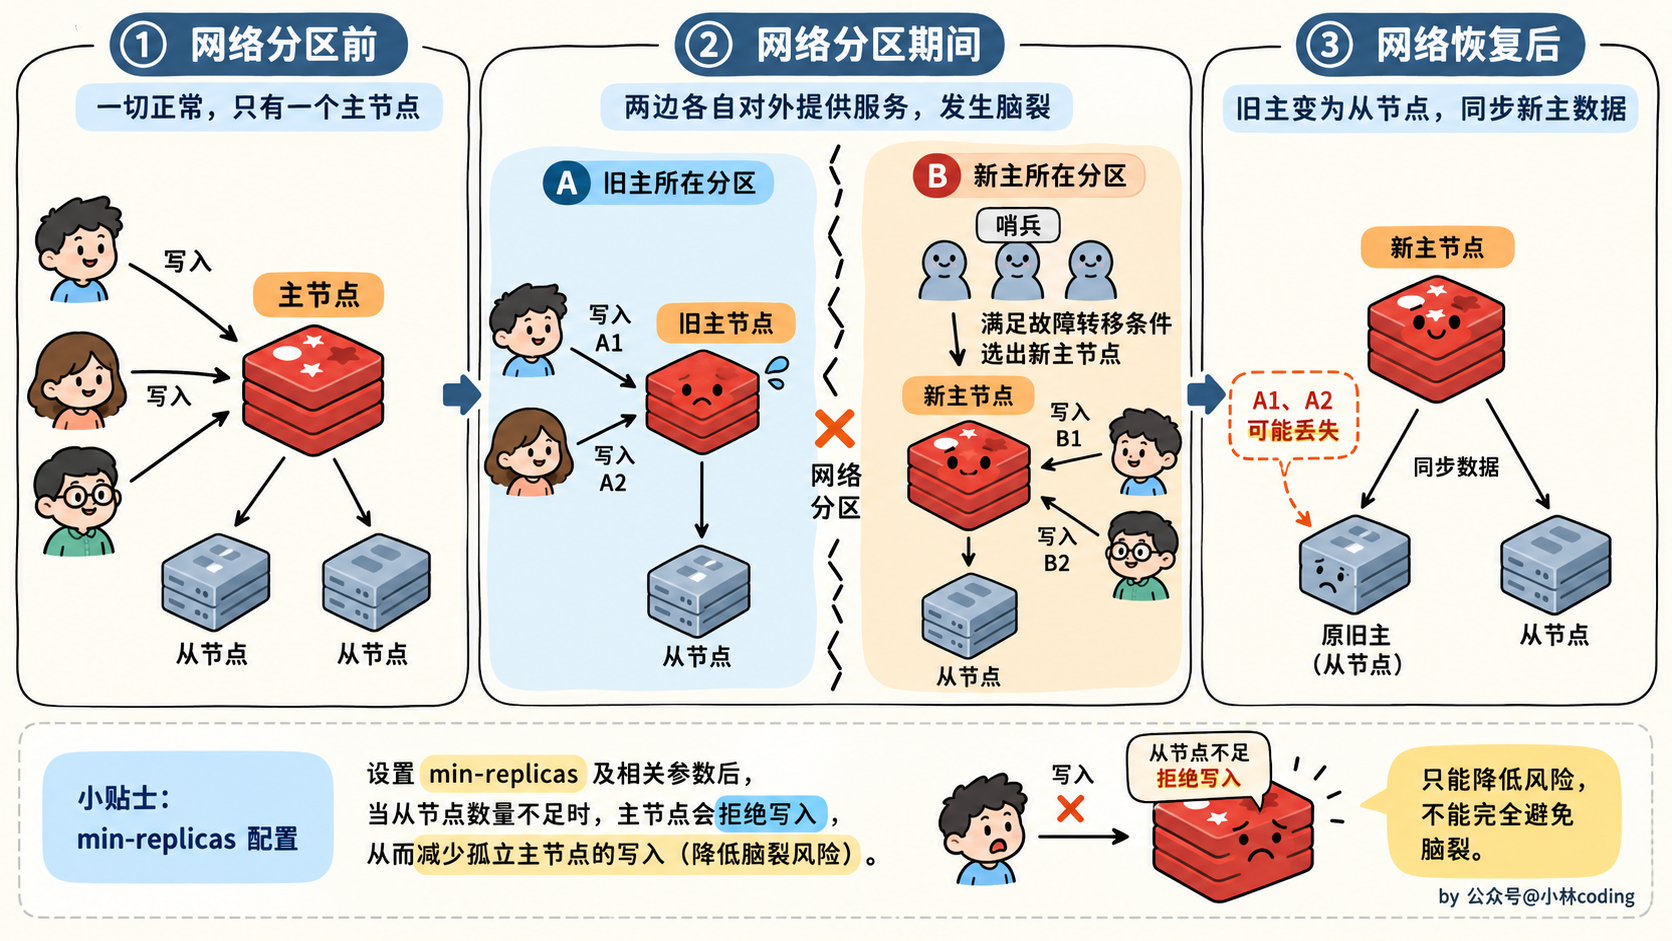
在哨兵管理的主从架构中,脑裂通常是指网络分区后,旧主节点仍然被部分客户端当作主节点使用,而另一边已经完成故障转移,出现了新主节点。
比如旧主节点和哨兵、从节点之间的网络断了,但某些应用还可以访问旧主节点。哨兵把从节点提升为新主节点,新旧两个主节点都可能收到写请求。网络恢复后,旧主节点被改成从节点,它独有的写入可能被新主节点的数据覆盖。
可以从几个方面降低影响:
- 限制孤立主节点的写入:通过 min-replicas-to-write 和 min-replicas-max-lag,要求主节点有足够数量、延迟在允许范围内的副本,否则拒绝写入。
- 让客户端及时发现新主节点:使用支持 Sentinel 的客户端,正确处理连接错误和拓扑变化,避免长期连接旧主节点。
- 减少共同故障:哨兵和主从节点分布在不同故障域,合理设置检测和切换参数。
这些措施能缩短风险窗口,但不能承诺完全消除数据丢失。副本状态的判断存在延迟,而且限制写入也会牺牲可用性,所以需要结合业务对一致性和可用性的要求来选择。
# Redis集群的模式了解吗 优缺点了解吗
当 Redis 缓存数据量大到一台服务器无法缓存时,就需要使用 Redis 切片集群(Redis Cluster )方案,它将数据分布在不同的服务器上,以此来降低系统对单主节点的依赖,从而提高 Redis 服务的读写性能。
Redis Cluster 方案采用哈希槽(Hash Slot),来处理数据和节点之间的映射关系。在 Redis Cluster 方案中,一个切片集群共有 16384 个哈希槽,这些哈希槽类似于数据分区,每个键值对都会根据它的 key,被映射到一个哈希槽中,具体执行过程分为两大步:
- 根据键值对的 key,按照 CRC16 算法计算一个 16 bit 的值。
- 再用 16bit 值对 16384 取模,得到 0~16383 范围内的模数,每个模数代表一个相应编号的哈希槽。
接下来的问题就是,这些哈希槽怎么被映射到具体的 Redis 节点上的呢?有两种方案:
- 平均分配: 在使用 cluster create 命令创建 Redis 集群时,Redis 会自动把所有哈希槽平均分布到集群节点上。比如集群中有 3 个主节点、每个主节点各有 2 个从节点,一共 9 个节点,槽位仍然只分配给 3 个主节点,每个主节点负责约 16384/3 个槽。从节点复制对应主节点的数据,不独立分配新的槽。
- 手动分配: 可以使用 cluster meet 命令手动建立节点间的连接,组成集群,再使用 cluster addslots 命令,指定每个节点上的哈希槽个数。
为了方便你的理解,我通过一张图来解释数据、哈希槽,以及节点三者的映射分布关系。
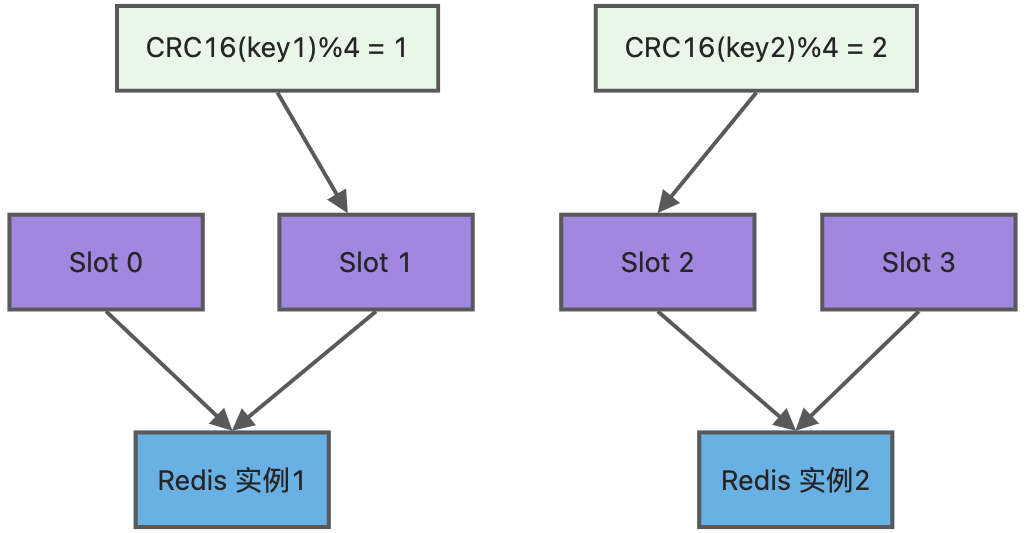
上图中的切片集群一共有 2 个节点,假设有 4 个哈希槽(Slot 0~Slot 3)时,我们就可以通过命令手动分配哈希槽,比如节点 1 保存哈希槽 0 和 1,节点 2 保存哈希槽 2 和 3。
redis-cli -h 192.168.1.10 -p 6379 CLUSTER ADDSLOTS 0 1
redis-cli -h 192.168.1.11 -p 6379 CLUSTER ADDSLOTS 2 3
然后在集群运行的过程中,key1 和 key2 计算完 CRC16 值后,对哈希槽总个数 4 进行取模,再根据各自的模数结果,就可以被映射到哈希槽 1(对应节点1) 和 哈希槽 2(对应节点2)。
上面的 4 个槽只是为了画图方便,真实的 Redis Cluster 固定有 16384 个槽,不能改成 4 个。默认 cluster-require-full-coverage 为 yes,需要全部槽可服务;关闭这个配置可以让可用槽继续服务,但仍然需要满足集群的其他可用性条件。
Redis集群模式优点/缺点
优点:
- 容量和吞吐量可以扩展:把不同 key 分散到多个主节点,多个分片可以并行处理各自的请求。
- 支持故障转移:主节点故障时,可以由合适的从节点接替。但前提是存在可用副本,并满足选举条件,不是任何节点故障都能保证整个集群正常工作。
- 可以在线扩缩容:通过迁移哈希槽及其数据,调整节点负责的数据范围。
缺点:
- 维护更复杂:要管理主从关系、槽位、迁移、客户端路由,以及数据和请求分布是否均衡。
- 多 key 操作受限制:事务、Lua 脚本以及许多多 key 命令,要求相关 key 在同一个哈希槽里;同一个节点上的两个 key,也不一定在同一个槽。
- 不能解决所有热点问题:一个 key 仍然只属于一个槽、由一个主节点处理,增加分片不能自动把同一个热 key 的写请求拆到多个主节点。
- 存在复制延迟和数据丢失窗口:主从异步复制,故障切换不能保证强一致;Cluster 也只支持数据库 0,不支持通过 SELECT 切换多个数据库。
另外,原生 Redis Cluster 节点不会充当代理来转发普通请求,而是让客户端根据槽位路由,必要时返回重定向。
# cluster集群客户端是怎样知道该访问哪个分片的?
首先 Redis Cluster 把所有数据映射到 16384 个哈希槽里,每个集群节点会负责一部分槽位,客户端启动后会先和集群中任意一个节点建立连接,通过 CLUSTER SLOTS,或者 Redis 7.0 起提供的 CLUSTER SHARDS,获取 “槽位 - 节点” 映射关系(比如哪些槽位归哪个 IP + 端口的节点管),然后把这份映射关系缓存到本地。
当客户端要访问某个 key 时,会先对 key 做 CRC16 哈希计算,再对 16384 取模,算出这个 key 对应的哈希槽位,接着查本地缓存的映射表,找到该槽位对应的节点地址,直接访问这个节点即可。
如果槽位发生迁移,或者故障切换使槽位对应的主节点变化,客户端可能收到 MOVED 或 ASK,但两者的处理不一样:
- MOVED:表示当前槽位应该访问另一个节点。客户端重发请求,并更新这个槽的路由,或者刷新整个槽位映射。
- ASK:通常出现在槽位迁移过程中,只要求这一次请求去目标节点。客户端在目标节点的同一连接上先发送 ASKING,再发送原命令,不能据此永久修改槽位映射。
如果连接直接断开,也可能先遇到连接错误,再由客户端刷新拓扑或者重试,不一定总能收到重定向。
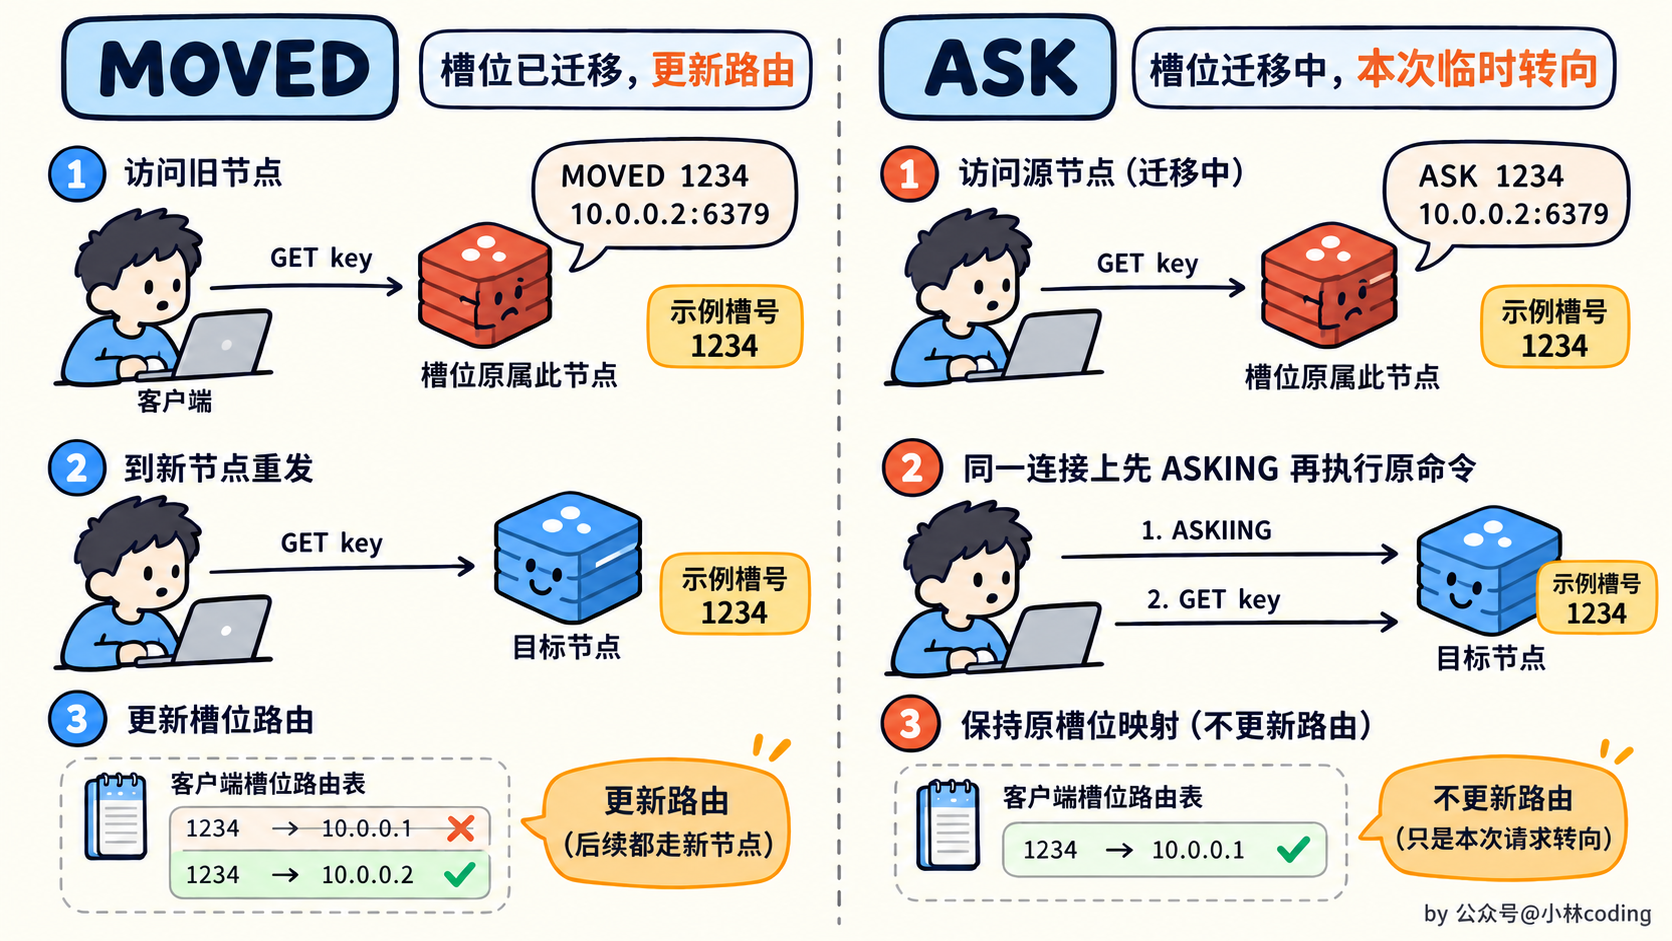
简单说,客户端先拿全量槽位映射表缓存起来,访问 key 时算槽位、查缓存找节点,遇到变动就更新缓存,全程自动完成,不用开发者手动指定分片,这也是 Redis Cluster 能做到透明分片访问的核心。
# Redis Cluster 为什么会报 CROSSSLOT?hash tag 有什么用?
因为 Redis Cluster 的许多多 key 操作,要求所有 key 位于同一个哈希槽。如果 key 分属不同槽,就可能返回 CROSSSLOT。
比如要用 Lua 同时检查商品库存和用户购买记录,可以这样设计 key:
seckill:{activity:1001}:stock
seckill:{activity:1001}:buyers
这里花括号内的 activity:1001 就是 hash tag。Redis 计算槽位时,只对这一段内容做哈希,所以这两个 key 会落在同一个槽里,能够在一个节点内执行相关原子操作。
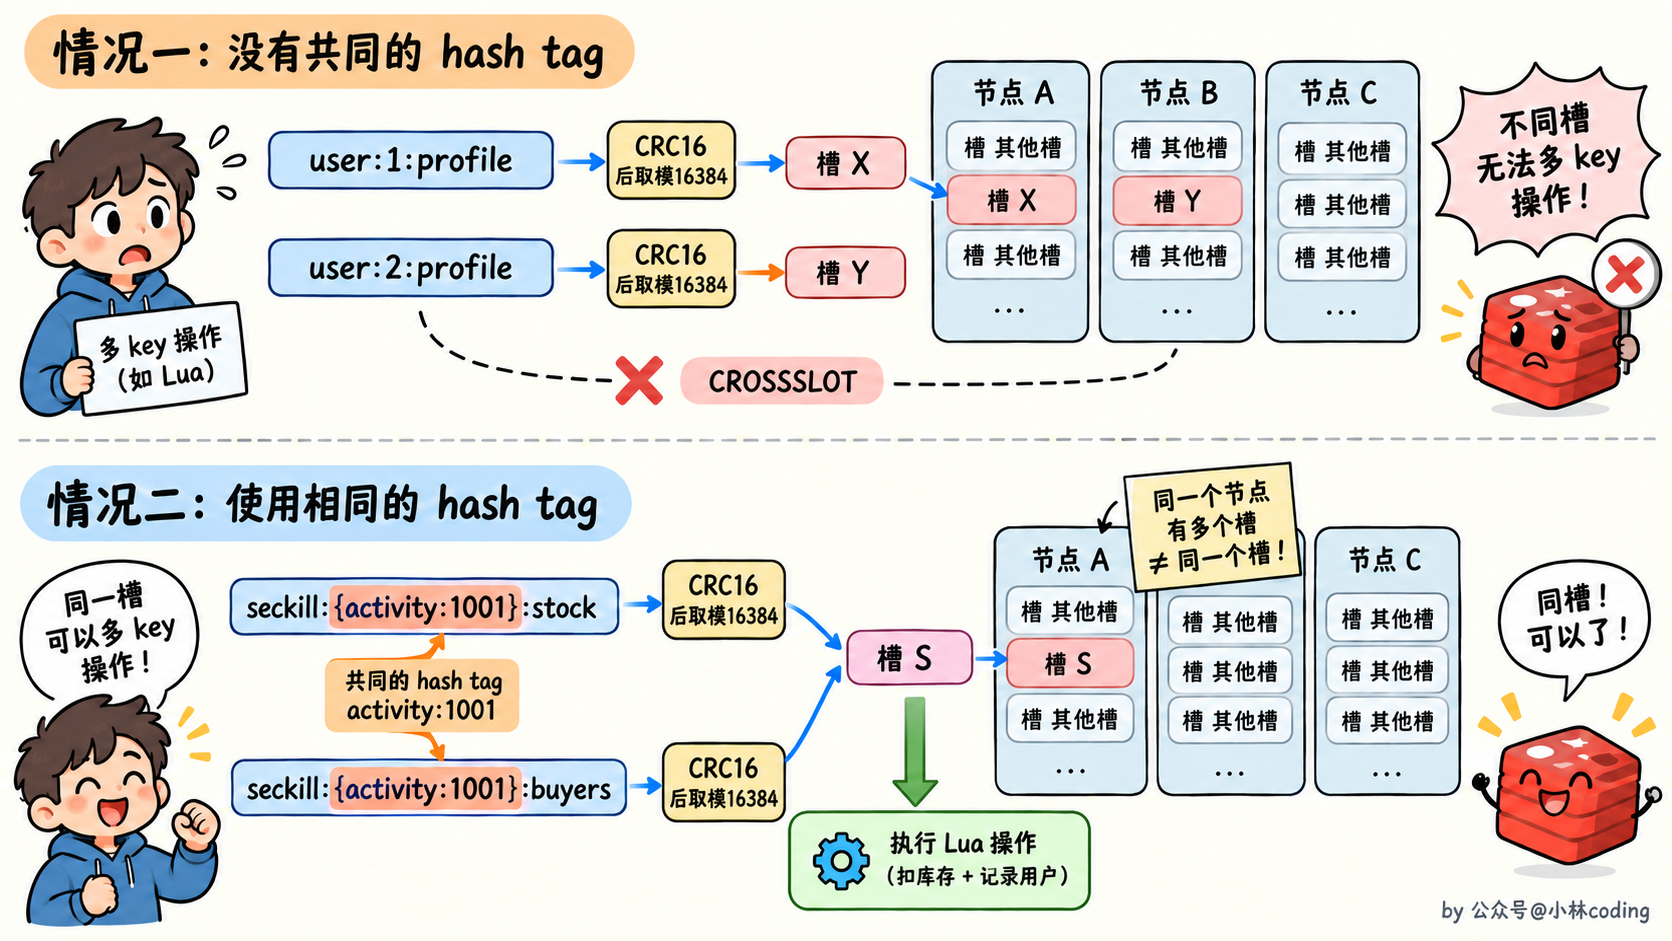
这里有两个容易答错的点:
- 在同一个节点,不等于在同一个槽。一个节点会负责很多槽,多 key 操作仍然要满足同槽要求。
- 不是所有 key 都应该使用同一个 hash tag。如果所有商品都用同一个 tag,就会把数据和流量集中到一个槽,失去分片带来的扩展能力。
因此,hash tag 应该按需要原子处理的业务范围来设置,比如一个活动或者一个订单,而不是为了方便,把整个业务的数据都放到同一个槽。
# 场景
# 为什么使用redis?
主要是因为 Redis 具备「高性能」和「高并发」两种特性。
1、Redis 具备高性能
假如用户查询商品详情,需要从 MySQL 读取商品信息、关联数据,再组装结果。第一次查询完成后,可以把结果缓存到 Redis,后面的请求直接读取缓存,减少数据库查询和重复计算。
这里要注意,MySQL 也有 Buffer Pool,不能把每次查询都理解为读硬盘。Redis 缓存的优势主要是让常见请求用更简单的键值操作直接拿到结果,减轻数据库的整体工作量。
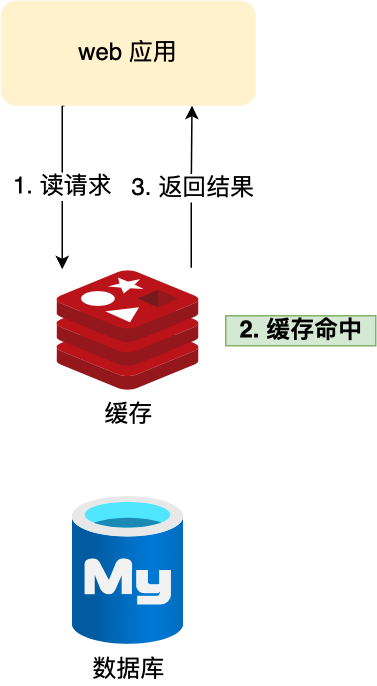
如果 MySQL 中的数据发生变化,还需要让对应缓存失效或刷新,这里就会涉及 Redis 和 MySQL 的一致性问题,后面会展开讲。
2、 Redis 具备高并发
Redis 对简单键值操作通常有较高的吞吐量,因此可以承担大量重复读取。QPS 是每秒请求数,不过 Redis 和 MySQL 能达到多少 QPS,取决于硬件、命令或 SQL、数据大小、网络和持久化配置,不能固定认为 Redis 一定是 MySQL 的 10 倍。
因此,可以把重复读取的数据放到缓存,让一部分请求直接命中 Redis,减少数据库的查询量,为真正需要访问数据库的请求留出容量。
# 为什么redis比mysql要快?
在缓存查询这类场景下,Redis 通常更快,主要有三个原因:
- 以内存访问为主:Redis 的数据主要放在内存中,普通读写不需要等待磁盘读取。MySQL 虽然也通过 Buffer Pool 缓存数据页,但缓存未命中时仍然可能涉及磁盘 I/O。
- 操作路径更简单:Redis 按 key 获取已经组装好的结果,很多查询可以通过哈希表完成。MySQL 则可能需要解析 SQL、选择执行计划、访问索引、回表、关联和排序,承担的工作更多。
- 命令串行执行,减少并发协调开销:Redis 普通命令由主线程执行,避免了这些命令之间的锁竞争和线程切换。不过,MySQL 的多线程模型也能利用多核,这里不能说单线程在所有场景下都更快。
比如查询一个包含多个表信息的商品详情,MySQL 需要查询和组装,Redis 直接 GET 缓存好的 JSON,做的事情本来就不一样。因此,面试时我会结合具体场景解释,不能只用 O(1) 和 O(log N) 就推出固定的性能差距。
# 本地缓存和Redis缓存的区别?
最大的区别是,本地缓存属于当前应用进程,Redis 缓存是多个应用实例可以共享访问的独立服务。
比如用 Caffeine 缓存商品详情,每个应用实例都有自己的一份;用 Redis 缓存商品详情,多个实例读取的是同一份缓存。
本地缓存的优点:
- 访问快:不需要网络请求,也不需要通过 Redis 客户端序列化和传输。
- 减轻 Redis 压力:特别适合少量高频读取的热点数据。
- 不依赖远程访问:Redis 短暂不可用时,已经存在于本地的数据仍然可以提供服务。
本地缓存的不足:
- 不同实例之间不共享:A 实例更新了缓存,B 实例可能还保留旧值,需要通过过期时间、变更通知等方式控制不一致窗口。
- 占用应用内存:数据量太大可能影响应用的内存和 GC;进程重启后缓存也会丢失。
Redis 缓存的优点:
- 便于共享数据:适合共享会话、全局计数和多个应用实例共同访问的缓存。
- 容量独立于应用进程:可以单独扩容、监控和运维,还能通过 Cluster 分片扩展。
- 支持丰富的数据结构和原子命令:可以完成计数、集合运算、排行榜等操作。
Redis 缓存的不足是增加了网络开销和一个需要维护的服务,而且主从复制也不保证强一致,不能因为用了 Redis 就认为所有副本都立即一致。
实际项目里也可以结合使用,先查本地缓存,再查 Redis,最后查数据库。多级缓存能缓解热点读压力,但也增加了缓存失效和一致性管理的复杂度,适合能接受短暂旧数据的场景。
# 高并发场景,Redis单节点+MySQL单节点能有多大的并发量?
这个问题不能只根据“4 核 8GB”就给一个固定答案,需要先区分 QPS、并发请求数和响应时间。
QPS 是每秒处理的请求数,并发请求数是某一时刻正在处理的请求数量。在系统比较稳定时,可以粗略用“并发请求数 ≈ QPS × 平均响应时间(秒)”估算,所以两者不是一回事。
对于 Redis + MySQL 的系统,缓存命中率特别关键。举个例子,假设总流量是 5 万 QPS,缓存命中率是 99%,每次缓存未命中只查询一次数据库,那么回源流量大约是 500 QPS;如果命中率降到 90%,回源就变成约 5000 QPS,压力一下增大了 10 倍。
实际还要看数据库写入量、每个请求执行多少条命令、SQL 是否有索引、数据大小、连接池、网络带宽以及 Redis 持久化配置。
所以我会先根据访问模型和命中率估算,再使用接近真实业务的数据压测,观察吞吐量、P99 延迟、CPU、带宽和数据库连接数,确认能稳定承受的流量,而不是直接承诺某个硬件配置一定能扛多少。
# redis应用场景是什么?
Redis 是一种基于内存的数据库,对数据的读写操作都是在内存中完成,因此读写速度非常快,常用于缓存,消息队列、分布式锁等场景。
- 缓存: Redis最常见的用途就是作为缓存系统。通过将热门数据存储在内存中,可以极大地提高访问速度,减轻数据库负载,这对于需要快速响应时间的应用程序非常重要。
- 排行榜: Redis的有序集合结构非常适合用于实现排行榜和排名系统,可以方便地进行数据排序和排名。
- 分布式锁: Redis的特性可以用来实现分布式锁,协调多个进程或服务对共享资源的访问,但仍然要考虑锁过期和故障切换的边界。
- 计数器 由于Redis的原子操作和高性能,它非常适合用于实现计数器和统计数据的存储,如网站访问量统计、点赞数统计等。
- 消息队列:可以用 List 做简单任务队列,用 Stream 实现消费组和消息确认;Pub/Sub 更适合实时通知,离线订阅者无法补收消息。
# Redis除了缓存,还有哪些应用?
除了缓存,Redis 还经常用于消息队列、分布式锁、计数器、排行榜和限流。
Redis实现消息队列
- Pub/Sub:适合实时广播和通知,多个订阅者可以同时收到消息。但消息不会为离线订阅者保存,也没有消费确认和重试机制。
- List:可以使用 LPUSH + BRPOP,或者 RPUSH + BLPOP 实现先进先出的队列。阻塞的是等待消息的客户端,不是 Redis 主线程。不过,直接弹出后消息就离开队列,消费者宕机可能丢失任务;可以用 BLMOVE 将任务原子转移到处理中列表,再自行实现确认和重试。Redis 的普通 TTL 针对整个 key,不是 List 中每条消息独立过期。
- Stream:支持消息记录、消费组、ACK 和待处理消息列表,更适合需要追踪消费进度的任务。但可靠性仍然取决于持久化、复制和业务的幂等处理。
Redis实现分布式锁
最常见的方式是 SET lock_key unique_value NX PX milliseconds,用一条命令完成“锁不存在才写入”和“设置过期时间”。解锁时,通过 Lua 判断标识是否仍然属于自己,再删除锁。
unique_value 应该对每一次加锁请求都唯一,不能让同一个客户端反复加锁一直使用相同的值。锁超时、续期和主从切换的问题,后面会展开讲。
Redis实现计数器和排行榜
计数器可以使用 INCR、HINCRBY 等原子命令;排行榜可以使用 Zset 保存成员和分数。限流则可以结合计数器或者 Zset,加上 Lua 把判断和更新放在一起执行。
# Redis支持并发操作吗?
支持多个客户端并发发送请求,但并发接收请求和并行执行普通命令,是两回事。
Redis 可以通过 I/O 多路复用处理多个连接,也可以启用 I/O 线程分担网络读写;普通命令主要由主线程串行执行。因此,多个客户端同时执行 INCR,不会出现应用层 GET + SET 那样的丢失更新。
不过,如果一个业务动作包含多条命令,仍然可能被其他客户端的命令穿插。需要根据场景使用原子命令、Lua 脚本,或者 WATCH + 事务处理,不能只因为 Redis 是单线程就省略并发控制。
事务和 Lua 可以保证连续执行,但都不提供出错后的自动回滚,业务条件和异常处理仍然需要自己设计。
# Redis分布式锁的实现原理?什么场景下用到分布式锁?
分布式锁是用于分布式环境下并发控制的一种机制,用于控制某个资源在同一时刻只能被一个应用所使用。如下图所示:
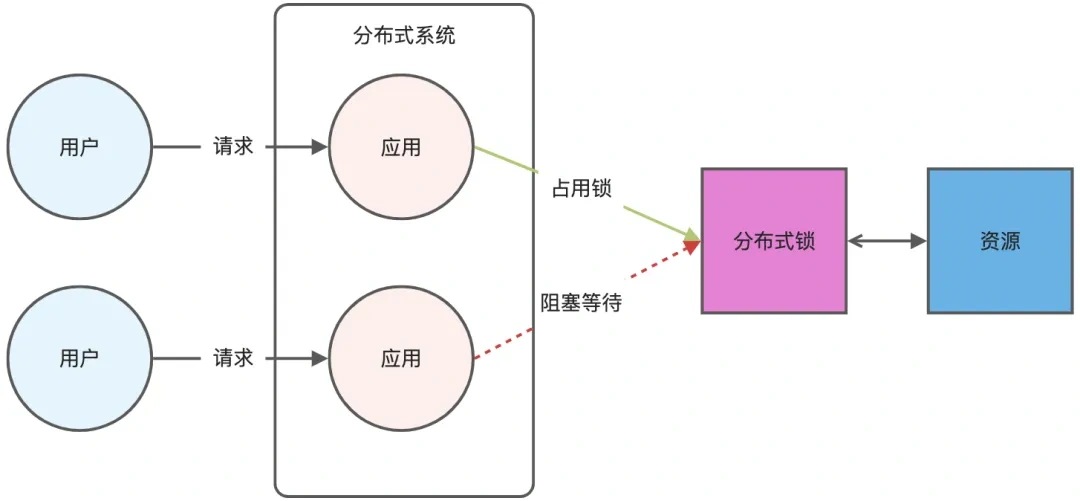
Redis 本身可以被多个客户端共享访问,正好就是一个共享存储系统,可以用来保存分布式锁,而且 Redis 的读写性能高,可以应对高并发的锁操作场景。Redis 的 SET 命令有个 NX 参数可以实现「key不存在才插入」,所以可以用它来实现分布式锁:
- 如果 key 不存在,则返回 OK 表示设置成功,可以用来表示加锁成功;
- 如果 key 存在,则返回空结果表示没有设置,可以用来表示加锁失败。
基于 Redis 节点实现分布式锁时,对于加锁操作,我们需要满足三个条件。
- 加锁包括了读取锁变量、检查锁变量值和设置锁变量值三个操作,但需要以原子操作的方式完成,所以,我们使用 SET 命令带上 NX 选项来实现加锁;
- 锁变量需要设置过期时间,以免客户端拿到锁后发生异常,导致锁一直无法释放,所以,我们在 SET 命令执行时加上 EX/PX 选项,设置其过期时间;
- 锁变量的值需要能区分来自不同客户端的加锁操作,以免在释放锁时,出现误释放操作,所以,我们使用 SET 命令设置锁变量值时,每次加锁都生成一个唯一值,用于标识这一次锁的持有关系;
满足这三个条件的分布式命令如下:
SET lock_key unique_value NX PX 10000
- lock_key 就是 key 键;
- unique_value 是为本次加锁生成的唯一标识,区分不同的加锁请求;
- NX 代表只在 lock_key 不存在时,才对 lock_key 进行设置操作;
- PX 10000 表示设置 lock_key 的过期时间为 10s,这是为了避免客户端发生异常而无法释放锁。
而解锁的过程就是将 lock_key 键删除(del lock_key),但不能乱删,要保证执行操作的客户端就是加锁的客户端。所以,解锁的时候,我们要先判断锁的 unique_value 是否为加锁客户端,是的话,才将 lock_key 键删除。
可以看到,解锁是有两个操作,这时就需要 Lua 脚本来保证解锁的原子性,因为 Redis 在执行 Lua 脚本时,可以以原子性的方式执行,保证了锁释放操作的原子性。
-- 释放锁时,先比较 unique_value 是否相等,避免锁的误释放
if redis.call("get",KEYS[1]) == ARGV[1] then
  return redis.call("del",KEYS[1])
else
  return 0
end
这样一来,就通过使用 SET 命令和 Lua 脚本在 Redis 单节点上完成了分布式锁的加锁和解锁。
比如定时任务由多个应用实例同时触发,但希望同一时刻只有一个实例执行;或者缓存失效后,希望只有一个请求去重建缓存,都可以考虑分布式锁。加锁失败的请求要有超时、退避或者降级逻辑,不能无限等待;涉及资金、库存等重要数据时,数据库约束和幂等仍然需要兜底。
# 分布式锁过期了,但业务还没执行完,怎么办?
这时可能有另一个客户端拿到锁,导致两个请求同时执行原本希望互斥的业务。锁过期只会删除 Redis 中的锁,不会自动停止原来那个客户端的代码。
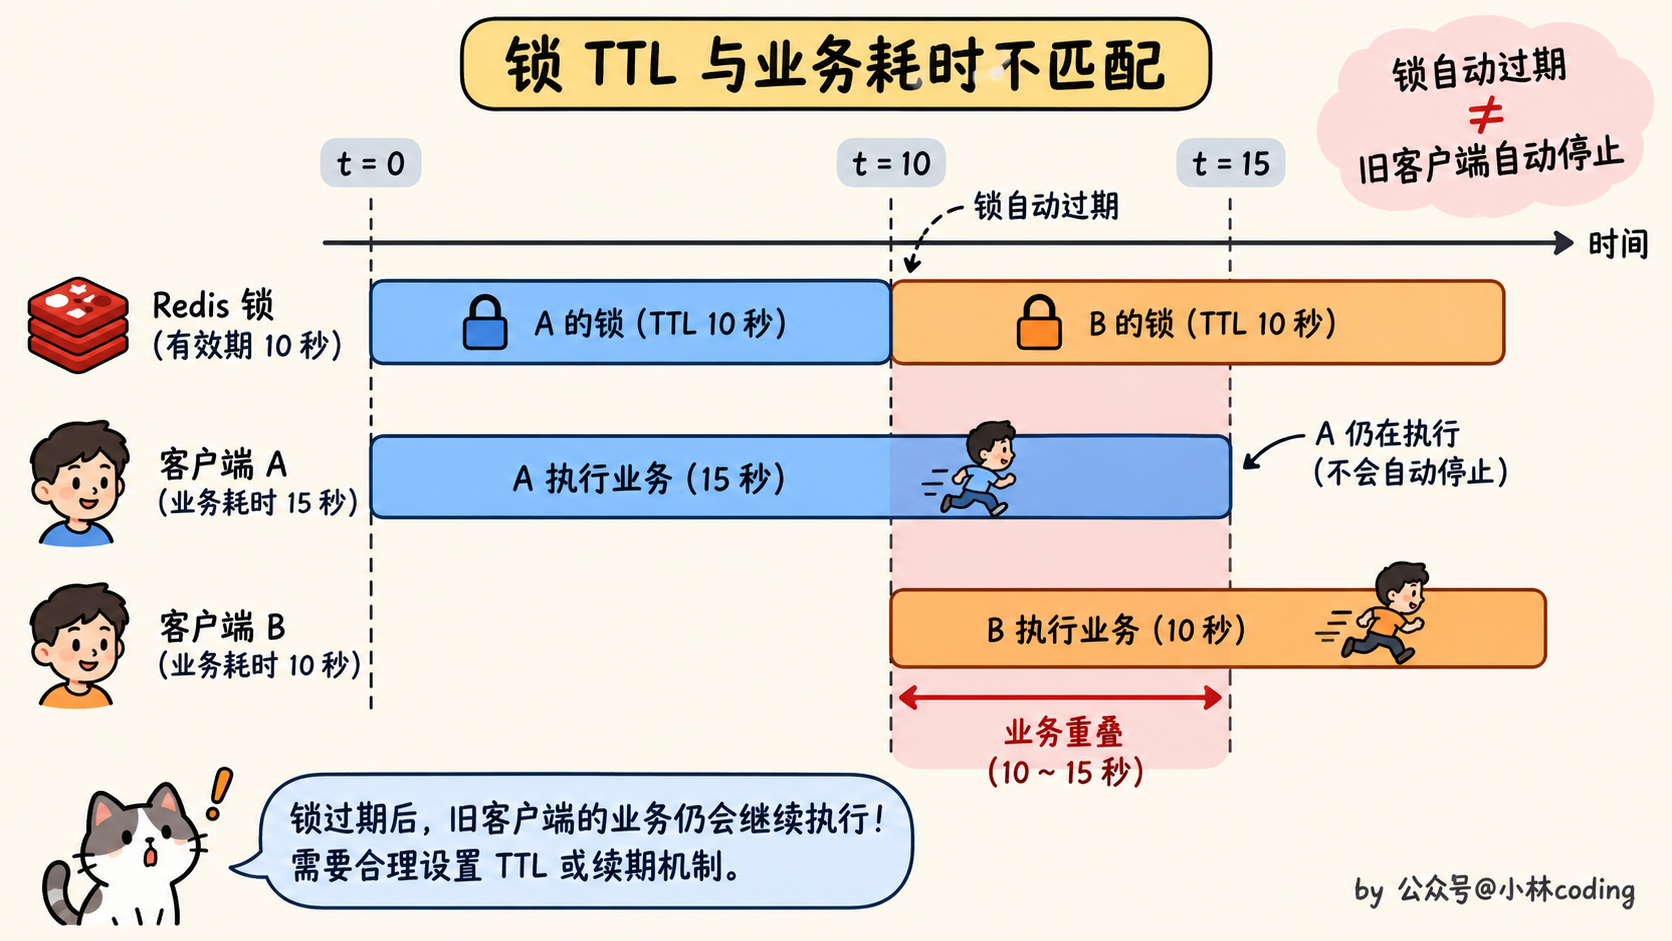
一般可以从两个方向处理。
1、合理设置有效期,并按需要续期
如果业务耗时比较稳定,可以根据耗时设置合理 TTL。如果耗时不确定,可以使用续期机制,定期检查锁仍然属于自己,再延长有效期。判断归属和续期也要用 Lua 放在一起:
-- ARGV[1] 是本次加锁标识,ARGV[2] 是续期毫秒数
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("pexpire", KEYS[1], ARGV[2])
end
return 0
Redisson 的看门狗就是常见的续期方案,在没有指定固定 leaseTime 的常用加锁方式下,按配置自动续期;指定固定 leaseTime 时,则按该有效期释放。具体行为要结合所用版本和 API。
2、业务层也要防止旧请求继续写入
续期并不是绝对保证,客户端可能长时间 GC、线程卡顿或者网络中断,错过续期后仍然继续执行。解锁时判断唯一标识,只能避免误删别人的锁,不能阻止旧请求改业务数据。
如果业务必须拒绝过期持有者,可以使用 fencing token:每次加锁获得一个递增令牌,下游资源记录已接受的令牌,拒绝更旧的请求。令牌生成本身要可靠,不能依赖一个故障切换时可能倒退的计数器,还需要下游真正校验。
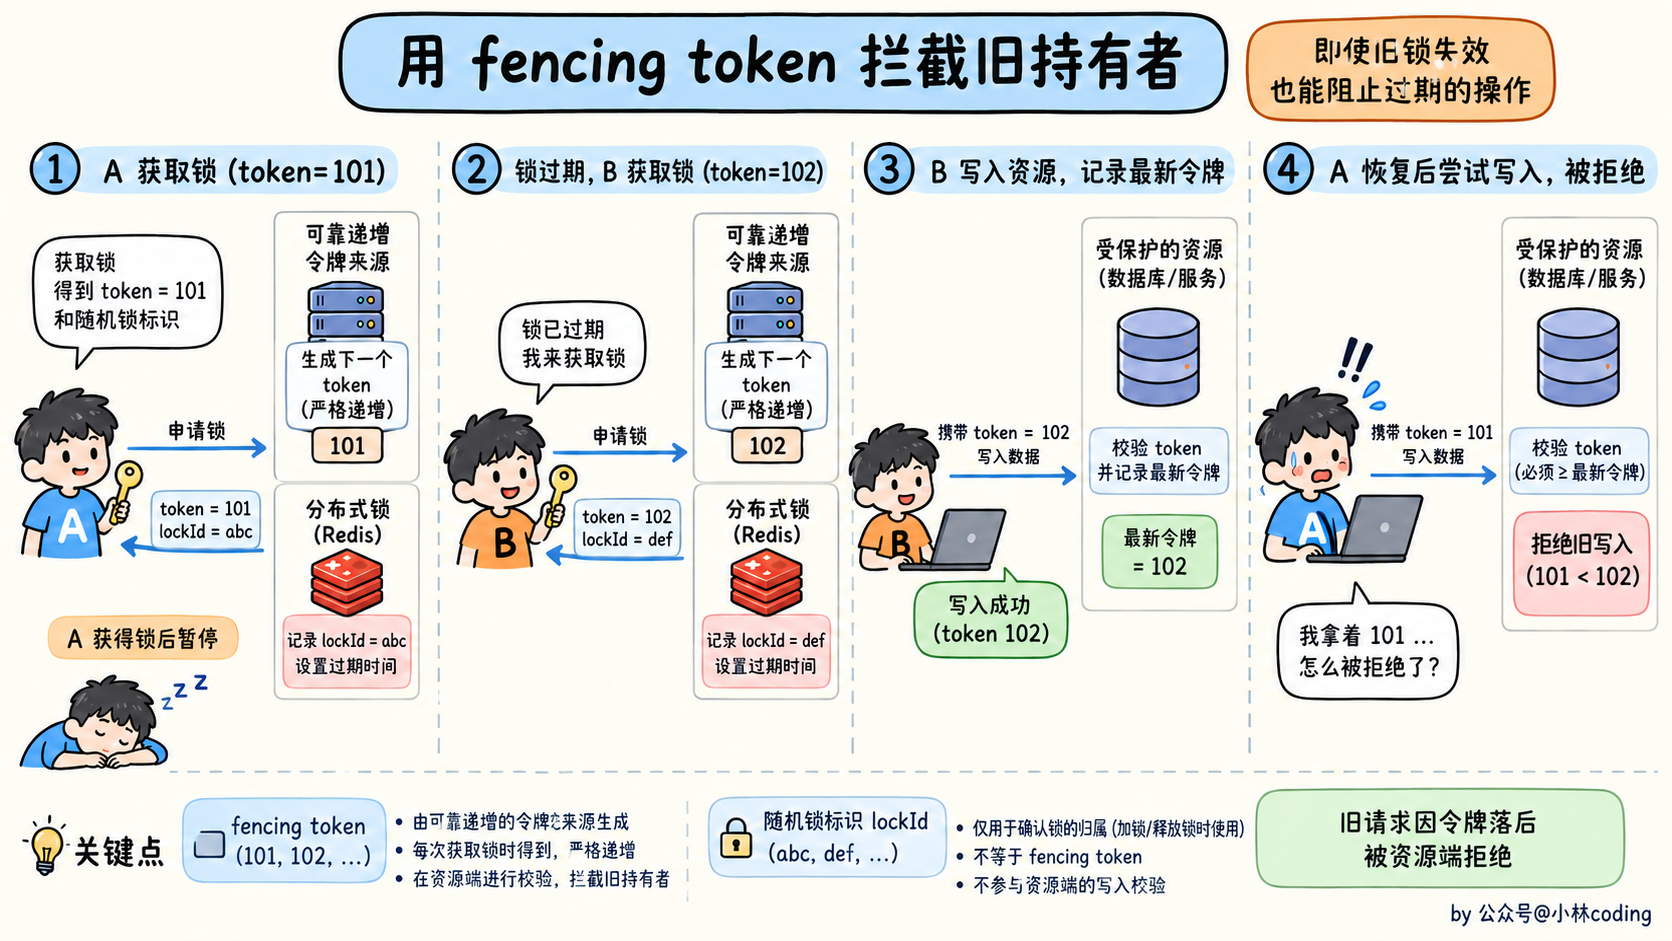
对于订单、库存等业务,也应结合唯一约束、条件更新、版本号和幂等,不能把正确性完全寄托在锁永远不会过期上。
# Redis 主从切换会让分布式锁失效吗?Redlock 怎么处理?
会有风险。比如客户端 A 在主节点加锁成功,但锁还没有复制到从节点,主节点就宕机了。从节点被提升为新主节点后,锁不存在,客户端 B 又可以加锁成功,而 A 的业务还没结束。
所以,给锁设置 TTL、用 Lua 解锁,只解决单节点内的加解锁问题,不能消除异步复制带来的锁丢失窗口。
Redlock 的思路是使用多个相互独立的 Redis 主节点,比如 5 个节点,使用相同的锁 key 和唯一标识分别尝试加锁。判断成功时,不仅要超过半数节点加锁成功,还要满足加锁总耗时小于锁有效期,并扣除耗时和时钟漂移余量,确认还有可用的持锁时间。
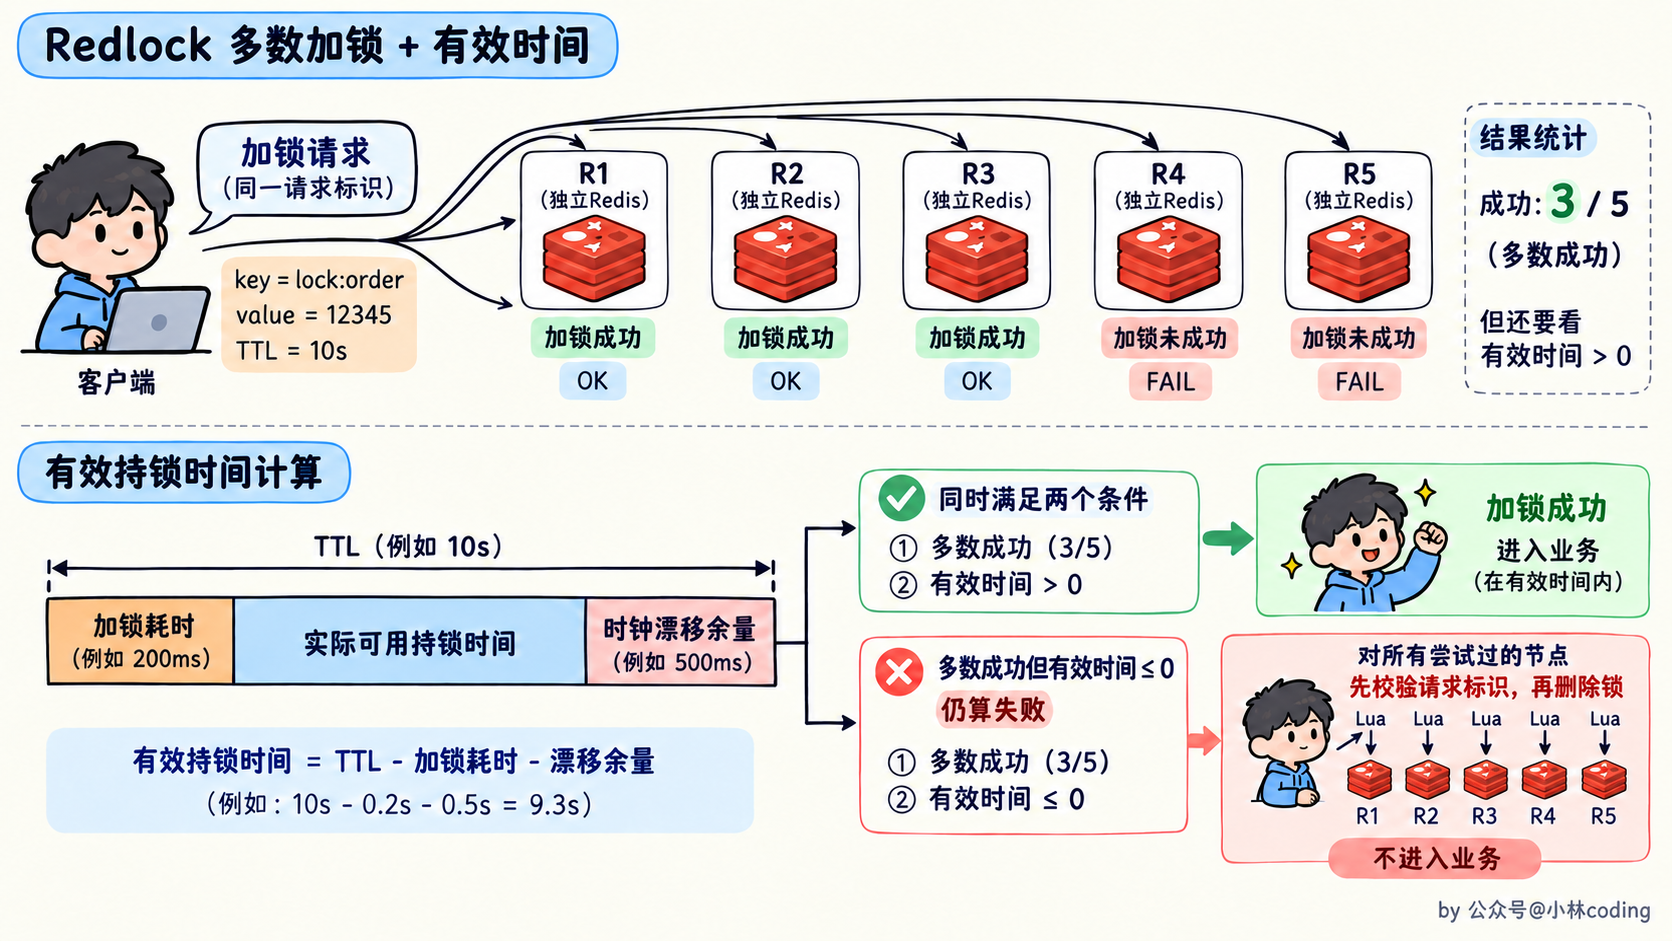
如果没有获得多数锁,或者有效时间不足,就要向所有尝试过的节点发起安全解锁,并在随机退避后重试。访问每个实例的超时应该明显短于整个锁的有效期,避免一个不可用节点耗掉全部时间。
不过,Redlock 依赖时钟和时间边界等假设,也不能停止暂停后恢复的旧客户端。重要业务仍然需要资源端校验、幂等或数据库约束,不能只因为采用多数加锁,就认为获得了绝对的业务互斥保证。
# Redis的大Key问题是什么?
Redis大key问题指的是某个key对应的value值所占的内存空间比较大,导致Redis的性能下降、内存不足、数据不均衡以及主从同步延迟等问题。
到底多大的数据量才算是大key?
没有固定的判别标准,有些团队把字符串 value 超过 1MB,或者集合元素超过 1 万个,作为初步排查阈值,但这不是 Redis 的硬性定义。
Redis大key问题的定义及评判准则并非一成不变,而应根据Redis的实际运用以及业务需求来综合评估。
例如,对高频读取、延迟要求很低的数据,即使只有几十 KB,也可能产生明显的传输和处理开销;而低频访问的数据,即使更大,也未必立即造成瓶颈。因此,在设计与运用Redis时,要依据业务需求与性能指标来确立合理的大key阈值。
# 大Key问题的缺点?
- 内存占用过高。大Key占用过多的内存空间,可能导致可用内存不足,从而触发内存淘汰策略。在极端情况下,可能导致内存耗尽,Redis实例崩溃,影响系统的稳定性。
- 性能下降。大Key会占用大量内存空间,频繁分配、修改和释放大小不一的数据,还可能增加内存碎片。对于大Key的操作,如读取、写入、删除等,都会消耗更多的CPU时间和内存资源,进一步降低系统性能。
- 阻塞其他操作。某些对大Key的操作可能会导致Redis实例阻塞。例如,使用DEL命令删除一个大Key时,可能会导致Redis实例在一段时间内无法响应其他客户端请求,从而影响系统的响应时间和吞吐量。
- 网络拥塞。每次获取大key产生的网络流量较大,可能造成机器或局域网的带宽被打满,同时波及其他服务。例如:一个大key占用空间是1MB,每秒访问1000次,就有1000MB的流量。
- 主从同步延迟。当Redis实例配置了主从同步时,大Key可能导致主从同步延迟。由于大Key占用较多内存,同步过程中需要传输大量数据,这会导致主从之间的网络传输延迟增加,进而影响数据一致性。
- 数据倾斜。在Redis集群模式中,某个数据分片的内存使用率远超其他数据分片,无法使数据分片的内存资源达到均衡。另外也可能造成Redis内存达到maxmemory参数定义的上限导致重要的key被逐出,甚至引发内存溢出。
# Redis大key如何解决?
- 对大Key进行拆分。例如将含有数万成员的一个HASH Key拆分为多个HASH Key,并确保每个Key的成员数量在合理范围。在Redis集群架构中,拆分大Key能对数据分片间的内存平衡起到显著作用。
- 对大Key进行清理。将不适用Redis能力的数据存至其它存储,并在Redis中删除此类数据。注意,要使用异步删除。
- 监控Redis的内存水位。可以通过监控系统设置合理的Redis内存报警阈值进行提醒,例如Redis内存使用率超过70%、Redis的内存在1小时内增长率超过20%等。
- 对过期数据进行定期清理。堆积大量过期数据会造成大Key的产生,例如在HASH数据类型中以增量的形式不断写入大量数据而忽略了数据的时效性。可以通过定时任务的方式对失效数据进行清理。
# 怎么找出 Redis 里的大 key?
可以先做低开销的扫描,再针对候选 key 看内存和访问情况。
- 使用 redis-cli --bigkeys:它基于 SCAN 遍历,统计字符串长度、集合元素数量等,适合初步定位。但集合成员最多,不一定代表占用内存最大。
- 使用 SCAN + MEMORY USAGE:先分批扫描 key,再查看候选 key 的内存占用。对于集合,MEMORY USAGE 默认会抽样估算,想精确遍历全部成员可能增加开销,不能在高峰期对所有大集合都这样做。
- 结合业务和监控:看哪些 key 的大小、成员数量持续增长,以及是否伴随慢日志、带宽升高和复制延迟。
扫描本身也有开销,要控制批次、速率,尽量放在低峰期。在 Cluster 中还需要覆盖各个主节点,扫描一个节点不等于扫完整个集群。
发现大 key 后,不建议直接 HGETALL、SMEMBERS 或读取完整内容来“确认一下”。可以先查看 HLEN、SCARD、ZCARD、STRLEN 等指标,再按需分批查看;清理大集合时优先考虑 UNLINK,避免同步释放大量对象拖慢主线程。
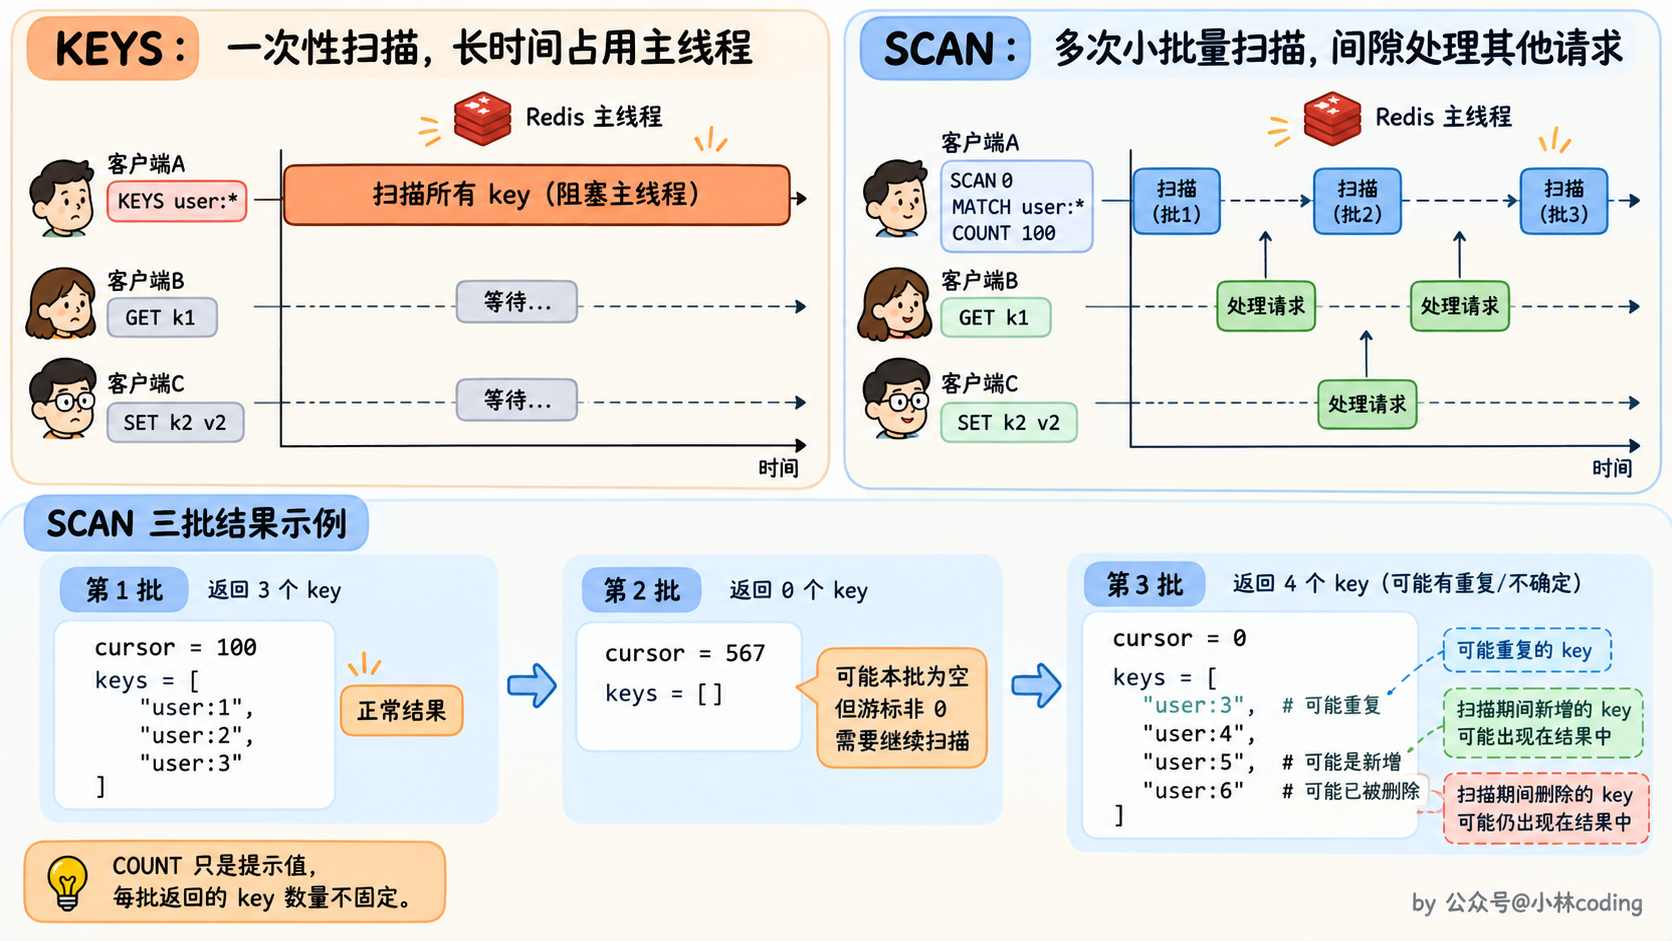
# KEYS 和 SCAN 有什么区别?SCAN 会漏数据吗?
KEYS 会在一次命令中遍历数据库并返回所有匹配 key。数据量很大时,这个过程会长时间占用主线程,所以不适合在线上直接使用 KEYS *。
SCAN 则通过游标分批遍历,每次只做一部分工作,让 Redis 有机会在两次扫描之间处理其他请求。
SCAN 0 MATCH user:* COUNT 100
# 使用返回的新游标继续扫描,直到游标重新变成 0
不过,SCAN 不是快照,也不是严格分页,要注意几个边界:
- 可能返回重复 key:客户端需要去重,或者让后续处理具备幂等性。
- COUNT 是工作量提示:不保证每次恰好返回这么多 key,甚至可能返回空列表;只有游标返回 0 才表示本轮结束。
- 并发变化时结果不固定:完整扫描期间一直存在的 key 能被返回;中途新增、删除或者删除后重建的 key,是否被返回不保证。
所以,SCAN 适合在线巡检、增量清理等场景,但不能直接当成某一时刻所有 key 的精确快照。
# 什么是热key?
通常以其接收到的Key被请求频率来判定,例如:
- QPS集中在特定的Key:Redis实例的总QPS(每秒查询率)为10,000,而其中一个Key的每秒访问量达到了7,000。
- 带宽使用率集中在特定的Key:对一个拥有上千个成员且总大小为1 MB的HASH Key每秒发送大量的HGETALL操作请求。
- CPU使用时间占比集中在特定的Key:对一个拥有数万个成员的Key(ZSET类型)每秒发送大量的ZRANGE操作请求。
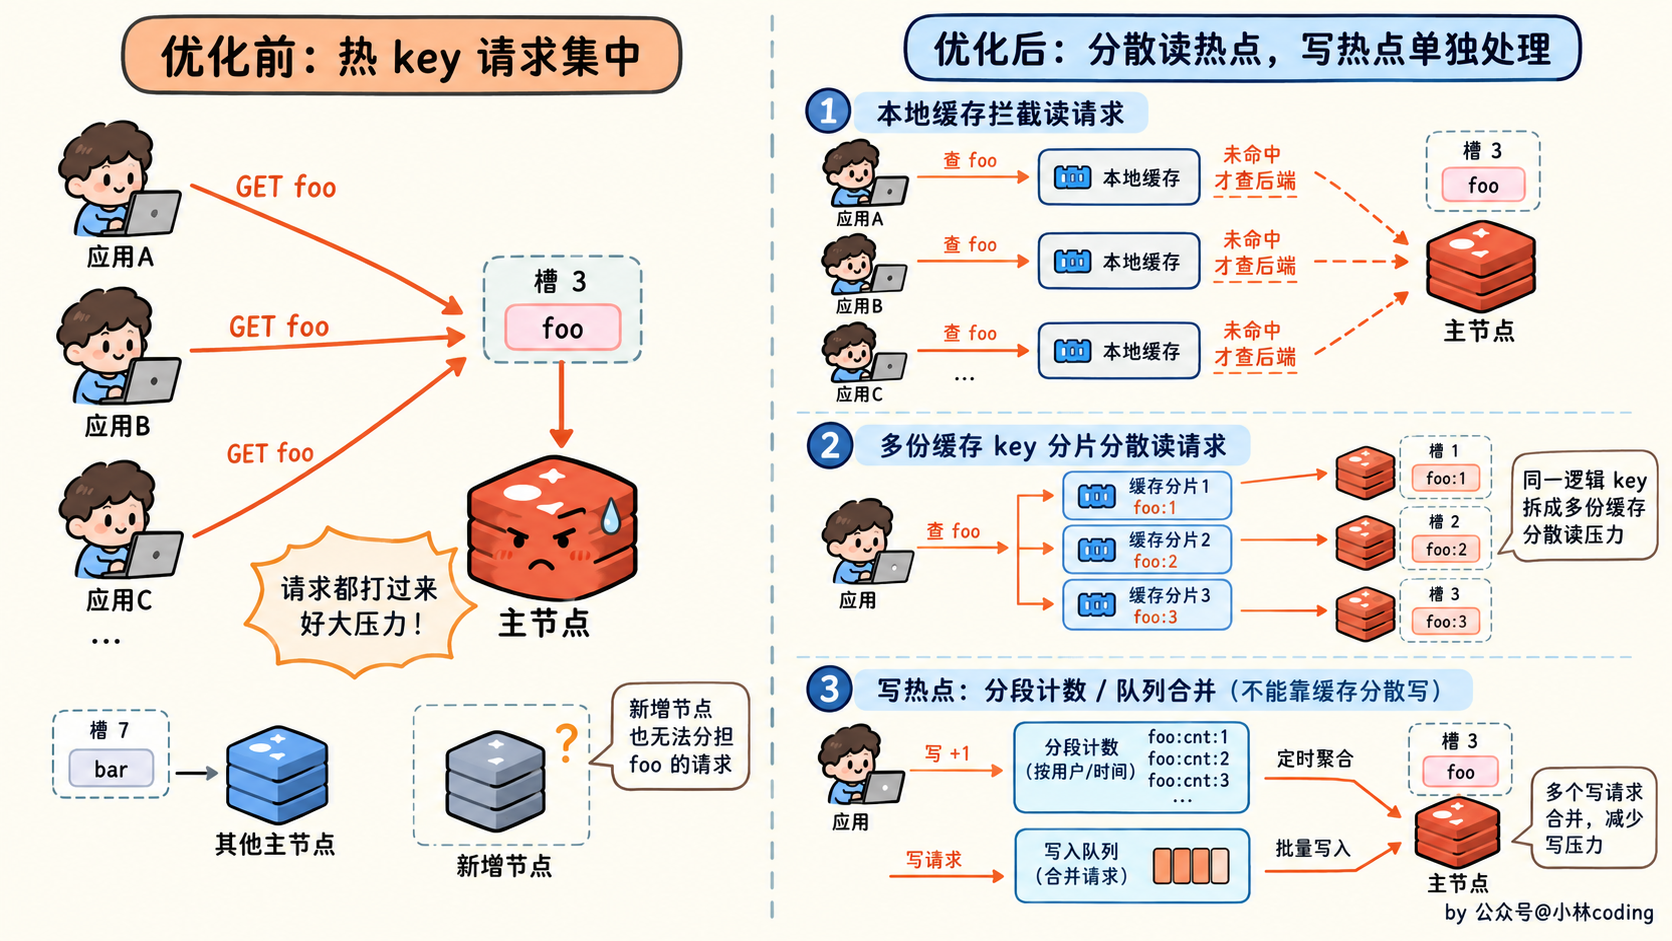
# 如何解决热key问题?
先区分是读热点还是写热点,因为处理方法不一样。
1、读热点
- 使用本地缓存:把少量热点数据缓存在应用进程里,让一部分请求不再访问 Redis。需要设置容量和有效期,或者通过变更通知失效,控制旧数据的使用时间。
- 复制成多个缓存 key:对于允许短暂不一致、更新不频繁的数据,可以复制多份,让请求随机访问不同 key。在 Cluster 中要确保这些 key 实际分布到不同槽和分片上,不能使用同一个 hash tag 把它们又放回同一个槽。更新时也要处理多份缓存的失效问题。
- 读从节点:可以分散读取压力,但要接受主从延迟。客户端需要支持副本读取和负载分配,不是加了从节点就自动分流。
2、写热点
本地缓存和读从节点不能直接解决写热点。可以根据业务把一个全局计数拆成多个分段计数,最后汇总,或者通过队列合并更新。
不过,如果业务要求每次更新都获得一个全局精确值,拆分就会改变语义,要仔细判断是否适合。
另外,增加 Cluster 节点不能自动拆开一个热 key。一个 key 仍然由一个主节点负责,所以要从访问方式和数据模型上分散压力,并配合限流防止单个热点拖慢整个实例。
# 如何保证 redis 和 mysql 数据缓存一致性问题?
对于读数据,我会选择旁路缓存(Cache Aside)策略:先读缓存,缓存不命中就查询数据库,再把结果写入缓存。对于写数据,我会选择先更新数据库,事务提交成功后,再删除缓存。如果数据库还没提交就删缓存,其他请求可能把旧值重新放回去。
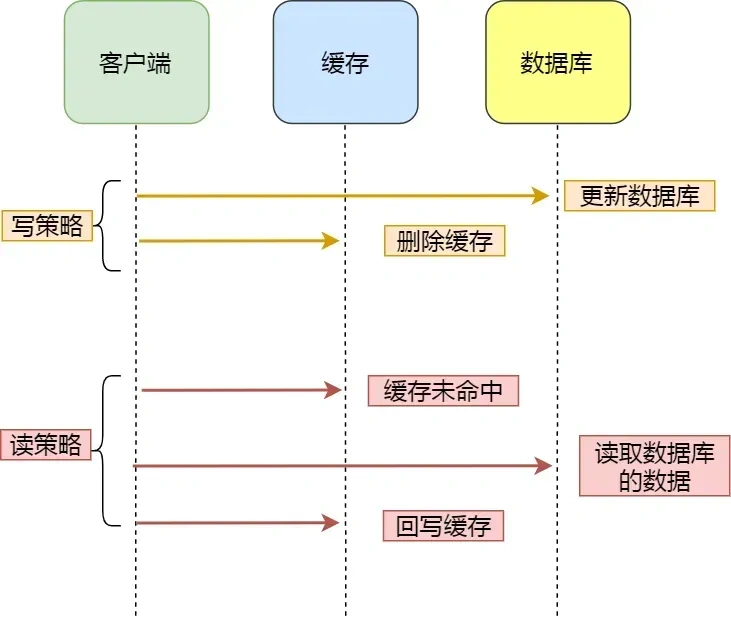
这套方案比较常用,但数据库更新和缓存删除是两个独立操作,并不能天然保证强一致。比如数据库更新成功了,缓存删除失败,后面的请求仍然可能读到旧缓存。
所以,要先明确业务能接受多长时间的旧数据。如果余额、库存确认等关键判断需要以最新状态为准,就应当以数据库或权威服务的结果为准,不能只依赖缓存。关键在于数据库和缓存的更新无法作为一个普通数据库事务一起提交,需要处理两者之间的失败窗口。
所以使用缓存提升性能,就是会有数据更新的延迟。这需要我们在设计时结合业务仔细思考是否适合用缓存。然后缓存一定要设置过期时间,这个时间太短、或者太长都不好:
- 太短的话请求可能会比较多的落到数据库上,这也意味着失去了缓存的优势。
- 太长的话缓存中的脏数据会使系统长时间处于一个延迟的状态,而且系统中长时间没有人访问的数据一直存在内存中不过期,浪费内存。
通过过期时间、可靠的失效通知和失败重试,可以让缓存逐步回到数据库的最新状态,也就是通常说的最终一致性。但还要处理旧值回填等竞态,不能只要引入消息队列就认为所有问题都解决了。
针对删除缓存异常的情况,可以使用 2 个方案降低影响:
- 删除缓存重试策略(消息队列)
- 订阅 binlog,再删除缓存(Canal+消息队列)
消息队列方案
我们可以引入消息队列,将第二个操作(删除缓存)要操作的数据加入到消息队列,由消费者来操作数据。
- 如果应用删除缓存失败,可以从消息队列中重新读取数据,然后再次删除缓存,这个就是重试机制。当然,如果重试超过一定次数仍然失败,就要记录失败任务并告警,安排后续补偿,不能直接把任务丢掉。
- 如果删除缓存成功,就确认这条消息已经处理完成;没有成功则继续重试,重复删除同一个缓存 key 也应当安全。
举个例子,来说明重试机制的过程。
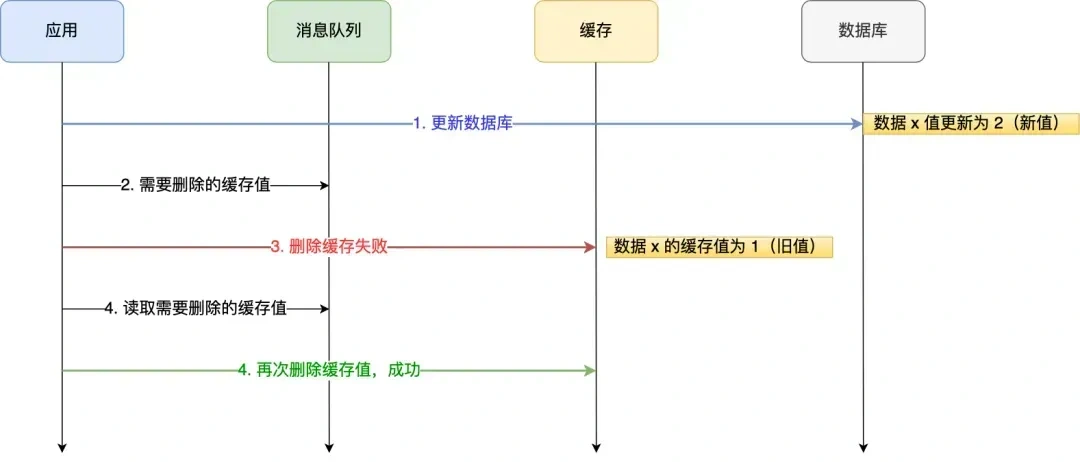
这里还要注意,数据库提交后,应用可能在“发送重试消息”之前就宕机。如果只是删除失败后临时发送一条 MQ 消息,这个窗口仍然存在。
可以把需要失效的缓存 key 写入数据库的任务表,并和业务更新放在同一个事务里,再由后台任务可靠地投递消息和重试删除;也可以通过订阅 binlog 捕获已提交的变更。这样不会把可靠性完全依赖在一次同步删除或一次发送消息上。
重试删除缓存可以缩短异常导致的不一致时间,但会对业务代码产生一定侵入。
订阅 MySQL binlog,再操作缓存
「先更新数据库,再删缓存」的策略的第一步是更新数据库,那么更新数据库成功,就会产生一条变更日志,记录在 binlog 里。
于是我们就可以通过订阅 binlog 日志,拿到具体要操作的数据,然后再执行缓存删除,阿里巴巴开源的 Canal 中间件就是基于这个实现的。
Canal 模拟 MySQL 主从复制的交互协议,把自己伪装成一个 MySQL 的从节点,向 MySQL 主节点发送 dump 请求,MySQL 收到请求后,就会开始推送 Binlog 给 Canal,Canal 解析 Binlog 字节流之后,转换为便于读取的结构化数据,供下游程序订阅使用。
下图是 Canal 的工作原理:
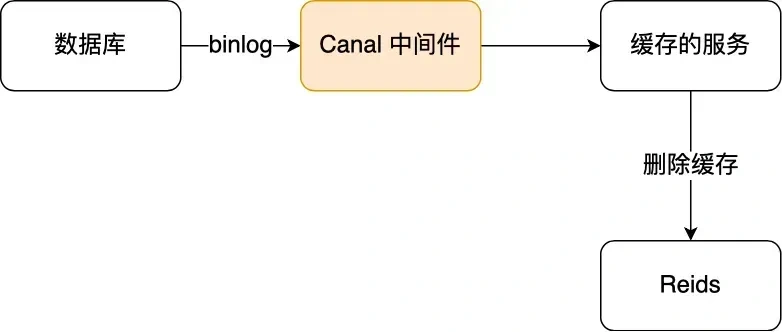
将 binlog 变更投递到 MQ 后,由消费者根据变更删除对应的缓存,删除成功再 ACK,失败则重试;还需要监控消费积压和重试失败,避免失效事件长期没有被处理。删除操作本身可以幂等执行,但 ACK 只说明消息处理进度,不代表数据库和缓存获得了强一致性。
# 更新数据库后,为什么通常删除缓存,而不是更新缓存?
主要是为了减少并发更新造成的覆盖问题,也避免每次写入都去重建缓存。
举个例子,商品价格原来是 100,两个请求先后把数据库更新为 110、120。由于网络和执行速度不同,写入缓存的顺序可能反过来:120 先写入缓存,110 后写入缓存,最后数据库是 120,缓存却是 110。
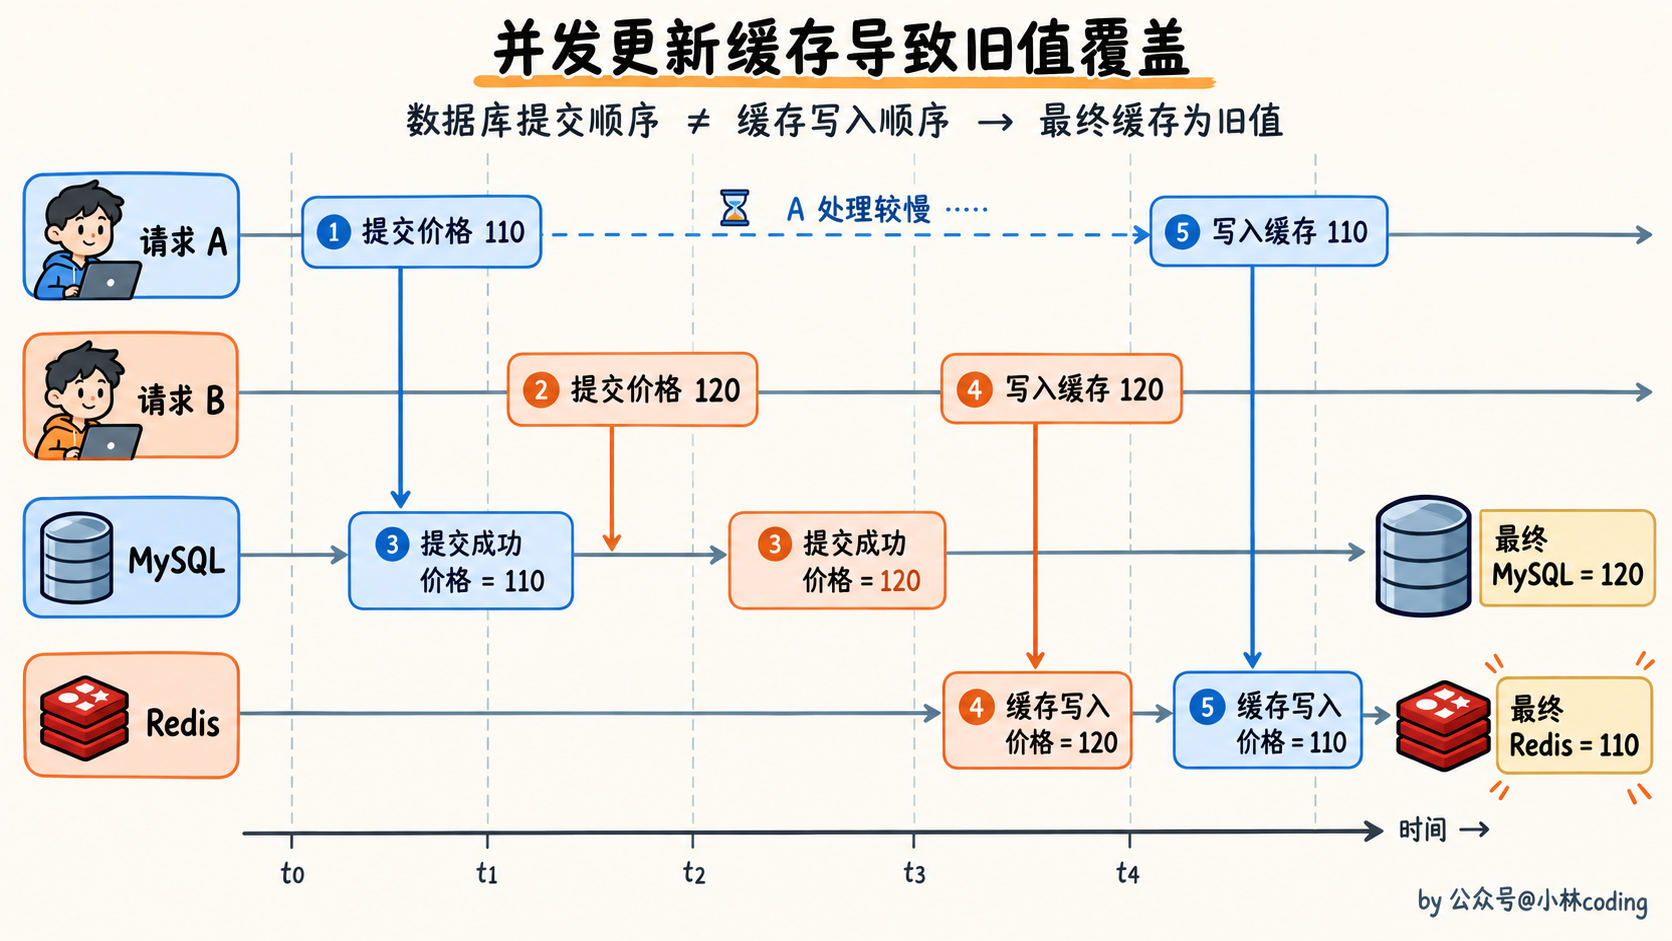
如果更新数据库后删除缓存,后续读取时再从数据库加载最新值,就不用让每个写请求都把自己读到或者计算出的值写进缓存。对于需要关联多个表、组装成本较高的数据,也能避免更新后没有人读取,却白白重建缓存。
那为什么不先删缓存再更新数据库?因为删完之后,另一个读请求可能在数据库提交前读到旧值,又把旧值填回缓存,而写请求提交后没有再次删除,这个旧值就会继续存在。
因此,先提交数据库,再删除缓存通常更合适。但这仍然存在删除失败和旧值回填的窗口,需要可靠重试、有效期和业务上的一致性要求一起配合。
# 先更新数据库再删缓存,还会出现旧值回填吗?
会。虽然这个窗口通常比较短,但不能说不存在。
可以看下面这个执行顺序:
- 请求 A 查询缓存未命中,去数据库读到旧值 100,随后暂时停顿。
- 请求 B 把数据库更新成 120,提交成功,并删除缓存。
- 请求 A 恢复执行,把之前读到的 100 写回缓存。
最终数据库是 120,缓存却又变成了 100。所以,删除缓存成功并不等于后面一定不会再有旧值写入。
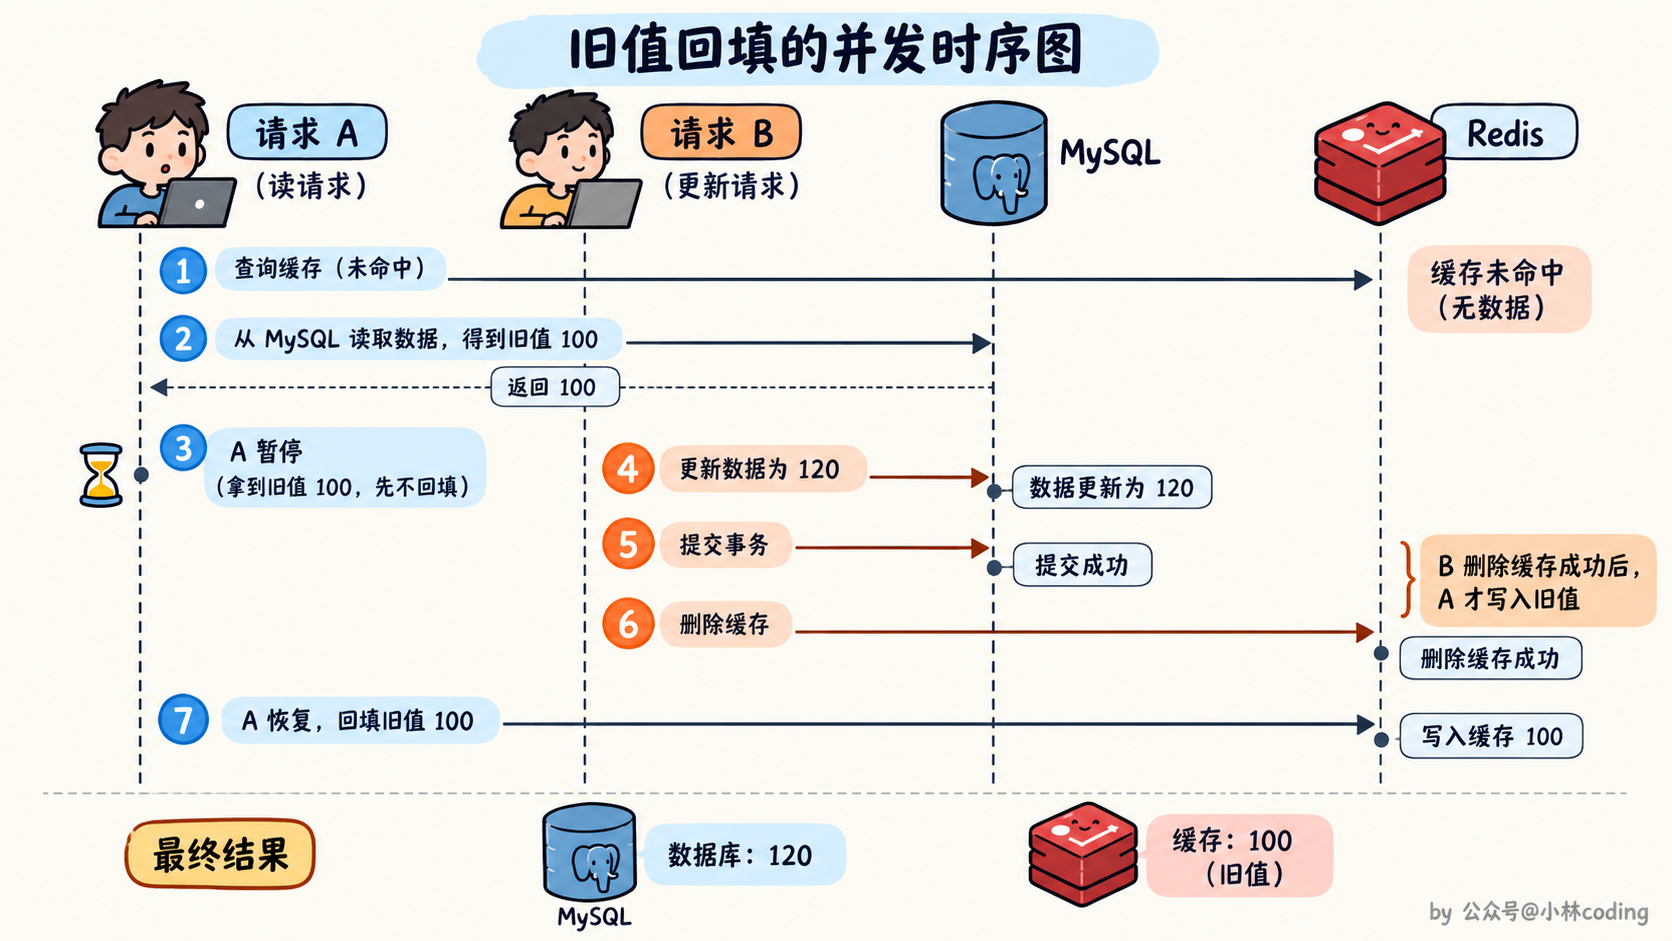
如果业务能接受短暂旧数据,可以用较短 TTL 兜底,必要时增加延迟删除,降低旧值回填的影响。但延迟多久很难完全覆盖慢请求、线程暂停和副本延迟,延迟双删也不能当成强一致保证。
如果要求更严格,可以把数据库提交后的失效和缓存回填纳入同一套协调机制,例如让更新方提交成功后持有同一个业务锁完成删除,读取方持锁重新查库并回填。这里还要处理锁超时和故障,所有写入路径都要遵守约定;对于关键业务判断,直接查询数据库通常更清楚。
另外,如果缓存未命中后读取的是 MySQL 从库,即使缓存删除成功,也可能把从库尚未更新的旧值填回来。因此,回源读哪个数据库节点,也是缓存一致性设计的一部分。
# 缓存雪崩、击穿、穿透是什么?怎么解决?
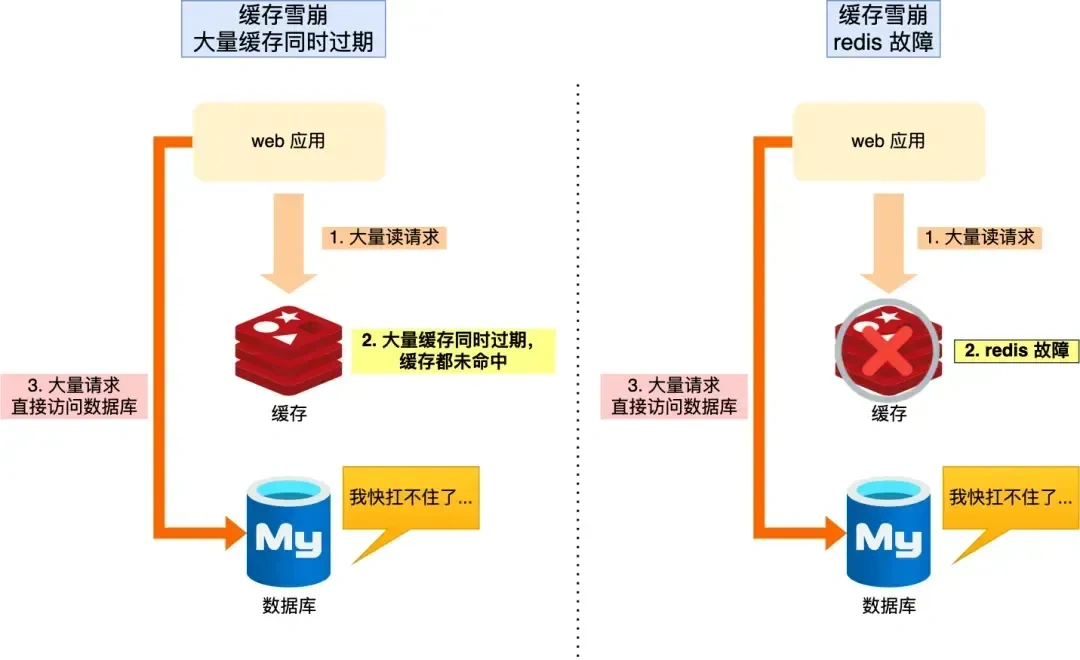
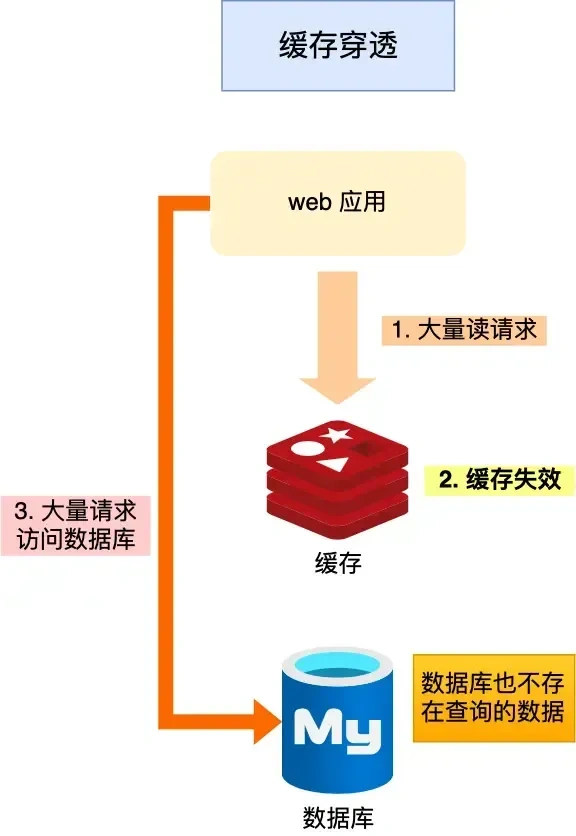
- 缓存雪崩:当大量缓存数据在同一时间过期(失效)或者 Redis 故障宕机时,如果此时有大量的用户请求,都无法在 Redis 中处理,于是全部请求都直接访问数据库,从而导致数据库的压力骤增,严重的会造成数据库宕机,从而形成一系列连锁反应,造成整个系统崩溃,这就是缓存雪崩的问题。
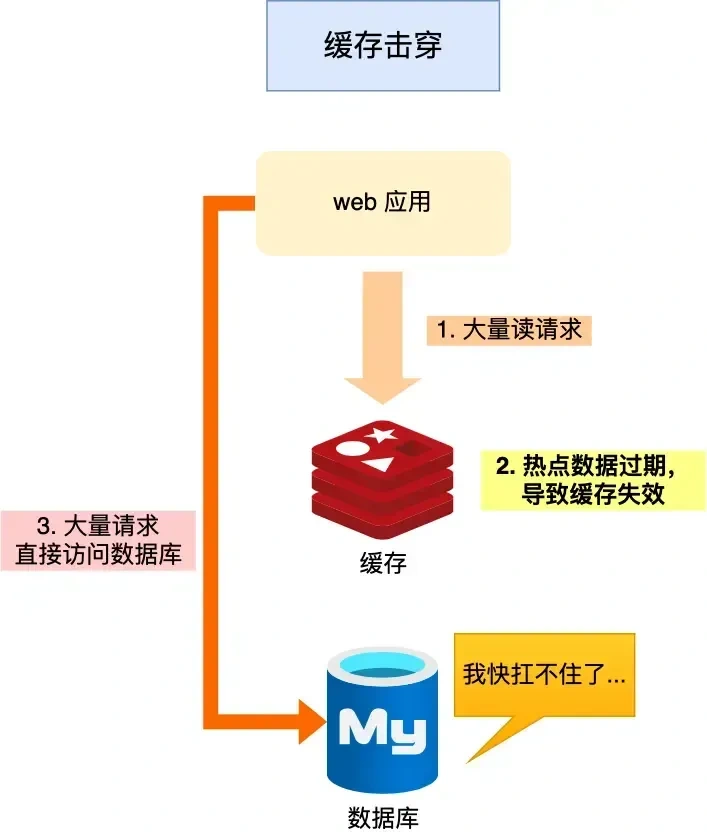
- 缓存击穿:如果缓存中的某个热点数据过期了,此时大量的请求访问了该热点数据,就无法从缓存中读取,直接访问数据库,数据库很容易就被高并发的请求冲垮,这就是缓存击穿的问题。
- 缓存穿透:当用户访问的数据,既不在缓存中,也不在数据库中,导致请求在访问缓存时,发现缓存缺失,再去访问数据库时,发现数据库中也没有要访问的数据,没办法构建缓存数据,来服务后续的请求。那么当有大量这样的请求到来时,数据库的压力骤增,这就是缓存穿透的问题。
缓存雪崩解决方案:
- 均匀设置过期时间:如果要给缓存数据设置过期时间,应该避免将大量的数据设置成同一个过期时间。我们可以在对缓存数据设置过期时间时,给这些数据的过期时间加上一个随机数,这样就保证数据不会在同一时间过期。
- 互斥锁:当业务线程在处理用户请求时,如果发现访问的数据不在 Redis 里,就加个互斥锁,保证同一时间内只有一个请求来构建缓存(从数据库读取数据,再将数据更新到 Redis 里),当缓存构建完成后,再释放锁。未能获取互斥锁的请求,要么等待锁释放后重新读取缓存,要么就返回空值或者默认值。实现互斥锁的时候,最好设置超时时间,不然第一个请求拿到了锁,然后这个请求发生了某种意外而一直阻塞,一直不释放锁,这时其他请求也一直拿不到锁,整个系统就会出现无响应的现象。
- 预热和后台刷新:对确定会被大量访问的数据,提前加载,或者在过期前异步刷新。可以结合逻辑过期允许短暂返回旧值,同时设置容量和清理机制,避免数据一直积累。
- 处理 Redis 故障:过期时间加随机数只解决集中失效,不能解决 Redis 宕机。此时还需要高可用、熔断、限流和降级,限制数据库回源并发,不能把所有流量直接放到数据库上。同一个 key 的互斥重建也不能限制大量不同 key 的总回源流量。
缓存击穿解决方案:
- 互斥锁方案,保证同一时间只有一个业务线程更新缓存,未能获取互斥锁的请求,要么等待锁释放后重新读取缓存,要么就返回空值或者默认值。
- 逻辑过期或者提前刷新:在缓存里记录业务过期时间,数据到期后由一个请求异步刷新,其他请求暂时使用旧值。这种方式能减少同步等待,但需要业务允许短暂旧数据,并做好刷新失败的重试和物理过期、清理机制。
使用互斥锁时,拿到锁之后还要再次检查缓存,可能前一个请求已经重建完成。锁最好按业务 key 设置,并有超时和安全解锁;没有拿到锁的请求应当限次重试、等待后重读或者降级,不能全部继续查数据库。
缓存穿透解决方案:
- 非法请求的限制:当有大量恶意请求访问不存在的数据的时候,也会发生缓存穿透,因此在 API 入口处我们要判断请求参数是否合理,请求参数是否含有非法值、请求字段是否存在,如果判断出是恶意请求就直接返回错误,避免进一步访问缓存和数据库。
- 缓存空值或者默认值:当我们线上业务发现缓存穿透的现象时,可以针对不存在的数据缓存一个可识别的空值标记,设置较短 TTL,让后续请求直接返回未找到,避免继续查数据库。空值标记要和缓存未命中区分;如果这条数据后来被创建,还要主动删除空值缓存,否则新数据要等 TTL 到期才可见。
- 布隆过滤器:我们可以在写入数据库数据时,使用布隆过滤器做个标记,然后在用户请求到来时,业务线程确认缓存失效后,可以通过查询布隆过滤器快速判断数据是否存在,如果不存在,就不用通过查询数据库来判断数据是否存在。即使发生了缓存穿透,大量请求只会查询 Redis 和布隆过滤器,而不会查询数据库,降低无效请求对数据库的压力。Redis 中可以使用 RedisBloom 等能力,也可以用 Bitmap 自行实现,但要确认所用版本和部署是否提供相应命令;普通旧版 Redis 并不是默认就有 BF.ADD、BF.EXISTS。
# 布隆过滤器原理介绍一下
布隆过滤器由「初始值都为 0 的位图数组」和「 N 个哈希函数」两部分组成。当我们在写入数据库数据时,在布隆过滤器里做个标记,这样下次查询数据是否在数据库时,只需要查询布隆过滤器,如果查询到数据没有被标记,说明不在数据库中。
布隆过滤器会通过 3 个操作完成标记:
- 第一步,使用 N 个哈希函数分别对数据做哈希计算,得到 N 个哈希值;
- 第二步,将第一步得到的 N 个哈希值对位图数组的长度取模,得到每个哈希值在位图数组的对应位置。
- 第三步,将每个哈希值在位图数组的对应位置的值设置为 1;
举个例子,假设有一个位图数组长度为 8,哈希函数 3 个的布隆过滤器。
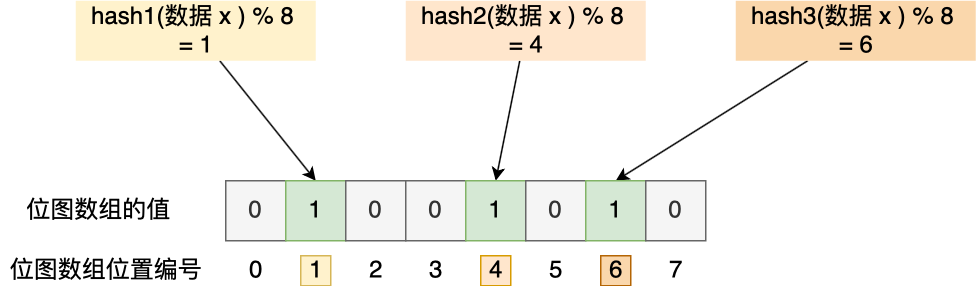
在数据库写入数据 x 后,把数据 x 标记在布隆过滤器时,数据 x 会被 3 个哈希函数分别计算出 3 个哈希值,然后在对这 3 个哈希值对 8 取模,假设取模的结果为 1、4、6,然后把位图数组的第 1、4、6 位置的值设置为 1。当应用要查询数据 x 是否在数据库中时,通过布隆过滤器只要查到位图数组的第 1、4、6 位置的值是否全为 1,只要有一个为 0,就认为数据 x 不在数据库中。
布隆过滤器由于是基于哈希函数实现查找的,高效查找的同时存在哈希冲突的可能性,比如数据 x 和数据 y 可能都落在第 1、4、6 位置,而事实上,可能数据库中并不存在数据 y,存在误判的情况。
所以,布隆过滤器判断“存在”,只是可能存在;判断“不存在”,对于已经正确加入过滤器的数据来说,一定不存在。
这里的前提是过滤器已经覆盖需要判断的数据。如果数据库新增成功,但过滤器还没更新,查询也可能被错误拦截,这是同步延迟造成的,不是布隆过滤器算法本身的误判。
另外,普通布隆过滤器不能直接把删除元素对应的位清零,因为其他元素可能也使用了这些位。删除数据较多时,可以定期重建,或者考虑支持删除的其他过滤器方案。容量和哈希函数数量也要合理设置,写入远超设计容量后,误判率会升高。
# Redis Stream 怎么保证消息消费?消费者宕机怎么办?
Stream 提供了消费组、待处理消息列表和 ACK,可以追踪消息有没有被处理。
比如创建一个订单消费组,再读取新消息:
# 从已有消息开始消费,如果 Stream 不存在就创建
XGROUP CREATE orders order-group 0 MKSTREAM
# consumer-1 获取这个组还没有投递过的新消息
XREADGROUP GROUP order-group consumer-1 COUNT 10 BLOCK 2000 STREAMS orders >
# 业务处理成功后,确认实际返回的消息 ID
XACK orders order-group 1720000000000-0
XREADGROUP 投递消息后,在没有使用 NOACK 的情况下,会把消息登记到消费组的 PEL(Pending Entries List,待处理消息列表) 中。消费者处理成功后调用 XACK,把它从 PEL 移除。注意,XACK 不是删除 Stream 中的消息本体。
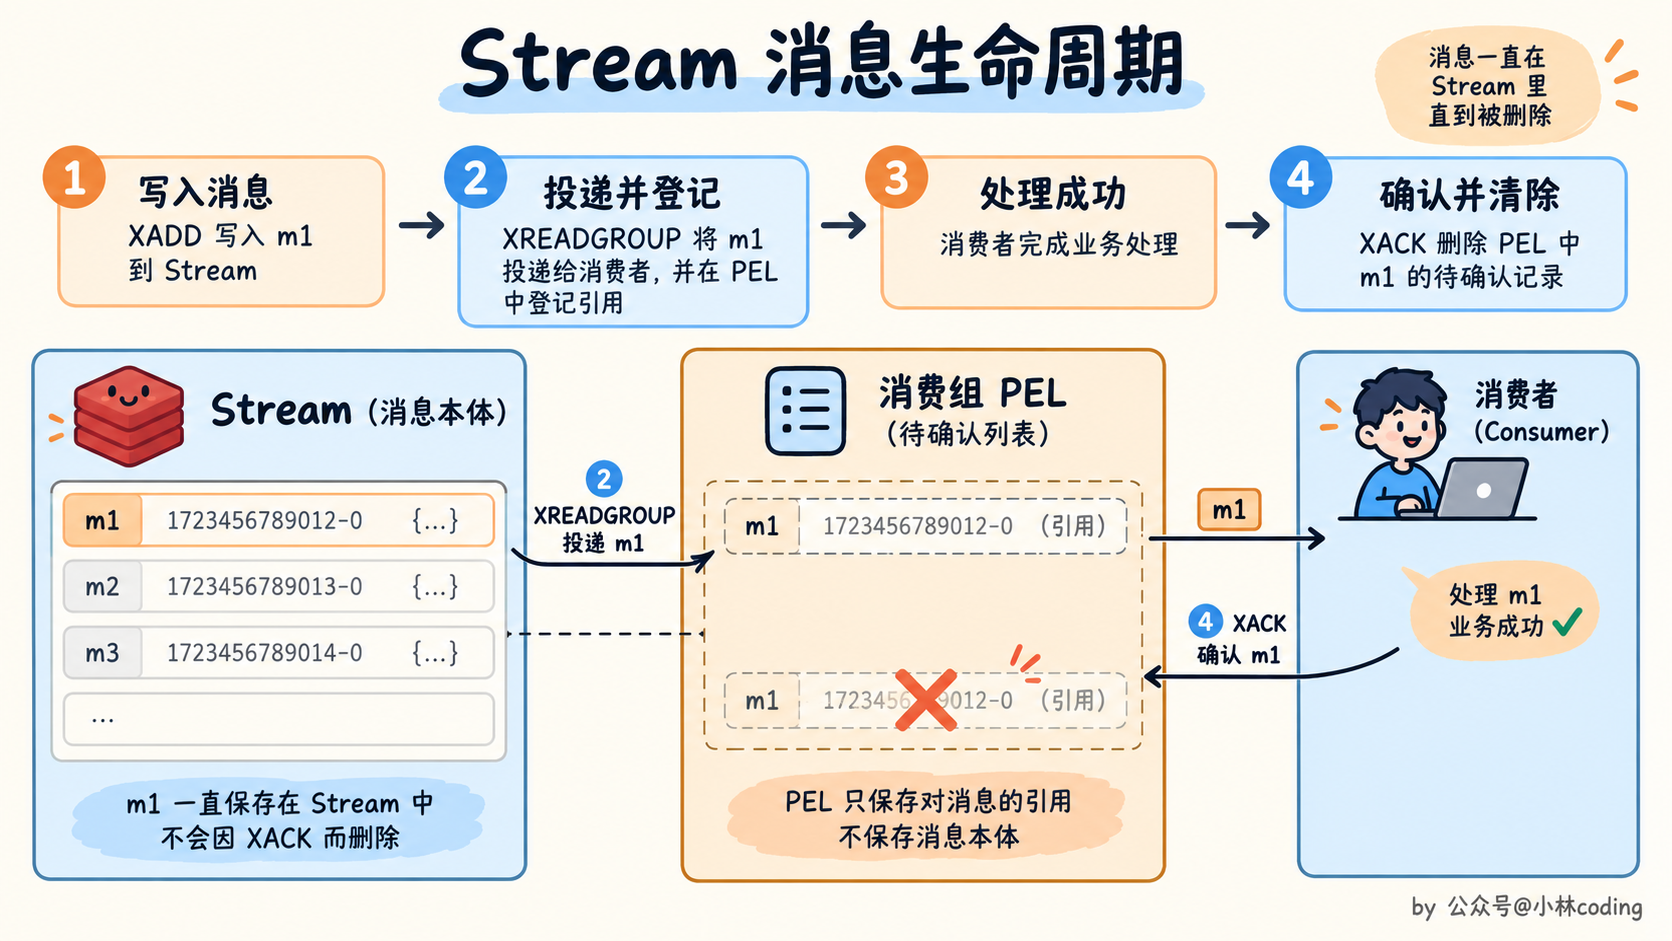
如果消费者处理过程中宕机,消息仍然留在 PEL。可以通过 XPENDING 查看待处理消息,再用 XCLAIM,或者 Redis 6.2 起的 XAUTOCLAIM,把超过合理空闲时间的消息转给其他消费者处理。
这里还有一个很重要的情况:业务已经成功,但消费者在 ACK 前宕机了,消息就可能被再次处理。所以,消费确认和业务执行不是一个原子事务,消费者必须做幂等,比如用消息 ID、订单号和数据库唯一约束去重。
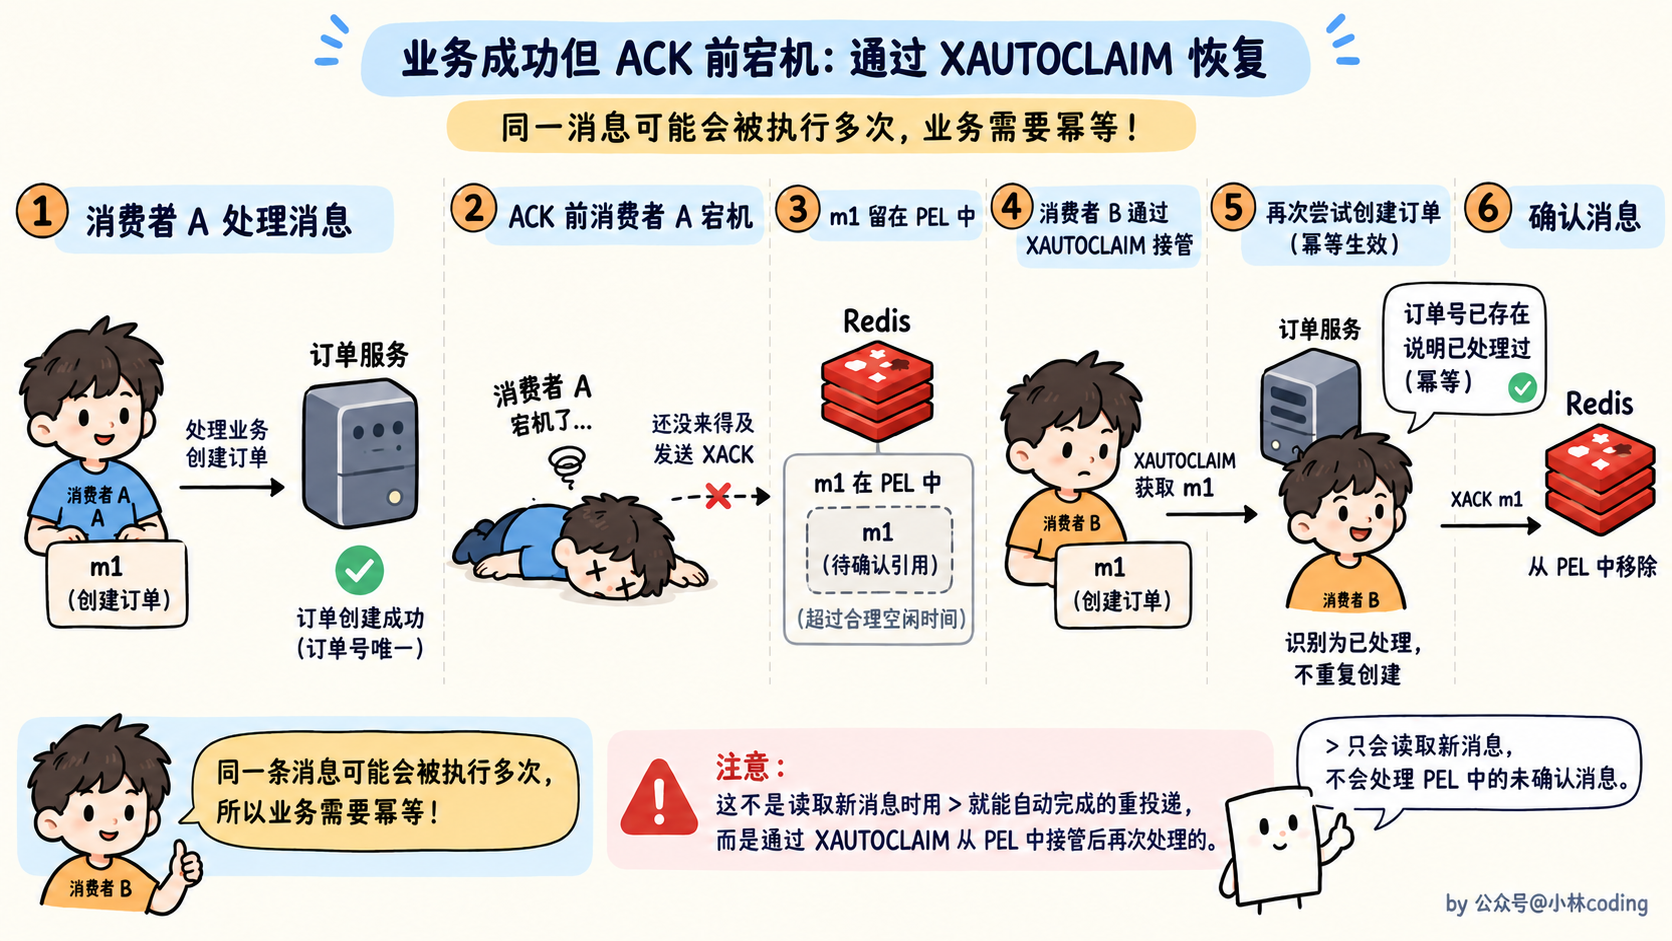
另外,读取新消息时用的 > 不会自动把所有待处理消息重新投递给其他消费者,恢复任务需要主动处理 PEL。消息裁剪也要考虑未确认数据,不能把还要重试的消息提前裁掉;底层 Redis 的持久化和故障切换,同样会影响消息是否保留。
# Redis 怎么实现限流?
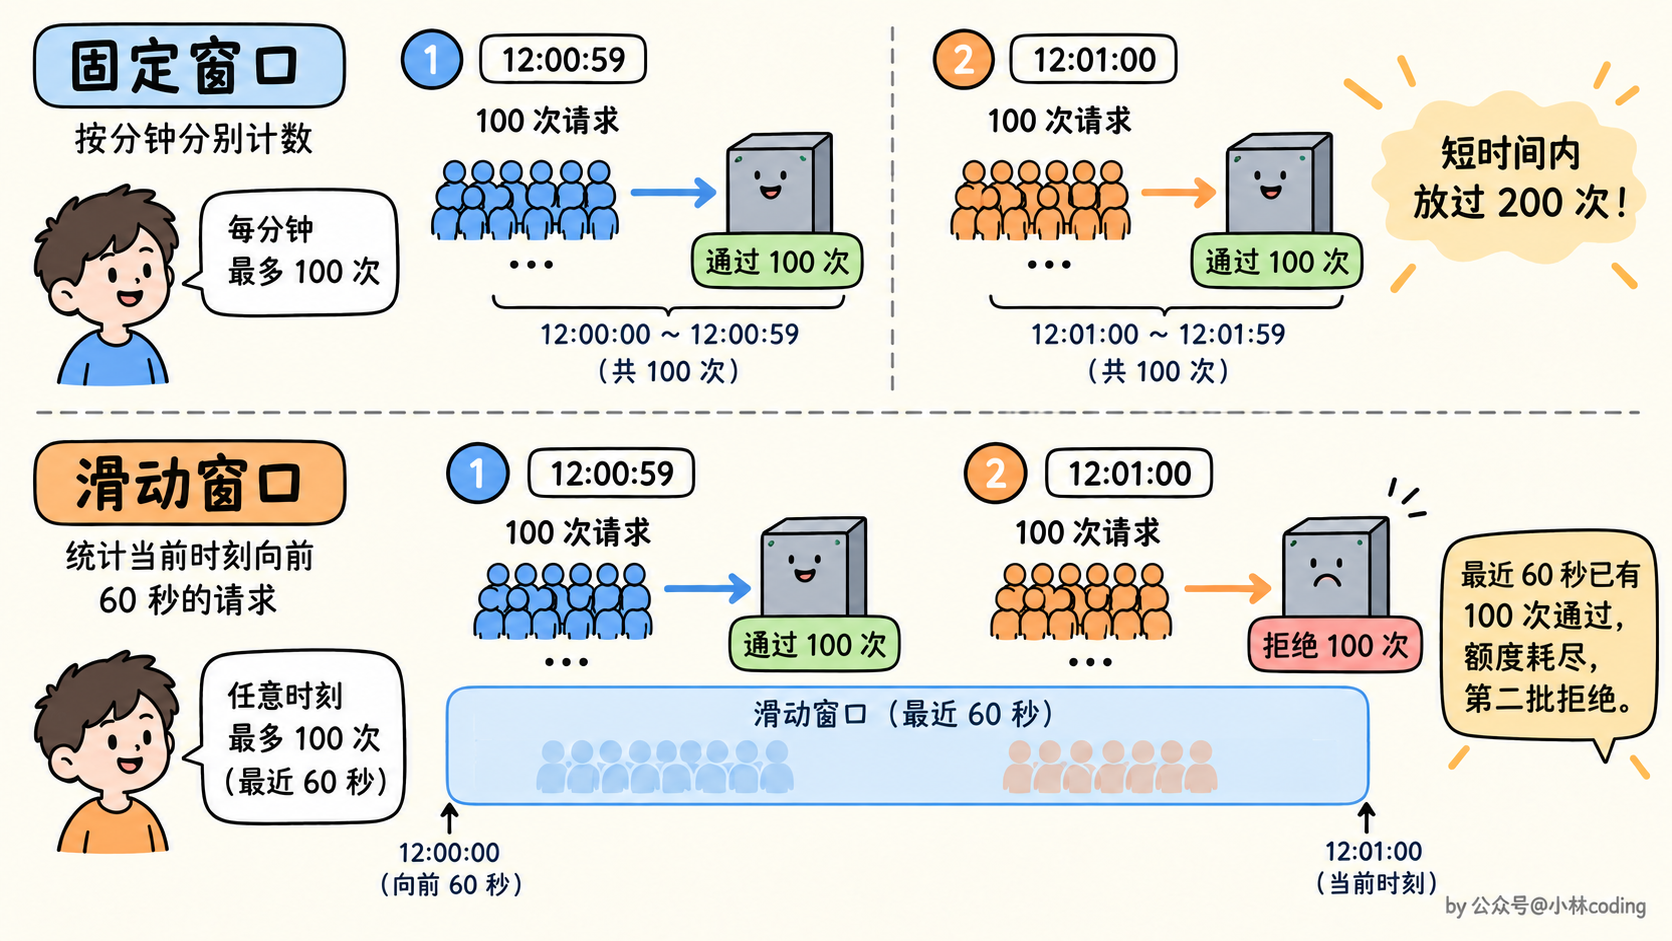
常见的有固定窗口、滑动窗口和令牌桶,主要看是否允许边界突发,以及想限制的是一段时间内的总量还是平滑速率。
1、固定窗口
比如每个用户每分钟最多请求 100 次,可以用“用户 ID + 当前分钟”作为 key,使用 INCR 计数,第一次写入时设置过期时间。
INCR 和第一次设置过期时间要放在同一个 Lua 脚本里,避免执行完 INCR 后客户端宕机,计数 key 却没有 TTL:
-- KEYS[1] 是当前窗口的计数 key
-- ARGV[1] 是计数 key 的保留时间(秒),ARGV[2] 是限流阈值
local count = redis.call("incr", KEYS[1])
if count == 1 then
    redis.call("expire", KEYS[1], ARGV[1])
end
if count > tonumber(ARGV[2]) then
    return 0
end
return 1
这里窗口由 key 中的时间段划分,TTL 主要用于回收旧窗口的计数。固定窗口实现简单,但窗口边界可能出现突发:上一分钟末尾请求 100 次,下一分钟开头又请求 100 次,短时间内就能放过 200 次。
2、滑动窗口
可以用 Zset 保存最近一段时间的请求,把时间戳作为 score,把唯一请求 ID 作为 member。每次先删除窗口外的数据,再统计数量,没有超过阈值才记录当前请求。删除、计数和添加需要放在 Lua 中一起完成。
这样可以控制“最近 60 秒最多 100 次”,但每条请求都要占用一条记录,流量大时需要考虑内存和脚本执行成本,也可以用分桶计数减少开销。
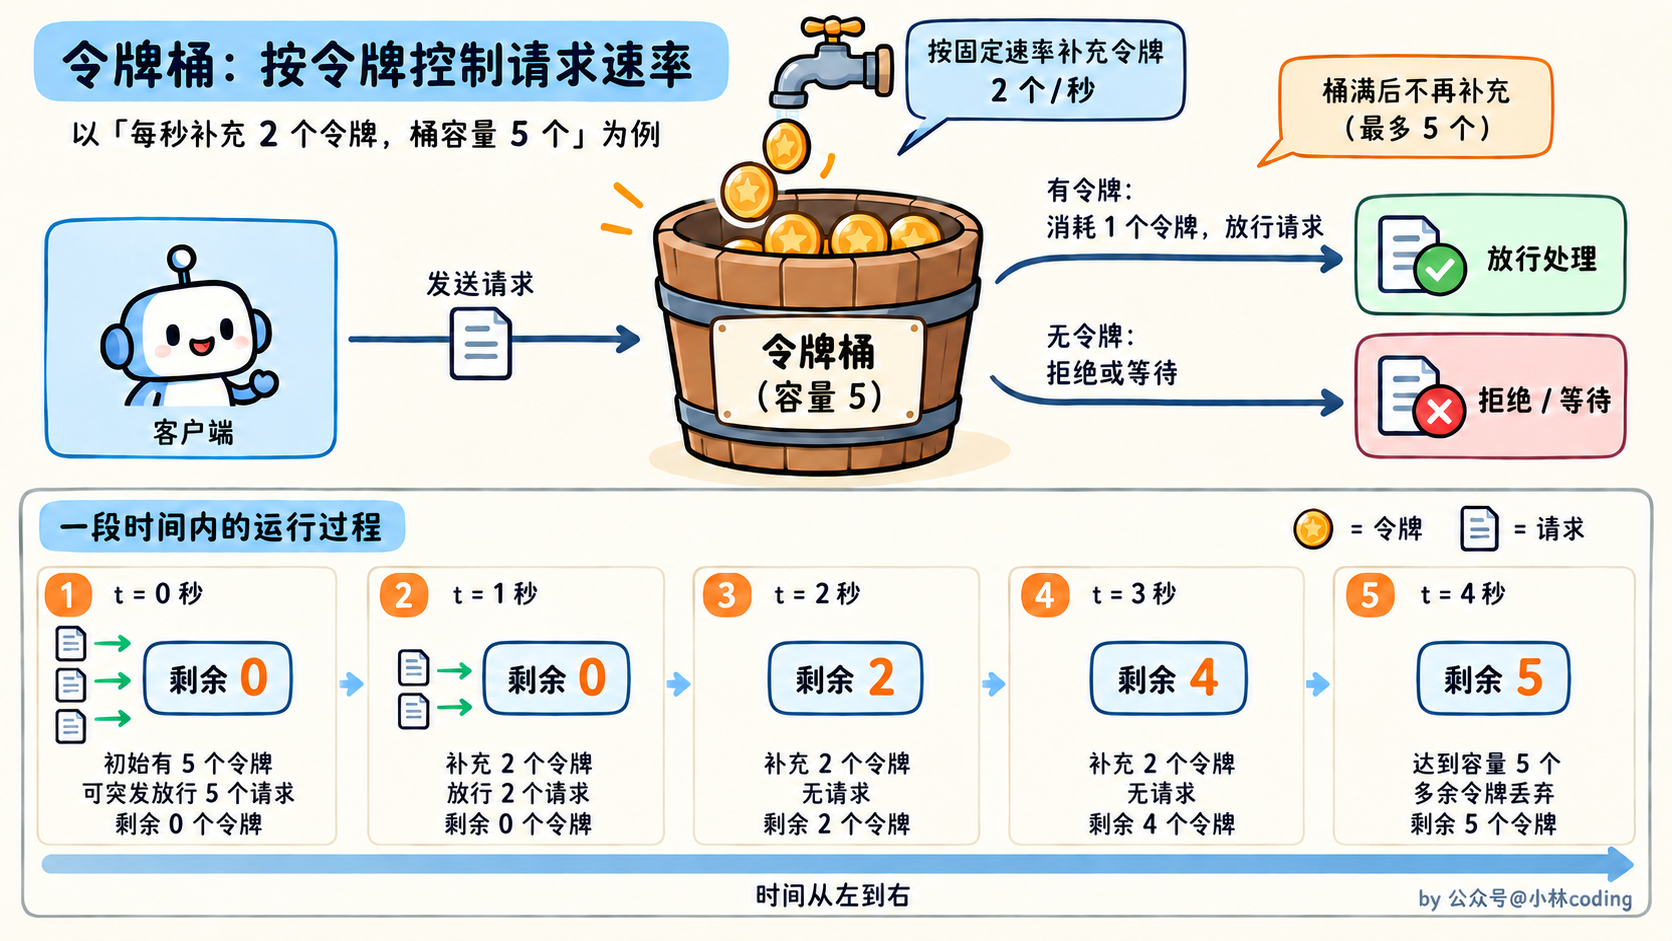
3、令牌桶
按固定速率补充令牌,桶有容量上限,请求先拿令牌,拿不到就拒绝或者等待。它允许容量范围内的短时突发,同时控制长期速率。可以在 Redis 中保存剩余令牌和更新时间,通过 Lua 根据时间差计算补充量,再扣减令牌。
无论哪种方案,都要明确 Redis 不可用时是放行、拒绝还是降级,并统一时间来源,避免不同应用机器的时间差影响窗口判断。
# Redis 突然变慢了,怎么排查?
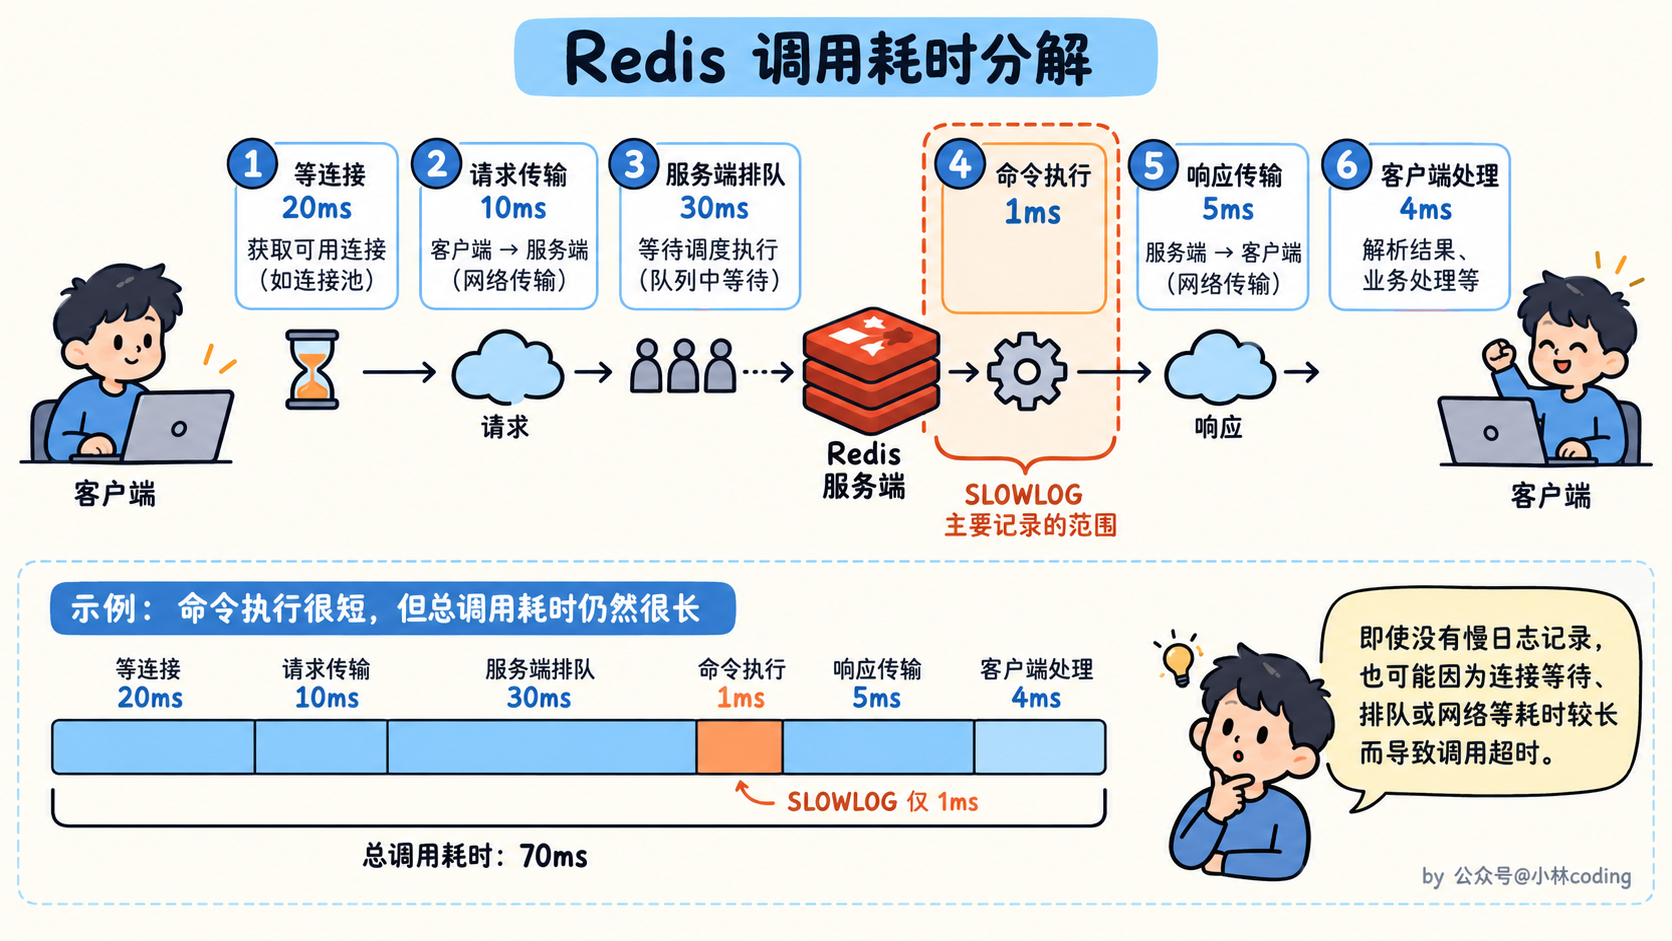
我会先区分,是 Redis 执行命令慢,还是应用到 Redis 的整个调用链路慢,不能看到客户端超时就直接认为 Redis CPU 不够。
1、检查慢命令和热点
先看 SLOWLOG GET,确认是否有 KEYS、大范围 ZRANGE、HGETALL、SMEMBERS,或者执行时间很长的 Lua 脚本,再结合大 key、热 key 排查。
慢日志主要记录命令执行时间,不包括网络传输和客户端连接池等待,所以没有慢日志,也不代表整个请求一定很快。可以结合 INFO commandstats、应用监控和延迟指标判断。
2、检查 Redis 的后台任务和内存压力
看 INFO persistence、INFO memory、INFO stats,确认延迟升高时是否发生了 BGSAVE、AOF 重写、磁盘刷盘、大量过期删除或者内存淘汰。
如果已经开启延迟监控,还可以用 LATENCY LATEST、LATENCY DOCTOR 查看 fork、AOF 写入、过期和淘汰等事件。大量 key 同时过期、内存不足导致频繁淘汰,也会占用主线程时间。
3、检查机器和网络
看 CPU、磁盘 I/O、内存、swap 和网络带宽。如果数据页被换到 swap,访问时可能触发磁盘读取;如果返回大 value,网络传输也可能成为瓶颈。还要检查客户端是否每次新建连接、连接池是否耗尽,以及超时重试是否进一步放大流量。
如果是 Cluster,还要比较各个分片,确认是不是只有某个热点分片变慢。
排查后再对症处理:慢命令改成分批访问,大集合删除用 UNLINK,热点读引入本地缓存,独立请求用适当大小的 Pipeline,容量或带宽不足再考虑扩容。增加 I/O 线程主要改善网络读写,不能把一个慢命令拆成多线程执行。
# 如何设计秒杀场景处理高并发以及超卖现象?
在数据库层面解决
- 在查询商品库存时加排他锁,执行如下语句:
SELECT * FROM goods WHERE goods_id = ? FOR UPDATE;
在事务中,线程 A 通过 SELECT ... FOR UPDATE 锁住 goods_id 对应的记录。这里假设 goods_id 使用合适的唯一索引,否则锁范围还可能扩大。那么其他线程此时可以使用select语句读取数据,但是如果也使用select for update语句加锁,或者使用update,delete都会阻塞,直到线程A将事务提交(或者回滚),其他线程中的某个线程排在线程A后的线程才能获取到锁。
- 更新数据库减库存的时候,进行库存限制条件
UPDATE goods SET stock = stock - 1 WHERE goods_id = ? AND stock > 0;
如果只是做库存扣减,可以直接执行带 stock > 0 条件的 UPDATE,不一定要先 SELECT FOR UPDATE。受影响行数为 1 才表示扣减成功,为 0 就不能继续按成功处理。订单创建和库存扣减还应该在同一个数据库事务里完成。
这种方案能在数据库层面防止库存被扣成负数,但同一个商品的写入仍然需要竞争锁,高并发时可能遇到连接池耗尽或者锁等待。
利用分布式锁
在锁有效且没有发生失效、切换等异常的前提下,同一个锁 key 同一时间只允许一个持有者进入业务逻辑。加锁失败的请求应该超时、退避或者直接返回繁忙,不能无限等待。
这种方案的缺点是同一个商品在多用户同时下单的情况下,会基于分布式锁串行化处理,导致没法同时处理同一个商品的大量下单的请求。
利用分布式锁+分段缓存
把数据分成很多个段,每个段是一个单独的锁,所以多个线程过来并发修改数据的时候,可以并发的修改不同段的数据
假设场景:假如你现在商品有100个库存,在redis存放5个库存key,形如:
goods:01:stock:0 = 20
goods:01:stock:1 = 20
goods:01:stock:2 = 20
goods:01:stock:3 = 20
goods:01:stock:4 = 20
用户下单时对用户 ID 取模,选择一个库存分段,每个分段使用独立的锁,减少所有请求争抢同一个锁的情况。但如果这些 key 仍在同一个 Redis 实例上,命令执行依然是串行的;是否能提升整体吞吐量,要看业务临界区和数据库是不是仍有共同瓶颈。
这种方案可以解决同一个商品在多用户同时下单的情况,但有个坑需要解决:当某段锁的库存不足,一定要实现自动释放锁然后换下一个分段库存再次尝试加锁处理,这种方案的复杂度比较高。
利用 Redis Lua 原子预扣库存 + 异步队列
更常见的思路是,把流量先挡在 Redis 层,再通过队列让数据库平稳地创建订单。
这里不能只说“DECR 是原子的,所以不会超卖”。如果先 GET 判断库存,再 DECR 扣减,两条命令之间仍然可能被插入其他请求;只执行 DECR,也可能把库存扣成负数。
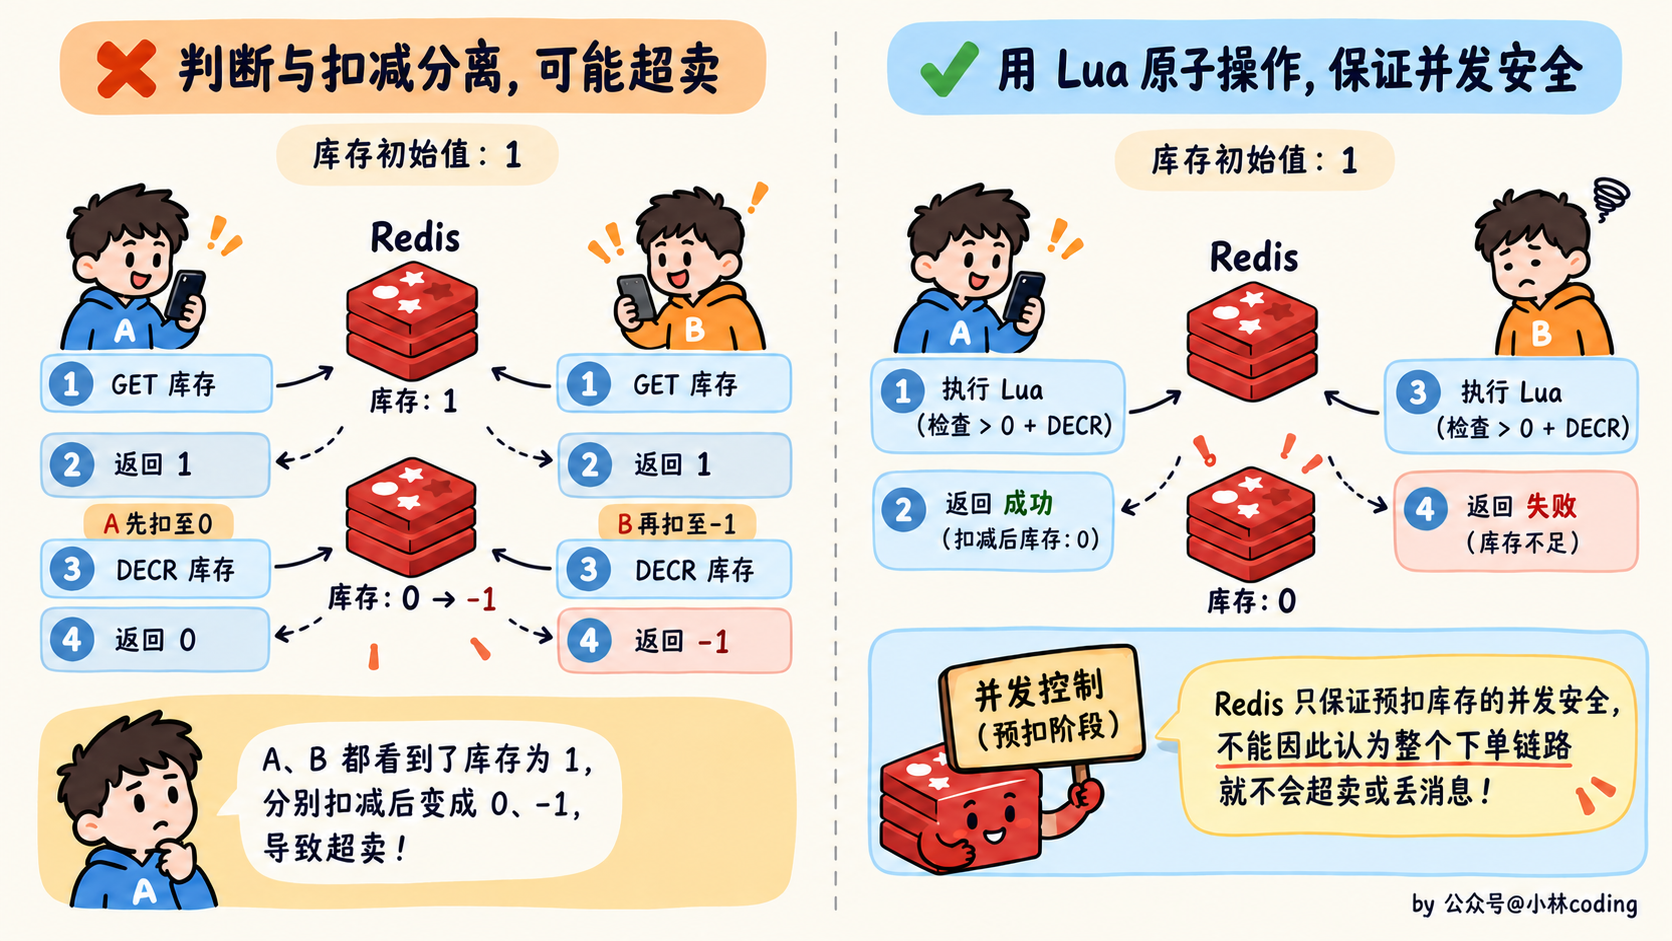
可以用 Lua 把“判断库存”和“扣减库存”放在一起:
-- KEYS[1] 是库存 key,返回 1 表示预扣成功,0 表示库存不足
local stock = tonumber(redis.call("get", KEYS[1]))
if not stock or stock <= 0 then
    return 0
end
redis.call("decr", KEYS[1])
return 1
完整流程可以这样设计:
- 提前加载库存:活动开始前,把可售库存加载到 Redis,并做好入口限流,避免所有请求都进入库存扣减流程。
- 原子校验和预扣:用 Lua 判断用户是否重复下单、库存是否足够,再预扣库存并记录请求状态。上面的脚本只演示库存判断,实际还要补充用户去重和请求标识。
- 可靠地发送下单事件:预扣成功后进入排队。要处理“扣减成功但消息发送失败”这个窗口,可以记录待投递请求并补偿重试;如果把请求记录放到 Redis Stream,也可以在同一脚本中完成预扣和记录,但要预先校验类型,配置持久化,并在 Cluster 中让相关 key 位于同一个槽。
- 消费消息并创建订单:消费者使用唯一请求 ID 或订单号做幂等,在数据库事务里创建订单、执行
UPDATE goods SET stock = stock - 1 WHERE goods_id = ? AND stock > 0,检查受影响行数。还可以通过用户与活动的唯一约束防止重复购买。 - 处理失败和查询结果:暂时性错误优先重试,明确下单失败再按请求状态补偿库存。补偿也要幂等,避免重复把库存加回去;客户端可以轮询订单状态或者接收结果通知。
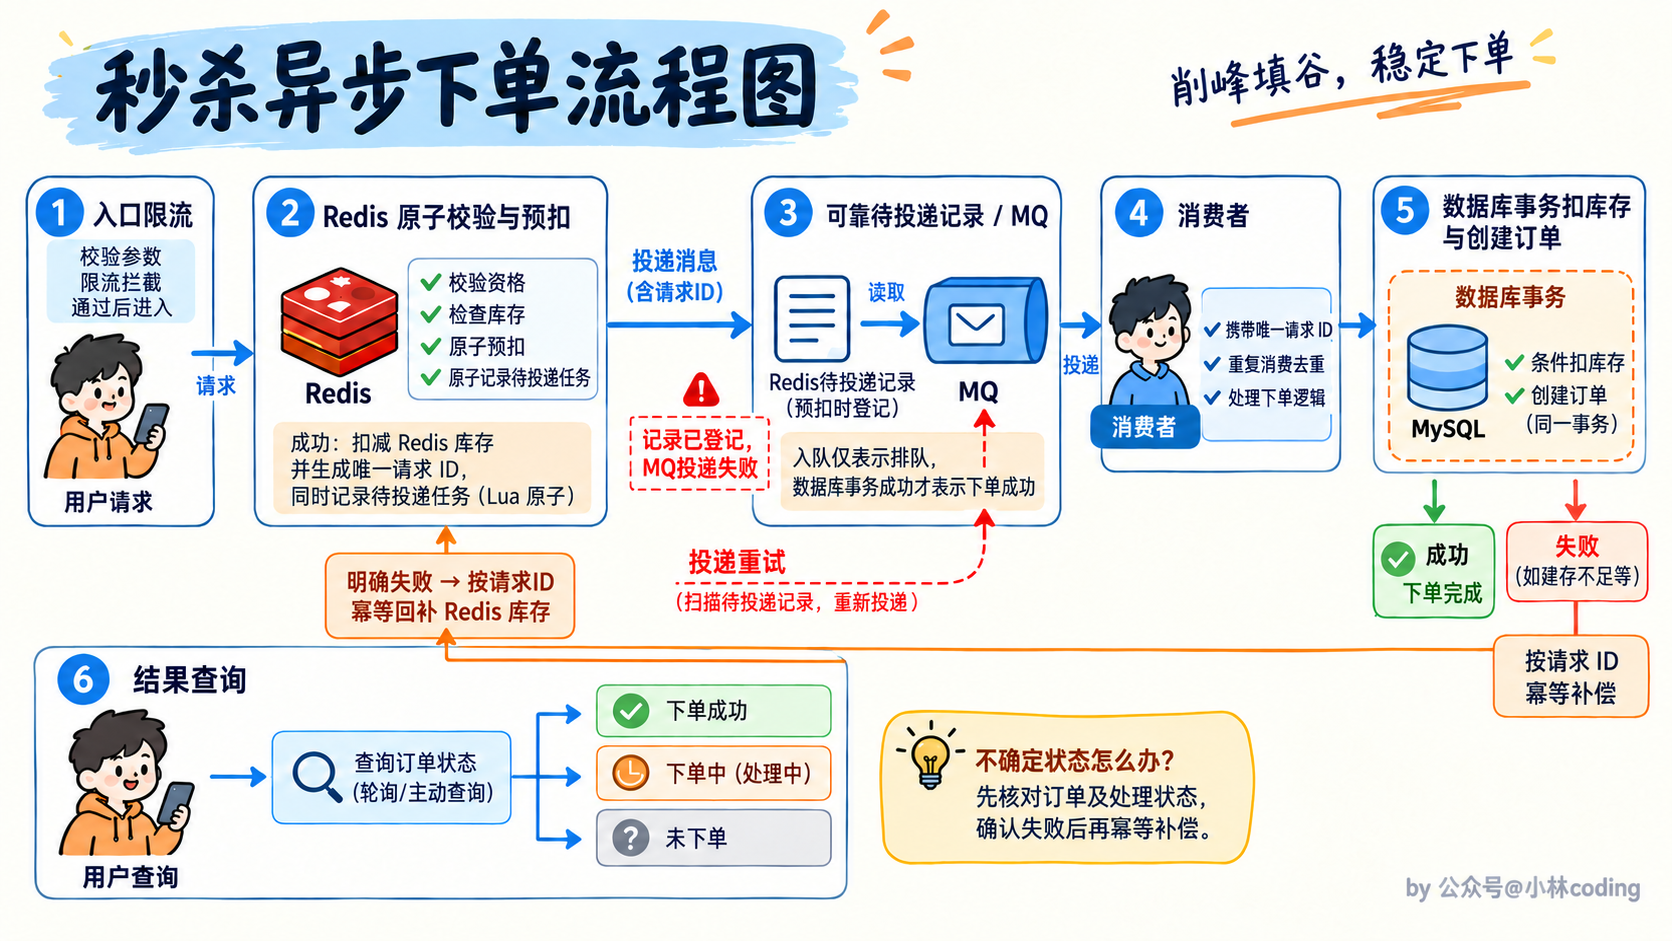
这里的 Redis 库存是流量控制和预占,最终能不能下单,仍然要有数据库条件更新、事务和唯一约束兜底。还需要考虑消息重复、消费者宕机、支付超时取消、Redis 数据丢失后的库存校准,不能只靠“原子扣减 + MQ”就认为整个链路一定一致。
最新的图解文章都在公众号首发,别忘记关注哦!!如果你想加入百人技术交流群,扫码下方二维码回复「加群」。